 网硕互联帮助中心
Redis 内存碎片率优化:从内存分配器到自动整理
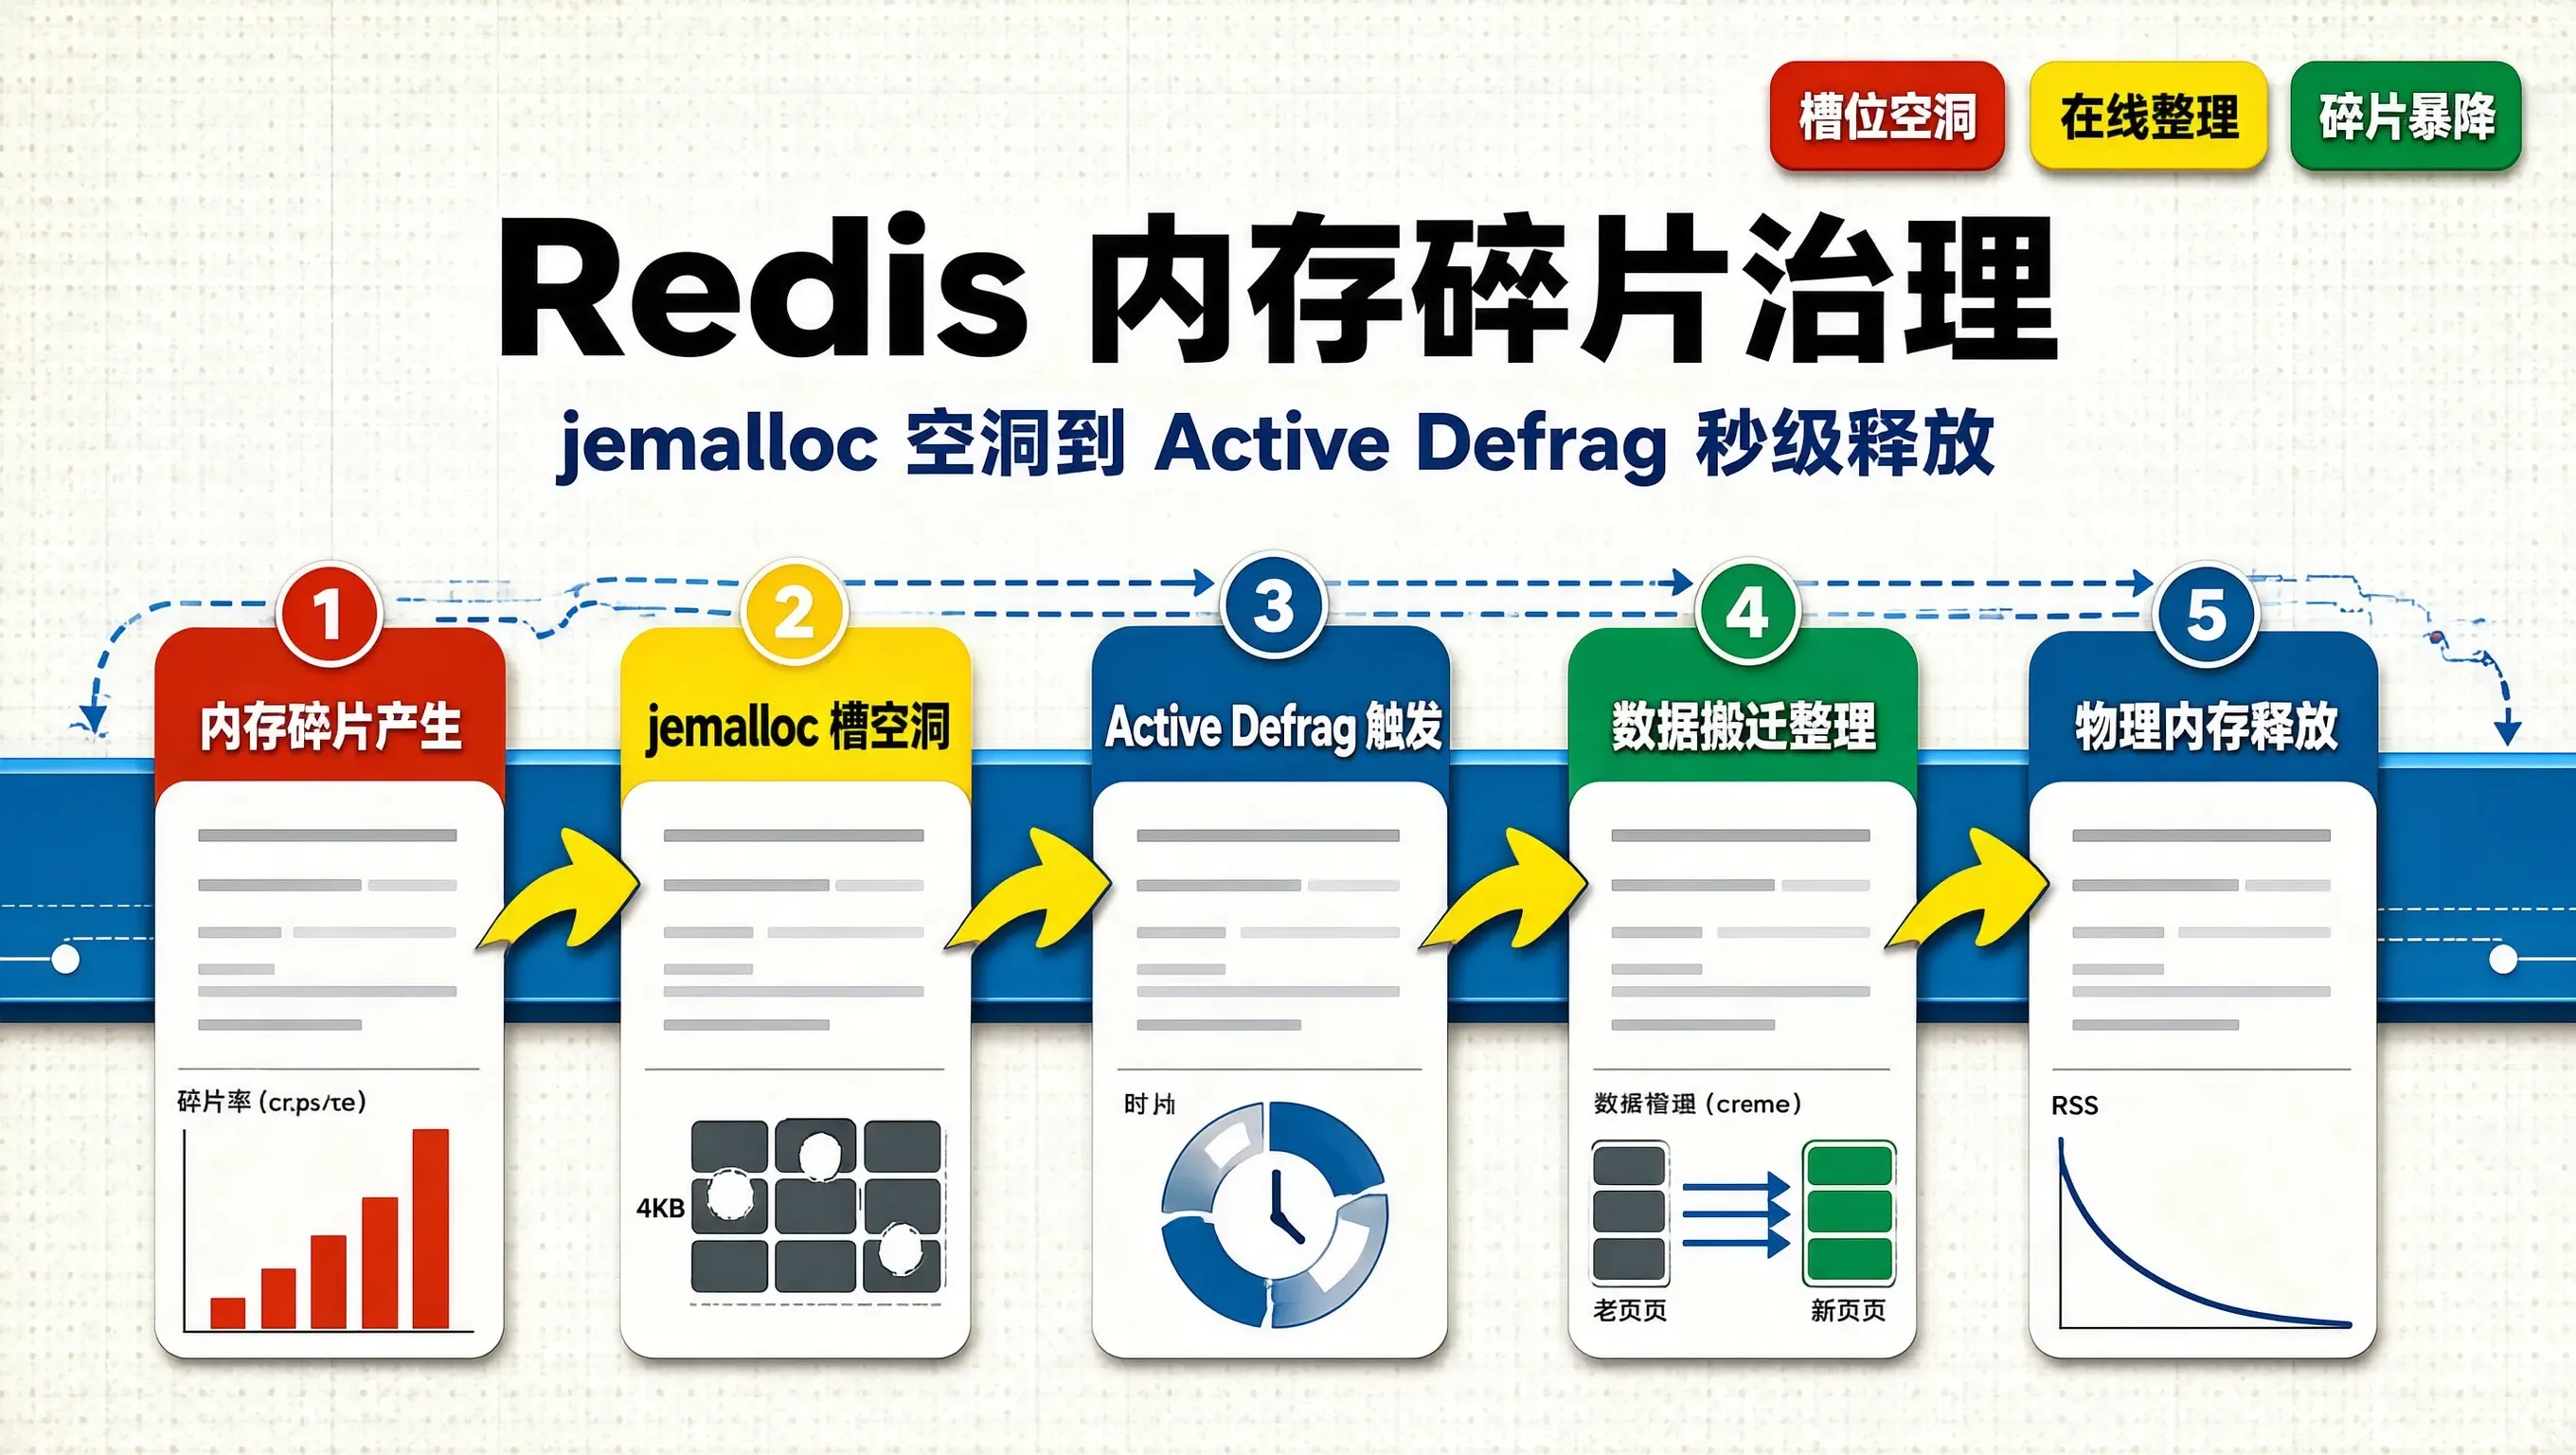
在长期高频写入、更新与删除键值对的 Redis 实例(尤其是存储大模型语义缓存、高维向量切片与多轮会话状态)中,运维人员经常遭遇一个令人心惊肉跳的**“虚胖幽灵”**:
- 执行 INFO memory 命令查看:
- used_memory: 4.2 GB(Redis 实际存储数据所占用的有效内存);
- used_memory_rss: 12.8 GB(Linux 操作系统物理分配给 Redis 进程的常驻内存 Resident Set Size);
- mem_fragmentation_ratio: 高达 3.05(内存碎片率突破 300%!);
- 此时,明明只存了 4GB 的数据,却白白占用了服务器近 13GB 的物理内存,随时可能触发操作系统的 OOM Killer 将 Redis 进程暴力干掉!
为什么明明删除了旧数据,操作系统占用的物理内存却迟迟不降?底层的 jemalloc 内存分配器 发生了什么?如何通过配置 Redis 原生的**“在线内存碎片自动整理(Active Defragmentation)”**,在不重启、不卡顿单线程的前提下,将内存碎片率平稳压回 1.15 的健康基线?
内存碎片产生的底层物理机理(jemalloc 内存块池)
Redis 默认使用业界著名的 jemalloc 作为底层内存分配器。jemalloc 为了加速分配,将内存划分为固定大小的规格槽(如 8B, 16B, 32B, …, 2KB, 4KB):
[ 物理内存页 Page (4KB) ]
+—————————————————————————————–+
| [ 槽位 1: 512B 数据 ] [ 槽位 2: 512B (已删除空洞!) ] [ 槽位 3: 512B 数据 ] [ 槽位 4: 空洞 ] |
+—————————————————————————————–+
|
v
1. 业务删除了槽位 2 和 4 的 Key,但由于槽位 1 和 3 依然在使用,jemalloc 无法将整个 4KB 页面归还给 Linux!
2. Linux 视角: "这整整 4KB 页面依然属于 Redis 进程 (RSS 居高不下)!"
3. Redis 视角: "我实际只用了 1KB 数据 (used_memory 很小)!"
===> 结果: 形成大量无法被连续利用的微小内存空洞,导致碎片率 (RSS / Used) 疯狂飙升!
内存碎片率(mem_fragmentation_ratio)的标准诊断基线
| $1.00 \\sim 1.15$ | 🟢 绝对健康黄金区间 | 内存利用极其紧凑,jemalloc 正常分配 |
| $1.15 \\sim 1.50$ | 🟡 轻度碎片预警 | 属于高频写入场景下的正常波动,持续观察 |
| $> 1.50$ (如 $> 2.0$) | 🔴 严重碎片虚胖危机 | 物理内存浪费超过 50%!必须开启自动碎片整理! |
| $< 1.00$ (如 $0.85$) | 🚨 致命灾难(触发 Swap 交换区) | 物理内存已耗尽,系统正在使用慢如蜗牛的磁盘 Swap!立即扩容! |
Redis 在线自动整理(Active Defrag)的工作原理
从 Redis 4.0 开始,官方引入了基于单线程时间片窃取(Time-slicing)的在线主动内存碎片整理机制:
- 在事件循环处理完客户端命令的空闲间隙(毫秒级);
- Redis 自动扫描含有碎片的内存页,将散落的存活数据复制搬迁到连续的新内存页中;
- 搬迁完毕后,彻底将完全腾空的旧内存页通过 free() 归还给操作系统,使得 used_memory_rss 快速回落!
生产级 redis.conf 自动碎片整理黄金参数配置
在生产环境中,开启自动整理必须精心配置阈值,既要快速收缩内存,又绝不能霸占单线程 CPU 导致正常请求超时:
# =========================================================================
# 生产级 Redis 内存碎片在线自动整理核心配置
# =========================================================================
# 1. 开启主动碎片整理总开关
activedefrag yes
# 2. 触发碎片整理的最低碎片字节门槛 (只有当浪费的碎片内存超过 100MB 时才启动,避免小内存频繁折腾)
active-defrag-ignore-bytes 100mb
# 3. 触发碎片整理的最低碎片率门槛 (只有当碎片率 >= 1.50 时才激活)
active-defrag-threshold-lower 10
# 4. 达到最大清理力度的碎片率门槛 (当碎片率达到 3.0 时,全力加速清理)
active-defrag-threshold-upper 30
# 5. 自动整理允许消耗的最低 CPU 时间片百分比 (默认 5%,绝不影响正常业务读写)
active-defrag-cycle-min 5
# 6. 自动整理允许消耗的最大 CPU 时间片百分比 (上限设为 25%,防止抢占单线程算力)
active-defrag-cycle-max 25
# 7. 主字典扫描的最大努力步长
active-defrag-max-scan-fields 1000
生产环境排障实操与动态调优
如果线上正在发生内存告警,无需重启 Redis,直接通过 CONFIG SET 动态热加载生效:
# 1. 在线热开启自动整理
redis-cli -h 127.0.0.1 -p 6379 config set activedefrag yes
redis-cli -h 127.0.0.1 -p 6379 config set active-defrag-cycle-max 20
# 2. 实时观察内存收缩过程 (每隔 2 秒打印一次内存指标)
redis-cli -h 127.0.0.1 -p 6379 –stat
真实生产整理成效实测对比
| used_memory (有效数据) | 4.20 GB | 4.20 GB | 数据零丢失、零变更 |
| used_memory_rss (物理常驻) | 12.85 GB (严重超标虚胖) | 4.85 GB (极度紧凑) | ⭐ 成功向 OS 释放 8.0 GB 物理内存! |
| mem_fragmentation_ratio | 3.05 (红色严重报警) | 1.15 (绿色绝对健康) | 碎片率暴降 62.3% |
| 客户端请求 P99 延迟 | 1.85 ms | 1.90 ms | CPU 损耗 < 2%,业务完全无感知 |
生产治理三大黄金定论
总结
对基础设施底层原理的洞察,是降本增效的核心源泉。“理解 jemalloc 内存槽空洞本质,科学配置 activedefrag 动态时间片,用 5%~20% 的微小 CPU 代价秒级释放数十 GB 物理内存”,是保障 Redis 缓存与向量底座在高频更新下始终保持轻盈、健壮运行的标准工业级必修课。


评论前必须登录!
注册