 网硕互联帮助中心
能力都在涨,但两家不约而同换了主战场:不是谁的模型更聪明,而是谁能让智能更便宜地被用起来。 
文章目录
-
- 一、先说发生了什么
- 二、成绩单:各自在自己的主场赢
-
- Opus 5.5 这一侧
- GPT-6 Sol / Luna 这一侧
- 三、标价只降 20%,任务成本为什么能降 40%?
- 四、还有个容易被忽略的升级:都不装了
- 五、价格表(直接抄走)
- 六、如果明天就要用,怎么选
- 七、真正值得记住的一件事
一、先说发生了什么
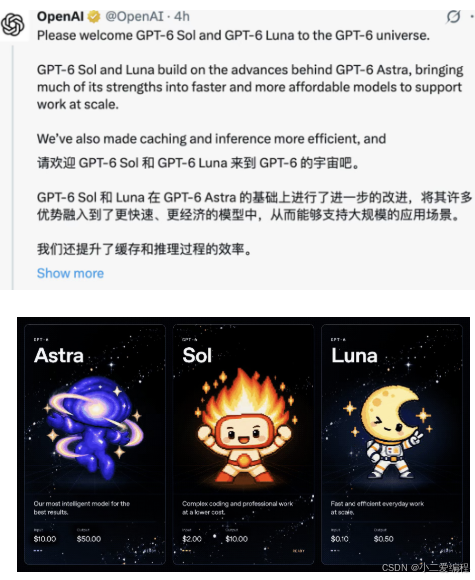
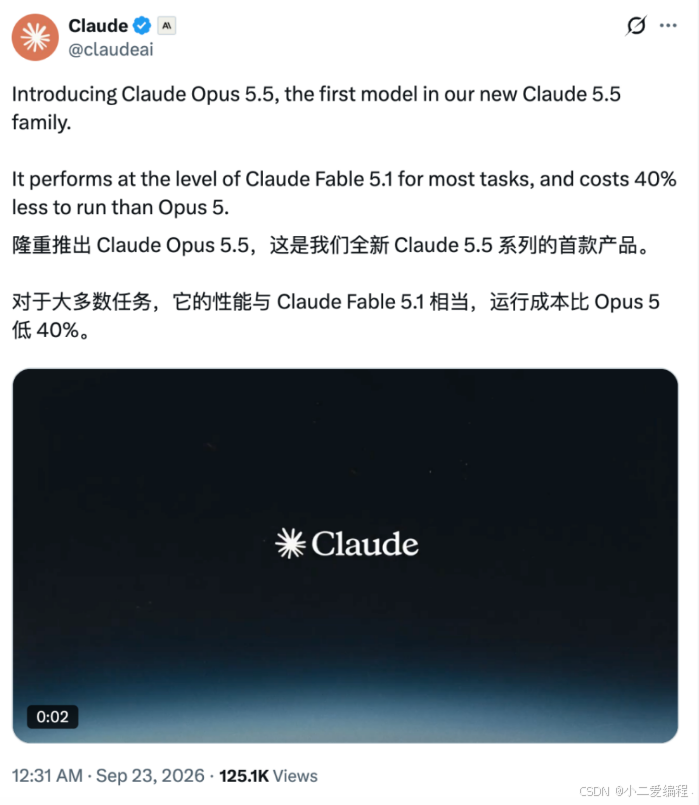
几乎同一时间,OpenAI 和 Anthropic 摁下发布键,前后只差一个小时:
- Anthropic:Claude Opus 5.5,Claude 5.5 系列第一款。定位说得很直白——大多数任务追平 Fable 5.1,成本比 Opus 5 低 40%,输出快 30%。
- OpenAI:GPT-6 Sol 和 Luna,从顶配的 GPT-6 Astra 底座下放。Astra 负责能力探索,Sol/Luna 负责规模化。API 价格对 GPT-5.6 直接腰斩。
这不是巧合。发布前三天,路透刚报道 Anthropic 在筹备新模型应对 Astra 抢企业市场;甚至有消息称 Fable 5.5 会卡着 OpenAI DevDay 当天亮相。
两家隔空对轰,打的却是同一张牌:单位任务成本。
二、成绩单:各自在自己的主场赢
Opus 5.5 这一侧
| Terminal-Bench 4.0(真实终端代码) | 66.4% | 55.8% | 57.9% | 拉开差距最大的一项 |
| CursorBench 4.0(Cursor 长流程工程) | 57.8% | 51.8% | — | Opus 5 仅 46.6% |
| GDPval-AA v2.1(职业真实任务) | 1846 | 1735 | 1542 | 律师/分析师/工程师类任务 |
| OSWorld 2.0(电脑操作) | 81.8% | 略低 | — | 实测丝滑 |
| AutomationBench(企业自动化) | 40.0% | — | 41.4% | Astra 仍占优 |
| Terminal-Bench-Science(科研终端) | 58.7% | — | 64.6% | Astra 优势更明显 |
第三方 Artificial Analysis 的综合智能指数里,Opus 5.5 拿 58 分排第一,比 Fable 5.1 和 Astra 都高 5 分;大约每题 1.4 美元,就拿到了 Opus 5 开满档(每题约 6 美元)的分数。
企业侧的反馈更实在:Deloitte 用它做代码审查,找出 72% 的已知 bug(Opus 5 开高档位只有 56%,误报还更多);Stripe 一个会话指挥十几个子会话,40 个改动全部通过测试;有人用它做完 68 万行代码的迁移,不到一天。
GPT-6 Sol / Luna 这一侧
| AutomationBench | 与 Opus 5 max 相当 | Opus 5 | 约为它的 1/11 |
| Agents’ Last Exam | 56.4%,超过 Opus 5 最高分 | Opus 5 | 低 60% |
| DeepSWE v1.1 | 68.8%,仅比 Fable 5 的 69.9% 低 1.1 点 | Fable 5 | 低约 80% |
| OSWorld 2.0 | 60.5% vs Opus 5 的 60.3% | Opus 5 | 低约 80% |
| FrontierCode | 更低成本匹配 Fable 5.1 xhigh | Fable 5.1 | — |
| 事实准确性 | 错误率约为上一代一半 | GPT-5.6 Sol | — |
Luna 更极端:输入 $0.10/百万 token,比 DeepSeek-V4.1 Flash 的 $0.15 还低;max 档用约 1% 的成本达到 GPT-5.6 Sol 的水平。
一句立场总结:写代码、办公、电脑操作,这轮赢家是 Opus 5.5;企业自动化和科研终端,Astra 还没让位;而"便宜"这条线,Sol 和 Luna 目前没有对手。
三、标价只降 20%,任务成本为什么能降 40%?
这是这次发布里最值得学的一课:每百万 token 的标价,根本不等于真实成本。
Opus 5.5 的输入输出只降了 20%,但缓存读取从 $0.50 降到 $0.20,降幅 60%。Claude Code 这种反复读代码和历史上下文的长任务,缓存折扣会被持续放大;再加上完成同一任务用的 token 和步骤更少,官方实测典型任务总成本降约 40%,比 Fable 5.1 便宜 60%。
更狠的是档位。Opus 5.5 的 Adaptive Thinking 默认 medium(Fable 5.1 默认 high),在 FrontierCode 上:
| medium | 54.6% | 约 $0.8 |
| max | 54.4% | 约 $6.19 |

多花 7.7 倍的钱,分数反而没涨。 原因是 FrontierCode 会惩罚超出任务范围的修改——推理预算拉满后,模型更容易"多做一些无用功"。
OpenAI 同一天把这套逻辑也讲了一遍:客户买的不是 token,是"任务被完成"。Sol/Luna 优化了缓存命中率、缓存输入读取打 1 折、调整 effort 不再打断缓存上下文,GitHub Copilot 需要重新处理的提示 token 因此降了 50% 以上。
两家隔空打出的,是同一张牌。
四、还有个容易被忽略的升级:都不装了
写代码的人应该深有体会。
Claude 的"腔调"(海外网友起名叫 Claudish)——回答偏长、重点埋在中间、爱堆术语——这次被官方正面修掉了:Opus 5.5 会把最重要的信息放最前、少用术语、严格执行你的写作要求。同一个产品介绍,Opus 5 开高档写了三大段,Opus 5.5 用更低的 medium 档,开头一句"旗舰级的能力,一半的价钱",两段写完。
OpenAI 这边也没闲着:Astra 上改进过的沟通方式下放到了 Sol/Luna,更清晰、更少术语、更少无效细节,而且会明确说清"我检查了什么、没检查什么",不再复述你已经知道的信息。
模型再聪明,输出读不下去也是白搭。这轮两家同时在这个"小事"上发力,说明他们也承认:过去一年卷 coding 卷过头了,体验欠的账得还。
五、价格表(直接抄走)
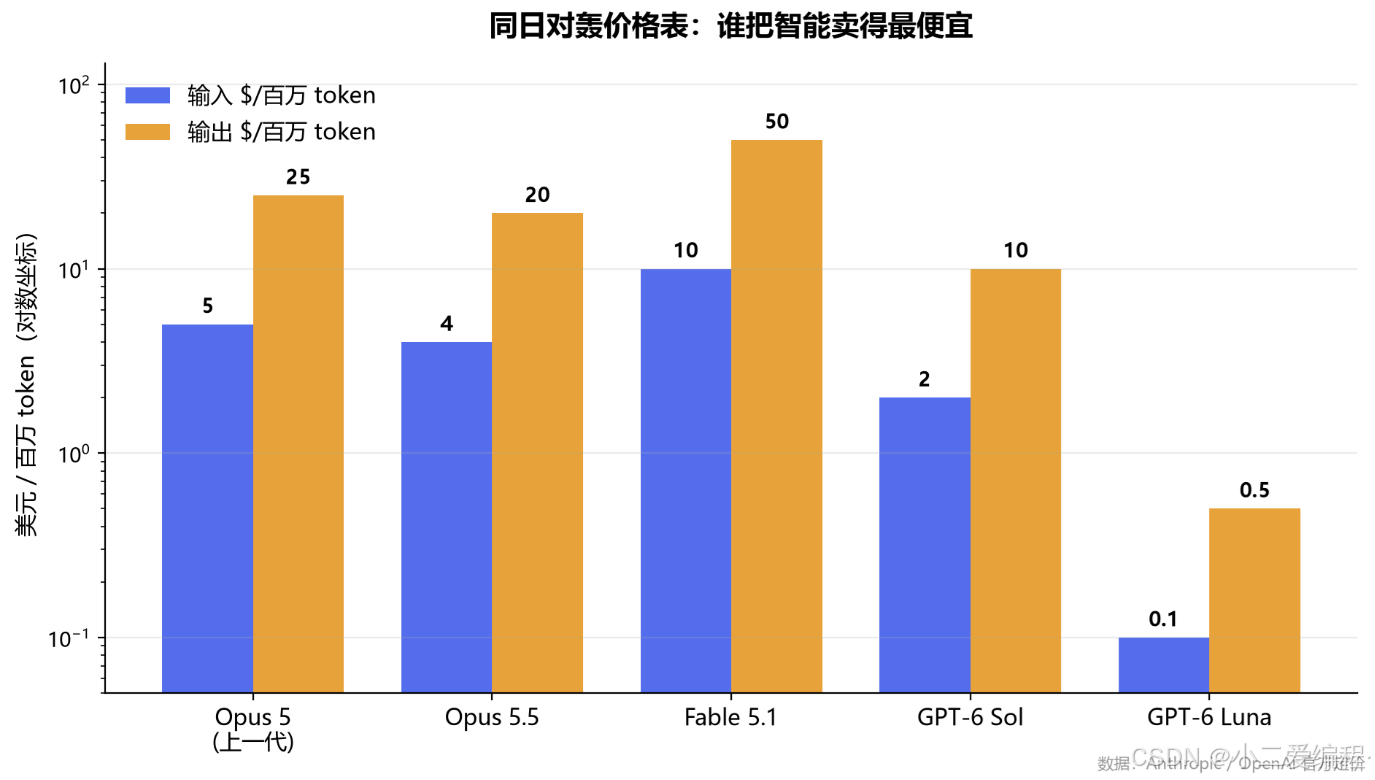
| Claude Opus 5.5 | 4 | 20 | 缓存读 0.2(降 60%);Fast 模式 8/40,快 2.5 倍 |
| Claude Fable 5.1 | 10 | 50 | 正好是 Opus 5.5 的 2.5 倍 |
| GPT-6 Sol | 2 | 10 | 缓存命中读取打 1 折 |
| GPT-6 Luna | 0.10 | 0.50 | 比 DeepSeek-V4.1 Flash 的输入价还低 |
| Opus 5(上一代) | 5 | 25 | 缓存读 0.5 |
顺带一提,Anthropic 给订阅用户提了五小时用量上限,还发了一次可攒着的限额重置;OpenAI 的 Codex 额度重置定在本周二。
六、如果明天就要用,怎么选
| 日常编码 Agent / Claude Code 长任务 | Opus 5.5(medium) | 中档已追平甚至超过 Opus 5 满档,成本约 1/7 |
| 大批量、高吞吐的工程任务 | GPT-6 Sol | 同级单任务成本最低的一档 |
| 轻量分类、路由、批量文本 | GPT-6 Luna | 输入 $0.10,便宜到可以放开跑 |
| 企业自动化 / 科研类终端任务 | 暂留 GPT-6 Astra | AutomationBench 和 Terminal-Bench-Science 仍是它最高 |
| 不知道选啥 | 先 medium,不够再升档 | 两家这轮共同证明:开满档大概率是浪费钱 |
三个注意点:
七、真正值得记住的一件事
Fable 5 发布时,Ramp 的企业支出追踪显示:这款 Anthropic 史上最贵的模型,只占其企业 token 用量约 6%。企业不会因为模型更强,就无限接受更贵的价格。
更有意思的是,Anthropic 自己的开发者文档甚至建议:大多数任务先用 Opus,不够再上 Fable 5.1。旗舰正在从"默认选项",变成留给硬骨头的昂贵资源。
所以这轮对轰之后,下阶段大模型战争的胜负手已经换了:不再是最高智能峰值,而是单位任务成本。 前沿能力当然还要继续往上捅,但真正决定普及速度的,是谁能让智能以最低成本持续创造价值。
价格战刚开打。你猜下一枪谁来放?
评论区聊聊:你现在的主力模型是哪家,这次发布会让你换吗?
参考文献
[1] Anthropic: Introducing Claude Opus 5.5 — https://www.anthropic.com/claude-opus-5-5 [2] OpenAI: Introducing GPT-6 Sol and Luna — https://openai.com/index/introducing-gpt-6-sol-and-luna/ [3] OpenAI: Building abundant intelligence — https://openai.com/index/building-abundant-intelligence


评论前必须登录!
注册