 网硕互联帮助中心
2026年LLM推理服务器生产级对比:vLLM、SGLang、TensorRT-LLM、LMDeploy与TGI的工程选型
2026年6月,LLM推理服务器已经从\"百花齐放\"走向\"四强争霸\"。vLLM、SGLang、TensorRT-LLM、LMDeploy、T...
2026年6月,LLM推理服务器已经从\"百花齐放\"走向\"四强争霸\"。vLLM、SGLang、TensorRT-LLM、LMDeploy、T...
本地跑大模型实战(二):GGUF 与量化等级到底怎么选?本文是《本地大模型搭应用实战》系列第 2 篇。上...
GPUStack 在华为昇腾 800I A2 服务器上的保姆级部署指南 前言 随着国产 AI 芯片生态的日益成熟,华为昇腾(As...
一、YaRN 方法核心定位 YaRN 是一种无需微调、高效扩展大语言模型(LLM)上下文窗口的方法,核心目标是在不重新...
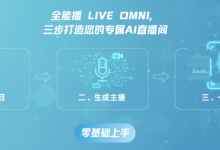
直播带货的规模化运营始终面临人力成本高、直播时长受限、内容输出不稳定等核心问题,尤其是在跨境电商、工厂展厅直播等场景中,对 “无人化...
LFM2.5-1.2B模型是近期的明星模型 LFM2.5-1.2B-Instruct 是 Liquid AI 在 2026 年 1 月推出的开源、轻量级、高...
前言:2025年是大模型“百模大战”转入“推理落地”的关键一年。DeepSeek V3、Llama 3 70B 等开源权重的发布,让...
目录 RAG检索增强优化指南一、三代RAG架构对比1.1 架构演进时间线1.2 三代架构详细对比1.3 Naive RAG - 基础架构Python实现示例 1...
摘要: 随着大模型从“对话时代”迈向“任务执行时代”,智能体工作流(Agentic Workflow)已...
