 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
requests 重试实测:Retry(total=3) 为什么打四次、status_forcelist 不配为什么等于没重试、POST 默认为什么不重试、backoff_factor 为什么第一次不等(urllib3 2.7 / Python 3.13)
零、先说结论
给 HTTP 客户端设了 Retry(total=3),按字面理解是「最多三次请求」。本地起一个会返回 503 的服务,一次调用之后数了数,服务端收到四次。
total 数的是重试,不是请求。第一次是原始请求,后面三次才是重试,所以 1 加 3 等于 4。更麻烦的是反过来那种情况:只写 Retry(total=3) 而不给 status_forcelist,服务端只收到一次请求,客户端直接拿着 503 回来了,重试压根没发生,也没有任何报错。
下面全部在 Python 3.13.12、requests 2.34.2、urllib3 2.7.0 上实测。做法是本机起一个 HTTP 服务,每次请求真实计数,不是模拟推演;120 次调用的状态序列由固定种子生成,不是真实线上流量。官方文档核的是 urllib3 2.7.0 的对应版本页,与本机版本一致,这次没有版本错配。所有数字删掉原始返回可以完整重跑。
一、三次重试,为什么是四次请求?
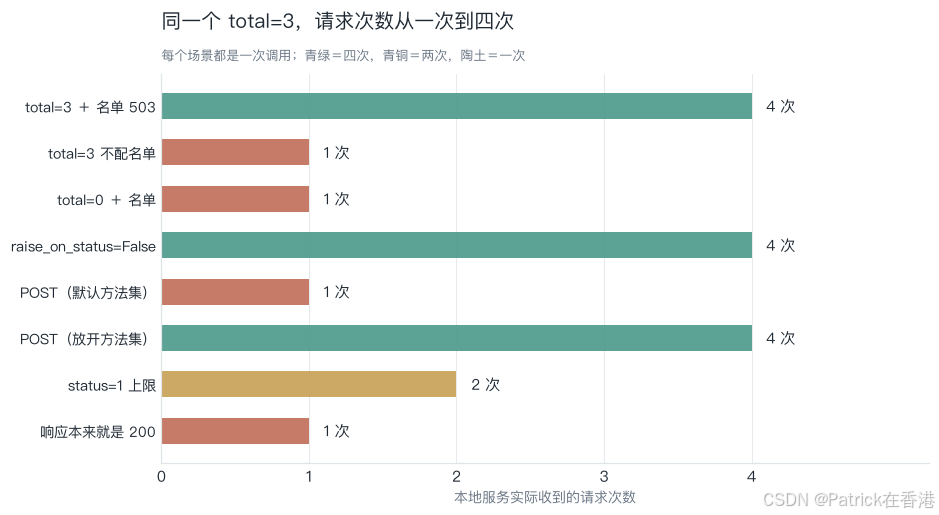
先看同一类配置换一个参数之后,请求次数能差多少:
| total=3 + status_forcelist=[503] | 4 | 抛 RetryError |
| total=3 不配名单 | 1 | 直接返回 503 |
| total=0 + 名单 | 1 | 抛 RetryError |
| raise_on_status=False | 4 | 返回 503,不抛异常 |
| POST,默认方法集 | 1 | 直接返回 503 |
| POST,allowed_methods=None | 4 | 抛 RetryError |
| status=1 | 2 | 抛 RetryError |
| 响应本来就是 200 | 1 | 正常返回 |
total=0 那一行值得停一下:设成零次重试,请求确实只打了一次,但客户端抛的是 RetryError。因为只要状态码落在名单里,重试逻辑就被触发了,一进去发现预算是零,于是以「重试耗尽」收场。它不是没重试,是重试一次都没被允许。
官方文档对 total 的原文是 Total number of retries to allow. Takes precedence over other counts.,后面还写了 Set to 0 to fail on the first retry.。字面一直很清楚,是我们习惯把「重试次数」读成「请求次数」。
二、不配 status_forcelist 会怎样?
这是整篇里最容易造成事故的一条。默认配置下,urllib3 只会对连接类错误重试,不会因为你拿到一个 500 或 503 就再发一次。要让它对状态码重试,必须显式给 status_forcelist。
文档原文写得很直白:By default, this is disabled with None.,并且重试的触发条件是「请求方法在 allowed_methods 里,且响应状态码在 status_forcelist 里」,两个条件缺一不可。
为什么默认关着?因为一个 5xx 并不代表服务端没处理。订单可能已经写进去了,只是回包丢了,这时候再发一次就是重复写入。这个默认值是保护,不是偷懒。所以看到「配了 total 却没重试」,别急着当成库的 bug,先问一句:我到底希望它对什么重试。
三、POST 为什么一次都不重试?
默认允许重试的方法集合,我直接把类属性读出来:DEFAULT_ALLOWED_METHODS = frozenset({'DELETE', 'GET', 'HEAD', 'OPTIONS', 'PUT', 'TRACE'}),六个,没有 POST。文档的说法是默认只重试幂等方法,设成 None 才对任意方法重试。
实测:同一个返回 503 的服务,用 POST 打过去只收到一次请求;把 allowed_methods 设成 None 之后变成四次。
这里要给一句反方向的提醒:默认值在保护你,别为了「让重试生效」随手放开。写入类接口一旦允许自动重试,前面第二节说的重复副作用就真会落到库里。真要重试 POST,前提是接口本身有幂等键,或者只放开连接类错误、不把 5xx 放进名单。这两件事都不该靠改一个 None 解决。
四、total 与 status、connect 谁说了算?
total 是总预算,但 connect、read、status、other 各有各的独立计数。文档对 total 写的是 takes precedence over other counts,另外四类分别对应连接前错误、读取错误、状态码重试、其它错误。
| total=3, status=1 | 2 | status 上限先到,只重试一次 |
| total=3, connect=1 | 4 | connect 只管连接类错误,管不到状态码 |
| total=None, status=3 | 4 | 没有总预算,由 status 计数决定 |
| total=3, status_forcelist=[503] | 4 | 基线 |
最容易误读的是第二行:以为写了 connect=1 就能把「总共重试次数」压到一次,实际状态码重试走的是另一本账,四次照打。想限制总量,该动的是 total 或 status。
五、把 raise_on_status 关掉为什么更危险?
raise_on_status=False 实测:四次请求照打,但最后不抛异常,返回一个 503 响应,它的 ok 是 False。
文档对它的定义是重试耗尽之后「抛异常还是返回响应」。看起来只是异常策略的区别,实际是静默错误最容易钻进来的地方:调用方如果只判断「有没有抛异常」,会以为这次调用成功了,接着去读 resp.json() 或 resp.text,拿到的却是错误页。昨天那篇讲过同族的「没报错不等于没改动结果」,这里是同一个形状。
保留默认的 raise_on_status=True,并在拿到响应后显式 raise_for_status(),是成本最低的兜底。真要关掉它,就必须把状态码检查写进调用方,不能省略。
六、退避为什么第一次不等待?
backoff_factor=0.2 时,我用 increment 逐次构造重试历史,读出 get_backoff_time() 的序列是 [0, 0.4, 0.8, 1.6, 3.2, 6.4]。前三次重试分别等待 0、0.4、0.8 秒,累计 1.2 秒。
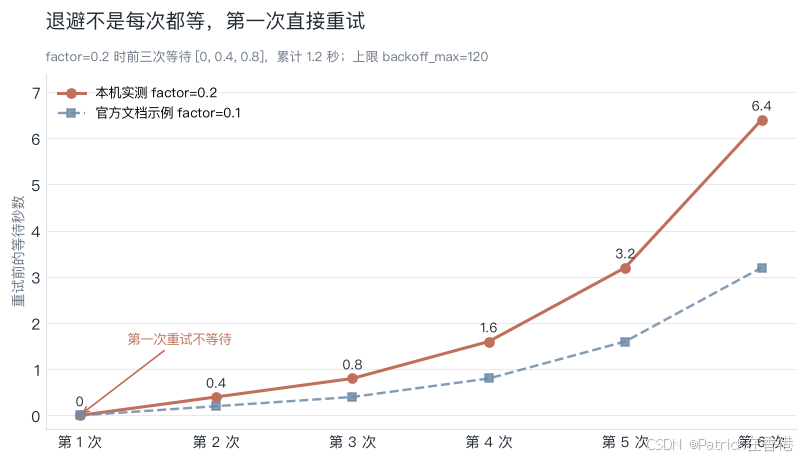
官方文档写的是 A backoff factor to apply between attempts after the second try,公式是 factor 乘以 2 的前次重试数次方,并给了 factor=0.1 的示例序列 [0.0s, 0.2s, 0.4s, 0.8s, …]。本机源码里 consecutive_errors_len <= 1 直接返回 0,之后才是 factor 乘以 2 的 n 减 1 次方,和实测、和文档示例都对得上。
所以「三次重试会等 0.2 + 0.4 + 0.8 = 1.4」这种估法是错的:第一次重试根本不等。另外还有 backoff_max=120 封顶、backoff_jitter=0.0 默认不加抖动,这两个值我也是直接读对象确认的,不是凭印象。
七、Retry-After 会盖过退避公式吗?
有一个默认开着的开关值得知道:respect_retry_after_header=True,而 RETRY_AFTER_STATUS_CODES 实测是 [413, 429, 503]。文档说它决定是否尊重这些状态码上的 Retry-After 头。
也就是说,服务端如果回了一个带 Retry-After 的 429 或 503,等待时间可能不走第六节那条指数曲线。这一节我只核了默认开关、状态码集合和文档措辞,没有实测真实 sleep 时长(真按头等下去会把探针拖得很慢),所以这里不给等待秒数,只提醒:线上排障看到等待时间和公式对不上,先去看响应头。
八、连接错误与状态码错误是一回事吗?
把服务改成「收到请求就直接关掉连接」,配 total=2,实测服务端被打了三次,客户端抛 ConnectionError。文档对 connect 的解释是「请求发到远端之前」的错误,对 read 则特别注明「请求已经发出,可能有副作用」。
两者不对称:连接错误默认就会重试,状态码错误必须显式给名单。排查时如果只盯着 5xx,很容易漏掉连接层的重试放大。
还有一个真实踩到的环境干扰值得记一笔:首版探针里,本地回环请求被机器的代理设置拦了一道,抛出来的是 ProxyError 而不是 ConnectionError,断言当场红了一条。给 Session 设 trust_env=False 之后才拿到干净结果。测本地服务时先把环境代理关掉,否则数到的次数和异常类型都不属于你要测的那层。
九、一百二十次调用,多出来多少请求?
把单次结论放到规模里看。固定种子生成 120 次调用,其中 33 次返回 503、87 次返回 200,每次调用的请求次数由本地服务真实计数:
| 按「总共三次」估计 | 186 |
| 实际计数 | 219 |
| 差额 | 33 |
实际这一边拆开是 87 次成功调用各 1 个请求,加上 33 次失败调用各 4 个请求,共 219。
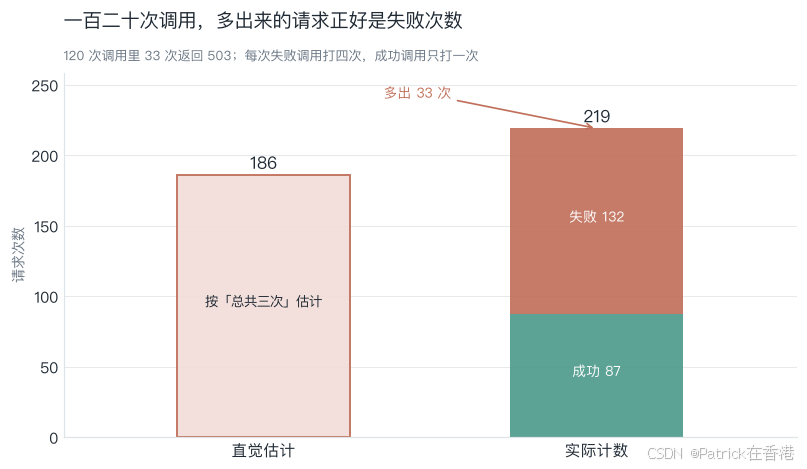
差额不是三倍,是每次失败调用多一次。因为直觉里的「三次」是含原始请求的总数,实际是 1 加 3。做容量估算、算限流配额、对账网关计费时,用错这个数会系统性低估失败时段的请求量,而且低估的量正好等于失败次数。
十、生产里该怎么配这个重试?
把上面几条收成一个可复用的会话构造:
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry
def make_session(total=3, idempotent_only=True):
retry = Retry(
total=total,
status_forcelist=[429, 500, 502, 503, 504],
allowed_methods=(
Retry.DEFAULT_ALLOWED_METHODS if idempotent_only else None
),
backoff_factor=0.2,
raise_on_status=True,
)
s = requests.Session()
s.mount("https://", HTTPAdapter(max_retries=retry))
return s
resp = make_session().get(url, timeout=3)
resp.raise_for_status()
五条约定:
最后一条是工程提醒,本轮没有测超时与重试的交互,不写具体时长。
十一、怎么在日志里看见重试次数?
三条能落地的办法:
import logging
# 1. 打开 urllib3 的重试日志
logging.basicConfig(level=logging.INFO)
logging.getLogger("urllib3.util.retry").setLevel(logging.DEBUG)
关键是别靠配置反推流量。设了 total=3 只能说明你允许了三次重试,不能说明实际发了几次请求;前者是意图,后者要用计数说话。
收口
数据层:
工程层:


评论前必须登录!
注册