 网硕互联帮助中心
一、Buffer Pool 是什么
1.1 作用
磁盘随机 IO 极慢,InnoDB 把频繁访问的数据页/索引页缓存到主内存,命中就直接返回,大幅减少磁盘 IO。
加粗要点:内存随机访问都比磁盘顺序访问快一到两个数量级。
1.2 缓存的是什么
| 数据页 / 索引页(聚簇索引、二级索引、undo、change buffer 位图等) | ✅ 这才是 Buffer Pool 缓存主体 |
| Adaptive Hash Index(AHI) | ✅ 建立在 Buffer Pool 页之上的哈希索引结构,占用池内空间 |
加粗要点:Buffer Pool 的核心是"数据页缓存"。
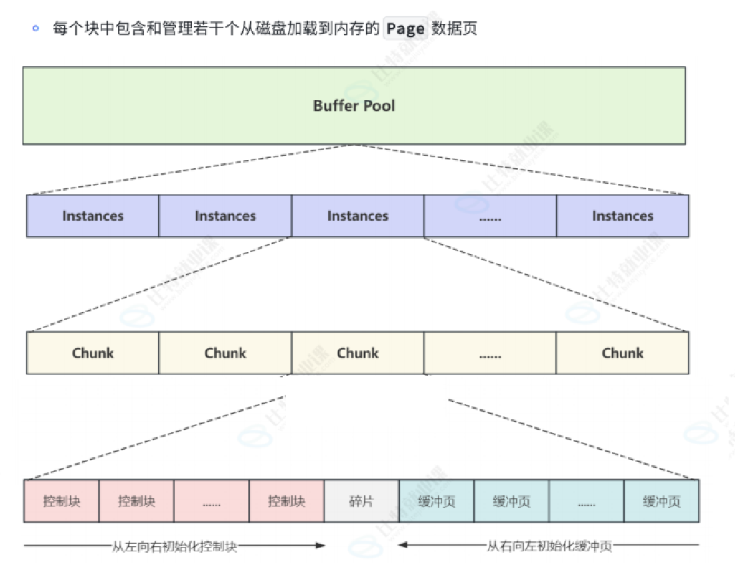
1.3 instance / chunk / page 三级结构
Buffer Pool
└── instance(实例,独立加锁,默认 8 个)
└── chunk(内存分配单位,默认 128MB)
└── page(16KB 数据页帧)
+ 对应的 control block(控制块)
- instance:真正的缓冲池对象,内存操作在 instance 内进行;每个 instance 有独立的 mutex,多线程并发访问不同 instance 不互相阻塞;
- chunk:运行时动态调整大小的单位,默认 innodb_buffer_pool_chunk_size = 128MB;
- page:从磁盘加载进来的 16KB 页帧。
1.4 查看配置
SHOW VARIABLES LIKE 'innodb_buffer_pool_size'; — 总大小
SHOW VARIABLES LIKE 'innodb_buffer_pool_instances'; — 实例数
SHOW VARIABLES LIKE 'innodb_buffer_pool_chunk_size'; — chunk 大小(128MB)
二、内存中如何寻址一页
2.1 外存寻址回顾
磁盘上定位一页 = space_id × 表空间基址 + page_no × 16KB,通过 B+Tree 一层层目录页找到目标 (space_id, page_no)。
2.2 内存寻址:page_hash 哈希表
内存里不做算术寻址,而是用一张哈希表 page_hash:
key = (space_id, page_no) (表空间id + 页id ——单表内唯一)
value = 对应 control block 的指针
一次查询的完整路径:
1. B+Tree 在磁盘结构上定位到目标 (space_id=0, page_no=123)
2. 先查 Buffer Pool 的 page_hash 哈希表
├─ 命中 → 拿到 control block → 直接读页帧内存地址 → 返回
└─ 未命中 → 从 Free List 取一个空闲控制块 → 把磁盘页读进页帧
→ 控制块挂入 LRU old 区 → 加入 page_hash → 返回
加粗要点:内存中的"找页"靠 (space_id, page_no) 哈希,不是页号×页大小。B+Tree 决定"找哪一页",page_hash 决定"这页在内存哪个地址"。
三、控制块:内存页的元数据
3.1 为什么需要控制块
磁盘上下一页的位置由 page_no × 页大小 唯一确定,但内存中页帧地址是运行时分配的,没有固定偏移。InnoDB 为每个页帧配一个控制块(buf_block_t),记录它的元数据。
3.2 控制块成员
| frame | 指向实际 16KB 页帧的内存地址 |
| 多个 list 指针 | LRU 链表指针、Flush 链表指针、Free 链表指针(同一个控制块同时挂多个链表) |
| space_id / page_no | 对应哪张表空间哪一页 |
| state | FREE / CACHED / DIRTY 等状态 |
| fix_count | 被多少线程引用(>0 不能淘汰) |
| LRU 位置标记 | young / old 区 |
3.3 chunk 的物理布局
一个 chunk(128MB):
┌──────────────────────────────────────┐
│ control block 数组(每个约几百字节) │ ← 元数据
├──────────────────────────────────────┤
│ page 帧数组(每个 16KB) │ ← 实际数据
└──────────────────────────────────────┘
控制块数量 = chunk 大小 / 页大小(128MB / 16KB = 8192 个)
- 控制块与页帧一一对应;
- 若 chunk 大小不是页大小整数倍,尾部有少量碎片区被浪费;
- 加粗要点:控制块之间的双链表关系 ≠ 页帧在内存中的物理相邻关系——页帧可能物理相邻,但 LRU 链表是按"冷热"逻辑串联的。
3.4 启动时全部预分配
Buffer Pool 启动时就按配置大小一次性预留好全部内存:所有页帧此时是空的,控制块都挂在 Free List 上。后续不需要 malloc,只是把空页帧填数据、从 Free List 移到 LRU。
3.5 chunk 为什么存在(动态调优)
如果 Buffer Pool 一开始就规定死instance边界,扩容时必须整块拷贝到新内存。引入 chunk 后:
- 调大 → 申请新 chunk,挂到 instance 上;
- 调小 → 摘走一个 chunk;
- 拷贝的只是 chunk 指针/引用,不是整个池的数据。
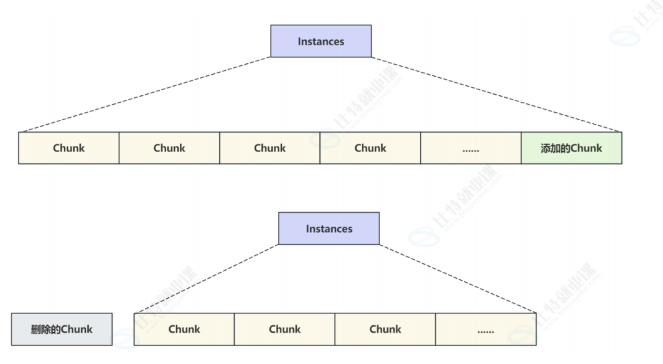
这就是 8.0 支持在线调整 innodb_buffer_pool_size 的底层原理。
四、三种页状态与三个链表
4.1 三种页状态
| Free | 未使用的空页帧 |
| Clean | 已缓存,但未被修改,与磁盘一致 |
| Dirty | 已被修改,内存与磁盘不一致,需要刷盘 |
4.2 三个链表(元素都是控制块)
| Free List | Free 状态的控制块 |
| LRU List | 已缓存的页(Clean + Dirty),分 young/old 两区 |
| Flush List | Dirty 页(待刷盘) |
4.3 一个控制块可以同时挂多个链表
一个脏页的控制块:
├── 在 LRU List 上(因为它已被缓存)
└── 在 Flush List 上(因为它是脏的,待刷盘)
一个干净页的控制块:
└── 只在 LRU List 上
一个空闲页的控制块:
└── 只在 Free List 上
这就是为什么控制块里需要多个独立的 list 指针,而不是一个前后指针。
4.4 页的生命周期流转(完整的页属性变换流程)
磁盘读入新页
│
▼
从 Free List 摘控制块 → 读页帧 → 挂入 LRU 的中点位置
│
├── 被修改 → 标记 Dirty → 挂入 Flush List
│ │
│ ▼
│ 后台线程异步刷盘 → 从 Flush List 摘下 → 恢复 Clean
│
└── Free 耗尽 → 淘汰 old 区尾部的页 → 该控制块被新页复用
五、改进 LRU:young / old 分区
5.1 为什么不用朴素 LRU
朴素 LRU:新页直接插头部,命中也移到头部。问题在于预读污染:
InnoDB 读到页 N,会按局部性原理预读 N+1、N+2、N+3…
这些页大概率不会马上被访问;
如果全部插 LRU 头部,会把真正热的页挤到尾部,反而被先淘汰。
5.2 InnoDB 的改进:midpoint 插入
LRU List 分两区:
LRU List(按从热到冷排列):
┌──────────────────────────┬──────────────────┐
│ young 区(约 5/8) │ old 区(约 3/8) │
│ 真正的热数据 │ 新读入/冷数据 │
└──────────────────────────┴──────────────────┘
头部 尾部
- 新读入的页 → 插到 old 区头部(midpoint,两区分界处);
- old 区页被再次访问(超过 innodb_old_blocks_time,默认 1s)→ 晋升到 young 区头部;
- 淘汰从 old 区尾部开始;
- young 区内部命中 → 移到 young 头部。
5.3 为什么新页插中点而不是头部
预读(Read-Ahead) 会批量带入相邻页(线性预读,innodb_read_ahead_threshold)。这些页是"顺手带进来的",短期不会被访问:
- 插头部 → 它们会在 LRU 里停留很久,占着热位置;
- 插 old 区 → 短期不被再次访问就直接从 old 尾部淘汰,不污染 young 热区。
innodb_old_blocks_time(默认 1000ms)就是为了防止"预读瞬间批量触碰 old 区页导致全部晋升"。
六、instance 并发与调优
6.1 多 instance 为什么提升并发
每个 instance 有独立的 mutex 和锁。多线程同时访问 Buffer Pool 时,只要访问不同 instance,就不抢同一把锁:
1 个 instance:所有线程抢同一把 LRU mutex → 瓶颈
8 个 instance:8 把锁,不同线程各管一摊 → 并发度 × N
6.2 instances 数量规则
| < 1GB | 强制为 1(不管配置) |
| > 1GB | 默认 8(官方建议每个 instance ≥ 1GB) |
调优口诀:总大小 / instances ≈ 1GB,不要为了多核盲目开多 instance。
6.3 动态调整
8.0 支持在线调整 innodb_buffer_pool_size,以 chunk 为单位增删,无需重启。
七、查看运行状态
SHOW ENGINE INNODB STATUS\\G
找到 BUFFER POOL AND MEMORY 段,关键指标:
| Buffer pool size | 总页数 |
| Free buffers | 空闲页数 |
| Database pages | LRU 中页数 |
| Old database pages | old 区页数 |
| Buffer pool hit rate | 命中率(关键!应接近 1000/1000) |
| Dirty pages | 脏页数 |


评论前必须登录!
注册