 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
文章目录
- 前言
- 零、论文基本信息
- 一、上下文压缩为什么值得单独做成模块
-
- 1. Full History 的成本不可持续
- 2. 简单截断丢失关键早期信息
- 3. Self-Summary 让昂贵 Agent 同时承担记忆维护
- 4. 任务耦合训练限制迁移
- 二、相关工作与论文定位
-
- 1. Input-Level Compression
- 2. Agent-Managed Compaction
- 3. Standalone Summarization
- 4. Reconstruction Self-Supervision
- 三、SUMONE 总览
- 四、模块一:定义需要压缩的历史
-
- 1. Expired History 与 Retained Context
- 2. 在线部署方式
- 五、模块二:Masked Reconstruction
-
- 1. 如何 Mask
- 2. Reconstructor
- 3. 为什么保留未遮盖历史
- 六、信息论解释
- 七、模块三:重构奖励
-
- 1. Precision 与 Recall
- 2. 长度惩罚
- 3. 与直接 Summary Judge 的区别
- 八、模块四:GRPO 优化
- 九、训练数据与实验协议
-
- 1. 训练数据
- 2. 下游 Agent
- 3. Benchmark
- 4. Baseline
- 5. Compression Ratio
- 十、主实验:DeepSearchQA
- 十一、主实验:SWE-bench Verified
- 十二、与 Self-Summary 的比较
- 十三、隔离记忆评测
- 十四、跨模型迁移
-
- 1. SWE-bench Verified
- 2. DeepSearchQA
- 十五、跨 Harness 迁移
- 十六、与下游 RL 结合
- 十七、训练目标消融
- 十八、Mask Ratio 与长度惩罚
-
- 1. Mask Ratio
- 2. Length Penalty
- 十九、效率与成本分析
-
- 1. 为什么成本下降不等于 Summary Cost
- 2. Cost Estimate 依赖表定价
- 3. 训练成本不可忽略
- 二十、失败模式与反例
-
- 1. Full History 仍然最好
- 2. Knowledge Update 不突出
- 3. 高压缩率可能掩盖任务差异
- 4. 重构可能偏向表面细节
- 5. Judge 与 Reconstructor 共同决定“什么算被保留”
- 二十一、与 Agent Memory 系列横向比较
- 二十二、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
-
- 1. Coding Agent:Memory Writer 可以独立于 Coding Model
- 2. Tool Agent:训练摘要器不一定需要真实执行任务
- 3. Multi-Agent:统一压缩协议降低角色耦合
- 4. 应对关键字段使用混合目标
- 5. 压缩器应像数据库组件一样独立评测
- 二十三、局限性与批判性分析
-
- 1. 训练领域集中
- 2. 训练仍依赖强模型
- 3. 缺少安全信息的类型化保护
- 4. 没有多轮压缩稳定性实验
- 5. 缺少摘要内容的定性失败分析
- 6. Cost 结论依赖价格假设
- 7. 论文存在数字叙述错误
- 8. 暂无公开代码
- 二十四、我的理解与启发
-
- 1. SUMONE 真正改变的是监督来源
- 2. “可重构”是比“像摘要”更好的基础目标
- 3. 可重构仍不等于可行动
- 4. 独立 Memory Model 是值得重视的系统形态
- 5. 最合理的未来方案可能是分层压缩
- 二十五、总结
- 参考资料
前言
长周期 Agent 都会遇到同一个工程问题:上下文会越跑越长。
搜索 Agent 需要保留前几轮找到的证据;Coding Agent 需要记住用户约束、已经修改的文件、失败测试和工具输出;Tool Agent 还要追踪哪些操作已经执行、哪些计划仍未完成。如果把全部历史原样送入模型,推理成本会持续增长,最终还会超过上下文窗口。
于是,Context Compaction 成为长期 Agent 的基础设施:把过期历史压缩成一段 Memory,再让 Agent 使用“旧历史摘要 + 最近交互”继续工作。
但压缩器应该怎样训练?
一种方案是用最终任务成功率训练:如果摘要后的 Agent 仍能完成任务,就奖励摘要器。问题是,这会把摘要器和具体任务、具体 Solver、具体 Harness 绑定在一起。另一种方案是准备人工参考摘要,但 Agent 轨迹长、工具输出复杂,很难获得规模化 Gold Summary。还可以让 LLM Judge 直接判断摘要质量,但“好摘要”是一个模糊目标,Judge 可能更偏好流畅而非真正可恢复的信息。
SUMONE 提出了一种更简单的训练信号:如果摘要真的保留了原轨迹的信息,那么在随机遮盖部分原历史后,另一个模型应该能够借助摘要把缺失内容恢复出来。
它将 Agent Memory 的训练从“摘要是否让下游任务成功”改写为“摘要是否保留足以重构原历史的信息”。这样,训练只需要原始轨迹,不需要参考摘要,也不需要运行下游 Agent。
这与我们前一篇讨论的 Compaction Cliff 形成了有意思的对照:Compaction Cliff 强调不同知识类型不能被统一压缩,尤其安全约束需要精确保留;SUMONE 则从更一般的角度学习一个高信息密度的独立摘要器。前者强调类型化安全保证,后者强调任务无关、低成本和可插拔迁移。
一句话核心增量:SUMONE 用“摘要能否帮助冻结模型重构被遮盖的原始 Agent 轨迹”作为自监督奖励,从而在不依赖参考摘要、下游任务结果或 Solver 行为的情况下,训练一个可跨任务、跨模型和跨 Harness 复用的独立上下文压缩器。
需要提前说明:SUMONE 的优势是简单、通用、便宜,而不是无损。主实验中,它把推理成本降低约 75%–78%,但 DeepSearchQA 和 SWE-bench Verified 的绝对性能都比 Full History 低 0.04。
零、论文基本信息
- 论文名称: SUMONE: A Simple and Efficient Summarizer for Plug-and-Play Agent Memory
- 发表平台: arXiv
- 代码仓库: 暂未公开;论文表示将在录用后发布代码与实现资源
- 作者: Jizhe Zhang、Ang Li、Chenheng Zhang、Yisen Wang
一、上下文压缩为什么值得单独做成模块
1. Full History 的成本不可持续
设 Agent 每一轮都把完整历史重新发送给模型。随着交互增长,第
t
t
t 轮的输入不只包含新观察,还包含前
t
−
1
t-1
t−1 轮所有内容。总 Token 消耗因此会近似二次增长。
在论文主实验中,Full History 平均每个 DeepSearchQA 查询累计消耗 2.83M 输入 Token;在 SWE-bench Verified 上达到 4.10M。即使模型上下文允许,成本也很难接受。
2. 简单截断丢失关键早期信息
Recency Truncation 在达到阈值后直接删除最旧内容。它成本低,却无法区分:
- 已经完成、可以概括的中间动作;
- 仍需保留的用户约束;
- 早期找到、最终回答仍依赖的证据;
- Coding Agent 已修改文件的原因和测试结果。
主实验中,Recent Truncation 在 DeepSearchQA 只有 0.16 F1,远低于 Full History 的 0.52;这说明“只保留最近内容”不能解决长期依赖。
3. Self-Summary 让昂贵 Agent 同时承担记忆维护
让下游 Agent 自己摘要历史很方便,但存在两个问题:
SUMONE 把 Memory Writing 从 Solver 中解耦:统一使用 2B 小模型写摘要,下游 Agent 保持不变。
4. 任务耦合训练限制迁移
HiAgent、FoldGRPO、CoMem 等方法可以根据下游任务行为学习压缩,但训练信号来自特定工作流、Agent 或任务奖励。换一个 Solver、Harness 或领域后,摘要策略可能需要重新训练。
SUMONE 的目标是一个类似“专用海马体”的模块:只负责把经历压成高信息密度文本,至于未来哪个 Agent 如何使用,由下游系统决定。
二、相关工作与论文定位
1. Input-Level Compression
LLMLingua、LLMLingua-2 等方法通过删除、选择或压缩输入 Token 降低上下文长度。它们处理的是原输入表面,而 SUMONE 生成一段新的文本记忆表示。
2. Agent-Managed Compaction
HiAgent 在任务流程中总结完成的子目标;FoldGRPO 和 AgentFold 让 Agent 学会压缩工具响应。这类方法更贴近行动决策,但需要修改 Agent 工作流,甚至把压缩动作纳入策略训练。
3. Standalone Summarization
RESUM、ACON、CoMem 等使用独立模型压缩交互历史,但学习或评测通常仍依赖下游行为。SUMONE 同样是独立摘要器,区别在于训练阶段完全不需要下游 Solver 执行任务。
4. Reconstruction Self-Supervision
BERT、BART、Denoising Autoencoder 和 Masked Autoencoder 都通过恢复缺失输入学习信息表示。SUMONE 把这一思想用于 Agent Memory:摘要本身不直接与参考文本对齐,而是通过能否恢复原轨迹接受评价。
三、SUMONE 总览
先看论文对它的产品定位:同一个 2B 摘要器,可以服务不同任务、模型与 Agent Harness。
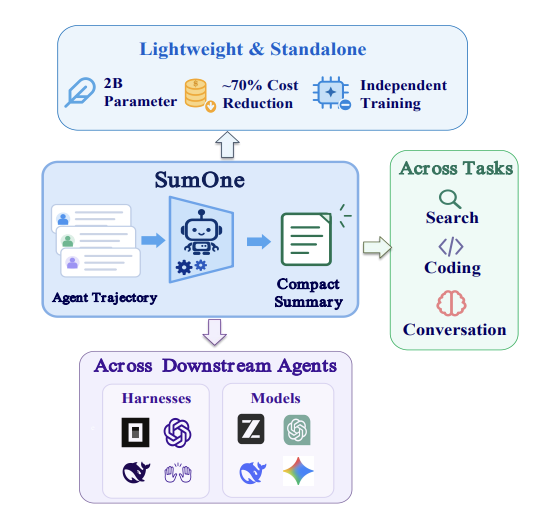
Figure 1(a):SUMONE 的可插拔定位。 2B 摘要模型只读取需要压缩的 Agent 历史并生成 Memory,下游 Agent 和 Harness 不需要参与训练,也不必修改核心求解逻辑。
论文进一步用 SWE-bench Verified 展示了性能—成本权衡。
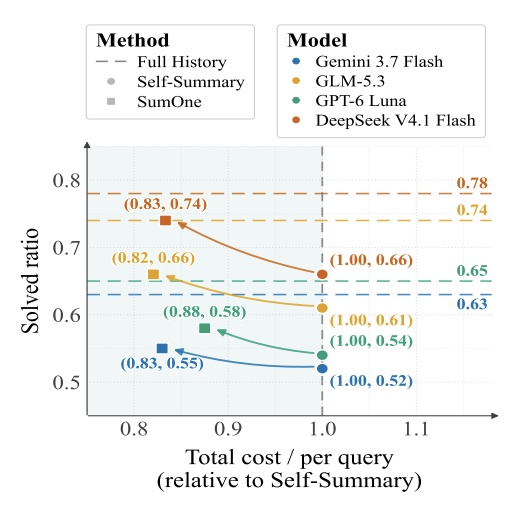
Figure 1(b):SWE-bench Verified 上的性能—成本权衡。 横轴是相对 Self-Summary 的归一化总成本,纵轴是 Resolved Rate;SUMONE 在多个下游模型上以更低成本取得更高表现。
完整方法包含训练期和推理期两个不同流程:
- 训练期: Summarizer 生成摘要,Reconstructor 恢复 Masked History,Judge 评分,GRPO 更新 Summarizer;
- 推理期: 删除 Reconstructor 与 Judge,只保留 2B Summarizer。
四、模块一:定义需要压缩的历史
1. Expired History 与 Retained Context
SUMONE 将当前上下文分成两部分:
-
H
H
H:需要被压缩的过期历史; -
C
C
C:保留不变的上下文,包括 System Instruction、任务描述、已有 Memory 和最近交互。
摘要器根据二者生成文本摘要:
S
∼
π
θ
(
⋅
∣
C
,
H
)
S\\sim\\pi_\\theta(\\cdot\\mid C,H)
S∼πθ(⋅∣C,H)
这里把
C
C
C 一并输入摘要器非常重要。相同历史在不同任务、系统约束和最近状态下,值得保留的信息可能不同。SUMONE 虽然使用任务无关训练信号,但摘要生成仍然能看到当前任务上下文。
2. 在线部署方式
当上下文达到 32K Compaction Threshold 时,系统将较旧的
H
H
H 替换成
S
S
S,Agent 继续使用
(
C
,
S
)
(C,S)
(C,S) 执行。之后若再次超过阈值,新一轮压缩可以同时处理已有 Memory 与新增历史。
五、模块二:Masked Reconstruction
下面这张图展示训练信号如何从原始轨迹自身产生。
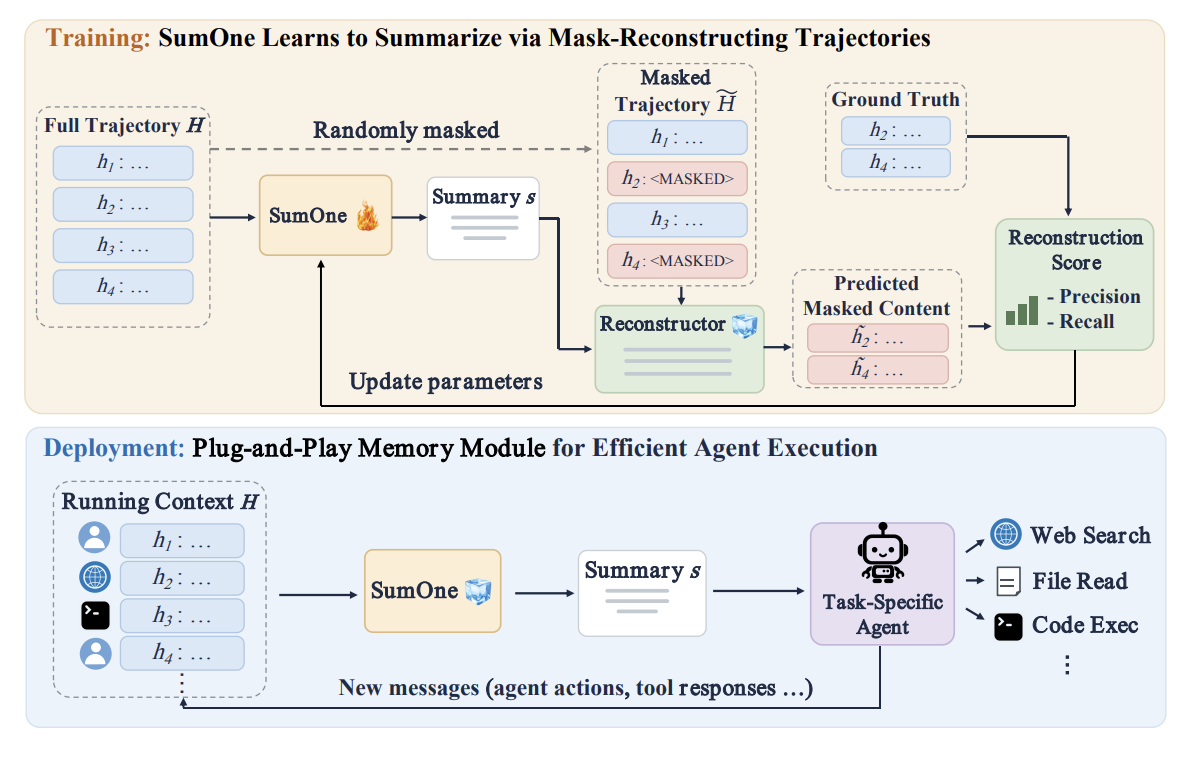
Figure 2:SUMONE 方法总览。 Summarizer 压缩 Expired History;系统随机遮盖原轨迹的一部分,由冻结 Reconstructor 结合摘要、可见历史和保留上下文恢复缺失块;重构质量减去长度惩罚后成为 GRPO Reward。
1. 如何 Mask
系统先把
H
H
H 划分成大小近似的块,优先沿自然交互边界切分,例如:
- 用户与 Assistant Role 切换;
- Tool Call 与 Tool Result 边界;
- 完整观察或操作步骤。
然后随机选择块集合
Ω
\\Omega
Ω,替换为 Missing-Span Marker:
H
~
=
Mask
(
H
;
Ω
)
\\widetilde{H}=\\operatorname{Mask}(H;\\Omega)
H
=Mask(H;Ω)
训练默认每块约 512 Token,遮盖 50%。
2. Reconstructor
冻结模型
D
D
D 根据摘要、剩余上下文和未遮盖历史预测缺失内容:
H
^
Ω
∼
p
D
(
⋅
∣
C
,
H
~
,
S
)
\\widehat{H}_\\Omega\\sim p_D(\\cdot\\mid C,\\widetilde{H},S)
H
Ω∼pD(⋅∣C,H
,S)
如果摘要保存了被遮盖的信息,恢复结果应该更接近 Ground Truth;如果摘要只是语言流畅却遗漏了事实、约束或工具结果,重构会失败。
3. 为什么保留未遮盖历史
Reconstructor 并不是只根据摘要从零恢复整条轨迹。它还看到
H
Ω
ˉ
H_{\\bar\\Omega}
HΩˉ,因此训练目标衡量的是摘要对可见上下文提供了多少额外信息。
这避免摘要浪费空间重复本来就在 Recent Context 中的信息,但也带来潜在边界:如果缺失内容能从相邻历史轻易推断,摘要可能不必显式保存它。
六、信息论解释
论文用条件互信息解释摘要的作用:
I
(
S
;
H
Ω
∣
H
Ω
ˉ
,
C
)
=
H
(
H
Ω
∣
H
Ω
ˉ
,
C
)
−
H
(
H
Ω
∣
S
,
H
Ω
ˉ
,
C
)
I(S;H_\\Omega\\mid H_{\\bar\\Omega},C)=\\mathcal{H}(H_\\Omega\\mid H_{\\bar\\Omega},C)-\\mathcal{H}(H_\\Omega\\mid S,H_{\\bar\\Omega},C)
I(S;HΩ∣HΩˉ,C)=H(HΩ∣HΩˉ,C)−H(HΩ∣S,HΩˉ,C)
第一项是不看摘要时,缺失历史的不确定性;第二项是加入摘要后的不确定性。因为第一项与 Summarizer 无关,所以更好的摘要应该让第二项更小。
SUMONE 并没有直接估计互信息,而是用语义重构质量作为代理。这一点必须区分清楚:论文提供的是信息论直觉,不是严格互信息优化器。
七、模块三:重构奖励
1. Precision 与 Recall
LLM Judge 对每个被遮盖块的恢复结果打两个分:
- Precision: 预测内容中有多少得到原文支持,惩罚编造;
- Recall: 原文的重要内容有多少被恢复,惩罚遗漏。
若第
i
i
i 个块的 Recall 和 Precision 分别为
r
i
r_i
ri、
p
i
p_i
pi,整体重构质量为:
Q
(
S
)
=
1
∣
Ω
∣
∑
i
∈
Ω
(
r
i
+
p
i
)
Q(S)=\\frac{1}{|\\Omega|}\\sum_{i\\in\\Omega}(r_i+p_i)
Q(S)=∣Ω∣1i∈Ω∑(ri+pi)
论文没有在公式中除以 2,因此
Q
(
S
)
Q(S)
Q(S) 的数值范围取决于 Judge 分数标度,并不必然是
[
0
,
1
]
[0,1]
[0,1]。
2. 长度惩罚
只优化重构质量,模型最安全的策略是把原历史尽量抄进摘要。为阻止退化复制,最终 Reward 加入长度项:
R
(
S
)
=
Q
(
S
)
−
λ
∣
S
∣
L
max
R(S)=Q(S)-\\lambda\\frac{|S|}{L_{\\max}}
R(S)=Q(S)−λLmax∣S∣
∣
S
∣
|S|
∣S∣ 是摘要长度,
L
max
L_{\\max}
Lmax 是最大输出预算,
λ
\\lambda
λ 控制压缩与保真的权衡。
这个目标很直观:摘要保存的信息越多,重构得分越高;摘要越长,代价越大。
3. 与直接 Summary Judge 的区别
Direct Judge Reward 直接问 LLM“这是不是一个好摘要”,评价标准宽泛且容易偏向文风。Reconstruction Reward 给 Judge 一个更具体任务:比较被恢复内容与真实 Masked Block,判断是否遗漏或编造。
它仍依赖 LLM Judge,但 Judge 的工作从主观摘要评价变成有 Ground Truth 的语义对齐。
八、模块四:GRPO 优化
对每个上下文,摘要器采样
G
G
G 个候选
S
k
S_k
Sk。根据组内 Reward 计算标准化 Advantage:
A
k
=
R
(
S
k
)
−
μ
R
σ
R
+
ϵ
A_k=\\frac{R(S_k)-\\mu_R}{\\sigma_R+\\epsilon}
Ak=σR+ϵR(Sk)−μR
μ
R
\\mu_R
μR、
σ
R
\\sigma_R
σR 是同组候选奖励的均值与标准差。随后使用标准 GRPO 更新 Summarizer,Reconstructor 始终冻结。
训练配置如下:
配置
值
Base Model
Qwen3.5-2B
Reconstructor
Qwen3.5-9B
Judge
DeepSeek V4.1 Flash
训练框架
veRL
硬件
8
×
H20-141G
训练步数
600
Prompts/Step
6
Samples/Prompt
8
Rollouts/Step
48
Learning Rate
10
−
6
\\begin{array}{c|c}\\textbf{配置}&\\textbf{值}\\\\\\hline\\text{Base Model}&\\text{Qwen3.5-2B}\\\\\\text{Reconstructor}&\\text{Qwen3.5-9B}\\\\\\text{Judge}&\\text{DeepSeek V4.1 Flash}\\\\\\text{训练框架}&\\text{veRL}\\\\\\text{硬件}&8\\times\\text{H20-141G}\\\\\\text{训练步数}&600\\\\\\text{Prompts/Step}&6\\\\\\text{Samples/Prompt}&8\\\\\\text{Rollouts/Step}&48\\\\\\text{Learning Rate}&10^{-6}\\end{array}
配置Base ModelReconstructorJudge训练框架硬件训练步数Prompts/StepSamples/PromptRollouts/StepLearning Rate值Qwen3.5-2BQwen3.5-9BDeepSeek V4.1 FlashveRL8×H20-141G600684810−6
Table 6:SUMONE 训练配置。 训练依赖 9B Reconstructor、LLM Judge 与 8 张 H20;部署时只保留 2B Summarizer。
九、训练数据与实验协议
1. 训练数据
训练集约包含 5K 个压缩实例,来自:
- OpenSeeker-v1-Data 的 Web Search 轨迹;
- SWE-smith 的 Software Engineering 轨迹。
数据大致平衡,并在 16K 与 32K 两种上下文长度上构造 Compaction Instance。
2. 下游 Agent
默认使用 Qwen3.5-35B-A3B 和 OpenCode。Harness 自带压缩被关闭,所有压缩方法统一使用 32K Threshold;Full History 则一直保留到模型约 256K 原生上下文上限。
3. Benchmark
- DeepSearchQA: 长链搜索任务,报告 F1;
- SWE-bench Verified: 真实 GitHub Issue 修复,报告 Resolved Rate;
- LongMemEval-S: 直接评测长期记忆能力。
4. Baseline
- Full History;
- Recent Truncation;
- Self-Summary;
- Prompt-2B;
- CoMem。
Prompt-2B 与 SUMONE 使用相同 Qwen3.5-2B 初始化和 Prompt,但没有重构训练,用于隔离训练目标本身的贡献。
5. Compression Ratio
C
R
=
1
−
∑
e
∣
S
e
∣
∑
e
∣
H
e
∣
\\mathrm{CR}=1-\\frac{\\sum_e|S_e|}{\\sum_e|H_e|}
CR=1−∑e∣He∣∑e∣Se∣
e
e
e 是压缩事件,
H
e
H_e
He 是被替换历史,
S
e
S_e
Se 是摘要。CR 越高说明压缩越激进。
十、主实验:DeepSearchQA
方法
F1
CR
Input
Tokens
Summary
Cost
Total
Cost
Comp./Q
Full History
0.52
−
2.83
M
−
$
0.170
−
Recent Truncation
0.16
−
752
K
−
$
0.047
1.24
Self-Summary
0.44
91
%
652
K
$
0.002
$
0.044
1.68
Prompt-2B
0.29
92
%
468
K
$
0.001
$
0.031
1.24
CoMem
0.32
88
%
577
K
$
0.001
$
0.036
1.48
SUMONE
0.48
90
%
591
K
$
0.001
$
0.038
1.57
\\begin{array}{c|c|c|c|c|c|c}\\textbf{方法}&\\textbf{F1}&\\textbf{CR}&\\textbf{Input Tokens}&\\textbf{Summary Cost}&\\textbf{Total Cost}&\\textbf{Comp./Q}\\\\\\hline\\text{Full History}&0.52&-&2.83M&-&\\$0.170&-\\\\\\text{Recent Truncation}&0.16&-&752K&-&\\$0.047&1.24\\\\\\text{Self-Summary}&0.44&91\\%&652K&\\$0.002&\\$0.044&1.68\\\\\\text{Prompt-2B}&0.29&92\\%&468K&\\$0.001&\\$0.031&1.24\\\\\\text{CoMem}&0.32&88\\%&577K&\\$0.001&\\$0.036&1.48\\\\\\textbf{SUMONE}&\\mathbf{0.48}&90\\%&591K&\\$0.001&\\$0.038&1.57\\end{array}
方法Full HistoryRecent TruncationSelf-SummaryPrompt-2BCoMemSUMONEF10.520.160.440.290.320.48CR−−91%92%88%90%Input Tokens2.83M752K652K468K577K591KSummary Cost−−$0.002$0.001$0.001$0.001Total Cost$0.170$0.047$0.044$0.031$0.036$0.038Comp./Q−1.241.681.241.481.57
Table 1:DeepSearchQA 主结果。 SUMONE 在压缩方法中取得最高 0.48 F1,距 Full History 仅 0.04;累计输入从 2.83M 降至 591K,总成本从 $0.170 降至 $0.038。
按表中数字计算:
1
−
0.038
0.170
=
77.6
%
1-\\frac{0.038}{0.170}=77.6\\%
1−0.1700.038=77.6%
即成本下降约 78%,同时 F1 下降 0.04。
Prompt-2B 输入 Token 更少、成本更低,但 F1 只有 0.29。说明轻量模型本身并不足够,重构训练让摘要保留了更可用的信息。
十一、主实验:SWE-bench Verified
方法
Resolved
CR
Input
Tokens
Summary
Cost
Total
Cost
Comp./Q
Full History
0.63
−
4.10
M
−
$
0.286
−
Recent Truncation
0.46
−
1.27
M
−
$
0.097
2.1
Self-Summary
0.56
74
%
1.05
M
$
0.013
$
0.082
2.7
Prompt-2B
0.51
77
%
0.98
M
$
0.001
$
0.073
2.1
CoMem
0.57
72
%
0.97
M
$
0.001
$
0.065
2.5
SUMONE
0.59
69
%
1.09
M
$
0.001
$
0.071
2.5
\\begin{array}{c|c|c|c|c|c|c}\\textbf{方法}&\\textbf{Resolved}&\\textbf{CR}&\\textbf{Input Tokens}&\\textbf{Summary Cost}&\\textbf{Total Cost}&\\textbf{Comp./Q}\\\\\\hline\\text{Full History}&0.63&-&4.10M&-&\\$0.286&-\\\\\\text{Recent Truncation}&0.46&-&1.27M&-&\\$0.097&2.1\\\\\\text{Self-Summary}&0.56&74\\%&1.05M&\\$0.013&\\$0.082&2.7\\\\\\text{Prompt-2B}&0.51&77\\%&0.98M&\\$0.001&\\$0.073&2.1\\\\\\text{CoMem}&0.57&72\\%&0.97M&\\$0.001&\\$0.065&2.5\\\\\\textbf{SUMONE}&\\mathbf{0.59}&69\\%&1.09M&\\$0.001&\\$0.071&2.5\\end{array}
方法Full HistoryRecent TruncationSelf-SummaryPrompt-2BCoMemSUMONEResolved0.630.460.560.510.570.59CR−−74%77%72%69%Input Tokens4.10M1.27M1.05M0.98M0.97M1.09MSummary Cost−−$0.013$0.001$0.001$0.001Total Cost$0.286$0.097$0.082$0.073$0.065$0.071Comp./Q−2.12.72.12.52.5
Table 1(续):SWE-bench Verified 主结果。 SUMONE 达到 0.59 Resolved Rate,低于 Full History 的 0.63、高于其他摘要方法;输入从 4.10M 降至 1.09M,总成本从 $0.286 降至 $0.071。
按主表计算:
1
−
0.071
0.286
=
75.2
%
1-\\frac{0.071}{0.286}=75.2\\%
1−0.2860.071=75.2%
即成本下降约 75%,Resolved Rate 下降 0.04。
这里存在论文内部不一致:摘要、引言和 Table 1 都支持“成本下降约 75%”;实验正文却写成 SUMONE “使用 Full History 的 58% 成本”。根据 $0.071 与 $0.286,该比例应是 24.8%,因此正文的 58% 应视为文本错误。
SUMONE 的 CR 只有 69%,低于 Self-Summary 的 74%、Prompt-2B 的 77% 和 CoMem 的 72%,但任务表现更高。这说明压缩率不是越高越好:SWE 修复任务需要保留文件修改、测试与错误细节,过度压缩会直接损害解题。
十二、与 Self-Summary 的比较
在 DeepSearchQA 上:
- F1:0.44 → 0.48;
- Summary Cost:$0.002 → $0.001;
- Total Cost:$0.044 → $0.038。
在 SWE-bench 上:
- Resolved:0.56 → 0.59;
- Summary Cost:$0.013 → $0.001;
- Total Cost:$0.082 → $0.071。
SUMONE 的核心工程价值不是比 Full History 更准确,而是用小模型替代昂贵下游模型执行 Memory Writing,同时减少摘要中的信息损失。
十三、隔离记忆评测
方法
Overall
Single
Multi
Temporal
Update
Sum.Cost
CR
Oracle
0.85
0.94
0.72
0.80
0.93
−
−
Full History
0.77
0.81
0.50
0.80
0.86
−
−
Prompt-2B
0.43
0.38
0.51
0.38
0.24
0.003
94
%
CoMem
0.31
0.41
0.08
0.24
0.61
0.003
93
%
SUMONE
0.47
0.48
0.41
0.36
0.43
0.003
89
%
\\begin{array}{c|c|c|c|c|c|c|c}\\textbf{方法}&\\textbf{Overall}&\\textbf{Single}&\\textbf{Multi}&\\textbf{Temporal}&\\textbf{Update}&\\textbf{Sum.Cost}&\\textbf{CR}\\\\\\hline\\text{Oracle}&0.85&0.94&0.72&0.80&0.93&-&-\\\\\\text{Full History}&0.77&0.81&0.50&0.80&0.86&-&-\\\\\\text{Prompt-2B}&0.43&0.38&\\mathbf{0.51}&\\mathbf{0.38}&0.24&0.003&94\\%\\\\\\text{CoMem}&0.31&0.41&0.08&0.24&\\mathbf{0.61}&0.003&93\\%\\\\\\textbf{SUMONE}&\\mathbf{0.47}&\\mathbf{0.48}&0.41&0.36&0.43&0.003&89\\%\\end{array}
方法OracleFull HistoryPrompt-2BCoMemSUMONEOverall0.850.770.430.310.47Single0.940.810.380.410.48Multi0.720.500.510.080.41Temporal0.800.800.380.240.36Update0.930.860.240.610.43Sum.Cost−−0.0030.0030.003CR−−94%93%89%
Table 4:LongMemEval-S 隔离记忆评测。 SUMONE 在压缩方法中 Overall 最高且各类别更均衡,但并非每个子项最优:Prompt-2B 在 Multi 与 Temporal 上更高,CoMem 在 Update 上明显更高。
这张表支持“任务无关信息保留更均衡”,但也展示了方法边界。CoMem 面向下游行为学习,在 Knowledge Update 上达到 0.61;SUMONE 只有 0.43。Masked Reconstruction 倾向保存一般可恢复信息,并不特别优化新旧事实冲突和更新逻辑。
十四、跨模型迁移
同一个 SUMONE Checkpoint 被直接用于四个下游模型,没有额外微调。
1. SWE-bench Verified
KaTeX parse error: Undefined control sequence: \\multicolumn at position 41: …|c}\\textbf{模型}&\\̲m̲u̲l̲t̲i̲c̲o̲l̲u̲m̲n̲{2}{c|}{\\textbf…
Table 7:SWE-bench Verified 跨模型迁移。 SUMONE 在四个 Solver 上都高于 Self-Summary、成本更低,但仍低于对应 Full History。
2. DeepSearchQA
KaTeX parse error: Undefined control sequence: \\multicolumn at position 41: …|c}\\textbf{模型}&\\̲m̲u̲l̲t̲i̲c̲o̲l̲u̲m̲n̲{2}{c|}{\\textbf…
Table 8:DeepSearchQA 跨模型迁移。 SUMONE 在 Gemini 与 GPT-6 Luna 上甚至超过 Full History,但在 GLM 和 DeepSeek 上仍低于 Full History;相对 Self-Summary 则四个模型均有提升。
这说明“接近 Full History”比“始终不损失性能”更准确。部分压缩结果超过 Full History,可能来自去除噪声与中间冗余;但这种增益不跨模型稳定。
十五、跨 Harness 迁移
Harness
Full
History
Self-Summary
SUMONE
OpenCode
0.52
0.44
0.48
OpenHands
0.49
0.39
0.46
Codex
0.55
0.47
0.47
DeepSeek Harness
0.50
0.41
0.42
\\begin{array}{c|c|c|c}\\textbf{Harness}&\\textbf{Full History}&\\textbf{Self-Summary}&\\textbf{SUMONE}\\\\\\hline\\text{OpenCode}&0.52&0.44&\\mathbf{0.48}\\\\\\text{OpenHands}&0.49&0.39&\\mathbf{0.46}\\\\\\text{Codex}&0.55&0.47&\\mathbf{0.47}\\\\\\text{DeepSeek Harness}&0.50&0.41&\\mathbf{0.42}\\end{array}
HarnessOpenCodeOpenHandsCodexDeepSeek HarnessFull History0.520.490.550.50Self-Summary0.440.390.470.41SUMONE0.480.460.470.42
Table 3:使用 Qwen3.5-35B 的跨 Harness 结果。 SUMONE 在 OpenCode、OpenHands 和 DeepSeek Harness 上高于 Self-Summary;在 Codex 上与 Self-Summary 持平,而非严格领先。
论文正文写“在每个 Harness 中 consistently outperforming Self-Summary”,但 Codex 两者都为 0.47。更准确的结论是:SUMONE 在三个 Harness 上更好、一个持平,且都低于 Full History。
十六、与下游 RL 结合
方法
DSQA
DSQA
Cost
SWE
SWE
Cost
Full History w/o RL
0.52
0.170
0.63
0.286
Self-Summary
0.57
0.052
0.65
0.091
Prompt-2B
0.41
0.028
0.58
0.083
CoMem
0.48
0.035
0.60
0.072
SUMONE
0.55
0.039
0.68
0.077
\\begin{array}{c|c|c|c|c}\\textbf{方法}&\\textbf{DSQA}&\\textbf{DSQA Cost}&\\textbf{SWE}&\\textbf{SWE Cost}\\\\\\hline\\text{Full History w/o RL}&0.52&0.170&0.63&0.286\\\\\\text{Self-Summary}&\\mathbf{0.57}&0.052&0.65&0.091\\\\\\text{Prompt-2B}&0.41&\\mathbf{0.028}&0.58&0.083\\\\\\text{CoMem}&0.48&0.035&0.60&\\mathbf{0.072}\\\\\\textbf{SUMONE}&0.55&0.039&\\mathbf{0.68}&0.077\\end{array}
方法Full History w/o RLSelf-SummaryPrompt-2BCoMemSUMONEDSQA0.520.570.410.480.55DSQA Cost0.1700.0520.0280.0350.039SWE0.630.650.580.600.68SWE Cost0.2860.0910.0830.0720.077
Table 2:任务特定 RL Agent 的结果。 与下游 RL 结合后,SUMONE 在 SWE-bench 达到最高 0.68;DeepSearchQA 为 0.55,略低于 Self-Summary 的 0.57,但成本更低。
这说明 SUMONE 不只适合推理期压缩,也可以作为 Agent RL 的固定内存模块。不过 RL 训练细节与不同方法的完全等价性需要结合原基线实现理解。
十七、训练目标消融
方法
DSQA
SWE
LongMem
Overall
Single
Multi
Temporal
Update
Full History
0.52
0.63
0.77
0.81
0.50
0.80
0.86
Prompt-2B
0.29
0.51
0.43
0.38
0.51
0.38
0.24
Summary-Judge-RL
0.41
0.54
0.36
0.40
0.14
0.31
0.71
Reconstruction-RL
0.48
0.59
0.47
0.48
0.41
0.36
0.43
\\begin{array}{c|c|c|c|c|c|c|c}\\textbf{方法}&\\textbf{DSQA}&\\textbf{SWE}&\\textbf{LongMem Overall}&\\textbf{Single}&\\textbf{Multi}&\\textbf{Temporal}&\\textbf{Update}\\\\\\hline\\text{Full History}&0.52&0.63&0.77&0.81&0.50&0.80&0.86\\\\\\text{Prompt-2B}&0.29&0.51&0.43&0.38&\\mathbf{0.51}&\\mathbf{0.38}&0.24\\\\\\text{Summary-Judge-RL}&0.41&0.54&0.36&0.40&0.14&0.31&\\mathbf{0.71}\\\\\\textbf{Reconstruction-RL}&\\mathbf{0.48}&\\mathbf{0.59}&\\mathbf{0.47}&\\mathbf{0.48}&0.41&0.36&0.43\\end{array}
方法Full HistoryPrompt-2BSummary-Judge-RLReconstruction-RLDSQA0.520.290.410.48SWE0.630.510.540.59LongMem Overall0.770.430.360.47Single0.810.380.400.48Multi0.500.510.140.41Temporal0.800.380.310.36Update0.860.240.710.43
Table 5:训练 Reward 消融。 在相同 2B 初始化、训练数据、优化预算和长度正则下,Reconstruction Reward 在两个下游任务和 LongMemEval Overall 上都最好。
Direct Summary Judge 在 Update 上达到 0.71,但 Multi 只有 0.14,表现非常偏科。Reconstruction-RL 更均衡,这支持作者关于“显式测试信息能否恢复,比全局主观评价更稳定”的解释。
十八、Mask Ratio 与长度惩罚
1. Mask Ratio
Mask
Ratio
25
%
50
%
75
%
DeepSearchQA
0.41
0.48
0.29
LongMemEval-S
0.35
0.47
0.20
\\begin{array}{c|c|c|c}\\textbf{Mask Ratio}&25\\%&50\\%&75\\%\\\\\\hline\\text{DeepSearchQA}&0.41&\\mathbf{0.48}&0.29\\\\\\text{LongMemEval-S}&0.35&\\mathbf{0.47}&0.20\\end{array}
Mask RatioDeepSearchQALongMemEval-S25%0.410.3550%0.480.4775%0.290.20
Table 5(a):Mask Ratio 消融。 50% Mask 在两个任务上最好;25% 过于简单,75% 又使重构难度过高。
论文解释很合理:Mask 太少时,Reconstructor 可以主要依赖未遮盖历史,摘要提供的增量信息很弱;Mask 太多时,任务接近从短摘要恢复大半条轨迹,Judge 信号噪声增加。
正文在这一段写“LongMemEval-S 达到 7%”,但表格明确是 0.47,即 47%,应视为排版遗漏了数字 4。
2. Length Penalty
λ
0.01
0.1
0.2
0.5
DeepSearchQA
0.47
0.48
0.45
0.37
LongMemEval-S
0.41
0.47
0.38
0.30
\\begin{array}{c|c|c|c|c}\\lambda&0.01&0.1&0.2&0.5\\\\\\hline\\text{DeepSearchQA}&0.47&\\mathbf{0.48}&0.45&0.37\\\\\\text{LongMemEval-S}&0.41&\\mathbf{0.47}&0.38&0.30\\end{array}
λDeepSearchQALongMemEval-S0.010.470.410.10.480.470.20.450.380.50.370.30
Table 5(b):长度惩罚消融。
λ
=
0.1
\\lambda=0.1
λ=0.1 最优;惩罚过弱导致摘要过长,惩罚过强则过度删除信息。
该结果说明 Reward 不是单纯最大化重构率。一个复制大部分历史的摘要可能重构很好,却失去压缩价值;过强长度惩罚则退化成激进截断。
十九、效率与成本分析
1. 为什么成本下降不等于 Summary Cost
SUMONE 本身每次摘要成本约 $0.001,但主要节省来自后续每轮 Agent 输入变短。长期任务中,同一段旧历史原本会被重复送给下游模型,压缩后每一轮都能减少 Token。
2. Cost Estimate 依赖表定价
论文使用标准 API List Price,不考虑:
- Cache Hit Discount;
- Batch Discount;
- Promotional Pricing;
- 企业合同价格。
因此 $0.038、$0.071 是统一口径的估算,不是实际账单。对于大量使用 Prompt Cache 的 Agent,Full History 与压缩方案的真实差距可能变化。
3. 训练成本不可忽略
训练使用 8 张 H20、600 Steps,每步 48 个摘要 Rollout,还要调用冻结 9B Reconstructor 和 DeepSeek Judge。论文没有报告总 GPU Hours、Judge API Cost 或训练能耗。
“轻量”主要描述部署期 2B 模型,而非训练过程。
二十、失败模式与反例
1. Full History 仍然最好
默认主实验中,SUMONE 在 DeepSearchQA 和 SWE-bench 都比 Full History 低 0.04。它实现的是高性价比近似,而不是无损替代。
2. Knowledge Update 不突出
LongMemEval-S Update 上,SUMONE 为 0.43,低于 CoMem 的 0.61 和 Summary-Judge-RL 的 0.71。一般重构目标没有显式建模新旧事实冲突、时间有效性和覆盖关系。
3. 高压缩率可能掩盖任务差异
DeepSearchQA 的 90% CR 可行,但 SWE-bench 最优方案只达到 69%。软件工程轨迹中的代码 Diff、错误日志和测试输出具有高信息密度,不能与搜索中间步骤使用相同压缩强度。
4. 重构可能偏向表面细节
能帮助恢复原文本的信息未必都是未来任务真正需要的信息。例如工具输出中的名称、数字或重复措辞可能有助于重构,却对最终任务无关;反过来,一个极短安全规则对未来行为很重要,但随机 Mask 未必经常覆盖或充分加权它。
5. Judge 与 Reconstructor 共同决定“什么算被保留”
如果 Reconstructor 依靠自身世界知识猜中缺失内容,摘要可能获得不应有的高分;如果 Reconstructor 不擅长代码或专业工具输出,即使摘要保存了关键线索,也可能恢复失败。LLM Judge 的语义偏好还会进一步影响 Reward。
二十一、与 Agent Memory 系列横向比较
方法
核心问题
训练/更新信号
与
SUMONE
的区别
HiAgent
长任务中的子目标历史压缩
工作流结构
与特定 Agent 流程耦合
A-MEM
动态记忆组织与关联
LLM 自主链接
外部记忆框架更完整,但接口更复杂
MAGMA
多图多粒度记忆
结构化更新
强调组织与检索,不是独立摘要器
CoMem
学习紧凑任务记忆
下游 Agent 行为
更任务导向,SUMONE 更通用
Compaction Cliff
安全规则在压缩中丢失
类型化零失真约束
提供安全保证;SUMONE 优化平均可恢复信息
MDSKILL
将 Skill Memory 内化到策略
RL+多视角蒸馏
改变参数能力;SUMONE 只维护外部上下文
SUMONE
通用低成本 Context Compaction
Masked Reconstruction Reward
最小化与任务、Solver、Harness 的耦合
\\begin{array}{c|c|c|c}\\textbf{方法}&\\textbf{核心问题}&\\textbf{训练/更新信号}&\\textbf{与 SUMONE 的区别}\\\\\\hline\\text{HiAgent}&\\text{长任务中的子目标历史压缩}&\\text{工作流结构}&\\text{与特定 Agent 流程耦合}\\\\\\text{A-MEM}&\\text{动态记忆组织与关联}&\\text{LLM 自主链接}&\\text{外部记忆框架更完整,但接口更复杂}\\\\\\text{MAGMA}&\\text{多图多粒度记忆}&\\text{结构化更新}&\\text{强调组织与检索,不是独立摘要器}\\\\\\text{CoMem}&\\text{学习紧凑任务记忆}&\\text{下游 Agent 行为}&\\text{更任务导向,SUMONE 更通用}\\\\\\text{Compaction Cliff}&\\text{安全规则在压缩中丢失}&\\text{类型化零失真约束}&\\text{提供安全保证;SUMONE 优化平均可恢复信息}\\\\\\text{MDSKILL}&\\text{将 Skill Memory 内化到策略}&\\text{RL+多视角蒸馏}&\\text{改变参数能力;SUMONE 只维护外部上下文}\\\\\\textbf{SUMONE}&\\text{通用低成本 Context Compaction}&\\text{Masked Reconstruction Reward}&\\text{最小化与任务、Solver、Harness 的耦合}\\end{array}
方法HiAgentA-MEMMAGMACoMemCompaction CliffMDSKILLSUMONE核心问题长任务中的子目标历史压缩动态记忆组织与关联多图多粒度记忆学习紧凑任务记忆安全规则在压缩中丢失将 Skill Memory 内化到策略通用低成本 Context Compaction训练/更新信号工作流结构LLM 自主链接结构化更新下游 Agent 行为类型化零失真约束RL+多视角蒸馏Masked Reconstruction Reward与 SUMONE 的区别与特定 Agent 流程耦合外部记忆框架更完整,但接口更复杂强调组织与检索,不是独立摘要器更任务导向,SUMONE 更通用提供安全保证;SUMONE 优化平均可恢复信息改变参数能力;SUMONE 只维护外部上下文最小化与任务、Solver、Harness 的耦合
横向比较(本文整理):SUMONE 与代表性 Agent Memory 方法。 SUMONE 只解决“如何把过期交互写成紧凑文本记忆”这一环节,换取了简单与可插拔;它不提供检索、记忆图、类型治理或参数内化。
二十二、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
1. Coding Agent:Memory Writer 可以独立于 Coding Model
昂贵 Coding Model 不必自己执行每次压缩。可以用小型专用模型把旧工具调用、文件修改和测试结果写成 Memory,让不同 Coding Agent 共享同一个 Context Compressor。
2. Tool Agent:训练摘要器不一定需要真实执行任务
许多工具任务缺少可靠最终 Reward,或执行成本很高。Masked Reconstruction 可以仅利用历史日志训练 Memory Writer,避免重复调用外部系统。
3. Multi-Agent:统一压缩协议降低角色耦合
多个 Agent 可以使用同一 Summarizer 把各自历史压成标准文本,再交给其他角色。相比让每个 Agent 自己总结,统一模块更容易评测、替换和控制成本。
4. 应对关键字段使用混合目标
工程上不应只使用平均重构奖励。用户约束、权限、安全规则、文件路径和失败测试可以增加结构化字段或类型权重;普通工具噪声继续使用重构目标。这样可以结合 SUMONE 的通用性与 Knowledge Triage 的安全性。
5. 压缩器应像数据库组件一样独立评测
除了最终任务成功率,还应分别测:
- 事实召回;
- 时间更新;
- 约束精确保留;
- 编造率;
- 跨模型可读性;
- 多轮重复压缩后的退化。
二十三、局限性与批判性分析
1. 训练领域集中
5K 训练实例主要来自 Web Search 和 Software Engineering。医疗、法律、客服、机器人和多模态 Agent 对 Memory 的需求不同,当前结论不能直接外推。
2. 训练仍依赖强模型
虽然不需要下游 Solver,训练仍依赖 Qwen3.5-9B Reconstructor 和 DeepSeek V4.1 Flash Judge。Reward 质量由这两个模型共同决定,并非完全模型无关。
3. 缺少安全信息的类型化保护
所有 Masked Block 使用同一 Precision/Recall 评价。一条安全约束和一段普通日志没有不同权重。结合 Compaction Cliff 的结论,SUMONE 不应被视为高风险 Agent 的完整安全方案。
4. 没有多轮压缩稳定性实验
真实 Agent 会反复把“旧摘要 + 新历史”再次压缩。论文报告平均 Compaction 次数约 1–2.7,但没有像 Compaction Cliff 那样单独追踪同一事实经过五轮、十轮后是否逐步失真。
5. 缺少摘要内容的定性失败分析
论文主要报告分数和成本,没有系统展示哪些信息最常丢失、哪些内容容易被编造、代码任务和搜索任务的错误类型是否不同。
6. Cost 结论依赖价格假设
成本使用公开 List Price,并忽略 Cache Discount。实际部署中,如果 Full History 的重复前缀大量命中缓存,75%–78% 的货币成本降幅可能无法原样复现。
7. 论文存在数字叙述错误
实验正文的 SWE 成本比例“58%”与主表不符;Mask Ratio 分析把 LongMemEval-S 0.47 写成 7%。这两处不改变表格支持的主趋势,但提醒读者应以正式表格数字为准。
8. 暂无公开代码
论文只承诺录用后发布,当前无法核验 Prompt、Mask 采样、Judge Rubric、GRPO Reward 实现和成本统计脚本。
二十四、我的理解与启发
1. SUMONE 真正改变的是监督来源
它没有提出复杂 Memory Architecture,核心是把摘要质量转换成一个可从原数据自动生成的任务。只要有 Agent Trajectory,就能构造 Mask 与 Ground Truth,从而训练专用 Memory Writer。
这是它比任务特定方法更容易扩展的根本原因。
2. “可重构”是比“像摘要”更好的基础目标
直接 Judge 容易奖励语言简洁、结构清晰和读起来合理的文本,却不一定知道 Agent 未来会需要什么。重构至少要求摘要对原始信息承担责任:如果关键内容完全没有留下痕迹,就无法帮助恢复。
3. 可重构仍不等于可行动
一个摘要可以保留大量事实,却没有保留动作前提、因果关系或安全优先级。未来更完整的目标应该同时包含:
- Reconstruction:是否保留信息;
- Action Sufficiency:是否足以继续任务;
- Constraint Fidelity:关键规则是否零失真;
- Temporal Consistency:新旧状态是否正确更新。
4. 独立 Memory Model 是值得重视的系统形态
Agent 系统越来越像由多个模型组成的计算机:大模型负责推理,小模型负责检索、路由、验证、压缩和安全检查。SUMONE 说明 Memory Writing 也可以成为独立模型服务,而不必永远消耗主模型能力。
5. 最合理的未来方案可能是分层压缩
我的理解是,SUMONE 最适合压缩普通交互历史;安全约束、用户持久偏好、权限和结构化任务状态则应进入单独的高保真通道。再配合外部检索与重复压缩审计,才能构成生产级 Agent Memory。
二十五、总结
SUMONE 提出了一种简单的独立 Agent Memory Summarizer。它不使用人工参考摘要,也不依赖下游 Agent 的任务成功率,而是随机遮盖原始交互历史,让冻结 Reconstructor 借助摘要恢复缺失内容,再用重构 Precision、Recall 和长度惩罚构造 GRPO Reward。
训练完成后,Reconstructor 和 Judge 都被移除,只保留 2B Summarizer。默认实验中,SUMONE 在 DeepSearchQA 将成本从 $0.170 降至 $0.038、F1 从 0.52 降至 0.48;在 SWE-bench Verified 将成本从 $0.286 降至 $0.071、Resolved Rate 从 0.63 降至 0.59。它在多个下游模型和 Harness 上普遍优于 Self-Summary,并保持无需微调的迁移能力。
但它不是无损压缩,也不是完整 Memory System。Knowledge Update、重复压缩稳定性、安全规则保护、跨领域泛化和真实训练成本仍需进一步验证。
一句话总结:SUMONE 把“如何写好 Agent Memory”变成了一个自监督重构问题——摘要不需要长得像人工摘要,只要能用更短文本保留足以恢复原轨迹的信息。




评论前必须登录!
注册