 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
JSON里的编号要不要加引号?用一次格式化核对清楚
接口对接时,有一类数据看起来全是数字,却从来不参与加减:订单编号、批次号、设备序列号。把它们和数量放进同一段 JSON,很容易顺手都写成数值。等数据经过几个系统,才发现前面的零不见了,或者长编号对不上。
这次我在 forxi.cn 的 JSON 格式化页做了一个小样本。内容全部自编,不对应真实订单:长编号写成字符串 "9007199254740993",批次号写成字符串 "000042",数量写成数值 12。
先让数据排开,再逐项看类型
把下面这段自编示例粘进输入框,点“格式化”:
{"orderCode":"9007199254740993","batchCode":"000042","quantity":12}
结果分行后,两个编号仍有双引号,批次号的六位字符没有改变,数量仍是不带引号的 12。截图来自 2026 年 11 月 6 日的本地功能实测。
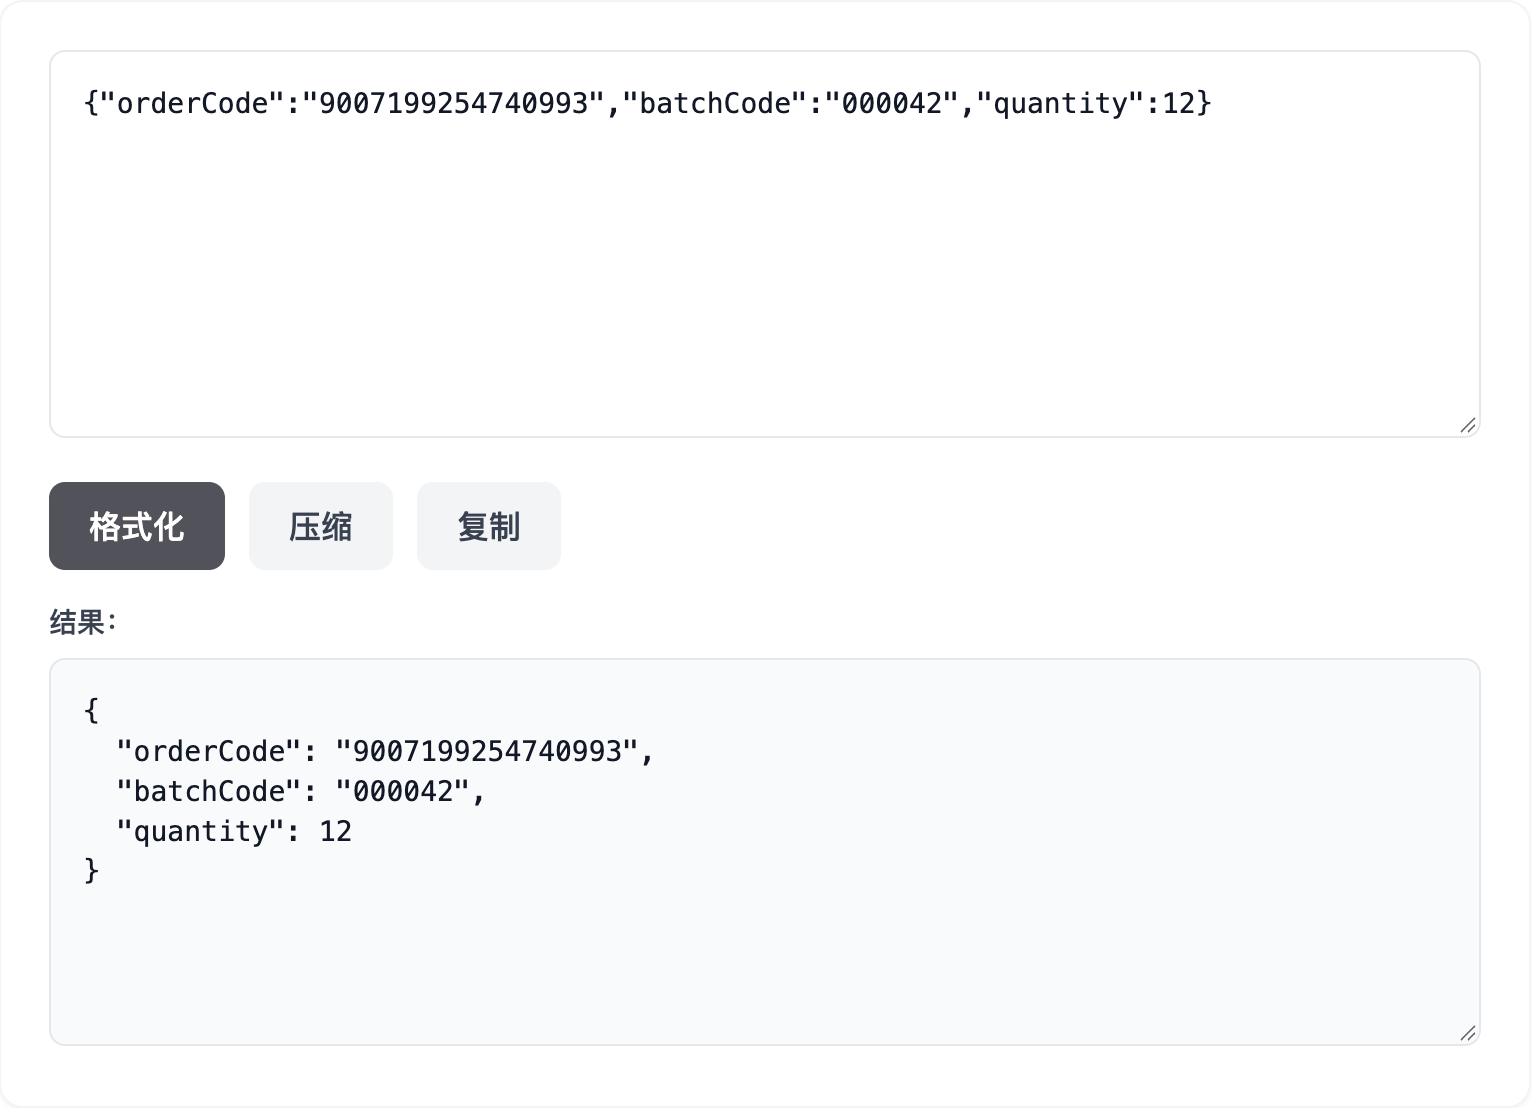
这个页面有格式化、压缩、复制三个操作。对这份样本,格式化最有用的地方是把字段逐行展开:检查时不容易漏掉双引号,也方便把输入和输出并排核对。需要复现这份无敏感数据的示例,可用 forxi.cn 的 JSON 格式化页。
长整数的边界,不等于 JSON 语法错了
RFC 8259 第 6 节提醒,不同实现可以限制数字的范围和精度。对于常见的双精度实现,绝对值不超过 9007199254740991 的整数有较好的精确互操作保证。超过这个范围,不能仅凭文本能解析,就认定每个系统都能原样保存。这里说的是跨系统的数据边界,并不是所有 JSON 实现都只支持这一范围。
编号的重点是字符身份。若接口约定它是字符串,长短都按字符串传;数量则按接口约定的数值类型传。不要为了页面看起来整齐,把所有字段一口气转成数字,也不要在不知道接口要求时统一加引号。
这次验证能说明什么
这份样本只能说明:所列两个字符串编号和一个普通数量,经过这次格式化后保持了预期类型与内容。格式化工具不会替业务决定字段类型,也不能把上游已经丢失的原始位数补回来。真实联调仍要从原始响应核对到接收端,尤其要检查中间导出、表格打开和重新序列化的步骤。
我会先用假数据把字段约定写明,再把格式化结果当作人工检查材料。排版更容易读,是检查的起点;数据能不能准确走完整条链路,还得逐段验证。
参考:RFC 8259,第 6 节 Numbers。


评论前必须登录!
注册