 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
先说结论:这不是什么「AI 荐股神器」,而是一个把真实券商公司的投研流程完整复刻出来的多智能体研究框架。能不能赚钱没有保证,但它展示的多 Agent 协作架构,值得每一个做 AI 应用的人拆开看看。
这个项目是什么
| 项目名 | TauricResearch/TradingAgents |
| GitHub | https://github.com/TauricResearch/TradingAgents |
| 开源协议 | Apache-2.0(商用友好) |
| Star | 12 万+,Fork 2.3 万 |
| 语言 | Python 3.11+,基于 LangGraph |
| 论文 | arXiv:2412.20138 |
| 最新版本 | v0.7.1(2026-10) |
一句话概括:给一个股票代码和分析日期,它会派出一支「虚拟投研团队」——基本面分析师、情绪分析师、新闻分析师、技术分析师并行出报告,多头和空头研究员开辩论会,交易员下单,风控团队和投资经理一票否决,最后输出一份带完整决策链路的模拟交易建议。
注意是模拟交易所成交,不接任何真实券商,不碰你的钱。
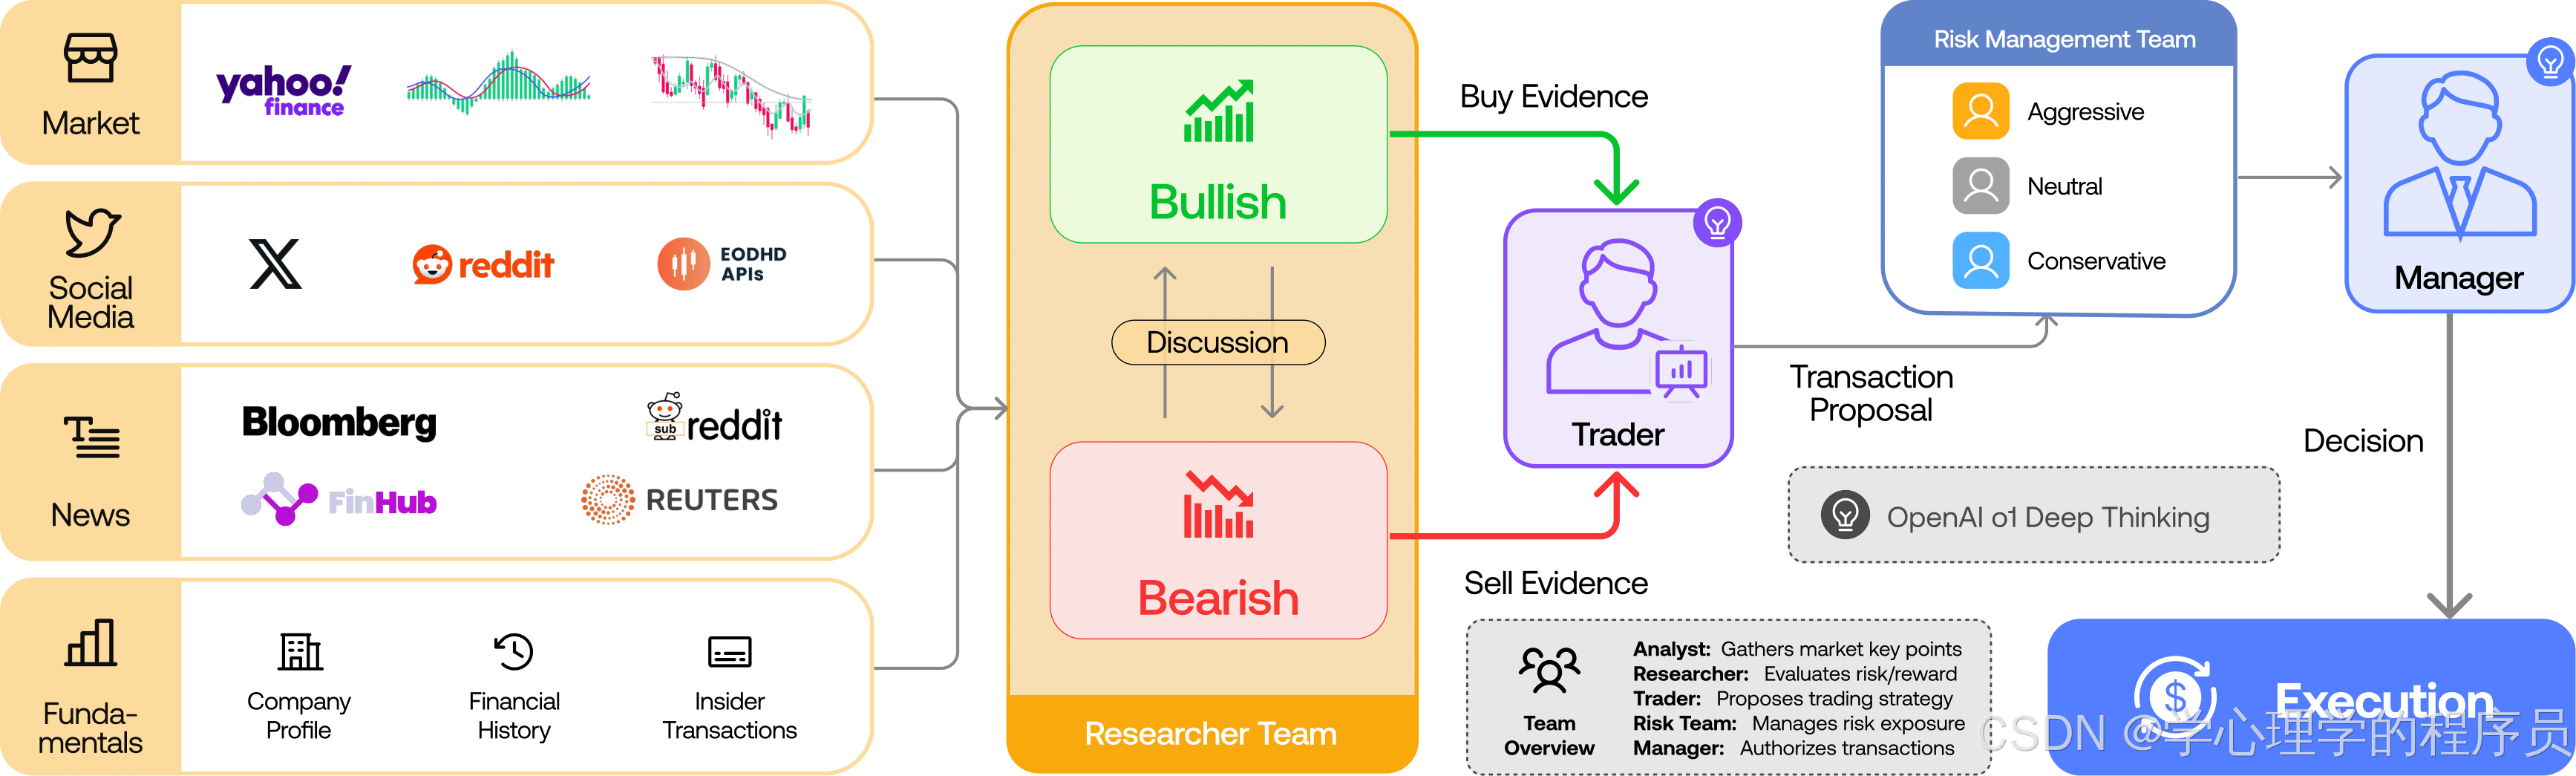
为什么值得看:它复刻的是真实券商的分工,不是单机问答
普通的「AI 选股」做法是把行情数据塞进一个 prompt,让大模型给个买卖建议。问题很明显:单一模型一次只持有一个观点,容易被一条新闻带节奏,也没人反驳它。
TradingAgents 的思路完全不同——用角色分工和强制对抗来压制幻觉。
第一层:分析师团队(并行,互不干扰)
四个分析师同时开工,各用各的数据源和工具:
- 基本面分析师:读 SEC EDGAR 财报,而且是「按申报日期」读取——回测 2015 年的决策时,看不到 2016 年才重述的数据,从机制上杜绝未来函数
- 情绪分析师:聚合 StockTwits、Reddit 的散户讨论,还可以接 Jev 模型过滤掉与该公司无关的水帖
- 新闻分析师:监控全球新闻和宏观指标,判断事件对市场的影响
- 技术分析师:用 MACD、RSI 等技术指标识别形态
四份报告全部到齐,辩论才开始。
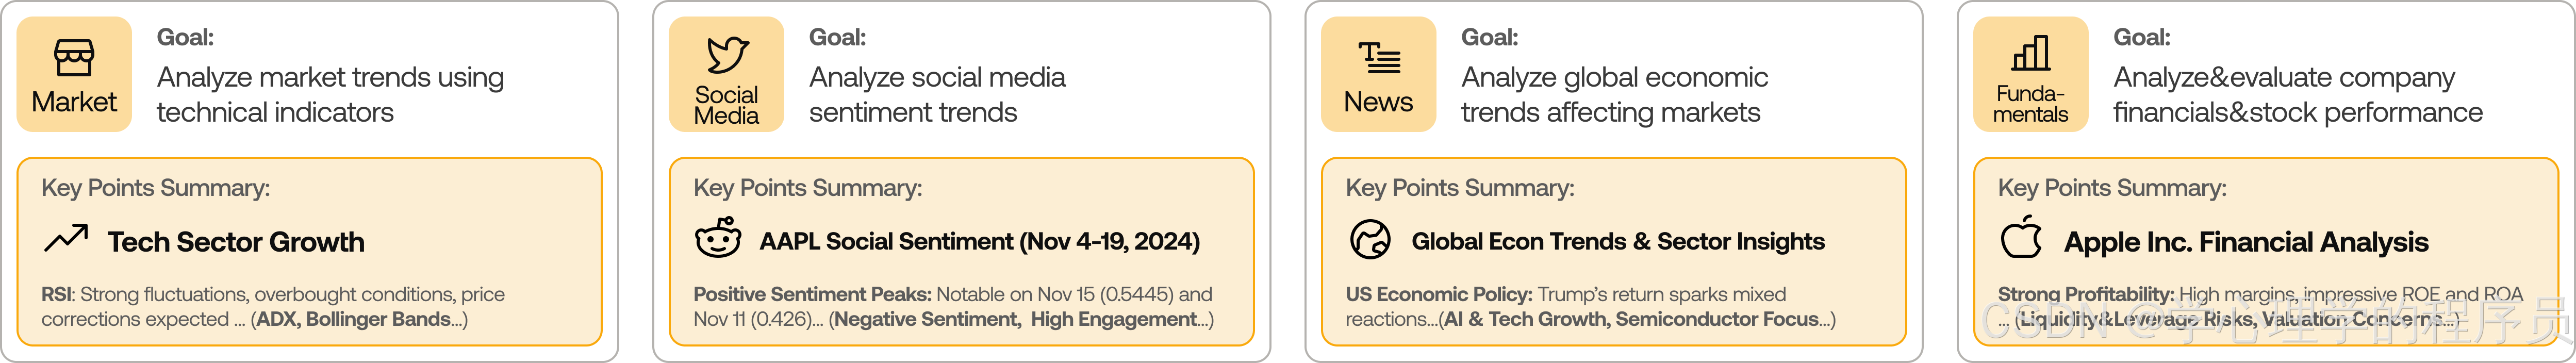
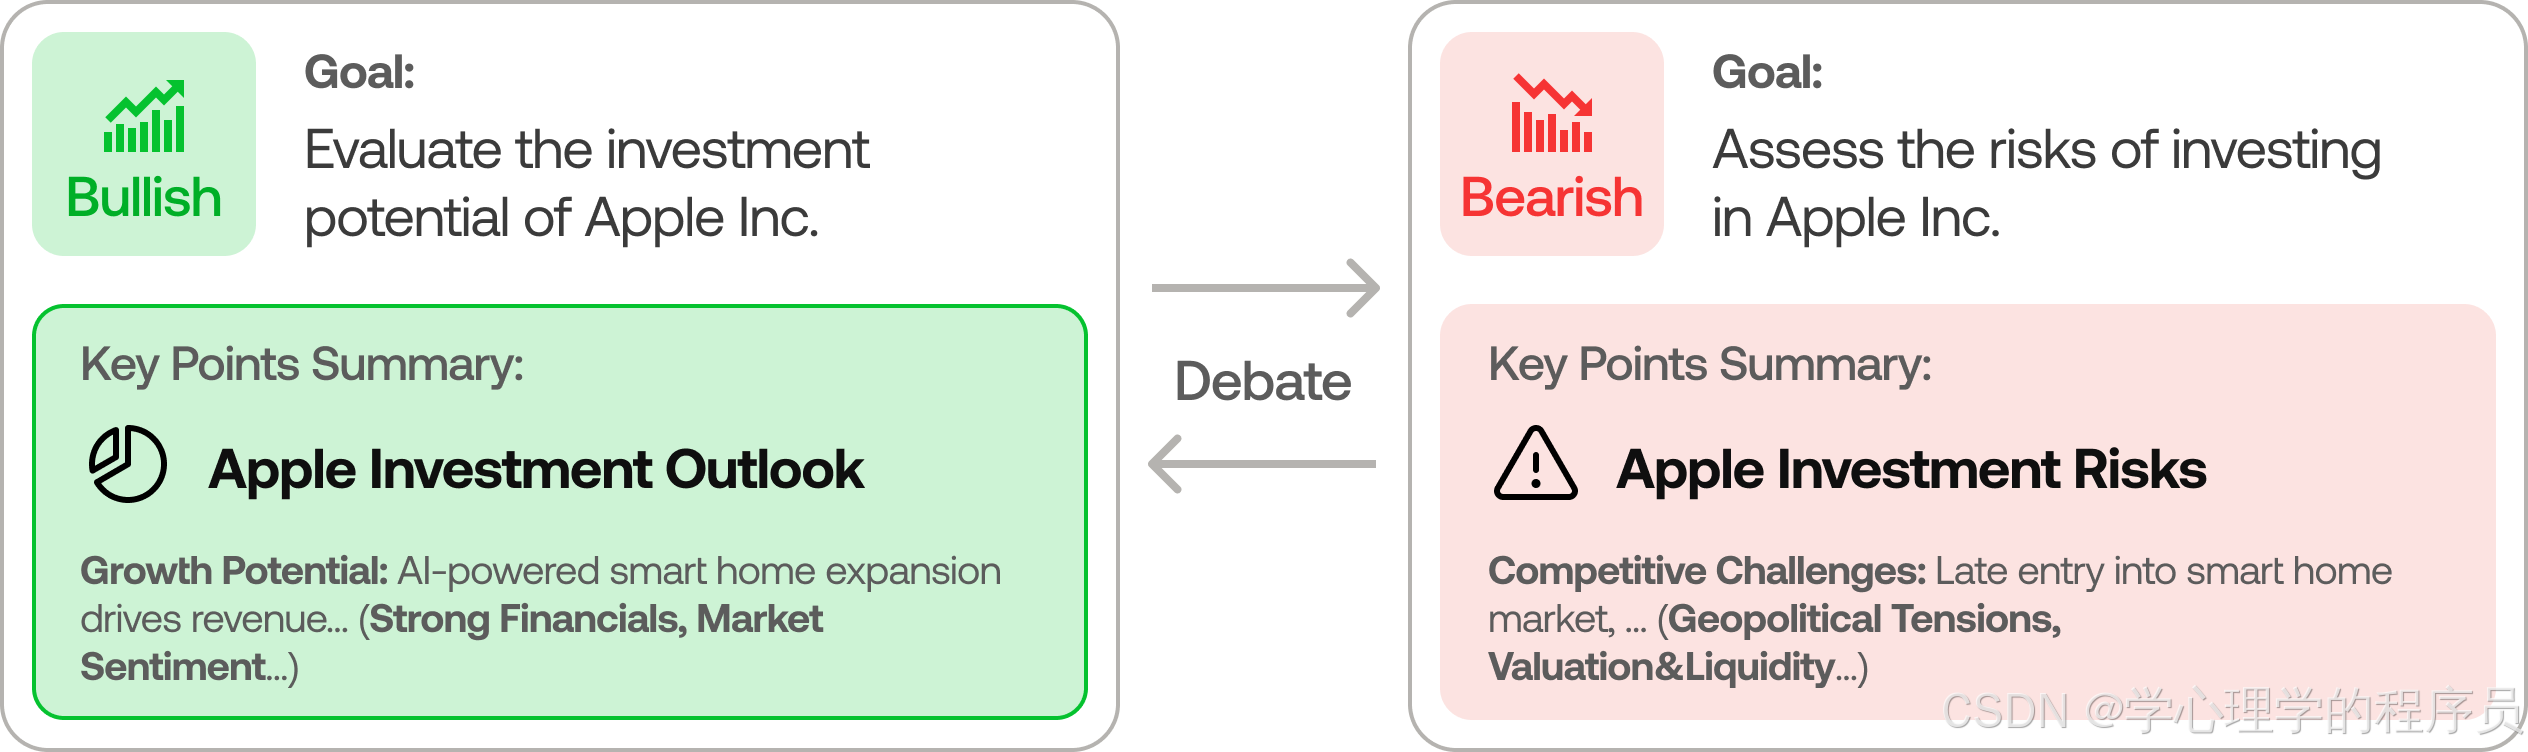
第二层:多空辩论会(强制对抗)
研究团队里天生两个角色:看多研究员和看空研究员。他们拿着分析师的报告互相挑刺,结构化辩论,把潜在收益和风险都摊开。
这一步是整个框架我最喜欢的设计:看多的人不能假装风险不存在,因为对面的人专门负责攻击你的论据。
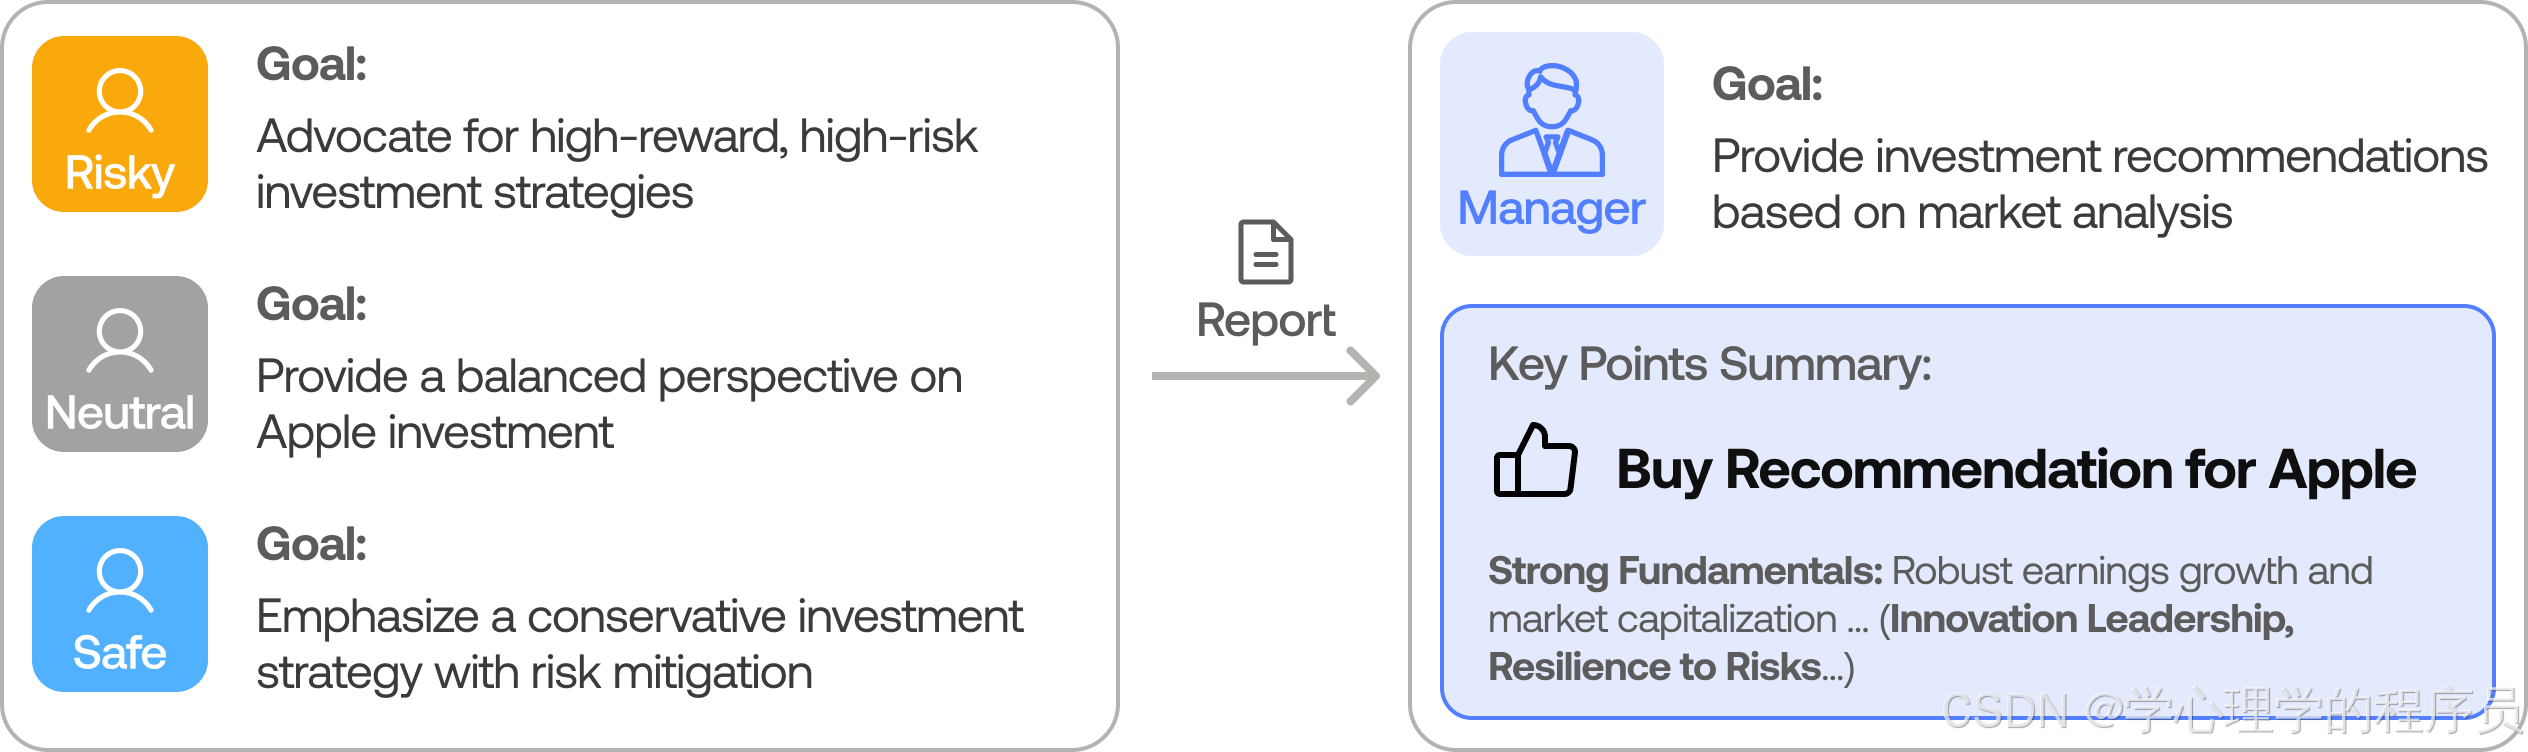
第三层:交易员 + 风控否决链
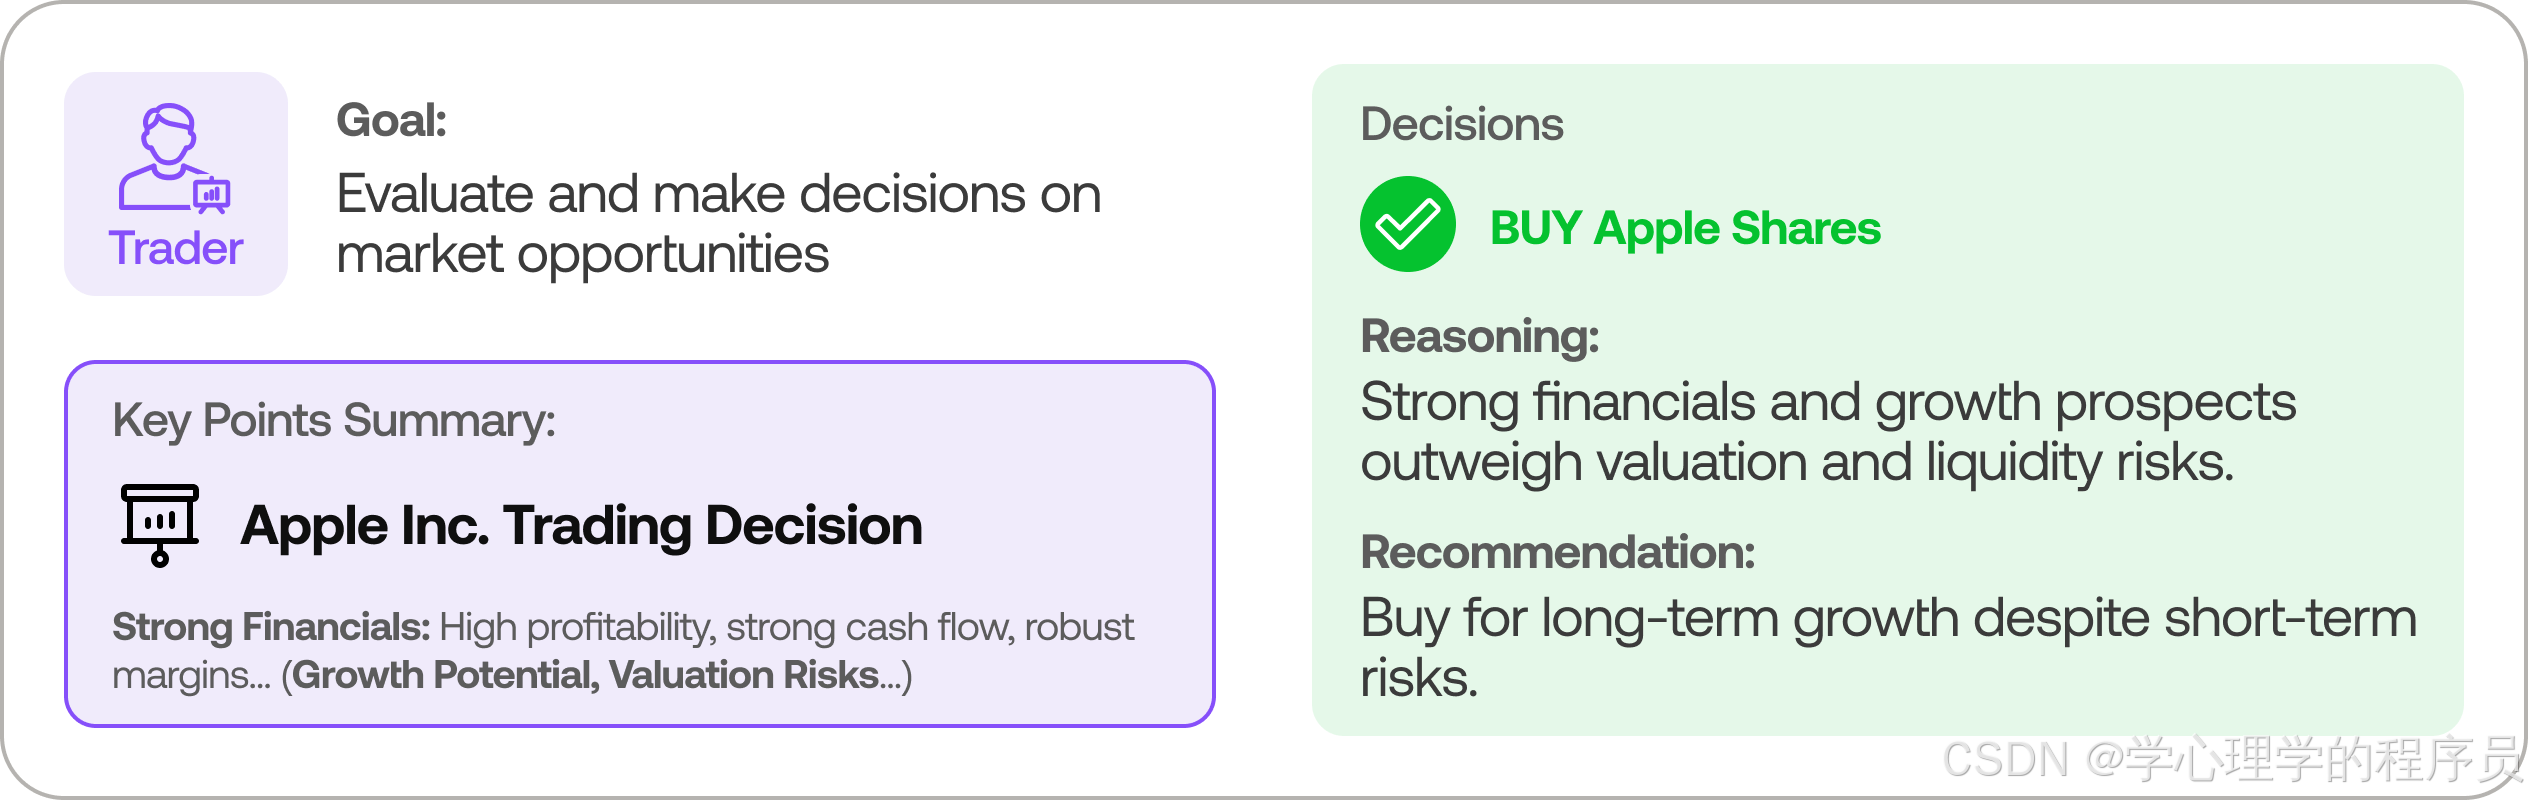
交易员综合所有报告,决定交易时机和仓位大小。但它说了不算——
- 风险管理团队评估波动率、流动性,出风险评估报告
- **投资经理(Portfolio Manager)**最终批准或驳回,驳回就不成交
- 通过后,订单才发往模拟交易所执行
怎么跑起来
方式一:Docker(最省事)
git clone https://github.com/TauricResearch/TradingAgents.git
cd TradingAgents
cp .env.example .env # 填入你的 LLM API Key
docker compose run –rm tradingagents
方式二:本地 pip 安装
conda create -n tradingagents python=3.13
conda activate tradingagents
pip install .
tradingagents # 启动交互式 CLI
方式三:三行代码嵌入自己的程序
from tradingagents.graph.trading_graph import TradingAgentsGraph
from tradingagents.default_config import DEFAULT_CONFIG
ta = TradingAgentsGraph(debug=True, config=DEFAULT_CONFIG.copy())
state, decision = ta.propagate("NVDA", "2026-09-01")
print(decision)
ta.save_reports(state, "NVDA")
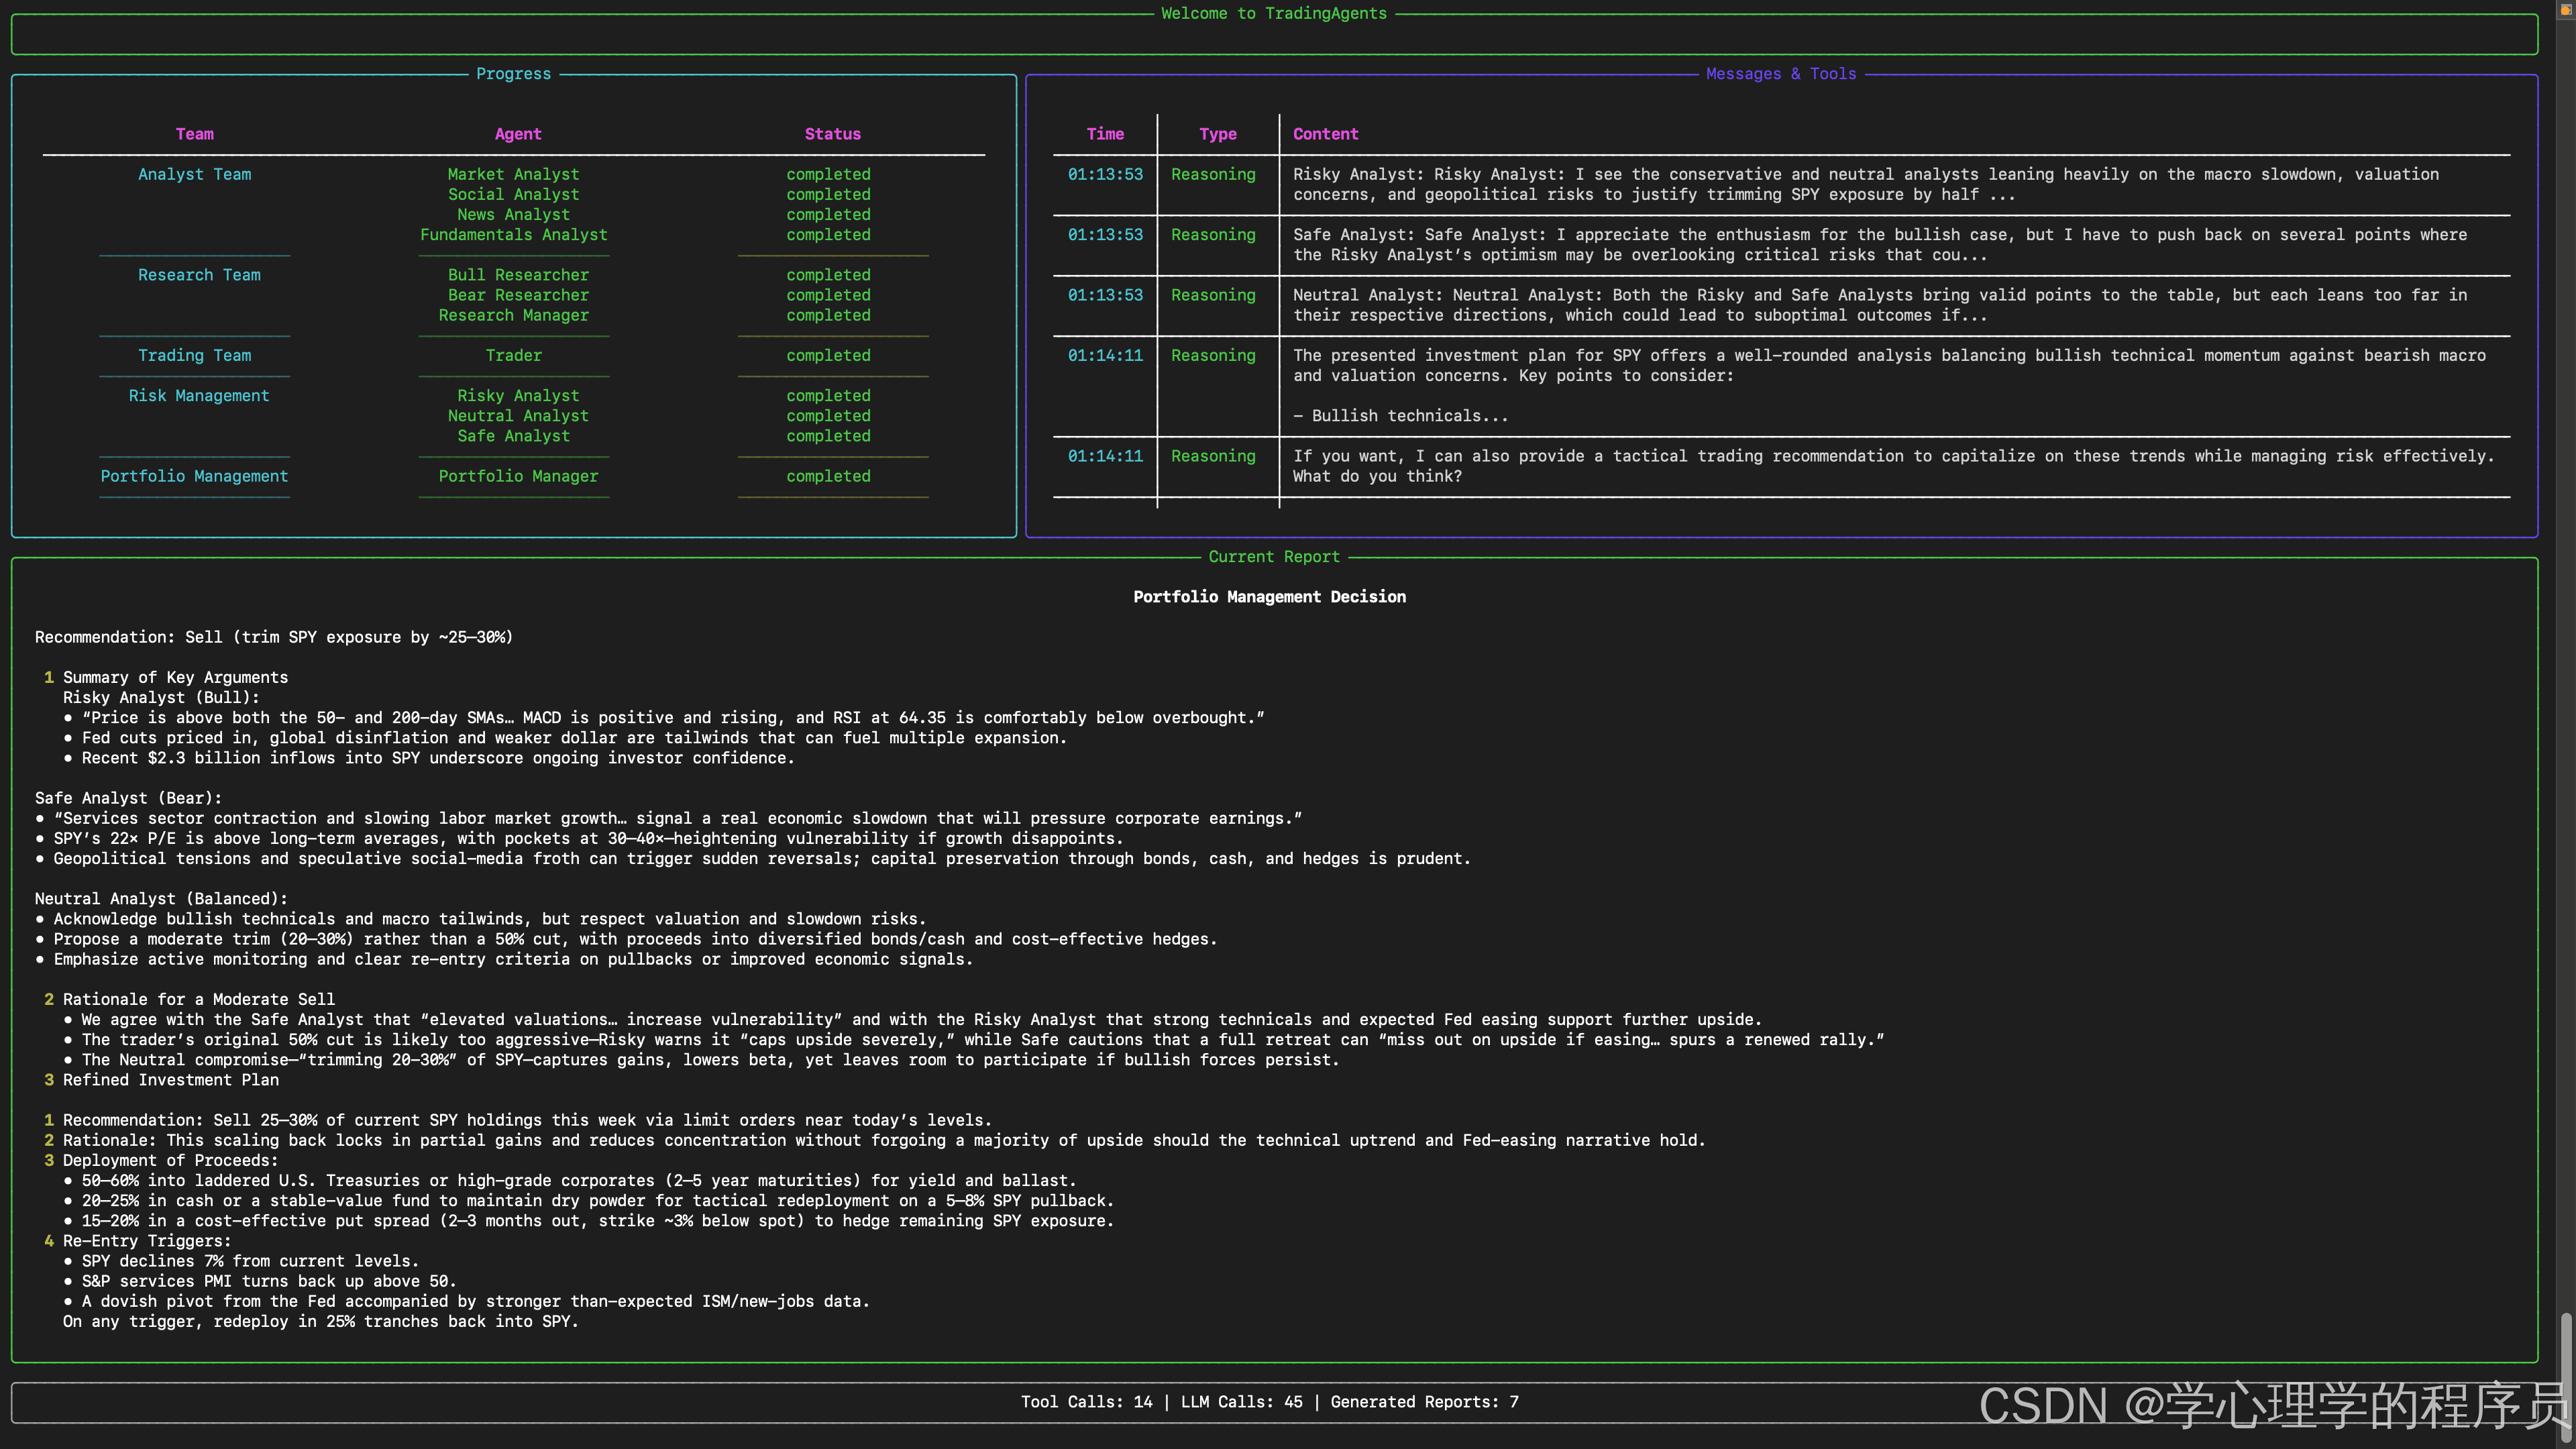
CLI 是全交互式的,选代码、选日期、选模型供应商、选研究深度,每一步都有界面,而且上一次的选择会作为默认值,回车即可复用:
几个工程上做得很扎实的细节
扒完源码和 CHANGELOG,有几个设计超出了「Demo 级开源项目」的水平:
1. 模型供应商极度开放。 OpenAI、Claude、Gemini、Grok、DeepSeek、通义千问、智谱 GLM、MiniMax、Kimi、Groq、本地 Ollama、AWS Bedrock、Azure,甚至可以直接挂你的 ChatGPT Plus/Pro 订阅额度。而且「快速模型」和「深度思考模型」可以分别指定不同供应商——分析师用便宜的,投资经理用最强的。
2. A 股原生支持。 上交所代码加 .SS、深交所加 .SZ,比如贵州茅台就是 600519.SS;港股 0700.HK、东京 7203.T,任何 Yahoo Finance 覆盖的市场都能跑,加密货币用 BTC-USD。
3. 记忆日志 + 决策复盘。 每次决策追加到 ~/.tradingagents/memory/trading_memory.md,持有期结束后自动结算真实收益和相对基准的超额收益,再生成一段反思。下一次分析同一标的时,投资经理会读历史教训——相当于让团队「长记性」。
4. 检查点断点续跑。 基于 LangGraph,每个节点执行后落 SQLite,崩了从最后一步恢复,成功完成后自动清理。对一个一次跑几十分钟、调几十次 LLM 的流程来说,这是刚需。
5. 回测网格 + 可复现性说明。 run_backtest 可以按「标的 × 日期」网格批量跑,每个决策按决策日后第一个收盘价计分。官方文档诚实地写明:LLM 采样本身不确定、新闻数据随时间变化,回测结果不保证复现任何论文数字——这种态度在量化圈反而少见地靠谱。
踩坑与限制(先说丑话)
- 成本不低:一次完整分析要跑十几个 Agent、多轮辩论,按 API 计费。建议先用 quick 配置和便宜模型试跑
- 强依赖外网数据源:Yahoo Finance、SEC EDGAR、Reddit 等,国内网络需要自行解决访问问题;A 股财报走 Yahoo 通道,历史回测数据精度不如美股
- LLM 输出有随机性:同一代码同一日期跑两次结论可能不同,这是框架特性不是 bug
- v0.5 之后包结构重排过,网上老教程的 import 路径可能已失效,以官方当前 README 为准
适合谁,不适合谁
适合:
- 学多智能体编排、LangGraph 状态机的开发者——这是最好的真实参考项目之一
- 做投研、舆情分析类产品的团队,角色分工和对抗辩论的设计可以直接借鉴
- 想用代码化方式研究「AI 怎么做结构化决策」的人
不适合:
- 想找个工具跟着买卖赚钱的人——官方免责声明写得很清楚:仅供研究,不构成任何投资、金融或交易建议
- 没有 API 预算、网络条件受限的用户
- 期待「稳赚策略」的人,这个项目给的是研究脚手架,不是印钞机
写在最后
TradingAgents 最有价值的部分其实不是「交易」,而是它证明了一件事:当你把一个复杂决策拆成专业角色、强制对抗、独立验证和否决链之后,LLM 的输出质量会被工程结构托住一个底。
这套模式换到代码评审、风控审批、医疗会诊场景,同样成立。12 万 Star,一半是给金融题材的流量,另一半,我觉得是给这套架构的。
项目地址:https://github.com/TauricResearch/TradingAgents
论文:https://arxiv.org/abs/2412.20138
官方免责声明:https://tauric.ai/disclaimer/
下一篇我们拆 Cloudflare 官方开源的安全审计 Skill:让一群 AI 扮演黑客和审计员,六阶段互查漏洞,还规定「发现漏洞的 Agent 不许自己验证」——和今天这套多空对抗,是同一个思想的两种用法。





评论前必须登录!
注册