 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
2026 后端 AI 集成落地拆解:Spring AI 2.0 + MCP + Agent 内嵌的三条路径怎么选
2026 年的 Java 后端 AI 集成,正在从"能不能调通一个大模型接口"演变为"怎么把模型能力稳定、可控、可计费、可审计地收进存量系统"的工程问题。近期多源高频出现的讨论也基本收敛到这一判断:RAG、知识图谱、MCP 协议、Agent 工作流编排不再是锦上添花的演示项,而是要在事务边界、权限体系、服务契约和团队技能栈约束下落地的模块[1][2][3]。本文不讨论"怎么调 API",只讨论一件事:把同一份 AI 能力收进现有 Java 微服务,检索、编排、工具注册、工具调用、流式通信这五个责任点分别放在哪一层,付出什么代价,留下什么坑。
先声明写作口径:本文引用的社区文章中,Spring Boot 版本线存在 3.x / 3.5 / 4.1 三种表述,部分来源自带"版本号需以官方资料核验"的提示[2][4][5];Spring Framework 7.1 在官方 Wiki 中标注为"计划于 2026 年 11 月发布的预览页"[7],属于尚未完全落地的事项。因此下文凡涉及具体版本号、类名、注解、配置项,一律标注"以所选版本官方文档为准",不把二手文章的版本口径当作既定事实。MCP 传输层的规范状态(SSE 是保留还是标记为旧版)同样需以你实际采用的规范版本原文为准,本文只做协议结构与部署语义的对比。
一、从"调通模型"到"收进系统":真正的约束是什么
一个 demo 级 Chat 接口和一个要进生产的 AI 能力,差别不在模型,而在外围约束:
| 鉴权 | 一个 API Key | 接入既有 OAuth2/JWT 体系,工具级授权 |
| 超时 | 无所谓,挂了重试 | 分级超时:连接、首 token、整轮、整流程 |
| 限流 | 无 | 按租户/用户/工具/模型分别限流与排队 |
| 成本 | 看 token 数 | 按调用链归集、归属部门、可对账、可限额 |
| 审计 | 打条日志 | 提示词、检索片段、工具入参出参、决策依据全留痕 |
| 降级 | 报错 | 检索空结果、模型超时、工具不可用都有明确出口 |
| 一致性 | 无状态 | 幂等键、副作用补偿、人工复核、断点续跑 |
存量 Java 系统还有一层隐性约束:业务规则已经沉淀在服务契约与事务边界里,团队技能栈以 Spring 生态为主,运维体系是既有的 Prometheus/Micrometer、日志与链路追踪[6]。所以选型的第一原则不是"哪个框架功能强",而是"哪条路径把责任放在我能治理的那一层"。
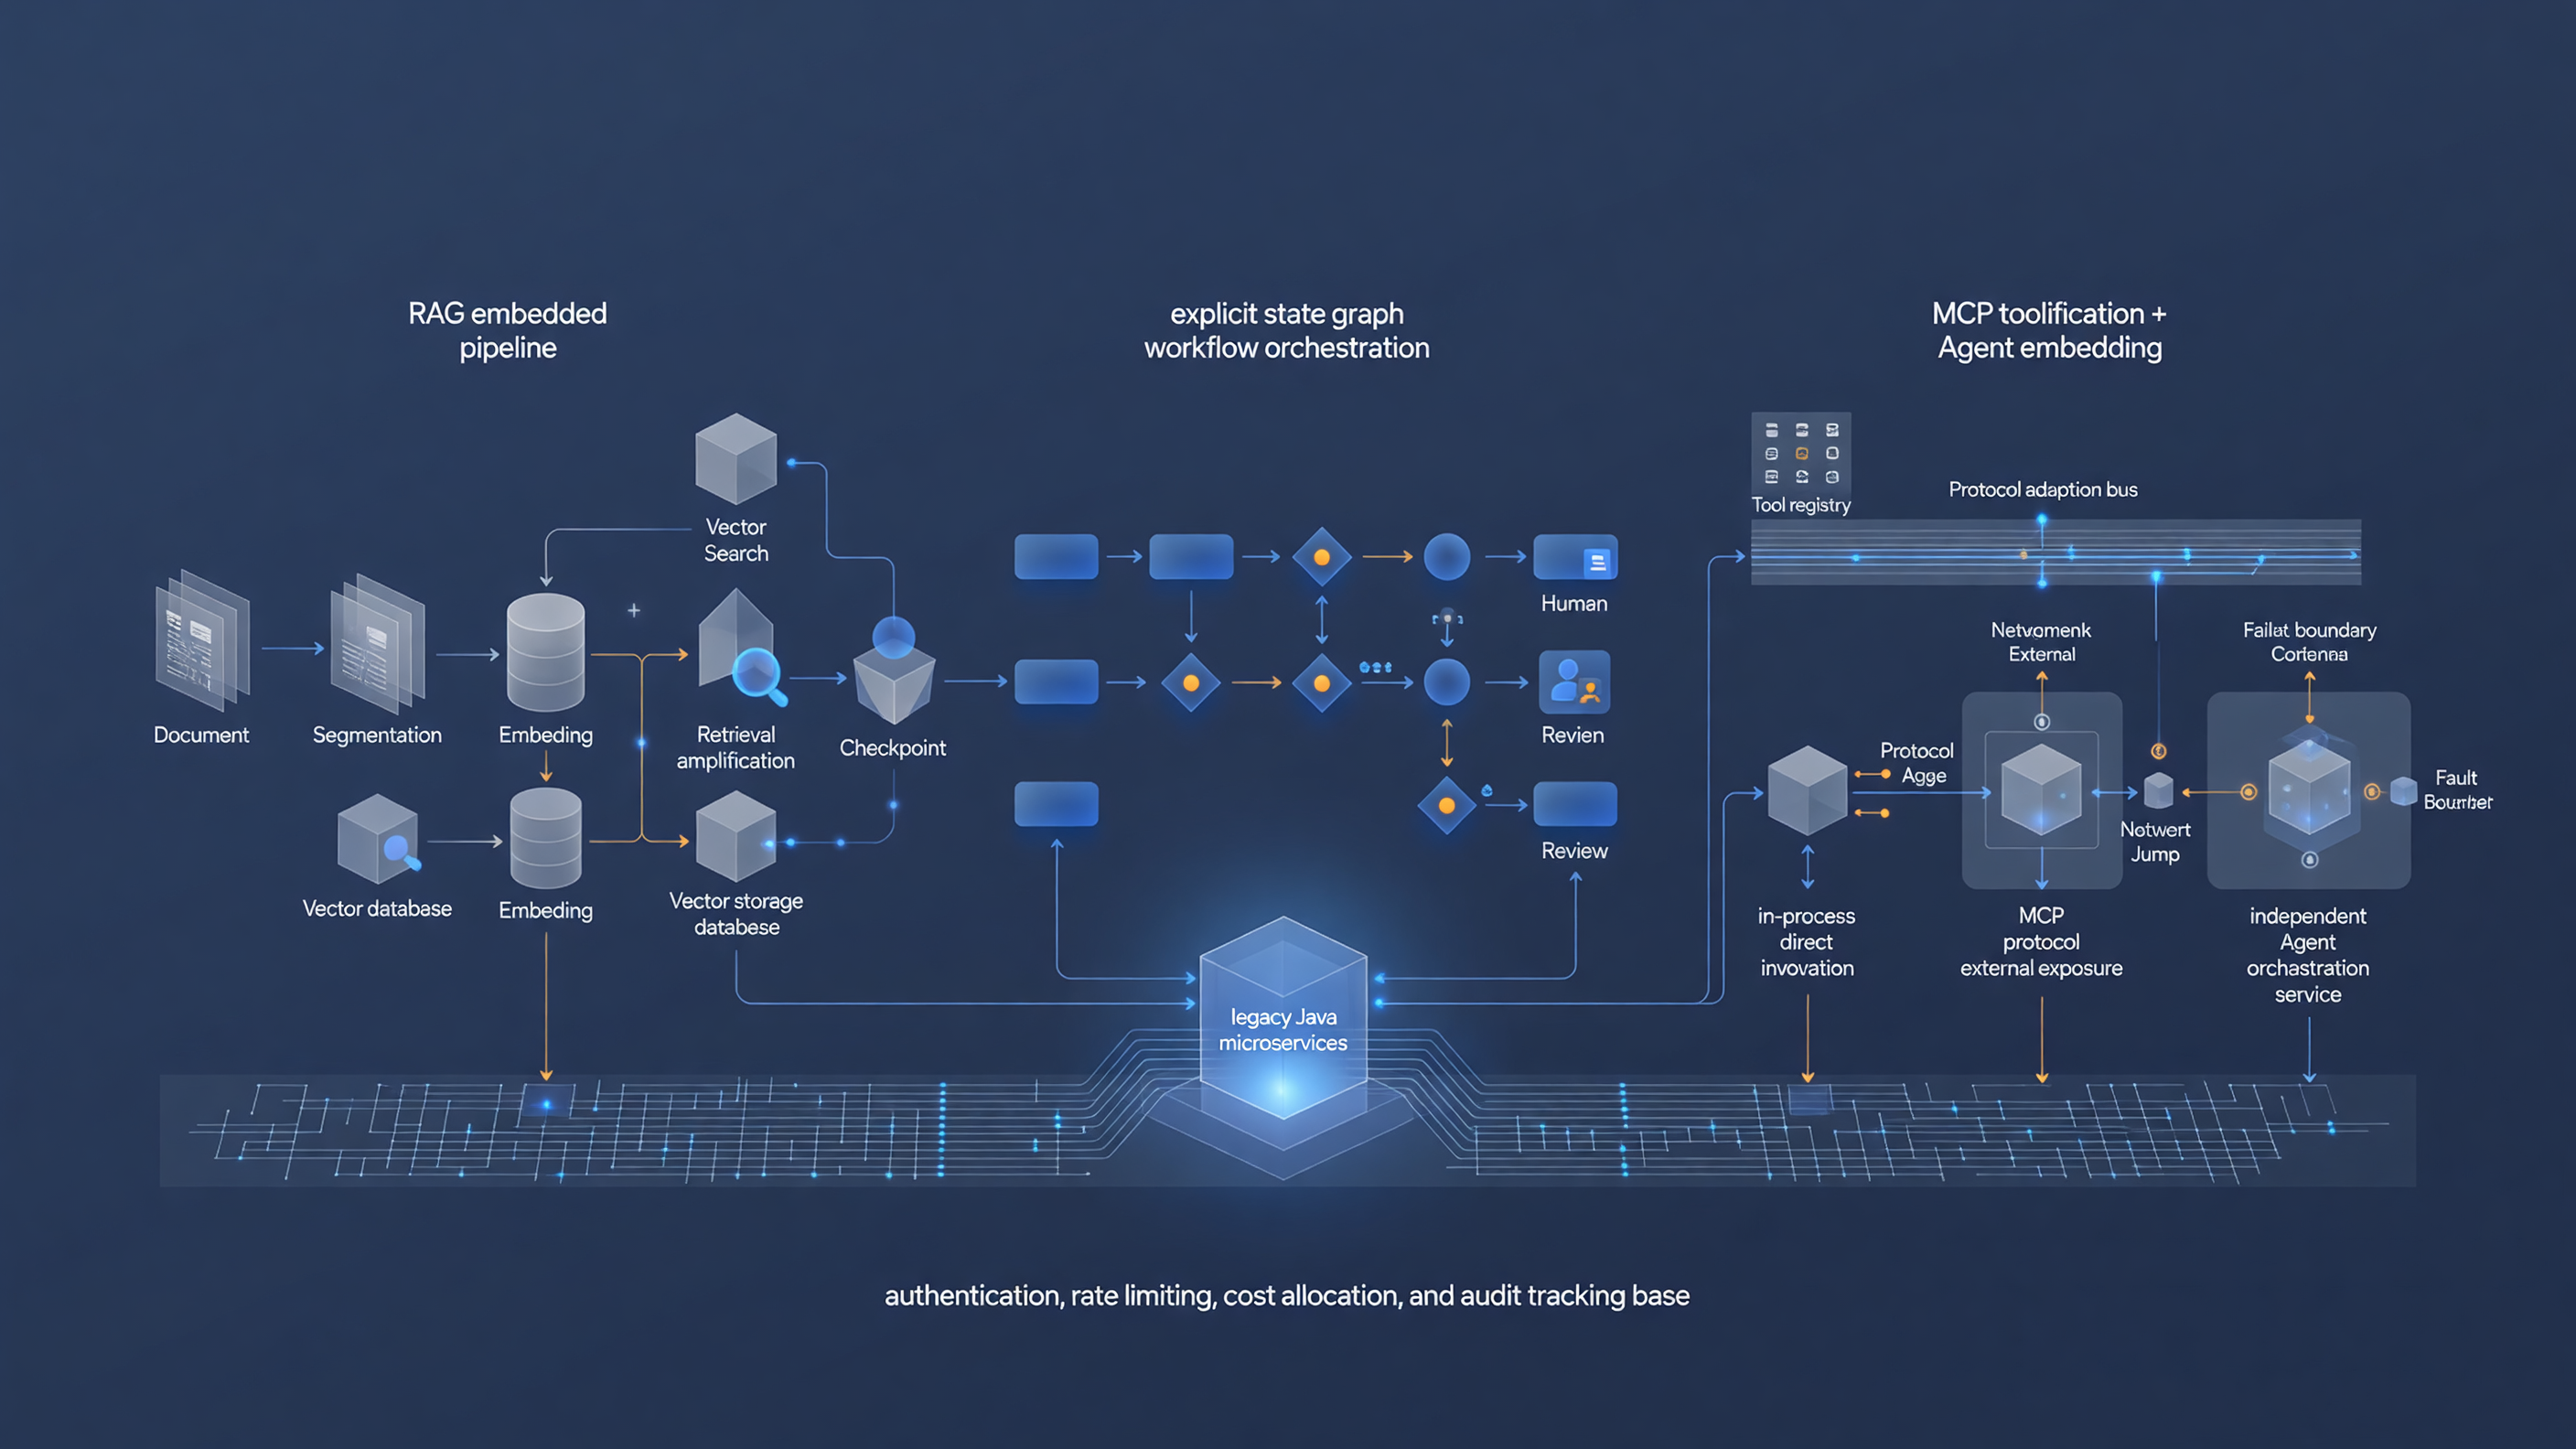
二、三条路画在同一张图上
2.1 三条路径的操作性定义
本文的三条路径定义如下(这是本文的展开口径,供与你的团队术语对齐):
- 路径 A:RAG 内嵌。把"文档摄取 → 切分 → 嵌入 → 向量存储 → 检索 → 组装上下文 → 生成"这条管线直接嵌进业务服务,模型回答带文档依据。适用于知识问答、辅助撰写、工单摘要等"单轮或浅多轮 + 需要文档依据"的场景。
- 路径 B:工作流编排(LangGraph4j)。把 LLM 调用收敛为显式状态图:节点是确定性的业务步骤或模型调用,边是条件分支,状态可持久化、可回放、可断点续跑。适用于多步、需人工审核、需重试与补偿的业务流程。参考实现中该能力由 LangGraph4j 与 Spring AI 2.0 组合承担[1]。
- 路径 C:MCP 服务端 + Agent 内嵌。把存量服务能力注册为 MCP 工具,供进程内 Agent 或外部 Agent 客户端按协议发现与调用;同时把 Agent 的落地拆成三种部署形态(见 4.2)。适用于能力外放、多 Agent 复用、与非 Java Agent 生态互操作。
需要说明的是,“Agent 内嵌"在不同文章里含义不一[2]。本文统一按部署形态展开:进程内 Tool Calling、MCP 服务端外放、独立 Agent 编排服务。三条主路径与三种 Agent 形态是两个维度的切分:路径回答"能力怎么组织”,形态回答"Agent 跑在哪里"。
2.2 责任边界矩阵
| 检索治理 | 业务服务或 RAG 模块负责摄取、切分、元数据、权限过滤 | 编排图中的一个节点,输入输出是结构化状态 | 通常不负责,除非把检索也注册为工具 | 知识治理流程 + 向量库过滤条件 |
| 流程编排 | 基本没有,单轮为主 | 显式状态图负责分支、重试、checkpoint | Agent 的推理循环负责,业务侧不参与决策 | 业务规则不允许下沉到 Prompt |
| 工具注册 | 无 | 节点内进程内调用或调用 MCP 客户端 | 工具描述 + 输入输出 Schema + 版本管理 | 工具契约评审与变更流程 |
| 工具调用与副作用 | 无 | 编排层负责幂等与补偿 | 工具实现内做参数校验、鉴权、限流、审计 | 幂等键 + 审计 + 二次确认 |
| 流式通信与断线 | 业务接口自己决定是否流式 | 节点进度上报,通常非长连接 | 由 MCP transport 决定(SSE 或 Streamable-HTTP) | transport 适配层 + 会话状态外置 |
| 成本与审计 | 归到"一次问答" | 归到"一次流程实例 + 节点级 token" | 归到"一次工具调用" | 统一埋点口径,贯穿 trace ID |
这张表的价值在于暴露一个常见误判:三条路径都"能跑通 demo",但责任落点完全不同。RAG 的失败是"答错、无依据、越权检索";编排的失败是"流程卡死、状态丢失、重复扣款";MCP 的失败是"工具描述误导、越权调用、副作用失控"。三者的测试集、监控指标、故障预案不能共用一套。

三、路径 A:Spring AI 2.0 的 RAG,把"有依据的回答"内嵌进业务服务
3.1 管线拆解:摄取侧决定上限,查询侧决定下限
RAG 在 Spring AI 里的抽象大致分为两侧。摄取侧是离线或准实时的:来源接入(数据库、对象存储、Confluence、代码仓库)、切分策略(固定长度、按标题层级、按语义边界)、元数据标注(租户、部门、文档 ACL、版本、生效时间)、嵌入写入向量库,以及最容易被忽略的增量更新与删除一致性。查询侧是在线的:把用户问题向量化,带权限过滤地检索,重排(rerank,若引入),组装上下文,生成答案,回传引用。
工程上的判断是:摄取侧的质量决定 RAG 的能力上限——切分错位、元数据缺失、文档过期,后面的 Prompt 工程救不回来;查询侧的上下文组装与降级策略决定体验下限——检索对了但引用混乱、找不到依据却硬答,用户立刻失去信任。
3.2 查询侧骨架与降级
下面是一个刻意保持"骨架级"的查询侧示例。类名与方法签名以你所选 Spring AI 版本官方文档为准,本文不锁定具体 API:
// 示意骨架:实际 API 以所选 Spring AI 版本官方文档为准
public record SourceRef(String docId, String title, double score, String snippet) {}
public record RagAnswer(String answer, List<SourceRef> refs, String degradeReason) {}
@Service
public class KnowledgeQaService {
private final ChatClient chatClient;
private final VectorStore vectorStore;
public KnowledgeQaService(ChatClient chatClient, VectorStore vectorStore) {
this.chatClient = chatClient;
this.vectorStore = vectorStore;
}
public RagAnswer answer(String question, UserContext user) {
// 1. 权限过滤下沉到向量库查询条件,不能靠 Prompt 约束
var hits = vectorStore.similaritySearch(SearchRequest.builder()
.query(question)
.topK(6)
.filterExpression(buildAclFilter(user)) // 租户 + 文档级 ACL
.build());
if (hits == null || hits.isEmpty()) {
// 2. 无依据就承认:转人工或返回明确的"未找到",不进生成
return RagAnswer.notFound("未检索到可见依据,已转人工或返回空结果");
}
var context = renderContextWithCitations(hits); // 带 [docId#chunk] 标记
var raw = chatClient.prompt()
.system("仅依据给定上下文回答;上下文不足时明确说明,不得推测")
.user(context + "\\n\\n问题:" + question)
.call()
.content();
// 3. 引用回传:从生成结果里解析引用标记,反查命中片段
return RagAnswer.withSources(raw, parseCitations(raw, hits), null);
}
private String buildAclFilter(UserContext user) {
// 示意:实际表达式语法以所选向量库适配层为准
return "tenantId == '%s' && (visibility == 'public' || acl contains '%s')"
.formatted(user.tenantId(), user.roleId());
}
}
三个不可省略的点:
3.3 权限、多租户与知识治理
多租户隔离键、文档级 ACL、版本生效时间,都应作为元数据写进向量库并在检索时强制过滤。删除文档时要保证"删源 → 删向量 → 缓存失效"的最终一致,否则会出现"文档已下线但 AI 还在引用"的合规事故。知识更新策略(全量重建、增量更新、双索引切换)需要与文档系统的变更事件挂钩,而不是靠定时任务兜底。
3.4 RAG 解决与不解决的问题
| 让回答有文档依据、可引用 | 跨系统的多步业务操作 |
| 降低幻觉、便于核验 | 需要写副作用的流程(下单、改配置) |
| 知识口径统一、可版本化 | 需要人工介入的审批与复核 |
| 单轮问答的延迟与成本可控 | 复杂条件分支与断点续跑 |
| 权限可控的检索(前提是过滤下沉) | 动态决策、自主探索型任务 |
如果需求里出现"然后"“需要确认”“失败后”"等到审批通过"这类词,问题就已经越出 RAG 的边界,应该进入路径 B。

四、路径 B:LangGraph4j 编排,把 LLM 收敛为显式状态图
4.1 什么时候必须上编排
判定清单:流程有多个步骤且步骤之间有状态传递;存在条件分支(检索到/未找到、金额超阈值、置信度低);需要人工审核节点;需要失败重试与断点续跑;需要对每一步留痕以便回放审计。满足两条以上,单次模型调用加 Prompt 就会失控。
显式状态图相对"Agent 自由发挥"的优势是可测试、可回放、可审计:给定同一初始状态,路径是确定的(分支条件确定时),回归测试可以按节点做断言,故障可以从 checkpoint 恢复,而不是让 Agent 从头再推理一遍。
4.2 一个构造示例(非真实客户案例)
以"知识问答 + 订单核对 + 人工复核"为例,节点划分可以是:
- retrieve:RAG 检索,产出 evidence;
- draftAnswer:生成初稿,产出 draft 与 confidence;
- checkOrder:调用订单服务(只读工具),核对金额与状态;
- decide:条件边——confidence >= 阈值 且 订单一致 走 autoReply;否则走 humanReview;
- humanReview:人工节点,状态挂起等待回调;
- autoReply / revise:出口节点,写审计与成本埋点。
状态字段建议显式建模为不可变记录或带版本的快照,至少包含:requestId、tenantId、evidence、draft、confidence、orderSnapshot、reviewDecision、nodeCosts。requestId 必须贯穿日志、链路追踪与计费表。
4.3 与 Spring AI 的分工
建议分工是清晰的两层:Spring AI 负责模型接入、Prompt 组装、RAG 组件与工具调用的底层能力;LangGraph4j 负责状态流转、条件分支、重试、checkpoint 与人审挂起。参考实现正是按这个思路把 RAG 与编排放在同一模块中组合的[1]。
需要核实的一点是:你所选的 Spring AI 版本是否已提供官方 workflow/编排原语。如果它已经内置了图或链式编排能力,那么再叠加 LangGraph4j 会产生"两层都做编排"的重复职责,节点重试、超时、状态归属会互相甩锅。成文前请回到 spring-projects/spring-ai 的官方文档确认,这一点在素材中也被标为必须核验项[2]。
4.4 编排层的工程债
- 状态持久化:checkpoint 放哪里?与现有存储体系(MySQL/PostgreSQL/Redis)如何共用事务?流程实例的生命周期要与业务单据的生命周期对齐。
- 幂等与补偿:所有副作用节点(写库、发消息、调用外部接口)必须带幂等键;失败后是重试、补偿还是转人工,要按业务分级定义。
- 超时分级:节点超时、整流程超时、人工节点挂起超时(转自动或作废)分别配置,不能只有一个全局 timeout。
- 可观测:每节点耗时、token 消耗、工具调用次数、重试次数,接入既有 Micrometer/Prometheus 体系[6]。注意这是口径统一问题,不是"加个监控面板"的收尾工作。
- 成本归集:token 成本必须能归到流程实例与节点,否则月底无法对账,配额也无法落地。
| 单次模型调用 | 低 | 高 | 低 | 摘要、改写、分类 |
| RAG | 中 | 高 | 中 | 有依据的问答 |
| 工作流编排 | 中高 | 高 | 中高 | 多步、人审、可补偿 |
| 自主 Agent | 高 | 低 | 高 | 探索型任务,生产慎用 |

五、路径 C:MCP 服务端,把存量能力工具化
5.1 MCP 解决的核心问题
MCP 的价值是把"工具契约"从各 Agent 框架的私有实现里抽出来,统一为注册、发现、调用、流式返回四件事。对存量 Java 系统而言,这意味着订单查询、库存占用、工单创建这些能力可以注册成工具,被内部 Agent、外部 Agent 客户端、甚至非 Java 生态的 Agent 复用,而不必为每个 Agent 框架写一遍适配层。参考实现里 springboot-mcp-sse 与 springboot-mcp-stream 两个模块分别实现了 SSE 与 Streamable-HTTP 两种服务端协议,覆盖工具注册、调用与双向流式通信[1]。
5.2 工具契约:注册、发现、调用、副作用
工具契约的质量直接决定调用准确率。description 写得含糊,模型就会拿错工具;参数 Schema 里没有枚举与边界,就会传进脏参数。但工具描述不是业务规则的载体——把"金额超过一万要人工复核"写进工具描述,等于把审批规则交给概率模型执行。
责任划分建议:参数校验、权限校验、审计、限流放在工具实现侧(或紧邻的网关侧),Agent 只负责"选工具 + 组参数"。写操作工具必须具备:幂等键、二次确认(规则或人工)、完整审计(谁、何时、以什么入参、结果如何)。
下面是一个骨架示例,注解与类名以你所选 Spring AI MCP Server 版本的官方文档为准:
// 示意骨架:注解名与注册方式以所选 Spring AI MCP Server 版本官方文档为准
@Service
public class OrderTools {
private final OrderQueryService orderQueryService;
private final AuditRecorder auditRecorder;
private final QuotaGuard quotaGuard;
@Tool(name = "query_order",
description = "按订单号查询订单状态与金额,只读,不做任何修改")
public OrderView queryOrder(@ToolParam("orderNo") String orderNo,
CallContext ctx) {
// 1. 鉴权与租户校验:不依赖 Agent 自觉
AccessControl.check(ctx.user(), "order:read", orderNo);
// 2. 配额与限流
quotaGuard.check(ctx.tenantId(), "query_order");
// 3. 入参合法性
OrderNoValidator.validate(orderNo);
// 4. 调用与审计:入参出参、耗时、traceId 全留痕
return auditRecorder.record("query_order", orderNo, ctx,
() -> orderQueryService.view(orderNo));
}
}
5.3 Agent 内嵌的三种形态
- 形态 1:进程内 Tool Calling。Agent 与业务同 JVM,工具调用是方法调用,延迟最低、调试最直观;代价是 Agent 逻辑与业务服务同生命周期,模型/提示词变更要跟着业务发版,故障互相牵连。
- 形态 2:MCP 服务端外放。业务服务暴露 MCP 工具,Agent 经协议调用;跨语言、跨框架复用最好,便于独立演进与灰度;代价是网络跳数、会话管理、协议版本兼容与传输层运维。
- 形态 3:独立 Agent 编排服务。把 Agent 推理循环抽成独立服务,业务服务只暴露工具与 API;故障隔离和扩缩容最灵活,Agent 侧可独立升级提示词与模型;代价是多一跳、分布式一致性与链路追踪复杂度显著上升。
| 部署耦合 | 高 | 中 | 低 |
| 调用延迟 | 最低 | 中 | 中高 |
| 跨框架复用 | 差 | 好 | 好 |
| 可观测粒度 | 方法级 | 协议级 | 服务级,需贯通 trace |
| 故障隔离 | 差 | 中 | 好 |
| 运维复杂度 | 低 | 中高 | 高 |
反模式清单:把业务规则写进工具描述;把鉴权交给 Agent 判断;把写操作无审计、无幂等地暴露;给 Agent 一个"万能工具"让它自己拼参数。
六、MCP 两种服务端协议:SSE 与 Streamable-HTTP 怎么取舍
这是本文最需要谨慎表述的一节。社区文章同时存在两种协议的实现样例[1],但 MCP 传输规范在持续演进,SSE 传输在你所采用的规范版本中是"保留、旧版兼容还是已标记弃用",必须以规范原文为准,本文不下定论。以下只比较协议结构与部署语义。
6.1 会话模型对照
| 连接模型 | 通常是两个通道:GET 建立 SSE 事件流,POST 发送请求 | 单一 HTTP 端点,响应可为普通 JSON 或 SSE 流 |
| 服务器推送 | 依赖长连接的 SSE 通道 | 按需在响应中升级为流式返回 |
| 断线语义 | 长连接断开后需重新建立并重放 | 可基于事件标识做恢复,重连成本相对可控 |
| 代理友好度 | 长连接易受空闲超时、缓冲、连接数限制影响 | 以普通 HTTP 请求为主,更贴近既有网关治理 |
| 会话恢复 | 依赖连接本身与客户端实现 | 可通过会话标识与事件 ID 组合恢复 |
| 客户端要求 | 需支持 SSE 长连接与双通道并发 | 需支持流式响应与可选的恢复机制 |
| 审计粒度 | 连接级 + 事件级,长连接内事件归属需额外标注 | 请求级为主,天然贴近现有 APM 与审计模型 |
简化地说:SSE 形态"一条长连接打通所有推送",交互直观,但在企业网络里长连接是运维成本;Streamable-HTTP 把传输收敛为普通 HTTP 语义,大部分请求是请求-响应,流式是按需开启的例外,因此对反向代理、LB、服务网格、WAF、审计中间件更友好,代价是客户端与服务端要正确处理会话标识、事件恢复与流式分支。
6.2 部署视角的坑
- 反向代理与 LB:Nginx/云 LB 常见的 proxy_read_timeout、响应缓冲、连接空闲回收会直接掐断 SSE;开启流式必须显式关闭缓冲并放大超时。云 LB 的连接漂移会让"会话粘性"形同虚设。
- 认证与会话:握手阶段用 token,之后长连接内的事件归属要靠会话标识;token 过期如何续期、如何把用户身份与工具调用绑定,需要在 transport 适配层统一处理,而不是散落在每个工具里。与既有 OAuth2/JWT 体系对接时,注意把租户与用户身份透传到工具实现。
- 扩缩容:会话状态放进程内,扩缩容与发布就会打断连接;放外部存储(Redis 等)则要处理状态大小与过期。K8s 滚动更新场景下,优雅关闭与连接迁移必须提前设计。
- 审计与限流:连接级限流(并发连接数)与请求级限流(每分钟工具调用数)是两套指标,只做其一都会失真。
- 观测:长连接内部的事件流需要额外打点,否则 APM 只能看到一条持续很久的"请求",无法定位到具体工具调用。
6.3 决策建议
| 客户端是浏览器/内部服务,推送数据量小,网络环境可控 | SSE 可用,运维成本可接受 |
| 客户端在企业网络、跨公网、经多层代理/网关 | 优先 Streamable-HTTP |
| 需要断线恢复、会话续跑、可审计的请求级计费 | 优先 Streamable-HTTP |
| 需要长期订阅、高频服务器推送 | 两者都要评估推送通道能力,必要时保留 SSE |
| 协议版本尚未在团队内统一 | 隔离 transport 适配层,同时支持两种,业务工具不感知传输 |
无论选哪个,都建议把 transport 收敛在一个适配层,工具实现只面向"注册 + 调用 + 返回"的抽象。协议还在演进,最贵的不是换传输,而是业务代码散落着对传输细节的假设。
七、参考实现拆解:springboot-agent 给了什么骨架,又留下什么必答题
7.1 模块地图
按参考实现文章的描述,springboot-agent 采用多模块微服务结构,核心模块包括 springboot-rag(Spring AI 2.0 + LangGraph4j 实现 RAG 与 Agent 工作流编排)、springboot-mcp-sse 与 springboot-mcp-stream(基于 Spring AI MCP Server 分别实现 SSE 与 Streamable-HTTP 两种服务端,覆盖工具注册、调用与双向流式通信)[1]。文章同时提到知识图谱相关能力与 Agent 平台的整体串联思路[1]。
| springboot-rag | RAG 管线 + LangGraph4j 编排 | 路径 A、B | 第三、四节 |
| springboot-mcp-sse | SSE transport 的 MCP 服务端 | 路径 C | 第五、六节 |
| springboot-mcp-stream | Streamable-HTTP transport 的 MCP 服务端 | 路径 C | 第五、六节 |
说明:上述模块清单来自参考实现文章的公开描述[1]。本文未逐一克隆仓库验证代码可运行性、依赖版本与 License,因此对仓库结构的表述保持描述性口径;落到你的项目前,请以仓库实际 pom/构建文件为准。

7.2 骨架的价值
它解决的是"全链路能否拼通"这个最贵的起步问题:
- 把 RAG、编排、两种 MCP transport 放在同一个可运行工程里,团队能直观看到模块边界与依赖方向;
- 两种 transport 并列实现,为协议对比与迁移演练提供了实验场;
- 为 Spring 生态团队提供了一个与既有技术栈同构的参照物,降低了"从 Python 示例翻译过来"的失真。
7.3 它没替你解决的问题
这是参考实现最有价值的部分,也是最容易被忽略的部分:
| 全链路模块拼接与依赖方向示范 | 身份认证与工具级授权 |
| RAG 与编排的组合样例 | 多租户隔离与数据可见性治理 |
| 两种 MCP transport 的并列实现 | 成本核算、计费、配额与限流 |
| 工具注册与调用的最小形态 | RAG 质量评测(召回率、忠实度)与回归测试集 |
| 流式通信的可行性验证 | 知识治理(更新、失效、版本、删除一致性) |
| —— | 灰度、回滚、模型与提示词版本管理 |
| —— | 提示注入防护、越权调用防护、副作用控制 |
| —— | 生产级观测、告警、容量与故障演练 |
7.4 拿来即用前的改造清单
八、选型决策:决策树、组合模式与分阶段路线
8.1 决策树
判断顺序建议如下:
三条典型组合:
- RAG 节点化:把检索与生成封装为编排图中的一个节点,输入输出是结构化状态,便于与其他节点组合与断言。
- 工具 MCP 化:存量能力统一注册为 MCP 工具,先只读、后写;Agent 与编排层都通过同一契约调用。
- 编排层独立化:流程逻辑收敛到独立服务,业务服务只暴露工具与 API,代价是分布式一致性与观测成本上升。
8.2 分阶段落地清单
| 阶段 0 | 模型接入 + 密钥托管 + 成本/审计埋点 | 单次调用可追溯到用户、租户、token 与费用;密钥不出配置仓库 | 一键切回非 AI 版本逻辑 |
| 阶段 1 | 单点 RAG,带引用与降级 | 回归问题集达标;越权检索测试全过;空检索有明确出口 | 关闭 RAG,退回关键词检索/人工 |
| 阶段 2 | 工具化与 MCP,先只读再写 | 只读工具审计完整;写工具有幂等键与二次确认;限流生效 | 禁用工具集开关(按工具粒度) |
| 阶段 3 | 引入编排层 | 流程可断点续跑;节点级成本可见;人审超时有明确处理 | 流程版本回退到上一版状态图 |
每个阶段都要有可回退的开关,尤其是提示词与模型版本,必须能独立于业务发版回退。
8.3 反模式清单
- 用 RAG 解决流程问题:问题里有"然后、需要、等到",RAG 不是答案。
- 用 Agent 自由发挥替代业务规则:规则进代码和配置,不进 Prompt。
- 协议选型只看 demo 能跑:不看代理、鉴权、断线、扩缩容,生产第一周就会还债。
- 无评测上线:没有回归问题集,任何提示词或模型变更都是赌博。
- 把鉴权、计费、审计留到最后:这三件事决定了 AI 能力能不能被组织长期持有,不是收尾项。
- 照搬参考实现:骨架提供的是结构与可行性,不是生产就绪度[1]。
九、结语
三条路径的共同底座是同一套工程纪律:契约明确、权限可控、成本可归集、失败有降级、行为可评测、全程可审计。把 AI 能力当成"又一个有 SLA 的内部服务"来设计,选型问题就从"哪个框架炫"变成"责任放在哪一层我治理得住"。对技术负责人而言,一句可执行的建议是:先做阶段 0 的成本与审计埋点,再按"单点 RAG → 只读工具 → 编排层"的顺序推进,任何一步没有评测与回退开关,就不要进入下一步。
参考资料
[1] 《Spring Boot 4.1 + Spring AI 2.0:我如何用 Java 微服务把 RAG、知识图谱和 MCP 协议串成一个 Agent 平台》,掘金,https://juejin.cn/post/7702792613526814771
[2] 《2026 后端 AI 集成实战:Spring AI 2.0、MCP 与 Agent 内嵌的三条落地路径》,CSDN,https://blog.csdn.net/m0_74899094/article/details/169058324
[3] 《2026 年后端开发跃迁:告别 CRUD 内卷,拥抱 AI 原生服务编排》,CSDN,https://blog.csdn.net/weixin_30844577/article/details/168584968
[4] 《2026 Java 后端技术选型:稳定基线 + 云原生 + 消息处理黄金组合》,CSDN,https://blog.csdn.net/weixin_32325225/article/details/168310341
[5] 《Spring Boot 3 + Spring Cloud 2026 微服务实战:云原生、AI》,CSDN,https://blog.csdn.net/2609_95039210/article/details/159245198
[6] 《业务挂了半小时才发现?基于 Spring Boot 3 + Prometheus + Grafana 打造企业级微服务立体可观测性与告警实战》,掘金,https://juejin.cn/post/7700380674944253962
[7] Spring Framework 7.1 Release Notes(官方 Wiki,页面标注为 7.1.0 预览、计划 2026 年 11 月发布),spring-projects/spring-framework,https://github.com/spring-projects/spring-framework/wiki/Spring-Framework-7.1-Release-Notes
补充说明:上述社区文章中的 Spring Boot / Spring AI / LangGraph4j 版本号表述不完全一致,部分来源自带"需以官方资料核验"提示[2];MCP 传输规范状态、Spring AI 具体 API 签名与参考实现仓库的实际可运行性,本文均未做逐一验证,涉及处已按"以官方文档与仓库实际内容为准"处理。






评论前必须登录!
注册