 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
11 月 4 日中午,腾讯混元发了 Hy4 正式版。朋友圈里流传的标题基本都是「开源」两个字。然后我怀着好奇的心理我把官方 Blog 从头到尾翻了一遍,第一反应是:这次的「开源」,其实是个将来时。
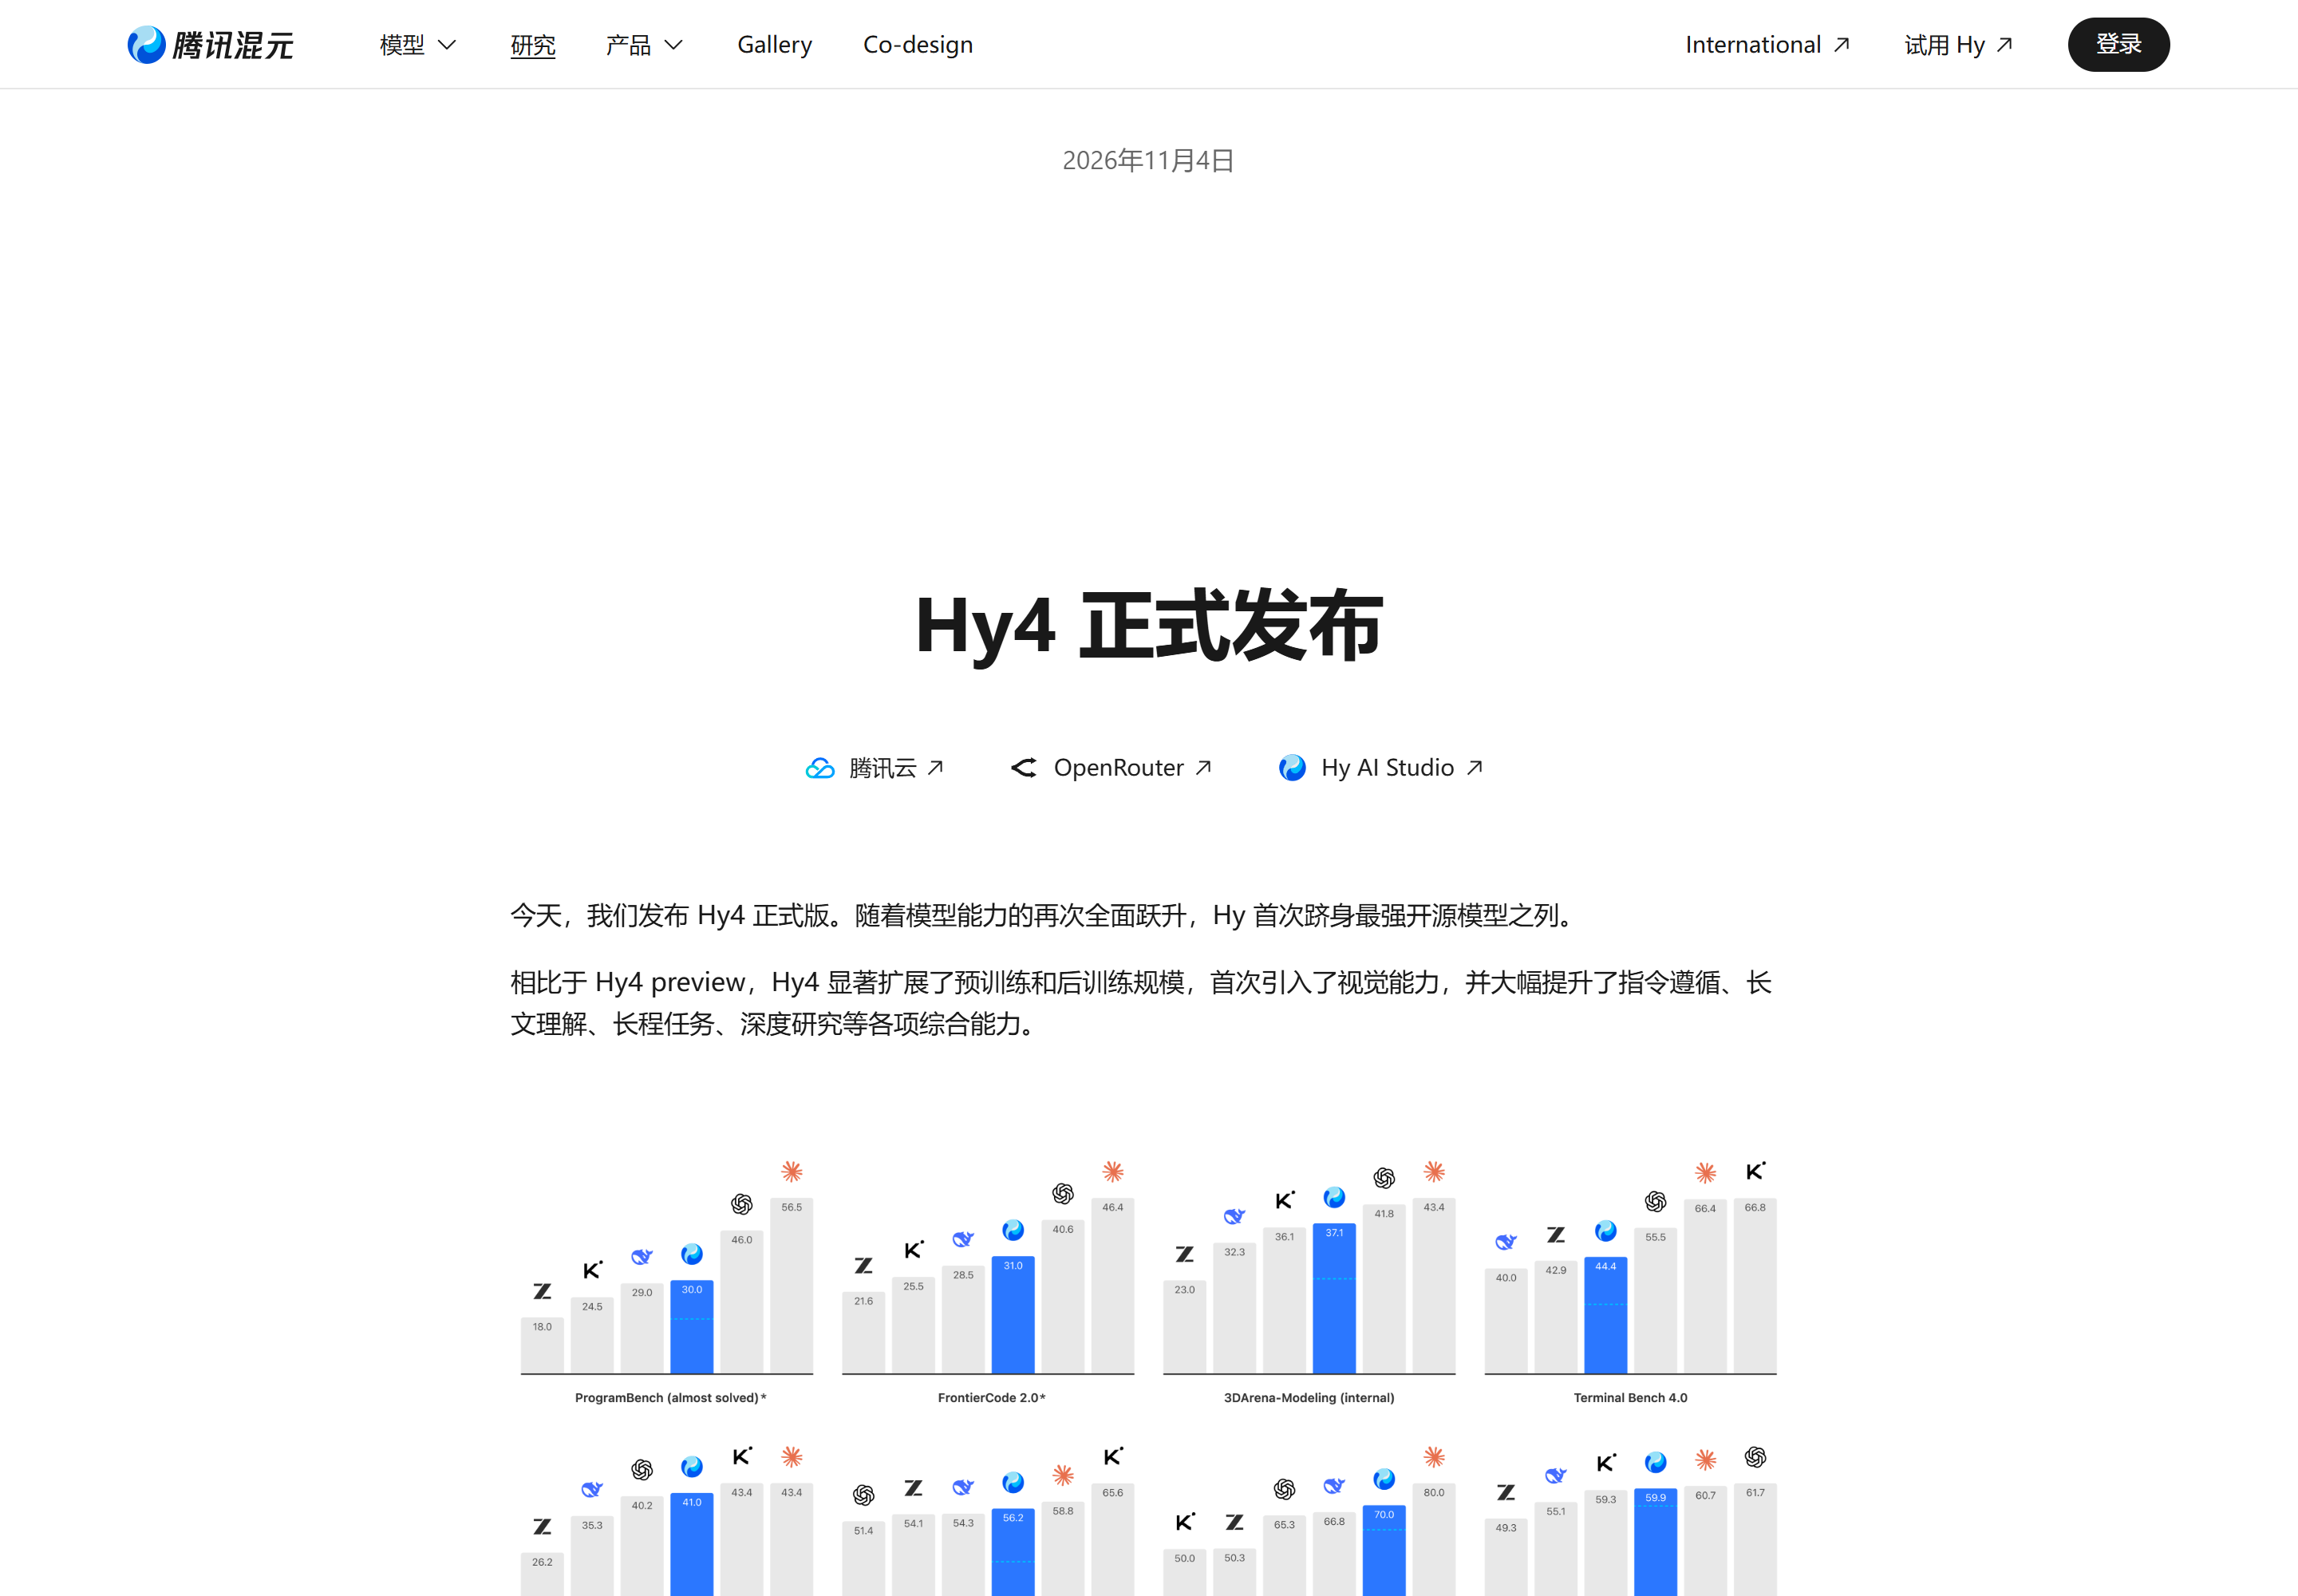
图 1:腾讯混元官方 Blog 的 Hy4 发布页
一、先把「开源」这两个字拆开读
官方 Blog 在「负责任的开源和发布」那一章,原话是这样:
我们计划开源模型权重,并已联合 vLLM/SGLang 社区与 Inferact Inc. 提供开源生态支持。我们届时也会发布模型系统卡片,包括更全面的安全评估等细节。
「计划开源」「届时也会发布」,两个都是将来时。也就是说,11 月 4 日这天发生的事情是:模型正式发布、API 和产品入口上线、价格和生态伙伴公布。权重本身还没有放出来。
真正把权重放出来的是 8 月 28 日的 Hy4 preview。腾讯官方中英文公告写得很清楚:已开源,Apache 2.0,总参数 770B、激活 49B 的 MoE,上下文超过 1M。腾讯云开发者社区那篇规格拆解还补了架构细节:78 层里第一层是 dense FFN,其余 77 层是 MoE,每层 256 个路由专家加 1 个共享专家,每 token 激活 top-8;Hugging Face 上显示 780B 是把内置的 MTP 投机解码层算进去了,官方口径的 770B 指主干。
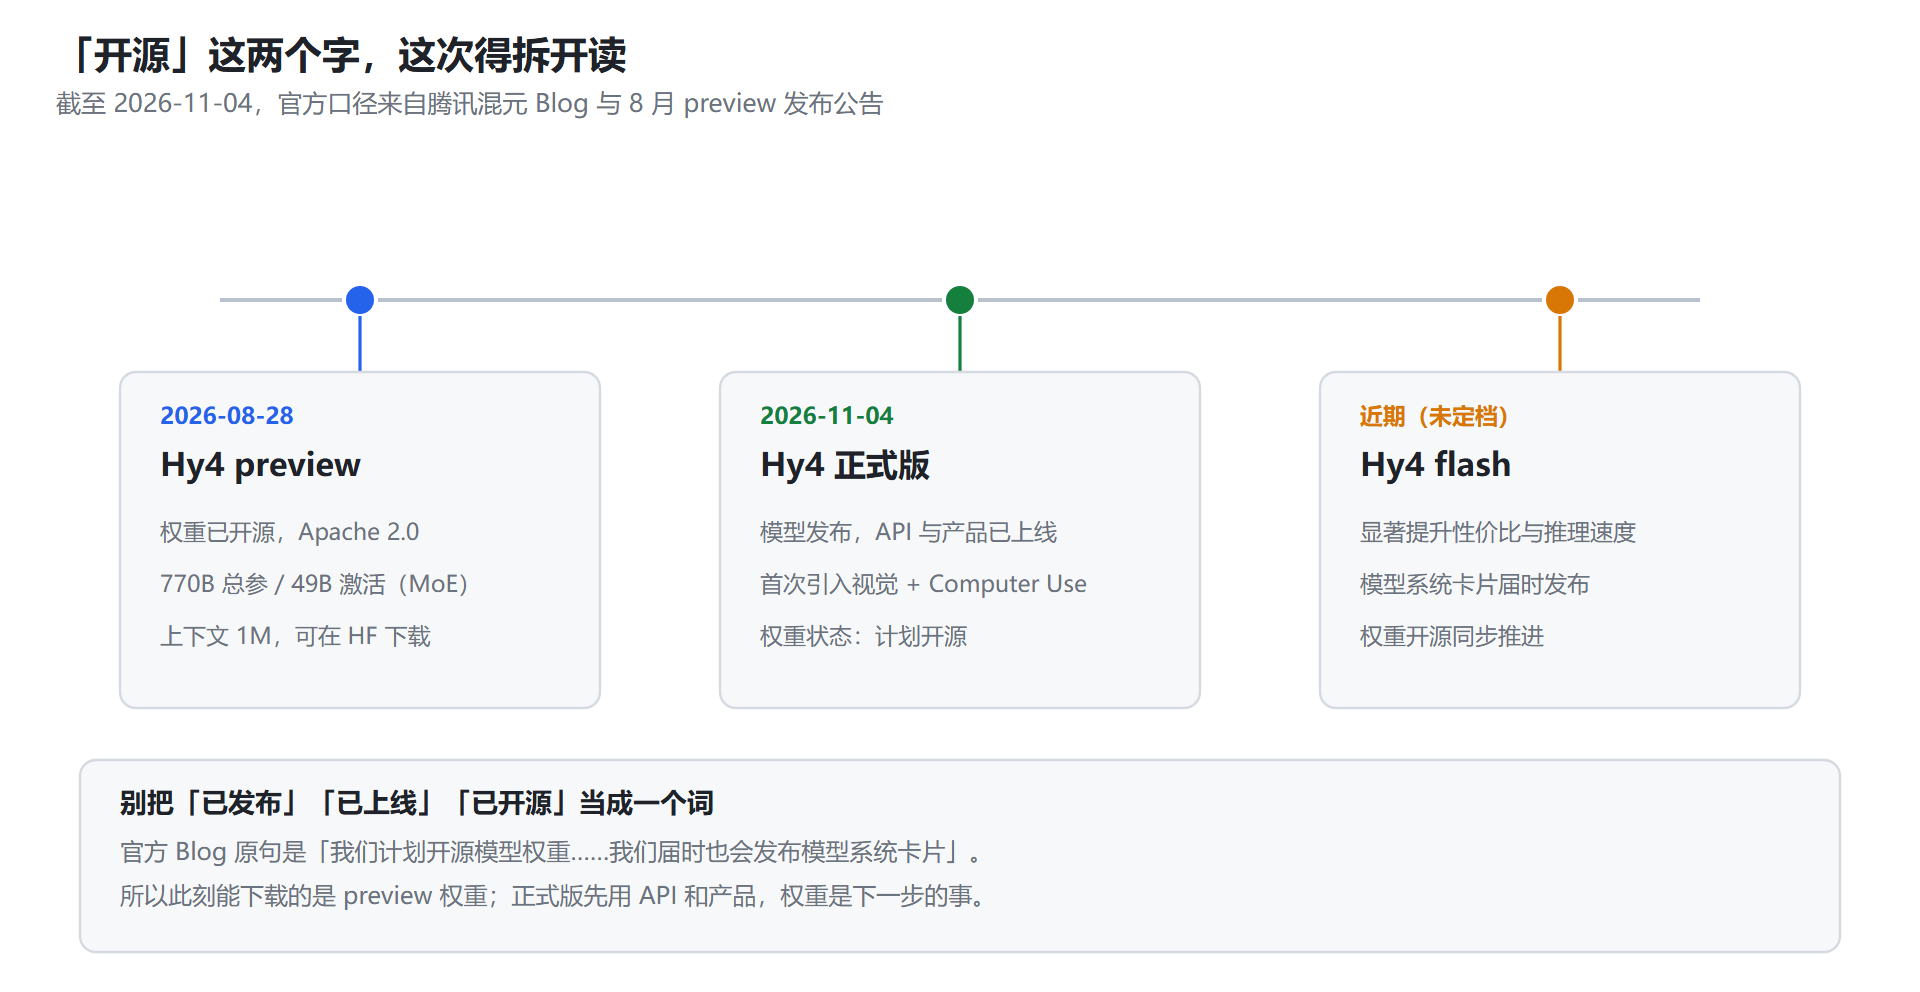
图 2:8 月的 preview 和 11 月的正式版,是两件不同的事。图里把「已发布」「已上线」「已开源」分开标了
这个区分不是抠字眼。如果你是打算做私有化部署、或者等着拿权重改推理算子的团队,此刻能下载、能改、能放进自己集群的还是 preview 那套。正式版目前走的是腾讯云、OpenRouter 以及 WorkBuddy / CodeBuddy、元宝、ima 这些入口。
还有一点容易混:媒体稿里反复出现的「770B 总参数、MoE」,是 preview 的规格。正式版官方 Blog 通篇没有披露架构参数,只说「显著扩展了预训练和后训练规模」。参数是否沿用、有没有变,官方没讲,我不替它猜。
二、正式版到底改了哪几件事
一句话概括官方说法:预训练和后训练规模都扩大了,首次引入视觉能力,指令遵循、长文理解、长程任务、深度研究这几项一起往上抬。
但这句话太抽象,我把 Blog 里散在各章的东西收成了六块。
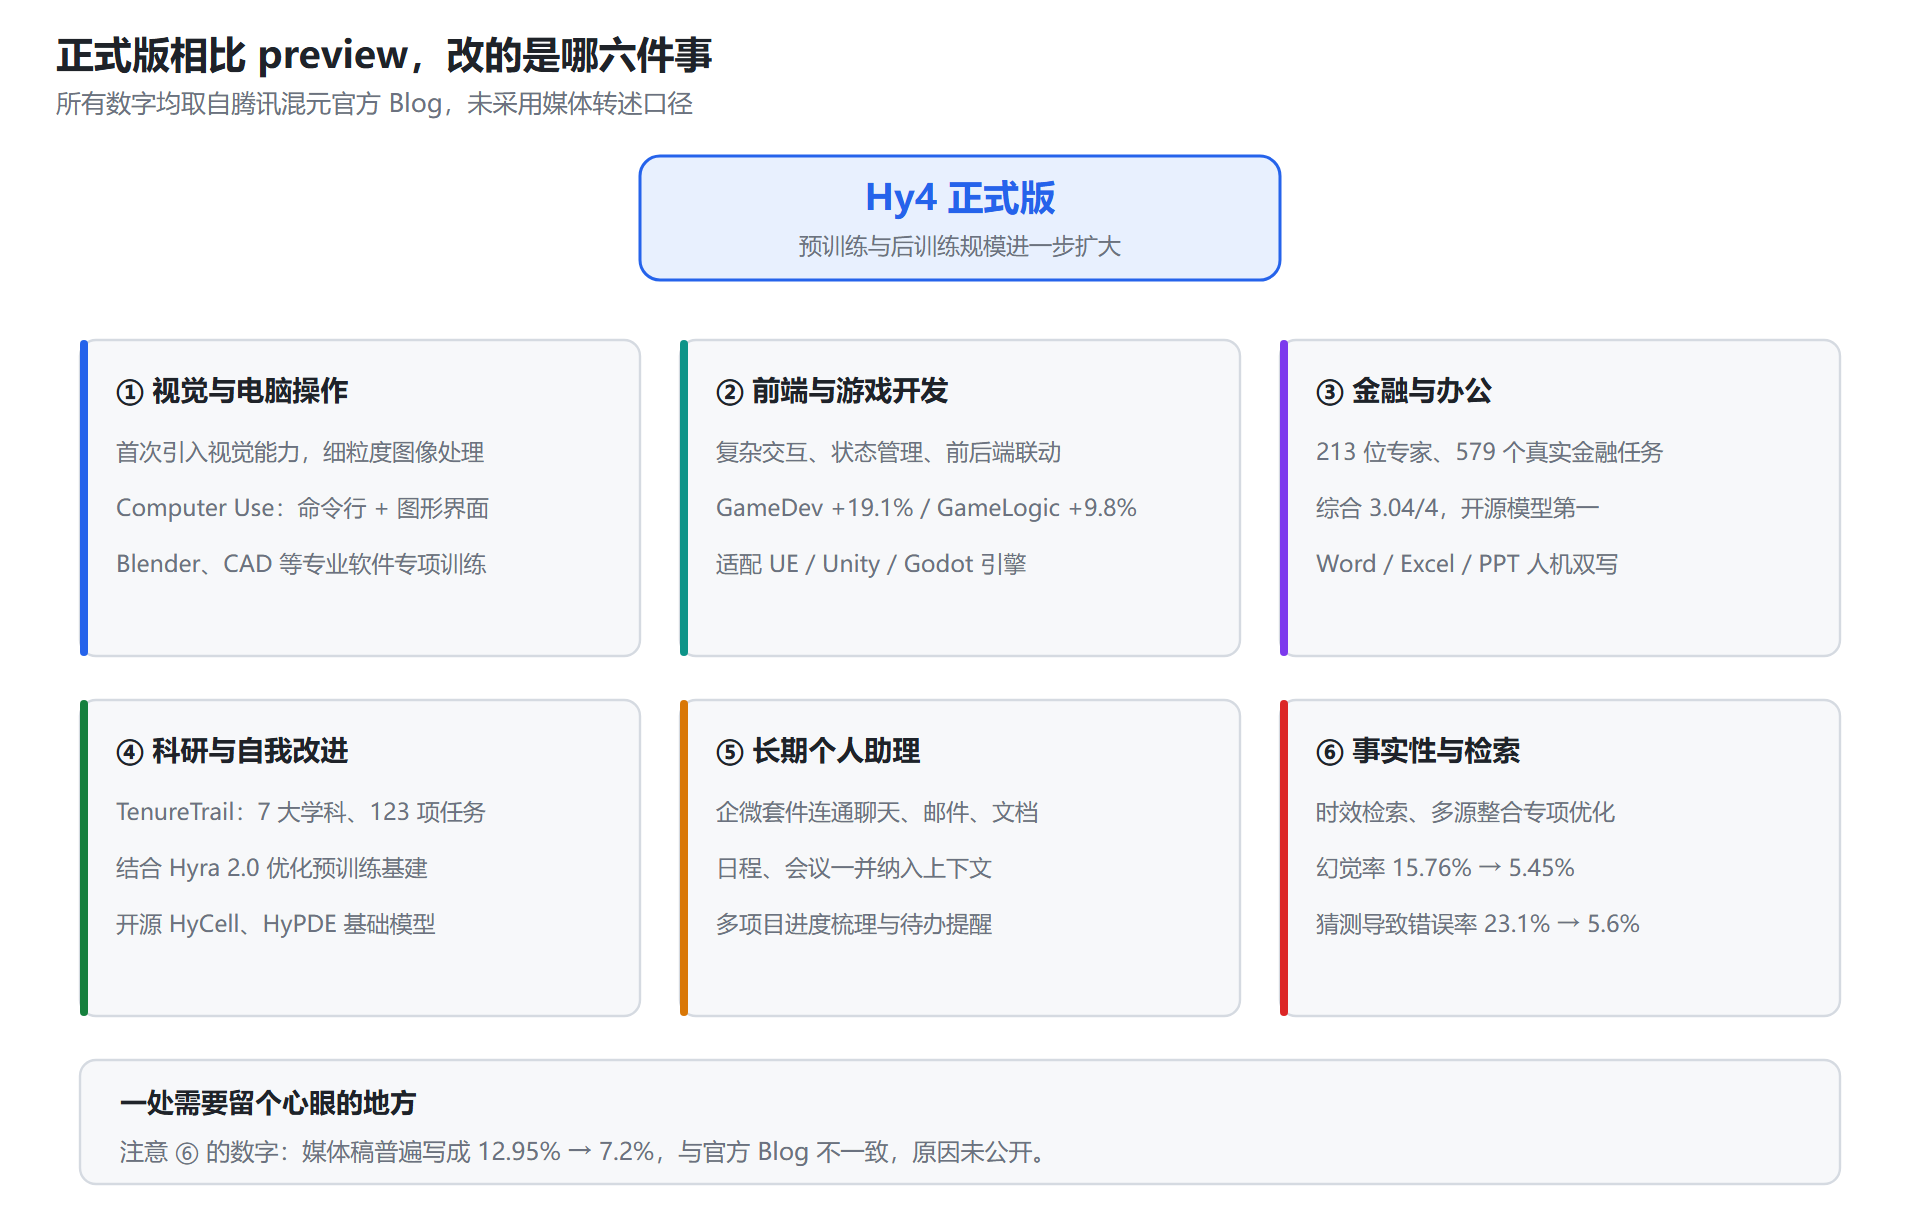
图 3:正式版相对 preview 的六个方向。数字全部取自官方 Blog,没有用媒体转述口径
最实质的变化是视觉。Hy4 首次能看图,而且是「感知 + 推理 + 工具调用」串起来用,不是单纯加一个图片输入通道。同期首次支持 Computer Use,命令行和图形界面一起上,官方还针对 Blender、CAD 这类专业软件以及跨应用长程任务做了专项训练。
游戏那块给的数字很直接:相比 preview,GameDev 提升 19.1%,GameLogic 提升 9.8%,并且适配了 UE、Unity、Godot 三个引擎,开始往多人联机开发扩。这块是和腾讯 IEG 的专业游戏开发者一起调的数据和评测。
金融是我认为整篇 Blog 里最有分量的部分。团队基于真实金融场景建了数千个工作空间和上万个高质量任务,覆盖基金研究、证券分析、量化策略、资产配置、公司金融、财税会计。然后联合腾讯金融科技 FiT 做了 213 位专家的金融众测,其中 153 位来自外部头部金融机构,七成有五年以上经验。579 个真实金融任务跑下来,Hy4 综合 3.04/4,排在 DeepSeek-V4.1-Flash-1017 的 2.97、Kimi K3.1 Pro 和 GLM-5.3 的 2.68 前面,是开源模型第一。讯兔科技的内部 IRAB 评测里,Hy4 比 preview 提升 12.03 个百分点。
办公侧顺带做了人机双写,支持用户和 Hy 实时协作编辑 Word、Excel、PPT。科研侧有覆盖 7 大学科、123 项可执行任务的 TenureTrail,官方说在数学构造、物理建模、地球环境、系统工程等方向位居开源模型第一;还有一个我读了两遍的例子:小鼠胚胎三维重建,84 张无序二维切片、699 万个细胞、带镜像翻转,离线、无专用配准工具、无细胞类型标注,1.5 小时完成对齐与重建,全程无人干预。另外官方开源了由 Hy4 协同 Hyra 2.0 研发的单细胞表征模型 HyCell 和物理场模型 HyPDE。
长期个人助理这块靠 WorkBuddy 的企业微信套件,把聊天记录、邮件、文档、日程、会议连进上下文,用来梳理多项目进展和待办优先级。
三、「跻身第一梯队」,具体在哪一档
官方给了两张图:一张是 12 组 benchmark 柱状图,一张是完整的模型得分表。
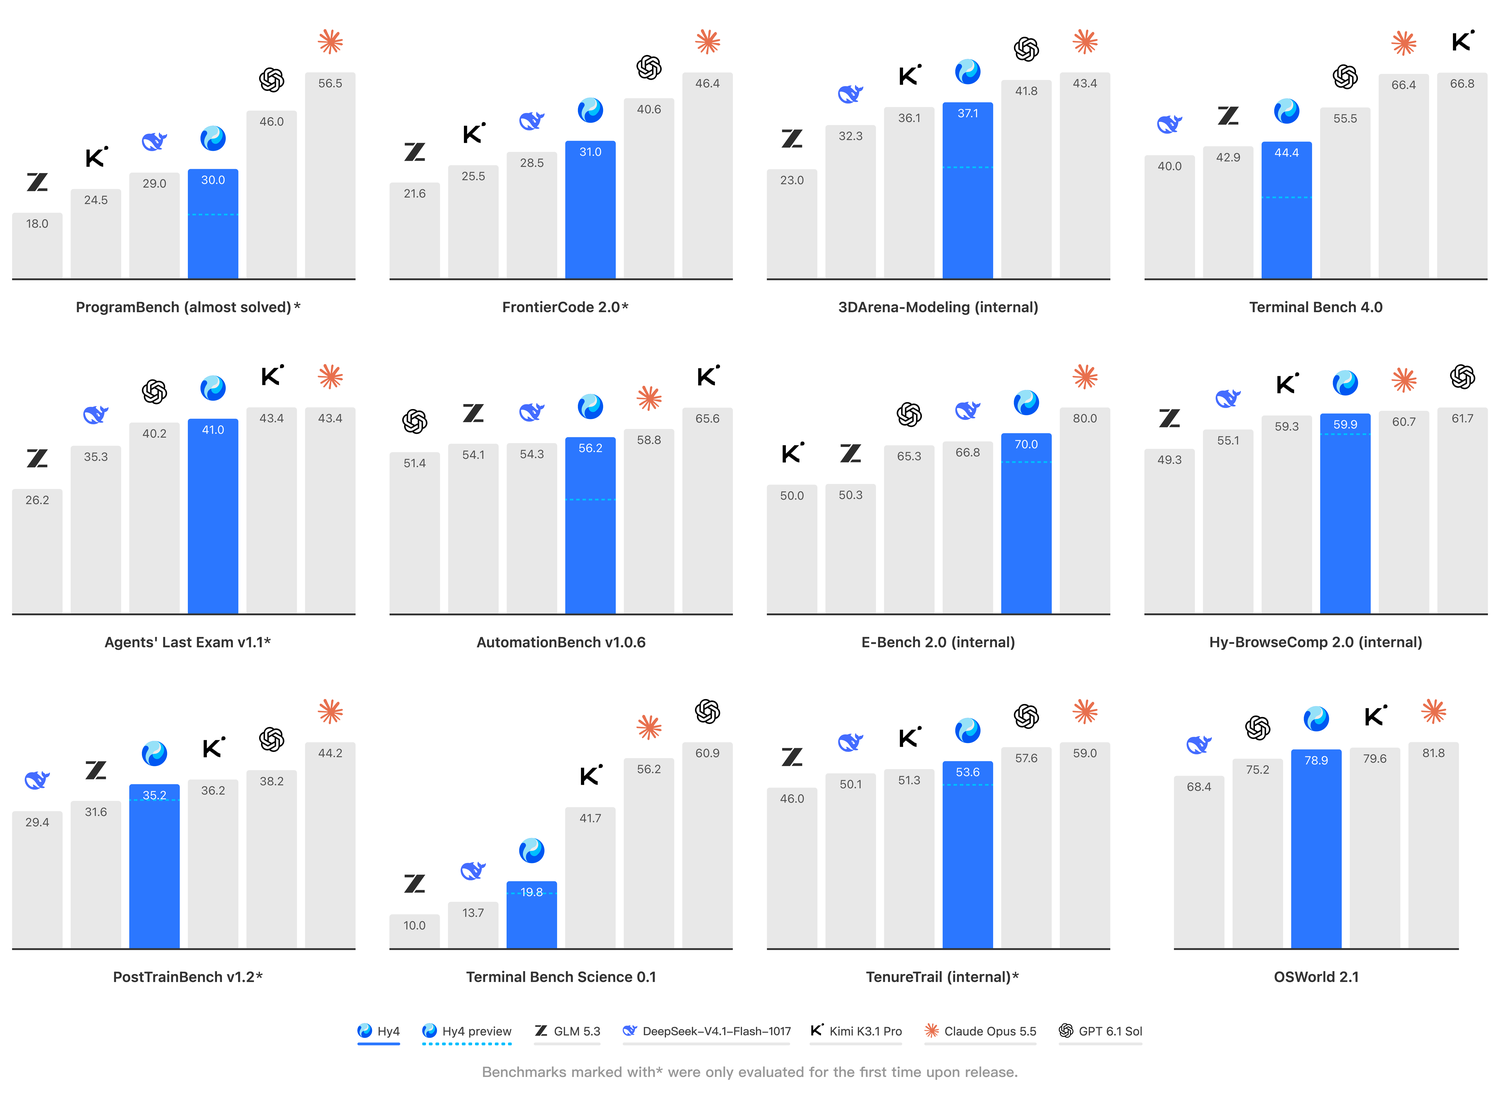
图 4:官方 Blog 的 12 组评测柱状图,蓝色是 Hy4。涵盖 ProgramBench、FrontierCode 2.0、Terminal Bench 4.0、Agents’ Last Exam v1.1、OSWorld 2.1、TenureTrail 等
我从附录表里挑了 6 项 preview 和正式版都有明确数值的,画成对比条。
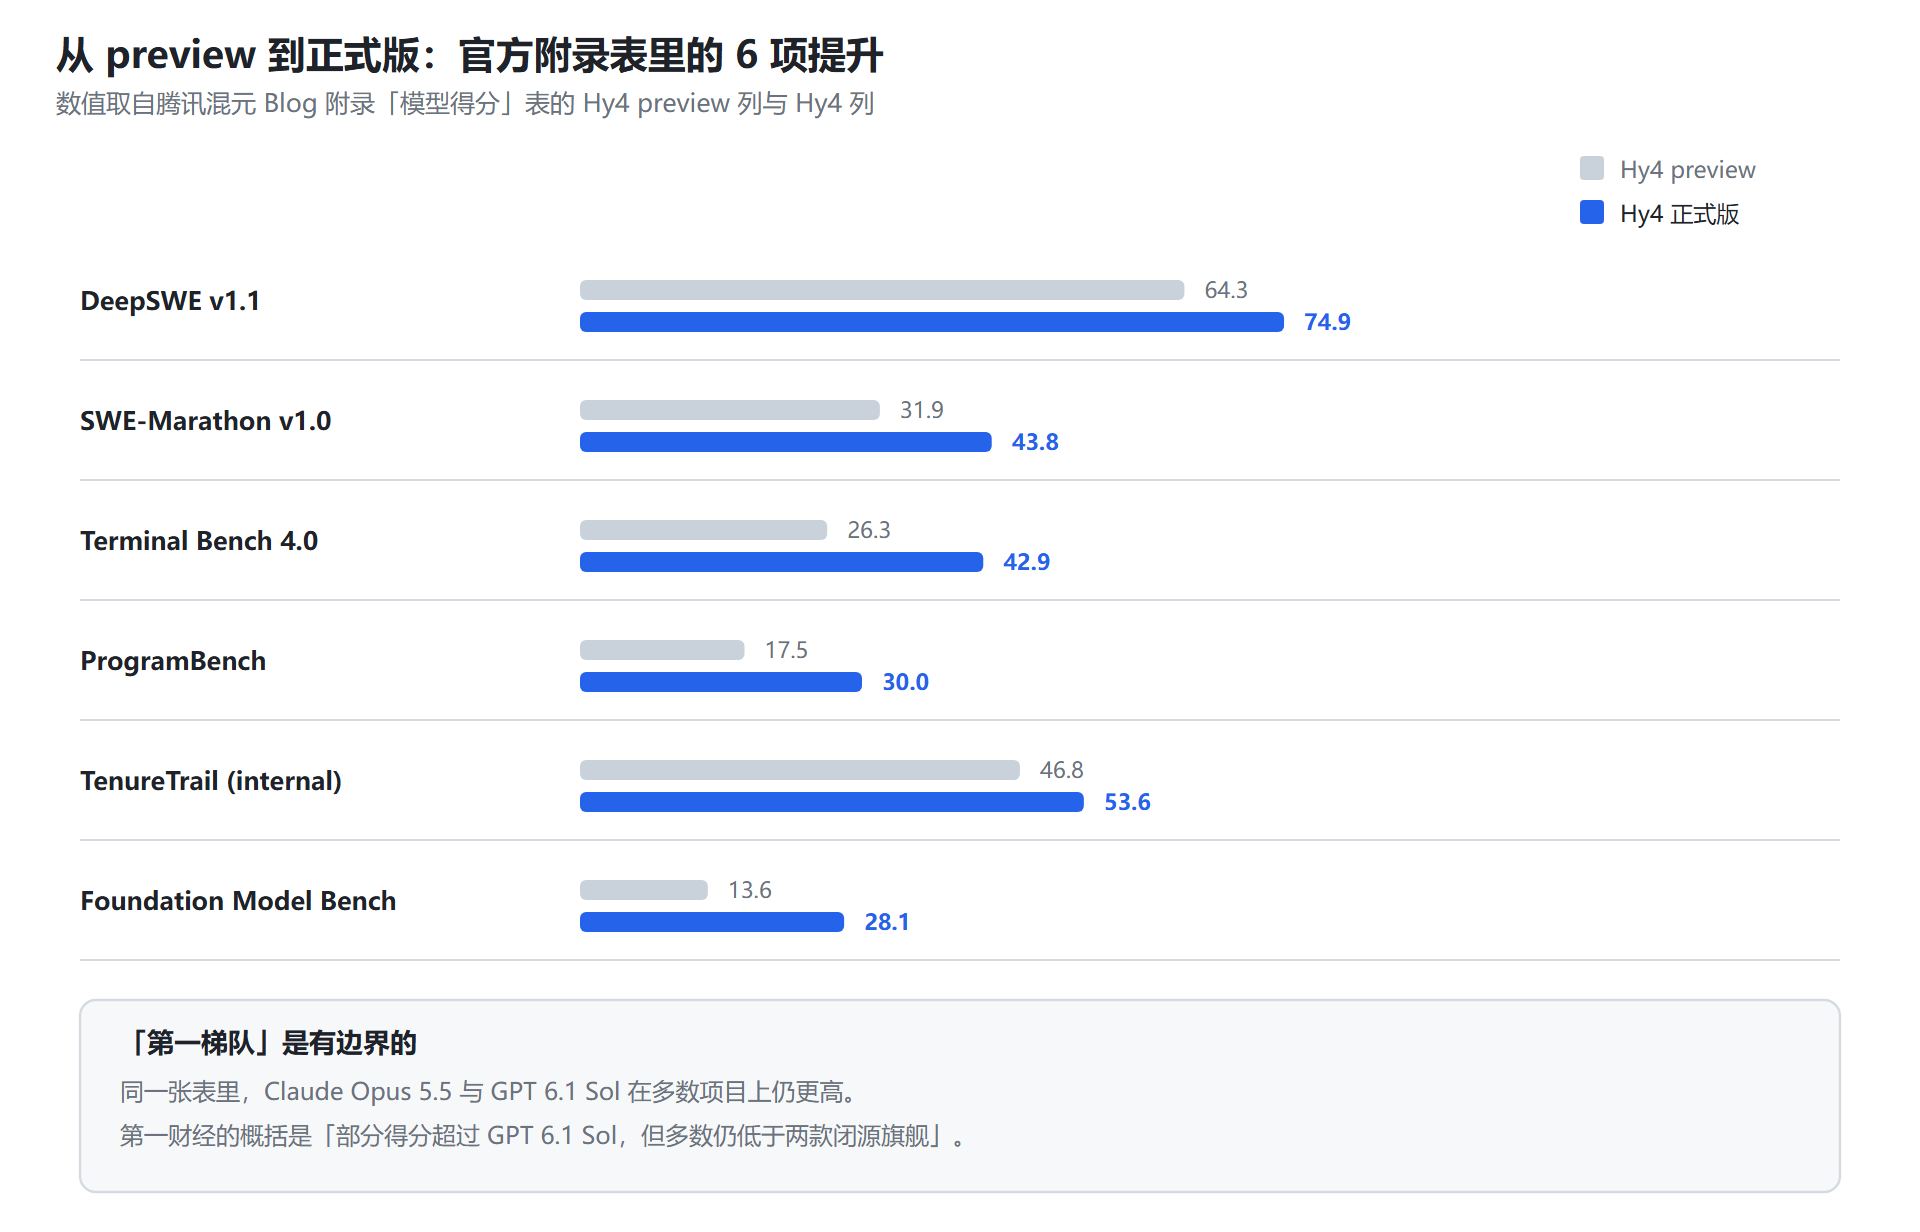
图 5:取自官方 Blog 附录「模型得分」表的 Hy4 preview 列与 Hy4 列,灰色是 preview,蓝色是正式版
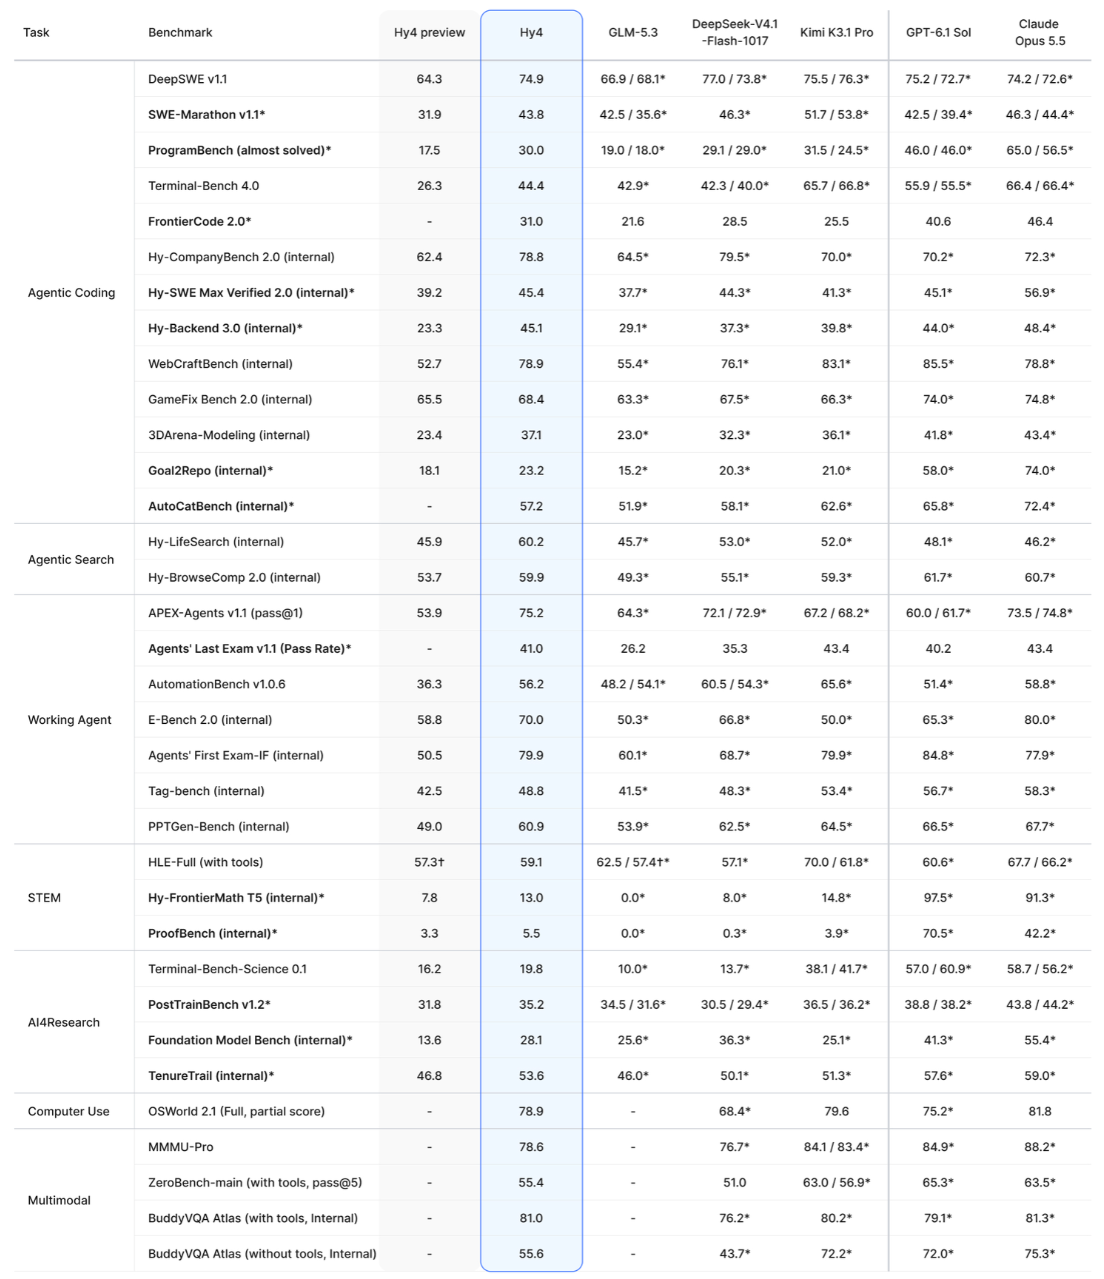
图 6:官方附录模型得分表,对比了 Hy4 preview、Hy4、GLM-5.3、DeepSeek-V4.1-Flash-1017、Kimi K3.1 Pro、GPT 6.1 Sol、Claude Opus 5.5
读这张表有两个坑。表下注释写明,带星号的 benchmark 只在模型首次发布时评测过;部分项目给了斜杠分隔的两个数,对应不同测试配置(比如 xhigh 和搭配 Claude Code 的 xhigh)。所以图 4 的柱状图数值和图 6 表格里的数值有时对不上,不是谁抄错了,是配置不同。别把两组数直接拿去算增幅。
至于「第一梯队」这四个字的边界,第一财经的判断说得比较克制:在 ProgramBench、FrontierCode 2.0、Agents’ Last Exam v1.1 等多项基准中,Hy4 超过 DeepSeek-V4.1-Flash-1017,部分与 Kimi K3.1 Pro 接近,部分超过 GPT 6.1 Sol,但多数基准分数仍低于 GPT 6.1 Sol 和 Claude Opus 5.5。
官方自己写得更直接:
尽管 Hy4 已经是目前最强的开源模型之一,其与顶尖闭源模型仍然存在较大差距,尤其在我们内部构建的前沿数学、长程开发、模型迭代、视觉问答等领域的高难度测试集上。
所以「第一梯队」说的是开源模型内部的排位,不是全模型排行榜的头部。这两句话得放一起读,只截前半句就成了另一篇文章。
四、比跑分更值得看的,是那串真实任务数据
跑分表看多了会麻。我更在意 Blog 里另一组数字,它们来自产品线和外部合作方的内部评测,虽然各家测试集不一样、横向没法直接比,但至少说明模型被放进了真实链路里跑。
WorkBuddy 的综合评测:平均效果 83.18 分,通过率 96.15%,12 个场景里 9 个位列国内模型第一。Manus 的内部评测里,办公文档生成和编辑的任务完成率接近 97%,指令遵循细到引用格式、样式编号、逐条修改说明。
腾讯自家产品的 Co-Design 反馈给了一长串:元宝内部评测集从 65.25 提到 72.53,多轮记忆 +6.67 分、写作多样性 +10.89 分,多模态 Agent 任务完成度提升 36.8%;王者荣耀 20 类游戏配置场景准确率从 91.74% 到 97.28%,Agent 自主校验修复后 99.32%,Bug 根因分析准确率从 59.5% 到 73.8%,工具调用深度是 preview 的 3.7 倍而耗时和 token 没有明显增长;QQ 小 Q 整体满意率 90.11% → 93.10%;微信读书综合评测 82.10 → 87.69;腾讯新闻端到端答案质量提升 36%。
外部金融侧,讯兔 IRAB 用 101 道真实投研任务给出 61.63 分,比 preview 高 12.03 分;进门的内部评测里,Hy4 是唯一在总分上与 Claude Opus 5.5 并列第二的国产模型,数据查询单项 75.4 分排全部参测模型第一;财搭子个股研究场景均分 4.27/5 排参评首位。
这里有一处必须说清楚的口径问题。
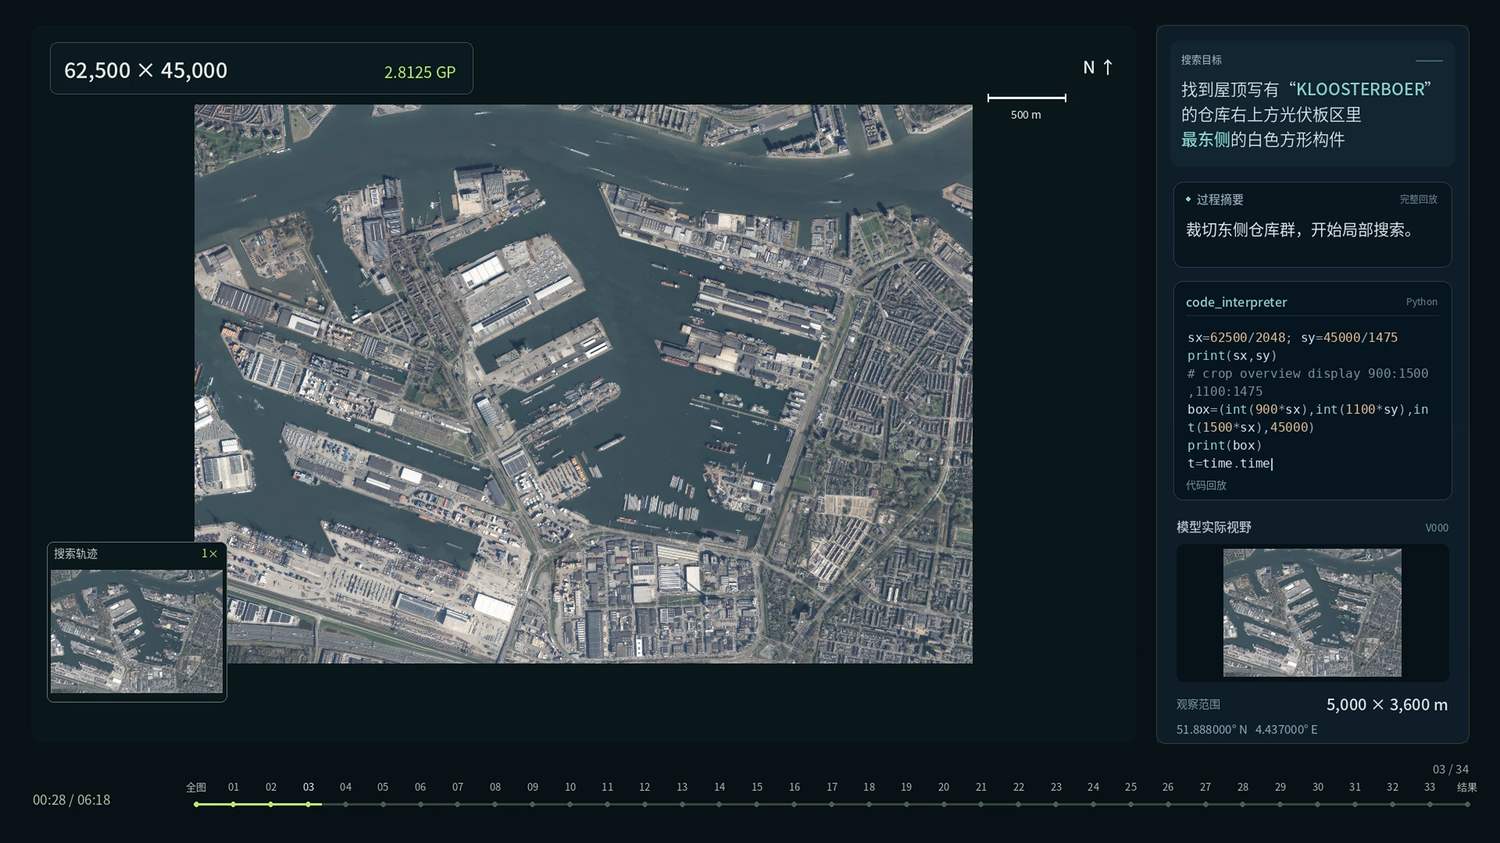
图 7:同一天出现的两套数字。本文一律以官方 Blog 为一手来源
官方 Blog 写的是「幻觉率从 Hy4 preview 的 15.76% 降至 5.45%,猜测导致的错误率从 23.1% 降至 5.6%」。腾讯新闻、第一财经等媒体稿普遍写成「幻觉率从 12.95% 降至 7.2%」,猜测错误率的 23.1% → 5.6% 倒是一致。两套幻觉率数字可能来自不同测试集或者发布前口径,官方没有解释差异。我的处理是不混用、不取平均,正文只引用官方 Blog 那一组。
写技术稿这些年我越来越不敢顺手抄二手数字,这次就是个典型例子:同一场发布会,同一个指标,两句话都能被当成「官方数据」转出去。
五、从「看见」到「动手」
视觉能力到底加到什么程度,看 Demo 比看描述快。
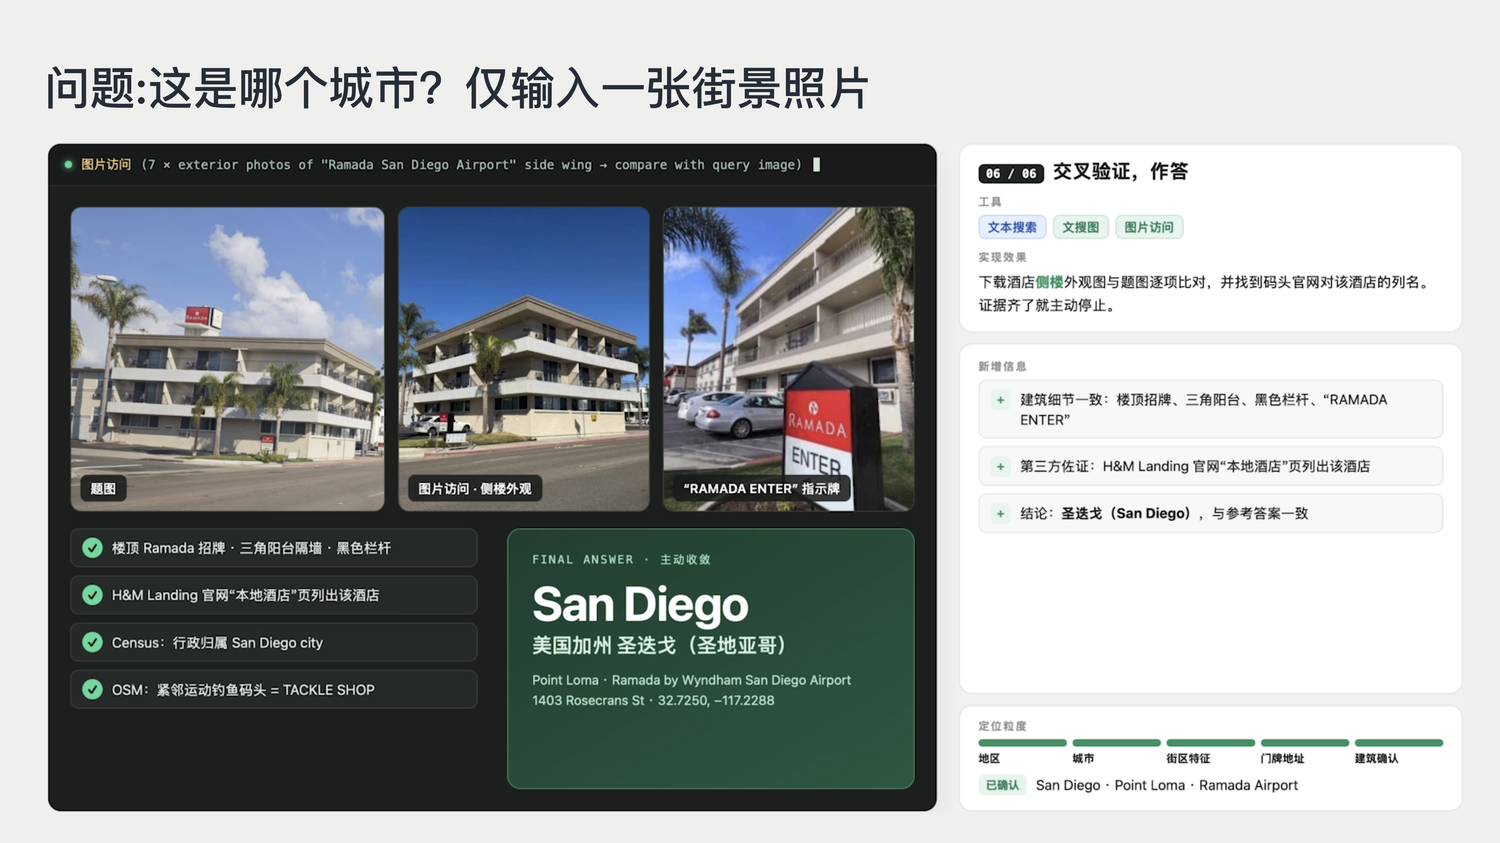
图 8:官方卫星图定位 Demo。提示词是「找到屋顶写有 KLOOSTERBOER 的仓库右上方光伏板区里最东侧的白色方形构件」,右侧能看到探索目标、过程摘要、code_interpreter 的 Python 代码和模型实际视野
这个任务的难处不在认字,在于要在大图里框定区域、放大、逐个排除,还得自己写代码辅助。图里能看出模型是按「先定位仓库 → 圈光伏板区 → 找最东侧白色方形构件」一步步做的,中间调了工具。
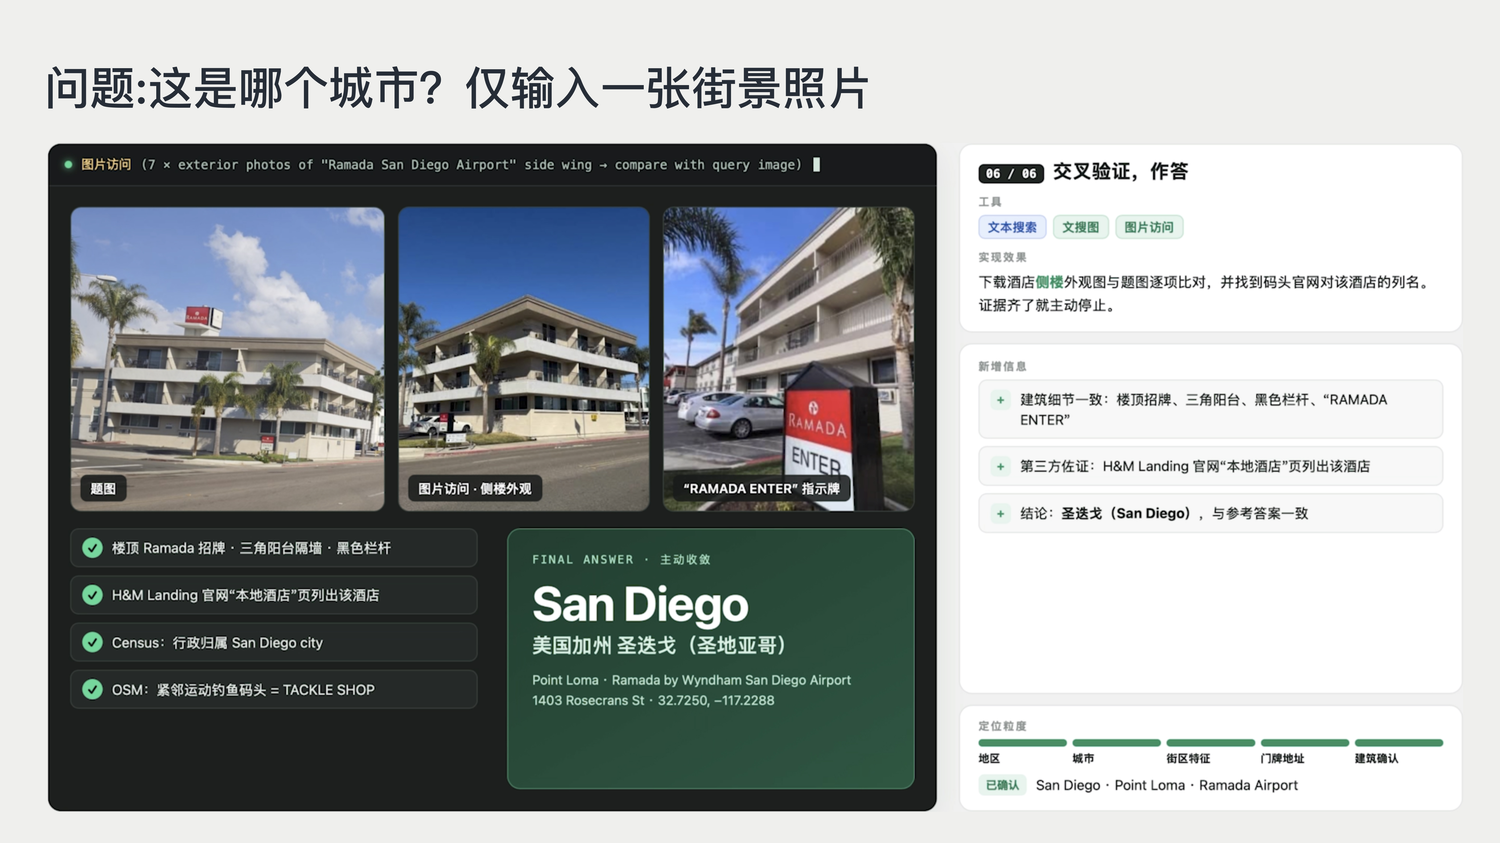
图 9:街景定位 Demo,模型从 San Diego、Ramada 等线索做 86/86 交叉验证,最后给出「圣迭戈(San Diego)」
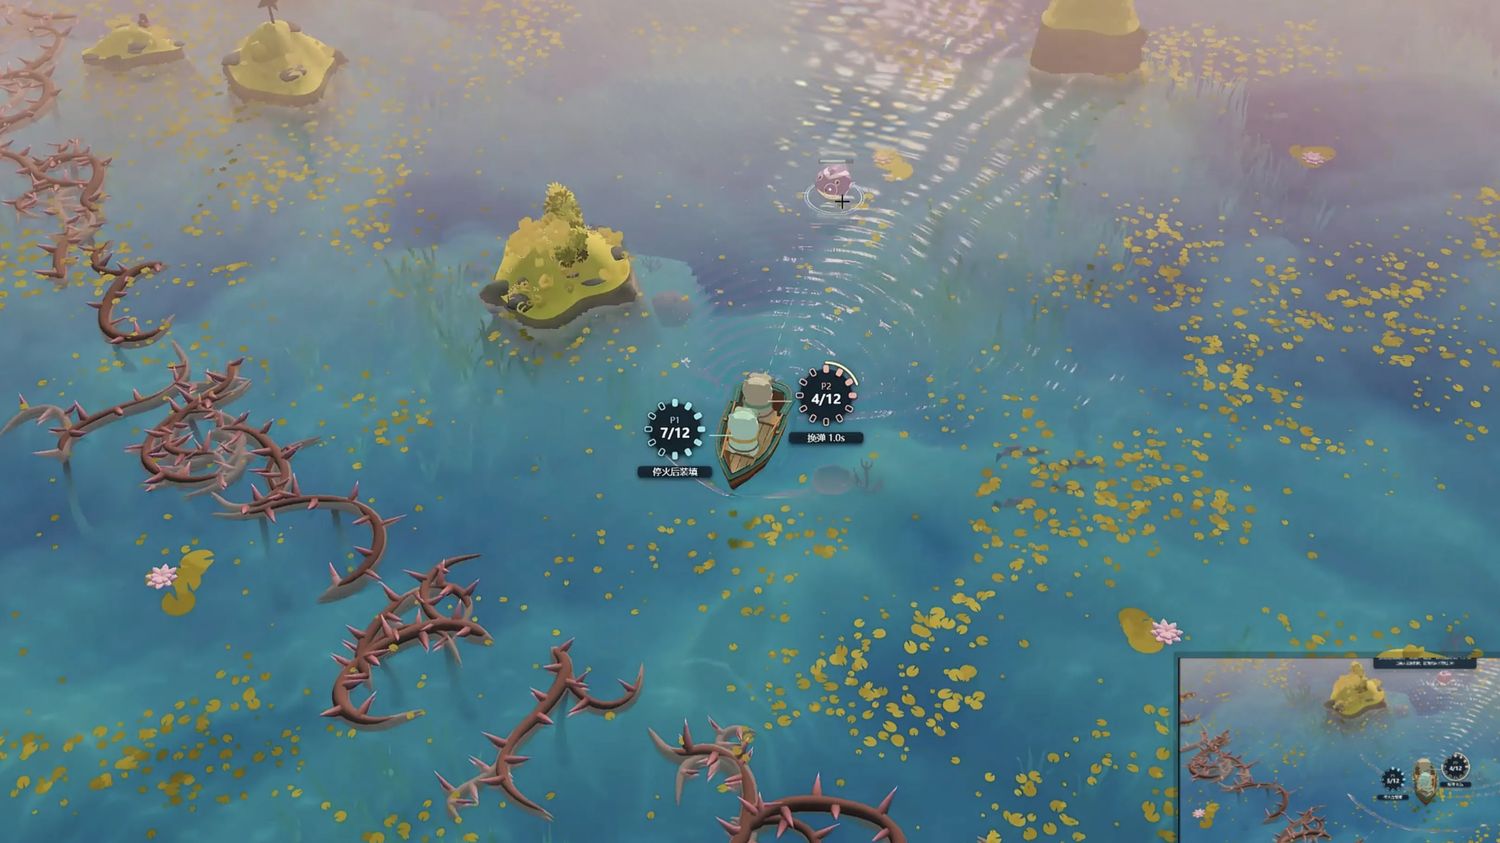
图 10:游戏开发场景的 3D 输出,对应官方和 IEG 合作的前端与游戏能力优化
官方 Blog 里还贴了几段完整的提示词,我建议原样读一遍。比如「腾讯企鹅岛 3D 数字沙盘」那条,要求交付一个可离线双击打开的单文件 HTML,内联 Three.js 0.184.0、零 CDN / 字体 / 纹理依赖,所有建筑、道路、绿脊、海岸、植被、人车必须在同一套真实三维场景里,还逐条约束了五组建筑的形态,其中腾讯螺旋特别注明「绝不能套外挂圆环或做成四根麻花」。另外两条分别是用 global-equity-research 和 neodata 做特斯拉估值建模并输出 Excel 和 PDF,以及综合聊天、邮件、日历、会议、文档生成 Daily Focus 单文件看板。
提示词写成这个长度,本身就说明官方评测的目标不是单轮问答,是长约束、多工具、要交付实物的任务。这跟「首次引入视觉」放在一起看,才对得上。
媒体那边也做了四道实测题,不是官方评测,测试集和评分标准都没公开,横向没法比,但有两个细节我记下来了。第一财经那篇稿子给 Hy4 一张虚构公司的业绩宣传图,让它像财经编辑一样核查:模型算出「营收增长 80%」实际只有 25%,「利润翻倍」实际是下降 40%,还指出纵轴从 110 起而不是从零起会夸大增幅,最后补了一句,能算的只是给定数字之间的关系,凭这张图确认不了企业真正的净利润。另一道题故意设成不可能完成:三条线加起来 555 分钟的任务,塞进 9 点到 17 点那 480 分钟。模型没有硬凑一份全能按时交的完美时间表,而是指出任务本身冲突,给出三套总超时 300 / 360 / 450 分钟的方案,建议由负责人批准延期,顺带说了句「别在排序里找平衡,去把不可行的截止时间改成可行的」。
一个永远答应用户要求的 Agent,反而不好用。信息不足时说「这里我没看清」,目标冲突时说「做不到」,这比多几分跑分更影响日常体验。官方 Blog 里幻觉率和猜测错误率那组下降,指向的其实也是同一件事。
六、价格没动,入口变多了
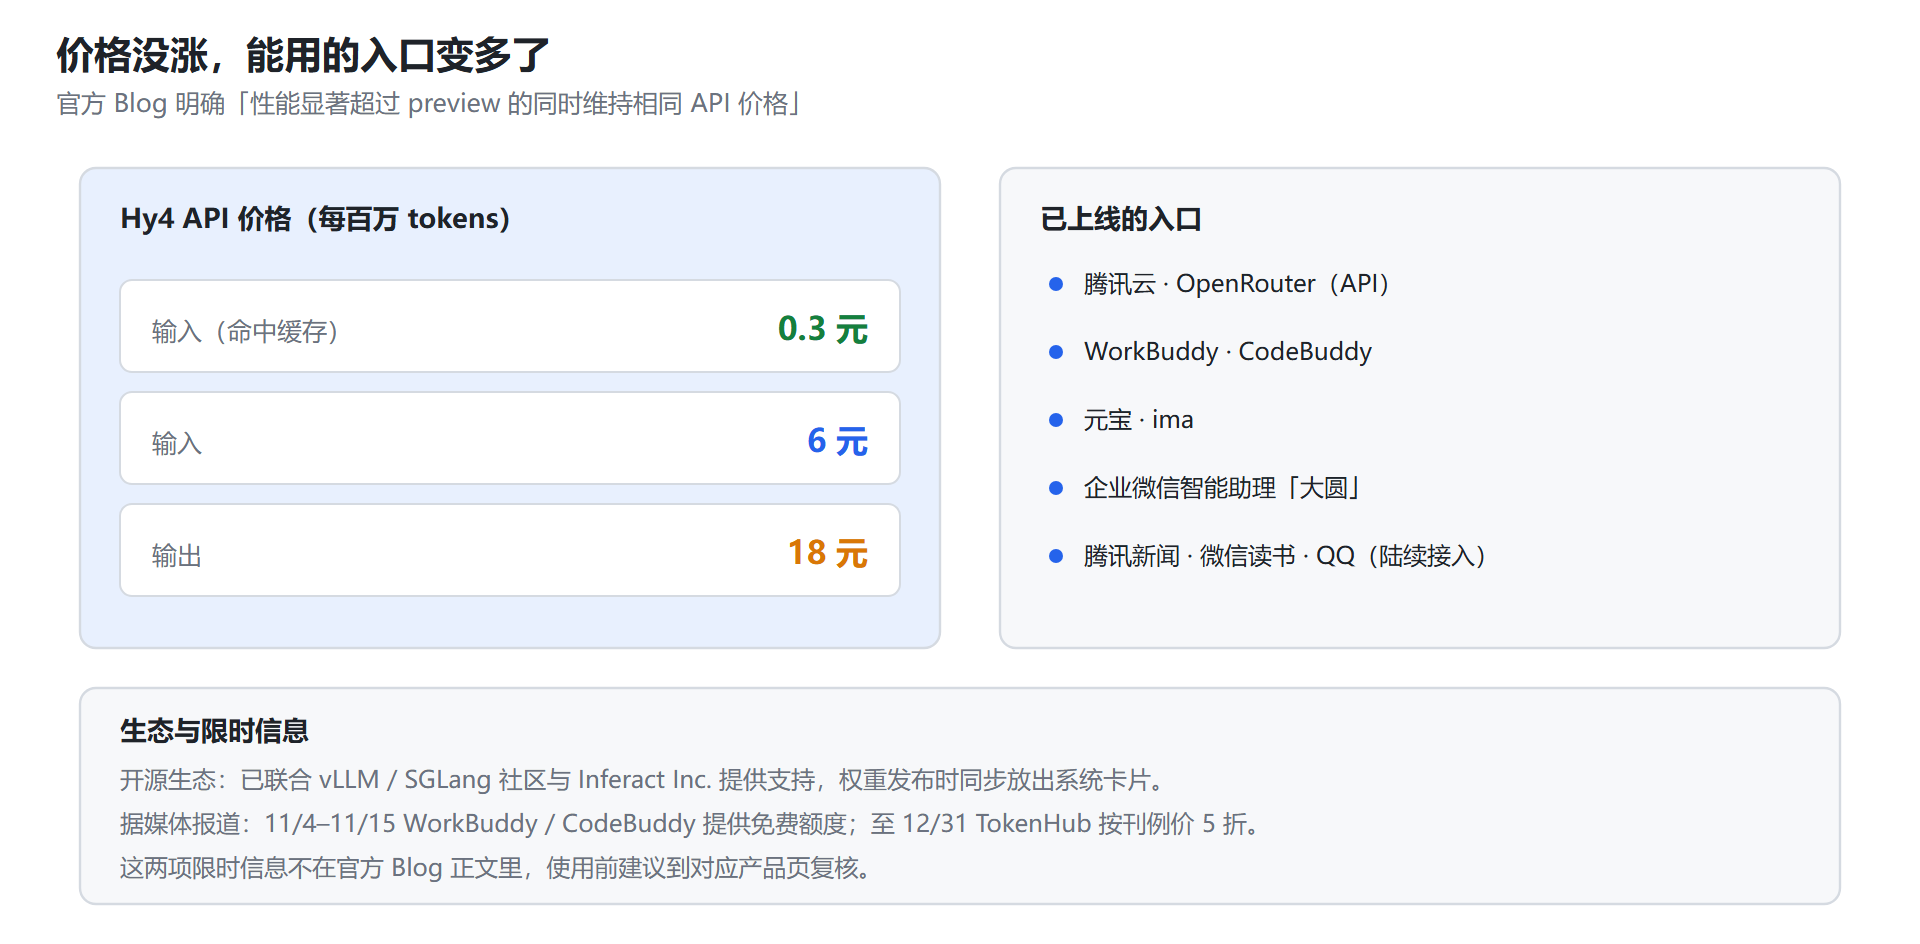
图 11:官方 API 定价、已上线入口、开源生态与限时信息。限时两项来自媒体报道,不在官方 Blog 正文里
官方 Blog 的原话是「性能显著超过 Hy4 preview 的同时维持相同 API 价格」:每百万 tokens,输入命中缓存 0.3 元、输入 6 元、输出 18 元。上线渠道是腾讯云和 OpenRouter,产品侧可在 WorkBuddy / CodeBuddy、元宝、ima 体验。开源生态那头已经联合了 vLLM / SGLang 社区和 Inferact Inc.,系统卡片会跟着权重一起发。
据媒体报道,11 月 4 日到 15 日 WorkBuddy / CodeBuddy 提供一定额度免费使用,即日起至 12 月 31 日 Hy4 在腾讯云 TokenHub 按刊例价 5 折计费。这两条不在官方 Blog 正文,用之前建议去对应产品页再核一次。
我倒觉得「价格不变」这件事比跑分涨几分更实在。存量调用可以原样平移,不用重算成本模型,也不用先说服财务。
七、把安全边界写进发布稿
「负责任的开源和发布」是官方 Blog 里独立的一章,不是附在末尾的免责声明。
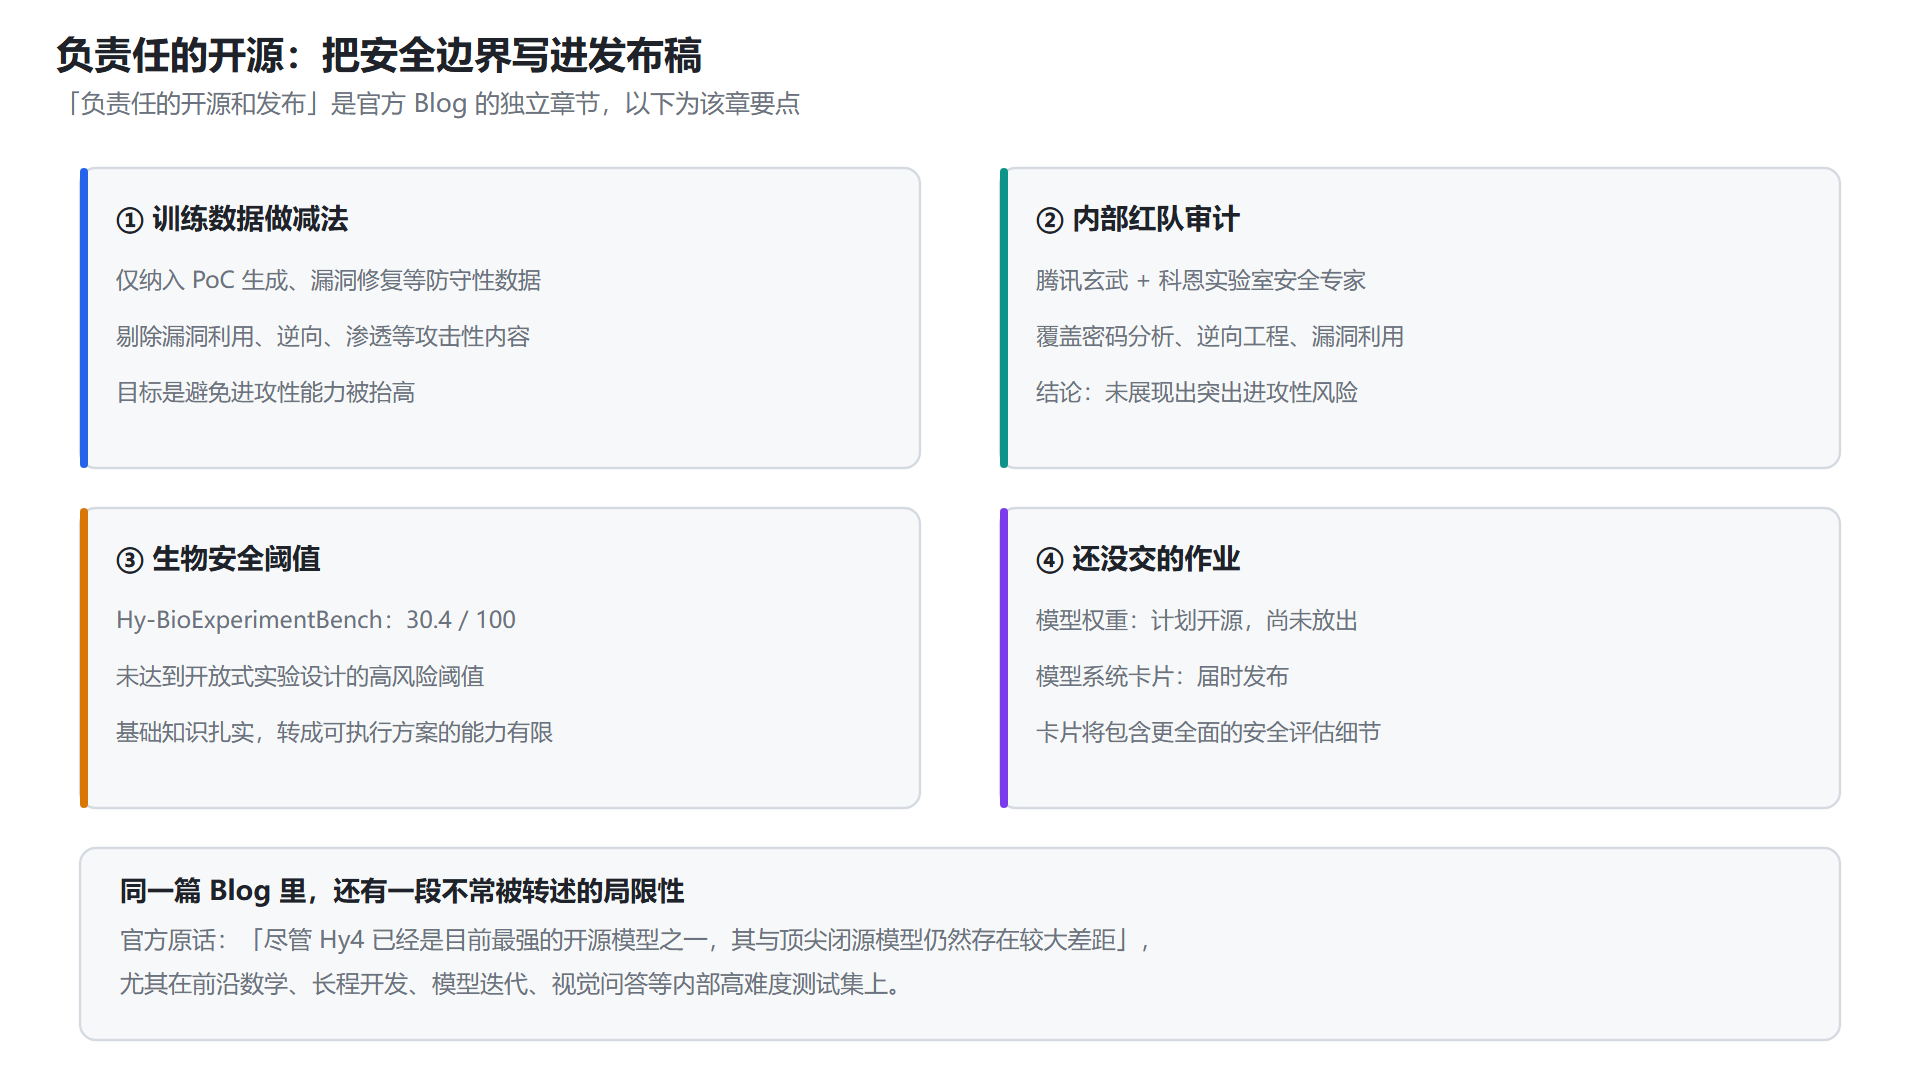
图 12:官方安全章节的四个要点,加上同一篇 Blog 里那段常被漏掉的局限性
训练阶段只纳入 PoC 生成、漏洞修复相关的防守性网络安全数据,主动剔除漏洞利用、逆向、渗透这类攻击性内容。腾讯玄武和科恩实验室的内部安全专家围绕密码分析、逆向工程、漏洞利用做了审计,结论是 Hy4 在加密算法逆向求解、对抗二进制混淆、漏洞利用上没展现出突出风险。生物安全侧给了个具体数:Hy-BioExperimentBench 30.4/100,未达开放式实验设计的高风险阈值;专家审作答轨迹后发现,模型基础生物知识扎实,但把知识转成可执行实验方案这一环仍然有限。
当然官方还留了个尾巴:Hy4 flash 计划近期发布,主打性价比和推理速度,会更频繁地和产品协同迭代。参数、日期、许可证都没说。我就不猜了,权重计划开源、系统卡片届时发布,卡片里会包含更全面的安全评估。。





评论前必须登录!
注册