 网硕互联帮助中心
节点维护与节点突然失联需要不同的恢复路径。前者可以先停止接入新请求并排空,后者常常无法确认旧执行是否已经结束。把两种情况都写成“重建 Pod”会漏掉流式响应和资源账本的状态。
主动退出先撤销接流资格
维护流程先把目标实例置为 Draining,路由器不再向它分配新请求。已有请求保留执行租约,继续运行到完成或排空截止时间。应用同时拒绝在旧连接上创建新的生成任务,避免连接复用绕开排空。
路由变化需要传播时间,实例本身也要检查 Draining 状态。只在控制面移除一个地址,不能保证所有缓存路由的网关立即停止发送。拒绝时返回可识别的退出原因,让尚未执行的请求重新调度。
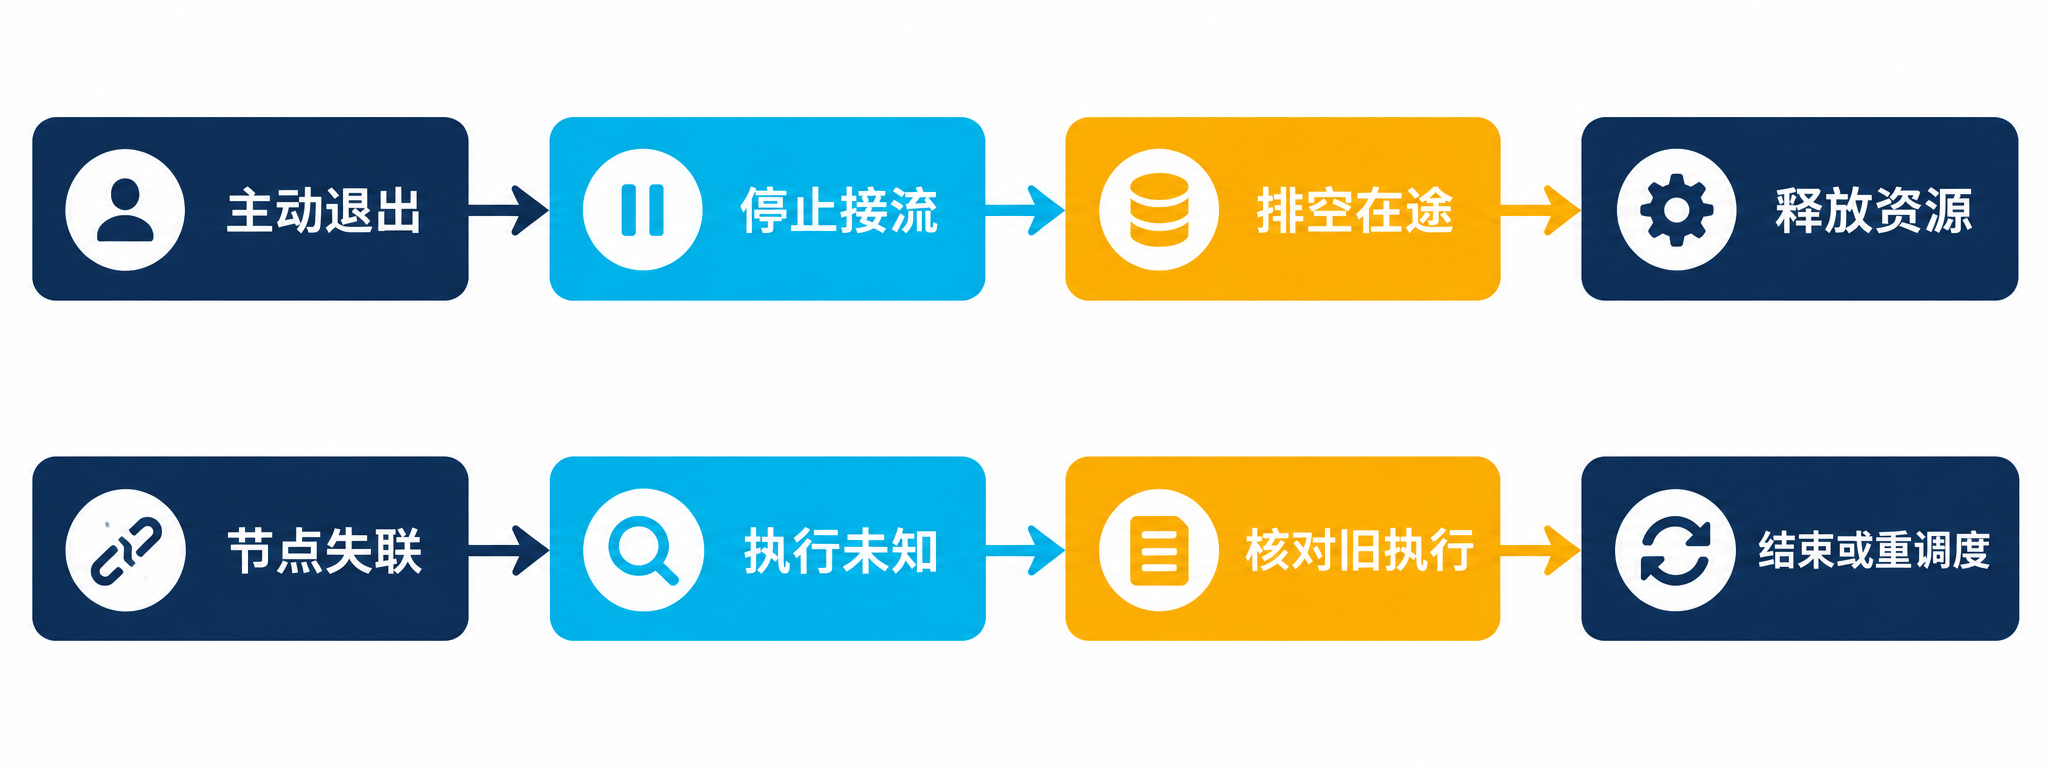
图示对应本文的应用层协调逻辑,各状态的前提仍需由控制器逐项校验。
退出过程留下一条状态链
记录节点与 Pod UID、退出原因、开始排空时间、剩余在途数和终止时间。请求记录关联具体执行实例,不能只写容易复用的 Pod 名。节点重建后同名资源并不代表旧执行已恢复。
Active → Draining → 等待在途结束 → 释放应用资源 → Stopped
节点失联 → ExecutionUnknown → 核对旧执行 → 结束或重调度
Kubernetes 的终止宽限期包含 preStop 执行时间;超过宽限期后进程可能被强制终止。应用的排空预算应小于整体宽限期,并留出清理时间。Pod 终止流程
突然失联保留未知状态
监控断开不能证明 GPU 上的工作立即停止。控制面先把实例排除出新请求候选,再把该实例的在途执行标记为未知。资源租约由具备生命周期信息的协调任务处理,不由客户端超时直接释放。
尚未输出且无副作用的请求,可以在确认旧执行停止后受控重试。已经输出部分内容的流式请求应返回中断,不能无协议地切到另一节点继续拼接。若支持持久化检查点恢复,接口还必须定义检查点版本、输出序列和重复事件处理;没有这些条件就不要声称无感恢复。
集群保护不等于请求保护
PodDisruptionBudget 可以约束一部分自愿中断流程,但不会为任意硬件故障保证副本数量,也不会自动迁移正在执行的请求。Disruptions 官方说明
诊断时把“副本恢复”和“请求恢复”分开:新 Pod 已 Ready 只证明新容量出现,旧请求可能仍处于中断或未知状态。分别统计排空完成率、被中断请求、未知执行存留时间以及新实例就绪耗时,才能判断退出流程哪里没有闭合。


评论前必须登录!
注册