 网硕互联帮助中心
把没作答的题剔掉,榜单第二冲到了第一(模型评测口径)
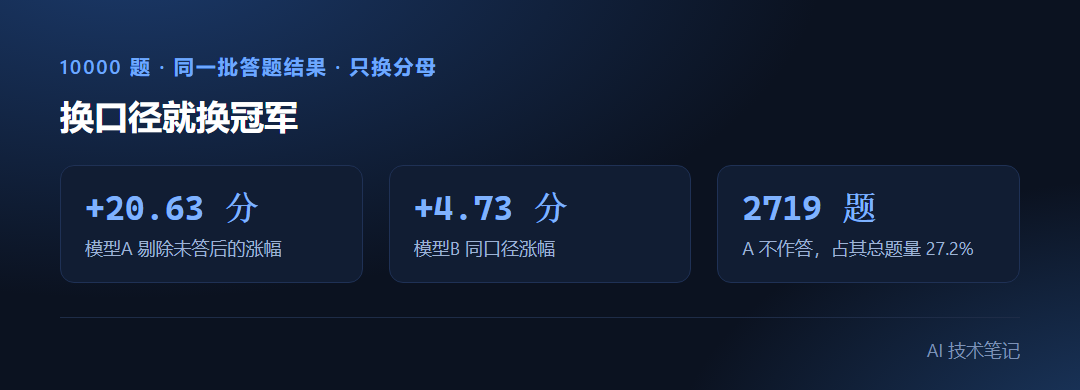
同一套题、同一批答题结果,我把“没作答的题”从分母里去掉之后,两个模型的排名直接调了个头:A 从 55.25 分涨到 75.88 分,B 只从 55.81 涨到 60.54。差别不在模型能力,只在算分的那一行代码。这篇把三种口径的差异、它们各自在什么时候骗人,以及小集子怎么翻盘,用一段 30 行的 Python 说清楚,你能直接拿去套自己的评测表。
我手上有一批跑完的评测结果,三个数据集一共 10000 题。A 模型爱说“这个我没法回答”,数学题里三成题直接不作答;B 模型什么都答,但答得糙。我按“答对的题占全部题数”算了一遍,B 高 0.56 分,我准备写结论说 B 略强。
同事问了一句:不作答的题你算错了还是没算?我改了那行分母,结论反了。
这不是个例。几乎所有对外报的模型分数,都藏着一个不写在表格里的选择:没答的题去哪了。
三个口径,三个冠军
先看数据。下面是一次模拟跑出来的真实输出,脚本用固定随机种子,谁跑都是这几个数:
"""模型评测口径:同一批结果,三种算法三个结论。"""
import random
# (数据集, 题数, A答题正确率, B答题正确率)
DATASETS = [("数学推理", 9000, 0.74, 0.58),
("常识问答", 800, 0.90, 0.86),
("代码生成", 200, 0.68, 0.52)]
# 两个模型各自的不作答比例
REFUSE = {"A": (0.30, 0.02, 0.18), "B": (0.08, 0.03, 0.10)}
rng = random.Random(20261101)
rows, tot = [], sum(n for _, n, _, _ in DATASETS)
for i, (name, n, pa, pb) in enumerate(DATASETS):
rec = {"name": name, "n": n}
for t, p in (("A", pa), ("B", pb)):
skip = sum(1 for _ in range(n) if rng.random() < REFUSE[t][i])
answered = n – skip
right = sum(1 for _ in range(answered) if rng.random() < p)
rec[t] = (skip, answered, right)
rows.append(rec)
for t in ("A", "B"):
skip = sum(r[t][0] for r in rows)
ans = sum(r[t][1] for r in rows)
right = sum(r[t][2] for r in rows)
macro = sum(r[t][2] / r[t][1] for r in rows) / len(rows)
print(f"模型{t} 不作答 {skip:>5} 作答 {ans:>5} 答对 {right:>5} "
f"未答计为错 {right/tot:.4f} 剔除未答 {right/ans:.4f} 宏平均 {macro:.4f}")
print(f"总题数 {tot}")
运行结果:
模型A 不作答 2719 作答 7281 答对 5525 未答计为错 0.5525 剔除未答 0.7588 宏平均 0.7623
模型B 不作答 781 作答 9219 答对 5581 未答计为错 0.5581 剔除未答 0.6054 宏平均 0.6509
总题数 10000
三种口径摆在一起:
| 未答计为错 | 全部 10000 题 | 0.5525 | 0.5581 | B | 不作答按错题处理,来源同上脚本 |
| 剔除未答 | 实际作答的题(A 7281 / B 9219) | 0.7588 | 0.6054 | A | 只算答过的题,来源同上脚本 |
| 宏平均 | 每个数据集等权,各集内剔除未答 | 0.7623 | 0.6509 | A | 三个数据集答题率求平均 |
同一批答对的题,换个分母 A 涨 20.63 分,B 只涨 4.73 分,因为 B 几乎不作答,分母没怎么变。一个模型越爱沉默,“剔除未答”这个口径就把它捧得越高。
反过来,“未答计为错”惩罚的是态度问题:不敢答当错。这两种都合理,取决于你评测想回答什么问题。想问“能不能用”,未答等于没产出,计错;想问“模型会不会”,剔除更合适。坑在于两种都发出来、又不写清口径的时候,读者只能看见分数看不见分母。
宏平均和微平均,13% 的概率给出不同冠军
第二个分歧跟拒答无关,是分权重的方式。把全部答对的题数除以全部题数,这是微平均;先算每个数据集的正确率再求平均,这是宏平均。题库集子越多、各集大小越悬殊,这两个数越容易各说各话。
我跑了 20000 组随机配置(每组 2~4 个数据集,每集 8~4000 题,准确率随机),统计两种平均给出的第一名是否一致:
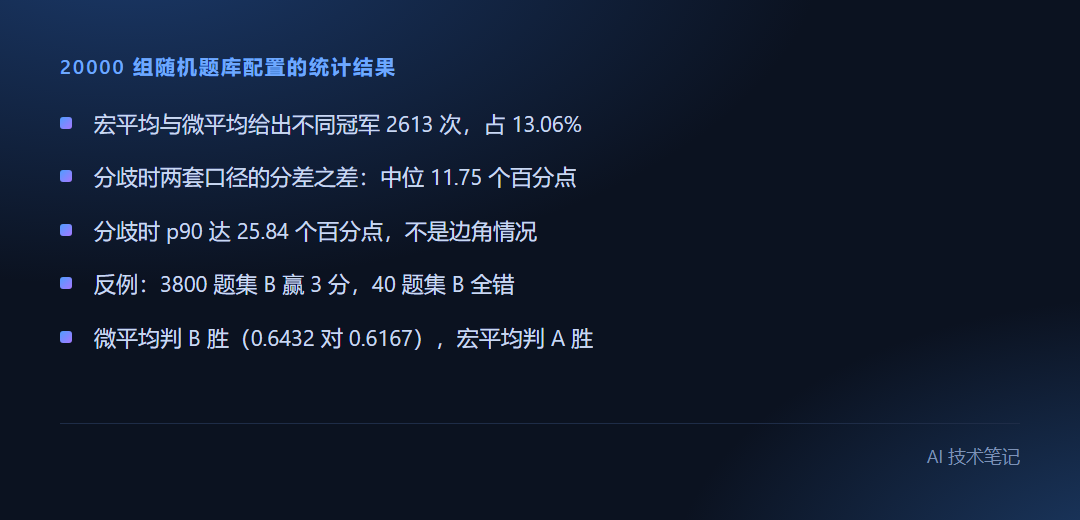
20000 组随机题库(每集 8~4000 题、准确率随机):宏平均与微平均给出不同冠军 2613 次 = 13.06%
分歧出现时,两套口径分差之差:中位 0.1175,p90 0.2584
差不多每八次就有一次换冠军,而且真换的时候两边差距不小(分位中位 11.75 个百分点)。原因很直白:一个 4000 题的大集子能压住一个 8 题的小集子,宏平均里它们各占一票。
给个能心算的反例。题数 [3800, 40],A 在两个数据集上的正确率 [0.62, 0.30],B 是 [0.65, 0.00]:
小集子压倒大集子的反例(题数 [3800, 40]):A 各集 [0.62, 0.3],B 各集 [0.65, 0.0]
微平均 A 0.6167 B 0.6432 -> B 胜
宏平均 A 0.4600 B 0.3250 -> A 胜
B 在 3800 题的大集上赢 3 分,在 40 题的小集上全错。微平均只看总量,判 B 好;宏平均一视同仁,判 A 好。哪个对?看你在不在乎那个小集子——如果它恰好是你业务里最关键的那类题,宏平均是对的;如果它只是凑数的边缘题,微平均更诚实。
题量不够,前面这些结论都是噪音
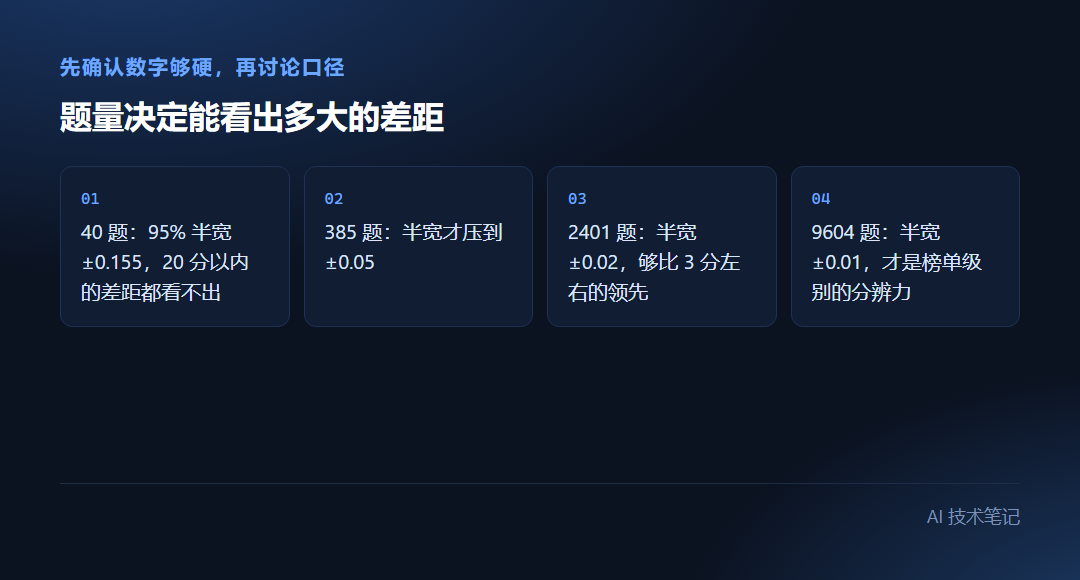
还有个更容易忽略的问题:数据集太小,算出来的分差根本不可信。95% 置信区间的半宽近似 1.96 * sqrt(0.25/n),n 是题数。我把几个常见规模代进去:
| 10 | ±0.3099 | 62.0 分 |
| 20 | ±0.2191 | 43.8 分 |
| 50 | ±0.1386 | 27.7 分 |
| 100 | ±0.0980 | 19.6 分 |
| 200 | ±0.0693 | 13.9 分 |
| 800 | ±0.0346 | 6.9 分 |
| 9000 | ±0.0103 | 2.1 分 |
半宽压到 ±0.05:每个数据集至少约 385 题
半宽压到 ±0.02:每个数据集至少约 2401 题
半宽压到 ±0.01:每个数据集至少约 9604 题
回看前面那个反例:40 题的小集子,半宽 ±0.155。它拿一票去翻 3800 题的大集子,本身就建立在噪音上。我一开始挑口径挑得起劲,其实先该问的是这堆数字够不够硬。
我怎么用它
我现在的做法是把“口径”写死在脚本里,一张表出四个数,不让自己临场选:
- 微平均(未答计为错)、微平均(剔除未答)、宏平均两个版本,四列一起印出来。哪列赢一目了然,我就不好意思再挑对自己有利的那列了。
- 不作答单独统计一行。我把拒答率当成一个跟正确率同级的指标看,而不是错误。一个 76% 正确率、三成题不作答的模型,接进生产就是三成工单要人工兜底。
- 每个数据集后面跟一列半宽,小于 5 个点的分差直接不下结论。这条最实用,砍掉了我大半无效对比。
踩过的坑有两个。第一,我一开始把“解析失败”归进未答,导致一批格式没对齐的输出被算成模型不会做,分母一改动,两个模型名次又换了。后来把未答拆成“模型主动拒答”和“输出无法解析”两类分开统计,前者算能力问题,后者算工程问题。第二,宏平均要显式剔除空集:某个数据集如果模型全不作答,right/answered 直接除零。我当时的处理是给这个集子记 0 分而不是跳过,跳过会让剩下的集子权重变大,反而抬高总分。这个细节很容易写错,值得单独测一遍。
至于哪种口径“正确”,我的看法是没有答案,只有选择。凡是只报一个数、不报分母的评测,我会默认它没说的那句话对它不利。



评论前必须登录!
注册