 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
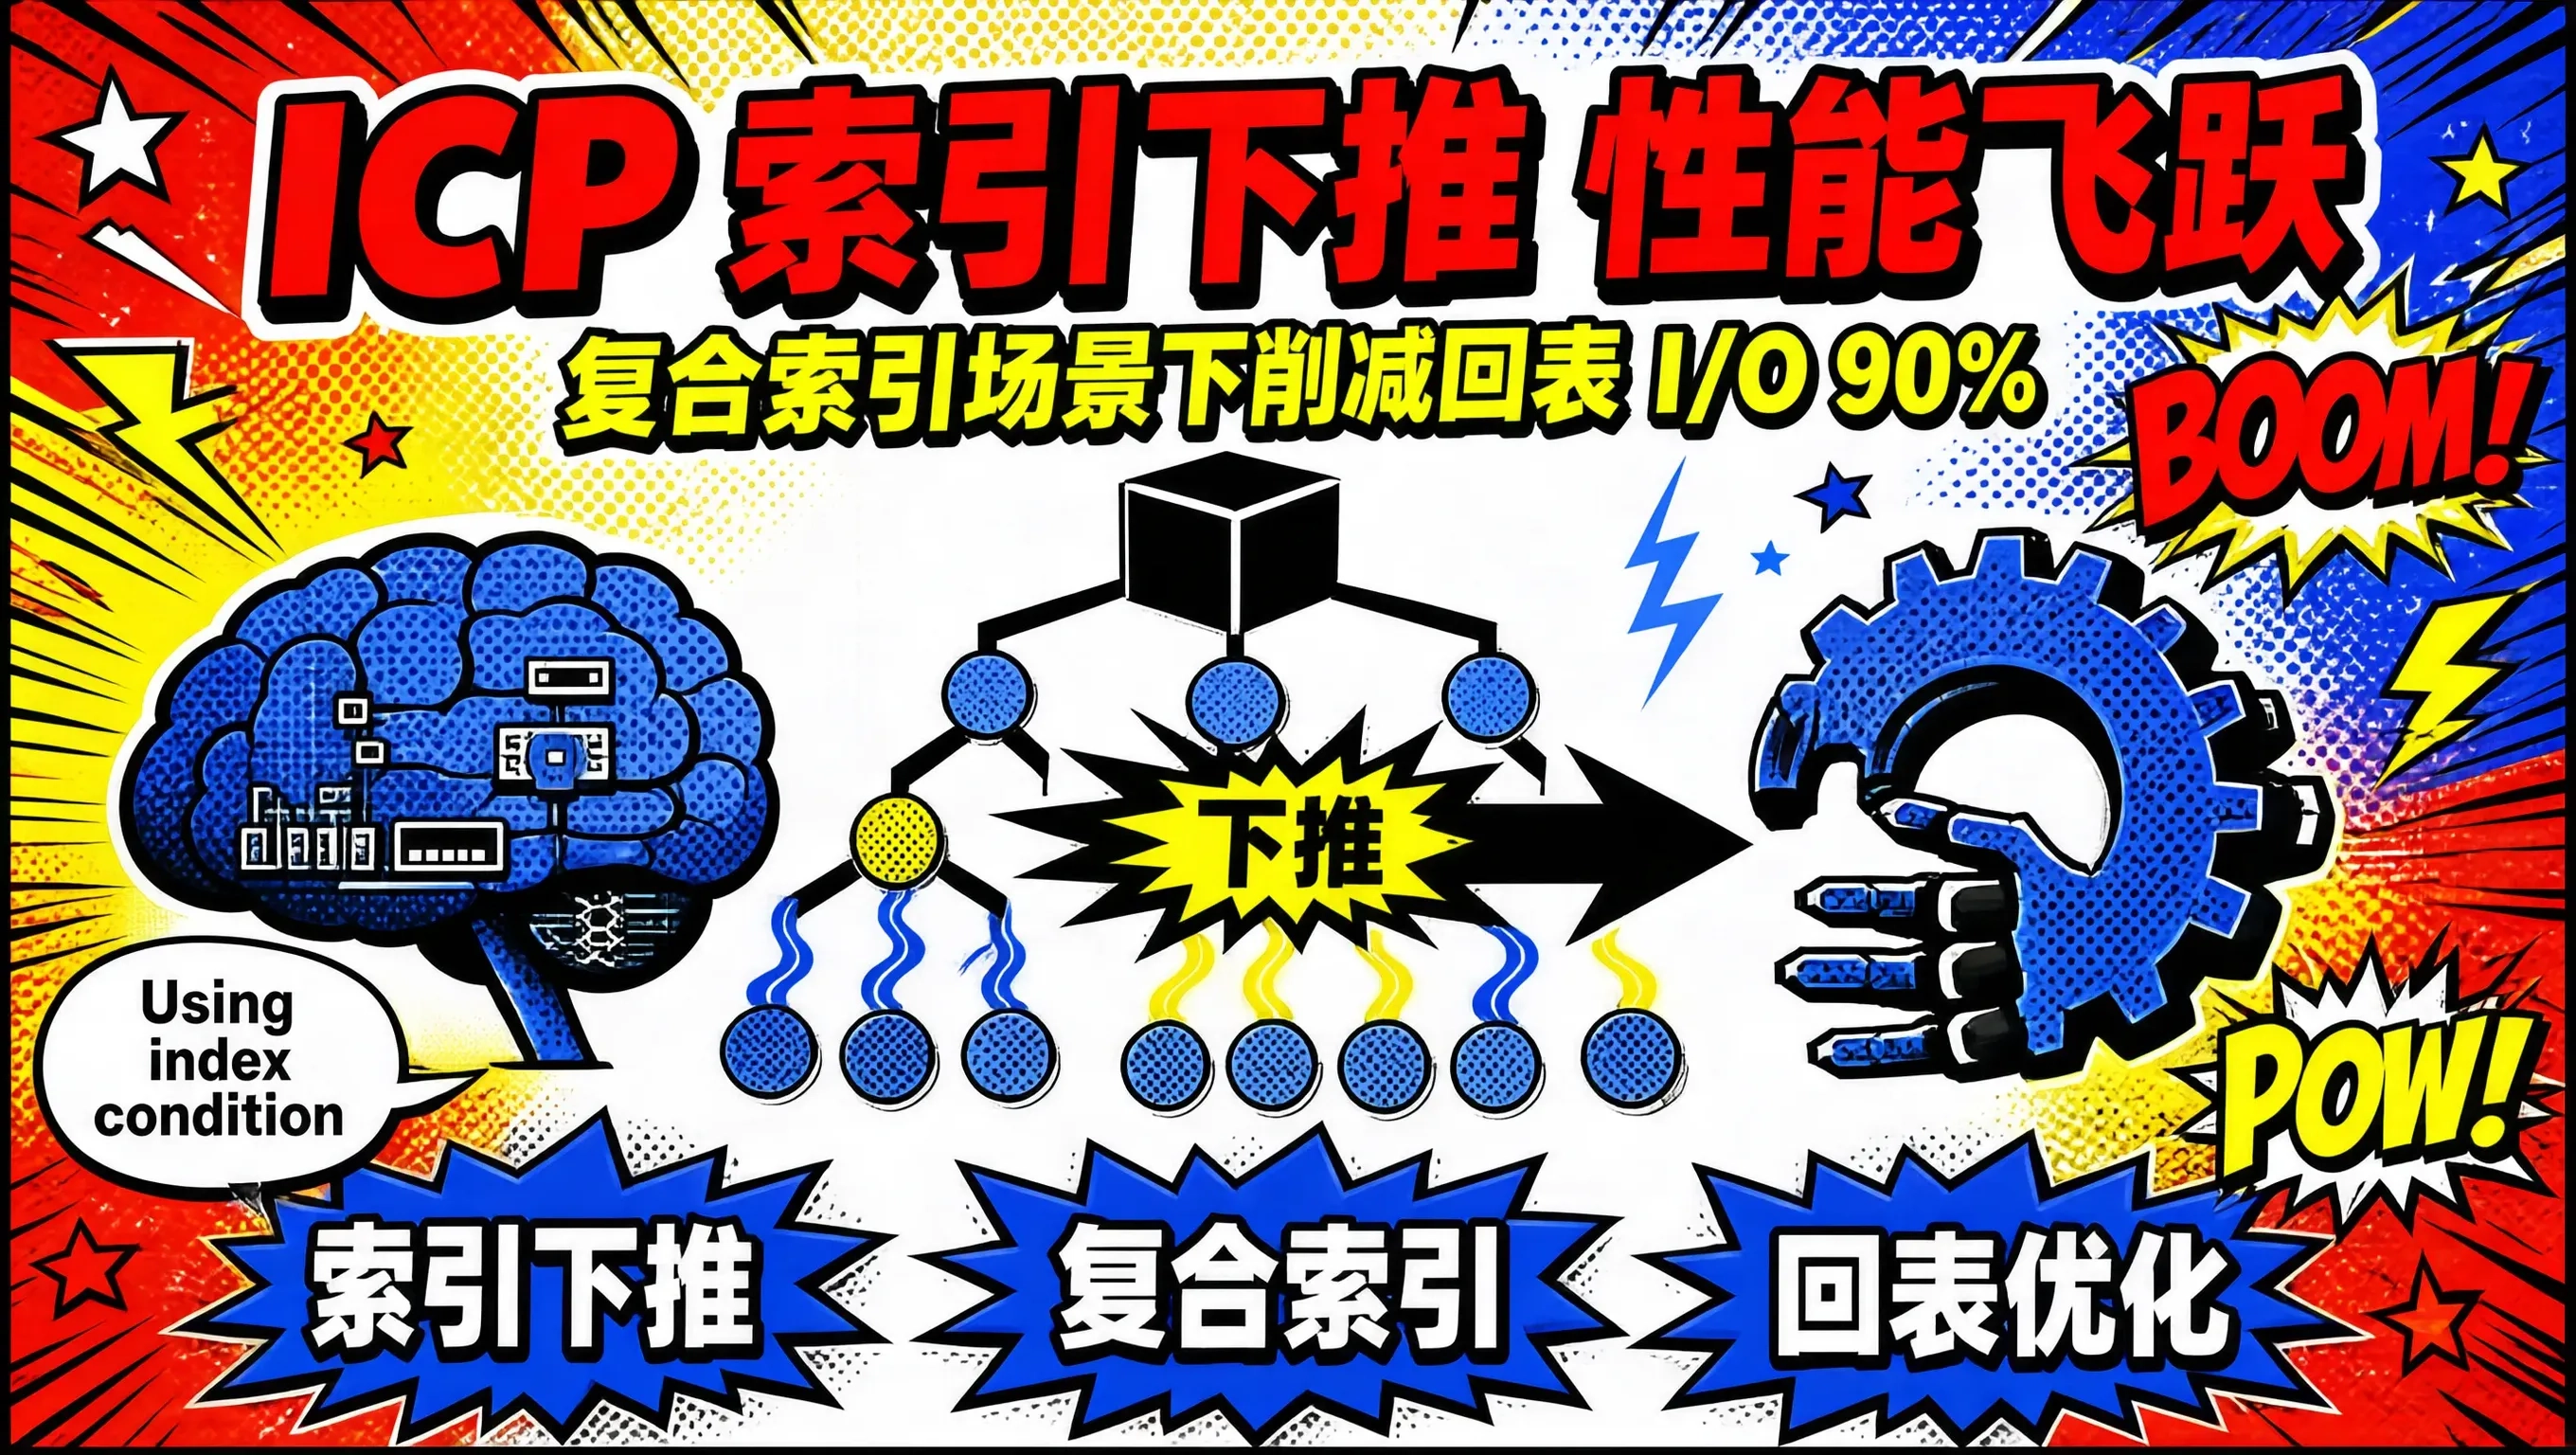
在 MySQL 性能调优的面试和实战中,“索引下推(Index Condition Pushdown, 简称 ICP)”是一个高频出现的词汇。很多工程师在执行计划里看到 Using index condition 时,只知道“这说明走索引下推了,查询变快了”,但如果追问一句:
- “到底什么东西被‘下推’到了哪里?”
- “为什么有了复合索引,还会产生大量的回表 I/O?”
- “在 MySQL 5.6 之前没有 ICP 的时代,存储引擎和服务层之间究竟发生了什么低效的‘扯皮’?”
绝大多数人往往就语焉不详了。
ICP 是关系型数据库内核从“粗放式架构”走向“精细化下推协同”的里程碑式技术。今天我们就来深入剖析 MySQL 的分层架构,复盘 ICP 的底层执行机制,搞懂它是如何在复合索引场景下将回表物理 I/O 削减 90% 以上的。
一、架构根源:Server 层与 Storage Engine 层的鸿沟
要想彻底理解 ICP,首先必须在脑海中建立清晰的 MySQL 双层分工模型:
┌─────────────────────────────────────────────────────────────┐
│ MySQL Server 层 (服务层) │
│ • 连接器、解析器、CBO 优化器、执行器 │
│ • 负责通用 SQL 语法、跨存储引擎算子、内存过滤与函数计算 │
└──────────────────────────────┬──────────────────────────────┘
│ 内部行获取接口 (handler API)
│ 传递每一行完整记录 (Row Records)
▼
┌─────────────────────────────────────────────────────────────┐
│ Storage Engine 层 (如 InnoDB 存储引擎) │
│ • 负责物理文件管理、B+ 树索引检索、Buffer Pool 缓存与事务日志│
└─────────────────────────────────────────────────────────────┘
在这个分层架构下,Server 层是发号施令的“大脑”,而 InnoDB 是干体力活的“手脚”。两者之间通过标准的 handler 抽象接口进行通信。问题恰恰就出在这条跨层通信与回表的流水线上!
二、没有 ICP 的暗黑时代:无休止的“无效回表”
我们来看一个经典业务场景:用户订单表 orders,包含字段 (user_id, age, phone, address, status)。我们建立了一个联合二级索引:
CREATE INDEX idx_user_phone ON orders (user_id, phone);
现在业务发起了一条查询:
SELECT * FROM orders
WHERE user_id LIKE '1001%'
AND phone LIKE '%8888';
1. 索引的最左匹配截断
在这个查询中,user_id LIKE '1001%' 是前缀匹配,可以利用二级索引树进行二分范围查找。但对于第二个条件 phone LIKE '%8888',由于其开头是模糊通配符 %,根据 B+ 树的有序性原则,这个条件无法用于缩小索引的检索范围。
2. 在 MySQL 5.6 之前(未引入 ICP)的悲剧执行流:
1. Server 层下达指令: "从 idx_user_phone 查找第一个 user_id LIKE '1001%' 的记录"
2. InnoDB 存储引擎:
– 在二级索引树中找到了一个叶子节点 (user_id='1001A', phone='13911118888')
– 获取到该记录的主键 ID (如 id=999)
– 【无脑回表】:根据主键 ID=999,去聚簇索引 B+ 树把包含 address、status 等整整 1KB 的完整行记录读出来!
– 把这行完整数据通过 handler API 递交给 Server 层。
3. Server 层接收到数据:
– 逐条检验: 这行的 phone 包含 '8888' 吗?
– 如果满足,保留;如果不满足,丢弃!
4. 重复上述步骤 2 和 3,直到扫描完所有 user_id LIKE '1001%' 的记录。
注意看步骤 2 中的荒谬之处:phone 字段的值明明就已经清清楚楚地存放在当前的二级索引叶子节点里了!但 InnoDB 引擎视而不见,它只知道按照最左匹配拿到主键,然后耗费极其昂贵的磁盘随机 I/O 去聚簇索引里把整行读出来,递给 Server 层,由 Server 层去判定它是不是以 8888 结尾。如果满足 user_id LIKE '1001%' 的记录有 10 万条,而其中真正符合 phone LIKE '%8888' 的只有 10 条,系统就要执行整整 100,000 次物理回表,其中 99,990 次都是彻底浪费的无用功!
三、破局:索引下推(ICP)的底层重构
MySQL 5.6 引入 ICP 后,执行权被下推到了存储引擎内部:
【开启 ICP 后的物理执行流】
┌─────────────────────────────────────────────────────────────┐
│ 1. Server 层生成执行计划,将 where 条件中的复合索引谓词 │
│ (phone LIKE '%8888') 直接下推打包给 InnoDB 存储引擎 │
└──────────────────────────────┬──────────────────────────────┘
│ 下推谓词 (Pushed Condition)
▼
┌─────────────────────────────────────────────────────────────┐
│ 2. InnoDB 存储引擎在二级索引树上遍历: │
│ ├── 命中 user_id LIKE '1001%' │
│ ├── 【就地判定】: 直接提取当前索引页上的 phone 字段比较 │
│ │ └── phone 是否匹配 '%8888'? │
│ │ ├── ❌ 否: 直接跳过!彻底放弃回表! │
│ │ └── ✅ 是: 仅针对这极少数行执行主键聚簇索引回表! │
└──────────────────────────────┬──────────────────────────────┘
│ 仅返回真正有效的数据
▼
┌─────────────────────────────────────────────────────────────┐
│ 3. Server 层接收到的每一行几乎都是有效数据,跨层交互大幅锐减 │
└─────────────────────────────────────────────────────────────┘
改变带来的飞跃:
InnoDB 在扫描二级索引时,就地消化了所有能在索引中直接计算的过滤谓词。原本的 100,000 次磁盘回表,瞬间被拦截压缩为了仅仅 10 次精准回表!磁盘 I/O 消耗直接缩减了 4 个数量级,查询耗时从几秒瞬间缩短至毫秒级。
四、深入 EXPLAIN:识别 Using index condition
我们通过实际的 SQL 执行计划来验证 ICP 的介入:
EXPLAIN SELECT * FROM orders
WHERE user_id LIKE '1001%'
AND phone LIKE '%8888';
输出的执行计划关键结果如下:
+—-+————-+——–+————+——-+—————-+—————-+———+——+——+———-+———————–+
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
+—-+————-+——–+————+——-+—————-+—————-+———+——+——+———-+———————–+
| 1 | SIMPLE | orders | NULL | range | idx_user_phone | idx_user_phone | 66 | NULL | 1480 | 11.11 | Using index condition |
+—-+————-+——–+————+——-+—————-+—————-+———+——+——+———-+———————–+
关键标志解读:
- Extra: Using index condition:这是开启 ICP 的铁证!表明存储引擎在利用索引范围查找时,同步下推了过滤条件,在索引层剔除了不合格行;
- 与 Using index 的根本区别:
- Using index(覆盖索引):查询的所有列都在二级索引里,完全不需要回表;
- Using index condition(索引下推):查询的列超出了二级索引(如 SELECT * 包含 address),依然需要回表,但回表的次数被索引内部下推条件大幅裁剪。
五、ICP 的生效边界与复合索引设计军规
虽然 ICP 是自动开启的(默认由系统参数 optimizer_switch='index_condition_pushdown=on' 控制),但它并不是无条件生效的,架构师在设计复合索引时必须牢记以下法则:
六、总结
技术演进的魅力,往往就隐藏在这些跨层交互的微观优化之中。
索引下推(ICP)打破了 Server 层与存储引擎层僵化的职责划分,用**“就地计算、尽早剪枝”**的理念,将海量无效的回表磁盘 I/O 扼杀在摇篮之中。深入理解 ICP 的底层流转,我们才能在设计复合索引时游刃有余,让底层的存储引擎发挥出最大的吞吐效能。





评论前必须登录!
注册