 网硕互联帮助中心
没写 @Transactional,事务就不生效?从一次索引重建看懂事务边界
方法里有提交和回滚,不代表整个业务流程都能一起回滚。判断事务是否有效,需要沿调用链找到真正的提交边界。
本文从知识库中的 PaiCLI 阅读笔记出发,重新核对了当前本地源码。项目使用 Java 17、SQLite JDBC,未使用 Spring;Spring 部分用于机制对照。文中的失败结果是基于代码的分析,改造结构是设计示意,均未进行故障注入实测。
读 PaiCLI 的代码索引模块时,我注意到一个细节:insertChunks() 的注释写着“事务保护”,方法上却没有 @Transactional。
如果习惯了 Spring Boot,很容易先去找事务注解。但这个项目通过 JDBC 直接操作 SQLite,事务控制就写在方法内部。
继续往调用处看,更值得追问的事情出现了:清理旧索引、插入新代码块、插入代码关系,是不是一个整体?如果最后一步失败,前面的操作还能恢复吗?
一、先看项目怎么操作数据库
PaiCLI 的 VectorStore 直接建立 JDBC 连接,相关语句如下:
this.connection = DriverManager.getConnection("jdbc:sqlite:" + dbPath);
它维护两张表:code_chunks 存代码块及其向量,code_relations 存代码之间的关系。
在当前的 CodeIndex.index() 中,持久化部分依次调用以下方法。下面节选调用顺序,省略统计和日志:
try (VectorStore store = new VectorStore(root.toString())) {
store.clearProject();
store.insertChunks(entries);
store.insertRelations(allRelations);
// 后续统计和结果处理省略
}
从业务上看,这是一次重建:先清掉当前项目的旧数据,再写入新数据。
但同一个 try 块、同一个对象,甚至同一个连接,都不能单独证明这三步属于同一个事务。
二、没有注解,事务控制在哪里?
insertChunks() 的关键结构如下。这是源码节选,省略了 SQL 定义及部分参数绑定,不是可独立运行的完整方法:
boolean autoCommit = connection.getAutoCommit();
connection.setAutoCommit(false);
try (PreparedStatement ps = connection.prepareStatement(sql)) {
for (CodeChunkEntry entry : entries) {
ps.setString(1, projectPath);
// 中间参数绑定省略
ps.setString(6, embeddingToJson(entry.embedding));
ps.addBatch();
}
ps.executeBatch();
connection.commit();
} catch (SQLException e) {
connection.rollback();
throw e;
} finally {
connection.setAutoCommit(autoCommit);
}
这里已经包含了 JDBC 手动事务的主要动作:关闭自动提交、执行 SQL、成功时提交、捕获指定异常时回滚,最后恢复连接状态。
setAutoCommit(false) 的含义是关闭自动提交;数据库实际何时建立事务,还与数据库和驱动有关,不必把它机械等同于立即执行了一条 BEGIN。
commit() 和 rollback() 作用于连接上的当前事务,不是按 Java 方法名划分范围。Java 17 Connection 文档
所以,没写 @Transactional,并不意味着没有事务。这个项目选择由代码直接控制数据库事务。
还有一个容易混淆的点:addBatch() 用于积累批处理,executeBatch() 用于提交执行,批处理本身不提供整批原子性的保证。驱动在部分命令失败后,可能继续执行剩余命令,也可能停止;不能把一次批处理调用理解成一次网络发送或一个天然的事务。Java 17 Statement 文档
三、每个方法有事务,为什么重建仍可能只完成一半?
先看 clearProject()。它顺序执行两条删除:
ps1.executeUpdate(); // 删除当前项目的代码块
ps2.executeUpdate(); // 删除当前项目的代码关系
这个方法没有自行关闭自动提交。沿当前调用链,新连接保持默认自动提交模式,因此两条删除分别提交,连“清理旧索引”这一步都没有被统一包成一个事务。
随后,insertChunks() 和 insertRelations() 分别关闭自动提交,并各自执行 commit()。
正常路径下,可以这样理解这些提交边界:
删除旧代码块 → 提交
删除旧代码关系 → 提交
插入新代码块 → 提交
插入新代码关系 → 提交
假设旧数据已经删除并提交,插入新代码块时遇到 SQL 异常,即使该批插入成功回滚,旧数据也不会随之恢复。
再假设代码块已经插入并提交,关系插入失败并回滚,可能留下“新代码块已存在,关系没有写入”的状态。
这些都是按当前代码推导的失败场景,不是一次已经复现的数据丢失事故。
局部事务能回滚的,是它当前尚未提交的工作;它不能撤销前面已经提交的事务。 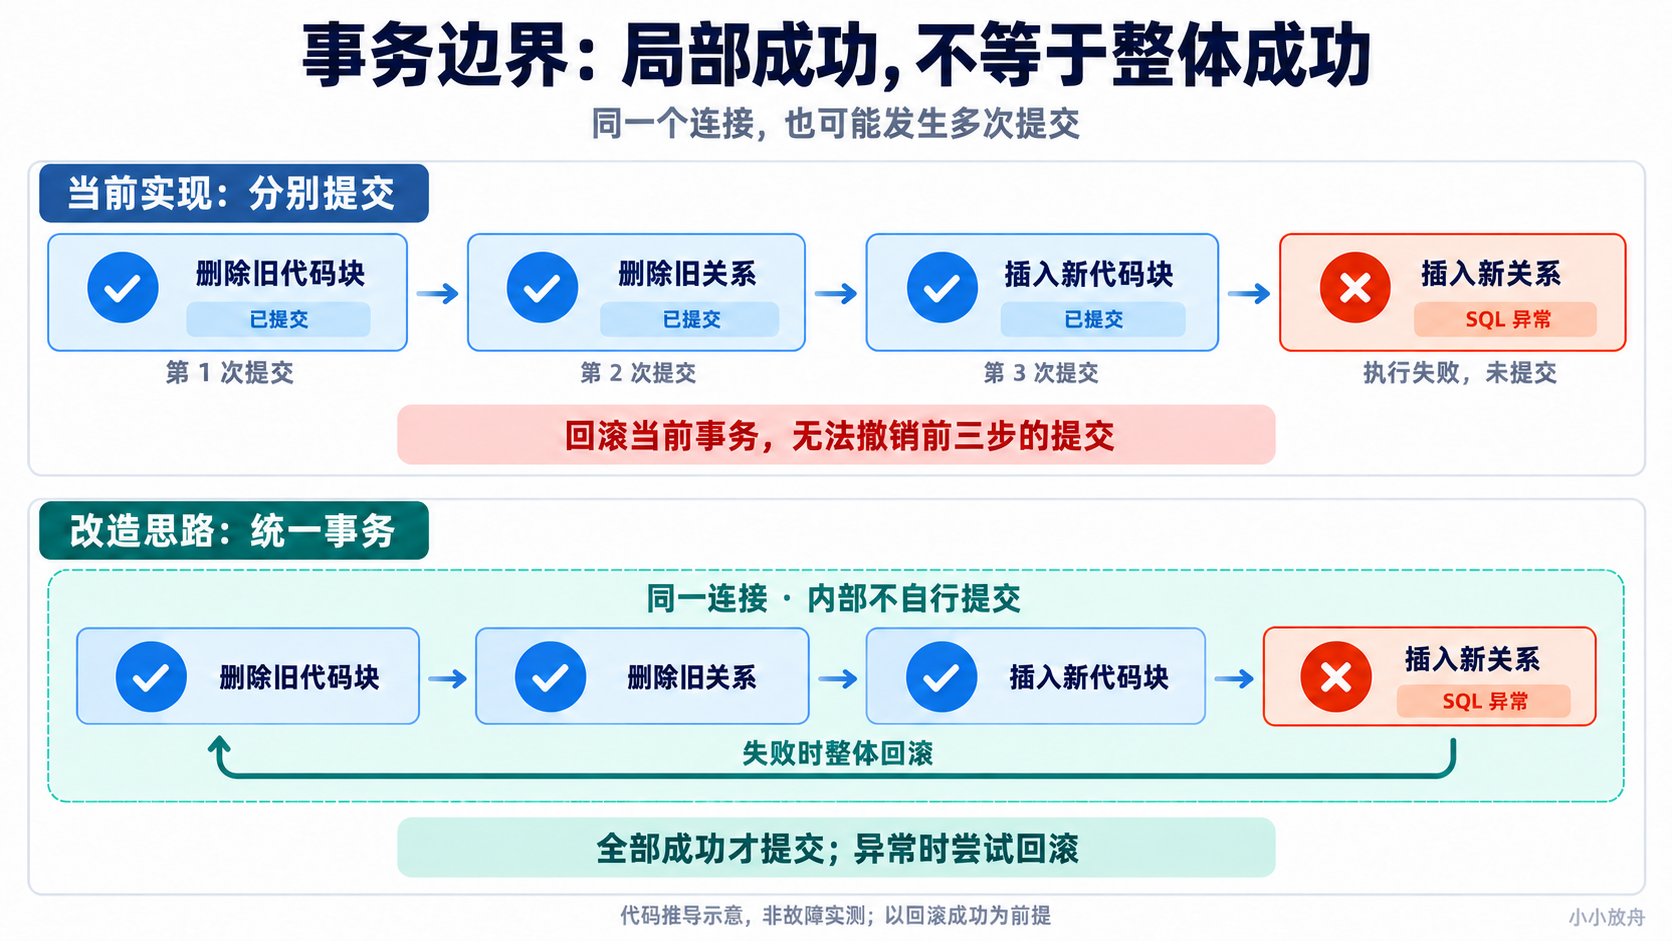
图:前三步已分别提交时,后续回滚无法撤销它们;统一事务方案在回滚成功时可撤销本次数据库修改。下半部分为改造示意,非故障实测。
四、为什么不能只在外面再套一层事务?
看到这里,一个直觉方案是:在外层关闭自动提交,然后继续调用原来的三个方法,最后统一提交。
问题在于,内部 insertChunks() 仍然会执行:
connection.commit();
如果使用同一个连接,它提交的是这个连接上当前事务中的全部工作,可能连前面的删除一起提交。后续插入关系失败,外层再回滚也无法撤销已经提交的部分。
因此,改造的关键是明确事务的拥有者。下面是职责划分示意,其中的 …SqlOnly 方法需要新实现,并非项目已有 API:
rebuildIndex:唯一负责事务边界
关闭自动提交
执行 clearProjectSqlOnly
执行 insertChunksSqlOnly
执行 insertRelationsSqlOnly
全部成功:提交
提交前发生失败:尝试回滚,向上传递错误
底层 SQL 方法必须使用同一个受控连接,并且不再自行提交、回滚或切换自动提交模式。如果它们需要独立调用,可以另外提供拥有事务边界的入口。
落地时还要明确:这个入口是独占一条新连接,还是允许加入调用者已有的事务?两种契约不能含混。对不支持事务嵌套的简单实现,可以拒绝接收已经处于手动事务模式的连接,而不是擅自提交调用者的工作。
恢复连接状态之前,也必须处理好事务结束和回滚失败。把自动提交从 false 改为 true 可能提交当前事务,不能把 finally 中的状态恢复当成回滚的替代品。Connection.setAutoCommit 文档
五、换成 Spring,就只需要一个注解吗?
在 Spring 应用中,声明式事务可以帮助管理边界。比如,下面是一段独立的设计示意,并非 PaiCLI 现有实现:
@Transactional(rollbackFor = Exception.class)
public void rebuildIndex() {
repository.clearProject();
repository.insertChunks();
repository.insertRelations();
}
这段示意成立,需要事务管理已配置、调用经过事务拦截,并且底层操作实际参与同一个事务。
本文讨论的是 Spring 的 org.springframework.transaction.annotation.Transactional,以及默认的代理模式。这个模式下,调用必须经过代理;同一对象内的自调用不会触发被调用方法的新事务拦截。自调用也不意味着既有事务消失,要看外层是否已经建立事务。Spring 事务注解文档
底层连接同样重要。原项目直接通过 DriverManager.getConnection() 建立连接,不能指望给外层加个注解,就把这条独立连接自动纳入 Spring 本地事务。使用 JdbcTemplate 等事务感知的数据访问方式,并匹配事务管理器及数据源,才能让连接参与预期的事务。Spring 数据库连接管理文档
还要看异常规则。未额外修改默认配置时,Spring 默认对 RuntimeException 和 Error 回滚,对受检异常并不默认回滚;SQLException 就是受检异常。rollbackFor = Exception.class 可以扩展规则,但它也不能自动识别被业务代码吞掉的异常。Spring 回滚规则文档
如果代码捕获异常后只返回失败标志,事务拦截器可能看到的是一次正常返回。是否回滚,还要看有没有其他机制将事务标记为仅回滚。
六、源码里还有一个值得留意的异常分支
回到最开始的 insertChunks(),它捕获的是 SQLException。但循环中的 embeddingToJson() 在序列化失败时,会抛出 RuntimeException。
这条异常路径不会进入 catch (SQLException e),却仍然会进入 finally。所以,这个节选不适合不加说明地当成“覆盖所有失败的通用事务模板”。具体后果取决于异常发生时是否已有数据库修改等条件,不能直接断言一定出现部分提交。
实际实现至少需要考虑 SQL 异常、运行时异常,以及回滚或清理再次失败时如何保留最初的错误。核心要求是:提交前的失败应沿预期路径触发回滚,连接状态恢复应建立在事务状态已妥善处理的基础上。
这里也没有证据说明原作者故意选择了当前失败边界。单文件解析失败后继续收集数据,与持久化阶段是否整体原子,是两个独立设计问题,不能用前者替后者解释动机。
七、事务边界应该包住哪一段?
这个索引流程先读取文件、生成 Embedding、收集关系,再进入数据库写入阶段。如果目标是避免持久化失败破坏旧数据,可以优先考虑把“删除旧记录 + 写入两张表”放进一个短事务。
通常不必为了这个目标,把耗时的文件扫描和远程 Embedding 请求也放进去。数据库事务也不能撤销已经发生的远程调用。
如果数据量更大、需要更长时间构建,可以进一步研究版本化索引:先准备新版本的数据,成功后再切换当前版本标识。这是另一种设计方向,不是本文已经完成的改造。
回顾这次阅读,我更愿意先问四个问题,再判断“事务有没有生效”:
事务注解是入口,业务操作之间的提交边界才决定失败后能恢复到哪里。
你遇到过哪些“方法明明有事务,整个流程却没有一起回滚”的情况?欢迎带上调用顺序和异常处理方式一起讨论。
⛵ 我是 小小放舟,记录 Java 后端与 AI Agent 的学习、实践和踩坑过程。
如果这篇文章对你有帮助,欢迎收藏,下次排查事务问题时对照检查。
小小放舟的 CSDN

评论前必须登录!
注册