 网硕互联帮助中心
这套专栏走到今天:正篇 90 篇打底,续集《AI 工程化深水区》60 篇接着往生产级走,加起来 150 篇、22 个阶段。你现在的位置和要去的地方,都在这张图里: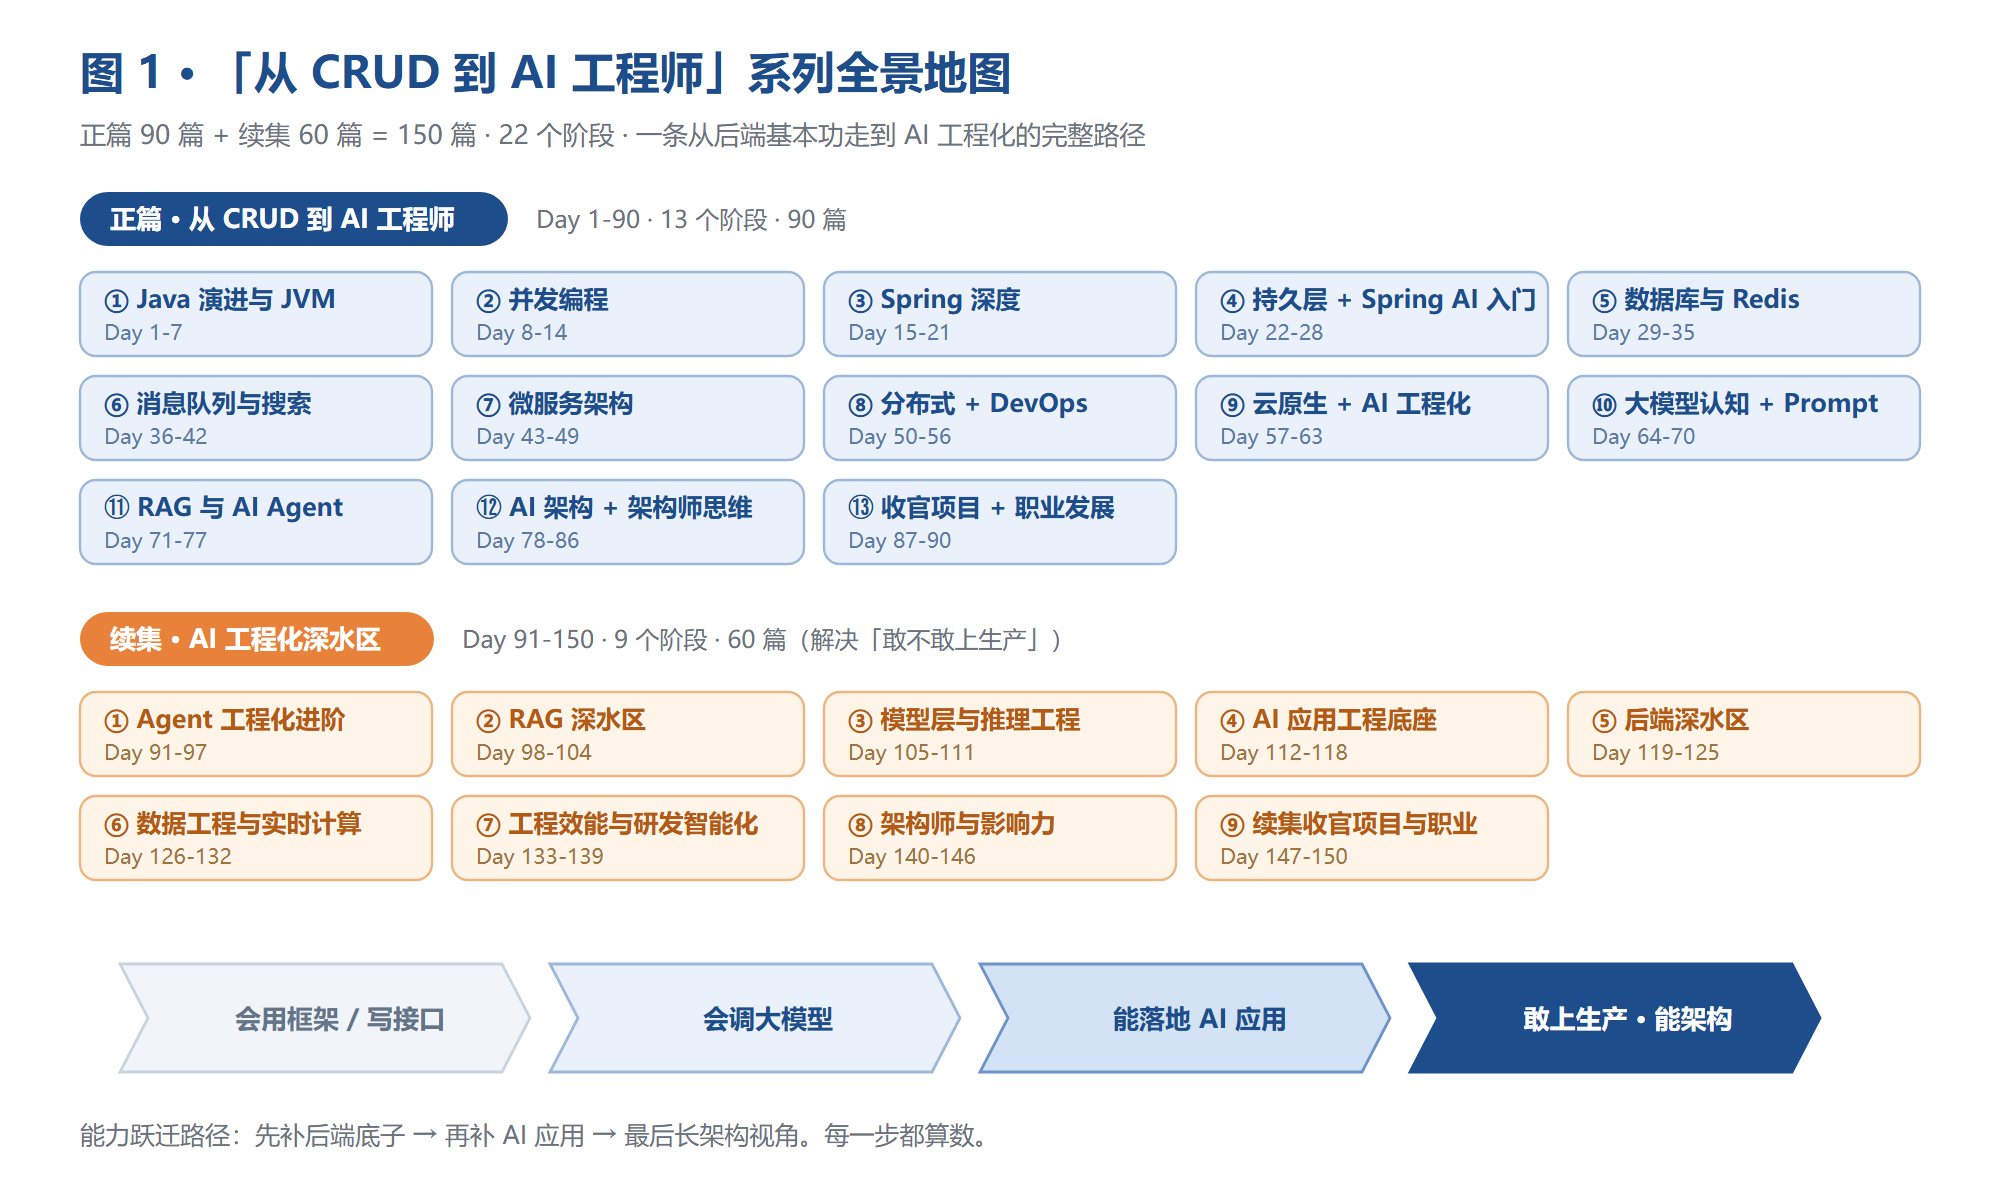
上半部分是正篇——前 8 个阶段(Day 1-56)把后端基本功夯实,中间 4 个阶段(Day 57-86)从云原生切进大模型、RAG 和 Agent,最后 4 篇用收官项目把能力串起来;下半部分是续集——正篇解决"能不能跑起来",续集解决"敢不敢上生产":Agent 工程化、RAG 深水区、模型推理、AI 工程底座、数据工程、架构师进阶。底部四级台阶,就是读者的成长路径:会用框架 → 会调大模型 → 能落地 AI 应用 → 敢上生产、能架构。
一、AI 时代后端工程师的三层能力地图
我把这 90 篇覆盖的能力分成三层。不是职位等级,而是"你能独立搞定多大的 AI 工程问题"。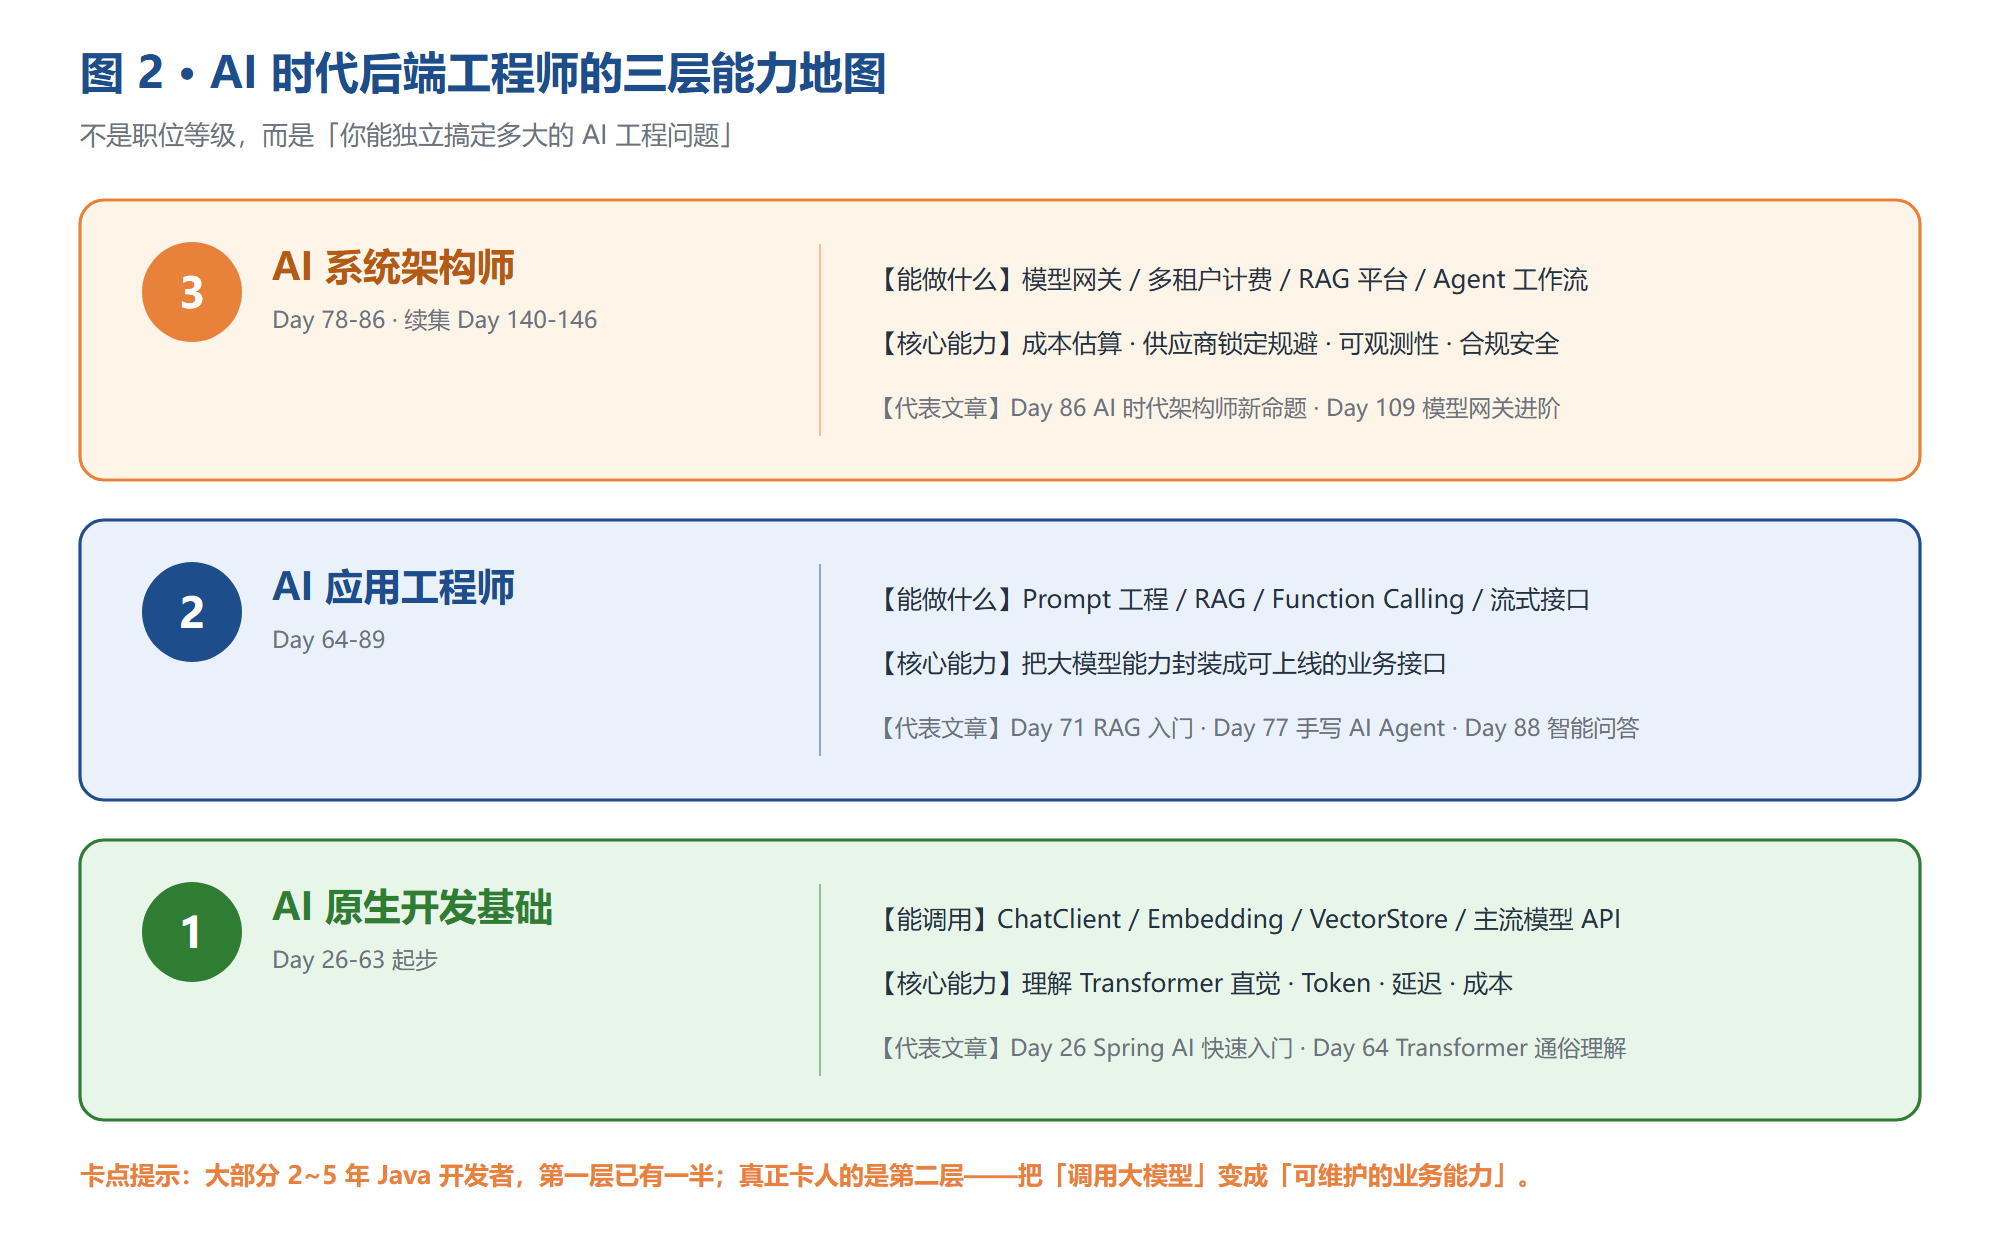
图 2 怎么看:第一层是地基——能调用模型 API、理解 Token 与成本,Day 26 接入 Spring AI 时你其实已经站上来了;第二层是主战场——把大模型能力封装成可上线的业务接口,RAG、Function Calling、流式接口都在这一层;第三层是视角——成本、延迟、幻觉、合规这四个词,决定你的技术方案能不能活过上线第一周。每层右侧标了对应的文章区间,哪层虚,就回去翻哪层。
大部分 2~5 年 Java 开发者,第一层已经有一半了——你会写接口、会接 SDK、会用 Spring Boot。真正卡人的是第二层:怎么把"调用大模型"变成"可维护的业务能力"。
第三层不是让你马上做架构师,而是让你有架构师的视角。因为 AI 系统里,成本、延迟、幻觉、合规这四个词,会反过来决定你的技术方案能不能活过上线第一周。
二、自测:你目前在第几层?
别凭感觉。我写了一个最小化的能力自评工具,把 90 天里的关键能力点列出来,你自己打分。
// CompetencyRadar.java —— JDK 17
// 用途:给自己做一次 AI 工程能力体检,满分 100
// 依赖:无,纯 Java 标准库
import java.util.Arrays;
import java.util.List;
public class CompetencyRadar {
enum Dimension {
// 第一层:基础
JAVA_CORE("Java 核心/JVM/并发", 10),
SPRING_ECOSYSTEM("Spring Boot/Spring Cloud", 10),
DB_REDIS("MySQL/Redis/消息队列", 10),
LLM_BASICS("Transformer/Token/模型选型", 10),
// 第二层:应用
PROMPT_ENGINEERING("Prompt 工程与版本管理", 10),
RAG("RAG:文档处理→向量检索→增强生成", 15),
FUNCTION_CALLING("Function Calling / Tool Use", 10),
STREAMING_API("流式接口 SSE/WebFlux 设计", 10),
// 第三层:架构
COST_OBSERVABILITY("Token 成本与可观测性", 10),
AI_SECURITY("AI 安全/合规/降级预案", 5);
final String label;
final int maxScore;
Dimension(String label, int maxScore) {
this.label = label;
this.maxScore = maxScore;
}
}
/** 给自己每个维度打分,0 ~ maxScore */
public static void evaluate(int[] scores) {
if (scores.length != Dimension.values().length) {
throw new IllegalArgumentException("分数数组长度必须等于维度数量");
}
int total = 0;
int maxTotal = 0;
Dimension[] dims = Dimension.values();
System.out.println("===== AI 工程能力自评 =====");
for (int i = 0; i < dims.length; i++) {
Dimension d = dims[i];
int s = Math.min(Math.max(scores[i], 0), d.maxScore);
total += s;
maxTotal += d.maxScore;
String bar = "█".repeat(s / 2) + "░".repeat((d.maxScore – s) / 2);
System.out.printf("%-30s %s %2d/%d%n", d.label, bar, s, d.maxScore);
}
System.out.printf("%n总分: %d / %d (%.1f%%)%n", total, maxTotal, 100.0 * total / maxTotal);
// 简单分层判断
if (total < 35) {
System.out.println("建议:先补第一层基础,别急着追 RAG。");
} else if (total < 70) {
System.out.println("建议:第二层是你的主战场,挑一个 RAG 或 Function Calling 项目做到上线。");
} else {
System.out.println("建议:你已经能独立做 AI 应用,下一步是多模型网关、成本可观测与合规。");
}
}
public static void main(String[] args) {
// 示例:一个工作 3 年的 Java 后端,刚学完 Spring AI 的典型分数
int[] sampleScores = {8, 8, 7, 5, 5, 6, 4, 5, 3, 2};
evaluate(sampleScores);
}
}
跑一遍这个程序,把 sampleScores 换成你自己的真实分数。低于 60 分不丢人,丢人的是不敢承认自己在哪弱。
我给自己打过分:RAG 和 Prompt 工程能到 8 分以上,但 AI 安全和合规只有 5 分。这就是接下来半年我要补的地方。
用示例分数跑出来的雷达长这样(主观自评,非实测值):
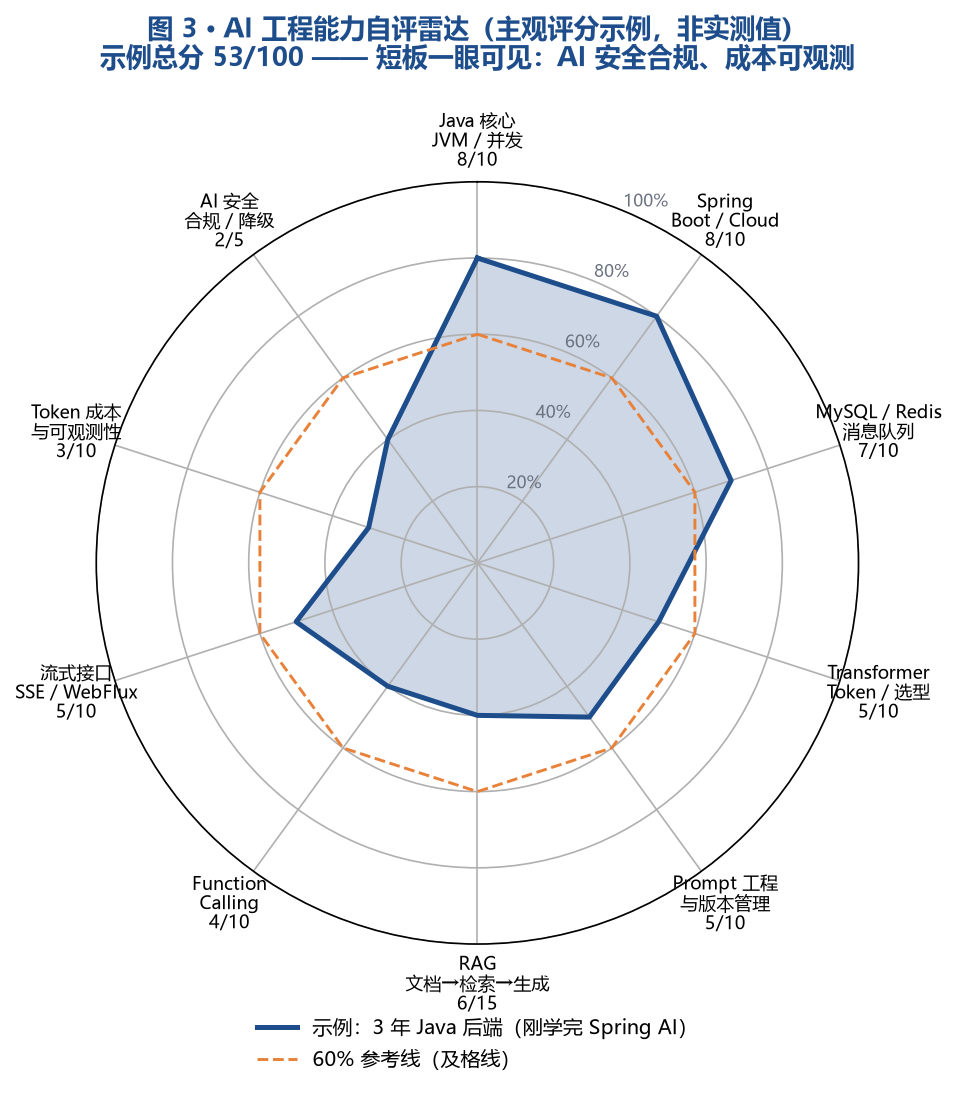
图 3 怎么看:蓝色实线是一个"3 年 Java 后端、刚学完 Spring AI"的典型画像——传统后端四项(Java 核心、Spring、数据库、消息队列)都在 70%~80%,但一进 AI 区就塌下去了:RAG 只拿到 6/15、Function Calling 4/10、AI 安全合规更是只有 2/5。橙色虚线是 60% 参考线,凹陷最深的地方,就是你接下来该投入的地方。
测完分,直接对照下面的处方开药:
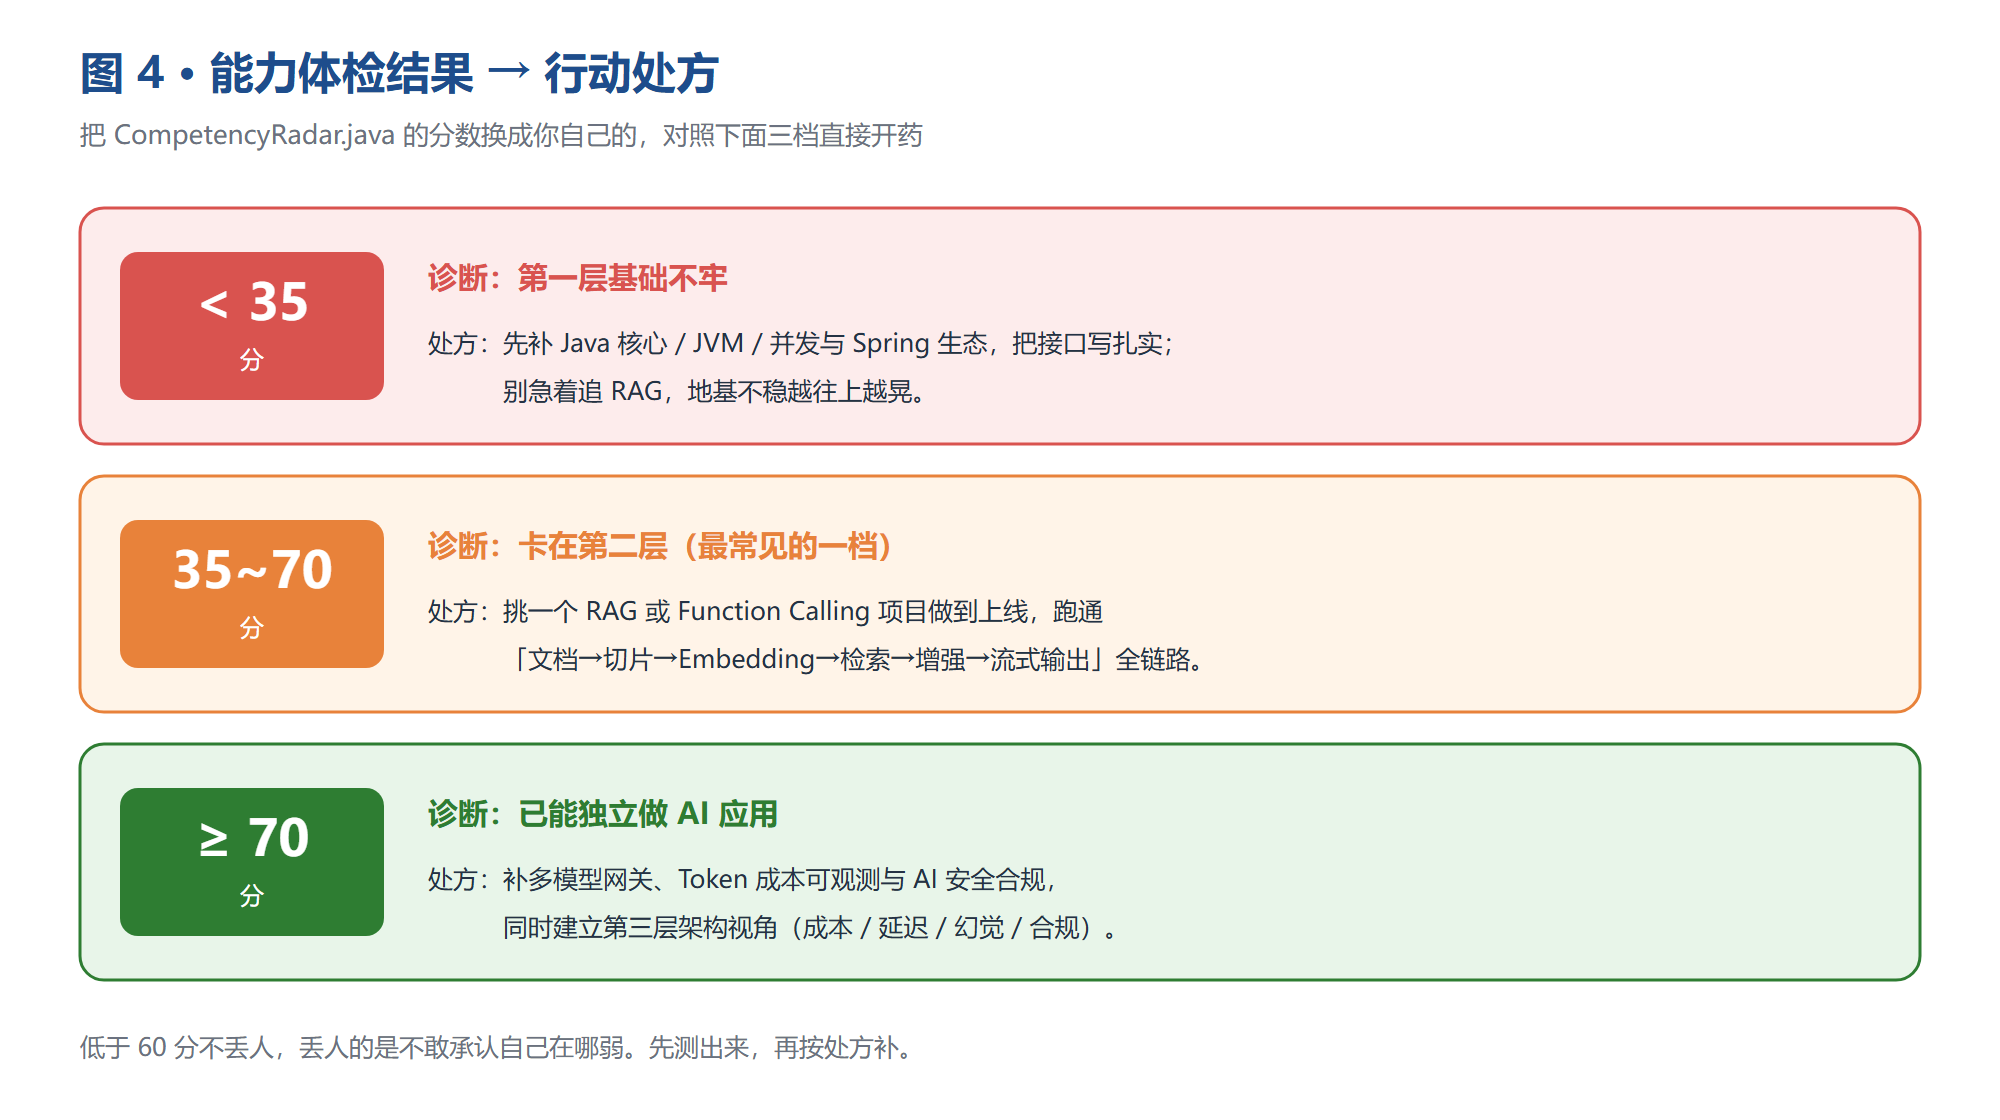 图 4 和 CompetencyRadar 里的三档判断一一对应:35 分以下补地基,35~70 分死磕一个上线项目,70 分以上往成本可观测和合规走。别跳档,地基不稳越往上越晃。
三、面试高频 AI 题:不是考你背概念,是考你有没有真的做过
最近面了几个候选人在聊 AI 项目,发现很多人能说出"RAG 是检索增强生成",但一到细节就露馅。下面两道题,是 2025~2026 年 Java 后端转 AI 工程的高频题。
题 1:手写一个最小 RAG 流程
面试官不是要你背 Spring AI 的类名,是要看你知不知道 RAG 的"数据飞轮"长什么样。
// RagMiniAnswer.java —— JDK 17 + Spring AI 1.0
// 面试考点:文档切片、Embedding、向量检索、Prompt 增强
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.document.Document;
import org.springframework.ai.embedding.EmbeddingModel;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.stereotype.Service;
import java.util.List;
import java.util.stream.Collectors;
@Service
public class RagMiniAnswer {
private final EmbeddingModel embeddingModel;
private final VectorStore vectorStore;
private final ChatClient chatClient;
public RagMiniAnswer(EmbeddingModel embeddingModel,
VectorStore vectorStore,
ChatClient chatClient) {
this.embeddingModel = embeddingModel;
this.vectorStore = vectorStore;
this.chatClient = chatClient;
}
/** 步骤 1:文档入库 —— 切片 + Embedding + 写入向量库 */
public void ingest(String rawText) {
// 生产环境用按语义/递归切片,这里用固定长度演示核心流程
int chunkSize = 500;
List<Document> chunks = java.util.ArrayList.new();
for (int i = 0; i < rawText.length(); i += chunkSize) {
String chunk = rawText.substring(i, Math.min(i + chunkSize, rawText.length()));
chunks.add(new Document(chunk));
}
// Spring AI 自动调用 EmbeddingModel,写入 VectorStore
vectorStore.add(chunks);
}
/** 步骤 2:问答 —— 检索相关片段 → 拼 Prompt → 调大模型 */
public String answer(String question) {
// 取 top-3 相关片段
List<Document> relevant = vectorStore.similaritySearch(
org.springframework.ai.vectorstore.SearchRequest.query(question).withTopK(3));
String context = relevant.stream()
.map(Document::getText)
.collect(Collectors.joining("\\n—\\n"));
// 关键:把检索结果放进 system prompt,约束模型只基于上下文回答
return chatClient.prompt()
.system(s -> s.text("""
你是企业知识库助手。请严格根据以下参考材料回答问题。
如果参考材料中没有答案,请直接说"我不知道",不要编造。
参考材料:
{context}
""").param("context", context))
.user(question)
.call()
.content();
}
}
面试官真正在听的点:
-
你有没有显式处理"检索为空"和"模型编造"的矛盾?
-
切片策略有没有考虑过语义完整性?
-
相似度阈值有没有调过?
题 2:Function Calling 是怎么让模型调用业务接口的?
这道题考的是"模型和业务的边界"。
// FunctionCallDemo.java —— JDK 17 + Spring AI 1.0
// 面试考点:Tool 定义、参数 schema、模型决策、业务执行
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.tool.function.FunctionToolCallback;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import java.util.function.Function;
@Configuration
public class FunctionCallDemo {
// 业务函数:查询订单状态
public record OrderQuery(String orderId) {}
public record OrderResult(String orderId, String status, double amount) {}
@Bean
public Function<OrderQuery, OrderResult> queryOrderStatus() {
return req -> {
// 实际调用订单服务或数据库
return new OrderResult(req.orderId(), "已发货", 199.0);
};
}
@Bean
public ChatClient chatClient(ChatClient.Builder builder,
Function<OrderQuery, OrderResult> queryOrderStatus) {
// 把业务函数注册成模型可调用的 Tool
return builder.defaultTools(
FunctionToolCallback.builder("queryOrderStatus", queryOrderStatus)
.description("根据订单号查询订单状态和金额")
.inputType(OrderQuery.class)
.build()
).build();
}
}
核心原理一句话:模型不直接调接口,模型只决定"该调哪个工具、参数是什么";真正执行工具的是你的 Java 代码。这样就把"概率性的大脑"和"确定性的业务"隔离开了。
四、学习资源清单:少即是多
90 天不可能覆盖所有细节。下面这些是我反复推荐、自己也还在看的资源。不要全看,每个层级选 1~2 个,看完就用。
| 第一层 | 课程 | DeepLearning.AI《AI For Everyone》 | 快速建立非技术决策者也能懂的大模型认知 |
| 第一层 | 文档 | Spring AI 官方 Reference | 最权威的 Java AI 开发入口 |
| 第二层 | 项目 | 用 Spring AI + pgvector 搭一个企业知识库 | 做完一遍,RAG 才算真会 |
| 第二层 | 书籍 | 《Building LLM Apps》 | 讲清 LLM 应用架构的权衡,不偏数学 |
| 第三层 | 论文/博客 | OpenAI、Anthropic 官方工程博客 | 看顶尖团队怎么处理成本、安全、可观测性 |
| 第三层 | 实践 | 给自己项目加 Token 计费仪表盘 | 不上线一次,永远不知道成本会怎么爆炸 |
一个重要提醒:不要陷入"收藏夹吃灰"。每学一个点,就问自己:这个能放进我现在的项目里吗? 不能,就先放一放。
五、开源项目贡献:最快的成长方式
看十篇博客不如改一个 bug。对 Java 开发者来说,下面是三类适合入门的开源方向。
// GoodFirstIssueFilter.java —— JDK 17 + HttpClient
// 用途:用 GitHub API 筛选适合新手的 Java/AI 相关 issue
import java.net.URI;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.time.Duration;
public class GoodFirstIssueFilter {
public static void main(String[] args) throws Exception {
String repo = "spring-projects/spring-ai"; // 可换成 langchain4j 等
String url = "https://api.github.com/repos/" + repo
+ "/issues?labels=good%20first%20issue&state=open&per_page=5";
HttpClient client = HttpClient.newBuilder()
.connectTimeout(Duration.ofSeconds(10))
.build();
HttpRequest request = HttpRequest.newBuilder(URI.create(url))
.header("Accept", "application/vnd.github+json")
.header("User-Agent", "java-dev")
.GET()
.build();
HttpResponse<String> response = client.send(request,
HttpResponse.BodyHandlers.ofString());
System.out.println("状态码: " + response.statusCode());
System.out.println("前 5 个 good first issue 摘要:");
// 简单打印 JSON,实际可用 Jackson 解析 title 和 html_url
System.out.println(response.body().substring(0, 1200));
}
}
推荐的入门项目:
Spring AI:Java 生态的 AI 应用框架,issue 质量高,文档完善。
LangChain4j:如果你想深耕 Agent 和 Tool Use。
pgvector Java 客户端:小项目,适合第一次提 PR。
贡献顺序:读文档找 typo → 补单元测试 → 修复简单 bug → 提交一个小 feature。不要一上来就重构核心模块。
六、三条能让你站稳脚跟的实战建议
1. 保留你的 Java 底子,但别让它成为你的天花板
AI 时代,Java 不会死,但只会写 CRUD 的 Java 工程师会很危险。你的 Spring Boot、MySQL、Redis、K8s 经验是优势,因为 AI 应用最终也要部署、也要高可用、也要可观测。把 AI 能力嫁接在你已有的工程能力上,而不是从零开始学 Python。
2. 三个月内,必须把一个 AI 功能推到生产环境
本地 demo 和线上环境隔着一个太平洋。只有真正上线,你才会遇到:Token 暴涨、模型超时、用户输入 Prompt 注入、缓存失效、成本失控。这些坑,光看文章踩不到。
3. 建立你的人机协作工作流
Cursor、Copilot、ChatGPT 不是敌人,是你新的 IDE 插件。但要有边界:
-
让 AI 写 boilerplate、写单测、补注释;
-
不让 AI 直接写核心算法、不写未 review 的生产代码;
-
所有 AI 生成的代码,必须能被你讲清楚。
"AI 不会取代 Java 后端工程师,但会用 AI 的 Java 后端工程师,一定会取代不会用的。"
90 天,我们从 JDK 聊到 JVM,从 Spring 聊到 Spring AI,从 Redis 聊到 RAG,从单体聊到 AI 网关。这条路很长,但每一步都算数。
这不是终点。把你的第一个 AI 功能推上线,然后回来告诉我它花了多少 Token、延迟多少毫秒、用户骂了还是夸了——那才是下一阶段的开始。
江湖路远,我们下一段旅程见。







评论前必须登录!
注册