 网硕互联帮助中心
文章目录
-
- 先说结论:它生成的不是画面,是一个能直接跑仿真的房间
-
- 输入是一条描述,输出是一棵带字段的场景
- 两阶段的分工一句话能说完
- 为什么“能跑”比“好看”难
- 已有生成器卡在哪:三条路线各自解决了一半
-
- 程序化与学习式布局:被自己的规则框住
- 语言与 agent 路线:灵活,但一次迭代要跑一整套工具
- 图像先验路线:视觉上合理不等于几何上可行
- 作者的判断:关系是定性的,位姿是数值的
- 第一段:分层视觉采样,规划交给 VLM、摆法交给扩散
-
- 检索三个样板间,是为了让 VLM 有空间先验
- zone plan 的字段为什么这么设计
- 资产 LoRA:图里的沙发必须就是库里的那只沙发
- 采样公式:换种子就是换布局
- 第二段:契约式 3D 编译,先钉住关系再修位姿
-
- 提升:单目检测加单目深度,误差是必然的
- 关系契约:只记录图上看得见的关系
- 分层拟合:先把每个功能区内部解决干净
- 关系精修:只允许局部旋转与平移
- 墙面与台面补全:另一种“先提议再校验”
- 把整段编译写成伪代码
- 主结果:五个房型五十个场景,零碰撞是怎么量出来的
-
- 实验设置:跟谁比,比什么
- 物理有效性:0.0% 对 12.7% 到 47.2%
- 真实布局对齐:LDD 与它的三个核
- 视觉质量与定性对比:评委更在意“少而合理”
- 时间是它顺带的胜利
- 消融:视觉提案与契约各值多少分
-
- 换成文本提案,每一列都会掉
- 契约能修正,但救不了坏提案
- 检索是看不见的地基
- 不只看图:用这批房子训导航策略
-
- 从头训练:35.3% 对 33.0%
- 微调预训练策略:差别出现在未见目标上
- 可控难度:加一条遮挡区,隐藏率从 0.8% 到 16.4%
- 连通性:房间被切碎,训练回合就短
- 代价:时间、token 与它没省掉的东西
-
- 164.2 秒花在哪
- token 与美元:34,867 与 $0.0057
- 资产库与 LoRA 是前置成本
- 局限与失效场景
-
- 作者自己承认的边界
- 我推出来的几个失效场景
- 和我有关的落地判断
-
- 什么团队值得试
- 什么团队别碰
- 如果要复现,先做这三件事
- 术语速查
-
- 方法相关术语
- 指标与缩写
给具身智能造训练环境的人迟早会撞上同一堵墙:真机数据贵、真场景少,想要多样化的训练环境,最现成的办法是用生成器造房子。但“造出来”和“能用”之间隔着一整套几何问题。布局生成器给你一张很好看的俯视图,你把场景导进 Habitat 跑两步就发现:沙发和茶几互相穿插,衣柜有一半在墙外面,餐桌旁边四把椅子全都背对着桌子。
SceneBloom 要解决的就是这一段落差。它的做法不是把渲染做得更漂亮,而是把“摆得像真的”和“几何上成立”拆给两个模块:分层视觉采样负责前者,契约式 3D 编译负责后者。前者用视觉语言模型把房间切成功能区、再用扩散模型给每个区画一张家具摆法的图;后者把图里的家具提升成 3D 盒子,再由视觉语言模型读出“哪把椅子对着哪张桌子”这类关系写成契约,最后让几何编译器在契约约束下修位姿。
规模感先说清楚:五个房型、每房型十个场景,SceneBloom 是唯一一个既没有检测到网格碰撞、也没有越界物体的方法;REST3D 协议下稳定物体率 75.3%,对比 35.1% 到 45.3%;单场景布局生成 2.7 分钟,比 SAGE 快约 27 倍。用这批房子从头训导航策略,在 36 个真实 HM3D 验证房里的成功率 35.3%,比用同等数量真实扫描训出来的 33.0% 还高。代价是它并不省事:需要一套自带 LoRA 的家具资产库,语言模型侧每场景 34,867 个 token。
先说结论:它生成的不是画面,是一个能直接跑仿真的房间
这篇论文最容易被误读成又一个“文生 3D 场景”的工作。把它读完会发现,它真正的主张是一个分工方案,而不是一个更大的生成模型:视觉先验只负责提出“家具该怎么摆”,几何与关系交给另一套流程去兑现。
输入是一条描述,输出是一棵带字段的场景
输入侧极简:一条房间描述就够了,论文实验里用的模板就是 a bedroom 这种形式,再配三个从 M3DLayout 检索来的样板间当作空间先验。
中间表示是一份结构化的 zone plan,字段在附录的提示词里写得很死:房间宽度与深度,以及若干个功能区。每个功能区带一个 2D 多边形、允许的家具类别与整数数量、作为中心件的锚定类别、贴哪面墙、最大物体数、优先级,以及一条给扩散模型的 zone prompt。多边形必须在 [0, W] × [0, D] 里互不重叠并铺满地板。
输出侧是一份编译后的家具布局,补上墙面挂件与台面小物件,得到可导入 Habitat 的仿真场景。注意输出不是像素、不是网格重建,而是每个物体带类别、尺寸、位置与朝向的场景图——这正是策略训练可以直接消费的东西。
两阶段的分工一句话能说完
第一段是分层视觉采样:视觉语言模型负责“这个房间该有哪几个功能区、每区放什么家具”,扩散模型负责“这一组家具具体怎么摆”。房间级结构由分区保证,区内的相对摆放由扩散模型一次联合生成。
第二段是契约式 3D 编译:先提升成 3D,再从提案图上抽关系契约,最后在契约约束下做分层拟合与关系精修。作者的说法是把“要保住的定性关系”和“必须修掉的数值位姿”分开,这句话是全文的枢纽(图 1)。
- 语义规划决定功能组织,回答“卧室要不要工作区”。
- 视觉采样决定区内摆法,回答“工作区的椅子和桌子怎么相对”。
- 关系契约记录“图上看得见的关系”,只记录、不发明。
- 几何编译器只改数值,让盒子不穿插、不越界、关系复原。
为什么“能跑”比“好看”难
因为两段流程的错误性质完全不同。视觉采样阶段追求“看起来像人住的”,它容忍一点透视误差;而从图到 3D 的提升阶段,深度、尺度、位姿的误差会变成硬冲突:物体互相穿插、家具浮在地板上方、整组家具偏出边界。
更麻烦的是,随便挪一下去解冲突,会把“看起来像人住的”毁掉。作者举的例子很典型:你平移椅子解决穿插,它可能就转过身背对书桌了。所以真正的问题不是“怎么修”,而是“修的时候哪些东西不能动”。论文的答案是把这些不能动的东西抽出来存成契约。
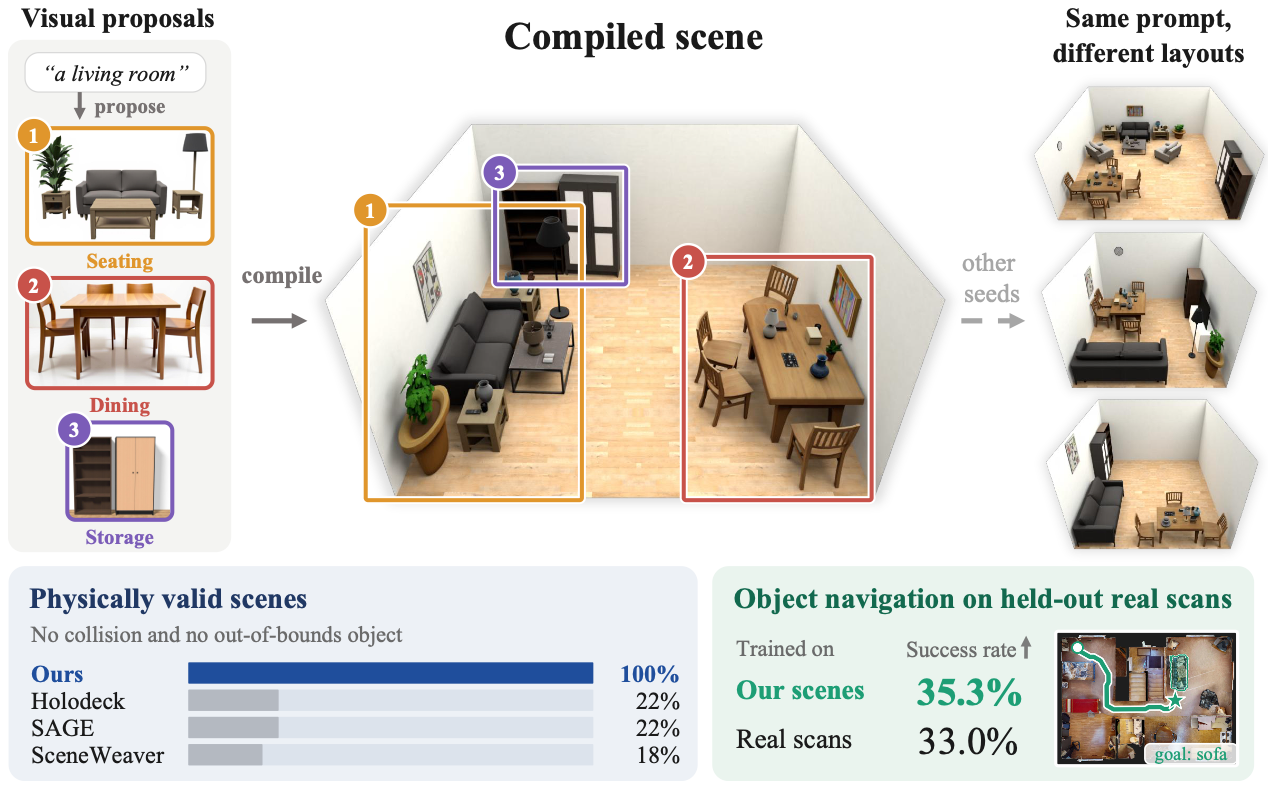 图 1|同一条描述走完两段流程:左侧出分区提案、中间编译成 3D、右侧换种子给出不同布局
已有生成器卡在哪:三条路线各自解决了一半
要判断这篇论文值不值得跟,得先看它批评的对象各自缺什么。论文把相关工作分成三条路线,每条都只解决一半问题。
程序化与学习式布局:被自己的规则框住
程序化方法在手写空间规则下拼装场景,学习式方法(自回归、扩散)从带标注的 3D 场景里学物体配置,物理引导的变体再把几何约束塞进采样。论文的一句判断很干脆:它们的排布始终被自己编码的规则、或自己学过的那些 3D 场景所限制。
语言与 agent 路线:灵活,但一次迭代要跑一整套工具
Holodeck 让大模型写出物体清单与空间约束、再交给求解器满足;SceneWeaver 把生成变成自反思 agent 的工具调用循环;SAGE 引入视觉与物理批评者,在仿真里反复校验摆放。
灵活性的代价是时间。论文实测的平均墙钟时间:SceneWeaver 313.0 分钟、SAGE 73.6 分钟,SceneBloom 2.7 分钟。SAGE 的 504 次工具调用里有 407 次花在摆放上,却只移动了 44 次已放好的物体,说明它的循环主要在加东西而不是改布局;392 次有记录结果的摆放调用里,75 次全部放成功、221 次部分成功、96 次一个都没放下。
图像先验路线:视觉上合理不等于几何上可行
第三类方法用整场景生成或渐进修补拿到图像提案,再恢复并精修 3D 摆放。价值是把图像里海量的“家具通常怎么凑在一起”引进来,缺点是图像层面的合理性不保证与真实资产几何兼容。
SceneBloom 与这条路线最近,区别有两点:提案图画的就是待构建的那批资产(靠资产 LoRA 保证),且编译是在从提案图抽出的契约下进行的。
作者的判断:关系是定性的,位姿是数值的
把三条路线看完,作者的洞察其实只有一句:一张提案图里有两类信息,定性关系(谁对着谁、谁靠在谁旁边)和数值位姿(每个盒子在世界系的六自由度)。前者是人能读懂的功能语义,后者才是提升误差的载体。所以修复只该动后者。
我认为这是全文最可复用的一条经验。它把“生成质量”这个含糊目标拆成两个可以分别度量、分别优化的东西:关系保真度与几何合法率。后面所有实验设计,本质上都在分别报这两个数(图 2)。
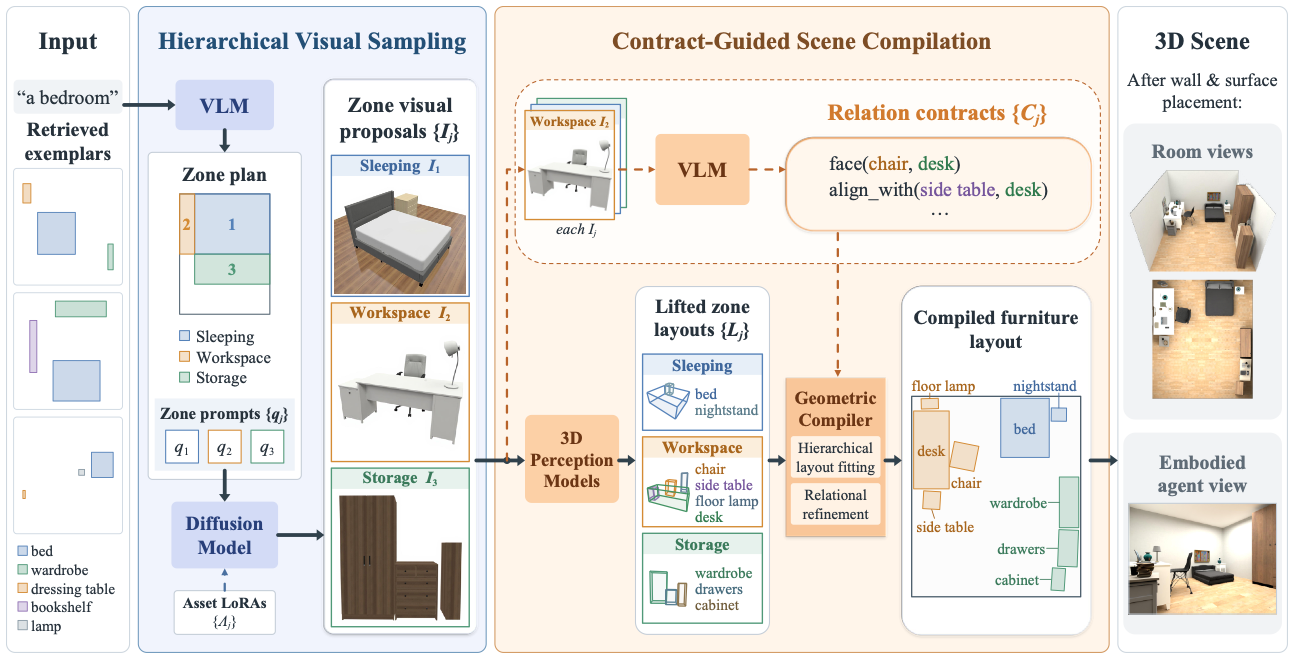 图 2|完整链路:VLM 出分区规划,扩散模型出提案,提升后抽关系契约,几何编译器拟合与精修
第一段:分层视觉采样,规划交给 VLM、摆法交给扩散
这一段的核心是把“房间该有几个区、每区放什么”和“这一组家具具体怎么摆”分成两次决策。前者用语言模型的常识,后者用扩散模型的空间先验。
检索三个样板间,是为了让 VLM 有空间先验
光给一句 a bedroom,语言模型也会分区,但分出来的区往往不带尺寸感。所以流程里加了一步检索:按房型过滤 M3DLayout 的样板间,用 Qwen3-Embedding 编码房间描述与样板间的结构化文本,按余弦相似度排序。
取三个的做法有点讲究:排名第一的固定当地锚,剩下两个按相似度加权、不放回地采样,既保住最近邻,又让参考每次略有不同。语料是两个不相交的索引:5,173 个 3D-FRONT 房间(卧室、客厅、餐厅)与 627 个 Matterport3D 区域(浴室、办公室、厨房等)。
这么做是为了保证样板间与评测参考不重叠。评测参考是 Matterport3D 的卧室、客厅、餐厅区域,以及来自 ScanNet 的 Scan2CAD 房间,两者都不在两个索引里,所以“条件集与评测参考按构造不相交”。消融也证实检索不是装饰:去掉样板间后,视觉语言模型在五个房型里有四个分得更少的功能区,平均 3.14 对 3.94,浴室从 4.40 掉到 1.80,餐厅从 2.90 掉到 1.90;最终场景四轴视觉质量全降,功能性与完整性掉得最狠(5.25 对 6.28、5.87 对 6.76),与 Scan2CAD 的距离从 .1340 退到 .2171。
zone plan 的字段为什么这么设计
提示词里那些啰嗦的约束,每条都在堵一个坑。要求功能区是轴对齐矩形且铺满地板、不重叠不留缝,是为了让分层装配能按分离轴整块搬;要求锚定类别必须在该区允许类别里,是为了让“中心件贴墙面向房间”永远有目标;允许存在一个没有类别、没有锚、最大物体数为 0 的流线区,是为了让模型把用不掉的地板面积合法地扔进去,而不是硬塞家具。
25 个词上限和“类别名前不加形容词”更细:zone prompt 直接喂给扩散模型,形容词会诱导它画出资产库里没有的样式,而没有的东西在提升阶段对不上真实网格。
资产 LoRA:图里的沙发必须就是库里的那只沙发
这是整个方法里最容易被忽略、却最关键的一处工程。资产库总共 192 件:22 个类别的 75 个落地家具网格、109 个台面物件、8 个墙面物件;大部分用 TRELLIS 文生 3D 生成,另有 27 个带关节的落地网格来自 ArtVIP,覆盖八类收纳与卫浴类别。
关键约束是:每一个扩散模型能画出来的落地家具都有一个专属 LoRA,用那个网格的多视角渲染、以 DreamBooth 加先验保持训练,并做正交适配减少互相干扰。触发词插在它代表的类别词前面,所以 zone prompt 里写 sofa,出图就是库里那只特定的沙发。一个功能区最多用五个适配器、每类一个,由 FreeFuse 在一次生成里同时驱动,并把每个适配器绑定到命名它的 token 以及这些 token 关注到的图像区域。
回报是确定的:从图里编译出来的每件家具,都是画它的那个适配器对应的库内网格。编译器重建的是图像真正展示的物件,而不是仅仅同类的网格。
采样公式:换种子就是换布局
I
j
=
G
(
q
j
,
Λ
j
;
ϵ
j
)
I_j = G(q_j, \\Lambda_j; \\epsilon_j)
Ij=G(qj,Λj;ϵj)
公式里 I_j 是第 j 个功能区的提案图,q_j 是该区的 zone prompt,Λ_j 是按该区家具清单选出的 LoRA 适配器集合,ε_j 是扩散种子。生成器用 FLUX.1-dev 配 FreeFuse。
可操作之处全在最后那个 ε_j:资产不变、提示不变、只换种子,就得到同一组家具的不同摆法。总览里专门画了这一格,因为“同一条描述能出多种布局”正是训练环境真正需要的东西——多样性不能来自随机挪家具,得来自合理的不同摆法。
第二段:契约式 3D 编译,先钉住关系再修位姿
如果第一段决定“像不像人住的”,第二段决定“能不能跑”。这端的输入是提案图,输出是每个物体位姿都合法的布局,中间夹着一次关系抽取和两次几何操作。两段里用的都不是全新零件——视觉语言模型、扩散模型、单目提升都是现成的;新的是把它们串起来的这条链路:在任何几何拟合之前,先把“要保住的关系”抽成契约,再让契约同时约束拟合与精修。
提升:单目检测加单目深度,误差是必然的
提升用的是现成组件:Grounding DINO 出 2D 框,OVMono3D-LIFT 把框提升成 3D,深度与相机内参来自 Depth Pro。得到的分区布局里每个物体带类别、尺寸、位置和朝向。
作者把提升误差分成两类,这个分类决定了第二段的结构:一类是物体之间的几何冲突(穿插、重叠、越界),另一类是功能性关系被打断(床头柜不再在床旁边、椅子不再面对桌子)。前一类能用几何解决,后一类必须知道“原本该是什么关系”才能恢复。
关系契约:只记录图上看得见的关系
C
j
=
{
(
u
,
r
,
v
,
γ
)
}
\\mathcal{C}_j = \\{(u, r, v, \\gamma)\\}
Cj={(u,r,v,γ)}
契约是一个四元组的集合:u 是被提升出来的物体,v 是另一个物体或一面墙,r 是关系类型,γ 是视觉语言模型给出的置信度。整份契约在任何几何拟合之前、对每个区的原始提案图只读一次就固定下来,只保留 γ ≥ 0.75 的关系,一次最多返回 10 条。
| face | 主体面向目标 | 绕竖直轴旋转,或移动到目标前方 |
| align_with | 主体与目标轴对齐 | 绕竖直轴旋转 |
| beside | 主体位于目标侧面 | 绕竖直轴旋转,或移动到侧面 |
| move_near | 主体保持在目标可达范围内 | 平移并向目标转向 |
| back_to | 主体背部靠着所在功能区的墙 | 绕竖直轴旋转,或移动到墙边 |
最值得看的是第三列:每种关系只解锁有限的几种修正。这条约束把“修复”变成有界的局部搜索,而不是又一次全局重排;也正因为有界,修复才不会把提案里那些没写进契约的合理摆法搞乱。
作者还强调契约与“语言模型写的约束”不是一回事:后者规定一个布局应该长什么样,而契约记录的是采样出的这个布局里已经存在的关系。这个区别决定了契约不会把视觉先验的多样性抹平,它只是不让已有关系在几何修复里丢掉。
分层拟合:先把每个功能区内部解决干净
拟合分两层。区内的做法是:把锚定物体对齐到它的墙、让它面向房间内部,然后把其余物体从固定的锚和彼此之间分开以消除投影重叠,分开方式按契约的指引决定。拟合完的物体确定该区包络,包络随即冻结,房间级装配只把功能区当刚体整体移动。
区与区之间由 zone plan 决定:每对功能区有固定的分离轴与沿轴先后顺序。贴墙的包络保持贴合,其他包络尽量保留规划位置,否则就沿轴推移靠后的包络,直到它与前一个之间至少留出一个间隙。只有包络在房间里放不下时,房间才会被放大。
这套设计的后果是“区内的相对摆法不被房间级装配破坏”。很多生成器先定房间再往里塞,塞不下就缩家具或挪家具,提案的结构被拆散;这里反过来,先接受家具需要多大,再决定房间要多大。
关系精修:只允许局部旋转与平移
装配完成后,几何谓词逐条检查契约里每个高置信关系。对违反的关系,用该关系专属的算子提出局部旋转或平移,必须通过房间边界与投影可行性检查才被接受。
局部性是关键词:每次调整只动一两个物体的一两个自由度,所以它能把关系救回来,又不打扰提案采出来的整体摆法。图 3 把三种状态并排摆出来:同一份提升结果,原始状态 6 条关系违反 4 条;只做几何拟合,还是违反 4 条;契约引导下先拟合再精修,违反 0 条,且布局依然无碰撞(图 3)。
墙面与台面补全:另一种“先提议再校验”
家具落定后,墙面物件与台面小物件分两步补上,先墙后台面,两步都遵循同一个模式:视觉语言模型挑类别、在目标表面的归一化坐标里提位置,几何侧换算到房间坐标并检查可用空间、边界与相交。
- 墙面:归一化横向坐标 u 线性映射到该区允许的沿墙区间,深度固定在内法线方向 d/2 处,朝向取墙的内法线,纵向坐标 v 在地板与天花板之间挑高度。
- 台面:按支撑面半尺寸缩放归一化坐标、经支撑面自身旋转搬到世界系,高度取台面加一个小间隙,朝向等于支撑面朝向加提议偏航。
- 共同点:只接受有向投影落在内缩支撑矩形内、且不与已接受物体重叠的候选。
把整段编译写成伪代码
仅示意(非可执行实现)
输入:提案图 I_j、资产库、zone plan
输出:仿真就绪的家具布局
# A 提升并抽契约(拟合之前,只读一次)
对每个功能区 j:
L_j = lift(I_j)
C_j = {(u, r, v, γ)},只留 γ ≥ 0.75
# B 分层拟合
对每个功能区 j:
锚定物体贴该区墙面,面向房间内部
分离其余物体,消除投影重叠
分开方式受 C_j 指引
冻结该区包络 E_j
对每一对功能区 i、j:
按分离轴与先后顺序摆放
重叠则沿轴推移靠后的包络,留出间隙
若包络放不进房间:放大房间,不缩家具
# C 关系精修
对 C_j 里每条高置信关系:
若几何谓词判定被违反:
用该关系的专属算子做局部旋转或平移
通过边界与投影可行性检查才接受
# D 补全(先墙后台面,先提议再校验)
按归一化坐标换算,拒绝越界、越出
内缩支撑面、或与已接受物体相交的候选
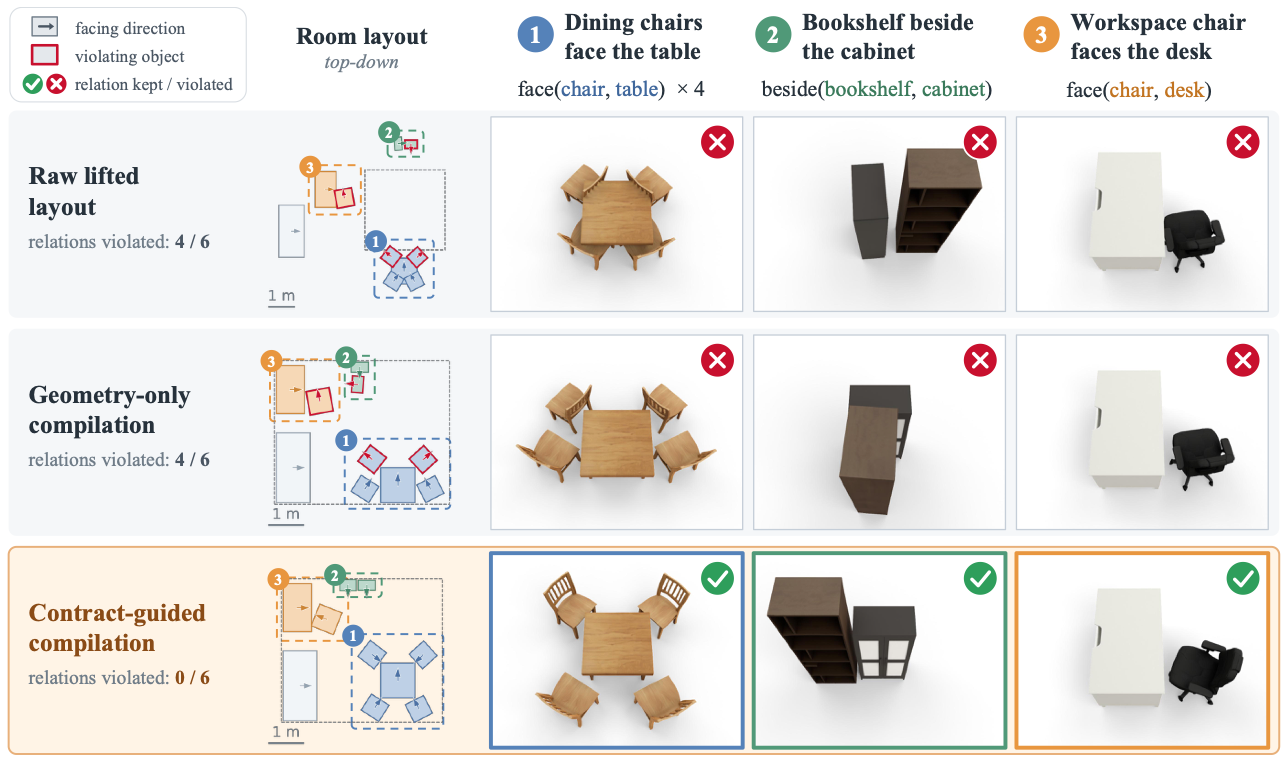 图 3|同一份提升结果的三条路:原始提升违反 4/6 关系,只做几何拟合仍是 4/6,契约引导后为 0/6
主结果:五个房型五十个场景,零碰撞是怎么量出来的
评测分三块:物理有效性、视觉质量、与真实布局分布的距离。三块的量法不一样,也都各有一个可以质疑的地方。
实验设置:跟谁比,比什么
生成侧用 Qwen3-VL-8B-Instruct 做功能分区与场景编译,用 FLUX.1-dev 配 FreeFuse 与资产专属 LoRA 出提案;物理指标按 SceneEval 与 REST3D 的口径算;视觉质量由 GPT-4o-2024-08-06 按四轴打 0 到 10 分;布局距离用 LDD。
对照组是三个官方实现:Holodeck(大模型写约束加求解器)、SceneWeaver(自反思 agent 调度生成与编辑工具)、SAGE(视觉与物理批评者在仿真里校验)。为控制变量,Holodeck 与 SceneWeaver 换成与本文相同的主干 Qwen3-VL-8B-Instruct,SAGE 保留它论文指定的模型组合(GPT-OSS-120B 配 Qwen3-VL-30B-A3B-Instruct)。
各方法的资产来源都保留原样:Holodeck 从 Objaverse 取,SAGE 用 TRELLIS 生成,SceneWeaver 主要用 Infinigen 程序化生成、其余取自 3D-FUTURE 与 Objaverse。作者的理由是这些系统都把资产管线当成贡献的一部分,换成自己的网格就是在评测另一个系统。好处是公平比较了系统,坏处是网格质量差异被混进了视觉分数。
物理有效性:0.0% 对 12.7% 到 47.2%
| Holodeck | 18.0 | 32.7% | 78.0% | 0.160 | 35.1% | 4.66 | 5.07 | 4.23 | 4.30 | .2509 | .2342 | 1.6 |
| SceneWeaver | 18.0 | 47.2% | 82.0% | 0.000 | 45.3% | 5.30 | 5.41 | 4.30 | 5.06 | .2009 | .1797 | 313.0 |
| SAGE | 34.2 | 12.7% | 78.0% | 0.020 | 45.1% | 5.91 | 5.62 | 4.54 | 6.46 | .2191 | .2251 | 73.6 |
| SceneBloom | 23.6 | 0.0% | 0.0% | 0.000 | 75.3% | 6.18 | 6.29 | 4.76 | 6.74 | .1759 | .1340 | 2.7 |
最扎眼的是两个 0.0%:碰撞率归零,越界物体也是零。作者的解释是结构性的——基线都逐个加物体、从不对整个场景统一求解,冲突随场景变大自然累积;SAGE 的 agent 在 50 个场景里用了 407 次摆放调用,只移动过 44 次已放物体;Holodeck 则会在同一点反复生成同一件家具的副本。SceneBloom 先把一个房间的所有家具统一解掉,再逐件校验台面物件与支撑面,所以没有冲突被留到后面。
稳定性还有一组更狠的数字:只看“至少 0.6 米见方”的大件,Holodeck 有 31%、SAGE 与 SceneWeaver 各有 26% 的物体在动态回放中越过稳定阈值,SceneBloom 是 3%。连续量也对得上:平均位置漂移 0.0996 米,对比 0.3698 到 0.9757 米;峰值线速度 0.811 米每秒,对比 1.974 到 2.573;峰值角速度 4.724 弧度每秒,对比 11.015 到 16.727。
真实布局对齐:LDD 与它的三个核
物理合法只说明能跑,不说明像真房间。为此论文引入布局分布差异 LDD:把每个布局映射到结构化描述子,再算生成分布与真实分布之间的无偏最大均值差异,最后取平方根。
L
D
D
(
G
,
R
)
=
M
M
D
R
B
F
2
(
X
,
Y
)
\\mathrm{LDD}(G,R) = \\sqrt{\\mathrm{MMD}^2_{\\mathrm{RBF}}(X,Y)}
LDD(G,R)=MMDRBF2(X,Y)
右边用 RBF 核算,带宽取标准化后参考特征的成对距离中位数;外面套平方根是为了量纲更好读。
描述子的设计有几处讲究:所有空间量相对“功能锚”来量,记录的是房间如何围绕“给它用途的那件家具”组织自己;只取角向傅里叶系数的模,房间与它的旋转副本得到完全相同的特征;计数走 log(1+n)、半径走软分箱,压缩了房间尺寸带来的跨度;类别缺失用存在标志位加其余置零表示,少一整组功能家具的布局依然会被区分开。整套描述子只用类别与位置,不看尺寸、朝向、纹理,也不看资产身份——这点很关键,因为四个方法的资产来源本来就不同。
参考分布用两个独立采集的真实房间集合:Matterport3D 经 M3DLayout 标注给出 236 个卧室、62 个餐厅、76 个客厅区域;Scan2CAD 把 CAD 对齐到 ScanNet 的 1,506 个扫描、704 个空间,再按锚定规则分房型,得到 275 个卧室、495 个餐厅、287 个客厅。零点是“真对真”对照:从留出建筑取十个真实房间、对参考的其余部分打分,200 次抽样的 LDD 中位数在 Matterport3D 上是 −0.001、Scan2CAD 上是 0.014,远低于任何生成方法。
结果上 SceneBloom 在两个参考上都最近(.1759 与 .1340),换核也稳:多尺度 LDD .1617、Layout-KID 2.0391,三个核下都排第一。作者还查了“是不是靠检索蹭分”:30 个被打分场景里没有一个检索到 Matterport3D 区域;在 LDD 特征空间里,一个被打分场景距它检索到的三个样板间平均 6.69、距同房型的其他样板间平均 6.96。
视觉质量与定性对比:评委更在意“少而合理”
四个轴 SceneBloom 全胜(6.18、6.29、4.76、6.74),但更值得看的是对手强在哪、弱在哪。SAGE 放的物体最多(34.2 对 23.6),但它的摆放循环会一直加东西直到地板与台面被塞满,所以功能性与完整性反而更低;Holodeck 与 SceneWeaver 靠文本约束与编辑放家具,功能关系经常丢失,比如餐椅站得离桌子很远、朝向还背对桌子。
定性图把这几种失效摆得很直白:卧室、餐厅、客厅三列,同一房型四种方法各取中位数场景,Holodeck 的椅子背对餐桌、SceneWeaver 的沙发面朝墙且茶几在沙发背后、SAGE 的地板上反复出现装饰陶罐(图 4)。下半部分的六个放大区域把“语义与关系连贯性”和“物理合理性”拆开看:前者对应 1 到 4 号(椅子是否面对桌子、沙发朝向、陶器是否堆地上、椅子是否围绕圆桌),后者对应 5 到 6 号(台面道具是否落在支撑面上而不是底座上)(图 5)。
附录补了办公室与浴室,规律同样成立:Holodeck 的办公室偏空,SceneWeaver 把家具堆在一起,SAGE 塞得太满且浴室洁具朝向不对(图 6)。
时间是它顺带的胜利
2.7 分钟一个场景,对比 SAGE 的 73.6 分钟、SceneWeaver 的 313.0 分钟。原因不神秘:每个区的摆法只采样一次、整房间的几何一次解完,没有逐物体的放置循环。Holodeck 更快(1.6 分钟),但它 78% 的场景含碰撞,这个“快”没有可比性。
测法上有个细节要替作者说清也要指出:运行时间是各自发布管线跑出来的,每个任务一张 H100 级 GPU,唯独 SceneWeaver 跑在 8 个 CPU 核上。所以“比 SAGE 快约 27 倍”在同硬件下成立,但和 SceneWeaver 的对比混了硬件口径,别把它当成严格倍数。
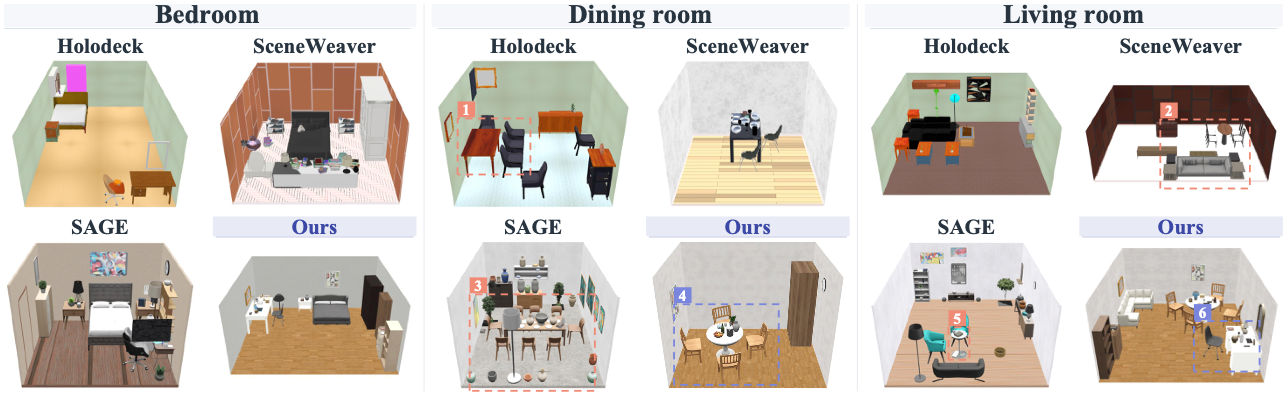 图 4|卧室、餐厅、客厅的四方对比:椅子背对餐桌、沙发面朝墙、陶器堆地上都是基线典型失效
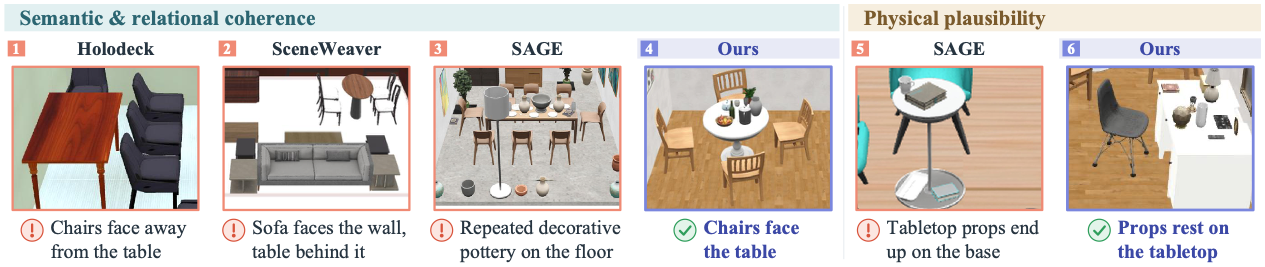 图 5|六个放大区域:1 到 4 看语义与关系连贯性,5 到 6 看台面物体是否真落在支撑面上
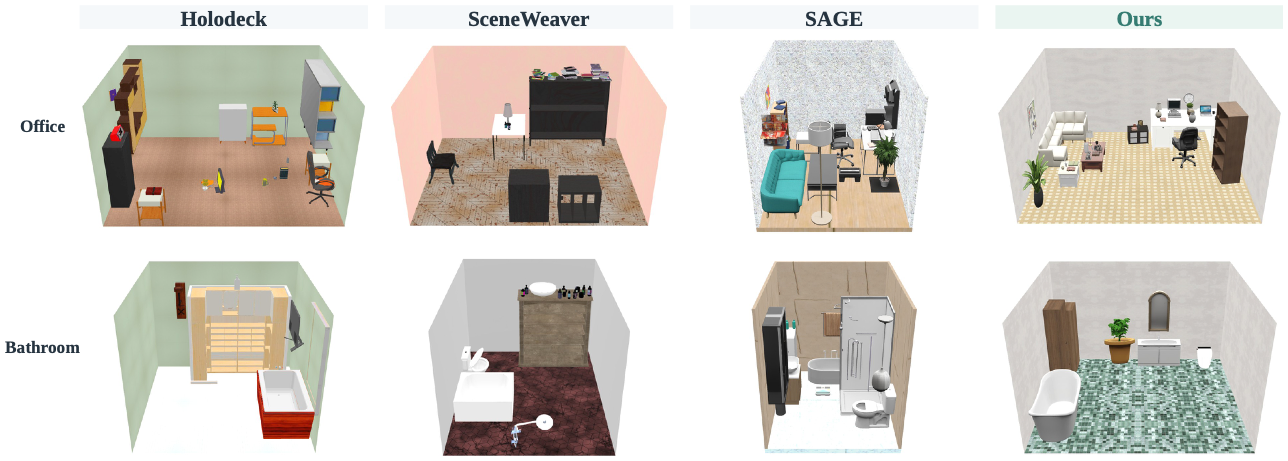 图 6|办公室与浴室的补充对比:Holodeck 偏空,SceneWeaver 把家具堆在一起,SAGE 塞得太满
消融:视觉提案与契约各值多少分
主表领先很多,但领先里有多少来自“扩散模型出图”、多少来自“契约约束”,主表回答不了。消融补的就是这一刀:把提案换成文本(视觉语言模型直接写每个物体的位置与朝向),两种提案各在有契约和无契约下编译,全部在 50 个只含家具的场景上跑,库存、资产、房间尺寸保持一致。
换成文本提案,每一列都会掉
| 文本 | 无 | 0.67% | 4.00% | 98.44% | 5.44 | 5.47 | 4.29 | 3.80 | 39.07% |
| 文本 | 有 | 2.00% | 8.00% | 94.27% | 5.50 | 5.59 | 4.37 | 3.93 | 10.75% |
| 视觉 | 无 | 0.00% | 0.00% | 100.00% | 5.66 | 5.65 | 4.31 | 4.05 | 37.45% |
| 视觉 | 有 | 0.00% | 0.00% | 99.74% | 5.83 | 5.85 | 4.65 | 4.07 | 4.25% |
在两种契约设置下,视觉提案在每一个物理与视觉指标上都赢过文本提案。固定视觉提案、加上契约,连贯性从 4.31 抬到 4.65、真实性从 5.66 抬到 5.83,关系违反率从 37.45% 降到 4.25%,碰撞率保持为零。
契约能修正,但救不了坏提案
最有趣的一行是文本加契约:视觉质量确实涨了(四轴全升),但碰撞率从 0.67% 涨到 2.00%、场景碰撞从 4.00% 涨到 8.00%、稳定率从 98.44% 掉到 94.27%。
作者的解释是:文本提案本身就不太合理,物体比视觉提案更拥挤、有些一开始就互相碰撞,在这种排布里强行恢复关系会引入更多冲突。所以契约的正确定位是“精修一个本来合理的提案”,而不是替代它,这也是 SceneBloom 必须把契约与视觉采样配对的原因(图 7)。
检索是看不见的地基
还有个容易被当成超参数的部件:样板间检索。去掉它,功能区平均数量从 3.94 掉到 3.14,四轴视觉质量全降,与 Matterport3D 的距离从 .1759 退到 .1857、与 Scan2CAD 从 .1340 退到 .2171。最夸张的是浴室:从 4.40 个功能区掉到 1.80 个。
这组数字说明检索的作用不在生成阶段,而在“语言模型怎么把房间拆开”这一步,后面所有模块都建立在这个拆分之上。浴室掉得最狠也合理,它的功能区(淋浴、马桶、洗手台、收纳)最容易靠样板间补常识。
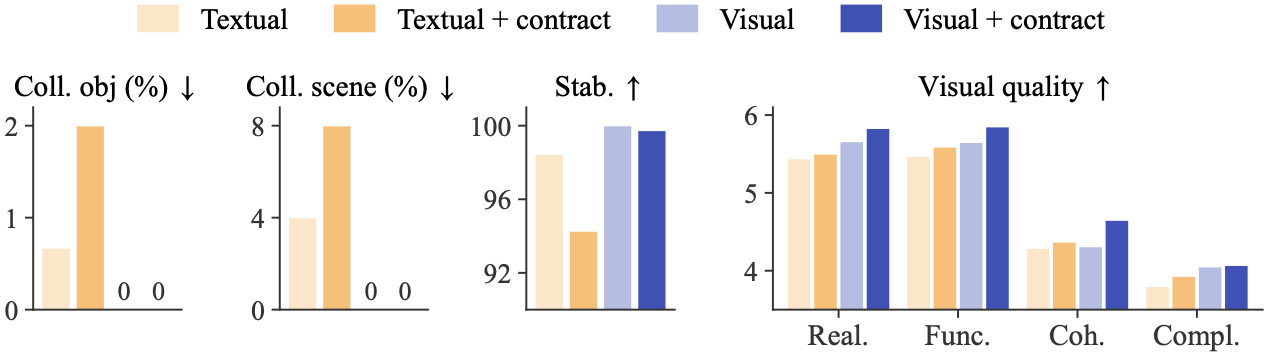 图 7|四组消融柱状:碰撞、稳定性与四轴视觉质量,视觉提案加契约在每一组里都最好
不只看图:用这批房子训导航策略
环境生成的论文最后一定要回答“训出来的策略有没有更好”。这篇做了两组:一组从头训,一组微调预训练策略,评测都在留出的真实扫描环境里。
从头训练:35.3% 对 33.0%
设置是:用 SemExp 的语义图加目标策略,PPO 从头训 2M 步;每个来源给 40、80 或 120 栋房子,每栋由三到五个房间沿一条走廊连起来;在 36 个真实 HM3D 验证房、1000 个回合上评测,成功判定沿用 SemExp。对照有三个:重采样地板物体位置的 Randomized、用文本 agent 出布局的 Agent-planned、以及真实扫描。
| 未训练 | 29.70 | — | — | 12.16 | — | — |
| 真实扫描 | 33.70 | 32.53 | 32.87 | 15.77 | 15.42 | 15.43 |
| Randomized | 32.53 | 32.67 | 33.50 | 15.24 | 15.66 | 16.04 |
| Agent-planned | 34.00 | 34.07 | 34.40 | 16.14 | 15.73 | 15.85 |
| SceneBloom | 34.70 | 35.57 | 35.63 | 15.83 | 16.25 | 16.20 |
从 29.7% 的未训练起点,SceneBloom 平均抬到 35.3%,是真实扫描增益的 1.7 倍——而真实扫描与评测集来自同一个数据集,这已经是偏向基线的最有利设定。更细的一条证据是回合终止质量:SceneBloom 的训练回合有 91.9% 以策略自己调用 STOP 结束,真实扫描是 75.0%;按起点距离分档,我们的房子在 2 米内、2 到 5 米、5 米以上分别是 94.7%、94.6%、88.7%,真实扫描是 85.4%、82.1%、65.9%。
Randomized 为什么不行?它把同样的家具随机撒在同样的房间里,经常把可走地板切成两半,训练时的搜索被困在房子的一部分。Agent-planned 为什么也不行?它共享同一套功能区与资产,但文本 agent 摆得不如视觉提案真实,策略学到的是在真实房间里不常见的排布里搜索(图 8)。
微调预训练策略:差别出现在未见目标上
第二组用 OVSegDT(以 RGB 观测、语言目标、目标掩码与历史为条件的开放词汇策略),从发布权重开始用 PPO 微调 128,000 步;每个生成来源给 120 个场景(五房型各 24 个),真实扫描续训用 142 个 HM3D 训练扫描。评测在留出的生成环境与 HM3D-OVON Val Unseen 的 864 回合子集上(覆盖全部 36 个场景)。
| 预训练不微调 | 73.67 | 61.31 | 52.57 | 38.29 | 48.26 | 21.18 |
| 142 个真实扫描续训 | 73.02 | 61.12 | 51.59 | 38.42 | 47.57 | 20.68 |
| Randomized | 74.88 | 63.26 | 51.51 | 38.09 | 48.15 | 20.74 |
| Agent-planned | 74.39 | 63.39 | 51.63 | 37.65 | 47.99 | 20.72 |
| SceneBloom | 74.60 | 64.00 | 53.19 | 38.89 | 48.57 | 21.17 |
盯住“未见目标”那一列:SceneBloom 是唯一在未见目标类别上把 SR 抬到预训练之上的(53.19 对 52.57),其他微调策略在这一列都掉到预训练以下。已见目标那一列反而反直觉:Randomized 的 SR 最高(74.88),说明已见目标上布局多样性比真实性更能刷分,但到了未见目标与真实环境这个优势就没了。
论文还做了一次标注清洗:864 个真实回合里有些目标标注与实际物体不符,86 个根本没有标对的目标。按预先固定的规则剔除后保留 631 个回合,SceneBloom 相对预训练的 SR 增益从 0.31 个百分点涨到 0.52,遮挡版本相对预训练从 1.24 涨到 2.00 个百分点。
可控难度:加一条遮挡区,隐藏率从 0.8% 到 16.4%
单房间场景有个天生缺陷:目标大多一眼可见。真实住宅里目标经常藏在墙和家具后面。因为 SceneBloom 把房间组织成功能区,它可以按区加难度:用与前面相同的提示重新生成每个场景,额外加一个放高衣柜的室内功能区当遮挡。
效果很直接:目标在起点原地转一圈后仍不可见的比例从 0.8% 抬到 16.4%,起点朝向下就不可见的从 50.1% 抬到 68.2%,而真实评测回合是 58.9% 与 87.7%。真实环境 SR 也从 48.57% 抬到 49.50%。对照实验更能说明问题:同样加遮挡物、但把其他地板物体随机重排的 Randomized 只有 48.34%,比不加遮挡的 SceneBloom 还低——难,但必须难在一个自洽的布局里才有用。
连通性:房间被切碎,训练回合就短
还有个不显眼却决定训练质量的指标:导航网格连通性。同一个 agent 几何下测,SceneBloom 的布局只有 2.6% 是碎片化的、0.9% 出现纯地板分裂、最大连通岛平均覆盖 99.68% 的可走面积;Randomized 是 37.9%、36.8%、88.23%。
后果体现在回合构成上:Randomized 有 41.1% 的训练回合来自碎片化场景,SceneBloom 只有 2.0%;碎片化场景里回合更短,中位测地长度 1.94 米对连通场景的 2.27 米。80 栋的训练集上,最大可走岛在 SceneBloom 的房子里覆盖 98.4%、Randomized 只有 86.7%。这类统计很少出现在生成论文里,但对训策略的人比多 0.1 的视觉分重要得多。
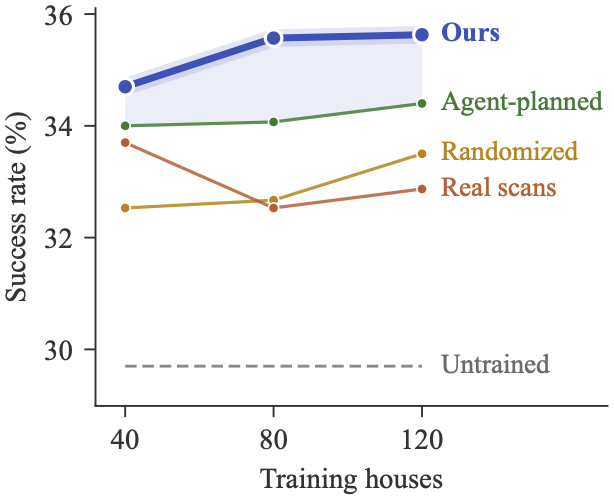 图 8|从头训练的 SR 曲线:40、80、120 栋时本文都最高,灰色虚线是未训练策略的 29.7%
代价:时间、token 与它没省掉的东西
这篇论文的性价比看起来很好,但“看起来”和“算下来”之间还差几项固定成本。
164.2 秒花在哪
50 个场景的生产运行里,平均每场景的布局生成耗时 164.2 秒,拆开是四段:
- 功能分区 45.3 秒,占 27.6%。
- 视觉提案生成 74.6 秒,占 45.4%,是最大头。
- 提升与契约式编译 23.8 秒,占 14.5%。
- 墙面与台面补全 20.3 秒,占 12.4%。
这份拆解透露两件事。扩散采样占近一半,换更快的采样器或更小的底座会直接省时间;整套几何编译只花 23.8 秒,比它要替代的那些 agent 循环便宜得多——这是“把迭代换成一次编译”最实在的回报。
token 与美元:34,867 与 $0.0057
| Holodeck | Qwen3-VL-8B-Instruct | 6,986 | $0.0016 |
| SceneWeaver | Qwen3-VL-8B-Instruct | 154,649 | $0.0228 |
| SAGE | GPT-OSS-120B 加 Qwen3-VL-30B-A3B-Instruct | 293,499 | $0.0151 |
| SceneBloom | Qwen3-VL-8B-Instruct | 34,867 | $0.0057 |
34,867 个 token、$0.0057,比 SAGE 少八倍 token、比 SceneWeaver 少四倍。只有 Holodeck 更省,但它的碰撞率是 32.7%。所以这条曲线上的定位很清楚:它不是最便宜的,但在“物理合法”这个前提下是最便宜的。
资产库与 LoRA 是前置成本
真正的大头没被计进上面的时间:资产库要建(192 件,大部分靠 TRELLIS 生成),落地家具每一件都要训一个 LoRA。论文把可扩展性写得很明确:只要新网格有训好的 LoRA,采样器就能画它,语言模型、编译器与提示词都不用改。
反过来说,这句话也划定了门槛:想加一个资产类别,你要走完建模、多视角渲染、训 LoRA、验证触发词与融合这一整套流程。这是这篇论文最不“开箱即用”的地方。
局限与失效场景
结论部分写得克制,但把正文与附录的边界条件拼起来,能看出这套方法在哪些输入上会退化。
作者自己承认的边界
- 稳定性不满格:75.3% 的稳定物体率意味着约四分之一的可动物体仍会在回放里漂移或转动超阈值。
- 关系提取依赖视觉语言模型:契约只收置信度不低于 0.75 的关系、一次最多十条,漏掉的关系不会被恢复。
- 资产库只有 22 个落地家具类别,换资产要么重训 LoRA,要么接受图与实物不匹配。
- 质量评分的裁判是单一模型:GPT-4o 温度 0、每场景五次取平均,本质是主观判断的自动化。
- LDD 只覆盖卧室、餐厅、客厅三个房型,浴室与办公室没有真实分布可比。
我推出来的几个失效场景
第一,提升环节错得太多时,契约与几何会打架。契约抽自“图上看起来的关系”,几何事实来自单目提升;当深度或框严重跑偏时,恢复某条关系可能需要把物体推到不合理位置,此时有界的局部算子要么找不到合法解、要么解出来更糟。论文没报这种冲突的统计,但“文本提案加契约反而碰撞变多”说明机制存在。
第二,稀疏房型退化明显。浴室去掉检索后功能区从 4.40 掉到 1.80,说明这类房间的常识高度依赖样板间。如果你的目标房型(实验室、机房、病房)在语料里稀有,分区质量会先掉。
第三,难度可控目前只在“加一条衣柜遮挡区”上验证过。真实住宅的难度还来自多房间连通、门洞、楼梯与走廊,而微调那组用的是单房间场景,多房间只在从头训练那组用“三到五个房间加一条走廊”拼过。
第四,各方法资产来源不同,作者选择保留各自资产管线:系统层面公平,但“视觉质量”这类会被网格质感影响的指标,差异无法完全归因到布局算法。
和我有关的落地判断
这篇论文的价值不在于又一个生成器,而在于它给出的分工可以拆开用。下面是我对“谁该试、谁别碰”的判断。
什么团队值得试
如果你的团队已经在用 Habitat 或 Isaac 训导航、操作策略,痛点是“场景不够多、真实扫描太贵”,这套流程收益可预期:一次性把管线搭起来,之后每场景 2.7 分钟、约 $0.0057 的语言模型成本,换来物理合法、布局像真房间的训练数据。特别是需要“目标被遮挡”这类难度变体时,按功能区加遮挡物非常便宜。
另一类合适的是做场景生成却卡在物理合法性上的团队:你已有不错的采样器,缺的只是“提升之后怎么修”,那么契约加分层拟合可以单独摘出来接在后面,前提是采样器能输出可读关系的图或布局。
什么团队别碰
资产以自有 CAD 为主、类别非常规的团队先别碰:整个流程的前提是每件落地家具都有 LoRA、且类别是常见的二十来类,为几十件特种设备训 LoRA 的成本很可能超过收益。
要求毫米级几何精度的团队也别碰:单目深度加单目检测这条提升链路的上限就在那里,它做的是布局级正确,不是摆放级精确。需要精细装配的训练场景,位姿误差会直接毁掉任务。
最后,如果你只需要俯视渲染图做配图、不需要真跑仿真,这套编译流程是纯浪费,用扩散模型直接出图就够。
如果要复现,先做这三件事
术语速查
下面把文中的关键名词与指标收在一起,方便回查原文。
方法相关术语
| 分层视觉采样 | 先由 VLM 出功能区规划,再由扩散模型按区生成家具摆法提案图 |
| zone plan | 结构化房间规划:房间尺寸加若干功能区,每区带多边形、类别数量、锚定类别与提示词 |
| 资产 LoRA | 为每件落地家具单独训练的适配器,使提案图画出的就是库内那只网格 |
| FreeFuse | 多主体 LoRA 融合方法,按 token 级路由让多个适配器在一次生成里共存 |
| 关系契约 | 从提案图抽出的四元组集合,记录主体、关系、目标与置信度,编译前固定 |
| 分层布局拟合 | 区内消重叠并冻结包络,区与区沿分离轴整块装配,房间不够大时放大房间 |
| 关系精修 | 用关系专属的局部旋转与平移把被违反的高置信关系复原 |
| 功能锚 | 给房间定用途的中心家具,分区描述子与 LDD 都以它为参照 |
| 遮挡区 | 额外生成的一类功能分区,放高衣柜遮挡目标,用来提高训练场景的搜索难度 |
指标与缩写
- Coll. obj:参与至少一次网格相交的物体百分比,接触容差为零。
- Coll. scene:含至少一个此类物体的场景百分比。
- OOB:每场景越界物体数的均值,用射线投射判定,容差 1%。
- Stab.:REST3D 协议下稳定物体百分比,位移不超过 0.1 米且旋转不超过 0.1 弧度。
- Real. / Func. / Coh. / Compl.:GPT-4o 打分的真实性、功能性、布局连贯性、完整性,0 到 10 分。
- LDD:布局分布差异,对结构化描述子做无偏最大均值差异后取平方根,越低越接近真实分布。
- SR / SPL:导航成功率与按路径长度加权的成功率。


评论前必须登录!
注册