 网硕互联帮助中心
文章目录
- MFH‑NAS:面向多模态融合目标检测的混合神经架构搜索框架
-
- 创新点
-
- 0.1 问题引入
- 0.2 本文贡献
- 方法
-
- 3.1 融合架构搜索空间的定义
- 3.2 双层搜索策略设计
-
- 3.2.1 可微梯度下降搜索阶段
- 3.2.2 进化算法搜索阶段
- 4 实验
-
- 4.1 实验细节
- 4.2 单融合方法搜索对比分析
- 4.3 多融合方法搜索对比分析
- 4.4 消融实验
MFH‑NAS:面向多模态融合目标检测的混合神经架构搜索框架
- 论文:https://openreview.net/pdf?id=FBcQKC3pLh
- 代码:https://github.com/someboy0/MFH-NAS
- 会议:ICML
- 年份:2026
创新点
0.1 问题引入
\\qquad
多模态融合目标检测整合异构传感器(可见光、红外等)采集的互补信息,往往能够提升检测性能。该技术的核心在于融合模块的设计与融合阶段的选取。
\\qquad
然而现有绝大多数多模态融合工作重点放在融合模块设计,忽视融合架构的探索。如图 1 所示,现有多数多模态融合方法采用预定义、阶段对齐的融合架构,不同模态的特征在特定语义层级完成对齐与融合(图 1 (a)(b))。这类方案既没有对融合阶段、融合阶段数量做系统性探索,还将融合交互限制在骨干网络的对应阶段,难以充分挖掘不同模态跨层级的语义互补性。
因此人工设计方案很难同时兼顾效率与最优性
\\boxed{因此人工设计方案很难同时兼顾效率与最优性}
因此人工设计方案很难同时兼顾效率与最优性。
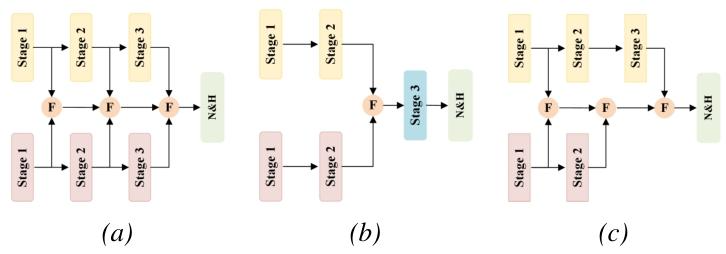
图 1:三种融合架构。(a)(b) 为对称融合架构:(a) 在特征提取的每一个阶段都执行融合;(b) 仅在特征提取中间阶段做融合;( c ) 是非对称融合架构,实现跨模态不同层特征融合。黄色、粉色、蓝色块分别代表可见光、红外、融合特征处理阶段;F 代表融合操作;N&H 代表颈部网络与检测头。
0.2 本文贡献
本文主要贡献总结如下:
方法
本文提出 MFH‑NAS 混合神经架构搜索框架,自动设计面向目标检测的多模态融合架构。如图 2,MFH‑NAS 包含四阶段流水线: 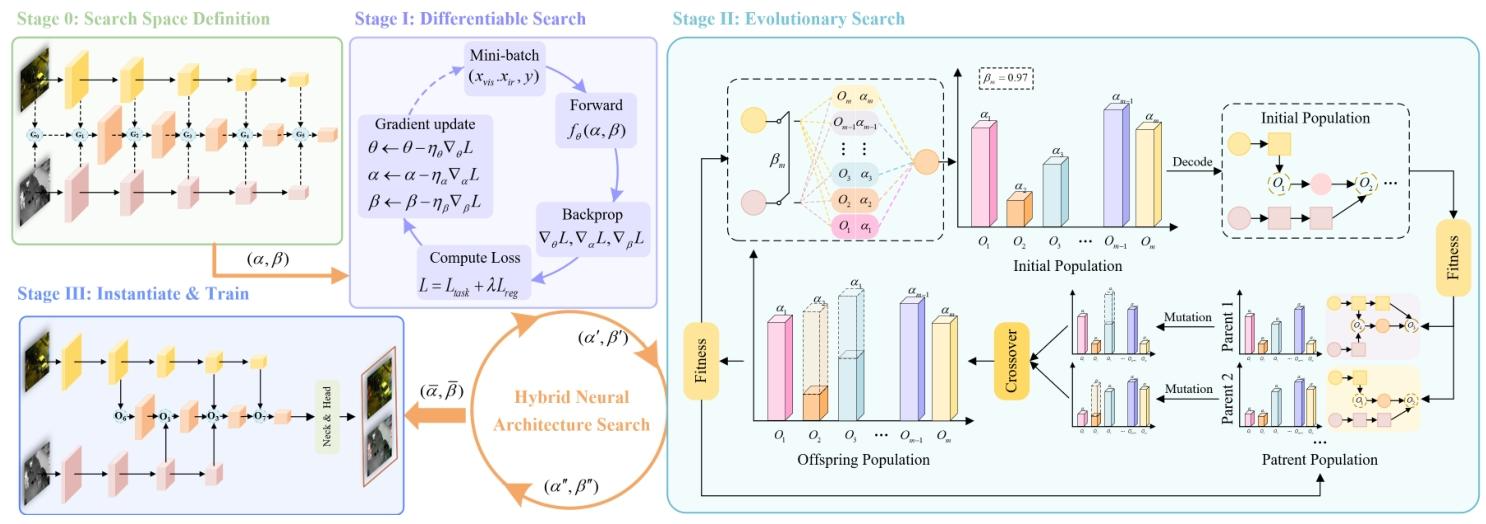
图 2:MFH‑NAS 总览,四阶段流水线结合可微搜索与进化搜索。
- 第零阶段(浅绿色):定义融合架构搜索空间,初始化架构参数
α
\\alpha
α、β
\\beta
β,送入阶段I
\\textbf{I}
I。 - 阶段
I
\\textbf{I}
I(浅紫色):执行可微搜索,在超网络内固定轮数优化α
\\alpha
α、β
\\beta
β,输出更新后的参数α
′
\\alpha'
α′、β
′
\\beta'
β′。 - 阶段
II
\\textbf{II}
II(浅青色):以阶段I
\\textbf{I}
I输出参数为种子,进化算法针对阶段级连接关系、算子配置做种群层面探索;进化得到最优参数α
′
′
\\alpha''
α′′、β
′
′
\\beta''
β′′反馈回阶段I
\\textbf{I}
I,形成交替优化循环,循环N
N
N轮。 - 阶段
III
\\textbf{III}
III(浅蓝色):收敛以后使用最终架构参数α
ˉ
\\bar{\\alpha}
αˉ、β
ˉ
\\bar{\\beta}
βˉ实例化搜索得到的架构,重新训练得到最终检测模型。
3.1 融合架构搜索空间的定义
\\qquad
如图 2 绿色区域,融合架构包含三条并行分支:两个模态专属骨干网络分别提取可见光、红外分阶段特征;一条融合分支整合跨阶段多层信息。黄色块代表可见光中间特征,粉色块代表红外中间特征;融合分支是架构核心,由门控融合策略(GFS)选择器(蓝色圆圈 G)构成;橙色块表示融合后特征。
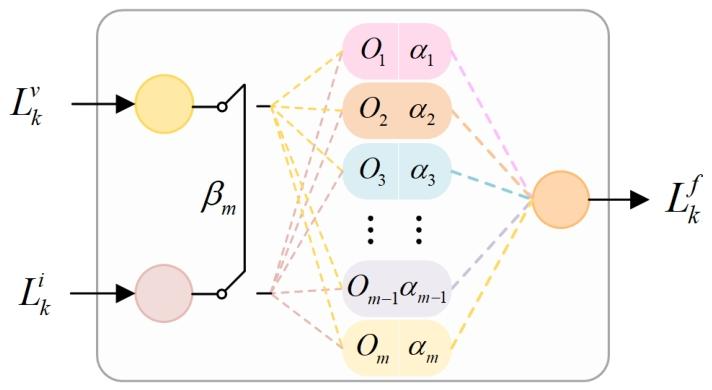
图 3:门控融合策略 (GFS) 模块架构。
我们定义的融合架构搜索空间包含两类可搜索单元,共同决定跨模态交互发生的位置与方式。
n
n
n个阶段,额外包含输入层,共计
n
+
1
n+1
n+1个候选融合点。每个候选点做二元决策:是否向分支注入特征。一共产生
2
n
+
1
2^{n+1}
2n+1种阶段连接方式;排除全部不注入特征的无效模式,有效方案数量为
2
n
+
1
−
1
2^{n+1}-1
2n+1−1。
{
O
i
}
i
=
1
m
\\{O_i\\}_{i=1}^{m}
{Oi}i=1m,引入可学习架构参数
α
=
{
α
i
}
i
=
1
m
\\alpha=\\{\\alpha_i\\}_{i=1}^{m}
α={αi}i=1m与
β
\\beta
β。经过softmax归一化的
α
\\alpha
α为候选算子分配权重,构成可谓混合输出;经过sigmoid激活的门控参数
β
\\beta
β控制当前阶段GFS模块是否参与运算。
图 4 列举不同输入条件下 GFS 的 7 种工作模式。假设融合在第
k
k
k阶段开启: 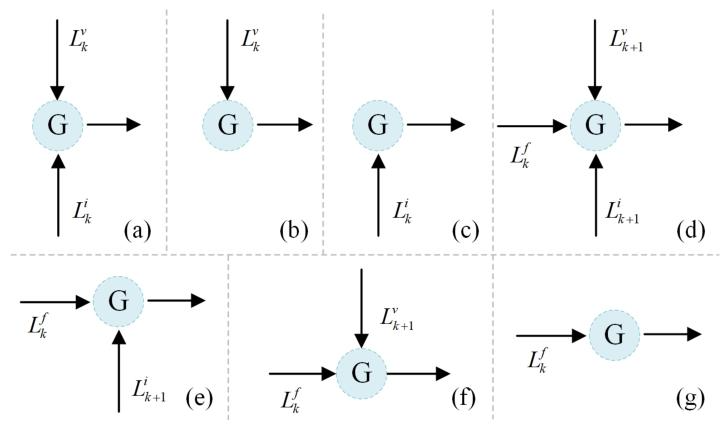
图 4:不同阶段输入条件下 GFS 的 7 种工作模式。
-
k
k
k阶段:GFS可以对可见光特征L
k
v
L_{k}^v
Lkv、红外特征L
k
i
L_k^i
Lki执行m
m
m种融合算子之一;也可以直接转发可见光/红外特征,跳过融合,一共m
+
2
m+2
m+2种选择。 - 后续
k
+
1
k+1
k+1阶段:模块额外接收上一步融合输出特征L
k
f
L_k^f
Lkf,产生m
2
m^2
m2种两步融合选择、2
m
2m
2m种单分支融合选择、1种跳过选择,总计m
2
+
2
m
+
1
m^2+2m+1
m2+2m+1种融合模式。
给定
n
n
n个候选阶段,
m
m
m个候选融合算子,搜索空间整体规模:
S
=
∑
k
=
1
n
(
m
+
2
)
(
m
2
+
2
m
+
1
)
n
−
k
(1)
S=\\sum_{k=1}^n(m+2)\\left(m^2+2m+1\\right)^{n-k}\\tag{1}
S=k=1∑n(m+2)(m2+2m+1)n−k(1)
本文设置
n
=
6
n=6
n=6中间特征提取阶段,
m
=
8
m=8
m=8候选融合算子,搜索空间规模
S
=
3.53
×
10
10
S=3.53\\times10^{10}
S=3.53×10¹⁰种架构。可见随着融合方法、阶段数量增加,网络架构搜索空间指数级膨胀,达到百亿规模。依靠穷举搜索或者缺少理论引导的 NAS 会带来巨大计算开销,无法在合理时间内完成有效搜索,实用性差。因此必须设计高效搜索策略。
3.2 双层搜索策略设计
3.2.1 可微梯度下降搜索阶段
\\qquad
第一阶段采用可微 NAS (Liu 等人,2018) 实现快速优化。每个 GFS 视为独立搜索单元。图3种共有
m
m
m种可选融合方法,每种算子对应可学习权重
α
i
\\alpha_i
αi。对
α
i
\\alpha_i
αi做softmax归一化,得到各个操作的权重系数。融合模块最终输出为全部候选操作的加权求和。GFS 模块输出定义:
f
(
x
v
i
s
,
x
i
r
)
=
∑
i
=
1
m
softmax
(
α
i
)
⋅
O
i
(
x
v
i
s
,
x
i
r
)
(2)
f(x_{vis},x_{ir})=\\sum_{i=1}^{m}\\text{softmax}(\\alpha_i)\\cdot O_{i}(x_{vis},x_{ir})\\tag{2}
f(xvis,xir)=i=1∑msoftmax(αi)⋅Oi(xvis,xir)(2)
O
i
(
x
v
i
s
,
x
i
r
)
O_i(x_{vis},x_{ir})
Oi(xvis,xir)是第
i
i
i种融合方法作用于多模态输入特征
x
v
i
s
,
x
i
r
x_{vis},x_{ir}
xvis,xir的输出;
α
i
\\alpha_i
αi是第
i
i
i个融合操作的可学习权重。公式 (2) 将离散的融合方法搜索空间松弛为连续可微空间。
\\qquad
另外引入科学系控制参数
β
\\beta
β,sigmoid激活函数输出控制GFS模块是否启用;输出越接近1,启用概率越高;越接近 0,越倾向跳过该模块。最终融合输出:
g
(
x
v
i
s
,
x
i
r
)
=
sigmoid
(
β
)
⋅
f
(
x
v
i
s
,
x
i
r
)
(3)
g(x_{vis},x_{ir})=\\text{sigmoid}(\\beta)\\cdot f(x_{vis},x_{ir})\\tag{3}
g(xvis,xir)=sigmoid(β)⋅f(xvis,xir)(3)
α
\\alpha
α、
β
\\beta
β功能互补:
α
\\alpha
α对候选融合算子加权;
β
\\beta
β控制每个GFS模块的激活状态。
\\qquad
阶段 I 中,二者作为连续参数,与网络权重联合优化。阶段 II 中将它们离散化为算子选择、GFS 门控状态;进化得到最优架构,把选中算子与激活门控索引回传给下一轮可微搜索。最终保留
s
i
g
m
o
i
d
(
β
)
>
0.5
sigmoid(\\beta)>0.5
sigmoid(β)>0.5的GFS模块;每个保留模块选取
α
\\alpha
α权重最大的算子。
\\qquad
将多模态融合目标检测架构搜索空间的操作参数松弛为连续空间,就可以用梯度下降同时优化网络权重与架构参数,同时优化模型性能与架构。训练过程中计算每个候选操作权重,最小化如下损失函数选择最优架构:
L
(
θ
,
α
,
β
)
=
L
t
a
s
k
(
f
θ
(
α
,
β
)
)
+
λ
L
r
e
g
(
α
,
β
)
(4)
L(\\theta,\\alpha,\\beta)=L_{task}(f_{\\theta}(\\alpha,\\beta))+\\lambda L_{reg}(\\alpha,\\beta)\\tag{4}
L(θ,α,β)=Ltask(fθ(α,β))+λLreg(α,β)(4)
L
t
a
s
k
L_{task}
Ltask为任务损失(多模态目标检测的分类、回归损失);
f
θ
(
α
,
β
)
f_\\theta(\\alpha,\\beta)
fθ(α,β)由网络权重
θ
\\theta
θ、架构参数
α
、
β
\\alpha、\\beta
α、β定义;正则项
L
r
e
g
(
α
,
β
)
L_{reg}(\\alpha,\\beta)
Lreg(α,β)防止架构参数过拟合;
λ
\\lambda
λ控制架构复杂度。利用梯度下降,同时优化网络权重向量与架构参数:
(
θ
∗
,
α
∗
,
β
∗
)
=
arg
min
θ
,
α
,
β
L
(
θ
,
α
,
β
)
(5)
(\\theta^*,\\alpha^*,\\beta^*)=\\arg\\min_{\\theta,\\alpha,\\beta}L(\\theta,\\alpha,\\beta)\\tag{5}
(θ∗,α∗,β∗)=argθ,α,βminL(θ,α,β)(5) 通过该过程,架构参数
α
\\alpha
α、
β
\\beta
β被优化为适配任务的最优架构,输出最优多模态目标检测架构。
3.2.2 进化算法搜索阶段
\\qquad
第二阶段采用进化算法优化 (Real 等人,2019)。如图 2,经过若干轮迭代,基于可微搜索输出权重分布筛选一批高性能候选架构,作为进化阶段初始种群。初始种群包含
N
N
N个个体,每个个体架构
A
i
A_i
Ai由一组架构参数
α
\\alpha
α、
β
\\beta
β构成:
A
i
=
[
α
1
,
α
2
,
⋯
,
α
k
,
β
]
,
(
i
=
1
,
⋯
,
N
)
(6)
A_i=[\\alpha_1,\\alpha_2,\\cdots,\\alpha_k,\\beta],\\qquad(i=1,\\cdots,N)\\tag{6}
Ai=[α1,α2,⋯,αk,β],(i=1,⋯,N)(6)
其中,
α
j
∈
{
t
1
,
t
2
,
⋯
,
t
m
}
\\alpha_j\\in\\{t_1,t_2,\\cdots,t_m\\}
αj∈{t1,t2,⋯,tm},
m
m
m代表多模态对称融合方法总数;
t
τ
t_{\\tau}
tτ代表第
τ
\\tau
τ种多模态对称融合方法;
α
j
\\alpha_j
αj代表网络第
j
j
j处选择的操作;
β
\\beta
β控制GFS模块是否开启:
s
i
g
m
o
i
d
(
β
)
sigmoid(\\beta)
sigmoid(β)趋近于1代表开启,趋近于0表示关闭
\\qquad
每个个体架构
A
i
A_i
Ai在多模态目标检测任务上训练,通过目标损失函数计算适应度。适应度函数综合检测精度(mAP)与模型计算复杂度(FLOPs、参数量):
f
(
A
i
)
=
−
(
λ
t
a
s
k
⋅
L
t
a
s
k
(
A
i
)
+
λ
c
o
m
⋅
L
c
o
m
(
A
i
)
)
(7)
f(A_i)=-(\\lambda_{task}\\cdot L_{task}(A_i)+\\lambda_{com}\\cdot L_{com}(A_i))\\tag{7}
f(Ai)=−(λtask⋅Ltask(Ai)+λcom⋅Lcom(Ai))(7)
L
t
a
s
k
(
A
i
)
L_{task}(A_i)
Ltask(Ai)为多模态目标检测任务损失,衡量架构性能;
L
c
o
m
(
A
i
)
L_{com}(A_i)
Lcom(Ai)是复杂度损失,和网络计算量、参数量相关;非负参数
λ
t
a
s
k
、
λ
c
o
m
\\lambda_{task}、\\lambda_{com}
λtask、λcom平衡任务性能与模型复杂度。本文全部主实验设置
λ
t
a
s
k
=
1
,
λ
c
o
m
=
0.1
\\lambda_{task}=1,\\lambda_{com}=0.1
λtask=1,λcom=0.1。适应度数值越高,代表任务表现越好。
\\qquad
之后选择高适应度架构作为父代种群,通过选择、交叉、变异生成新一代。选择操作:依据适应度从当前种群挑选性能优异个体;交叉操作:两个父代个体交换部分基因(架构参数)生成子代;变异操作:对部分个体基因做小规模随机修改,提升种群多样性,可以随机修改架构中某一层的操作。新一代继续执行适应度评估、选择、交叉、变异,迭代直到满足停止条件。
\\qquad
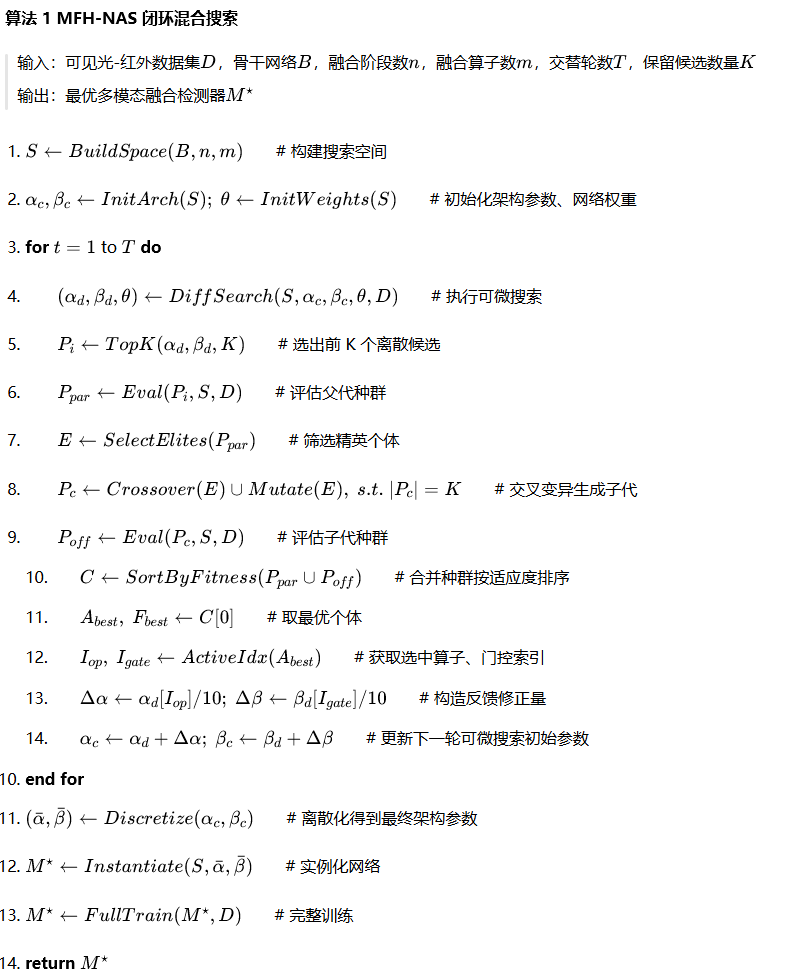
算法 1 总结闭环搜索流程。MFH‑NAS 首先构建融合阶段、融合算子的搜索空间,初始化连续架构参数与网络权重。每一轮交替循环:阶段 I 在超网络内做可微搜索更新连续参数,学习局部算子偏好、GFS 激活倾向;把架构分布转化为 Top‑K 离散候选,送入阶段 II,通过精英选择、交叉、变异、适应度评估完成优化。取出本轮最优离散架构,提取选中融合算子、启用 GFS 模块,生成反馈修正量
(
Δ
α
,
Δ
β
)
(\\Delta\\alpha,\\Delta\\beta)
(Δα,Δβ),作为下一轮可微搜索的初始化,形成连续算子优化与离散拓扑优化的闭环。交替过程收敛后,保留激活的 GFS 模块,每个模块选取权重最高算子,得到最终架构。
4 实验
\\qquad
本章介绍实验实现细节、数据集、评价指标。设置两组搜索实验:①在 M3FD 上做单融合方法阶段搜索,对比不同阶段搜索策略;②在 M3FD、LLVIP、RGBT‑Tiny 做多算子搜索,同时优化融合阶段与融合算子。最后在 M3FD 开展消融实验,量化各个组件贡献:可微搜索、进化搜索、多算子搜索空间。
4.1 实验细节
MFH‑NAS 基于 PyTorch2.7.1 实现,使用 6 张 NVIDIA RTX5090 GPU,CUDA12.9。实验数据集采用 M3FD、LLVIP、RGBT‑Tiny 三个主流基准。每个模态流使用 YOLO11n 作为检测器骨干网络。架构搜索时,骨干网络 5 个阶段 + 输入层,一共 6 个候选融合阶段。从 12 种近期 RGB‑T 融合策略中挑选 8 个性能优异的方法作为候选融合算子。
搜索流程:阶段 I 可微搜索执行 1000 轮 epoch;初始学习率 0.025,最小学习率 0.001;架构参数学习率
3
×
10
−
4
3\\times10^{-4}
3×10⁻⁴。每 100 个 epoch 导出一组离散候选架构,性能靠前的候选用于初始化阶段 II 种群。阶段 II 进化搜索运行 10 代;架构学习率
3
×
10
−
4
3\\times10^{-4}
3×10⁻⁴,
β
\\beta
β参数学习率
1
×
10
−
3
1\\times10^{-3}
1×10⁻³。网络使用 SGD 优化器,动量 0.9;网络权重衰减
3
×
10
−
4
3\\times10^{-4}
3×10⁻⁴;架构参数权重衰减
1
×
10
−
3
1\\times10^{-3}
1×10⁻³;
β
\\beta
β参数权重衰减
1
×
10
−
3
1\\times10^{-3}
1×10⁻³;梯度裁剪阈值 5。可微搜索、进化搜索交替迭代直到搜索结束。
模型评价指标:目标检测标准指标,IoU 阈值 0.5 下平均精度 mAP@0.5;以及 IoU 0.5~0.95 区间平均精度 mAP@0.5:0.95。
4.2 单融合方法搜索对比分析
\\qquad
选取近年 12 种 RGB‑T 融合方法作为基线:COMO (Liu 等人,2026)、CMADet (Song 等人,2024)、GMDETR (Xiao 等人,2024)、ICAFusion (Shen 等人,2024)、CDC‑YOLO (Wang 等人,2024b)、DAMSDet (Guo 等人,2024)、DHANet (Wu 等人,2025)、M‑SpecGene (Zhou 等人,2025)、Fusion Mamba (Dong 等人,2025b)、UniRGB‑IR (Yuan 等人,2024)、TFDet (Zhang 等人,2024)、SCFR (Sun 等人,2024)。同时选取 5 个代表性 NAS 方法:DC‑NAS (Liang 等人,2024b)、BM‑NAS (Yin 等人,2022)、EG‑NAS (Cai 等人,2024)、SMoA (Liu 等人,2021)、ParZC (Dong 等人,2025a)。
\\qquad
针对每一种融合方法,在 M3FD 数据集对比 MFH‑NAS 与 4 种 NAS 方法探索融合阶段的效果。实验结果如表 1。可以看到 MFH‑NAS 搜索得到的融合架构绝大多数情况下优于其他 NAS 方法,也优于对应人工设计基线。对比 COMO (mAP50=0.853)、DAMSDet (mAP50=0.802) 等人手设计方法,本文方法平均 mAP50 达到 0.842。当搜索 Fusion Mamba 融合方法时,取得最高 mAP50=0.879,相比原始方法提升 4.5 个百分点。证明门控融合策略 GFS 可以自适应弥合可见光、红外信息语义鸿沟,自动探索更优融合阶段。对比 SMoA (0.841)、EG‑NAS (0.840) 等 NAS 模型,MFH‑NAS 依靠双层协同优化,缓解纯梯度搜索容易陷入局部最优的缺陷,得到更优融合检测架构。
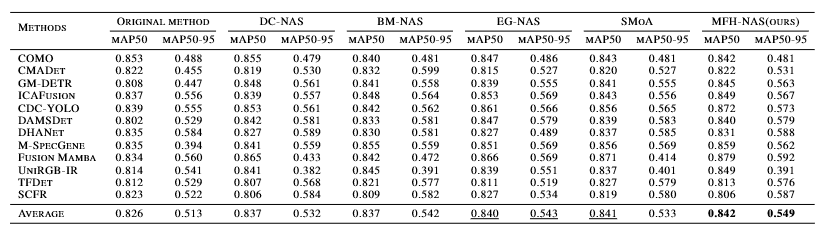
表 1 M3FD 数据集上,MFH‑NAS 与代表性人工设计、NAS 融合模型对比,指标 mAP50、mAP50‑95;最优加粗,次优下划线。
4.3 多融合方法搜索对比分析
\\qquad
表 2 展示不同 NAS 方法搜索得到的分阶段融合配置。In列编码含义:{0:无输入,1:仅可见光输入,2:仅红外输入,3:双模态输入}。Cur.代表作用于当前阶段可见光、红外特征的融合算子;Pre.代表将当前融合特征与上一阶段传播过来的融合特征进一步融合所使用算子。算子索引 1‑12 对应 4.2 节 12 种 RGB‑T 融合方法;13、14 分别代表直接传递红外分支、可见光分支特征。
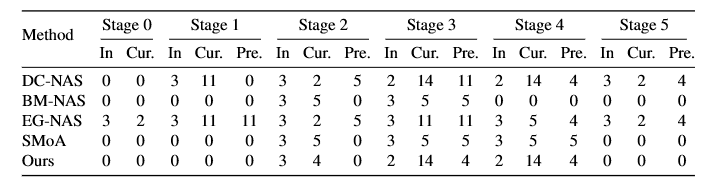
表 2 不同 NAS 方法搜索得到的分阶段融合配置
MFH‑NAS 从第 2 阶段开启融合:双模态特征送入 GFS 模块,使用 ICAFusion 完成融合。第 3、4 阶段选择仅红外输入,和上一阶段传播过来的融合特征做跨阶段融合,依旧使用 ICAFusion。搜索循环中全部 GFS 模块融合算子权重变化见图 5。得到最终离散架构规则:保留
s
i
g
m
o
i
d
(
β
)
>
0.5
sigmoid(\\beta)>0.5
sigmoid(β)>0.5的GFS模块;每个模块选取权重
α
\\alpha
α最大的算子。对比对比 DC‑NAS:阶段 1 使用 SCFR 做本阶段融合,阶段 2 使用 CMADet,再用 CDC‑YOLO 和上阶段融合特征融合;阶段 3、4 仅红外输入,分别用 SCFR、ICAFusion 做跨阶段融合;阶段 5CMADet 做本阶段融合,ICAFusion 和历史特征融合。
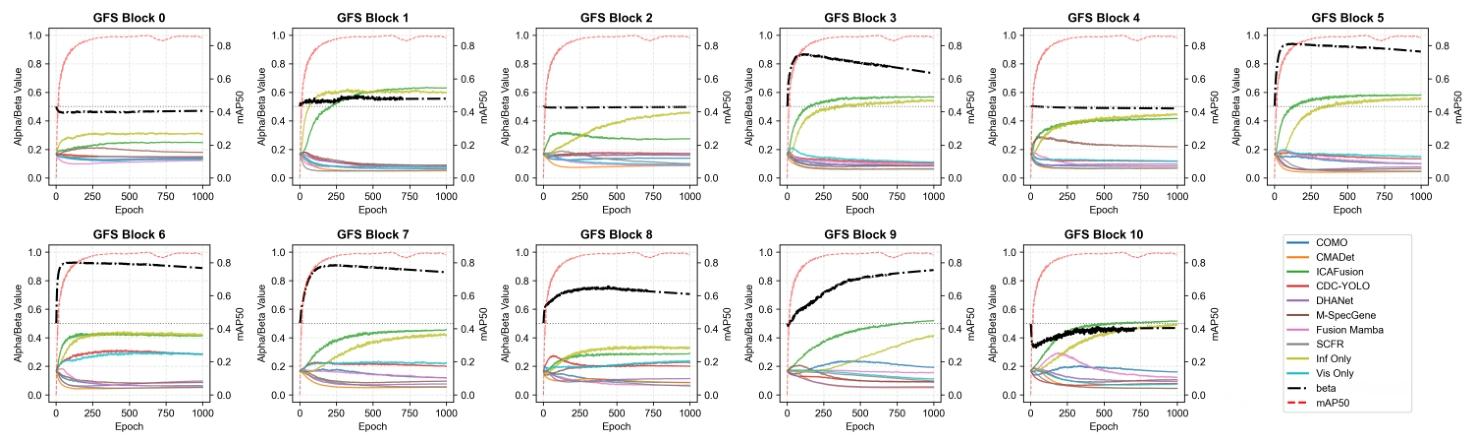
图5 GFS模块中各融合方法的超参数演化及性能分析
进一步在 M3FD、LLVIP、RGBT‑Tiny 做多融合算子搜索实验。在 M3FD 数据集按照 mAP@0.5 对 12 种候选融合方法排序,选取 Top‑8 作为搜索空间算子池:(1) COMO、(2) CDC‑YOLO、(3) ICAFusion、(4) DHANet、(5) M‑SpecGene、(6) Fusion Mamba、(7) SCFR、(8) CMADet。 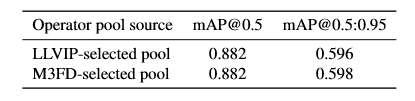
表 4 算子池来源对 M3FD 性能的影响
为验证算子池是否带来数据集偏向,开展算子池迁移实验:不在 M3FD 筛选算子,而是先在 LLVIP 数据集对 12 种方法排序,选出 LLVIP 上 Top‑8 算子构成算子池;相比 M3FD 算子池,移除 SCFR、M‑SpecGene,增加 GM‑DETR、DAMSDet。使用迁移后的算子池在 M3FD 搜索。表 4 结果显示性能几乎不变:mAP@0.5 完全一致,mAP@0.5:0.95 只差 0.002。说明 MFH‑NAS 搜索得到的架构不会过度依赖目标数据集筛选出的算子子集;当然并非完全数据集无关,但对算子预选取来源敏感度很低。 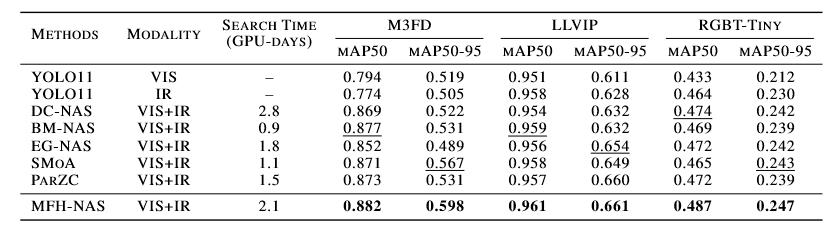
表 3 M3FD、LLVIP、RGBT‑Tiny 数据集性能与搜索开销对比;GPU‑day 为搜索时间;最优加粗,次优下划线
该设置下,同时搜索融合阶段与融合算子,和 4 种 NAS 基线对比,结果见表 3。M3FD 数据集,YOLO11 单可见光 mAP@0.5=0.794,单红外 mAP@0.5=0.774;MFH‑NAS 达到 0.882,相比最优单模态基线提升 8.8 个百分点;同时取得最优 mAP@0.5:0.95=0.598,比第二名 SMoA (0.567) 高出 3.1 个百分点。LLVIP 数据集所有方法整体性能都很高 (mAP@0.5>0.95),MFH‑NAS 取得最高 0.961。RGBT‑Tiny 数据集 MFH‑NAS mAP@0.5=0.487,超过可见光 YOLO11 基线 0.433,在全部 NAS 基线中 mAP@0.5 与 mAP@0.5‑95 均为最优。不同 NAS 搜索架构的检测可视化见图 6。
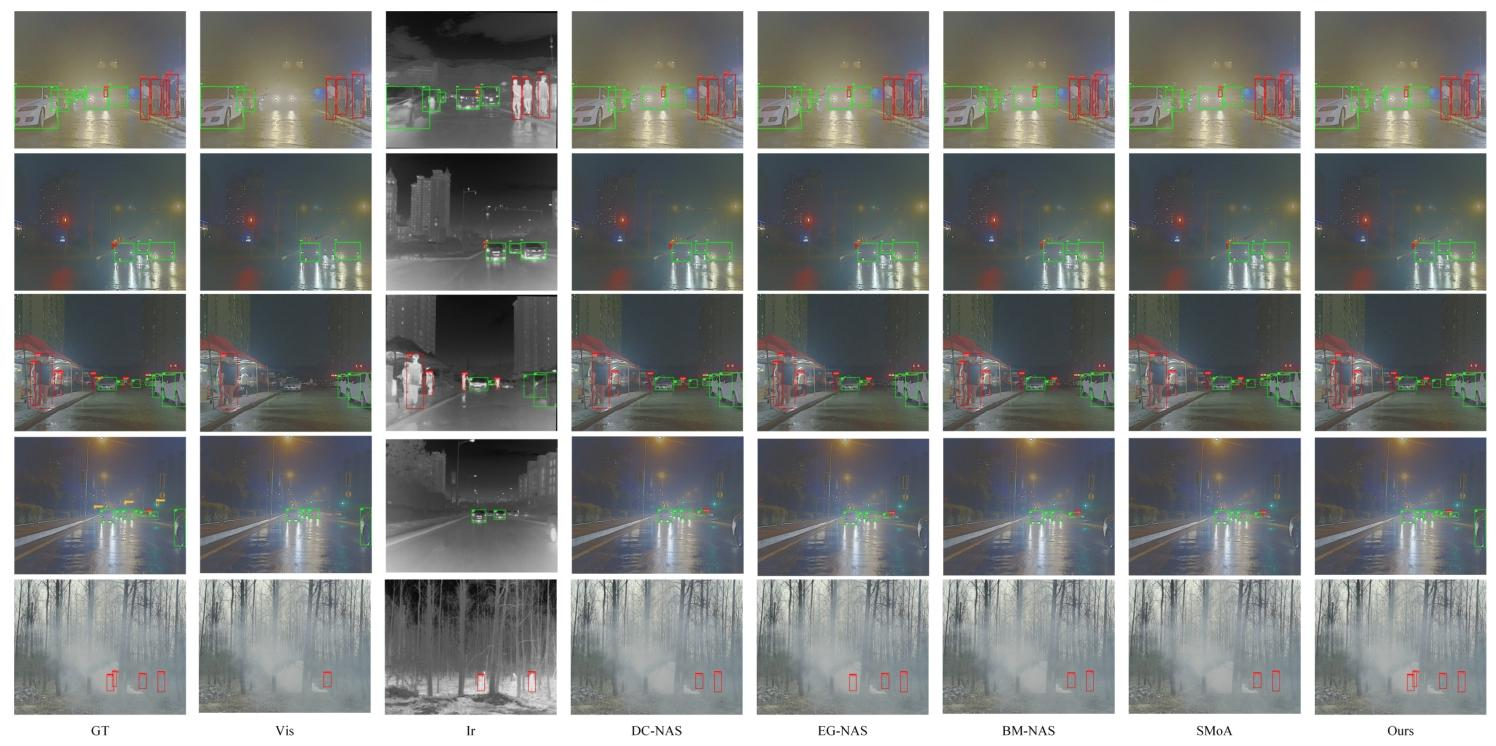
图 6:不同 NAS 方法搜索得到融合架构的目标检测可视化结果。
4.4 消融实验
在 M3FD 数据集开展系统消融实验,验证各个核心组件贡献,结果如表 6。仅使用单模态输入(第 1‑2 行)性能存在明显瓶颈;引入双模态融合 + 进化搜索(第 3 行)mAP50 提升至 0.862;加入可微搜索(第 4 行)mAP50 进一步提升到 0.872,证明搜索算法可以在庞大架构空间中定位更优融合路径;可微搜索 + 进化搜索,使用单一融合方法(第 5 行),mAP50‑95 提升至 0.592;完整策略,启用多融合算子(第 6 行)取得最优性能,mAP50=0.882,mAP50‑95=0.598。相比基线融合方案提升显著,充分验证进化算法、可微搜索、多融合算子三者结合优化融合架构、提升检测精度的有效性。
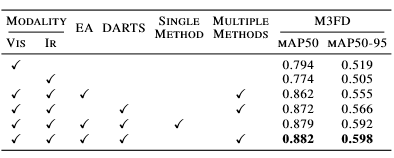
表 6 M3FD 数据集消融实验,验证搜索机制与融合策略有效性


评论前必须登录!
注册