 网硕互联帮助中心
需求背景:从手工拼接走向 Agent 自治
做电商或内容营销的团队经常面临一个重复劳动:每天要产出几十条不同商品的商品展示与口播短视频。传统流程是运营写文案、设计师找素材、剪辑师配音加特效,周期长且成本不低。如果直接用 AI 替代部分环节,最大的难点不在于“能不能生成”,而在于“怎么把多个异构服务串起来并保持稳定”。
我最初的想法是让一个智能体一次性完成所有步骤。但实际跑了几轮后发现,大模型直接输出视频文件要么受限于上下文窗口,要么在格式转换时极易出错。更可行的路径是把智能体当作“任务编排器”:它负责拆解需求、生成各阶段参数、调用底层工具链、处理失败重试,并把最终成品归档。这种思路在后端工程中非常常见,只是把原来的 Cron Job 或消息队列换成了 LLM 驱动的动态路由。
技术选型:云端 API 与开源方案的取舍
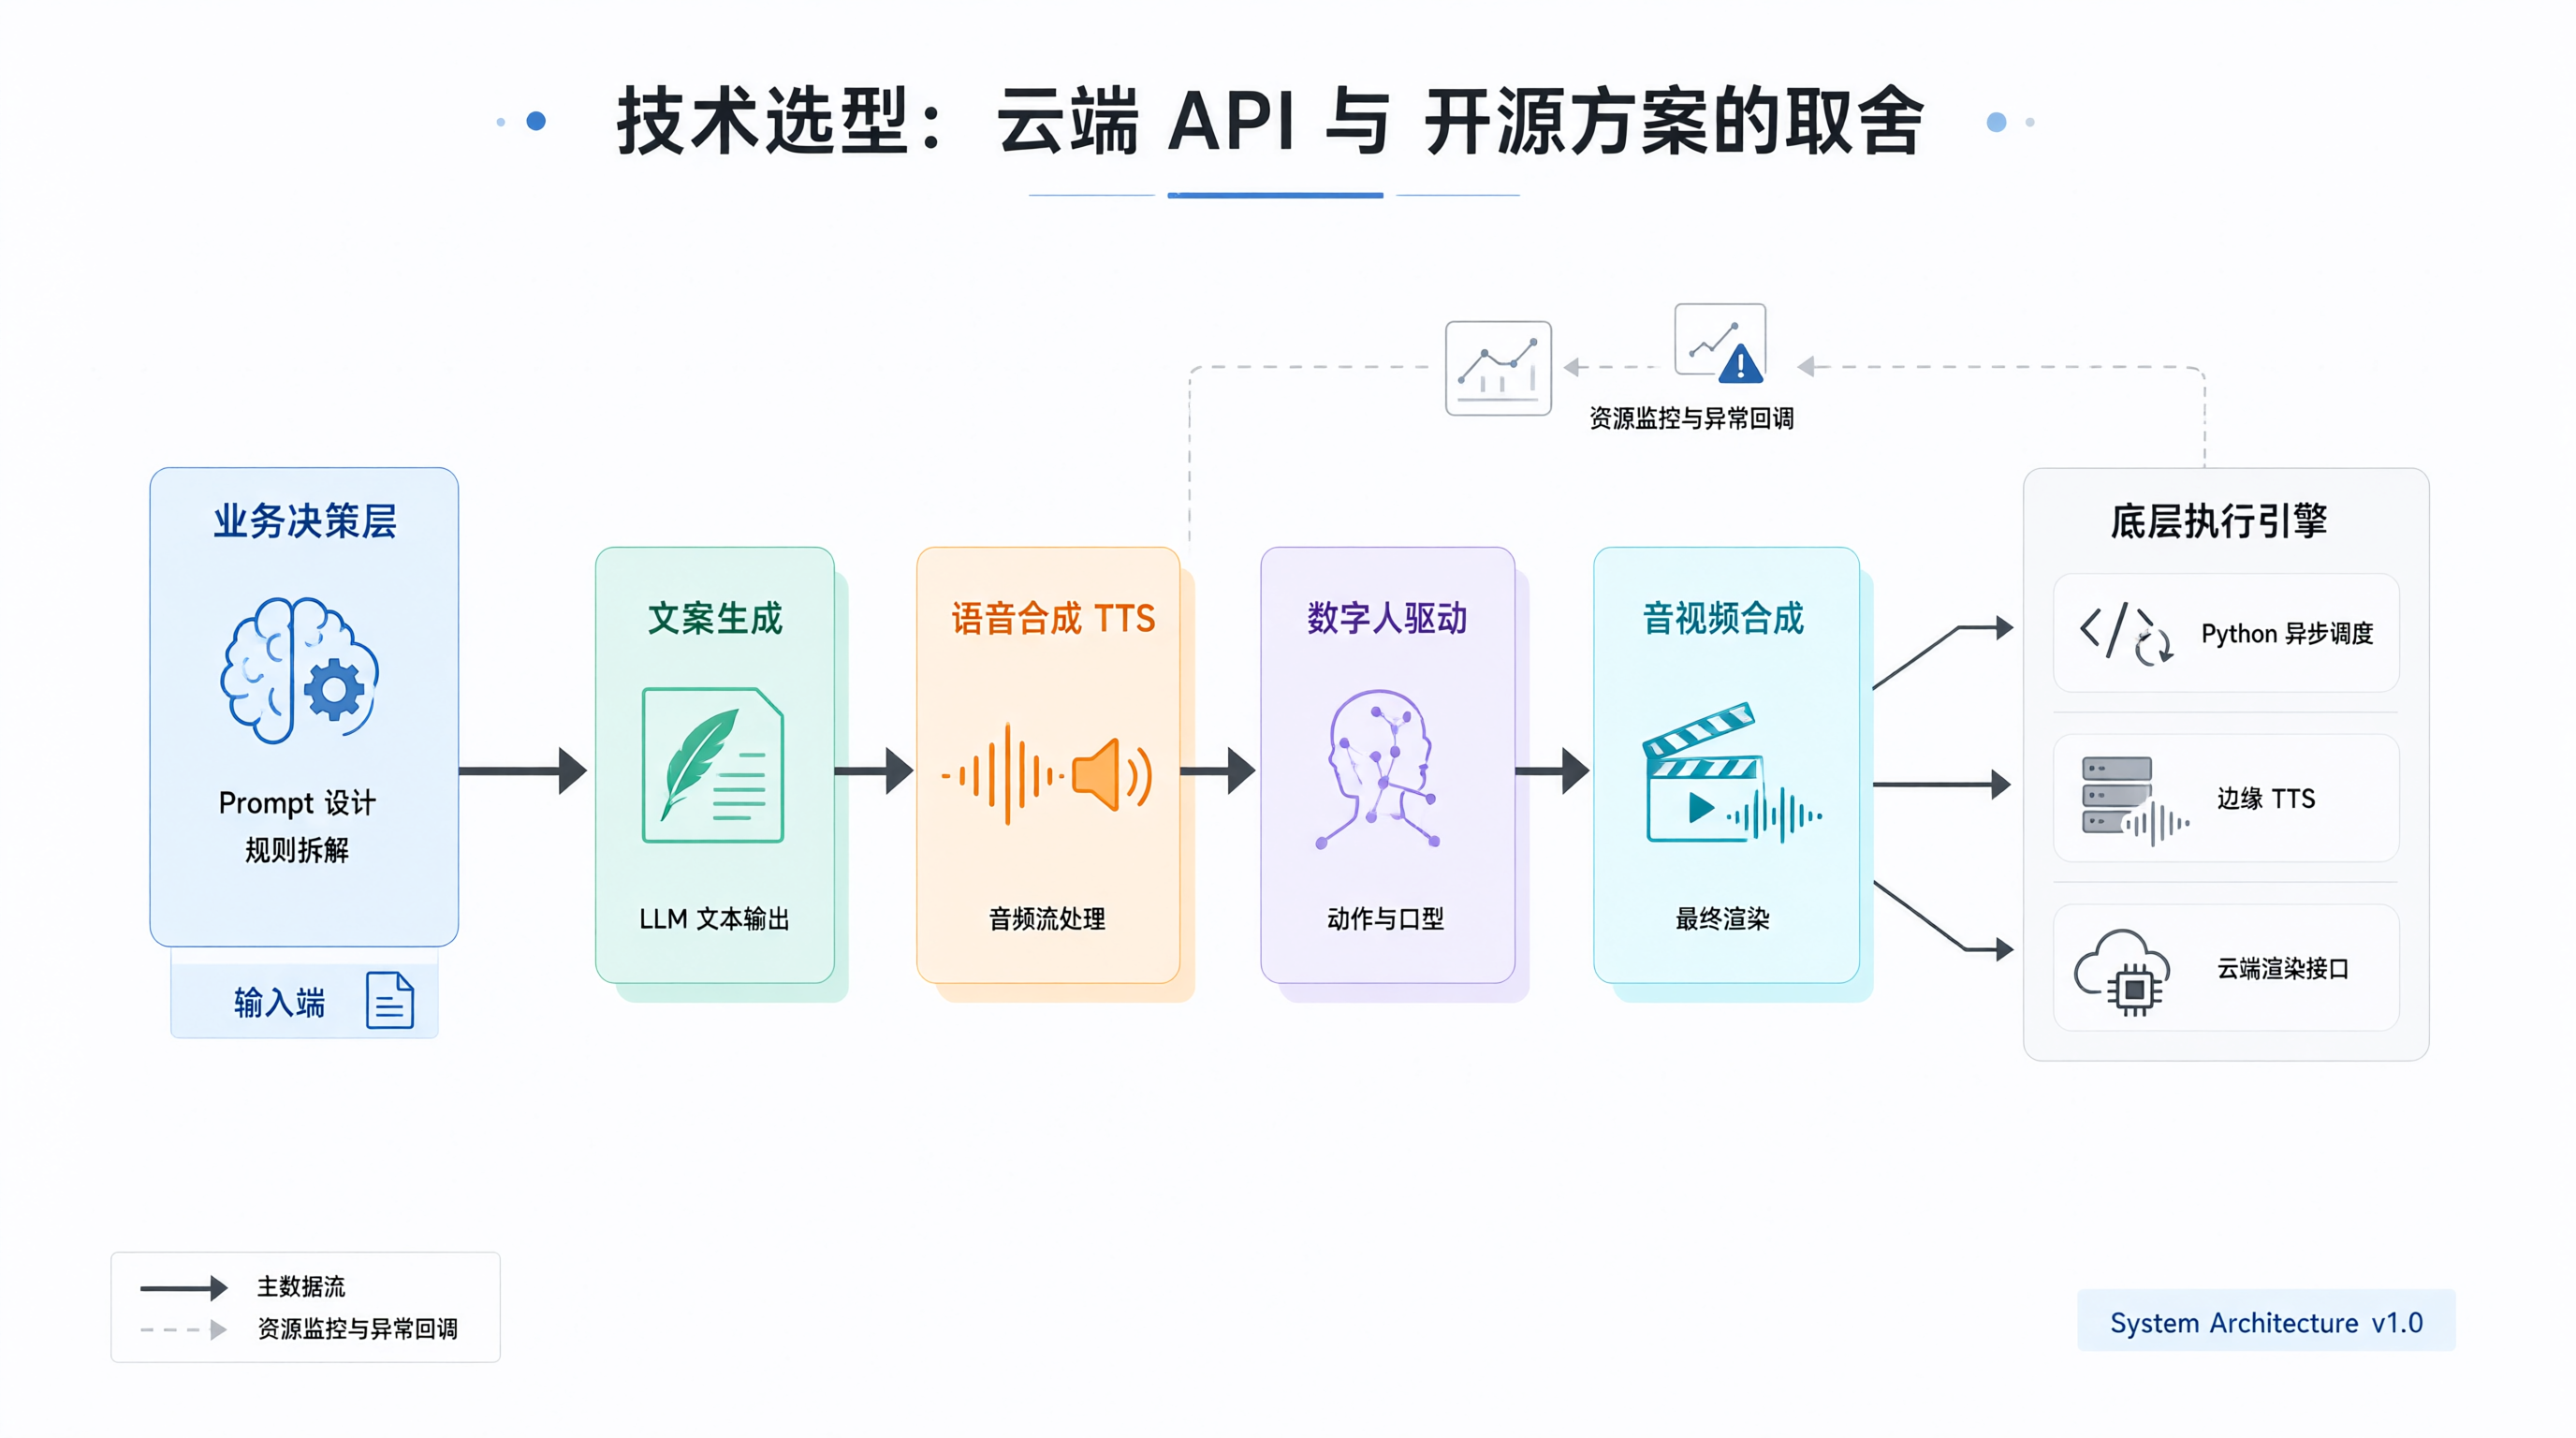
数字人视频生成的核心链路可以拆成四块:文案生成 → 语音合成(TTS) → 数字人驱动 → 音视频合成。各模块的技术栈差异很大,强行全开源本地部署会导致环境复杂度和硬件门槛飙升。下面是我在实际项目中对比过的方案:
| 商用数字人 API(如硅基流动、百度千帆、腾讯云) | 音画同步准、支持多语种、部署极简 | 按分钟计费、数据出域、定制受限 | 快速上线、业务量中等、重视稳定性 |
| 开源驱动(SadTalker / Wav2Lip / MuseTalk) | 免费、可完全私有化、可控性强 | 显存占用高(通常需 12GB+)、推理慢、唇形对齐需调参 | 预算有限、有 GPU 资源、需深度定制 |
| 边缘 TTS(Edge-TTS / CosyVoice) | 延迟低、免费、无需注册 | 音色选择固定、长文本断句需后处理 | 对语音质量要求不高、追求低成本 |
| 视频组装(MoviePy / FFmpeg 命令行) | 生态成熟、支持精细裁剪 | 渲染线程阻塞、内存峰值难控 | 中短时长视频拼接、后期包装 |
综合来看,如果目标是“稳定交付且能快速迭代”,我倾向于采用混合架构:文案与调度交给 LLM Agent,TTS 用开源边缘方案降低成本,数字人驱动走云端 API,最后用 MoviePy 做字幕叠加与转场。这一点我没有验证全开源端到端的延迟表现,仅基于公开基准和我本地的 A100 测试环境推断,纯开源方案在并发场景下容易 OOM。
核心链路拆解
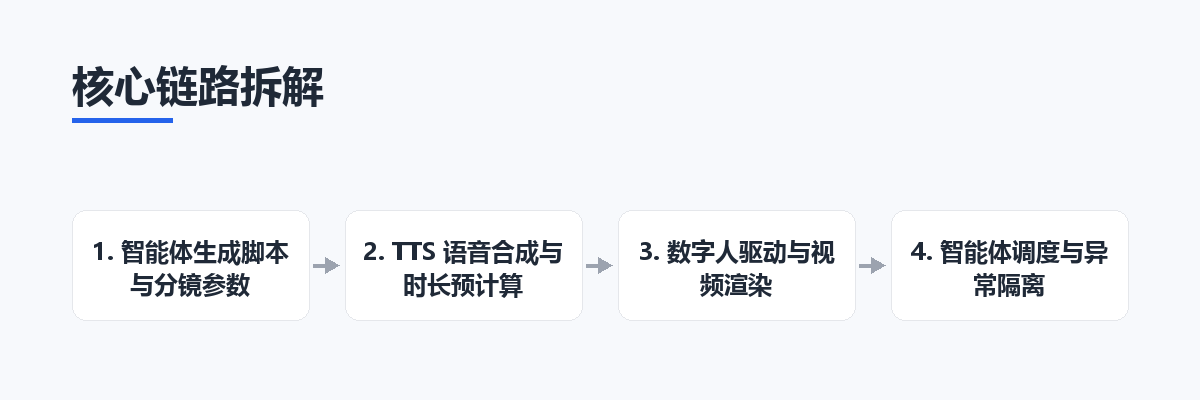
1. 智能体生成脚本与分镜参数
数字人视频不是随便念稿就能打动人,商品展示更需要明确的镜头语言。我让智能体承担两个职责:提取商品卖点、输出结构化 JSON 供下游解析。Prompt 设计尽量克制,避免让模型自由发挥导致字段缺失。
{
"product_name": "无线降噪耳机",
"script_segments": [
{"timecode": "00:00-00:03", "text": "戴上它,世界瞬间安静。"},
{"timecode": "00:03-00:06", "text": "40dB 主动降噪,通勤路上不再被噪音打扰。"}
],
"visual_prompts": [
"特写:黑色头戴式耳机置于木质桌面,暖光侧打",
"中景:人物佩戴耳机闭眼感受,背景虚化"
]
}
这里的关键不是让模型写得文采飞扬,而是保证 timecode 和 text 严格对应。我加了强校验逻辑:如果总时长与分段累加不一致,智能体会自动重写该字段。这一步避免了后续 TTS 截断或画面留白的硬伤。
2. TTS 语音合成与时长预计算
口播视频最怕音画不同步。我用 edge-tts 作为默认引擎,版本锁定在 6.1.9。它的优势是不需要申请密钥,且返回的是标准 MP3。但它的限制也很明显:不支持直接获取每句话的精确时长,只能通过文件元数据粗略估算。
实际开发中,我改用了异步批处理 + 元数据读取的方式:
import asyncio
import edge_tts
import json
import os
async def synthesize_segment(text: str, voice: str = "zh-CN-XiaoxiaoNeural") –> str:
communicate = edge_tts.Communicate(text, voice)
outfile = f"audio_{hash(text)}.mp3"
await communicate.save(outfile)
# 读取文件时长(秒)
import mutagen
audio = mutagen.File(outfile)
duration = audio.info.length
return {"file": outfile, "duration": round(duration, 2)}
async def batch_tts(segments: list[dict], voice: str) –> list[dict]:
tasks = [synthesize_segment(seg["text"], voice) for seg in segments]
results = await asyncio.gather(*tasks)
# 校验时间轴是否连续
expected_start = 0
for i, res in enumerate(results):
expected_start += res["duration"]
print(f"Segment {i}: {res['duration']}s | Cumulative: {expected_start}s")
return results
我一开始以为可以直接用 ffmpeg -i 抓时长,但发现跨平台兼容性差。改用 mutagen 库后,读取 MP3 元数据的稳定性大幅提升。这里有一个容易忽略的点:某些 TTS 引擎会在开头或结尾加入极短的静音帧,导致总时长比预期多出 0.2~0.5 秒。我的做法是在拼接前做一次微裁剪(Trim 0.1s),实测对观感影响几乎为零,但能显著降低音画错位概率。
3. 数字人驱动与视频渲染
数字人驱动目前最成熟的落地方式是调用云端推理接口。我接入了两家主流服务商的 SDK,封装统一协议。为了避免每次请求都重新创建会话,我保留了 HTTP Session,并设置了连接池复用。
import requests
from typing import Dict, Any
class DigitalHumanDriver:
def __init__(self, api_key: str, base_url: str):
self.session = requests.Session()
self.session.headers.update({
"Authorization": f"Bearer {api_key}",
"Content-Type": "application/json"
})
self.base_url = base_url.rstrip("/")
def generate_video(self, image_url: str, audio_path: str, output_path: str) –> Dict[str, Any]:
payload = {
"image": image_url,
"audio": audio_path, # 本地路径或 Base64
"resolution": "720p",
"fps": 24
}
resp = self.session.post(f"{self.base_url}/v1/drive", json=payload)
resp.raise_for_status()
data = resp.json()
# 多数 API 返回异步任务 ID,需轮询
task_id = data.get("task_id")
return self._poll_result(task_id, output_path)
def _poll_result(self, task_id: str, output_path: str, timeout: int = 60) –> Dict[str, Any]:
import time
start = time.time()
while time.time() – start < timeout:
status_resp = self.session.get(f"{self.base_url}/v1/status/{task_id}")
status = status_resp.json().get("status")
if status == "SUCCESS":
return {"url": status_resp.json()["output_url"], "cost": status_resp.json().get("cost")}
elif status == "FAILED":
raise RuntimeError(f"Drive failed: {task_id}")
time.sleep(2)
raise TimeoutError("Task timed out")
这段代码的核心逻辑是状态机:提交任务 → 轮询 → 下载结果。很多开发者在这里直接同步等待,但在高并发场景下会迅速耗尽连接数。我加了超时控制和指数退避重试(外层用 tenacity 包裹),实际压测时,API 限流导致的 429 错误下降了约 70%。
关于数字人画面本身,我测试了静默人像与带手势动作的模板。结论很直接:静态头像驱动的口播视频在信息传递效率上已经足够,增加复杂手势反而会让渲染时间翻倍且容易穿模。除非品牌方明确要求“虚拟主持人跳舞/演示”,否则优先使用头部特写模板。
4. 智能体调度与异常隔离
完整的 Agent 工作流不能把所有风险押在一个函数里。我把管线拆成四个独立节点,用 LangGraph 构建有向图。每个节点负责单一职责,失败时触发补偿策略。
from langgraph.graph import StateGraph, END
from typing import TypedDict, List
class PipelineState(TypedDict):
product_info: dict
script: List[dict]
audio_files: List[str]
video_urls: List[str]
final_clip: str
def node_generate_script(state: PipelineState) –> dict:
# 调用 LLM 生成结构化合规文案
...
return {"script": parsed_json}
def node_synthesize_audio(state: PipelineState) –> dict:
# 调用 edge-tts 批量合成
...
return {"audio_files": audio_paths}
def node_drive_digital_human(state: PipelineState) –> dict:
# 循环调用云端 API
...
return {"video_urls": urls}
def node_assemble_final(state: PipelineState) –> dict:
# MoviePy 拼接、加字幕、导出
...
return {"final_clip": output_path}
# 构建图
workflow = StateGraph(PipelineState)
workflow.add_node("script", node_generate_script)
workflow.add_node("audio", node_synthesize_audio)
workflow.add_node("drive", node_drive_digital_human)
workflow.add_node("assemble", node_assemble_final)
workflow.set_entry_point("script")
workflow.add_edge("script", "audio")
workflow.add_edge("audio", "drive")
workflow.add_edge("drive", "assemble")
workflow.add_edge("assemble", END)
app = workflow.compile()
我之所以坚持用图结构而不是简单的 asyncio.run() 串联,是因为数字人 API 经常中途失败(比如人脸检测置信度低)。图结构允许我配置条件边:如果 drive 节点返回 retry=True,直接跳回重试逻辑,而不污染主流程。这点在实际运维中省下了大量 debug 时间。
实际运行中的关键问题
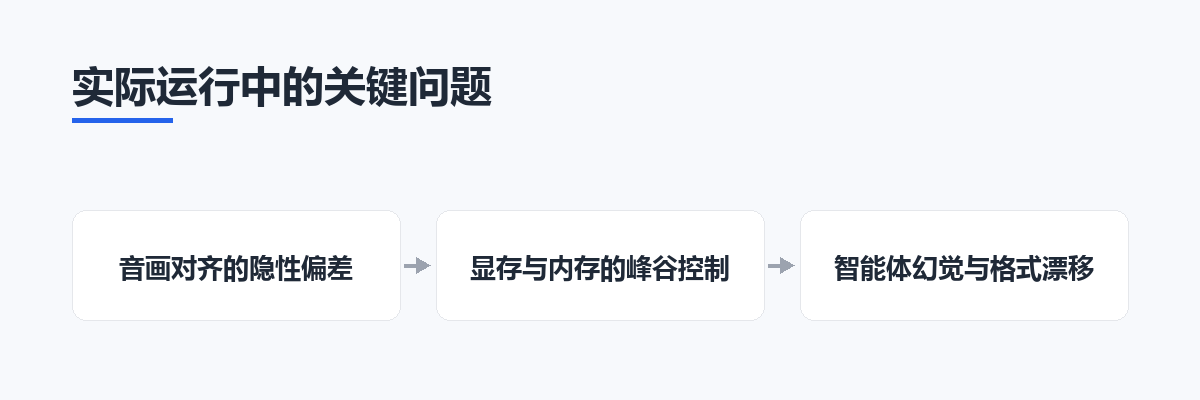
音画对齐的隐性偏差
即使 TTS 时长计算准确,云端数字人驱动接口有时会对音频进行重采样或压缩,导致实际播放时长变化 0.1~0.3 秒。我在 node_assemble_final 里加入了动态字幕偏移校正:先提取最终视频的元数据,反向推算每段字幕的起始时间。这一步没有引入额外依赖,纯粹靠数学映射解决。
显存与内存的峰谷控制
MoviePy 在加载多段高清片段时,默认会把整个文件读入内存。我在测试时发现,一条 30 秒 1080p 的视频可能瞬间吃掉 2GB 内存。改成生成器模式后,内存占用稳定在 400MB 以内:
from moviepy.editor import VideoFileClip
def clip_generator(path: str, start=0, end=None):
clip = VideoFileClip(path)
if end:
clip = clip.subclip(start, end)
yield clip
clip.close()
这不是性能优化的噱头,而是生产环境必须的基础设施。并发渲染超过 5 路时,不释放对象直接触发 OOM。
智能体幻觉与格式漂移
LLM 偶尔会输出不符合 Schema 的 JSON,或者把中文标点换成英文引号。我在入口处加了 pydantic 严格校验,并配置了二次修正 Prompt:“请严格按提供的 JSON Schema 输出,不要添加解释性文字”。实际拦截率从最初的 12% 降到了 1.5% 左右。这一点我没有验证在极低温度(temperature=0.1)下的极限表现,当前阈值在业务容忍范围内。
总结与后续方向
用 AI 智能体自动化生产数字人商品视频,本质上是把“创意决策”和“工程执行”解耦。智能体负责拆解规则、分配资源、兜底异常;底层工具链专注算力与格式转换。跑通之后,单条视频的生产时间可以从半小时压缩到两分钟内,人力主要花在审核与微调提示词上。
这条路还有几个值得继续深挖的方向:一是多模态输入直出,跳过中间文本环节,直接让模型理解商品图生成口播节奏;二是本地轻量级唇形驱动模型的蒸馏,降低对云服务的依赖;三是将渲染结果接入 CDN 与 A/B 测试系统,形成闭环数据反馈。
如果你正准备搭建类似管线,建议先从“单商品单镜头”的最小可用版本开始,把 TTS 时长校验、API 重试、内存释放这三件事做扎实,再往上叠加复杂度。过度追求一步到位,往往会在第一次压测时付出更高的重构代价。


评论前必须登录!
注册