 网硕互联帮助中心
“把衣服拿到洗衣机旁”,听起来是一句指令,落到代码里却是一串条件:先找到人,等衣物交接,再找到洗衣机,最后才是移动和放下。
我翻了启元开源组织里的 carry-clothes 项目。任务流程已经写好,视觉接口也留好了,但默认的 HeuristicDetector 返回空列表;–sim 使用的 SimDetector 则从模拟世界读取目标信息,并没有真的看图。
这次就补其中一块:让真实模型看照片,把结果送进原项目的“寻找洗衣机”分支。 推理跑在一台 RTX 5070 Ti 上,动作端沿用 Mock,不连接真机。这样可以把“模型有没有看见”和“技能有没有接受”放在同一条日志里检查。
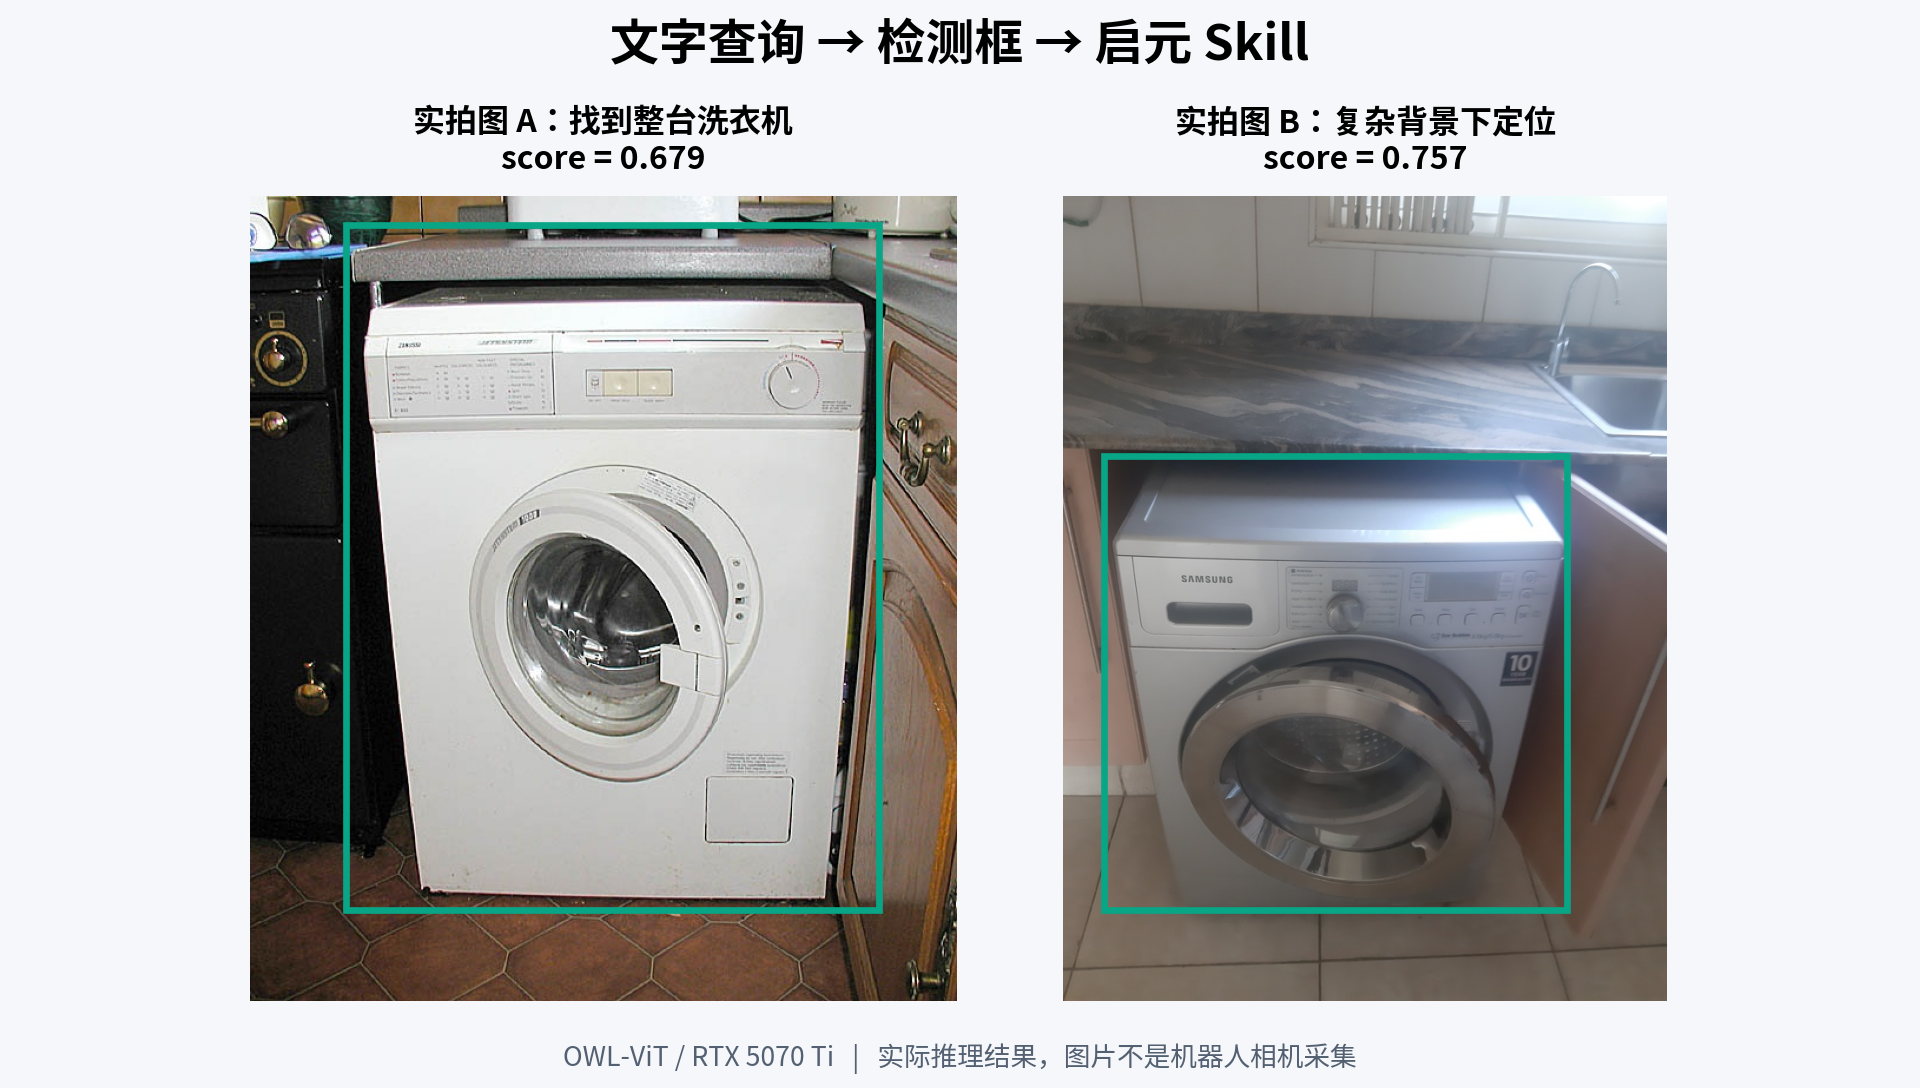
两张公开实拍照片上的实际预测框。左图:Adrian Pingstone,公有领域;右图:Fanti Salms,CC BY-SA 3.0。本图做了缩放、方向校正和检测框标注,衍生图按 CC BY-SA 3.0 提供。
1. 从一个能替换的接口开始
启元的示例面向 T1,视觉入口在 src/vision.py:输入 JPEG 字节,输出 Detection 列表。_s7_find_washer() 负责寻找洗衣机:取图、调用检测器、检查类别和分数,找到就返回,找不到继续搜索,超时则抛出 TaskAborted。
因此不用重写整套任务。本次只实现检测器、接入这一个阶段,并给它加连续确认。接人、抱衣物和实际导航不在这次实验里。
模型选用 OWL-ViT base-patch32。它可以根据文字查询返回目标框,本文固定查询:
prompt = "a photo of a washing machine"
这里用的是目标检测模型,不需要让聊天模型先写一段解释,再从回答里猜坐标。识别类别也明确限定为洗衣机,避免把别的高分目标交给后面的伺服器。
完整代码放在实验仓库的 vision-skill 目录。复现命令:
git clone https://atomgit.com/gcw_JBmPZT05/primebot-mujoco-lab.git
cd primebot-mujoco-lab/vision-skill
bash code/setup.sh
# 单张图片:保存检测框,并在终端打印分数、坐标和耗时
.venv/bin/python code/infer.py assets/washer_normal.jpg
# 图片对照、技能分支、异步指令循环
.venv/bin/python code/probe.py
.venv/bin/python code/skill_demo.py
.venv/bin/python code/loop_demo.py
环境是 Ubuntu 22.04、Python 3.11.16、PyTorch 2.7.1+cu128、Transformers 4.51.3。脚本固定了启元源码和模型的提交版本;模型下载后从本地加载。没有 ROS2,也不用云端推理 API。创建虚拟环境需要 uv 或可用的 Python venv。
2. 框找到了,坐标单位别接错
模型输出的是像素坐标 [x1, y1, x2, y2]。接入时要转成示例所需的字段:
Detection(
label="washing_machine",
confidence=score, # 保留模型原始分数
cx=(x1 + x2) / width – 1,
cy=1 – (y1 + y2) / height,
height=y2 – y1, # 这里传像素高度
)
cx 以画面中心为零,右侧为正;cy 向上为正。模型输出的越界框先裁剪到图像范围,再做转换。
height 是这次遇到的第一个坑。 Detection 的字段注释写着“归一化框高度”,但 VisualServo.estimate() 实际使用的是:
distance = focal_px_per_m * target_height_m / detection.height
SimDetector 自己也传像素高度。接入时应以实际计算为准,不能只照字段注释写。
以图 A 为例,模型框高约 581.7 像素。沿用示例中的焦距数值 900 和目标高度 0.85,公式结果约为 1.32 米;如果误传 581.7 / 684,计算结果会先膨胀到约 900 米,再被代码限幅到 12 米。
这只是接口算例,并非照片的真实距离:照片的相机没有按上述参数标定。本文因此只验证搜索和转向指令,不用这个距离驱动前进。
3. 遮挡以后,调低门槛真的有用吗?
我给两张照片分别做了亮度降低和灰条遮挡,再加一张没有洗衣机的 Q1 渲染图与纯灰图。共八种输入,用来检查接口行为,不把它们当成八个独立场景统计识别率。
| 图 A 原图 | 0.679 | 通过 |
| 图 B 原图 | 0.757 | 通过 |
| 图 A / B 亮度降至 25% | 0.720 / 0.697 | 通过 |
| 图 A / B 加灰条遮挡 | 0.240 / 0.167 | 拒绝 |
| 无洗衣机的机器人画面 | 0.015 | 拒绝 |
| 纯灰画面 | 0.001 | 拒绝 |
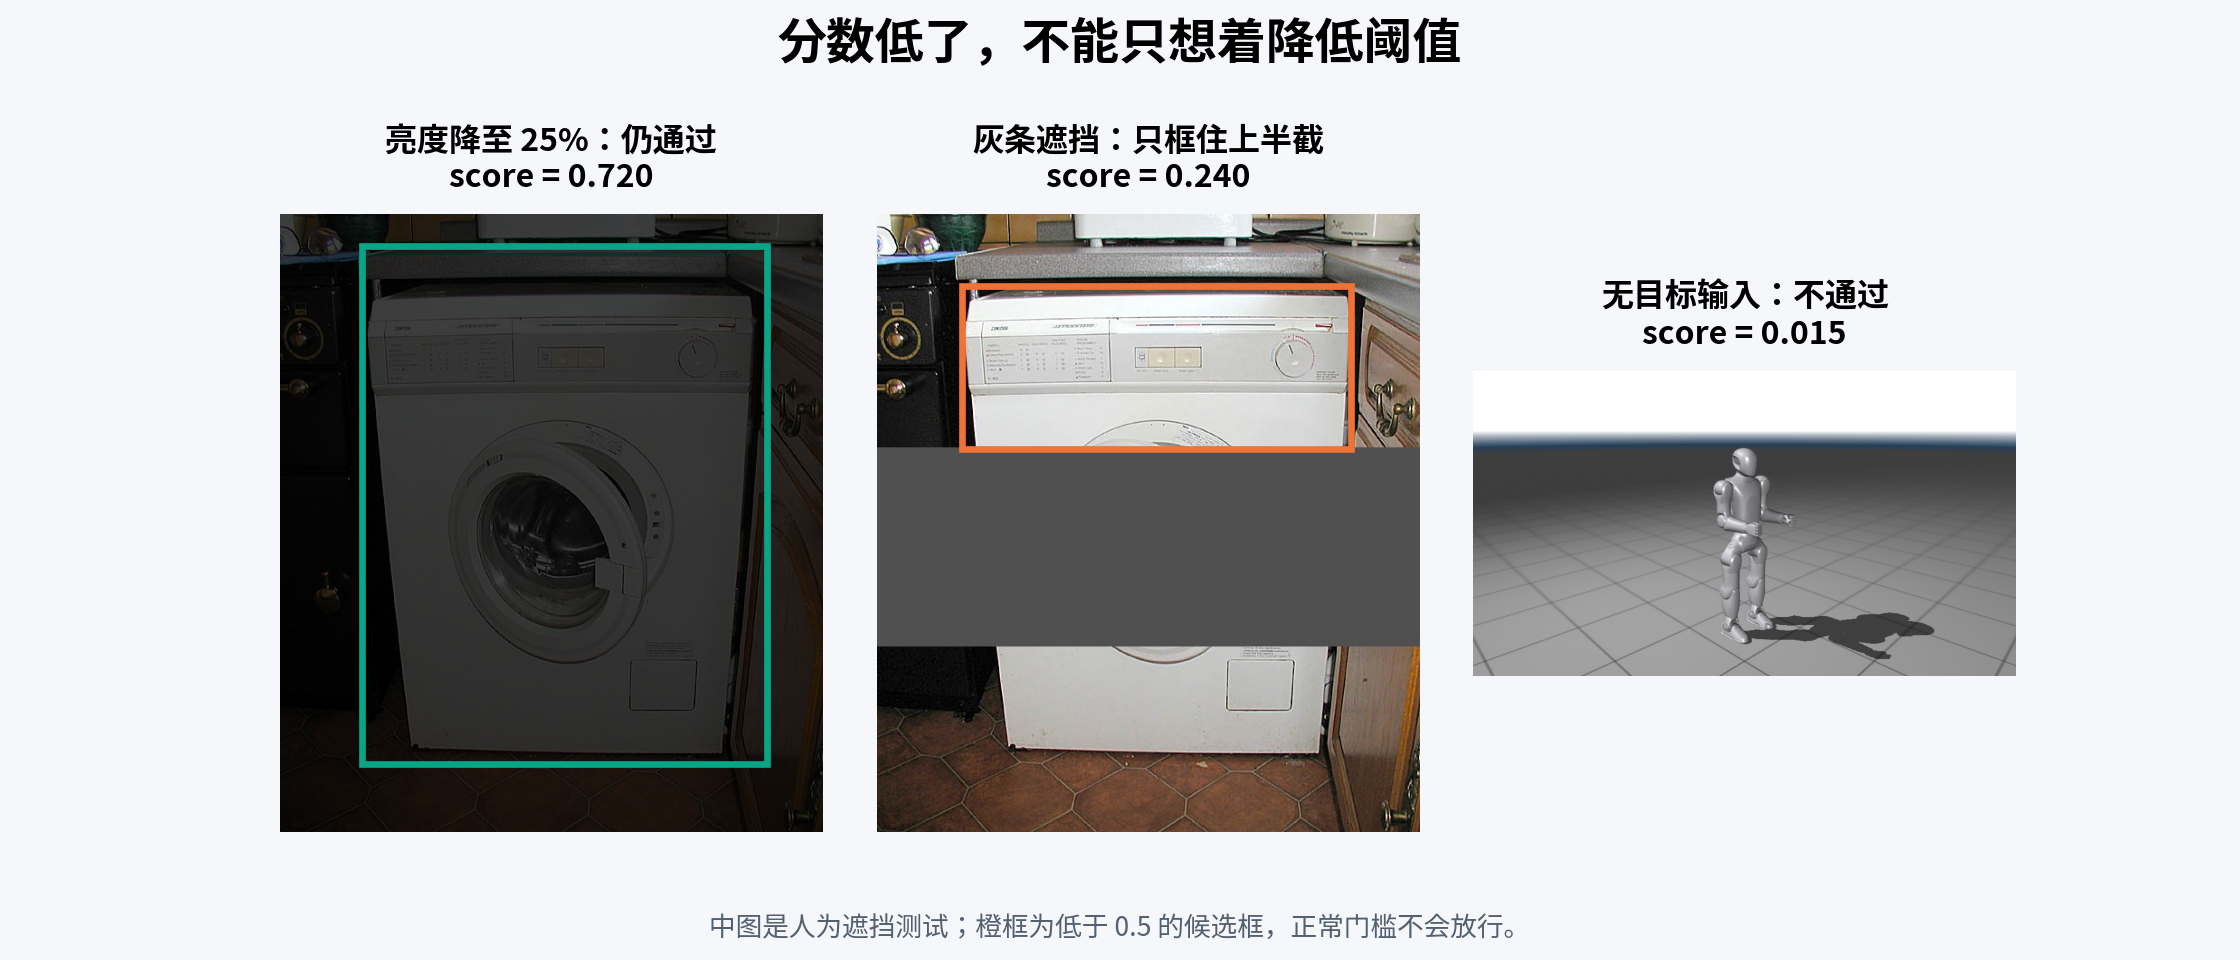
调暗后分数没有下降,不能据此说暗光一定更好识别;它只说明这两张变换后的图片仍能通过。真正要盯住的是中间的遮挡图:模型把洗衣机上半截当成了目标框。
把门槛从 0.5 降到 0.12,它确实能“检测成功”。但框高已经缩短到约 179.4 像素。同一套公式得到的距离,从 1.32 米变成约 4.26 米。物体并没有变远,只是框变短了。
分数够不够,与框能不能用于测距,是两件事。 0.5 也不是通用正确值,这里保留示例门槛做对照;0.12 专门用于暴露错误放行,不能当成推荐参数。模型分数更不能直接解释为现实世界中的正确概率。
4. 让技能亲自跑一次判断
检测器外面加一个小门控:连续三次通过分数门槛,并且相邻框的 IoU 不低于 0.5,才把结果交给技能。没有目标就清零计数,且始终保留原始分数,不把低分改写成高分。
接着用 PhotoBot 继承原项目的 MockPrimeBot,只替换取图方法,按指定顺序返回照片。实际调用的仍是原来的 _s7_find_washer();唯一的任务源码调整,是把写死的 0.5 提取成配置项,补丁保存在 results/upstream.patch。
搜索超时设为 1.2 秒;Mock 的模式切换等待设为零,缩短回归测试。结果如下:
| 占位检测器 + 正常照片 | 超时,抛出搜索失败异常 |
| 真实模型:无目标 → 正常照片连续三次 | 第 4 次取图后,搜索正常返回 |
| 始终没有目标 | 超时退出 |
| 正常照片、无目标画面交替 | 确认计数反复清零,超时退出 |
| 遮挡照片,门槛 0.5 | 超时退出 |
| 同一遮挡照片,门槛 0.12 | 第 3 次取图后放行,但框不完整 |
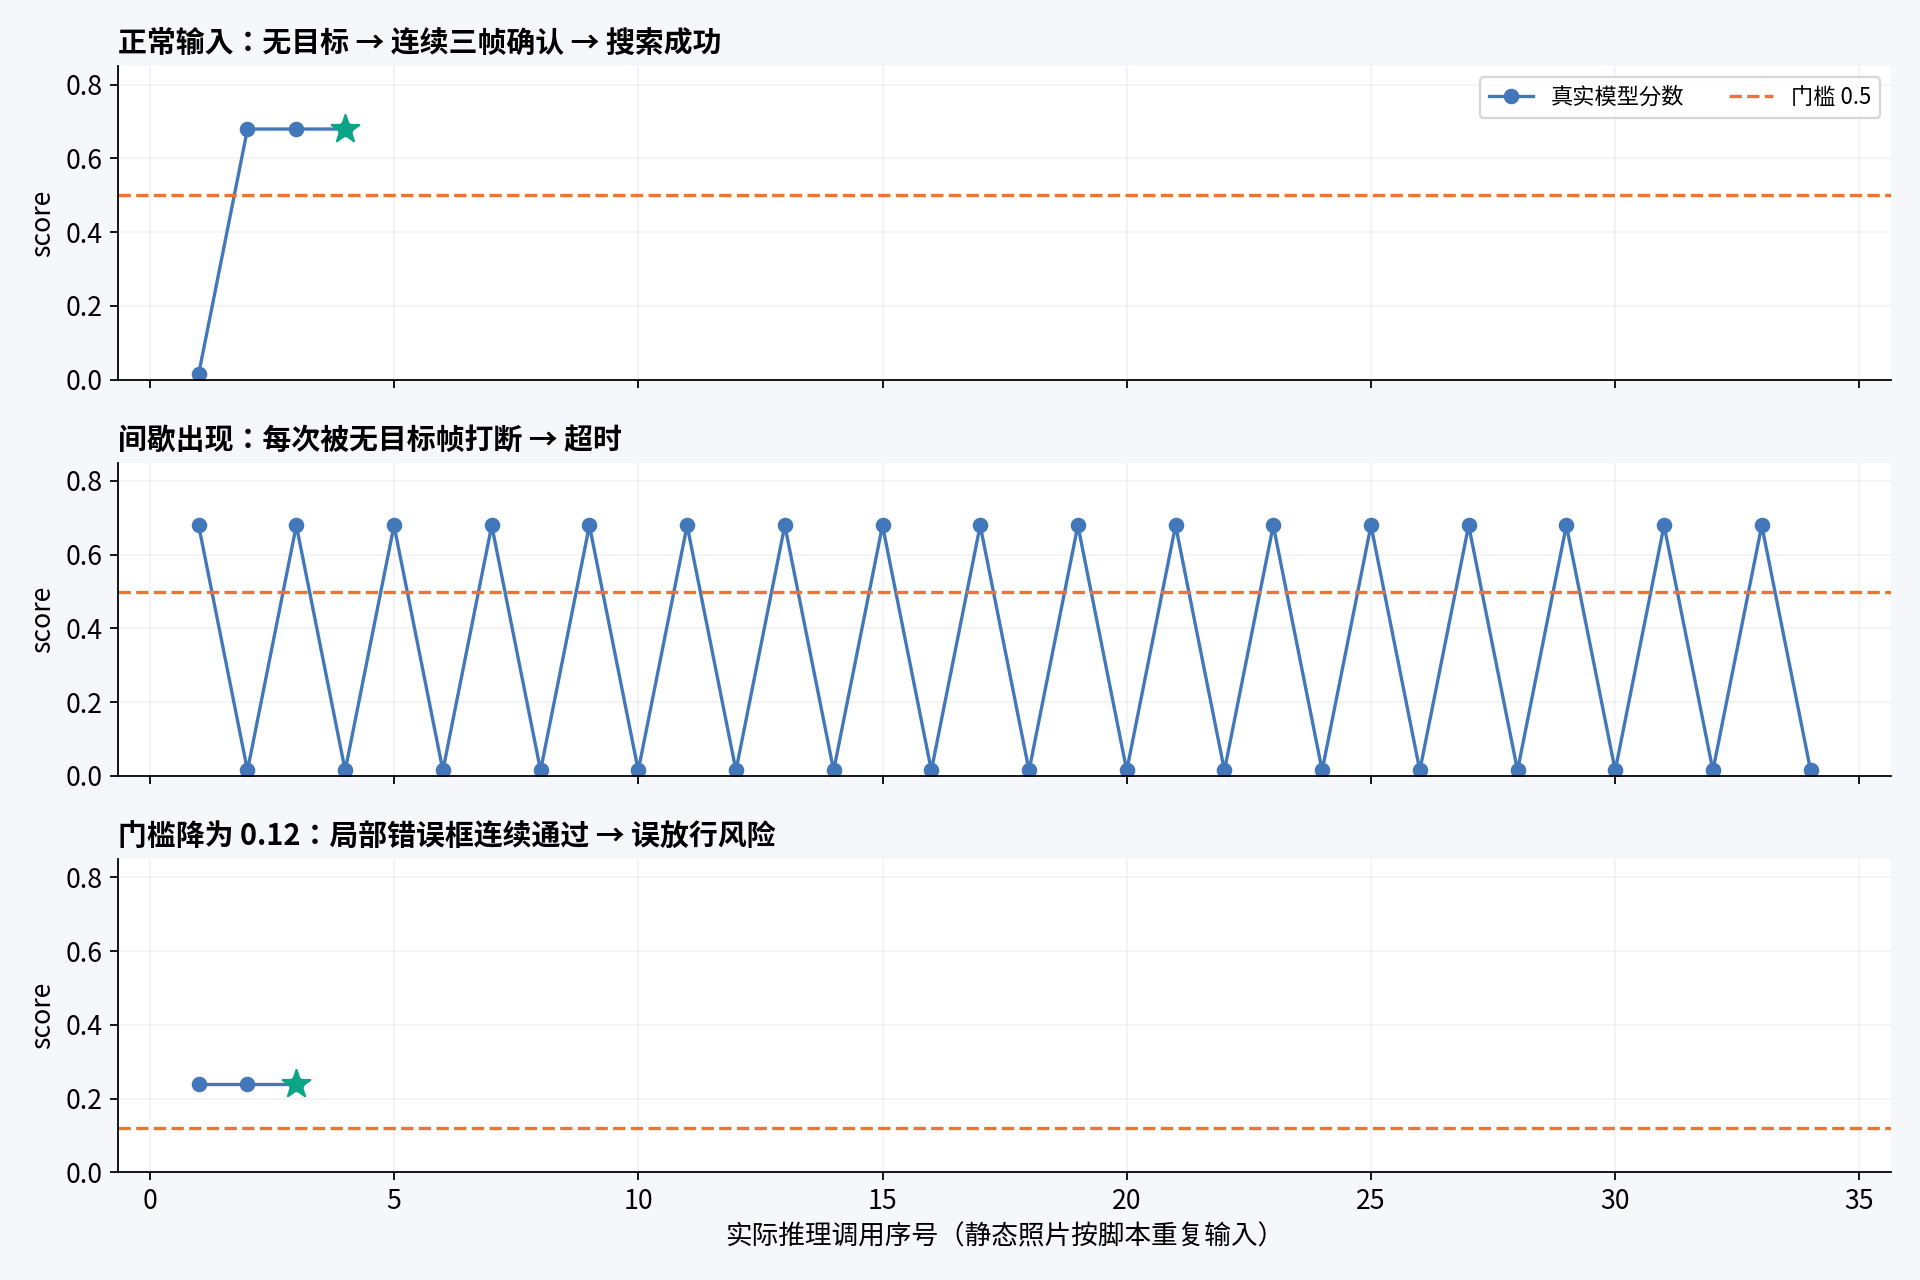
这里“搜索正常返回”表示找到目标条件成立,后续才会进入前往洗衣机的阶段,不代表搬运任务已经完成。测试还检查了每种分支最后都调用停止、搜索过程中前进速度始终为零。
最后一行尤其有意思:连续三帧只能过滤闪烁,挡不住连续三次都相同的错误框。 重复输入静态照片,就是为了把这个问题单独暴露出来。
5. 模型跑得挺快,为什么循环还是慢了?
在 5070 Ti 上,以 FP32、batch size 1 运行,预热 5 次,再对图 A 重复推理 40 次:完整 detect() 的中位耗时为 34.71 ms,P95 为 35.27 ms。计时包含图片解码、预处理、GPU 推理和框后处理,并在两端同步 CUDA;不含模型加载和文件读取。单张图片 CLI 的首次推理为 391.55 ms,启动阶段仍要单独预热。
PyTorch 记录的峰值已分配显存约 644 MiB,这不等于 nvidia-smi 显示的整进程占用。这个小模型用不上 16 GB 显存的大部分空间。
但示例搜索循环希望每 20 ms 下发一次指令。把 35 ms 的推理同步塞进去,哪怕不再 sleep,也赶不上原定频率。目标缺失的那组实测中,相邻搜索指令的中位间隔是 36.21 ms。
我另写了一个独立的 Mock 循环:推理线程只发布最新观测,指令线程按 50 Hz 读取;画面超过 300 ms 没更新,指令归零。
# captured_at 在获取图像时记录,不能在推理完成后才开始计时。
age = time.monotonic() – captured_at
if age > 0.30 or not confirmed_detections:
yaw = 0.0
else:
yaw = max(–0.25, min(0.25, confirmed_detections[0].cx * 0.4))
bot.drive(0.0, 0.0, yaw)
完整脚本有锁保护、异常退出和 finally: bot.stop()。这段只演示水平对准,前进速度一直为零;它是独立验证的改造方式,没有声称整个上游任务已完成异步改造。
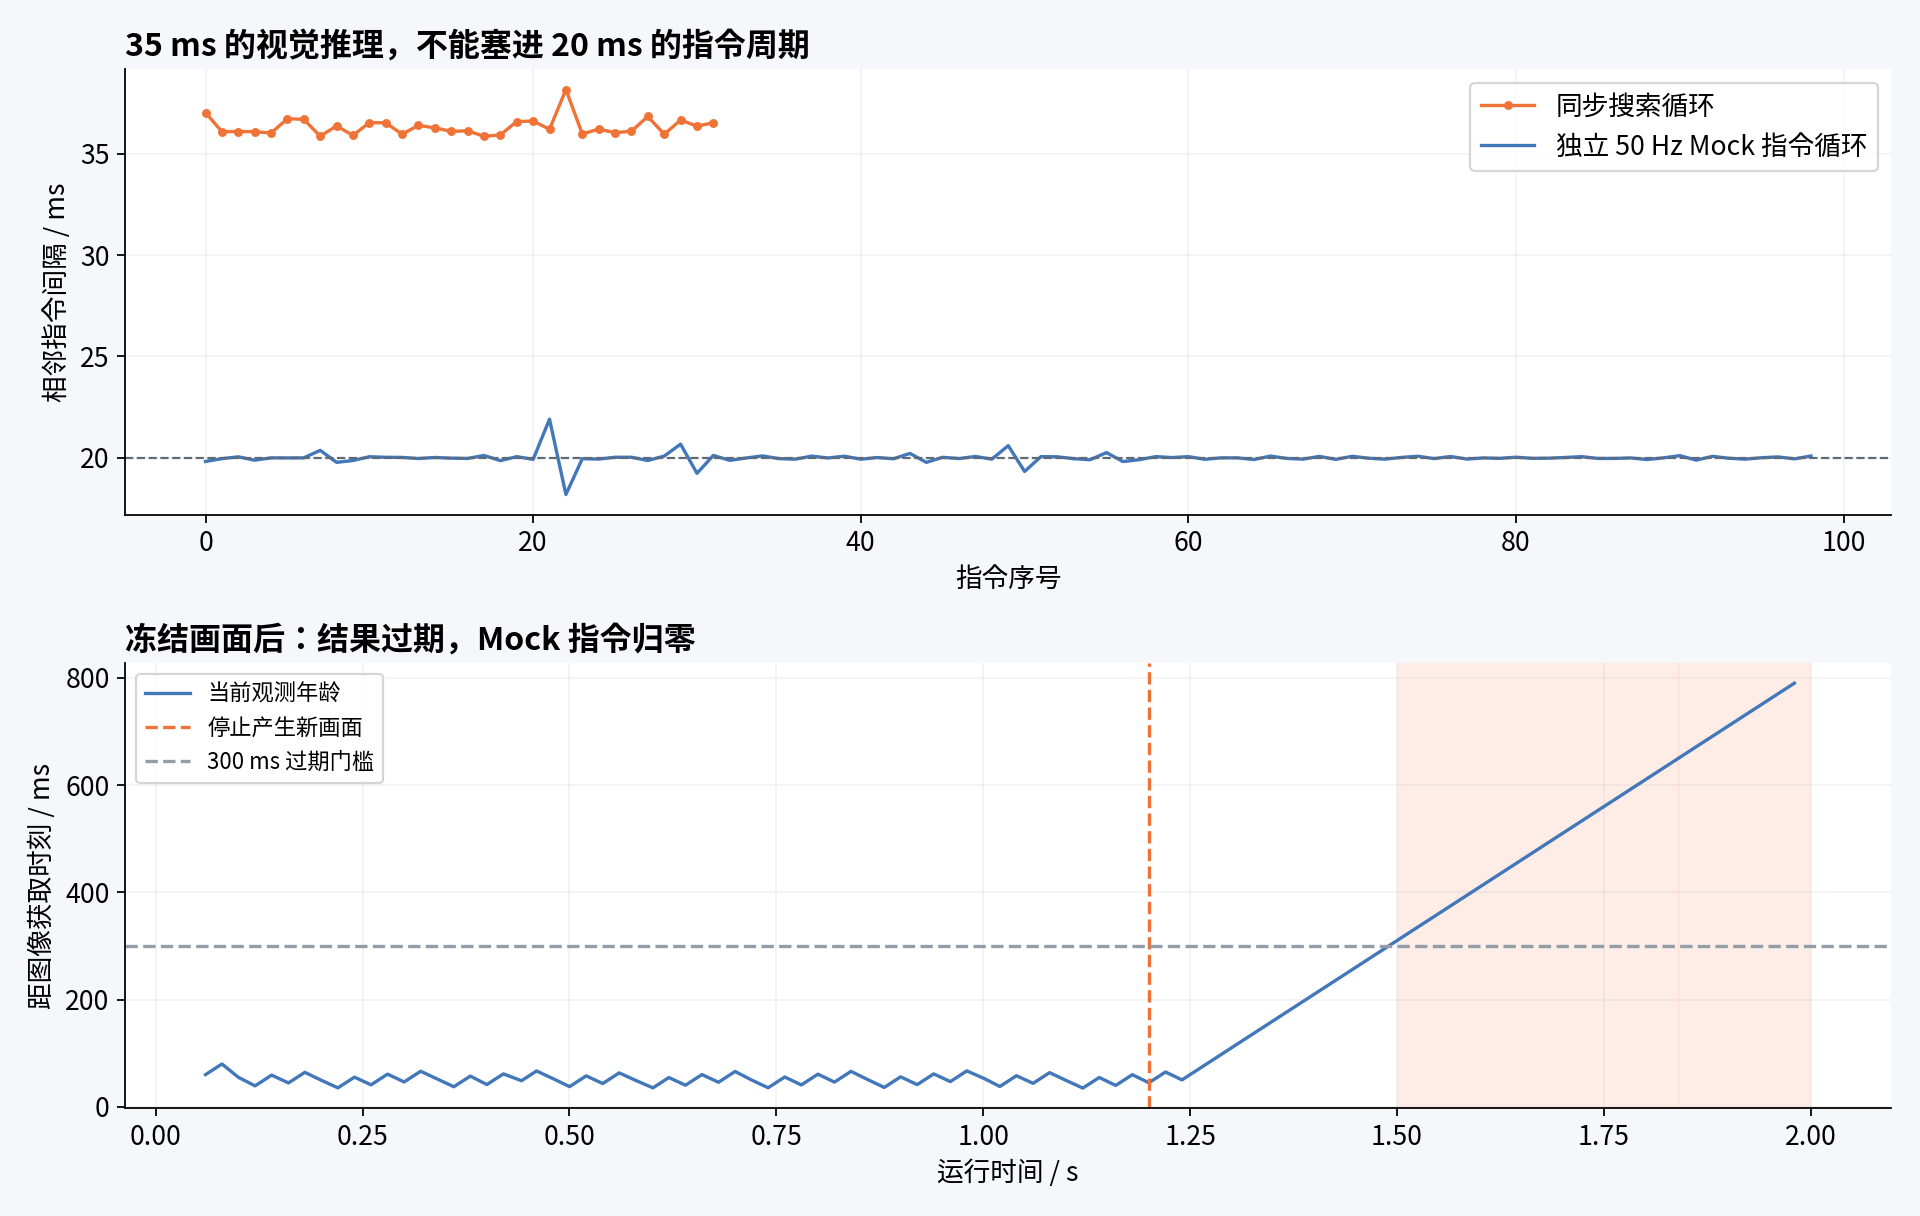
这次运行 2 秒,共记录 100 个指令周期,中位间隔 20.00 ms,最大 21.91 ms。运行到 1.2 秒时,故意停止提供新画面;约 1.5 秒后,旧观测过期,输出归零。这里验证的是桌面 Python 与 Mock 的实际时序,不是机器人控制器的实时性保证。
6. 换成自己的照片试一遍
先别动模型和阈值,换一张图最直接:
.venv/bin/python code/infer.py /path/to/your-photo.jpg \\
–output results/my-photo.png
先看框有没有包住整台洗衣机,再看类别和分数,最后才把它交给技能。接自己的视频或相机时,还要保留真正的取帧时间;断流后反复返回同一张旧图,不能算“新画面”。
这次最有用的结果,就是把这几个检查留在了代码里:框的像素单位、三帧确认、搜索超时和观测过期。换模型时,沿着这条链路再跑一次,比只看一张漂亮的检测截图更容易发现问题。
代码入口:本地视觉与技能分支实验;接口依据:启元 carry-clothes、OWL-ViT 文档。


评论前必须登录!
注册