 网硕互联帮助中心
大家好,欢迎来到 huangjin007_ 的博客
⭐
个人主页:huangjin007_
🔥
文章收录专栏:Linux 内功修炼手册(系统篇)
总会有一些坚持能从冰封的土地里培育出十万朵怒放的蔷薇
Linux 系统篇(三十一) —— 从管道原理到进程池实战
文章目录
- Linux 系统篇(三十一) —— 从管道原理到进程池实战
-
- 一、进程间通信:为什么进程之间需要通信?
-
- 1.1 先思考一个问题:两个进程,怎么才能交换数据?
- 1.2 进程间通信要解决哪些问题?
- 1.3 Linux 进程间通信是怎样发展起来的?
- 二、管道:能不能让一个进程写,另一个进程读?
-
- 2.1 从一个实际问题开始
- 2.2 什么是管道?
- 2.3 为什么说管道是一种字节流?
- 2.4 管道分为哪几种?
-
- 匿名管道
- 命名管道
- 三、匿名管道:pipe() 到底做了什么?
-
- 3.1 先认识 pipe() 函数
- 3.2 为什么创建一个管道,需要返回两个文件描述符?
- 四、fork() 与匿名管道:父子进程为什么能够通信?
-
- 4.1 先创建管道,再创建子进程
- 4.2 父子进程通信时,为什么要关闭不使用的端?
- 4.3 一个完整的父子进程管道程序
- 4.4 父子进程为什么能够通过管道通信?
- 4.5 为什么父进程能够读到 EOF?
- 4.6 EOF 和 `waitpid()` 有什么区别?
- 五、从文件描述符的角度理解管道
-
- 5.1 文件描述符不等于真正的数据对象
- 5.2 fork() 后,父子进程如何共享管道?
- 5.3 为什么关闭一个文件描述符,不会影响另一个进程?
- 5.4 文件描述符表和管道缓冲区有什么区别?
- 六、从内核的角度理解管道
-
- 6.1 管道中的数据存放在哪里?
- 七、管道的读写规则
-
- 7.1 管道为空时,read() 会怎样?
- 7.2 管道写满时,write() 会怎样?
- 7.3 所有写端关闭后,为什么 read() 会返回 0?
- 八、管道的主要特点
-
- 8.1 匿名管道通常用于相关进程之间通信
- 8.2 管道提供字节流服务
- 8.3 管道的生命周期与引用有关
- 8.4 管道由内核协调读写
- 九、用四种典型情况验证管道规则
-
- 9.1 情况一:读端正常,写端正常
- 9.2 情况二:写端正常,但管道为空
- 9.3 情况三:写端关闭,读端正常
- 9.4 情况四:读端关闭,写端正常
- 十、从管道到进程池:为什么需要多个子进程?
-
- 10.1 什么是进程池?
- 10.2 为什么进程池需要管道?
- 十一、任务管理器:如何根据编号执行任务?
- 十二、Channel:管理父进程与子进程的通信
- 十三、ChannelManager:如何轮流选择子进程?
- 十四、ProcessPool:把多个组件组织起来
-
- 14.1 Start():创建管道和子进程
- 14.2 为什么子进程必须关闭继承来的旧写端?
- 14.3 Work():子进程如何执行任务?
- 14.4 Run():父进程如何派发任务?
- 14.5 Stop():如何让子进程正常退出?
- 结语:
一、进程间通信:为什么进程之间需要通信?
1.1 先思考一个问题:两个进程,怎么才能交换数据?
一个程序运行起来,就会形成一个进程。每个进程都有自己的地址空间、代码、数据以及相应的运行状态。操作系统通过进程管理机制,让多个进程能够并发执行。
例如,我们在 Linux 中打开两个终端,分别运行两个程序:
- 进程 A:负责读取用户输入的数据。
- 进程 B:负责处理数据,并将处理结果输出到屏幕上。
现在问题来了:进程 A 读取到的数据,应该怎么交给进程 B?
在单个进程内部,我们可以通过变量、数组、指针等方式传递数据。但两个独立进程之间,事情就没有这么简单了。
原因在于,每个进程通常拥有独立的虚拟地址空间。
假设进程 A 中存在一个变量:
int number = 100;
进程 A 可以通过自己的地址空间访问这个变量,但进程 B 不能直接使用进程 A 中的普通指针,来访问同一个变量。
因为这个地址属于进程 A 的虚拟地址空间。即使进程 B 中存在数值相同的虚拟地址,也不代表它们指向同一块物理内存。
因此,我们需要一种机制,让两个进程能够按照一定的规则交换数据。
这种机制,就是进程间通信(IPC,Inter-Process Communication)。
1.2 进程间通信要解决哪些问题?
我们可以将其归纳为以下四类。
数据传输。最直接的需求:一个进程把数据交给另一个进程。比如 ps aux | grep nginx,ps 的输出要传给 grep。
资源共享。多个进程需要操作同一份数据,比如多个 worker 进程读取同一份配置,或者共享一块缓存。
通知事件。一个进程需要告诉另一个进程“某件事发生了”。最典型的是父进程需要知道子进程什么时候终止,才能去回收它,避免僵尸进程。
进程控制。有时候一个进程需要完全控制另一个进程的执行,比如调试器需要拦截被调试进程的信号、查看它的寄存器状态、单步执行。ptrace 就是这类需求的实现。
这四类需求,对应的 IPC 机制各有侧重。管道擅长的是“数据传输”和一定程度的“通知事件”;共享内存擅长“资源共享”;信号擅长“通知事件”;而 socket 和信号量则各自覆盖更专门的场景。
1.3 Linux 进程间通信是怎样发展起来的?
Linux 的 IPC 机制不是一口气设计出来的,而是经历了几个阶段的堆积。
第一代:管道和信号。Unix 最早期的 IPC 手段,简单粗暴,管道用于字节流传输,信号用于异步事件通知。这一代机制的问题也很明显:管道只能用于有亲缘关系的进程(匿名管道),信号能携带的信息几乎为零。
第二代:System V IPC。AT&T 在 System V Unix 中对早期 IPC 做了系统性的改进和扩充,形成了 System V 消息队列、System V 共享内存、System V 信号量这一套。它们在单个计算机内工作,接口风格统一,但生命周期管理和权限模型经常被吐槽——创建一个 IPC 对象后如果进程异常退出,对象可能残留在内核里。
第三代:POSIX IPC。POSIX 在 System V 的基础上重新设计了一套接口,包括 mq_open、shm_open、sem_open 等,设计上更接近文件操作,生命周期也更可控。Linux 从一开始就遵循 POSIX 标准,所以现代 Linux 上 POSIX IPC 是更推荐的选择。
把这张分类图放在脑子里:
| 早期 Unix | 匿名管道、命名管道、信号 | 简单,但能力有限 |
| System V | 消息队列、共享内存、信号量 | 功能强,但生命周期粗糙 |
| POSIX | mq_*、shm_*、sem_*、互斥量、条件变量、读写锁 | 接口更干净,生命周期更可控 |
本篇博客聚焦在管道上,但你会发现,管道的设计思想——“一切皆文件”——贯穿了整个 Linux IPC 体系。
二、管道:能不能让一个进程写,另一个进程读?
2.1 从一个实际问题开始
假设现在有两个进程:
- 进程 A 负责生产数据。
- 进程 B 负责消费数据。
我们希望进程 A 产生数据之后,进程 B 能够接收到这些数据。
最直接的想法可能是:进程 A 把数据写入一个变量,进程 B 再从这个变量中读取。
但是,普通变量位于进程各自的地址空间中。两个互相独立的进程,并不能直接通过同一个普通变量完成通信。
那我们换一种思路。
能不能在内核中准备一块用于暂存数据的区域?
进程 A 将数据写进去,进程 B 再从里面读出来。
这样,两个进程就不需要直接访问对方的普通变量,只需要按照统一的规则操作这块内核维护的区域。
管道采用的就是类似的思路。
2.2 什么是管道?
管道是 Unix 中最古老的进程间通信形式之一。
我们可以将管道理解成一个由内核维护的、用于在进程之间传递字节流的通道。
它有两个基本操作:
- 写端:向管道中写入数据。
- 读端:从管道中读取数据。
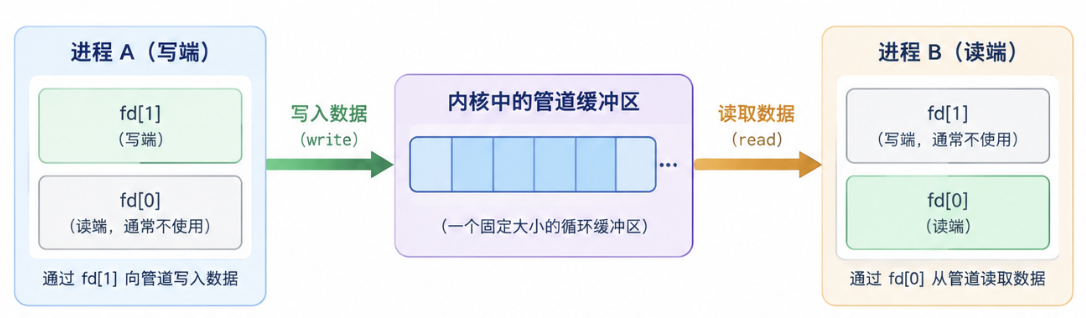
进程 A 不需要知道进程 B 的内部实现,只需要把数据写入管道。
进程 B 也不需要知道数据最初是怎么产生的,只需要从管道中读取数据。
内核负责维护管道中的数据以及相应的读写状态。
2.3 为什么说管道是一种字节流?
这是学习管道时非常重要的一个知识点。
假设写端连续写入两次数据:
write(wfd, "hello", 5);
write(wfd, "world", 5);
写端进行了两次 write() 调用,每次写入 5 个字节。
读端可能一次读取 10 个字节,得到:
helloworld
也可能先读取 5 个字节,得到:
hello
然后再读取另外 5 个字节,得到:
world
对于一般的管道读写,不能认为一次 write() 就必然对应一次 read()。
例如,写端写入两个逻辑消息:
消息 A
消息 B
读端可能一次就把两条消息的数据全部读出来,也可能只读到第一条消息的一部分。
管道只负责按照字节顺序传递数据,并不理解这些字节在业务上代表什么。
因此,管道是面向字节流的通信机制,而不是天然保留消息边界的通信机制。
2.4 管道分为哪几种?
Linux 中最常见的管道有两种。
匿名管道
匿名管道通常通过 pipe() 创建。
它没有一个供其他进程通过文件路径直接打开的名称,一般由一个进程创建,然后通过 fork() 等方式将管道的文件描述符交给相关进程使用。
例如,父进程创建管道,再创建子进程,父子进程就可以通过这个管道进行通信。
命名管道
命名管道也叫 FIFO,可以通过文件系统中的路径找到。
例如,可以使用 mkfifo() 创建一个命名管道:
mkfifo myfifo
这样,两个没有亲缘关系的进程,也可以通过约定好的 FIFO 路径打开它并进行通信。
本文先研究匿名管道。
三、匿名管道:pipe() 到底做了什么?
3.1 先认识 pipe() 函数
Linux 为我们提供了 pipe() 系统调用,可以创建一个匿名管道。
头文件:
#include <unistd.h>
函数原型:
int pipe(int fd[2]);
参数 fd 是一个包含两个整数的数组,用来接收创建成功后的两个文件描述符。
调用成功时:
- fd[0] 表示管道读端。
- fd[1] 表示管道写端。
返回值:
- 成功返回 0。
- 失败返回 -1,并设置 errno,用于说明失败原因。
例如:
int fds[2];
if (pipe(fds) == –1)
{
perror("pipe");
return 1;
}
如果创建成功,fds 中就会保存两个文件描述符。
3.2 为什么创建一个管道,需要返回两个文件描述符?
先回忆一下文件描述符的概念。
在 Linux 中,文件描述符是一个非负整数,用于标识当前进程打开的文件或其他 I/O 对象。
例如:
int fd = open("test.txt", O_RDONLY);
open() 成功后会返回一个文件描述符,后续可以通过 read(fd, …) 从文件中读取数据。
管道也遵循类似的使用方式。
不过,管道有两个不同的操作方向:一个用于读取,一个用于写入。
因此,pipe() 创建成功后会提供两个文件描述符:
fds[0] // 读端
fds[1] // 写端
例如:
write(fds[1], "hello", 5);
这行代码把 5 个字节写入管道。
随后:
char buffer[10];
ssize_t n = read(fds[0], buffer, sizeof(buffer));
这行代码从管道中读取数据。
可以发现,管道的使用方式与文件非常相似。
普通文件可以通过 open() 打开,再通过 read() 和 write() 操作;匿名管道则通过 pipe() 获取读写端,再通过 read() 和 write() 操作。
四、fork() 与匿名管道:父子进程为什么能够通信?
4.1 先创建管道,再创建子进程
前面已经知道,pipe() 可以创建管道。
但问题来了:如果管道最初是由父进程创建的,子进程又怎么能够访问它?
答案是:fork()。
在 Linux 中,父进程调用 fork() 创建子进程时,子进程会获得父进程文件描述符表中相应描述符的副本。
这意味着,如果父进程在调用 fork() 之前已经创建了管道,那么子进程就可以继承管道读端和写端的文件描述符。
因此,父子进程能够通过同一个管道对象进行通信。
基本流程如下:
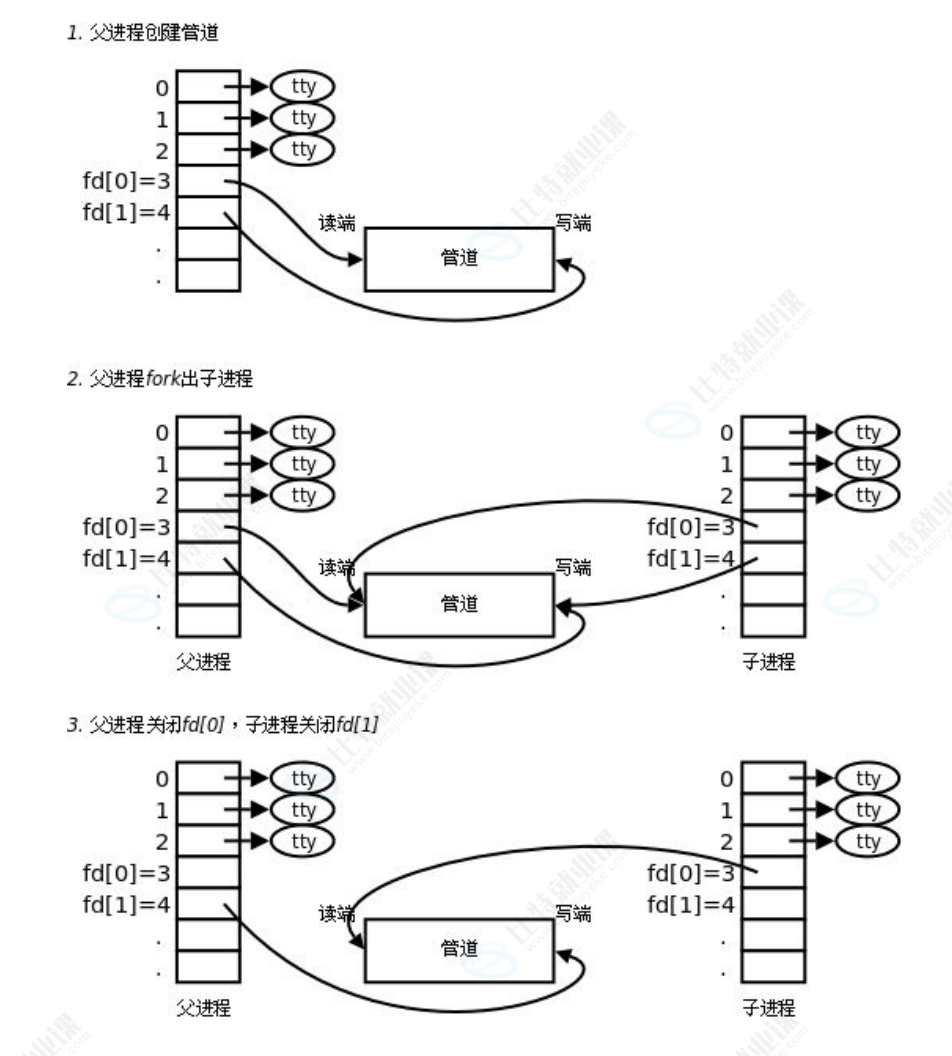
需要注意的是,这里的“副本”并不是重新创建了一条完全独立的管道。
父子进程拥有各自的文件描述符表,但对应的描述符引用着同一个底层管道对象。
因此,父进程写入的数据,子进程可以读取;子进程写入的数据,父进程也可以读取。
不过,如果父子进程都保留读写两端,就容易出现问题。例如,读端等待数据时,内核可能发现仍然有写端处于打开状态,从而无法判断写入方已经全部退出。
因此,建立父子进程通信后,通常需要关闭双方不使用的文件描述符。
4.2 父子进程通信时,为什么要关闭不使用的端?
假设我们希望实现这样的通信关系:
- 子进程负责写入数据。
- 父进程负责读取数据。
那么,子进程只需要写端,父进程只需要读端。
正确的做法是:
子进程关闭读端:
close(fds[0]);
父进程关闭写端:
close(fds[1]);
为什么一定要关闭不使用的端?
因为管道是否还有读者、是否还有写者,取决于内核对相关打开引用的管理,而不是取决于我们主观上认为哪个进程负责读、哪个进程负责写。
例如,子进程虽然不打算读取管道,但如果它仍然保留读端,那么父进程关闭自己的读端之后,内核仍然可能认为管道还有读端存在。
这会影响写端对“已经没有读者”的判断。
同样,如果父进程不关闭写端,即使子进程已经退出,父进程也可能无法及时从管道读取到 EOF。
4.3 一个完整的父子进程管道程序
下面通过一个简单的程序,演示父子进程如何利用匿名管道通信,以及父进程如何通过 EOF 判断写端已经全部关闭。
#include <iostream>
#include <unistd.h>
#include <cstring>
#include <sys/types.h>
#include <sys/wait.h>
int main()
{
int fds[2];
if (pipe(fds) == –1)
{
perror("pipe");
return 1;
}
pid_t id = fork();
if (id == –1)
{
perror("fork");
close(fds[0]);
close(fds[1]);
return 1;
}
if (id == 0)
{
// 子进程负责写入
close(fds[0]);
const char* msg = "Hello, father!";
write(fds[1], msg, strlen(msg));
close(fds[1]);
_exit(0);
}
// 父进程负责读取
close(fds[1]);
char buffer[1024];
ssize_t n;
while ((n = read(fds[0], buffer, sizeof(buffer) – 1)) > 0)
{
buffer[n] = '\\0';
std::cout << "child say: " << buffer << std::endl;
}
if (n == –1)
perror("read");
else
std::cout << "管道读到 EOF,写端已经全部关闭" << std::endl;
close(fds[0]);
waitpid(id, nullptr, 0);
return 0;
}
4.4 父子进程为什么能够通过管道通信?
整个过程可以概括为:
管道通信的关键,是父子进程通过文件描述符访问同一个内核管道对象,而不是直接访问对方的内存。
4.5 为什么父进程能够读到 EOF?
read() 的返回值主要有三种情况:
| 大于 0 | 成功读取到数据 |
| 等于 0 | 管道中的数据已经读完,并且所有写端都已关闭 |
| 等于 -1 | 读取发生错误 |
需要注意,子进程退出不代表父进程立即读到 EOF。如果管道中还有数据,父进程需要先将数据读完;如果还有其他进程持有写端,父进程也可能继续等待。
因此,及时关闭不需要的文件描述符非常重要。
4.6 EOF 和 waitpid() 有什么区别?
二者解决的是不同的问题:
- EOF:表示管道中的数据已经读完,并且所有写端都已关闭。
- waitpid():等待子进程,并在适当情况下回收其退出资源。
所以,父进程既要正确关闭文件描述符,也要使用 waitpid() 回收子进程。
五、从文件描述符的角度理解管道
前面我们知道,pipe() 创建管道,fork() 让子进程继承父进程的文件描述符。那么,为什么父子进程能够通过这些文件描述符访问同一个管道?
5.1 文件描述符不等于真正的数据对象
在 Linux 中,文件描述符可以理解为进程访问内核对象的入口编号。
例如:
int fd = open("test.txt", O_RDONLY);
假设返回的文件描述符是 3。当我们调用 read(3, buffer, sizeof(buffer)) 时,内核会通过当前进程的文件描述符表找到对应的打开文件对象,再执行读取操作。
因此,文件描述符只是一个编号,并不是文件内容或管道本身。
5.2 fork() 后,父子进程如何共享管道?
假设父进程调用 pipe(fds) 后得到:
fds[0] = 3 // 读端
fds[1] = 4 // 写端
调用 fork() 后,子进程会继承这些文件描述符。可以简化理解为:
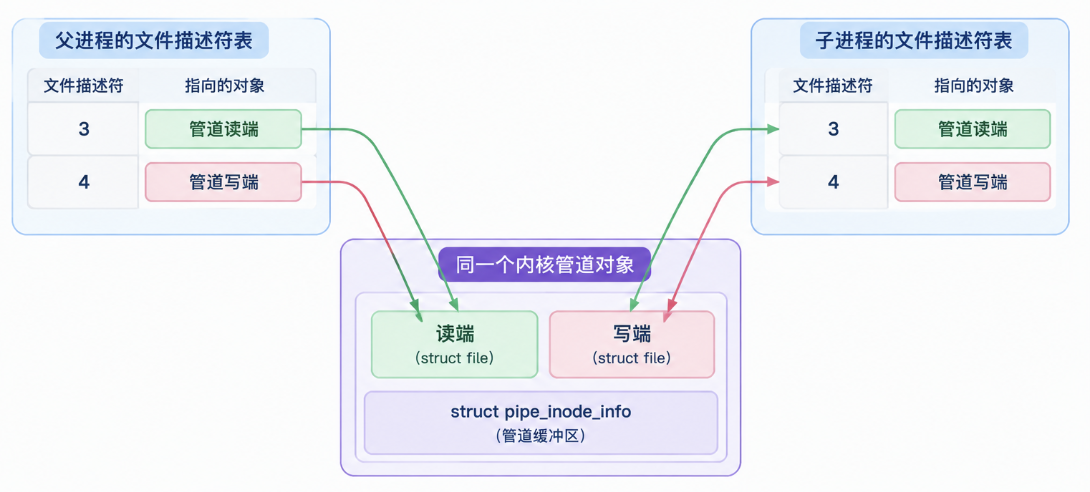
这里需要注意,父子进程拥有各自的文件描述符表,但相应的描述符引用着继承而来的底层打开对象,最终访问同一个内核管道。
因此,子进程调用 write() 写入数据后,父进程就可以通过 read() 读取数据。
5.3 为什么关闭一个文件描述符,不会影响另一个进程?
例如,父进程执行:
close(fds[1]);
关闭的只是父进程自己的文件描述符,不会自动关闭子进程对应的描述符。
如果子进程仍然持有写端,管道就仍然存在写端引用。只有所有写端都关闭,并且管道中没有剩余数据时,读端的 read() 才会返回 0。
因此,判断管道是否还有写入方,不能只看某个进程是否退出,还要看是否有其他进程保留着写端。
5.4 文件描述符表和管道缓冲区有什么区别?
| 文件描述符 | 当前进程访问内核对象的入口编号 |
| 文件描述符表 | 记录当前进程持有的文件描述符 |
| 管道对象 | 管理管道的读写状态及相关内核数据 |
| 管道缓冲区 | 暂存已经写入、但尚未读取的数据 |
六、从内核的角度理解管道
6.1 管道中的数据存放在哪里?
假设子进程执行:
write(wfd, "hello", 5);
这 5 个字节不会直接写进父进程的普通变量,而是由内核管道机制接收,并暂存在内核维护的管道缓冲区中。
随后,父进程执行:
read(rfd, buffer, sizeof(buffer));
内核再将管道中的数据复制到父进程提供的缓冲区。
整个过程可以概括为:
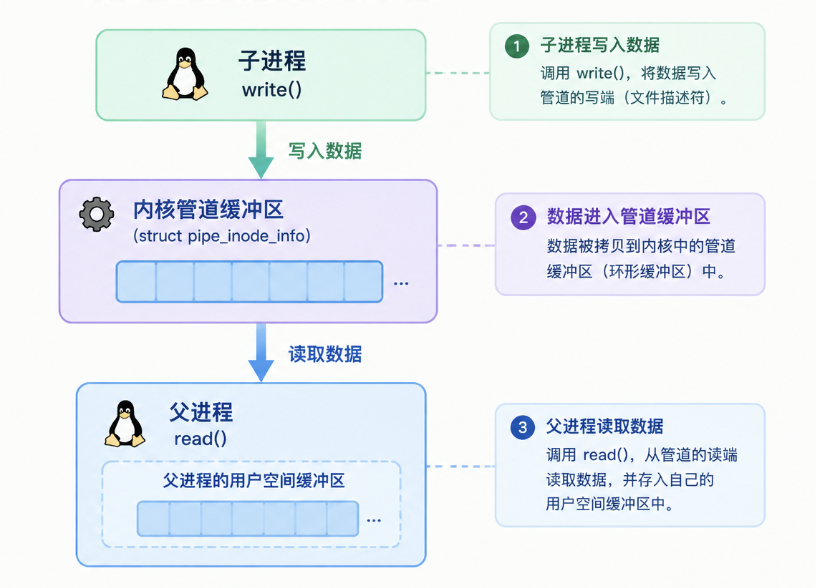
父子进程拥有各自独立的虚拟地址空间,但可以通过系统调用,让内核帮助它们传递数据。
管道通信的关键,是不同进程通过内核提供的共同通信对象交换数据,而不是直接访问对方的普通内存。
七、管道的读写规则
7.1 管道为空时,read() 会怎样?
默认情况下,如果管道中没有数据,但仍有写端打开,阻塞模式下的 read() 会等待数据到来。
如果将读端设置为非阻塞模式,那么在当前没有数据可读时,read() 通常返回 -1,并将 errno 设置为 EAGAIN 或 EWOULDBLOCK。
但是,如果所有写端已经关闭,并且管道中的数据也已经读完,那么 read() 会返回 0,表示 EOF。
7.2 管道写满时,write() 会怎样?
管道缓冲区容量有限。如果写入方不断写入数据,却没有进程读取,缓冲区就可能被写满。
- 阻塞模式: 空间不足时,write() 可能等待,直到读端释放空间。
- 非阻塞模式: 如果当前无法写入,write() 通常返回 -1,并设置 errno 为 EAGAIN 或 EWOULDBLOCK。
对于较大的写入请求,还可能出现只写入部分数据的情况,因此实际编程时需要检查返回值。
7.3 所有写端关闭后,为什么 read() 会返回 0?
假设子进程执行:
write(wfd, "hello", 5);
close(wfd);
如果父进程读取时,管道中仍然有数据,就会先读取这些数据。等数据全部读完,并且所有写端都关闭后,后续的 read() 才会返回 0。
因此,EOF 并不意味着某个子进程刚刚退出,而是表示管道中的数据已经读完,且不再有任何写端能够写入数据。
如果其他进程仍然持有写端,即使最初写入数据的子进程已经退出,父进程也可能继续等待。
八、管道的主要特点
8.1 匿名管道通常用于相关进程之间通信
匿名管道没有可以让任意进程直接通过文件系统路径打开的名称,因此最常见的方式是由父进程创建管道,再通过 fork() 让子进程继承文件描述符。
不过,如果文件描述符通过其他方式传递给无亲缘关系的进程,匿名管道也可以用于它们之间的通信。
8.2 管道提供字节流服务
管道只负责传递字节,不会自动区分每次 write() 对应哪次 read()。如果需要传递一条条完整消息,通信双方必须约定数据格式。
8.3 管道的生命周期与引用有关
某个进程退出,并不意味着管道一定立即释放。只要仍有相关文件描述符保持打开,管道对象就可能继续存在。相关引用全部释放后,内核才能回收相应资源。
8.4 管道由内核协调读写
内核负责管理管道缓冲区,并根据读写状态处理阻塞和唤醒等操作。但管道并不能自动解决所有业务层面的同步问题,复杂场景仍然可能需要额外的同步机制。
九、用四种典型情况验证管道规则
理论讲完之后,我们可以回到实际代码中,验证前面的规则。
这里重点考虑四种情况:
9.1 情况一:读端正常,写端正常
这是最普通的情况。
写端执行:
write(wfd, "hello", 5);
读端执行:
char buffer[100];
ssize_t n = read(rfd, buffer, sizeof(buffer));
只要数据成功写入,读端就可以读取相应的数据。
不过,如果写端暂时没有数据可写,而读端使用阻塞模式调用 read(),读端就可能等待。
因此,正常通信不仅要求管道存在,还需要写入方和读取方按照合理的流程协作。
9.2 情况二:写端正常,但管道为空
假设写端仍然打开,但是暂时没有向管道写入数据。
此时读端调用:
read(rfd, buffer, sizeof(buffer));
如果是阻塞模式,读取操作会等待。
如果是非阻塞模式,则通常返回 -1,并将 errno 设置为 EAGAIN 或 EWOULDBLOCK。
这说明管道为空和管道已经结束是两种不同状态。
- 管道为空,但仍有写端:后面还可能有数据。
- 管道为空,所有写端关闭:已经到达 EOF。
9.3 情况三:写端关闭,读端正常
假设写端先写入:
write(wfd, "hello", 5);
然后执行:
close(wfd);
读端第一次读取时,仍然可能得到:
hello
数据被读完后,读端再次读取,就会得到:
read(rfd, buffer, sizeof(buffer)) == 0
这就是 EOF。
所以,写端关闭不意味着已经写入的数据会被直接丢弃。
读端仍然可以把缓冲区中的剩余数据读取完毕。
9.4 情况四:读端关闭,写端正常
假设所有读端都关闭了,但写端仍然尝试写入:
write(wfd, "hello", 5);
此时会产生 SIGPIPE 信号。
如果采用默认处理方式,进程通常会终止。
如果程序忽略或处理了 SIGPIPE,就可以通过 write() 的返回值检查错误。常见结果是返回 -1,并设置 errno 为 EPIPE。
因此,写端在设计时不能假设读端永远存在。
如果读端可能提前退出,写端就应该考虑如何处理这种情况,例如记录错误、停止发送数据、清理资源等。
十、从管道到进程池:为什么需要多个子进程?
前面我们已经学会了使用管道进行父子进程通信。但如果程序需要执行大量任务,例如打印日志、下载文件、上传数据,只依靠一个进程处理,就可能无法充分利用多进程并发执行的能力。
这时,可以创建多个子进程,让父进程负责派发任务,子进程负责执行任务。这就是进程池的基本思想。
10.1 什么是进程池?
进程池就是提前创建一组工作进程,并让它们反复执行任务。
它主要包含三个部分:
- 父进程: 管理子进程,负责派发任务。
- 子进程: 接收任务并执行。
- 通信通道: 负责在父子进程之间传递任务信息。
为什么不每次有任务时才创建子进程?
因为创建和销毁进程需要一定的系统开销。对于任务较多的场景,提前创建并复用工作进程,可以减少重复创建进程的成本。
10.2 为什么进程池需要管道?
假设父进程创建了 3 个子进程:
父进程
/ | \\
管道1 管道2 管道3
| | |
子进程1 子进程2 子进程3
父进程生成一个任务编号,例如 1,就可以通过对应管道将编号发送给子进程。
子进程读取编号后,再执行相应任务。
这里发送的是任务编号,而不是整个任务函数。父子进程通过约定好的编号对应关系,就能知道应该执行什么任务。
为每个子进程建立独立管道,也方便父进程明确指定任务的接收者。
十一、任务管理器:如何根据编号执行任务?
进程池可以将任务函数统一保存起来,通过编号决定执行哪个任务。
Task.hpp文件
#pragma once
#include<iostream>
#include<vector>
#include<ctime>
typedef void (*task_t)();
void PrintLog()
{
std::cout << "我是一个打印的任务…" << std::endl;
}
void DownLoad()
{
std::cout << "我是一个下载的任务…" << std::endl;
}
void UpLoad()
{
std::cout << "我是一个上传的任务…" << std::endl;
}
class TaskManager
{
public:
TaskManager()
{
srand(time(nullptr));
}
void Register(task_t t)
{
_task.push_back(t);
}
int Code()
{
if(_task.empty())
return –1;
return rand() % _task.size();
}
void Execute(int code)
{
if(code >= 0 && code < _task.size())
{
_task[code]();
}
}
private:
std::vector<task_t> _task;
};
这里最重要的是三个函数:
- Register():将任务函数保存到 vector 中。
- Code():随机生成一个有效的任务编号。
- Execute():根据编号调用对应的函数。
例如,注册三个任务后,可以建立这样的对应关系:
编号 0 → PrintLog
编号 1 → DownLoad
编号 2 → UpLoad
父进程只需要向子进程发送编号 1,子进程就能执行 DownLoad()。
为什么子进程也能执行这些函数?因为 fork() 后,子进程会继承父进程当时的进程内存状态,其中包括已经注册的任务列表。但父子进程的普通内存是相互独立的,后续修改不会自动同步。
十二、Channel:管理父进程与子进程的通信
每个子进程都对应一个通信通道。父进程需要记录管道写端和子进程 PID,因此可以使用 Channel 类统一管理。
class Channel
{
public:
Channel(int fd, pid_t id)
: _wfd(fd), _subid(id)
{
_name = "channel-" + std::to_string(_wfd) + "-" + std::to_string(_subid);
}
~Channel() = default;
void Send(int code)
{
size_t n = write(_wfd, &code, sizeof(code));
(void)n; // 暂时不使用变量n的值
}
void Close()
{
if (_wfd > 0)
{
close(_wfd);
_wfd = –1;
}
}
void Wait()
{
pid_t rid = waitpid(_subid, nullptr, 0);
(void)rid;
}
int FD() const { return _wfd; }
pid_t SubId() const { return _subid; }
const std::string &Name() const { return _name; }
private:
int _wfd;
pid_t _subid;
std::string _name;
};
这里需要理解三个函数:
- Send():将任务编号写入管道。
- Close():关闭父进程持有的管道写端。
- Wait():等待并回收对应的子进程。
注意,关闭管道和回收子进程是两件不同的事。关闭写端可以让子进程在读完剩余数据后读到 EOF;waitpid() 则负责等待并回收子进程。
实际工程中,Send() 还应检查 write() 的返回值,并处理写入失败等情况。
十三、ChannelManager:如何轮流选择子进程?
当进程池中有多个子进程时,父进程需要知道下一次应该向谁派发任务。
可以使用 vector 保存所有通道,再通过轮询的方式依次选择:
class ChannelManager
{
public:
ChannelManager()
: _next(0)
{
}
~ChannelManager() = default;
void Insert(int wfd, pid_t subid)
{
_channels.emplace_back(wfd, subid);
}
Channel *Select()
{
if(_channels.empty())
return nullptr;
Channel *c = &_channels[_next];
_next++;
_next %= _channels.size();
return c;
}
void PrintProcess()
{
for (const auto &channel : _channels)
{
std::cout << channel.Name() << std::endl;
}
}
void StopSubProcess()
{
for (auto &channel : _channels)
{
channel.Close();
std::cout << "关闭: " << channel.Name() << std::endl;
}
}
void CloseInheritedWFds()
{
for (auto &channel : _channels)
{
channel.Close();
}
}
void WaitSubProcess()
{
for (auto &channel : _channels)
{
channel.Wait();
std::cout << "回收:" << channel.Name() << std::endl;
}
}
private:
std::vector<Channel> _channels;
int _next;
};
假设有 3 个子进程,选择顺序就是:
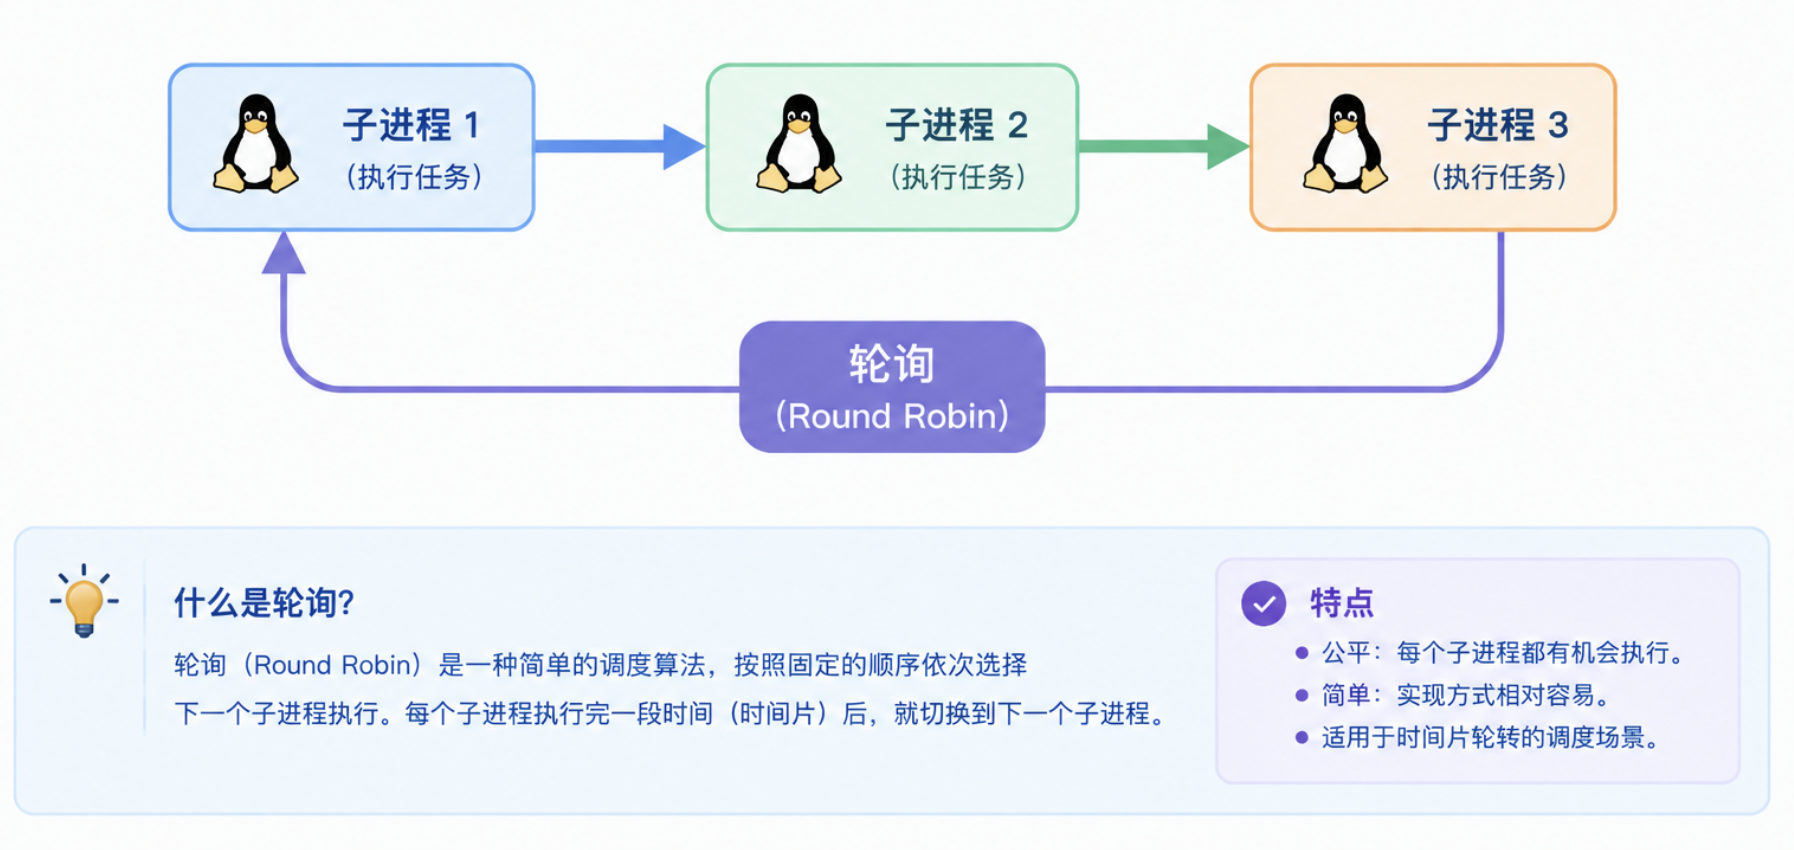
这种方式叫作轮询(Round Robin)。
它的优点是实现简单,能够依次向各个子进程分配任务。不过,它不会判断哪个子进程已经空闲,也不会考虑任务执行时间是否相同,因此属于基础的调度策略。
十四、ProcessPool:把多个组件组织起来
进程池的核心工作,就是创建子进程、建立管道、派发任务,并在结束时清理资源。
14.1 Start():创建管道和子进程
核心逻辑可以简化为:
for (int i = 0; i < process_num; i++)
{
int pipefd[2];
if (pipe(pipefd) == –1)
return false;
pid_t id = fork();
if (id == 0)
{
close(pipefd[1]); // 子进程关闭当前写端
Work(pipefd[0]); // 从读端接收任务
close(pipefd[0]);
_exit(0);
}
else if (id > 0)
{
close(pipefd[0]); // 父进程关闭当前读端
manager.Insert(pipefd[1], id);
}
else
{
close(pipefd[0]);
close(pipefd[1]);
return false;
}
}
这段代码展示了最核心的结构:
- 父进程保留管道写端,用来发送任务编号。
- 子进程保留管道读端,用来接收任务编号。
- 每次循环创建一个子进程和一条独立管道。
完整工程代码还需要在创建失败时清理之前创建的子进程和通道,不能只处理当前这条管道。
14.2 为什么子进程必须关闭继承来的旧写端?
假设父进程先创建子进程 1,再创建子进程 2。由于 fork() 会继承文件描述符,子进程 2 可能也持有管道 1 的写端。
如果子进程 2 不关闭这个无关的写端,那么即使父进程和子进程 1 都关闭了管道 1 的写端,内核仍然认为管道 1 存在写端引用。
结果就是:子进程 1 可能一直读不到 EOF,无法正常退出。
因此,实际代码中的 CloseInheritedWFds() 就是用来关闭子进程继承来的、自己不需要的旧写端。
原则:每个进程都应该及时关闭自己不使用的管道端,否则可能导致 EOF 无法出现,甚至让程序一直阻塞。
14.3 Work():子进程如何执行任务?
子进程的工作循环可以概括为:
void Work(int rfd)
{
while (true)
{
int code;
ssize_t n = read(rfd, &code, sizeof(code));
if (n == 0)
break; // 所有写端关闭,且数据已经读完
if (n == sizeof(code))
task_manager.Execute(code);
else
break; // 简化示例,实际代码需要完善错误处理
}
}
子进程不断读取任务编号,再调用 Execute() 执行对应任务。
这里要注意,管道是字节流。真实工程代码还需要妥善处理短读、系统调用被信号中断等情况,不能直接把所有非完整读取都当作正常结束。
14.4 Run():父进程如何派发任务?
父进程的任务派发流程可以概括为:
int code = task_manager.Code();
Channel* c = channel_manager.Select();
if (code >= 0 && c != nullptr)
c->Send(code);
整个过程就是:
这里的 Run() 只负责派发任务,不代表任务已经执行完成。如果需要知道任务是否完成,还需要额外设计反馈机制。
14.5 Stop():如何让子进程正常退出?
进程池结束时,通常先关闭所有父进程持有的管道写端,再等待并回收子进程:
void Stop()
{
manager.StopSubProcess(); // 关闭所有写端
manager.WaitSubProcess(); // 等待并回收子进程
}
为什么不能直接先等待?
因为子进程可能还阻塞在 read() 中。如果父进程没有关闭写端,子进程可能一直等不到数据或 EOF,父进程也就无法顺利等到它退出。
所以,停止进程池的关键顺序是:
关闭写端 → 子进程读到 EOF 并退出 → 父进程通过 waitpid() 回收子进程。
ProcessPool 代码:
class ProcessPool
{
public:
ProcessPool(int num)
: _process_name(num)
{
_tm.Register(PrintLog);
_tm.Register(DownLoad);
_tm.Register(UpLoad);
}
~ProcessPool() = default;
void Work(int rfd)
{
while (true)
{
int code = 0;
size_t n = read(rfd, &code, sizeof(code));
if (n > 0)
{
if (n < sizeof(code))
continue;
std::cout << "子进程[" << getpid() << "]执行任务:" << code << std::endl;
_tm.Execute(code);
}
else if (n == 0)
{
std::cout << "子进程退出!" << std::endl;
break;
}
else
{
std::cout << "读取错误!" << std::endl;
break;
}
}
}
bool Start()
{
for (int i = 0; i < _process_name; i++)
{
int pipefd[2] = {0};
pid_t n = pipe(pipefd);
if (n < 0)
{
_cm.StopSubProcess(); // 关闭父进程保存的管道写端
_cm.WaitSubProcess(); // 调用waitpid(),等待并回收子进程
return false;
}
pid_t subid = fork();
if (subid < 0)
{
// 清理当前创建的子进程
close(pipefd[1]);
close(pipefd[0]);
// 关闭之前保存的所有父进程的写端
_cm.StopSubProcess();
// 等待并回收之前创建的子进程
_cm.WaitSubProcess();
return false;
}
else if (subid == 0)
{
// 子进程
// 关闭从父进程继承过来的旧管道写端
_cm.CloseInheritedWFds();
close(pipefd[1]);
Work(pipefd[0]);
close(pipefd[0]);
_exit(0);
}
else
{
close(pipefd[0]);
_cm.Insert(pipefd[1], subid);
}
}
return true;
}
void Debug()
{
_cm.PrintProcess();
}
void Run()
{
int taskcode = _tm.Code();
if(taskcode < 0)
{
std::cerr << "没有可用的任务,无法派发" << std::endl;
return;
}
Channel* c = _cm.Select();
if (c == nullptr)
{
std::cerr << "没有可用的子进程,无法派发任务" << std::endl;
return;
}
std::cout << "选择了一个子进程:" << c->Name() << std::endl;
c->Send(taskcode);
std::cout << "发送了一个任务码:" << taskcode << std::endl;
}
void Stop()
{
_cm.StopSubProcess();
_cm.WaitSubProcess();
}
private:
ChannelManager _cm;
int _process_name;
TaskManager _tm;
};
至此,进程池就将 pipe()、fork()、read()、write()、close() 和 waitpid() 这些知识点串联了起来。
结语:
今天的内容到这里就结束了,希望你能有所收获~
干货整理到手抖,觉得有用的话,赏个三连回回血?__(:ᗤ」ㄥ)_ _


评论前必须登录!
注册