 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
成为全栈·Taro 小程序篇·小程序 Markdown 阅读器:从 AST 到受控原生组件
“代码没有高亮,也没标语言。”APP 阅读器上线后收到的这条反馈,比任何设计评审都直接。
前言:读者反馈"代码没有高亮",比设计评审更直接
APP 阅读器上线后收到一条反馈:“代码没有高亮,也没标语言。”
我当时的第一反应是"这是装饰功能吧"。但那条反馈里真正有用的信息是后半句:读者要判断这段代码属于哪个环境。
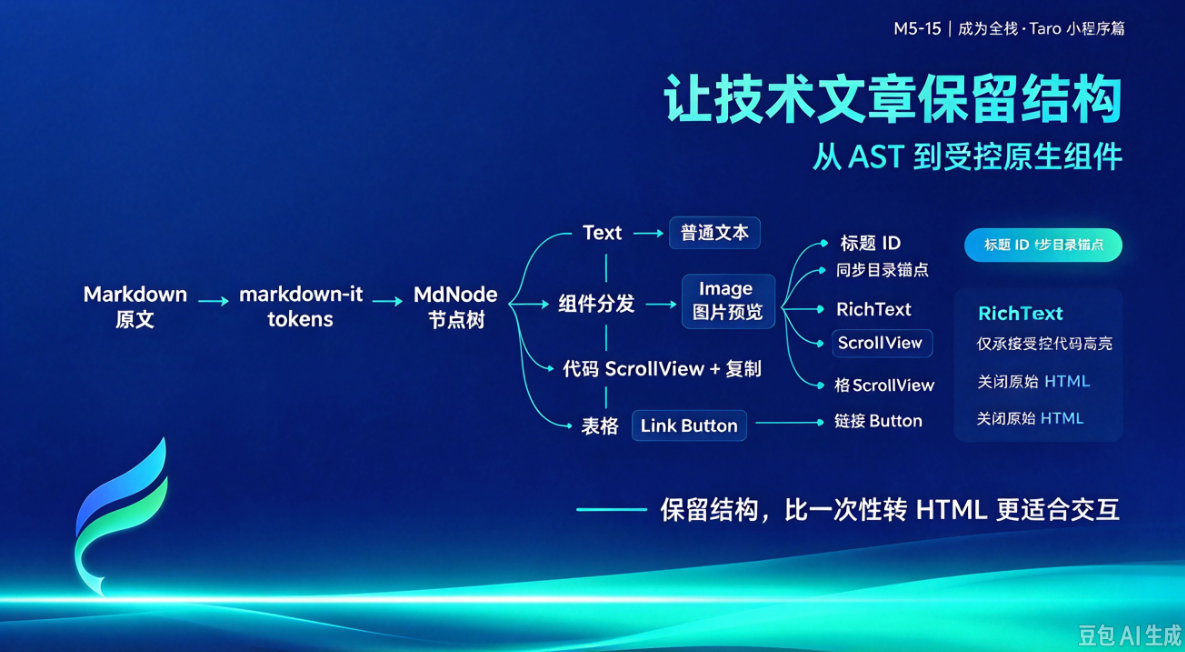
对一个技术专栏来说,代码块不是插图 —— 它是内容本身。读者要读它、判断它、复制它,长的还要横向滚动。而"用 rich-text 把整篇 Markdown 转成 HTML 字符串"这条最省事的路,恰好把这些能力全部交出去。
摆在面前的三条路:转 HTML、换一个能解析成虚拟 DOM 的库、自己解析 token 建节点树。
第一条最省事但交互全丢;第二条引入的运行时体量和端上包体积天然冲突。当前实现走第三条:markdown-it 只负责把文本切成 token,我们再把 token 翻译成受控的原生组件。
这篇的重点,是为什么保留结构比"一口气转成 HTML"更适合当前产品,以及如何让未知内容有清楚的降级方式。
我把它当成了阅读器的设计起点。对技术教程来说,代码不标语言不是装饰缺失——读者要判断这段代码属于哪个环境,要复制,还可能横向查看长行。
APP 侧可以用成熟的 Markdown 渲染库把整篇内容交给渲染器处理,小程序侧没有等价物。rich-text 能渲染一段受限的 HTML 字符串,却接不住“点击代码块复制原文”“点击链接走原生路由”“表格横向滚动”这些交互。
摆在面前的有三条路:用 rich-text 把 Markdown 直接转成 HTML 字符串;换一个能解析成虚拟 DOM 的库,再把节点映射到 Taro 组件;或者自己解析 token 建节点树。第一条最省事,但交互全部丢失;第二条引入的运行时体量和端上包体积天然冲突。当前实现走第三条——markdown-it 只负责把文本切成 token,我们再把 token 翻译成受控的原生组件。
这篇的重点,是为什么保留结构比“一口气转成 HTML”更适合当前产品,以及如何让未知内容有清楚的降级方式。
解析器负责理解,组件负责交互
解析器的三个开关都带着理由,不是随手抄来的初始化模板:
// src/core/markdown.ts:关闭原始 HTML,开启链接识别和软换行。
const md = new MarkdownIt({ html: false, linkify: true, breaks: true });
html: false 是关键的一条——它让 <script> 这类内容留在文本层,不会被解析成可执行节点。linkify: true 让裸写的 URL 自动成链接,作者不必手动包一层 []()。breaks: true 让单个换行按作者直觉断行,而不是必须空一行才分段。这三个默认值合起来,决定了后面节点会出现哪些种类。
解析结果分两部分:一棵 MdNode 树和一份标题清单。节点结构很薄,只保留渲染真正需要的字段:
// src/core/markdown.ts:节点只带渲染所需的字段,text 与 tag 供组件分派。
export interface MdNode {
type: string;
tag: string;
content: string;
attrs: Record<string, string>;
info: string;
children: MdNode[];
id?: string;
}
组件拿到 type 就分派,不需要在页面里重新用正则猜标题或链接。tag 保留原始标签名,让标题层级、列表这些结构还能按 Markdown 原意落到样式上;id 只在标题节点出现,供目录定位。
| 普通文字、强调、行内代码 | Text 与语义样式 | 文字可选择 |
| 围栏代码 | 语言头、复制、横向 ScrollView | 未识别语言转义后显示 |
| HTTP(S) 图片 | Image | 点击原生预览 |
| 链接 | 明确的 Button | 站内导航或外链复制 |
| 表格 | 横向 ScrollView 与表格样式 | 不压缩成无法读的窄列 |
| 标题与引用 | 带层级的 View | 标题可被目录定位 |
这不是完整实现所有 Markdown 插件。当前没有因为 AST 存在就自动获得数学公式、流程图或脚注交互。新增语法必须有对应解析、渲染与验证,不能只在样例中放一段字符。
节点树保留了嵌套关系
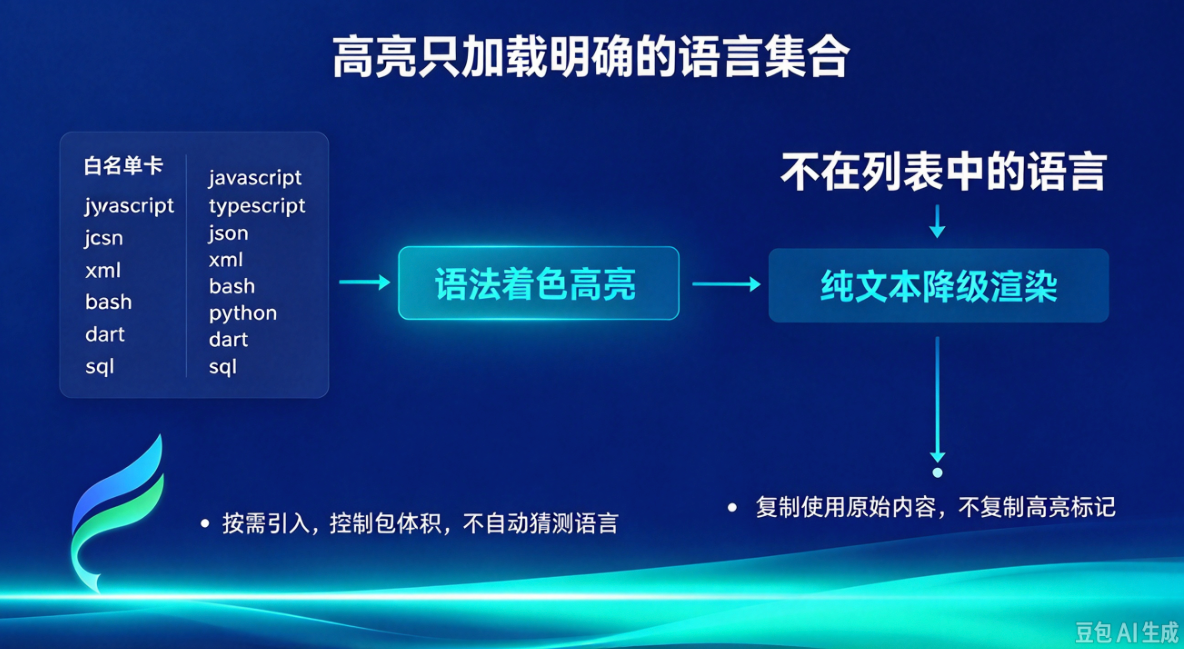
解析时用栈处理开始和结束 token。开始节点进入栈,结束节点弹出,子节点挂在当前父节点下。inline token 再递归处理自己的 children。核心循环不到二十行,但它决定了后面所有交互能不能成立:
// src/core/markdown.ts 的 tree() 节选,入栈与出栈决定父子关系。
const root: MdNode = { type: "root", tag: "", content: "", attrs: {}, info: "", children: [] },
stack = [root];
for (const token of list) {
if (token.nesting === –1) {
if (stack.length > 1) stack.pop();
continue;
}
const n: MdNode = {
type: token.type,
tag: token.tag,
content: token.content,
attrs: Object.fromEntries(token.attrs || []),
info: token.info,
children: token.children ? tree(token.children) : [],
};
if (token.type === "heading_open") {
n.id = `heading-${headings.length}`;
headings.push({ id: n.id, title: "", level: Number(token.tag.slice(1)) });
}
stack[stack.length – 1].children.push(n);
if (token.nesting === 1) stack.push(n);
}
这比把所有 token 平铺成文本更重要:加粗文字可以位于链接中,列表可以包含段落,引用里面可以继续有代码。丢掉嵌套之后,再想恢复交互就要重新猜结构。
标题节点分配 heading-0、heading-1 这样的顺序 ID(上一段代码里能看到登记 headings 的那几行),中文和重复标题不会因为文本相同撞 ID。真正需要单独处理的是标题的文本,它并不在开标签上:
// src/core/markdown.ts:标题文本由 inline 子内容拼回,不读开标签的 content。
if (token.type === "inline" && stack[stack.length – 1].type === "heading_open")
headings[headings.length – 1].title =
token.children?.map((t) => t.content).join("") || token.content;
heading_open 的 content 是空的。真正的文字落在紧随其后的 inline 子节点里,而且可能被拆成“文字 + 行内代码 + 文字”几段,所以要 join 拼回去。如果标题写成 ## 认识 `useEffect`,直接读 content 会得到空字符串,目录里那一条就会消失。这类问题不报错,只是让目录少一行——正是这种静默,让它值得单独写一段对照。
当前正文组件与目录都调用同一个 parseMarkdown 函数,但各自解析一次,不是共享同一个内存结果对象。共同算法确保对应关系;如果长文性能测量显示重复解析成本明显,可以提升一次解析结果的所有权。
高亮只加载明确的语言集合
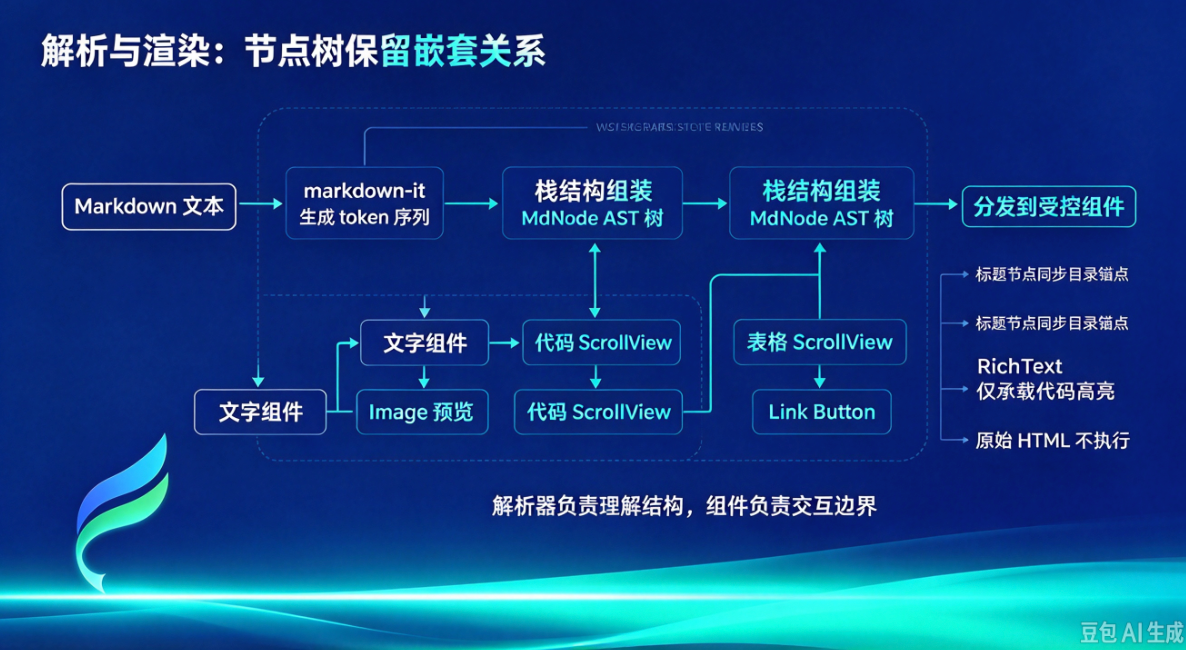
项目只注册九种语言定义,而不是整包引入 highlight.js:
// src/core/markdown.ts:逐个注册,把包体积控制在可预期的范围。
import javascript from "highlight.js/lib/languages/javascript";
// …typescript / json / css / xml / bash / python / dart / sql 按需 import…
for (const [name, language] of Object.entries({
javascript, typescript, json, css, xml, bash, python, dart, sql,
}))
hljs.registerLanguage(name, language);
highlight.js/lib/core 是精简内核,语言必须一个个 registerLanguage 才生效。这样做的好处是包体积可预期;代价是没注册的语言一律走纯文本分支,rust、go 这类会原样显示。库还附带一些别名(例如 js、ts),别名能识别不等于主名之外的都支持,不能把任意语言都算进来。
围栏第一段信息作为语言名,没有就显示 text:
const language = n.info.trim().split(/\\s+/)[0] || 'text';
不使用自动语言猜测,是为了减少意外和运行成本。文章作者标注 ts,读者就知道它的上下文;未知语言保留标签,同时以安全的普通代码显示。
复制按钮使用原始 n.content,而不是高亮后的 HTML。否则,读者会复制到 span 标签或实体编码。代码的展示表示和原始内容必须分开。
语言标签代表上下文,不代表执行能力
工具条默认插入 TypeScript 围栏,阅读器显示作者填写的语言标签。它不会执行代码,也不提供在线沙箱。用户看到 python,只说明内容上下文,不表示当前小程序安装了 Python。
已识别语言高亮、未知语言纯文本,是一个渐进降级选择。自动猜语言有时能给未标注代码加颜色,但也会猜错。教学文章更需要作者明确上下文,因此当前方案把标注责任留给内容。
高亮输出的颜色目前是定义好的 token 映射。它与主题变量不完全同一套系统,深色可读性要在具体样本上观察。以后若扩展语言,应一起评估包体与长代码解析成本,不能无限注册整库然后用一次构建成功替代性能检查。
受控 RichText,仍然要转义
未知语言先转义 &、<、>;已知语言通过 highlight.js 生成标记,再把高亮 class 转成受控颜色样式。输出只用于代码区域的 RichText。
// src/core/markdown.ts:未知语言转义后原样返回。
const escaped = code.replace(/&/g, "&").replace(/</g, "<").replace(/>/g, ">");
if (!language || !hljs.getLanguage(language)) return escaped;
高亮结果带的是 hljs-keyword 这类 class,而小程序 rich-text 接不住外部样式表,所以要把 class 换成内联 style:
// src/core/markdown.ts:把高亮 class 归到五个语义色,避免引入完整主题 CSS。
return hljs.highlight(code, { language, ignoreIllegals: true }).value
.replace(/class="([^"]+)"/g, (_, classes: string) => {
const color = /keyword|literal|built_in/.test(classes) ? "#b078c4"
: /string|attr/.test(classes) ? "#58a281"
: /number|symbol/.test(classes) ? "#cc8c55"
: /comment/.test(classes) ? "#8192a4" : "#6095ca";
return `style="color:${color}"`;
});
| keyword / literal / built_in | 关键字与内置名 | #b078c4 |
| string / attr | 字符串与属性 | #58a281 |
| number / symbol | 数字与符号 | #cc8c55 |
| comment | 注释 | #8192a4 |
| 其余 | 默认文字 | #6095ca |
这套色值写死在代码里,和主题变量不是同一套系统。好处是深浅色行为一致、无需额外样式表;代价是它不随主题走,主题大改时要回来一起看。ignoreIllegals 让不完整或写错的代码也能高亮而不抛错——阅读器展示的是快照,不该因为作者少打一个括号就整块变红。
这能让 <script> 作为代码文本出现,而不是被当成页面结构。关闭原始 HTML 和代码转义解决不同入口,不能省略任何一个。
而复制入口写回的是原始内容,不是带 span 的标记。两处一旦混用,读者拿到的就不是代码:
// src/features/markdown.tsx:复制按钮取 n.content,而非高亮后的 HTML。
<Button className="link" onClick={() => Taro.setClipboardData({ data: n.content })}>
复制
</Button>
但它也不是针对所有网络资源的安全认证。图片仍可能来自外部 HTTP(S) 地址,是否加载受网络和平台条件影响;链接需要统一路由规则。阅读器控制的是如何渲染和触发动作,不是证明所有来源都可信。
横向滚动是一种内容保护
长代码强行换行会改变对齐,表格挤进手机宽度会让列失去意义。因此,代码块和表格都套一层横向滚动容器,让正文保持纵向阅读:
// src/features/markdown.tsx:代码块局部横向滚动,复制按钮固定在标题栏。
<View className="code-block">
<View className="row between code-head">
<Text>{language}</Text>
<Button className="link" onClick={() => Taro.setClipboardData({ data: n.content })}>复制</Button>
</View>
<ScrollView scrollX>
<RichText
nodes={`<pre style="margin:0;white-space:pre;font-family:monospace">${highlight(n.content, language)}</pre>`}
/>
</ScrollView>
</View>
scrollX 只加在代码块这一层,外层的 .markdown 用 overflow-wrap:anywhere 兜底,保证整个页面不会横向溢出——否则目录浮动按钮、评论和底部操作都会跟着跑偏。代码内容用内联 white-space:pre 保留缩进,.code-body 的 min-width:100% 让短代码撑满宽度、长代码横向滚动而非换行。表格同理:.md-table 用 display:table 加 min-width:100%,每一列 min-width:150px,宁可让读者横向滑,也不把列压到不可读。
这种方案也有代价:读者需要发现横向区域,代码复制入口要稳定可见。所以我们把复制按钮固定在标题栏右侧,让它不跟着代码一起横向滚动。
图片使用 widthFix 保持比例,并限制非 HTTP(S) 来源的当前展示方式。链接通过统一 openLink,让一篇文章中的不同链接遵循相同平台边界,不由每个节点随意打开。
三层所有权,和它们各自的资源边界
原文、解析结果和显示节点各有所有权
Markdown 原文由后端内容字段提供,解析结果由阅读器生成,组件状态只处理当前交互。复制操作回到原文,目录依赖解析 ID,图片预览依赖受控 URL。把三层混合,后续编辑预览就容易出现两种内容定义。
当前预览复用 Markdown 组件,所以相同语法沿用同一解析行为。但编辑器只预览标题和正文,并非完整模拟公开文章页。封面、摘要、互动和推荐没有因为组件共享就全部进入预览。
受控渲染还有资源边界
一篇巨大文章仍可能消耗解析与节点渲染时间,大图片仍可能影响布局与网络。关闭 HTML 不会自动解决资源消耗。若未来实际数据变长,应先测解析、节点数量和图片加载,再考虑缓存解析结果或限制单次展示范围。
本次没有公布阅读器性能基准,因此文章不写“长文毫无压力”。我们已经有明确结构与验证入口,接下来可以依据真实测量优化,而不是靠库名证明表现。
图片与代码的失败不要阻断整篇文字
内容节点有自己的降级方式,未知语言仍能读,非支持图片来源保留文字。后续若增加图片失败占位,应针对具体节点处理,而不是让一张加载失败的图把全文替换成错误页。文章正文的连续性,比外围资源全部成功更重要。
回归样本检验嵌套,而不是每种语法各写一行
单独测试标题、链接与加粗都通过,仍可能在“标题里含行内代码”“链接里含强调”时出错。解析器的价值在于保留嵌套,回归样本也应该检验嵌套。
现有单元测试就压在这几个最容易出错的地方——同一份输入里同时放两个同名标题、一段 <script> 和一个未知语言代码块:
// test/core.test.ts:目录唯一、HTML 不执行、未知语言转义。
const parsed = parseMarkdown(
"# 标题\\n## 标题\\n<script>alert(1)</script>\\n```typescript\\nconst a = 1\\n```",
);
assert.deepEqual(parsed.headings.map((h) => h.id), ["heading-0", "heading-1"]);
assert.equal(parsed.nodes.some((n) => n.type === "html_block"), false);
assert.ok(highlight("const a = 1", "typescript").includes("style="));
assert.equal(highlight("<script>", "unknown"), "<script>");
四条断言恰好覆盖四个争议点:两个同名标题拿到不同 ID;关闭 HTML 后 html_block 节点根本不存在;已知语言产出带 style 的高亮;未知语言把尖括号转义成实体。这比每种语法写一行更接近真实文章——同一段内容里,几种结构本来就是同时出现的。
更完整的样本(引用中的列表、列表里的链接、多列表格)仍在人工回归清单上,属于建议矩阵,尚未做成自动化用例。
验证拿真实文章说话
开发工具里实际阅读过 M3-24,观察了表格、TypeScript/TSX 代码与目录跳转;逻辑测试验证解析和高亮相关行为。它们能证明当前样本,不能覆盖所有语法组合和所有设备布局。
后续回归应固定一份综合样本:中文重复标题、嵌套列表、未知语言、包含尖括号的代码、长表格和坏链接。尤其要确认复制得到原文,而非渲染标记。这是一份建议矩阵,不是补写出来的既有验收结果。
更多阅读行为见目录、上下篇与外链路由,编辑预览见 Markdown 投稿编辑器。解析与渲染边界清楚后,同一份内容才能在阅读和创作之间保持一致。
延伸阅读
- 首页、分类与搜索:把内容发现做成可恢复的数据流
- 文章详情:Markdown、代码高亮与目录必须共享解析结果
- Markdown 编辑器:预览、暗色主题与连续图片粘贴
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer


评论前必须登录!
注册