 网硕互联帮助中心
上一篇我们讨论了单体与微服务的区别,也明确了 Service 和 Instance 的关系。
将一个应用拆分成多个服务之后,原来在同一个进程内完成的业务操作,现在可能需要跨越不同的服务器、容器甚至数据中心。
例如,用户创建一个订单,Order Service 需要请求 Inventory Service 预留库存。
这时候问题就出现了:
Order Service 怎么调用 Inventory Service?如果库存服务有多个实例,应该调用哪一个?如果实例重启,IP 地址发生变化怎么办?又为什么需要 Gateway、Nacos 或 Envoy?
这些问题看似对应不同组件,实际上都围绕一个核心目标:
让分布在不同位置的服务能够找到彼此、完成通信,并且在实例变化和网络异常时保持可控。
一、从一次普通方法调用说起
先看单体架构中的订单创建。
假设订单和库存是两个业务模块,但都运行在同一个 Java 应用中。
public Order createOrder(OrderRequest request) {
inventoryService.reserveStock(
request.getProductId(),
request.getQuantity()
);
return orderRepository.save(request);
}
这里的 inventoryService.reserveStock() 本质上是一次进程内方法调用。
调用方通常不需要考虑目标模块运行在哪台服务器,也不需要处理网络连接、服务发现等问题。
但如果将订单与库存拆成两个独立服务:
Order Service
|
| 网络请求
v
Inventory Service
情况就不同了。
两个服务可能运行在不同机器上,拥有不同的进程空间。
Order Service 无法直接执行另一个进程里的 Java 方法,而是需要通过网络发送请求。
一次远程调用至少涉及以下过程:
Order Service
|
| 1. 构造请求
v
网络传输
|
| 2. 到达目标服务
v
Inventory Service
|
| 3. 执行业务逻辑
v
生成响应
|
| 4. 通过网络返回
v
Order Service
这里最值得注意的,不是网络调用比本地方法调用慢多少,而是它引入了新的失败可能。
例如:
- 请求可能根本没有到达下游。
- 请求可能已经执行成功,但响应在返回途中丢失。
- 目标实例可能在处理过程中崩溃。
- 网络可能短暂不可用,导致调用超时。
尤其是第二种情况。
假设库存已经预留成功,但响应丢失,Order Service 最终只收到了 Timeout。
它无法单凭超时判断库存是否预留成功。
所以,远程调用与本地调用最本质的区别,不仅是多了网络开销,更是调用方需要处理不确定的执行结果。
在理解这一点之后,我们再看具体的通信技术。
二、HTTP、REST 和 RPC 到底是什么关系?
微服务通信中,经常会听到 HTTP、REST、RPC 和 gRPC。
这些名词很容易被放在一起比较,但它们并不属于完全相同的层次。
HTTP 是一种应用层通信协议。
REST 是一种围绕资源组织接口的架构风格,通常通过 HTTP 实现。
RPC(Remote Procedure Call,远程过程调用)则是一种通信抽象:让调用远程服务的过程看起来接近调用一个方法。
gRPC 是 RPC 框架的一种具体实现。
因此,HTTP 和 RPC 不是天然对立的技术,RPC 也可以基于 HTTP 实现。
1. 使用 HTTP/REST 通信
假设 Inventory Service 提供库存预留能力。
一种 REST 风格的接口可以是:
POST /inventory/reservations
Content-Type: application/json
请求体:
{
"request_id": "R10001",
"product_id": 888,
"quantity": 2
}
Inventory Service 接收到请求后,完成库存预留并返回:
{
"reservation_id": "RES10001",
"status": "RESERVED"
}
这里的 reservations 表示库存预留资源。
Order Service 通过 HTTP 向库存服务提交创建预留资源的请求。
REST 风格的接口强调资源及其操作,例如:
GET /orders/10001
POST /orders
GET /inventory/reservations/RES10001
DELETE /inventory/reservations/RES10001
这类方式的优势在于接口直观、生态成熟,调试和跨语言集成都比较方便。
但 HTTP/JSON 并不自动意味着接口设计合理。
例如,接口仍然可能存在超时、重复提交、错误码不统一和版本兼容问题。
这些问题需要服务自身处理。
2. 使用 RPC 通信
如果采用 RPC,我们可能希望 Order Service 直接调用一个远程方法:
InventoryService.Reserve()
在 gRPC 中,可以使用 Protocol Buffers 定义服务接口。
例如:
syntax = "proto3";
service InventoryService {
rpc Reserve(ReserveRequest) returns (ReserveResponse);
}
message ReserveRequest {
string request_id = 1;
int64 product_id = 2;
int32 quantity = 3;
}
message ReserveResponse {
string reservation_id = 1;
string status = 2;
}
定义好接口后,可以生成客户端和服务端所需的代码。
于是,调用方在业务代码中可以使用类似方法调用的方式:
ReserveResponse response =
inventoryStub.reserve(request);
但这里必须明确:
写法类似本地方法,不代表它真的变成了本地调用。
底层仍然需要完成序列化、网络传输和远程执行。
gRPC 通常使用 Protocol Buffers 作为接口定义和消息编码方式,并基于 HTTP/2 提供通信能力。
它比较适合内部服务之间具有明确契约、调用频繁、需要跨语言代码生成的场景。
此外,gRPC 还支持流式通信,不局限于普通的一问一答。
3. HTTP/REST 和 gRPC 怎么选?
可以从以下几个角度理解:
| 接口设计 | 通常围绕资源与 HTTP 方法 | 通常围绕服务方法 |
| 数据格式 | 常见 JSON | 常见 Protobuf |
| 接口契约 | OpenAPI 等方式描述 | Protobuf 定义 |
| 客户端集成 | 浏览器与通用 HTTP 客户端较方便 | 通常使用生成的客户端 |
| 流式通信 | 需要搭配相应机制 | 原生支持多种流式模式 |
| 典型场景 | 对外 API、通用业务接口 | 内部服务通信、强类型接口 |
有一点需要特别说明:
不能简单认为 gRPC 一定比 HTTP 接口快。
实际性能受到消息大小、连接复用、业务逻辑、网络环境和具体实现方式影响。
如果一个接口本身需要执行 200ms 的数据库查询,那么把 HTTP/JSON 改成 gRPC,并不会自动解决数据库慢的问题。
协议选型应该考虑系统需求,而不是单纯比较某个理论性能指标。
三、同步调用和异步通信,解决的是另一个问题
前面讨论 HTTP/REST 和 gRPC,主要是在比较通信方式和接口抽象。
但还有一个经常被混淆的维度:
同步与异步。
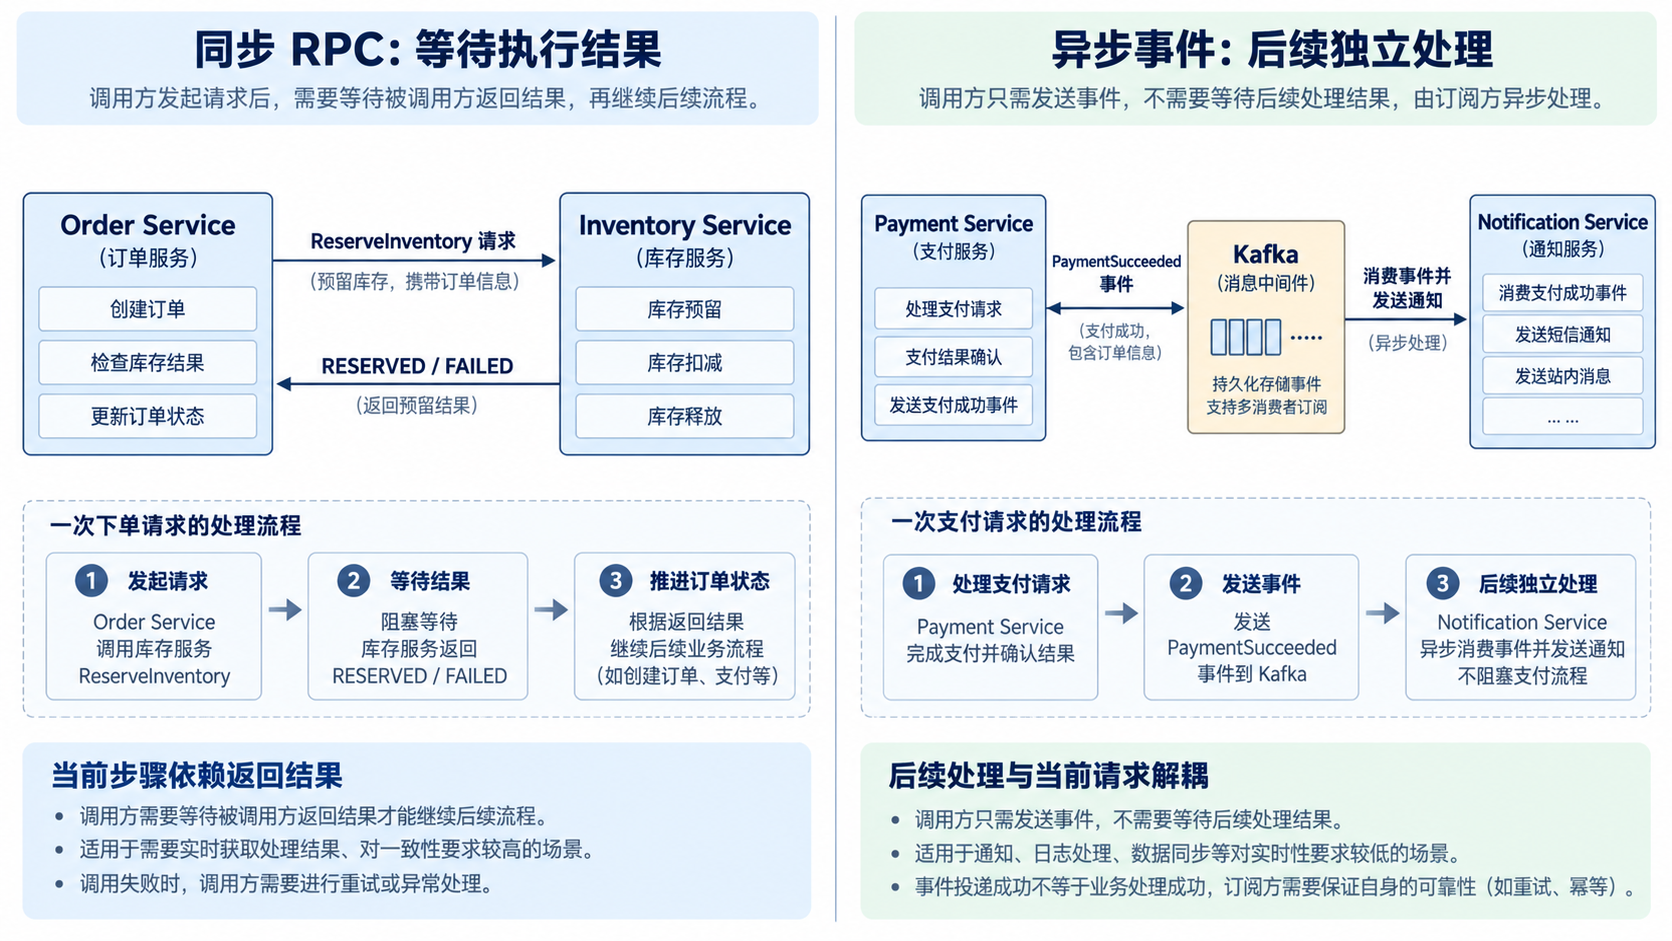
假设用户提交订单,Order Service 必须知道库存是否预留成功,才能决定是否进入等待支付状态。
一种实现方式是:
Order Service
|
| ReserveInventory
v
Inventory Service
|
| RESERVED / FAILED
v
Order Service
Order Service 等待预留结果,然后推进订单状态。
这是典型的同步请求—响应模式。
不过,同步调用并不意味着必须使用阻塞线程,也不代表只能采用 HTTP/REST。gRPC 同样可以用于同步请求—响应,HTTP 客户端也可以使用异步 I/O。
这里说的同步,主要强调业务流程需要等待结果。
再看另外一个场景。
用户支付成功后,系统还需要发送短信通知。
如果 Payment Service 同步调用 Notification Service:
Payment Service
|
v
Notification Service
|
v
短信平台
那么短信平台变慢,就可能增加支付请求的响应时间。
但实际上,通知是否立即发出,通常不应该影响已经确认的支付结果。
因此可以改为:
Payment Service
|
| PaymentSucceeded 事件
v
Kafka
|
v
Notification Service
|
v
发送短信
Payment Service 发布支付成功事件后,不需要同步等待短信发送完成。
Notification Service 则根据自己的处理能力消费消息。
这里的 Kafka 不是 RPC 框架的替代品,而是承担了不同的职责。
同步调用关注的是:
当前业务步骤需要什么结果?
异步消息关注的是:
某件事情已经发生,其他业务能力是否需要随后处理?
当然,异步化也会引入消息延迟、重复消费和可靠投递等问题,并不是用了 Kafka 就自动解决这些问题。
关于 Partition、Offset 和 Consumer Group,我们会在 Kafka 专题中单独讨论。
四、服务发现:Order Service 怎么知道 Inventory Service 在哪里?
现在假设我们使用 gRPC 调用库存服务。
一开始,Inventory Service 只有一个实例:
Inventory Service
|
192.168.1.10:9000
Order Service 可以直接通过 IP 和端口调用它。
但实际微服务通常不会只有一个实例。
例如:
Inventory Service
|
+– 192.168.1.10:9000
|
+– 192.168.1.11:9000
|
+– 192.168.1.12:9000
当某个实例重启、故障或者扩容时,这些地址可能发生变化。
如果 Order Service 把目标 IP 全部写死在代码中,维护成本会很高。
所以我们希望它只需要知道:
inventory-service
而不需要知道每个实例的具体 IP。
这就是 Service Discovery(服务发现)要解决的问题。
1. 通过注册中心实现服务发现
以 Nacos、Consul 这类服务注册与发现方案为例。
一个典型流程是:
Inventory Instance 1 ──┐
Inventory Instance 2 ──┼──> Registry
Inventory Instance 3 ──┘
|
服务实例列表
|
v
Order Service
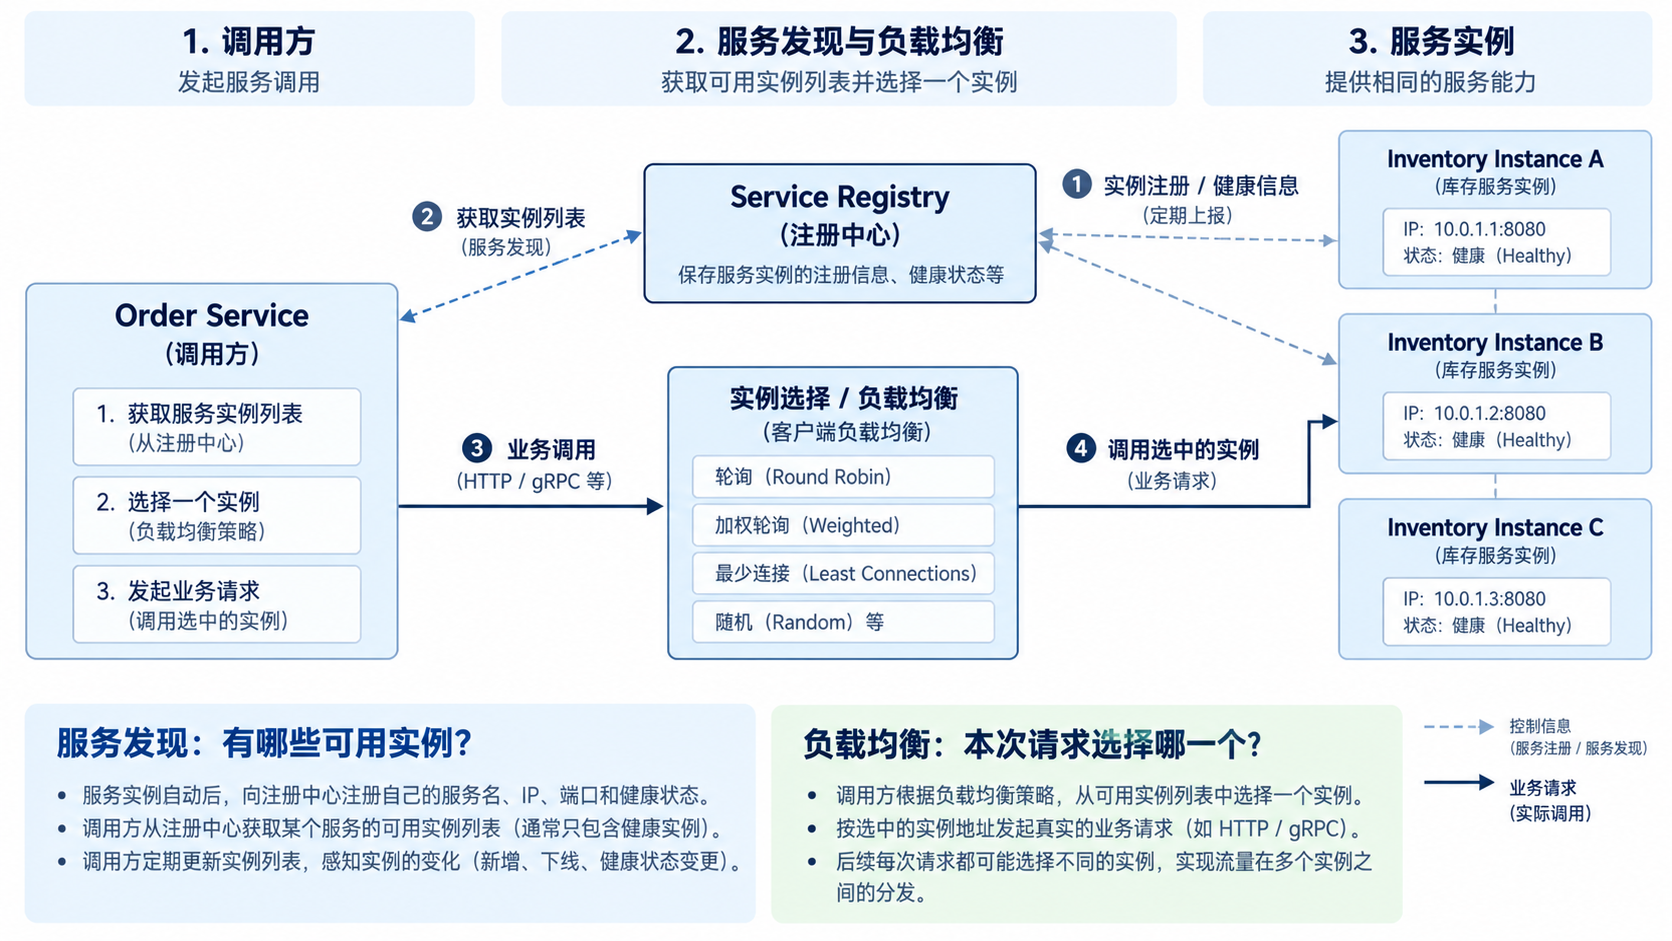
库存服务实例启动后,按照配置注册自己的服务名称和网络地址。
Order Service 需要调用库存服务时,可以通过注册中心获取可用实例信息。
例如:
inventory-service
|
+– 192.168.1.10:9000
+– 192.168.1.11:9000
+– 192.168.1.12:9000
当实例上线、下线或者健康状态发生变化时,注册中心可以更新相应信息。
但这里容易产生一个误解:
注册中心通常不是每一次业务请求都必须经过的转发节点。
在常见的客户端服务发现模式中:
Order Service
|
| 查询/订阅实例信息
v
Registry
Order Service
|
| 直接发送业务请求
v
Inventory Instance
注册中心负责提供服务位置,真正的业务流量可以由调用方直接发送给目标实例。
换句话说:
注册中心负责告诉你“服务在哪里”,不一定负责替你转发每一次请求。
2. Kubernetes 也能实现服务发现吗?
可以,而且这是 Kubernetes 很重要的一项能力。
假设库存服务运行在 Kubernetes 中:
Inventory Deployment
|
+– Pod 1
+– Pod 2
+– Pod 3
我们可以创建一个 Kubernetes Service:
apiVersion: v1
kind: Service
metadata:
name: inventory–service
spec:
selector:
app: inventory
ports:
– port: 9000
targetPort: 9000
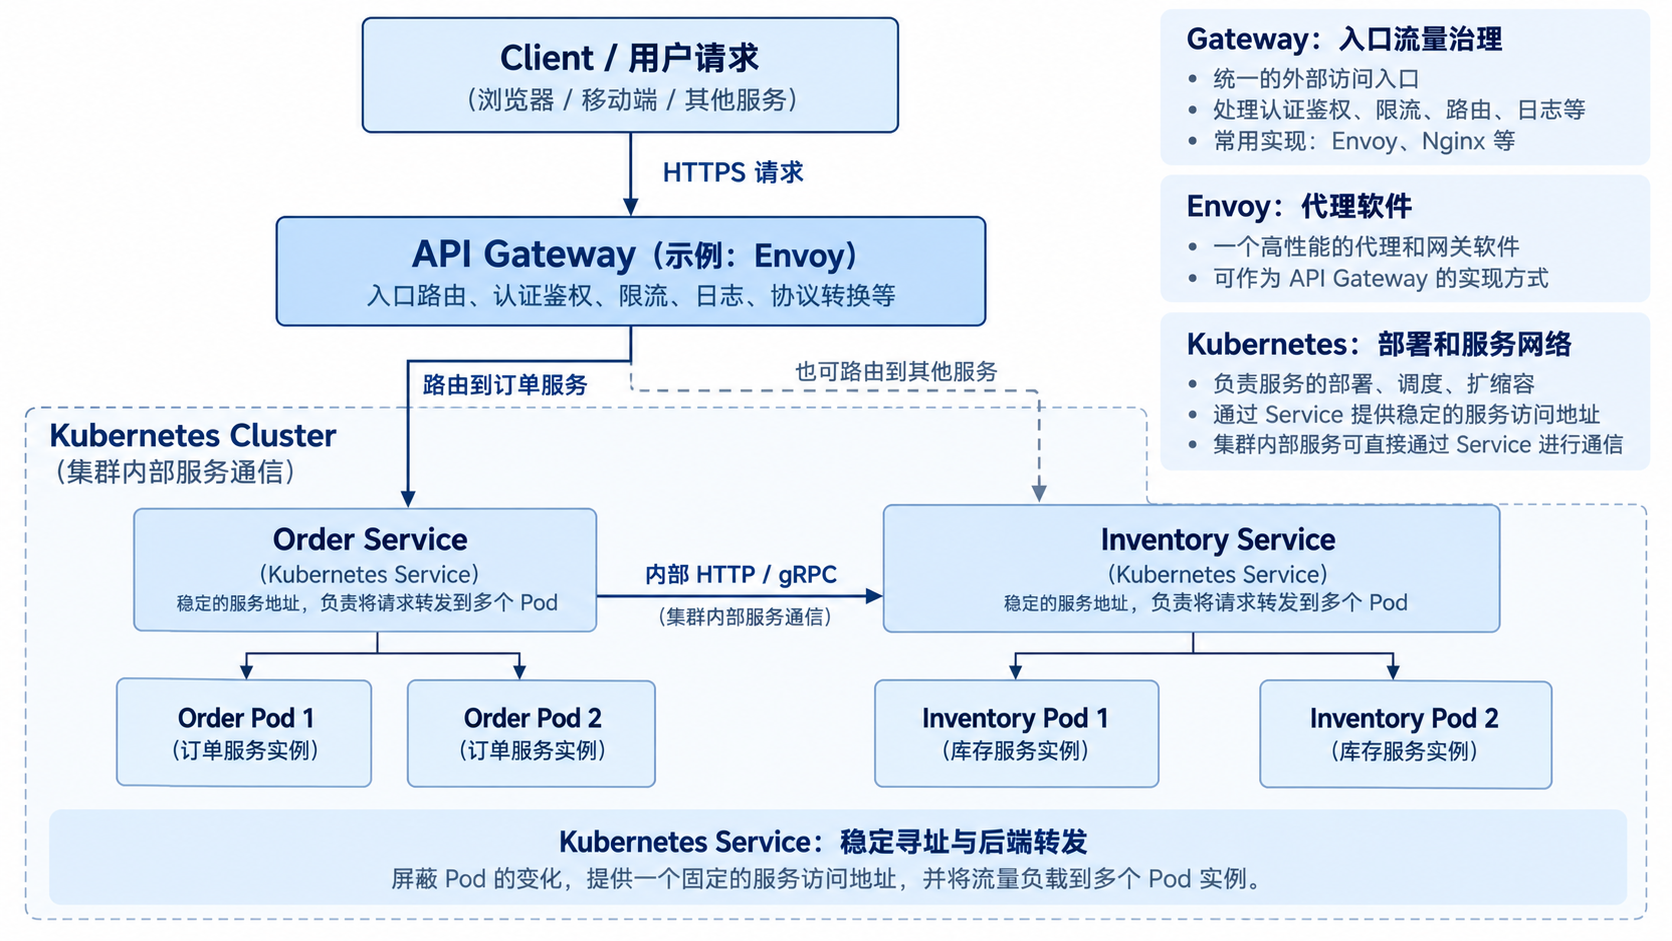
这个 Service 提供一个稳定的访问入口。
集群内其他服务可以通过 DNS 名称访问它:
inventory-service
在完整域名形式下,例如:
inventory-service.default.svc.cluster.local
这里假设它位于 default 命名空间,并使用常见的集群域名配置。
当 Order Service 发起请求时,可以使用:
inventory-service:9000
而不需要关心背后具体是哪一个 Pod。
Kubernetes 会维护与 Service 关联的 EndpointSlice 信息,其中包含符合条件的后端网络端点。
对于普通的 ClusterIP Service,DNS 通常解析到稳定的服务虚拟 IP,再由服务代理或相应数据平面机制把流量转发给后端 Pod。
所以这里应该区分:
Service DNS
|
提供稳定的服务访问名称
|
v
Service 虚拟入口
|
流量转发
|
v
后端 Pod
而不是理解成每次 DNS 查询都会返回三个 Pod 的 IP。
这也说明:
Kubernetes 已经提供了一套服务发现和访问机制。
如果所有服务都运行在 Kubernetes 内,并且需求比较简单,不一定还需要单独引入 Nacos 作为服务注册中心。
但 Nacos 也可能承担配置管理、跨环境服务治理等其他职责,是否使用仍然取决于具体系统。
五、负载均衡:找到服务之后,怎么选择实例?
服务发现解决了“有哪些实例可以访问”的问题。
但假设 Inventory Service 有三个实例:
Instance A
Instance B
Instance C
Order Service 发起一个库存查询,应该选择谁?
这就需要 Load Balancing(负载均衡)。
从概念上讲,负载均衡主要负责:
在多个可用实例之间分配请求或连接。
常见策略包括轮询、加权分配、最少连接和基于负载的选择等。
不过,具体支持哪些策略,取决于负载均衡组件和实现方式。
1. 客户端负载均衡
一种方式是由调用方自己选择目标实例。
例如:
Registry
|
实例列表
|
v
Order Service
|
选择实例 B
|
v
Inventory B
这种方式通常称为客户端负载均衡。
它的特点是客户端掌握实例信息,并在发送请求前进行选择。
2. 服务端负载均衡
另一种方式是调用方只访问一个稳定入口,由中间的代理或负载均衡组件完成分配。
Order Service
|
v
Load Balancer
|
+–+–+
| | |
v v v
A B C
Kubernetes Service 就可以提供这种稳定入口和后端流量分发能力。
但也要注意,Kubernetes Service 的常见转发主要工作在连接/传输层,并不一定具有高级 HTTP 请求级负载均衡的所有能力。
例如,对于长时间保持的 gRPC 连接,多个请求可能复用同一个连接,因此请求未必均匀分配到所有 Pod。
如果需要更细粒度的请求级路由、动态权重或者故障实例摘除,可以考虑 Envoy 等具备更丰富流量治理能力的代理。
3. 负载均衡不是平均分配就万事大吉
假设三个实例分别处理请求:
Instance A:正常
Instance B:响应很慢
Instance C:正常
如果仍然不断把流量分配给 B,就可能导致部分请求持续变慢。
所以真实负载均衡系统还需要考虑健康状态、就绪探针、故障摘除和恢复等机制。
此外,负载均衡也不能保证业务数据正确。
例如三个库存实例共同修改同一个 MySQL 库存记录,增加服务实例数量并不会自动解决数据库层面的库存并发冲突。
这里要再次分清两个问题:
负载均衡负责把请求交给合适的实例。
数据库事务、幂等和状态机负责保证业务操作的正确性。
六、Gateway:既然服务之间能直接通信,为什么还需要网关?
现在我们的 Order Service 已经可以找到 Inventory Service,也知道如何选择实例了。
但还有一个问题:
用户的请求应该从哪里进入系统?
假设电商平台有:
User Service
Order Service
Product Service
Payment Service
如果客户端直接访问每个服务:
Client
|
+– User Service
+– Order Service
+– Product Service
+– Payment Service
那么客户端可能需要了解每个服务的访问地址和接口。
各个服务还可能分别实现鉴权、跨域处理、入口限流和访问日志。
这就增加了系统维护成本。
所以我们可以在外部客户端与内部服务之间增加统一入口。
Client
|
v
API Gateway
|
+———–+———–+
| | |
v v v
User Order Product
Service Service Service
这就是 API Gateway(API 网关)的典型位置。
Gateway 主要负责什么?
常见职责包括:
请求路由
例如:
/api/users/** → User Service
/api/orders/** → Order Service
/api/products/** → Product Service
统一认证与入口控制
网关可以验证 Token、执行通用身份认证与访问策略,并把经过校验的身份信息传递给后端。
但这不意味着后端服务可以完全放弃业务权限校验。
例如用户是否有权取消某笔订单,通常仍然需要 Order Service 根据订单归属和业务状态进行判断。
限流
例如网关可以对某个接口设置速率限制,防止过量请求直接进入后端。
流量治理与可观测性
根据具体实现,网关还可以承担 TLS 终止、请求转发、灰度路由、统一访问日志等职责。
不过需要注意,网关不是所有业务逻辑的集中处理中心。
如果把订单创建、库存判断和支付业务都写在网关里,反而会让网关成为一个新的单体应用。
内部服务通信是否都要经过 Gateway?
通常不需要。
假设:
Client
|
v
Gateway
|
v
Order Service
|
v
Inventory Service
Gateway 主要负责客户端到系统内部的入口流量。
Order Service 到 Inventory Service 则可以通过内部服务发现和 RPC 直接调用。
否则,如果所有内部调用都强制经过同一个入口网关,会增加不必要的网络路径和中心化依赖。
当然,某些系统会配置内部网关或者专门的东西向流量代理,但这与外部 API Gateway 的职责并不完全相同。
七、Kubernetes、Gateway API 和 Envoy 到底是什么关系?
这一部分很容易混淆,因为三个概念经常一起出现。
先明确:
Kubernetes 是容器编排平台。
Gateway 是流量入口或网关的逻辑角色。
Envoy 是能够承担网关、反向代理和服务间通信代理职责的软件。
它们不是同一种东西。
1. Kubernetes 不等于 Gateway
Kubernetes 能部署和管理各种应用,包括网关程序。
但 Kubernetes 本身不是一个用于处理所有 HTTP 业务路由和认证逻辑的单独网关程序。
例如,我们可以在 Kubernetes 中部署一个 Envoy 网关,由它接收外部请求并转发给后端服务。
2. Gateway API 是配置模型
Kubernetes Gateway API 提供了描述网关和路由需求的 API 资源。
其中典型的资源包括:
GatewayClass
|
v
Gateway
|
v
HTTPRoute
|
v
Backend Service
这组结构主要描述:
- 由哪类网关实现负责管理。
- 网关在哪里接收流量。
- 根据什么规则把请求转发到哪些后端服务。
但是:
Gateway API 不是负责实际转发网络数据包的程序。
实际流量处理仍然需要相应的控制器和数据平面实现。
3. Envoy 可以作为实际的流量代理
Envoy 是高性能代理软件,可以承担七层 HTTP 路由、负载均衡、TLS、部分限流与熔断等功能。
例如:
Client
|
v
Envoy Gateway
|
+– /api/orders → Order Service
|
+– /api/products → Product Service
但 Envoy 不只能部署在系统入口。
在 Service Mesh 场景中,Envoy 或其他流量代理还可以部署在服务附近,处理内部服务之间的通信。
因此:
Envoy 是一种实现技术,Gateway 是一种架构职责。
同样,Spring Cloud Gateway 也可以承担 API Gateway 的职责,只是实现方式不同。
如果只是一般的微服务系统,不应该因为已经用了 Kubernetes,就认为一定还要使用 Istio、Envoy Sidecar 或完整的 Service Mesh。
这些组件的价值,需要结合流量治理复杂度、团队运维能力和实际需求判断。
八、配置中心又是用来解决什么问题的?
到这里,我们已经介绍了服务之间怎么通信、怎么找到实例以及怎么转发流量。
但是微服务还有一个容易被忽视的问题:配置管理。
假设 Order Service 需要配置:
inventory:
timeout-ms: 1000
order:
max-retries: 2
如果系统有十个服务,每个服务都有测试、预发布和生产环境,那么配置文件会越来越多。
一些配置还可能需要在不同环境使用不同取值。
例如:
开发环境:
Inventory Service → 测试地址
生产环境:
Inventory Service → 生产地址
如果这些配置全部硬编码在应用中,每次修改都要重新构建程序,维护成本就会不断上升。
所以我们需要将配置与代码分离。
1. 配置中心的作用
例如使用 Nacos 或 Spring Cloud Config,可以集中管理不同服务、不同环境所需的配置。
Config Center
|
+———–+———–+
| | |
v v v
Order User Payment
Service Service Service
服务在启动时或运行过程中,根据机制获取对应配置。
这就是配置中心主要解决的问题:
应用运行参数如何统一管理和分发。
要注意,配置中心与服务注册中心是两个不同职责。
注册中心关心:
Inventory Service
当前有哪些可用实例?
配置中心关心:
Order Service
超时时间和重试次数是多少?
Nacos 可以同时提供这两类能力,但不能因此认为服务发现和配置管理是同一件事。
2. Kubernetes 自身也有配置能力
如果服务全部运行在 Kubernetes 中,可以使用:
ConfigMap
Secret
来管理普通配置和敏感信息。
例如:
ConfigMap
|
v
Order Service
不过需要特别注意:
配置发生变化后,应用能否自动感知并生效,与配置的注入方式和应用程序是否支持动态重新加载有关。
例如通过环境变量注入的配置,通常不会因为 ConfigMap 修改就自动更新进程中的环境变量。
另外,Secret 不等于完整的密钥管理和安全方案,仍然需要正确设置访问权限、存储保护和轮换策略。
所以是否再引入专门的配置中心,仍然取决于配置规模、动态更新需求和运维环境。
九、把这些组件放回一次完整的请求中
前面讨论了很多技术,现在把它们放回真实调用过程。
假设用户创建订单:
POST /api/orders
整个流程可以分成五步。
第一步:客户端请求进入 Gateway。
Client
|
v
Gateway
Gateway 可以先完成通用鉴权、限流和路径路由。
第二步:Gateway 将请求转发给 Order Service。
Gateway
|
v
Order Service
如果 Order Service 有多个实例,网关或底层服务网络会根据相应的负载均衡机制选择后端。
第三步:Order Service 调用 Inventory Service。
Order Service
|
| ReserveInventory
v
Inventory Service
这里可以使用 HTTP/REST 或 gRPC。
Order Service 不需要把某个 Pod IP 写死,而是通过服务发现和稳定访问入口调用库存服务。
第四步:Inventory Service 执行库存预留。
Inventory Service
|
v
Inventory DB
|
v
返回预留结果
如果成功,Order Service 可以继续推进订单状态。
如果失败,则按业务规则返回库存不足等结果。
如果发生 Timeout,则不能直接认定库存预留失败,而应根据请求 ID 查询或者安全恢复。
第五步:返回订单受理结果。
Order Service
|
v
Gateway
|
v
Client
如果后续订单状态发生变化,并且需要通知其他服务,可以再通过 Kafka 发布相应的业务事件。
所以完整系统中,不同组件实际上承担不同职责:
| HTTP/REST | 如何以 HTTP 资源接口进行通信 |
| RPC/gRPC | 如何定义并执行远程服务调用 |
| Kafka | 如何进行异步消息与事件传递 |
| 服务发现 | 如何找到可访问的服务 |
| 负载均衡 | 如何将流量分配到多个实例 |
| API Gateway | 外部请求如何统一进入系统 |
| Envoy | 如何实现流量代理和治理 |
| 配置中心 | 服务运行配置如何管理 |
| Kubernetes | 服务实例如何部署、管理和提供稳定的集群网络入口 |
这些能力之间有联系,但并不能互相替代。
例如,Gateway 可以提供入口路由,却不能自动解决数据库事务问题;服务发现可以找到库存实例,却不能保证库存预留一定成功;gRPC 提供远程调用能力,也不会让网络超时消失。
十、总结:通信技术不是越多越好
微服务从单体拆分出来后,最直接的变化就是原来的进程内调用变成了跨进程、跨网络的服务通信。
围绕这个变化,才逐渐出现了 RPC、服务发现、负载均衡和 Gateway 等配套机制。
回头看,这些技术其实分别在回答几个简单的问题。
服务之间如何交换信息?
可以选择 HTTP/REST、gRPC 或异步消息机制。
调用方如何找到目标服务?
依靠服务注册发现、DNS 或平台提供的服务网络能力。
目标服务有多个实例时,怎么选择?
依靠负载均衡机制。
外部请求怎样统一进入系统?
通过 API Gateway 等入口组件。
服务运行时的配置放在哪里?
通过配置文件、Kubernetes ConfigMap/Secret 或专门的配置管理方案。
理解这些问题之后,就没有必要把每个框架都当成必选组件。
例如,一个全部运行在 Kubernetes 中的系统,完全可能使用:
外部请求:
Gateway → Service
内部通信:
HTTP / gRPC → Kubernetes Service
服务发现:
Kubernetes DNS
配置管理:
ConfigMap / Secret
而不单独引入 Nacos。
另一个系统则可能采用 Spring Cloud、Nacos、Gateway 和 Kafka 的组合。
它们只是不同的工程实现,并不存在统一适用于所有项目的最佳技术栈。
真正重要的不是掌握多少通信框架,而是能区分每个组件所解决的问题,以及引入它以后会增加哪些复杂度。
下一篇会进一步学习 Docker 与 Kubernetes,重点理解容器、Pod、Deployment、Service 和 HPA 的关系,以及微服务究竟是如何运行和扩容的。


评论前必须登录!
注册