 网硕互联帮助中心
目录
- 1. C++介绍
- 2. C++发展历史
- 2.1 C++版本更新
- 2.2 关于C++23的一个小故事
- 3. C++参考文档
- 4. C++的重要性
- 5. C++学习建议和书籍推荐
- 6. C++的第一个程序
- 7. 命名空间
- 8. C++输入&输出
- 9. 缺省参数
- 10. 函数重载
- 11. 引用
- 12. inline
- 13. nullptr
1. C++介绍
C++包含哪些部分:C++语法、STL、高阶数据结构
2. C++发展历史
C++的起源可以追溯到1979年,当时Bjarne Stroustrup(本贾尼·斯特劳斯特卢普,这个翻译的名字不同的地方可能有差异)在贝尔实验室从事计算机科学和软件工程的研究工作。面对项目中复杂的软件开发任务,特别是模拟和操作系统的开发工作,他感受到了现有语言(如C语言)在表达能力、可维护性和可扩展性方面的不足。
1983年,Bjarne Stroustrup在C语言的基础上添加了面向对象编程的特性,设计出了C++语言的雏形,此时的C++已经有了类、封装、继承等核心概念,为后来的面向对象编程奠定了基础。这一年该语言被正式命名为C++。
在随后的几年中,C++在学术界和工业界的应用逐渐增多。一些大学和研究所开始将C++作为教学和研究的首选语言,而一些公司也开始在产品开发中尝试使用C++。这一时期,C++的标准库和模板等特性也得到了进一步的完善和发展。
C++的标准化工作于1989年开始,并成立了一个ANSI和ISO(International Standards Organization)国际标准化组织的联合标准化委员会。1994年标准化委员会提出了第一个标准化草案。在该草案中,委员会在保持斯特劳斯特卢普最初定义的所有特征的同时,还增加了部分新特征。
在完成C++标准化的第一个草案后不久,STL(Standard Template Library)是惠普实验室开发的一系列软件的统称。它是由Alexander Stepanov、Meng Lee和David R Musser在惠普实验室工作时所开发出来的。在通过了标准化第一个草案之后,联合标准化委员会投票并通过了将STL包含到C++标准中的提议。STL对C++的扩展超出C++的最初定义范围。虽然在标准中增加STL是个很重要的决定,但也因此延缓了C++标准化的进程。
1997年11月14日,联合标准化委员会通过了该标准的最终草案。1998年,C++的ANSI/ISO标准被投入使用。
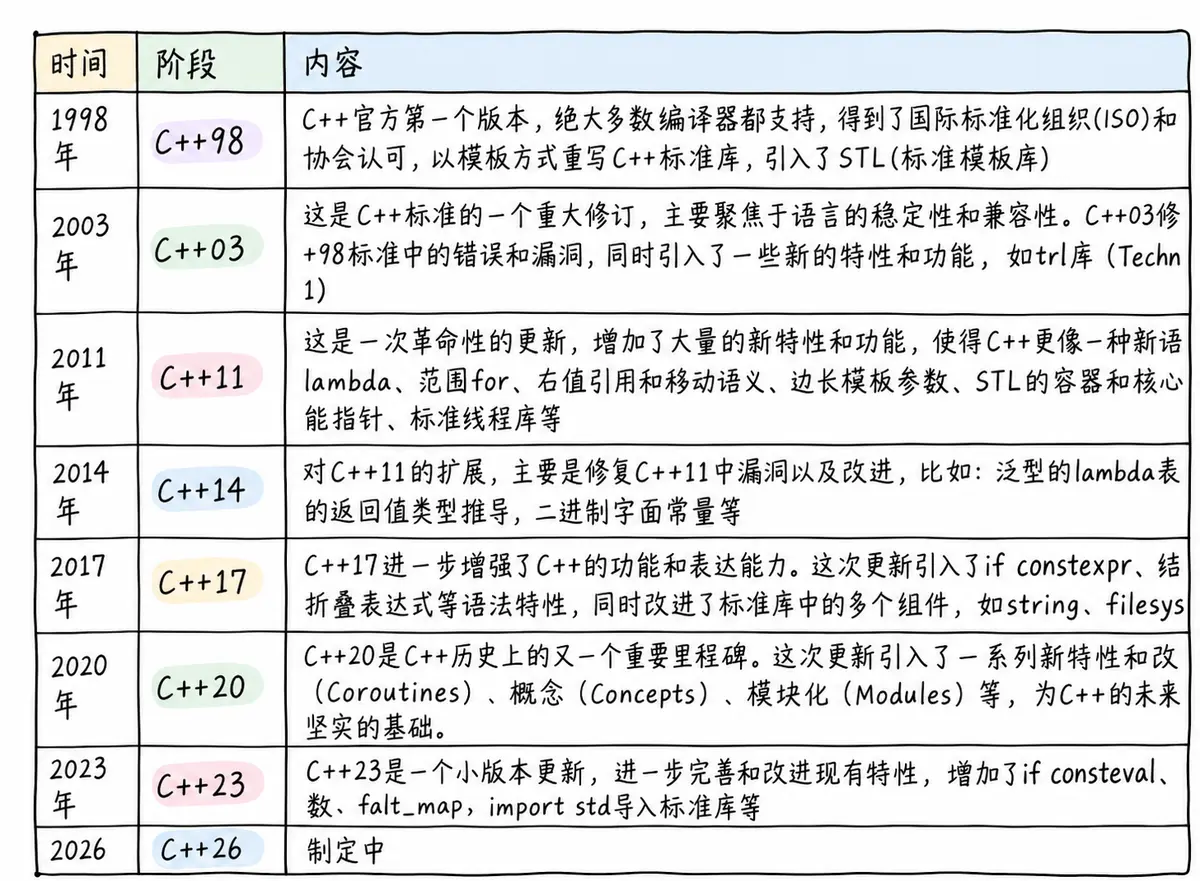
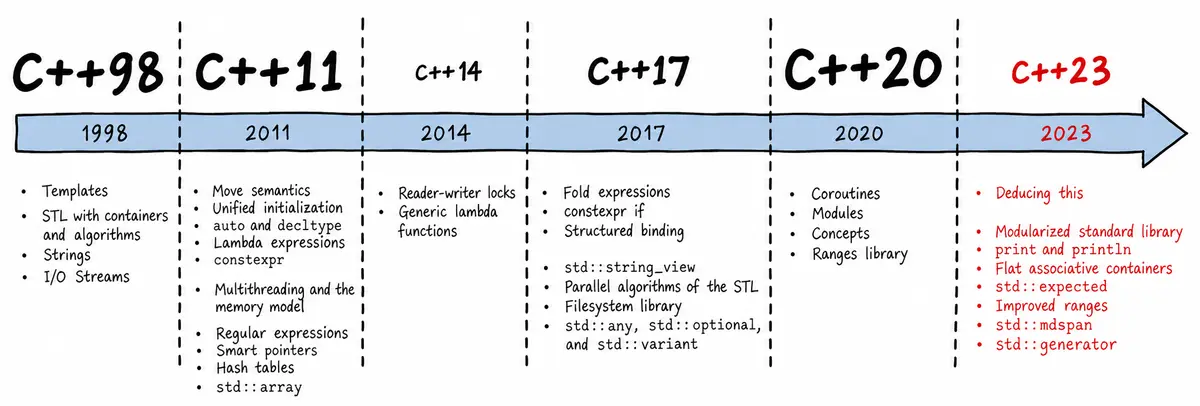
2.1 C++版本更新
2.2 关于C++23的一个小故事:
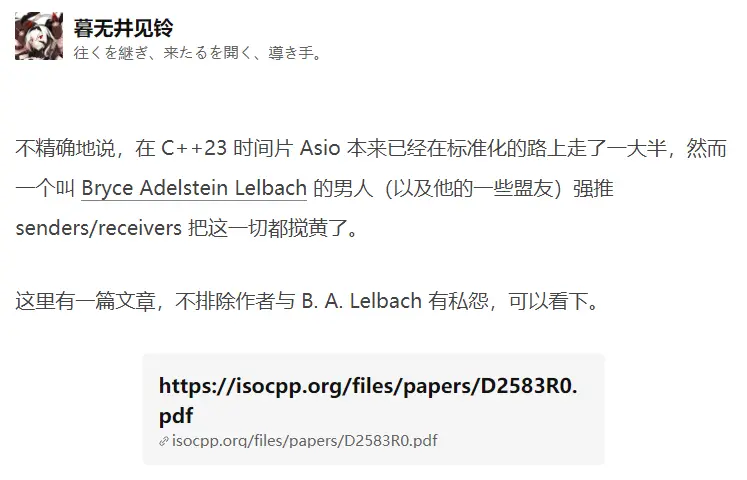
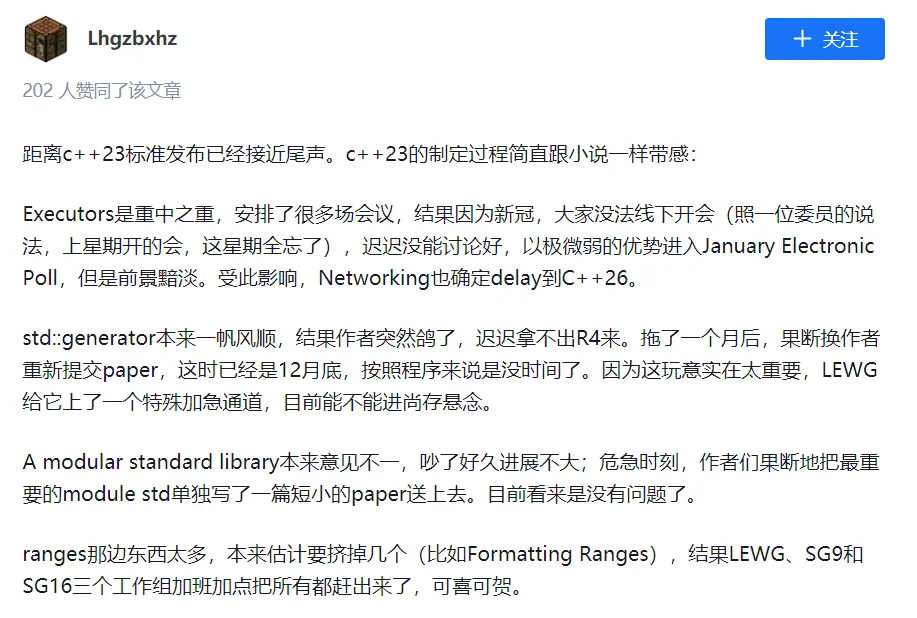
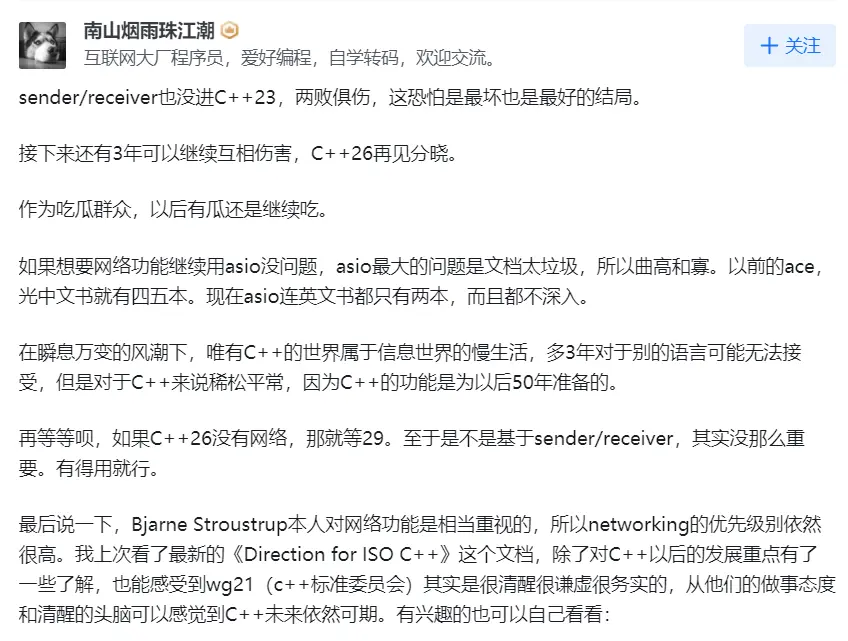
C++一直被诟病的一个地方就是一直没出网络库(networking),networking之前是在C++23的计划中的,现在C++23已经发布了,但是没有networking,网上引发了一系列的吃瓜和吐槽。中间过程就像发生了宫斗剧一样。
P2452R0: 2021 October Library Evolution and Concurrency Networking and Executors Poll Outcomes
C++23的目标
3. C++参考文档:
Reference – C++ Reference
C++ 参考手册 – cppreference.com
cppreference.com
说明:第一个链接不是C++官方文档,标准也只更新到C++11,但是以头文件形式呈现,内容比较易看好懂。后两个链接分别是C++官方文档的中文版和英文版,信息很全,更新到了最新的C++标准,但是相比第一个不那么易看;几个文档各有优势,我们结合着使用。
4. C++的重要性
4.1 编程语言排行榜
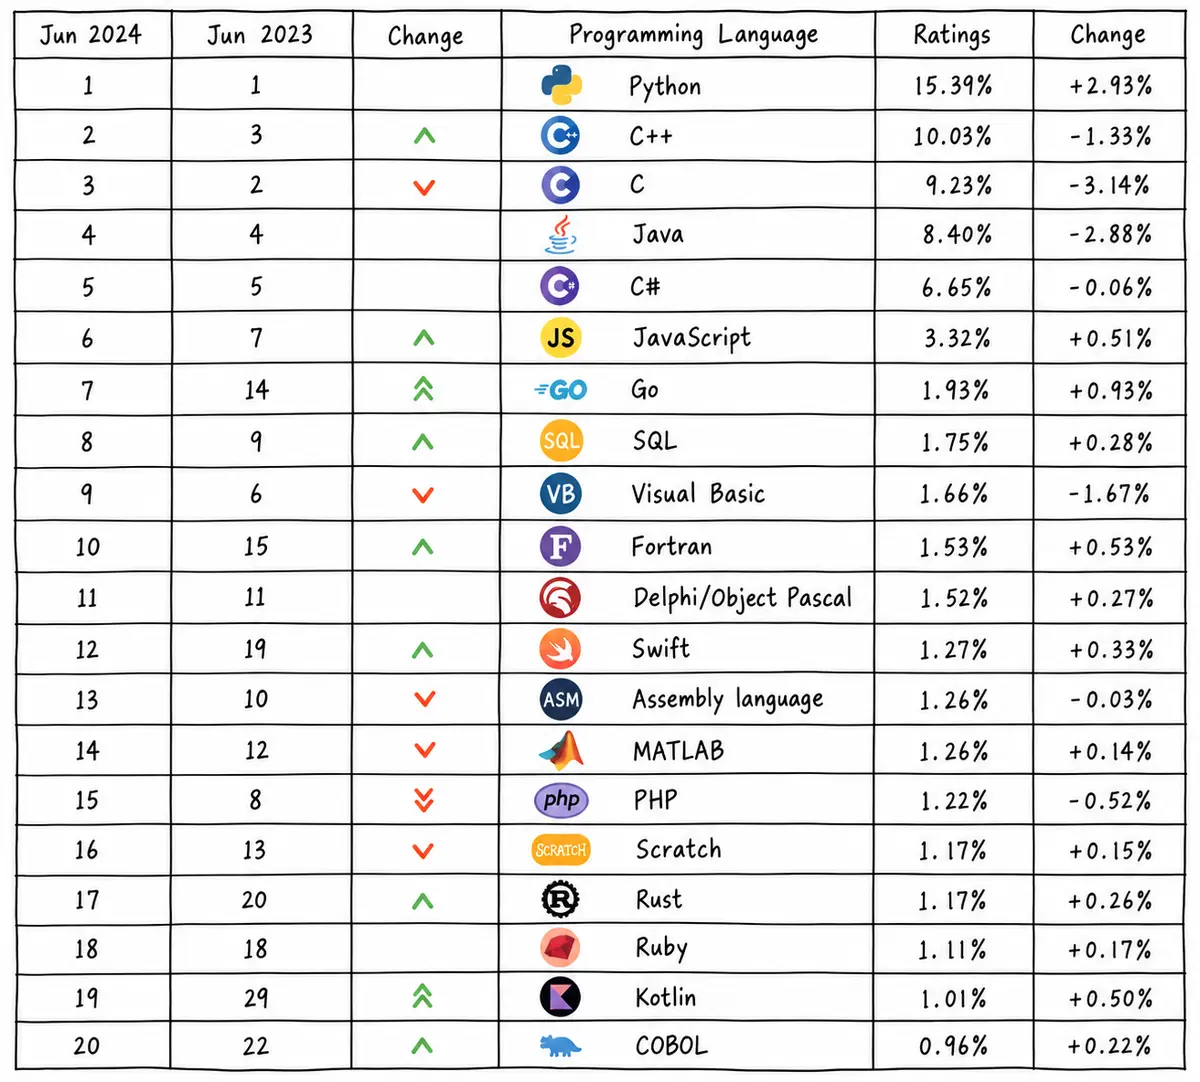
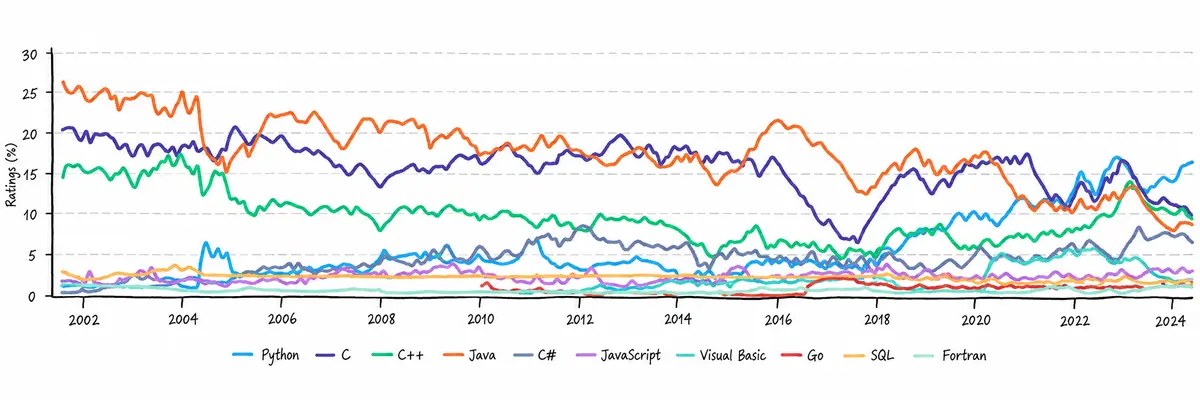
TIOBE排行榜是根据互联网上有经验的程序员、课程和第三方厂商的数量,并使用搜索引擎(如Google、Bing、Yahoo!)以及Wikipedia、Amazon、YouTube和Baidu(百度)统计出排名数据,只是反映某个编程语言的热门程度,并不能说明一门编程语言好不好,或者一门语言所编写的代码数量多少。
2024年6月TIOBE发布的编程语言排行榜
4.2 C++在工作领域中的应用
C++的应用领域服务器端、游戏(引擎)、机器学习引擎、音视频处理、嵌入式软件、电信设备、金融应用、基础库、操作系统、编译器、基础架构、基础工具、硬件交互等很多方面都有。
大型系统软件开发。如编译器、数据库、操作系统、浏览器等等
音视频处理。常见的音视频开源库和方案有FFmpeg、WebRTC、Mediasoup、ijkplayer,音视频开发最主要的技术栈就是C++。
PC客户端开发。一般是开发Windows上的桌面软件,比如WPS之类的,技术栈的话一般是C++和QT,QT 是一个跨平台的 C++图形用户界面(Graphical User Interface,GUI)程序。
服务端开发。各种大型应用网络连接的高并发后台服务。这块Java也比较多,C++主要用于一些对性能要求比较高的地方。如:游戏服务、流媒体服务、量化高频交易服务等
游戏引擎开发。很多游戏引擎就都是使用C++开发的,游戏开发要掌握C++基础和数据结构,学习图形学知识,掌握游戏引擎和框架,了解引擎实现,引擎源代码可以学习UE4、Cocos2d-x等开源引擎实现
嵌入式开发。嵌入式把具有计算能力的主控板嵌入到机器装置或者电子装置的内部,通过软件能够控制这些装置。比如:智能手环、摄像头、扫地机器人、智能音响、门禁系统、车载系统等等,粗略一点,嵌入式开发主要分为嵌入式应用和嵌入式驱动开发。
机器学习引擎。机器学习底层的很多算法都是用C++实现的,上层用Python封装起来。如果你只想准备数据训练模型,那么学会Python基本上就够了,如果你想做机器学习系统的开发,那么需要学会C++。
测试开发/测试。每个公司研发团队,有研发就有测试,测试主要分为测试开发和功能测试,测试开发一般是使用一些测试工具(selenium、Jmeter等),设计测试用例,然后写一些脚本进行自动化测试,性能测试等,有些还需要自行开发一些测试用具。功能测试主要是根据产品的功能,设计测试用例,然后手动的方式进行测试。
5. C++学习建议和书籍推荐
5.1 C++学习难度
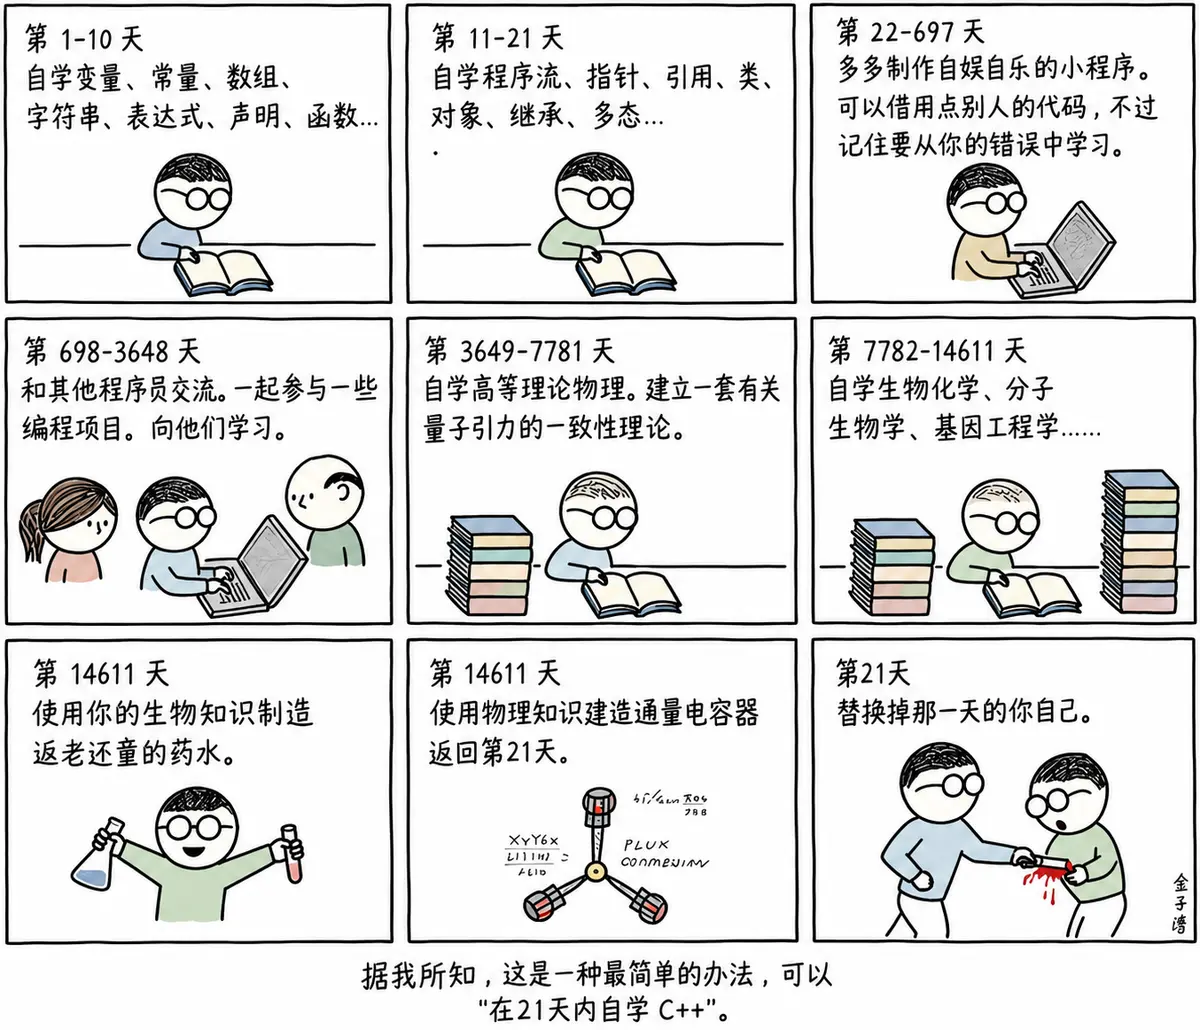
首先第一个问题,C++难学吗?首先在这里告诉大家C++是一个相对难学难精的语言,相比其他一些语言,学习难度要高一些要陡峭一些,这里有历史包袱的问题,也有语言本身设计和发展历史的问题。网上以前一直流传下面这个21天内自学精通C++的梗。
5.2 C++学习建议
动手优先,拒绝 “看懂就等于学会”。C++ 是实践性很强的语言,哪怕看懂例题,也要独立敲一遍代码,主动制造 bug、排查内存问题,指针、内存管理这类难点只有在调试中才能真正理解。
建立规范的阅读源码习惯。学习过程中多看 STL 源码,理解容器的底层实现;同时善用编译器选项,在不同 C++ 标准下编译测试,区分旧写法与现代 C++ 的差异,避免积累过时的编程习惯。
5.3 学习书籍推荐
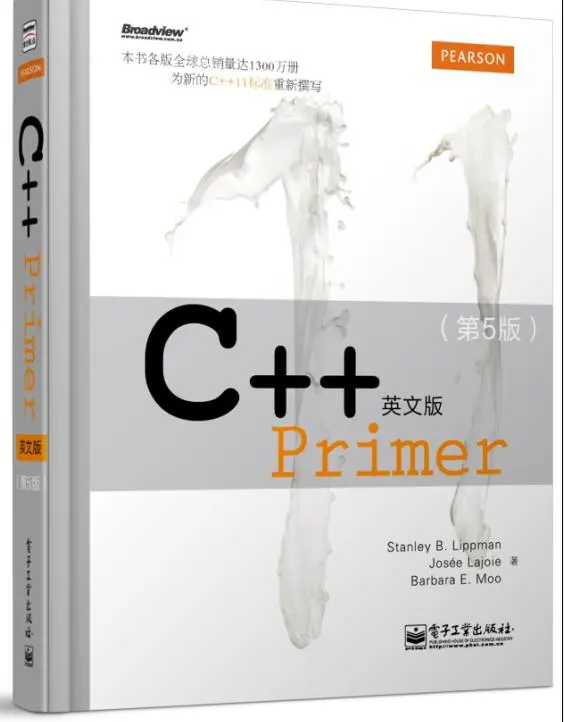
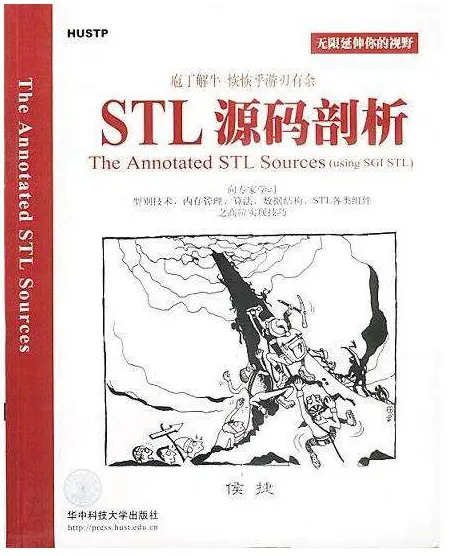
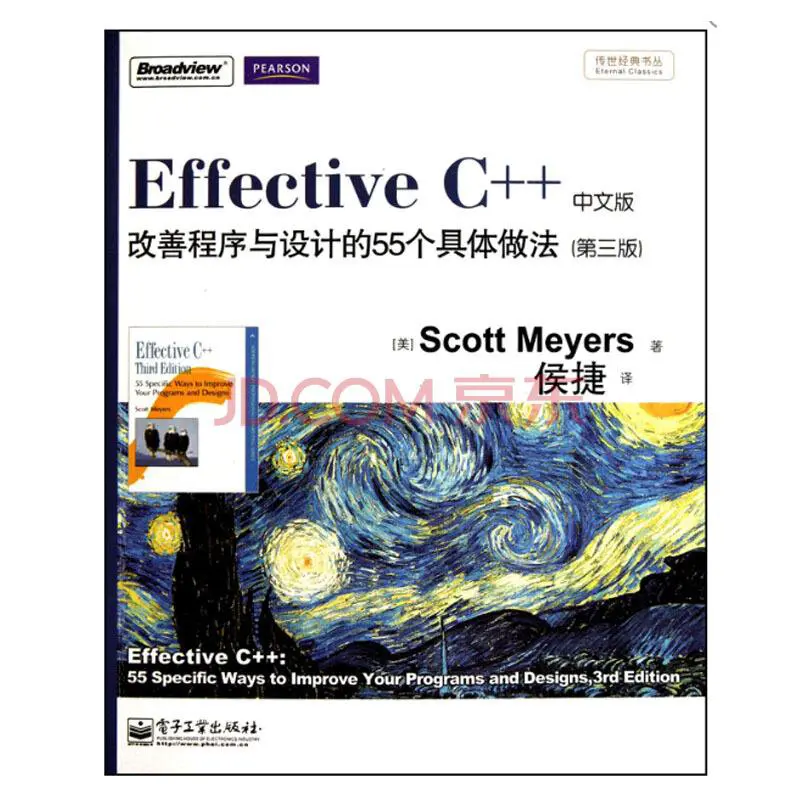
C++ Primer:主要讲解语法,经典的语法书籍,前后中期都可以看,前期如果自学看可能会有点晦涩难懂,能看懂多少看懂多少,就当预习,学了比特课程后,中后期作为语法字典,非常好用。
STL源码剖析:主要从底层实现的角度结合STL源码,庖丁解牛式剖析STL的实现,是侯捷老师的经典之作。可以很好的帮助我们学习别人用语法是如何实现出高效简洁的数据结构和算法代码,如何使用泛型封装等。让我们不再坐井观天,闭门造车,本书课程上一半以后,中后期可以看。
Effective C++:本书也是侯捷老师翻译的,本书有的一句评价,把C++程序员分为看过此书的和没看过此书的。本书主要讲了55个如何正确高效使用C++的条款,建议中后期可以看一遍,工作1-2年后再看一遍,相信会有不一样的收获。
6. C++的第一个程序
C++兼容C语言绝大多数的语法,所以C语言实现的hello world依旧可以运行,C++中需要把定义文件代码后缀改为.cpp,vs编译器看到是.cpp就会调用C++编译器编译,linux下要用g++编译,不再是gcc
// test.cpp
#include<stdio.h>
int main()
{
printf("hello world\\n");
return 0;
}
当然C++有一套自己的输入输出,严格说C++版本的hello world应该是这样写的。
// test.cpp
// 这里的std cout等我们都看不懂,没关系,下面我们会依次讲解
#include<iostream>
using namespace std;
int main()
{
cout << "hello world\\n" << endl;
return 0;
}
7. 命名空间
7.1 namespace的价值
在C/C++中,变量、函数和后面要学到的类都是大量存在的,这些变量、函数和类的名称将都存在于全局作用域中,可能会导致很多冲突。使用命名空间的目的是对标识符的名称进行本地化,以避免命名冲突或名字污染,namespace关键字的出现就是针对这种问题的。
c语言项目类似下面程序这样的命名冲突是普遍存在的问题,C++引入namespace就是为了更好的解决这样的问题
#include <stdio.h>
#include <stdlib.h>
int rand = 10;
int main()
{
// 编译报错:error C2365: “rand”: 重定义;以前的定义是“函数”
printf("%d\\n", rand);
return 0;
}
7.2 namespace的定义
-
定义命名空间,需要使用到namespace关键字,后面跟命名空间的名字,然后接一对{}即可,{}中即为命名空间的成员。命名空间中可以定义变量/函数/类型等。
-
namespace本质是定义出一个域,这个域跟全局域各自独立,不同的域可以定义同名变量,所以下面的rand不在冲突了。
-
C++中域有函数局部域,全局域,命名空间域,类域;域影响的是编译时语法查找一个变量/函数/类型出处(声明或定义)的逻辑,所有有了域隔离,名字冲突就解决了。局部域和全局域除了会影响编译查找逻辑,还会影响变量的生命周期,命名空间域和类域不影响变量生命周期。
-
namespace只能定义在全局,当然他还可以嵌套定义。
-
项目工程中多文件中定义的同名namespace会认为是一个namespace,不会冲突。
-
C++标准库都放在一个叫std(standard)的命名空间中。
#include <stdio.h>
#include <stdlib.h>
// 1. 正常的命名空间定义
// bit是命名空间的名字,一般开发中是用项目名字做命名空间名。
// 我们上课用的是bit,大家下去以后自己练习可以考虑用自己名字缩写,如张三:zs
namespace bit
{
// 命名空间中可以定义变量/函数/类型
int rand = 10;
int Add(int left, int right)
{
return left + right;
}
struct Node
{
struct Node* next;
int val;
};
}
int main()
{
// 这里默认是访问的是全局的rand函数指针
printf("%p\\n", rand);
// 这里指定bit命名空间中的rand
printf("%d\\n", bit::rand);
return 0;
}
//2. 命名空间可以嵌套
namespace bit
{
namespace pg
{
int rand = 1;
int Add(int left, int right)
{
return left + right;
}
}
namespace hg
{
int rand = 2;
int Add(int left, int right)
{
return (left + right)*10;
}
}
}
int main()
{
printf("%d\\n", bit::pg::rand);
printf("%d\\n", bit::hg::rand);
printf("%d\\n", bit::pg::Add(1, 2));
printf("%d\\n", bit::hg::Add(1, 2));
return 0;
}
// 多文件中可以定义同名namespace,他们会默认合并到一起,就像同一个namespace一样
// Stack.h
#pragma once
#include<stdio.h>
#include<stdlib.h>
#include<stdbool.h>
#include<assert.h>
namespace bit
{
typedef int STDataType;
typedef struct Stack
{
STDataType* a;
int top;
int capacity;
}ST;
void STInit(ST* ps, int n);
void STDestroy(ST* ps);
void STPush(ST* ps, STDataType x);
void STPop(ST* ps);
STDataType STTop(ST* ps);
int STSize(ST* ps);
bool STEmpty(ST* ps);
}
// Stack.cpp
#include"Stack.h"
namespace bit
{
void STInit(ST* ps, int n)
{
assert(ps);
ps->a = (STDataType*)malloc(n * sizeof(STDataType));
ps->top = 0;
ps->capacity = n;
}
// 栈顶
void STPush(ST* ps, STDataType x)
{
assert(ps);
// 满了, 扩容
if (ps->top == ps->capacity)
{
printf("扩容\\n");
int newcapacity = ps->capacity == 0 ? 4 : ps->capacity * 2;
STDataType* tmp = (STDataType*)realloc(ps->a, newcapacity * sizeof(STDataType));
if (tmp == NULL)
{
perror("realloc fail");
return;
}
ps->a = tmp;
ps->capacity = newcapacity;
}
ps->a[ps->top] = x;
ps->top++;
}
//…
}
// Queue.h
#pragma once
#include<stdlib.h>
#include<stdbool.h>
#include<assert.h>
namespace bit
{
typedef int QDataType;
typedef struct QueueNode
{
int val;
struct QueueNode* next;
}QNode;
typedef struct Queue
{
QNode* phead;
QNode* ptail;
int size;
}Queue;
void QueueInit(Queue* pq);
void QueueDestroy(Queue* pq);
// 入队列
void QueuePush(Queue* pq, QDataType x);
// 出队列
void QueuePop(Queue* pq);
QDataType QueueFront(Queue* pq);
QDataType QueueBack(Queue* pq);
bool QueueEmpty(Queue* pq);
int QueueSize(Queue* pq);
}
// Queue.cpp
#include"Queue.h"
namespace bit
{
void QueueInit(Queue* pq)
{
assert(pq);
pq->phead = NULL;
pq->ptail = NULL;
pq->size = 0;
}
// …
}
// test.cpp
#include"Queue.h"
#include"Stack.h"
// 全局定义了一份单独的Stack
typedef struct Stack
{
int a[10];
int top;
}ST;
void STInit(ST* ps){}
void STPush(ST* ps, int x){}
int main()
{
// 调用全局的
ST st1;
STInit(&st1);
STPush(&st1, 1);
STPush(&st1, 2);
printf("%d\\n", sizeof(st1));
// 调用bit namespace的
bit::ST st2;
printf("%d\\n", sizeof(st2));
bit::STInit(&st2);
bit::STPush(&st2, 1);
bit::STPush(&st2, 2);
return 0;
}
7.3 命名空间使用
编译查找一个变量的声明/定义时,默认只会在局部或者全局查找,不会到命名空间里面去查找。所以下面程序会编译报错。所以我们要使用命名空间中定义的变量/函数,有三种方式:
-
指定命名空间访问,项目中推荐这种方式。
-
using将命名空间中某个成员展开,项目中经常访问的不存在冲突的成员推荐这种方式。
-
展开命名空间中全部成员,项目不推荐,冲突风险很大,日常小练习程序为了方便推荐使用。
#include<stdio.h>
namespace bit
{
int a = 0;
int b = 1;
}
int main()
{
// 编译报错:error C2065: “a”: 未声明的标识符
printf("%d\\n", a);
return 0;
}
// 指定命名空间访问
int main()
{
printf("%d\\n", N::a);
return 0;
}
// using将命名空间中某个成员展开
using N::b;
int main()
{
printf("%d\\n", N::a);
printf("%d\\n", b);
return 0;
}
// 展开命名空间中全部成员
using namespace N;
int main()
{
printf("%d\\n", a);
printf("%d\\n", b);
return 0;
}
8. C++输入&输出
-
<iostream> 是 Input Output Stream 的缩写,是标准的输入、输出流库,定义了标准的输入、输出对象。
-
std::cin 是 istream 类的对象,它主要面向窄字符(narrow characters (of type char))的标准输入流。
-
std::cout 是 ostream 类的对象,它主要面向窄字符的标准输出流。
-
std::endl 是一个函数,流插入输出时,相当于插入一个换行字符加刷新缓冲区。
-
<<是流插入运算符,>>是流提取运算符。(C语言还用这两个运算符做位运算左移/右移)
-
使用C++输入输出更方便,不需要像printf/scanf输入输出时那样,需要手动指定格式,C++的输入输出可以自动识别变量类型(本质是通过函数重载实现的,这个以后会讲到),其实最重要的是C++的流能更好的支持自定义类型对象的输入输出。
-
IO流涉及类和对象,运算符重载、继承等很多面向对象的知识,这些知识我们还没有讲解,所以这里我们只能简单认识一下C++ IO流的用法,后面我们会有专门的一个章节来细节IO流库。
-
cout/cin/endl等都属于C++标准库,C++标准库都放在一个叫std(standard)的命名空间中,所以要通过命名空间的使用方式去用他们。
-
一般日常练习中我们可以using namespace std,实际项目开发中不建议using namespace std。
-
这里我们没有包含<stdio.h>,也可以使用printf和scanf,在包含<iostream>间接包含了。vs系列编译器是这样的,其他编译器可能会报错。
#define _CRT_SECURE_NO_WARNINGS 1
#include <iostream>
using namespace std;
int main()
{
int a = 0;
double b = 0.1;
char c = 'x';
cout << a << " " << b << " " << c << endl;
std::cout << a << " " << b << " " << c << std::endl;
scanf("%d%lf", &a, &b);
printf("%d %lf\\n", a, b);
// 可以自动识别变量的类型
cin >> a;
cin >> b >> c;
cout << a << endl;
cout << b << " " << c << endl;
return 0;
}
#include<iostream>
using namespace std;
int main()
{
// 在io需求比较高的地方,如部分大量输入的竞赛题中,加上以下3行代码
// 可以提高C++IO效率
ios_base::sync_with_stdio(false);
cin.tie(nullptr);
cout.tie(nullptr);
return 0;
}
9. 缺省参数
-
缺省参数是声明或定义函数时为函数的参数指定一个缺省值。在调用该函数时,如果没有指定实参则采用该形参的缺省值,否则使用指定的实参,缺省参数分为全缺省和半缺省参数。(有些地方把缺省参数也叫默认参数)
-
全缺省就是全部形参给缺省值,半缺省就是部分形参给缺省值。C++规定半缺省参数必须从右往左依次连续缺省,不能间隔跳跃给缺省值。
-
带缺省参数的函数调用,C++规定必须从左到右依次给实参,不能跳跃给实参。
-
函数声明和定义分离时,缺省参数不能在函数声明和定义中同时出现,规定必须函数声明给缺省值。
#include <iostream>
#include <assert.h>
using namespace std;
void Func(int a = 0)
{
cout << a << endl;
}
int main()
{
Func(); // 没有传参时,使用参数的默认值
Func(10); // 传参时,使用指定的实参
return 0;
}
#include <iostream>
using namespace std;
// 全缺省
void Func1(int a = 10, int b = 20, int c = 30)
{
cout << "a = " << a << endl;
cout << "b = " << b << endl;
cout << "c = " << c << endl << endl;
}
// 半缺省
void Func2(int a, int b = 10, int c = 20)
{
cout << "a = " << a << endl;
cout << "b = " << b << endl;
cout << "c = " << c << endl << endl;
}
int main()
{
Func1();
Func1(1);
Func1(1,2);
Func1(1,2,3);
Func2(100);
Func2(100, 200);
Func2(100, 200, 300);
return 0;
}
// Stack.h
#include <iostream>
#include <assert.h>
using namespace std;
typedef int STDataType;
typedef struct Stack
{
STDataType* a;
int top;
int capacity;
}ST;
void STInit(ST* ps, int n = 4);
// Stack.cpp
#include"Stack.h"
// 缺省参数不能声明和定义同时给
void STInit(ST* ps, int n)
{
assert(ps && n > 0);
ps->a = (STDataType*)malloc(n * sizeof(STDataType));
ps->top = 0;
ps->capacity = n;
}
// test.cpp
#include"Stack.h"
int main()
{
ST s1;
STInit(&s1);
// 确定知道要插入1000个数据,初始化时一把开好,避免扩容
ST s2;
STInit(&s2, 1000);
return 0;
}
10. 函数重载
C++支持在同一作用域中出现同名函数,但是要求这些同名函数的形参不同,可以是参数个数不同或者类型不同。这样C++函数调用就表现出了多态行为,使用更灵活。C语言是不支持同一作用域中出现同名函数的。
#include<iostream>
using namespace std;
// 1、参数类型不同
int Add(int left, int right)
{
cout << "int Add(int left, int right)" << endl;
return left + right;
}
double Add(double left, double right)
{
cout << "double Add(double left, double right)" << endl;
return left + right;
}
// 2、参数个数不同
void f()
{
cout << "f()" << endl;
}
void f(int a)
{
cout << "f(int a)" << endl;
}
// 3、参数类型顺序不同
void f(int a, char b)
{
cout << "f(int a,char b)" << endl;
}
void f(char b, int a)
{
cout << "f(char b, int a)" << endl;
}
// 返回值不同不能作为重载条件,因为调用时也无法区分
//void fxx()
//{}
//
//int fxx()
//{
// return 0;
//}
// 下面两个函数构成重载
// f()但是调用时,会报错,存在歧义,编译器不知道调用谁
void f1()
{
cout << "f()" << endl;
}
void f1(int a = 10)
{
cout << "f(int a)" << endl;
}
int main()
{
Add(10, 20);
Add(10.1, 20.2);
f();
f(10);
f(10, 'a');
f('a', 10);
return 0;
}
11. 引用
11.1 引用的概念和定义
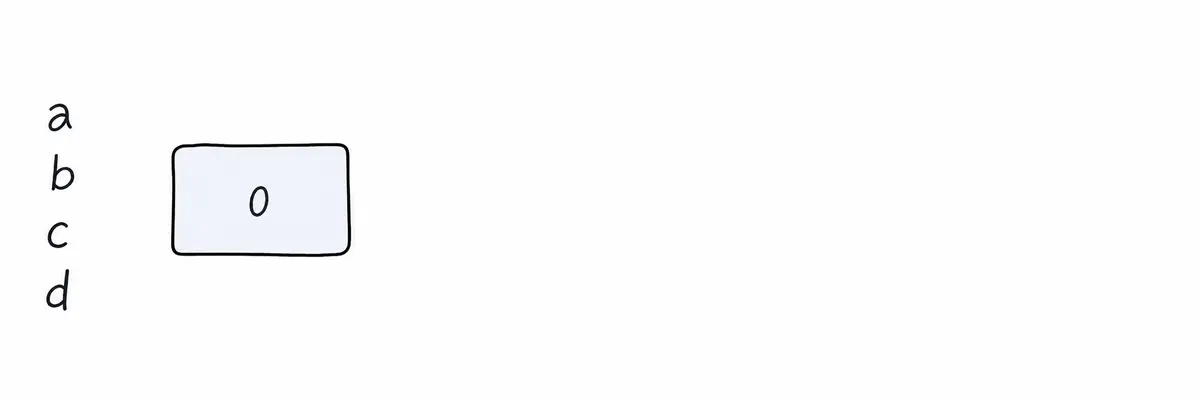
引用不是新定义一个变量,而是给已存在变量取了一个别名,编译器不会为引用变量开辟内存空间,它和它引用的变量共用同一块内存空间。比如:水壶传中李逵,宋江叫"铁牛",江湖上人称"黑旋风";林冲,外号豹子头;
类型& 引用别名 = 引用对象;C++中为了避免引入太多的运算符,会复用C语言的一些符号,比如前面的<< 和 >>,这里引用也和取地址使用了同一个符号&,大家注意使用方法角度区分就可以。(吐槽一下,这个问题其实挺坑的,个人觉得用更多符号反而更好,不容易混淆)
#include<iostream>
using namespace std;
int main()
{
int a = 0;
// 引用:b和c是a的别名
int& b = a;
int& c = a;
// 也可以给别名b取别名,d相当于还是a的别名
int& d = b;
++d;
// 这里取地址我们看到是一样的
cout << &a << endl;
cout << &b << endl;
cout << &c << endl;
cout << &d << endl;
return 0;
}
11.2 引用的特性
-
引用在定义时必须初始化
-
一个变量可以有多个引用
-
引用一旦引用一个实体,再不能引用其他实体
#include<iostream>
using namespace std;
int main()
{
int a = 10;
// 编译报错:“ra”: 必须初始化引用
//int& ra;
int& b = a;
int c = 20;
// 这里并非让b引用c,因为C++引用不能改变指向,
// 这里是一个赋值
b = c;
cout << &a << endl;
cout << &b << endl;
cout << &c << endl;
return 0;
}
11.3 引用的使用
-
引用在实践中主要是于引用传参和引用做返回值中减少拷贝提高效率和改变引用对象时同时改变被引用对象。
-
引用传参跟指针传参功能是类似的,引用传参相对更方便一些。
-
引用返回值的场景相对比较复杂,我们在这里简单讲了一下场景,还有一些内容后续类和对象章节中会继续深入讲解。
-
引用和指针在实践中相辅相成,功能有重叠性,但是各有特点,互相不可替代。C++的引用跟其他语言的引用(如Java)是有很大的区别的,除了用法,最大的点,C++引用定义后不能改变指向,Java的引用可以改变指向。
-
一些主要用C代码实现版本数据结构教材中,使用C++引用替代指针传参,目的是简化程序,避开复杂的指针,但是很多同学没学过引用,导致一头雾水。
void Swap(int& rx, int& ry)
{
int tmp = rx;
rx = ry;
ry = tmp;
}
int main()
{
int x = 0, y = 1;
cout << x <<" " << y << endl;
Swap(x, y);
cout << x << " " << y << endl;
return 0;
}
#include<iostream>
using namespace std;
typedef int STDataType;
typedef struct Stack
{
STDataType* a;
int top;
int capacity;
}ST;
void STInit(ST& rs, int n = 4)
{
rs.a = (STDataType*)malloc(n * sizeof(STDataType));
rs.top = 0;
rs.capacity = n;
}
// 栈顶
void STPush(ST& rs, STDataType x)
{
assert(ps);
// 满了, 扩容
if (rs.top == rs.capacity)
{
printf("扩容\\n");
int newcapacity = rs.capacity == 0 ? 4 : rs.capacity * 2;
STDataType* tmp = (STDataType*)realloc(rs.a, newcapacity * sizeof(STDataType));
if (tmp == NULL)
{
perror("realloc fail");
return;
}
rs.a = tmp;
rs.capacity = newcapacity;
}
rs.a[rs.top] = x;
rs.top++;
}
// int STTop(ST& rs)
int& STTop(ST& rs)
{
assert(rs.top > 0);
return rs.a[rs.top];
}
int main()
{
// 调用全局的
ST st1;
STInit(st1);
STPush(st1, 1);
STPush(st1, 2);
cout << STTop(st1) << endl;
STTop(st1) += 10;
cout << STTop(st1) << endl;
return 0;
}
#include<iostream>
using namespace std;
typedef struct SeqList
{
int a[10];
int size;
}SLT;
// 一些主要用C代码实现版本数据结构教材中,使用C++引用替代指针传参,目的是简化程序,避开复 杂的指针,但是很多同学没学过引用,导致一头雾水。
void SeqPushBack(SLT& sl, int x)
{}
typedef struct ListNode
{
int val;
struct ListNode* next;
}LTNode, *PNode;
// 指针变量也可以取别名,这里LTNode*& phead就是给指针变量取别名
// 这样就不需要用二级指针了,相对而言简化了程序
//void ListPushBack(LTNode** phead, int x)
//void ListPushBack(LTNode*& phead, int x)
void ListPushBack(PNode& phead, int x)
{
PNode newnode = (PNode)malloc(sizeof(LTNode));
newnode->val = x;
newnode->next = NULL;
if (phead == NULL)
{
phead = newnode;
}
else
{
//…
}
}
int main()
{
PNode plist = NULL;
ListPushBack(plist, 1);
return 0;
}
11.4 const引用
-
可以引用一个const对象,但是必须用const引用。const引用也可以引用普通对象,因为对象的访问权限在引用过程中可以缩小,但是不能放大。
-
需要注意的是类似 int& rb = a*3;、double d = 12.34;、int& rd = d; 这样一些场景下,a*3 的结果保存在一个临时对象中,int& rd = d 也是类似,在类型转换中会产生临时对象存储中间值,也就是此时,rb 和 rd 引用的都是临时对象,而 C++ 规定临时对象具有常性,所以这里就触发了权限放大,必须要用常引用才可以。
-
所谓临时对象就是编译器需要一个空间暂存表达式的求值结果时临时创建的一个未命名的对象,C++中把这个未命名对象叫做临时对象。
int main()
{
const int a = 10;
// 编译报错:error C2440: “初始化”: 无法从“const int”转换为“int &”
// 这里的引用是对a访问权限的放大
//int& ra = a;
// 这样才可以
const int& ra = a;
// 编译报错:error C3892: “ra”: 不能给常量赋值
//ra++;
// 这里的引用是对b访问权限的缩小
int b = 20;
const int& rb = b;
// 编译报错:error C3892: “rb”: 不能给常量赋值
//rb++;
return 0;
}
#include<iostream>
using namespace std;
int main()
{
int a = 10;
const int& ra = 30;
// 编译报错: “初始化”: 无法从“int”转换为“int &”
// int& rb = a * 3;
const int& rb = a*3;
double d = 12.34;
// 编译报错:“初始化”: 无法从“double”转换为“int &”
// int& rd = d;
const int& rd = d;
return 0;
}
11.5 指针和引用的关系
C++中指针和引用就像两个性格迥异的亲兄弟,指针是哥哥,引用是弟弟,在实践中他们相辅相成,功能有重叠性,但是各有自己的特点,互相不可替代。
-
语法概念上引用是一个变量的取别名不开空间,指针是存储一个变量地址,要开空间。
-
引用在定义时必须初始化,指针建议初始化,但是语法上不是必须的。
-
引用在初始化时引用一个对象后,就不能再引用其他对象;而指针可以在不断地改变指向对象。
-
引用可以直接访问指向对象,指针需要解引用才是访问指向对象。
-
sizeof中含义不同,引用结果为引用类型的大小,但指针始终是地址空间所占字节个数(32位平台下占4个字节,64位下是8byte)
-
指针很容易出现空指针和野指针的问题,引用很少出现,引用使用起来相对更安全一些。
12. inline
-
用inline修饰的函数叫做内联函数,编译时C++编译器会在调用的地方展开内联函数,这样调用内联函数就需要建立栈帧了,就可以提高效率。
-
inline对于编译器而言只是一个建议,也就是说,你加了inline编译器也可以选择在调用的地方不展开,不同编译器关于inline什么情况展开各不相同,因为C++标准没有规定这个。inline适用于频繁调用的短小函数,对于递归函数,代码相对多一些的函数,加上inline也会被编译器忽略。
-
C语言实现宏函数也会在预处理时替换展开,但是宏函数实现很复杂很容易出错的,且不方便调试,C++设计了inline目的就是替代C的宏函数。
-
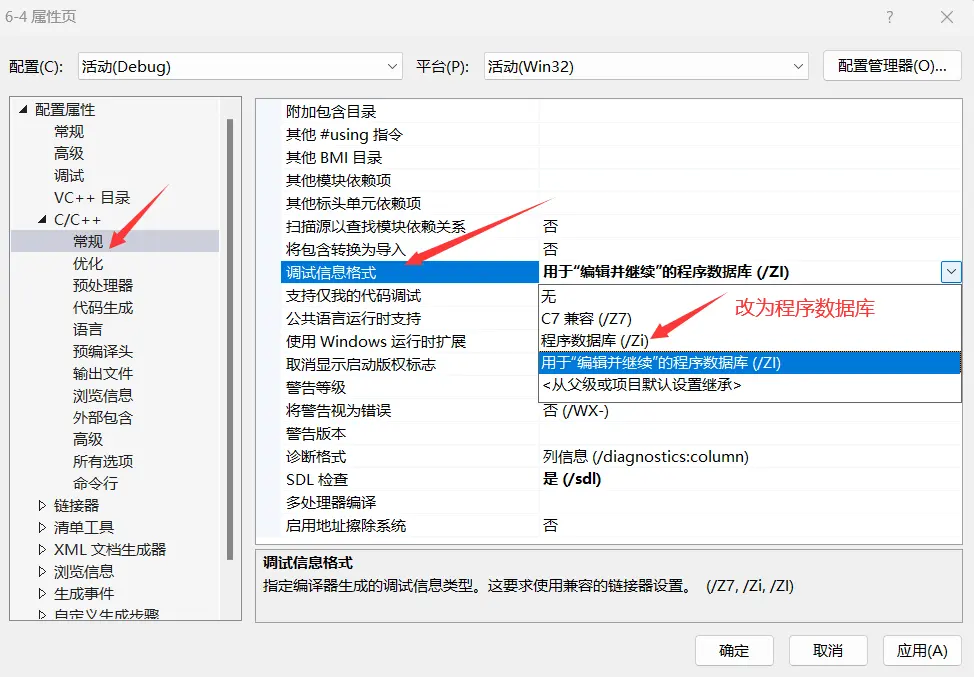
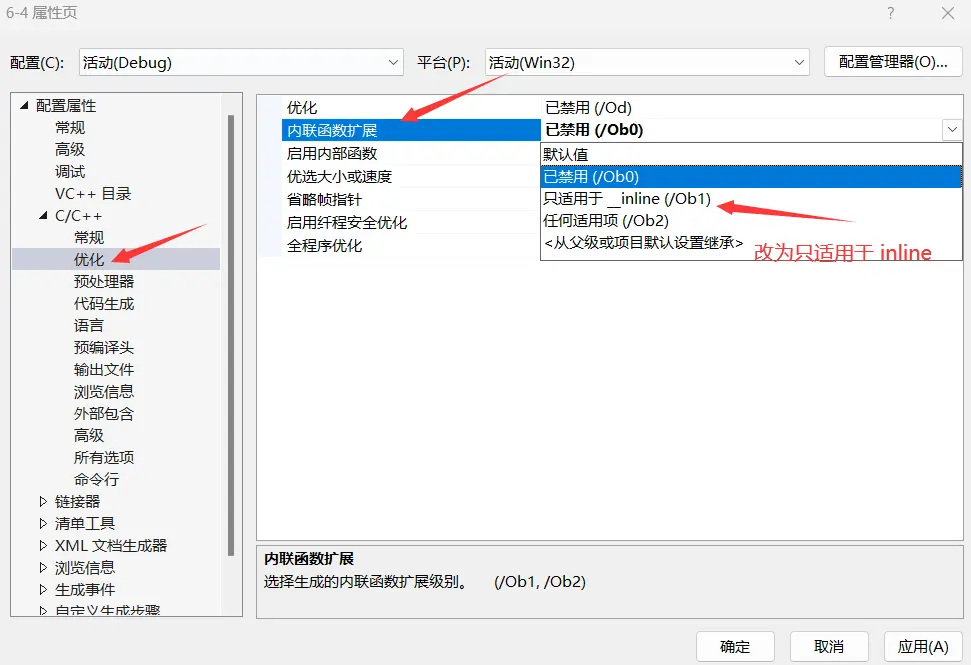
vs编译器 debug版本下面默认是不展开inline的,这样方便调试,debug版本想展开需要设置一下以下两个地方。
-
inline不建议声明和定义分离到两个文件,分离会导致链接错误。因为inline被展开,就没有函数地址,链接时会出现报错。
#include<iostream>
using namespace std;
inline int Add(int x, int y)
{
int ret = x + y;
ret += 1;
ret += 1;
ret += 1;
return ret;
}
int main()
{
// 可以通过汇编观察程序是否展开
// 有call Add语句就是没有展开,没有就是展开了
int ret = Add(1, 2);
cout << Add(1, 2) * 5 << endl;
return 0;
}
#include<iostream>
using namespace std;
// 实现一个ADD宏函数的常见问题
//#define ADD(int a, int b) return a + b;
//#define ADD(a, b) a + b;
//#define ADD(a, b) (a + b)
// 正确的宏实现
#define ADD(a, b) ((a) + (b))
// 为什么不能加分号?
// 为什么要加外面的括号?
// 为什么要加里面的括号?
int main()
{
int ret = ADD(1, 2);
cout << ADD(1, 2) << endl;
cout << ADD(1, 2)*5 << endl;
int x = 1, y = 2;
ADD(x & y, x | y); // -> (x&y+x|y)
return 0;
}
// F.h
#include <iostream>
using namespace std;
inline void f(int i);
// F.cpp
#include "F.h"
void f(int i)
{
cout << i << endl;
}
// main.cpp
#include "F.h"
int main()
{
// 链接错误:无法解析的外部符号 "void __cdecl f(int)" (?f@@YAXH@Z)
f(10);
return 0;
}
13. nullptr
NULL实际是一个宏,在传统的C头文件(stddef.h)中,可以看到如下代码:
#ifndef NULL
#ifdef __cplusplus
#define NULL 0
#else
#define NULL ((void *)0)
#endif
#endif
-
C++中NULL可能被定义为字面常量0,或者C中被定义为无类型指针(void*)的常量。不论采取何种定义,在使用空值的指针时,都不可避免的会遇到一些麻烦,本想通过f(NULL)调用指针版本的f(int*)函数,但是由于NULL被定义成0,调用了f(int x),因此与程序的初衷相悖。f((void*)NULL);调用会报错。
-
C++11中引入nullptr,nullptr是一个特殊的关键字,nullptr是一种特殊类型的字面量,它可以转换成任意其他类型的指针类型。使用nullptr定义空指针可以避免类型转换的问题,因为nullptr只能被隐式地转换为指针类型,而不能被转换为整数类型。
#include<iostream>
using namespace std;
void f(int x)
{
cout << "f(int x)" << endl;
}
void f(int* ptr)
{
cout << "f(int* ptr)" << endl;
}
int main()
{
f(0);
// 本想通过f(NULL)调用指针版本的f(int*)函数,但是由于NULL被定义成0,调用了f(int x),因此与程序的初衷相悖。
f(NULL);
f((int*)NULL);
// 编译报错:error C2665: “f”: 2 个重载中没有一个可以转换所有参数类型
// f((void*)NULL);
f(nullptr);
return 0;
}


评论前必须登录!
注册