 网硕互联帮助中心
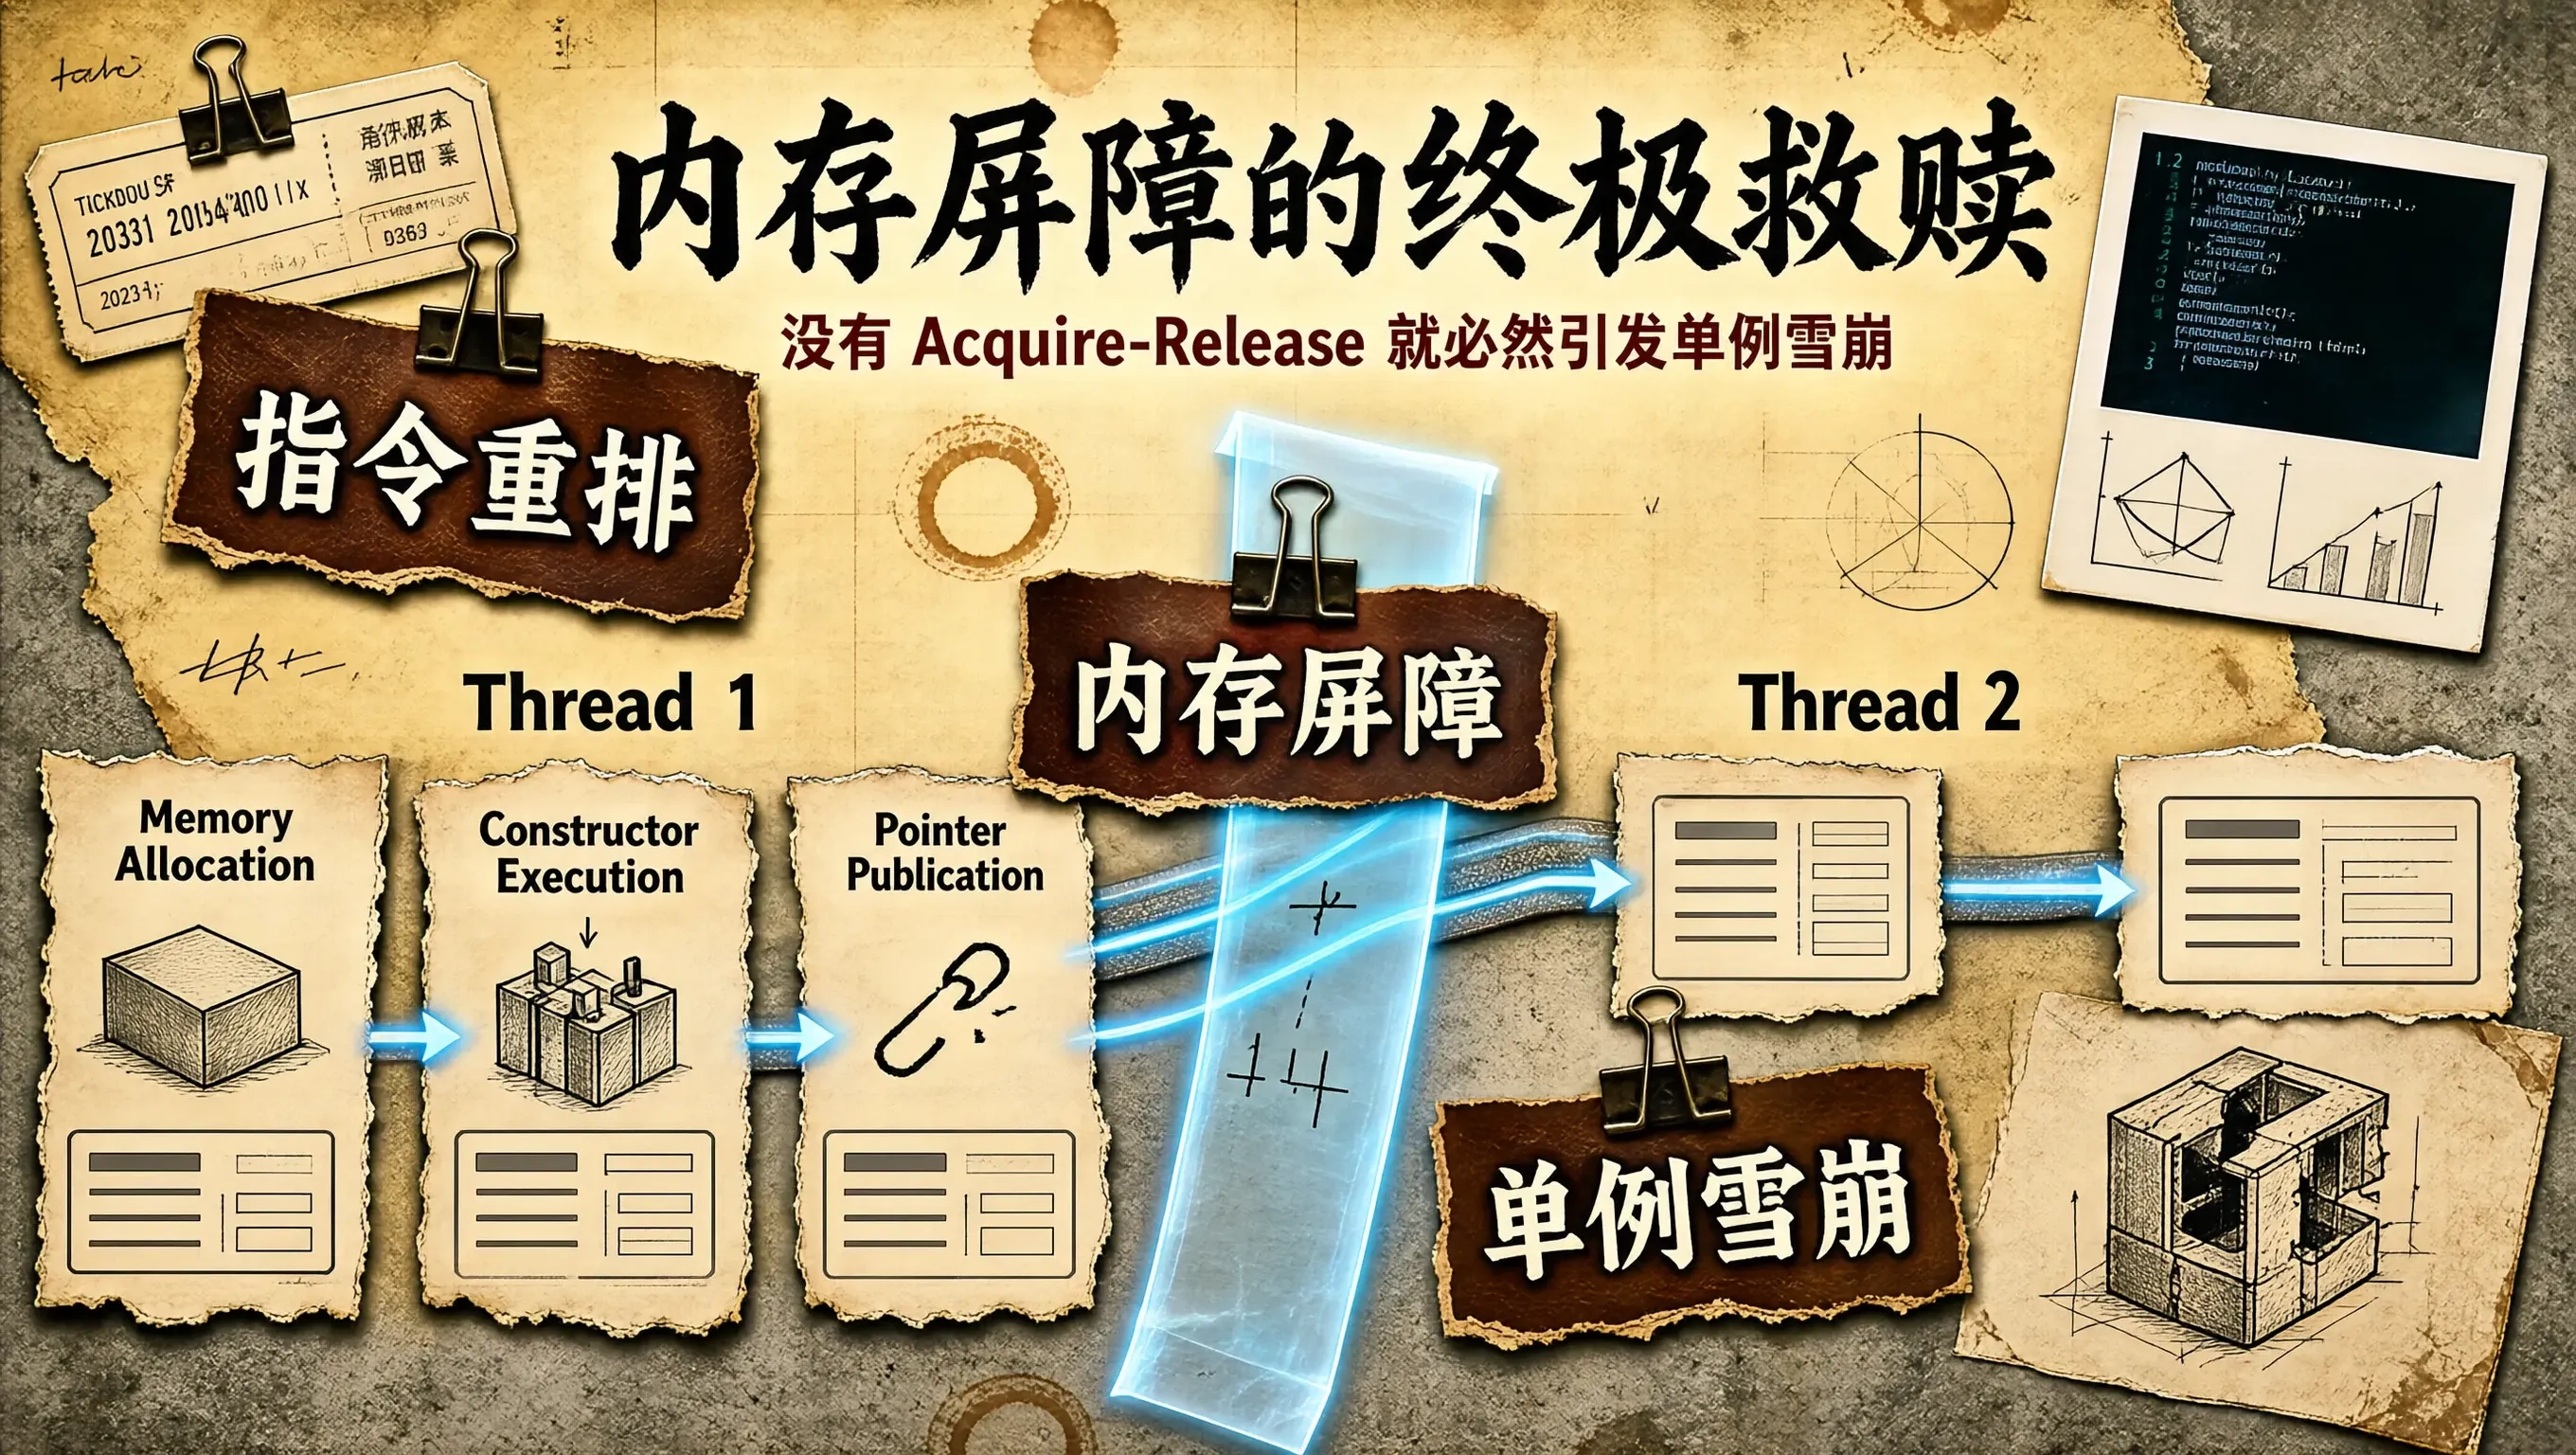
在并发编程的发展史中,**双重检查锁定模式(Double-Checked Locking Pattern, 简称 DCLP)**是一座被无数技术先贤反复解剖、却依然在现代多核服务器上频繁制造线上崩溃的“经典迷宫”。
其最初的设计动机极其单纯而优雅:为了在多线程环境下实现懒加载(Lazy Initialization)单例模式,同时避免每次获取单例都经历互斥锁(std::mutex)高昂的加锁解锁开销,工程师们设计了“先检查指针是否为空、若为空再加锁并二次检查”的双重检测结构。
然而,在 2004 年 Scott Meyers 与 Andrei Alexandrescu 共同发表震撼业界的著名论文之前,整个 C/C++ 工业界甚至未曾意识到:基于传统裸指针实现的 DCLP,在现代超标量多核处理器上从根本上就是彻底错误的!
如果不引入严格的现代 C++ 内存模型屏障(Acquire-Release 语义),看似完美的 DCLP 会在并发高压下瞬间引发灾难性的**“半初始化对象逸出(Half-Initialized Object Escape)”**——当某个线程检测到单例指针已经非空时,其所指向的内存空间中的成员变量可能根本还没有被写入,从而导致业务线程在一个充斥着随机未初始化垃圾数据的“半成品对象”上狂奔,最终引发灾难性的内存崩溃!
本文将从物理微架构层面的指令重排与写缓冲区排空机制切入,彻底撕开 DCLP 崩溃的本质,并给出基于 C++23 原子内存模型与现代编译期特性的终极工业解法。
一、微架构解剖:对象构造的三个底层步骤与乱序指令重排
要理解 DCLP 为什么必然崩溃,必须深入汇编指令层面,审视代码 instance = new Singleton(); 究竟对应了哪些物理机器动作。
在编译器与超标量 CPU 视角下,这行代码必须被严格拆解为三个步骤:
传统 DCLP 致命崩溃时空交错:
Thread 1 (执行初始化):
Step 1: 分配内存 (得到地址 0x1000)
Step 3: 赋值 instance = 0x1000 <—+ (灾难!编译器/CPU 乱序将发布指针重排到了前面!)
|
Thread 2 (调用 getInstance): |
外层检查: if (instance != nullptr) | (此时 instance 已经非空!)
以为已经初始化完毕,直接返回 0x1000 |
开始访问 instance->data_ | (此时 Step 2 根本尚未执行!访问到未初始化的随机内存垃圾!)
| ===> 发生段错误 SIGSEGV 或逻辑严重撕裂!
Thread 1 (这才开始执行): |
Step 2: 执行对象构造函数 ————+ (为时已晚,Thread 2 已经雪崩!)
为什么编译器和 CPU 敢于将步骤 3 重排到步骤 2 之前?根据 C++ 标准著名的“As-if 规则”,在单线程执行视角下,先赋值指针还是先构造内存,对于当前线程自身而言没有任何可观测的副作用。因此,现代优化编译器为了最大化寄存器分配效率,或者超标量处理器的乱序执行引擎(Out-of-Order Engine)为了隐藏构造函数深层写入的延迟,完全有合法的自由将步骤 3 提前发射!
一旦发生这种重排,对于另一个完全在无锁状态下读取 instance 的线程而言,它看到的便是一个“已经暴露、却未完全成型”的致命怪胎。
二、Acquire-Release 语义的终极救赎:建立单向绝对因果律
解决这一困境的数学核心,是在“写线程”与“读线程”之间建立起跨核心的同步与先行因果关系(Synchronizes-With & Happens-Before)。
这正是 C++11 引入、并在 C++23 中持续作为核心基石的原子内存顺序所定义的神圣契约:
Acquire-Release 建立的跨核内存屏障:
Thread 1 (写线程):
[ 步骤 1: 内存分配 ]
[ 步骤 2: 构造函数所有成员变量写入 ]
——————————— [ 内存屏障: memory_order_release ]
[ 步骤 3: instance.store(ptr, release) ]
|
| (硬件层保证: 屏障之上的全部写操作,在发布指针时已绝对落盘可见!)
v
Thread 2 (读线程):
[ instance.load(acquire) ]
——————————— [ 内存屏障: memory_order_acquire ]
[ 读取 instance 内部的成员变量 ]
(硬件层保证: 绝不重排到 acquire 之前,必定看到 Thread 1 在 release 之前的所有写入!)
三、工业级 C++23 DCLP 终极标准实现
以下代码演示了完全符合 C++ 标准、具备绝对微架构安全性的工业级 DCLP 实现:
#include <iostream>
#include <atomic>
#include <mutex>
#include <string>
#include <cstdint>
#include <cassert>
class GlobalTensorEngine {
private:
// 必须声明为原子指针,彻底消除数据竞争
static inline std::atomic<GlobalTensorEngine*> instance_{nullptr};
static inline std::mutex init_mutex_{};
// 单例内部复杂状态
uint64_t engine_id_{0};
std::string config_name_{};
bool is_hardware_locked_{false};
// 私有构造函数
GlobalTensorEngine(uint64_t id, std::string cfg)
: engine_id_(id), config_name_(std::move(cfg)), is_hardware_locked_(true) {
std::cout << "[DCLP] 复杂单例硬件环境正在初始化,完成物理寄存器锁定…\\n";
}
public:
~GlobalTensorEngine() = default;
GlobalTensorEngine(const GlobalTensorEngine&) = delete;
GlobalTensorEngine& operator=(const GlobalTensorEngine&) = delete;
// 工业级 DCLP 终极安全获取函数
static GlobalTensorEngine* get_instance() noexcept {
// 第 1 重检查: 采用 Acquire 语义读取!
// 保证只要读到了非空,后续对单例成员的访问绝对安全可见!
GlobalTensorEngine* ptr = instance_.load(std::memory_order_acquire);
// 快路径 (Happy Path): 绝大多数时刻指针已初始化,单条无锁指令直接返回!
if (ptr == nullptr) {
// 慢路径 (Cold Path): 加互斥锁进行双重校验
std::lock_guard<std::mutex> lock(init_mutex_);
// 第 2 重检查: 采用 Relaxed 即可,因为处于互斥锁的完全保护伞下
ptr = instance_.load(std::memory_order_relaxed);
if (ptr == nullptr) {
// 原地构造复杂对象
auto* new_instance = new GlobalTensorEngine(1024, "Sapphire_Rapids_AVX512");
// 核心关键: 采用 Release 语义发布指针!
// 彻底阻断指令重排,确保构造函数的写入绝对先行于指针的可见性!
instance_.store(new_instance, std::memory_order_release);
ptr = new_instance;
}
}
return ptr;
}
void execute_operator() const noexcept {
assert(is_hardware_locked_ && "致命错误: 观测到了半初始化对象!");
// 安全执行…
}
};
四、终极替代:C++11/23 静态局部变量(Magic Static)的微架构真相
在现代 C++(C++11 以后)中,标准提出了著名的“Magic Static(静态局部变量线程安全规范)”:
GlobalTensorEngine& get_magic_instance() {
static GlobalTensorEngine instance(1024, "Magic_Static");
return instance;
}
很多人知道 Magic Static 是线程安全的,却不知道现代编译器在底层是如何实现它的——其底层机器码恰恰就是我们上述手写的 DCLP 的工业级封装!
审视 GCC 14 对 Magic Static 生成的核心汇编代码:
# Magic Static 底层生成的机器码:
movzbl _ZGVZ19get_magic_instancevE8instance(%rip), %eax # (1) 检查保护标志 Guard Flag (Acquire)
testb %al, %al
je .Lslow_init # 为空则进入慢速初始化
movq _ZZ19get_magic_instancevE8instance(%rip), %rax # 已经初始化,直接返回!
ret
.Lslow_init:
call __cxa_guard_acquire # (2) 类似于加互斥锁
testl %eax, %eax
je .Ldone
call GlobalTensorEngine::GlobalTensorEngine(…) # (3) 调用构造函数
call __cxa_guard_release # (4) Release 语义发布标志
编译器底层自动生成了一个隐式的 __cxa_guard_acquire 与 __cxa_guard_release,这从硬件机器码层面彻底印证了我们的理论推导:没有 Acquire-Release 屏障,就根本无法在物理多核芯片上构建正确的双重检查单例!
五、总结
双重检查锁定模式(DCLP)不仅是一段关于设计模式的经典案例,更是通往现代体系结构、编译器优化与内存模型深处的一面透视镜。它无情地戳破了“高级语言语法代表机器物理行为”的浅显假象,将现代超标量 CPU 乱序执行与多级写缓冲区的冰冷现实展现在我们面前。理解并精通 Acquire-Release 语义在 DCLP 中的绝对因果律,是每一位致力于系统级核心基础设施研发的工程师建立起坚不可摧并发直觉的必修之课。


评论前必须登录!
注册