 网硕互联帮助中心
💖💖作者:计算机毕业设计小途 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 猫图像目标检测方法研究系统介绍
- 猫图像目标检测方法研究系统演示视频
- 猫图像目标检测方法研究系统演示图片
- 猫图像目标检测方法研究系统代码展示
- 猫图像目标检测方法研究系统文档展示
猫图像目标检测方法研究系统介绍
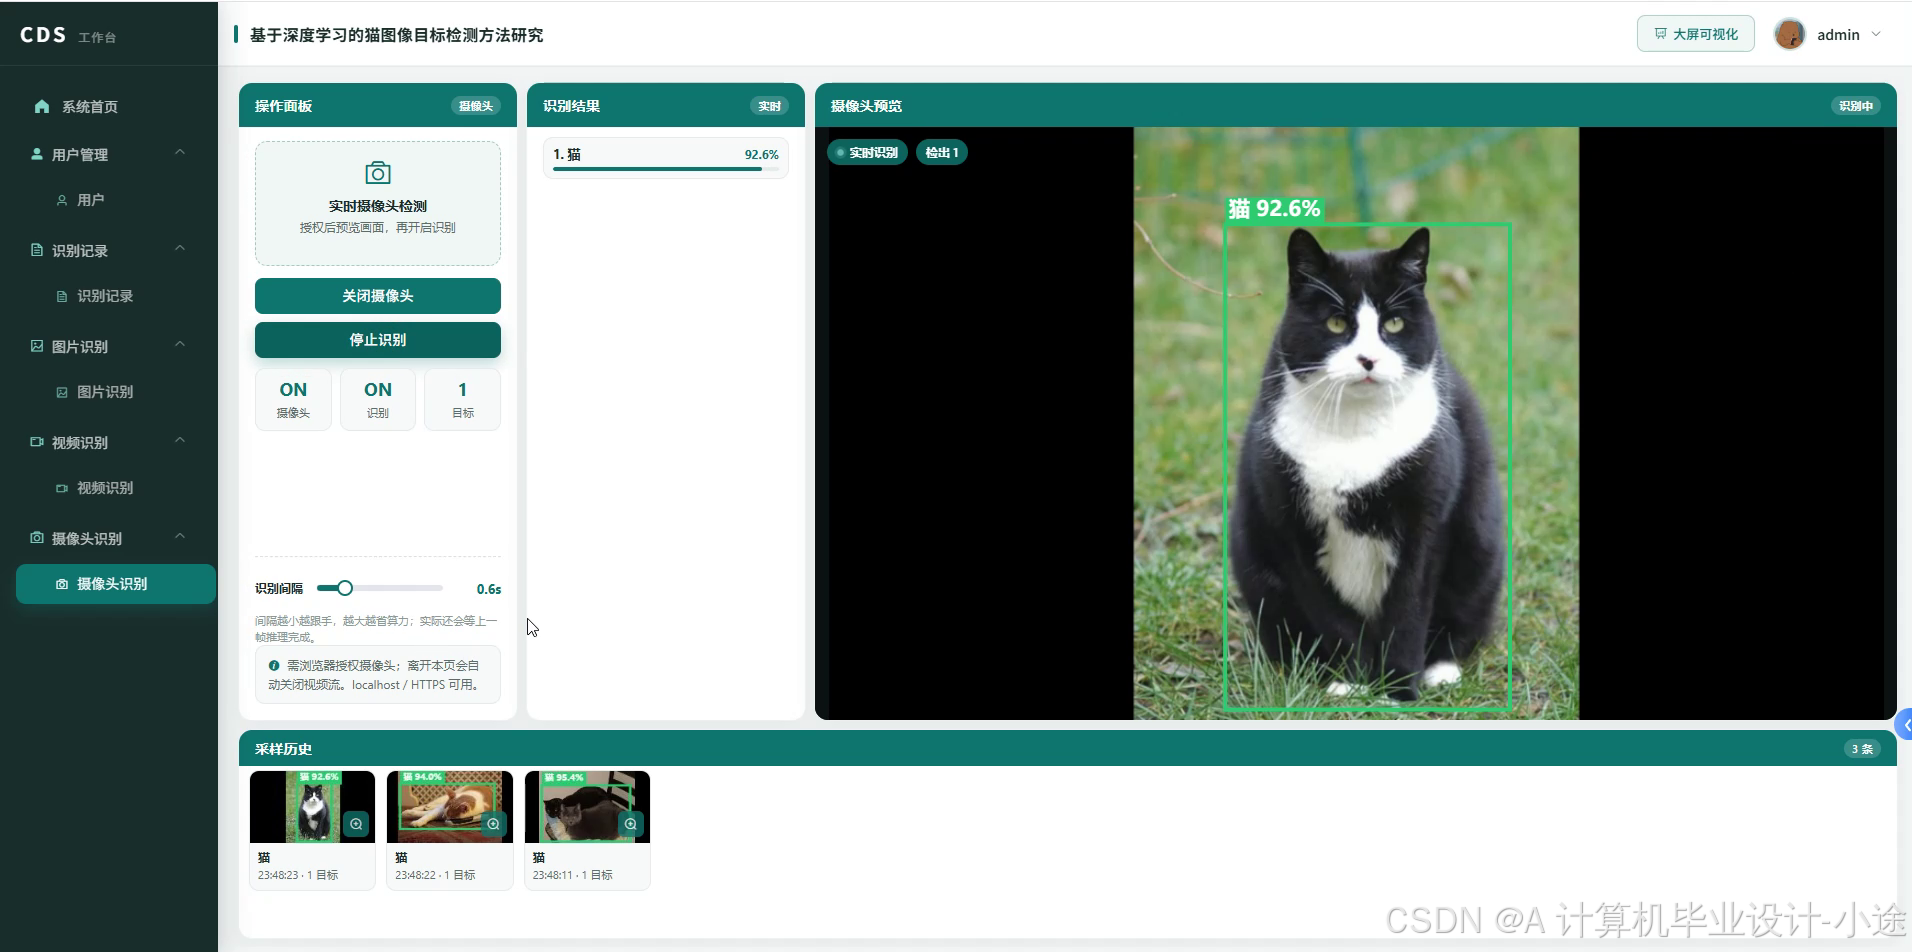
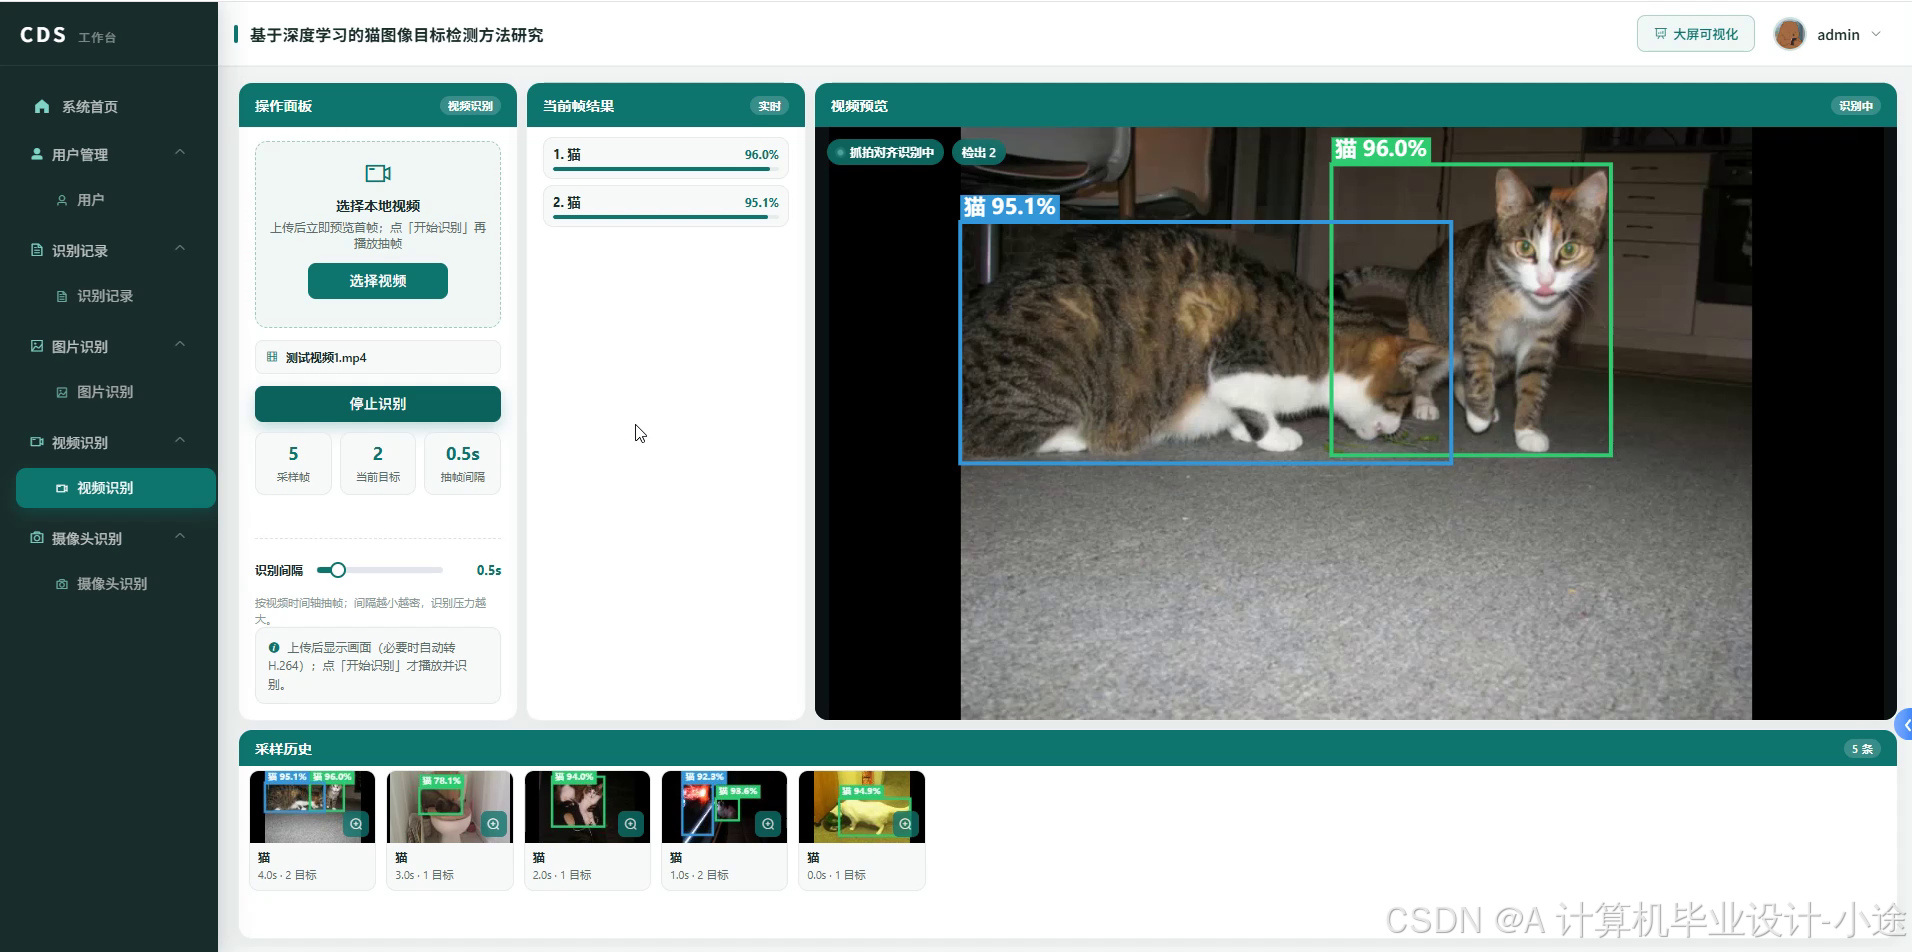
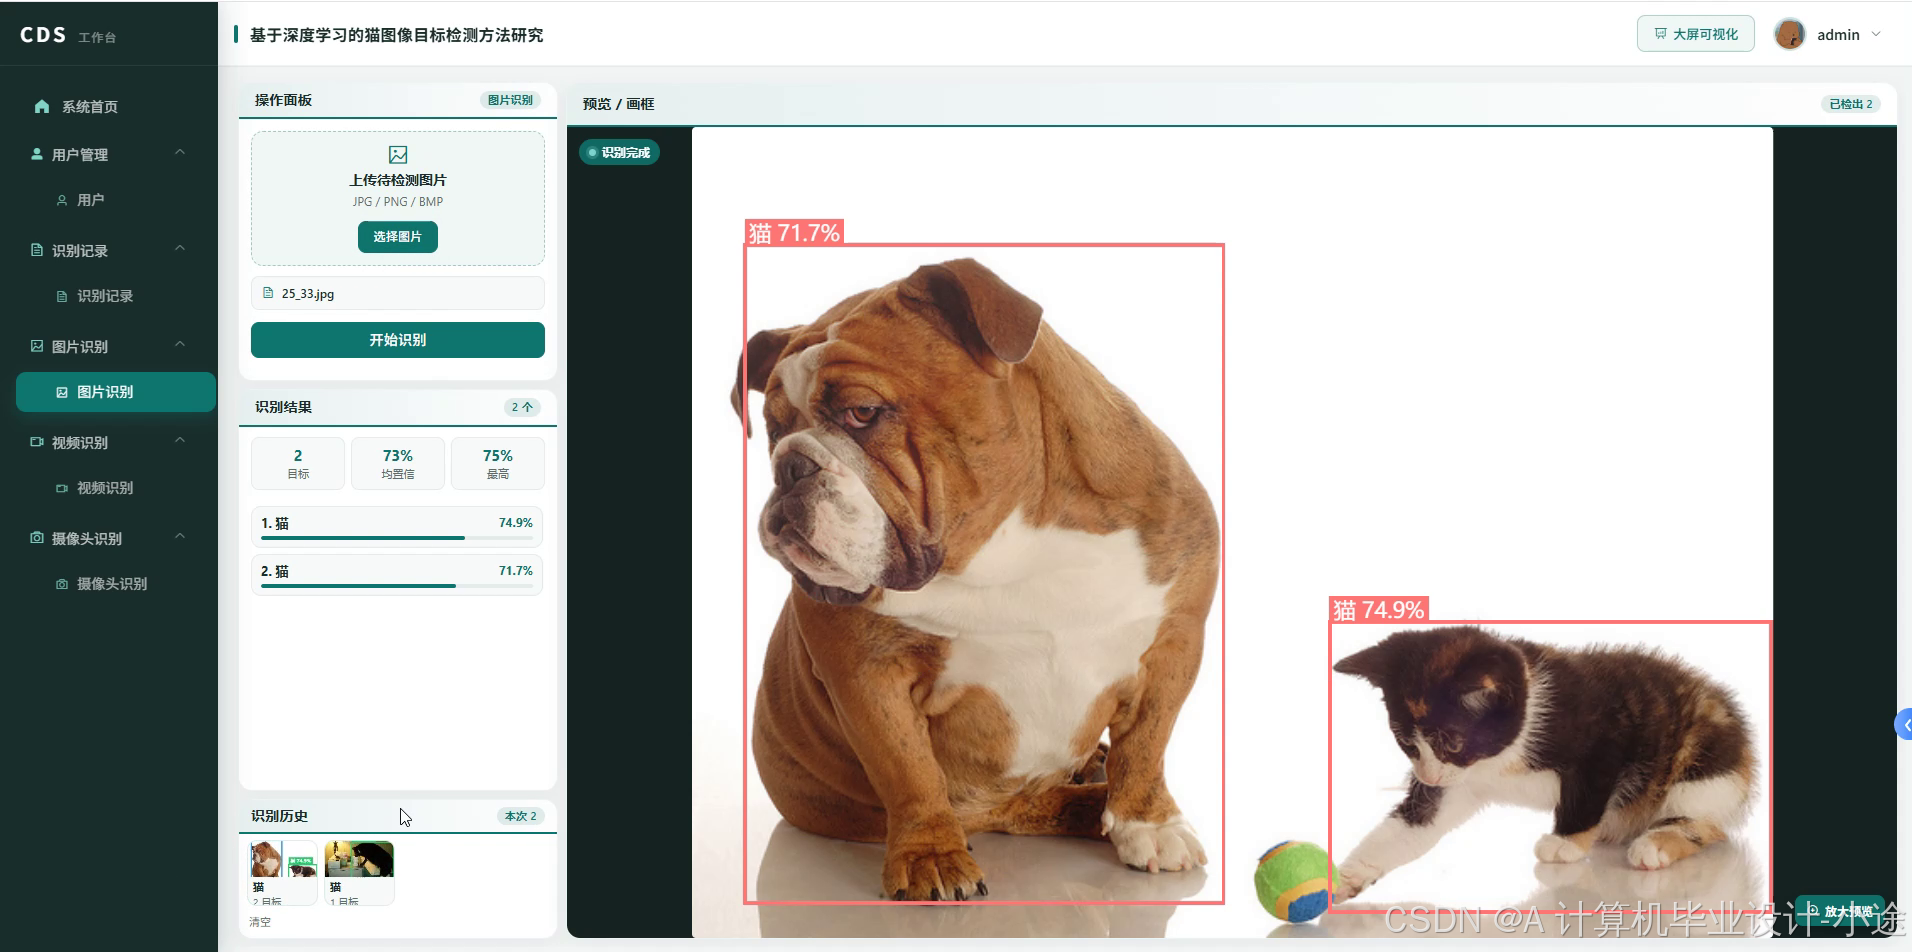
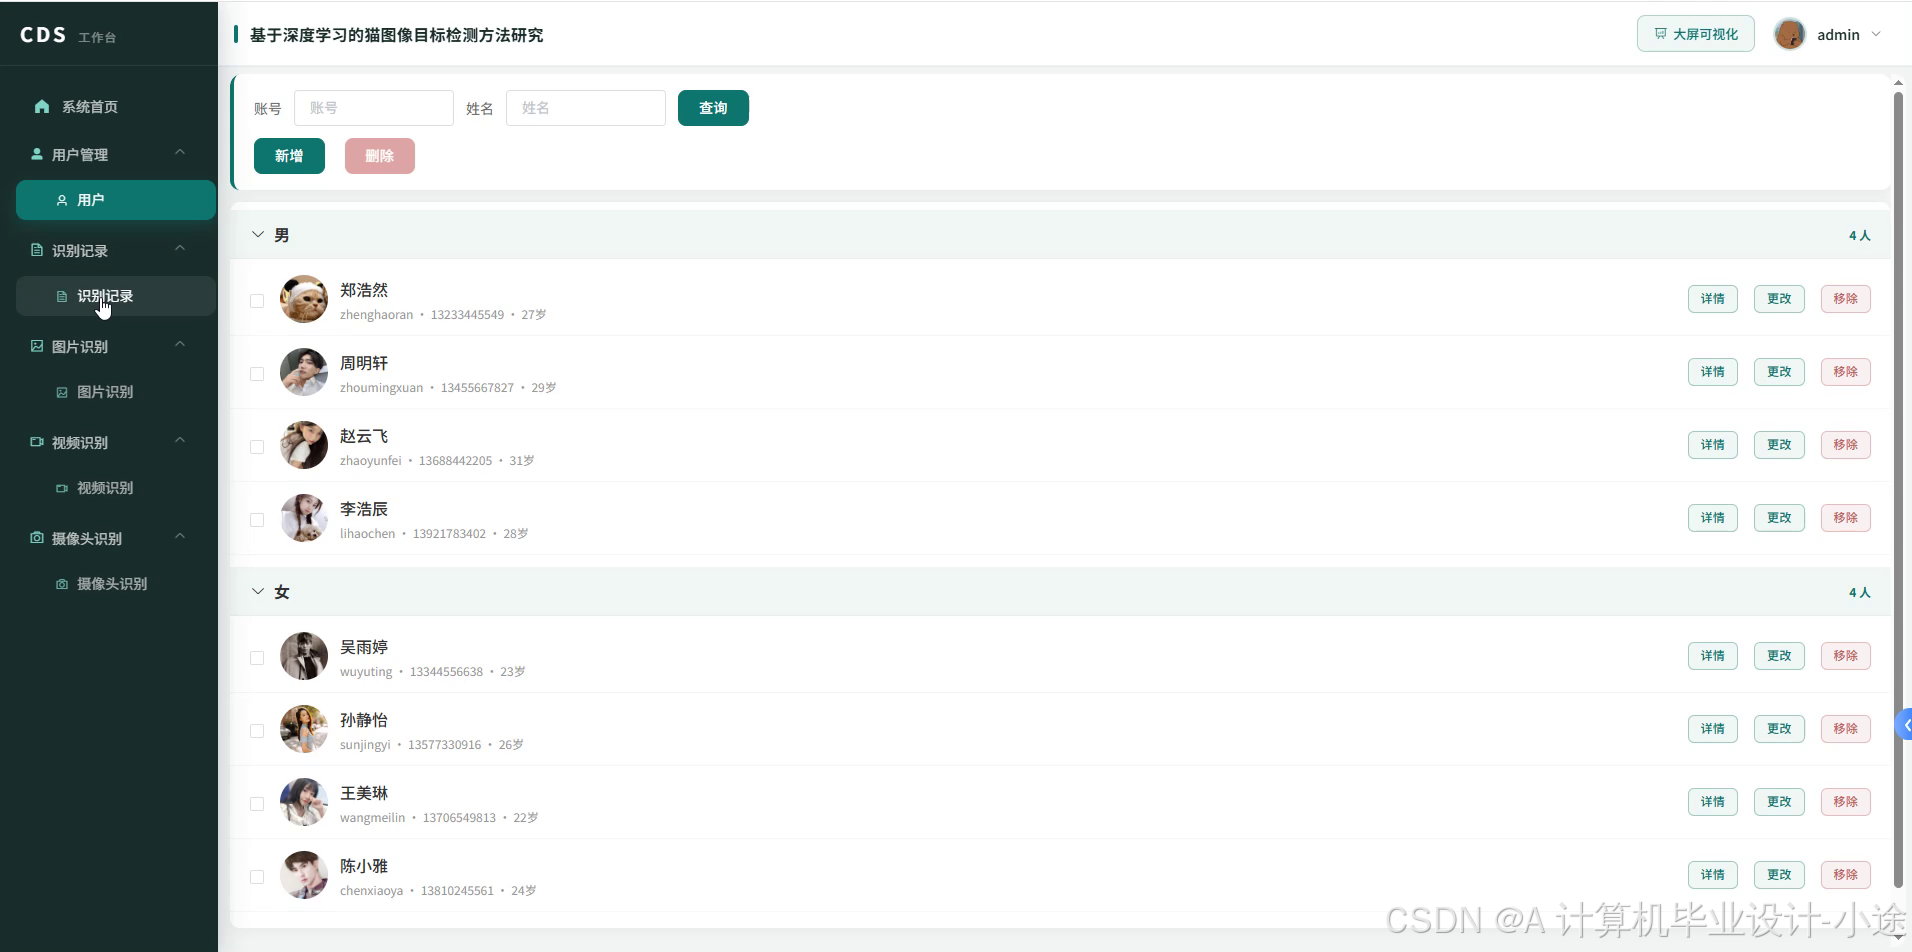
本系统《基于深度学习的猫图像目标检测方法研究》围绕猫图像的目标检测与识别记录管理展开,后端采用Python与Django搭建接口,检测模型基于PyTorch和Ultralytics YOLO完成短训、验证与best.pt导出,并支持导出ONNX后由后端加载best.onnx进行推理。前端使用Vue、ElementUI、ECharts、HTML、CSS、JavaScript和jQuery组织页面,MySQL保存用户、识别记录等业务数据。系统功能包含系统首页、数据大屏、用户管理、识别记录、图片识别、视频识别、摄像头识别、个人信息和修改密码;图片识别支持上传图片并返回检测框与类别置信度,视频识别按帧抽样汇总检测结果,摄像头识别接收前端帧数据完成实时检测,识别记录统一入库并可在数据大屏中查看统计结果。
猫图像目标检测方法研究系统演示视频
点击观看项目演示视频
猫图像目标检测方法研究系统演示图片
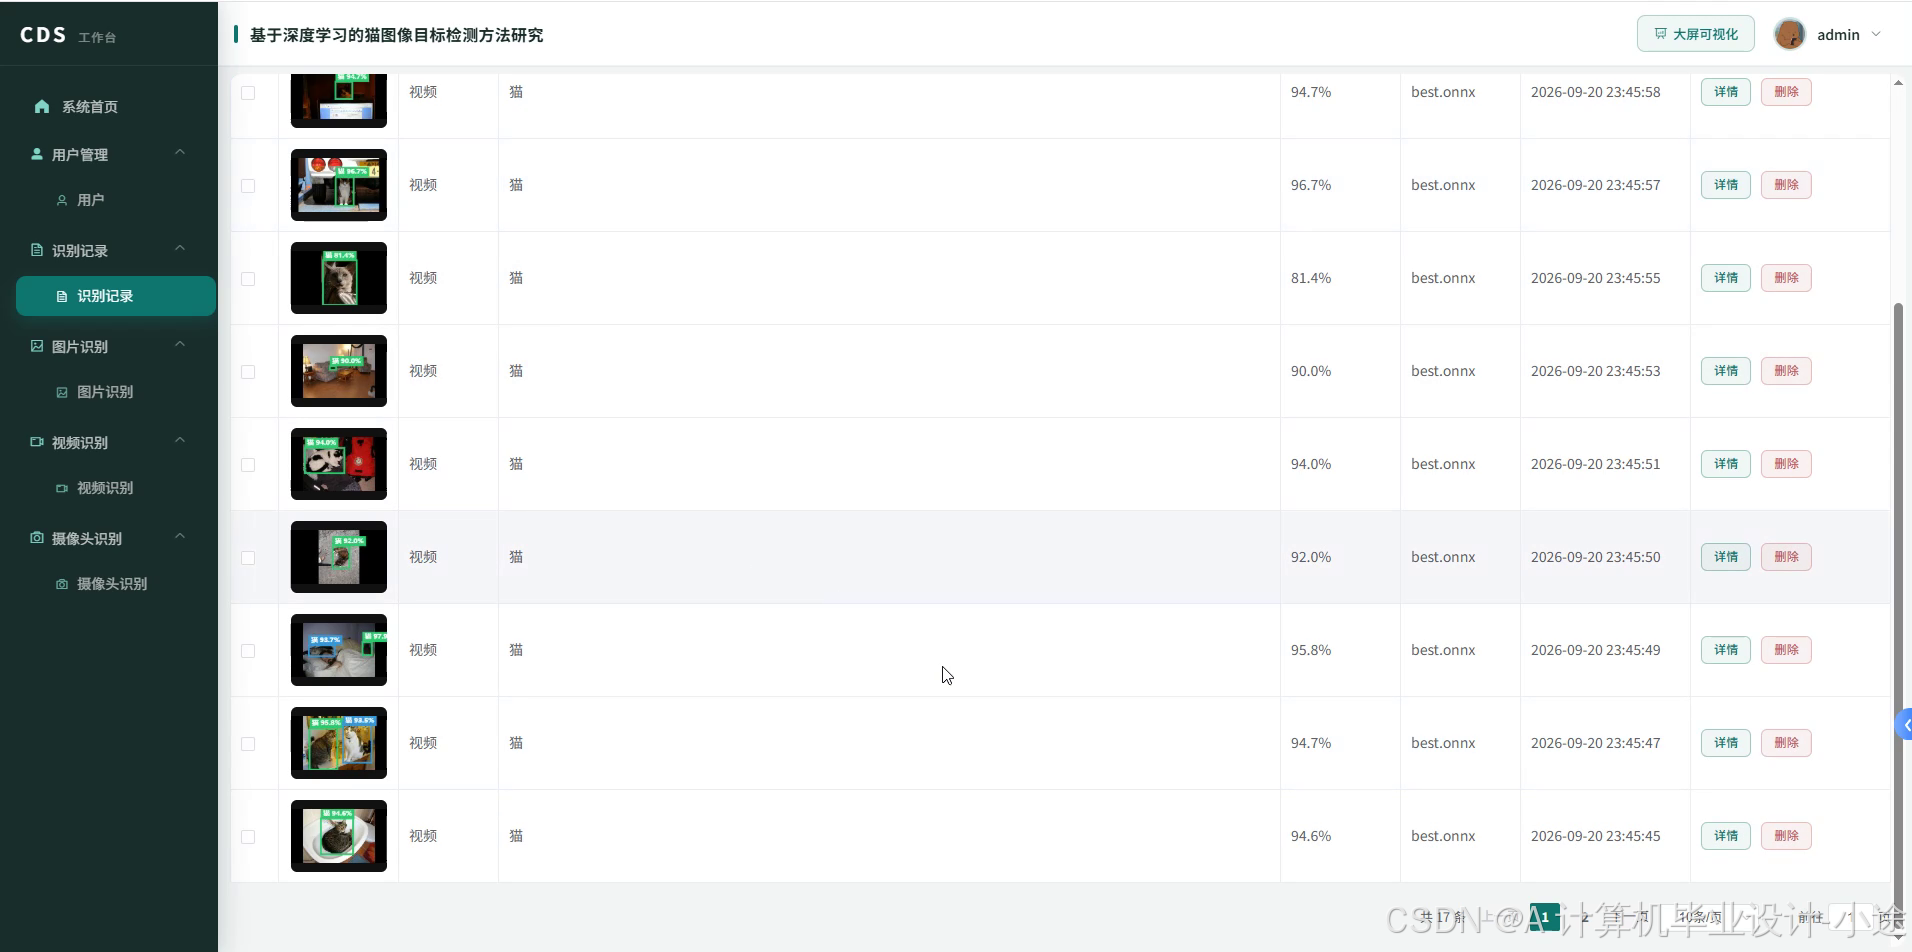
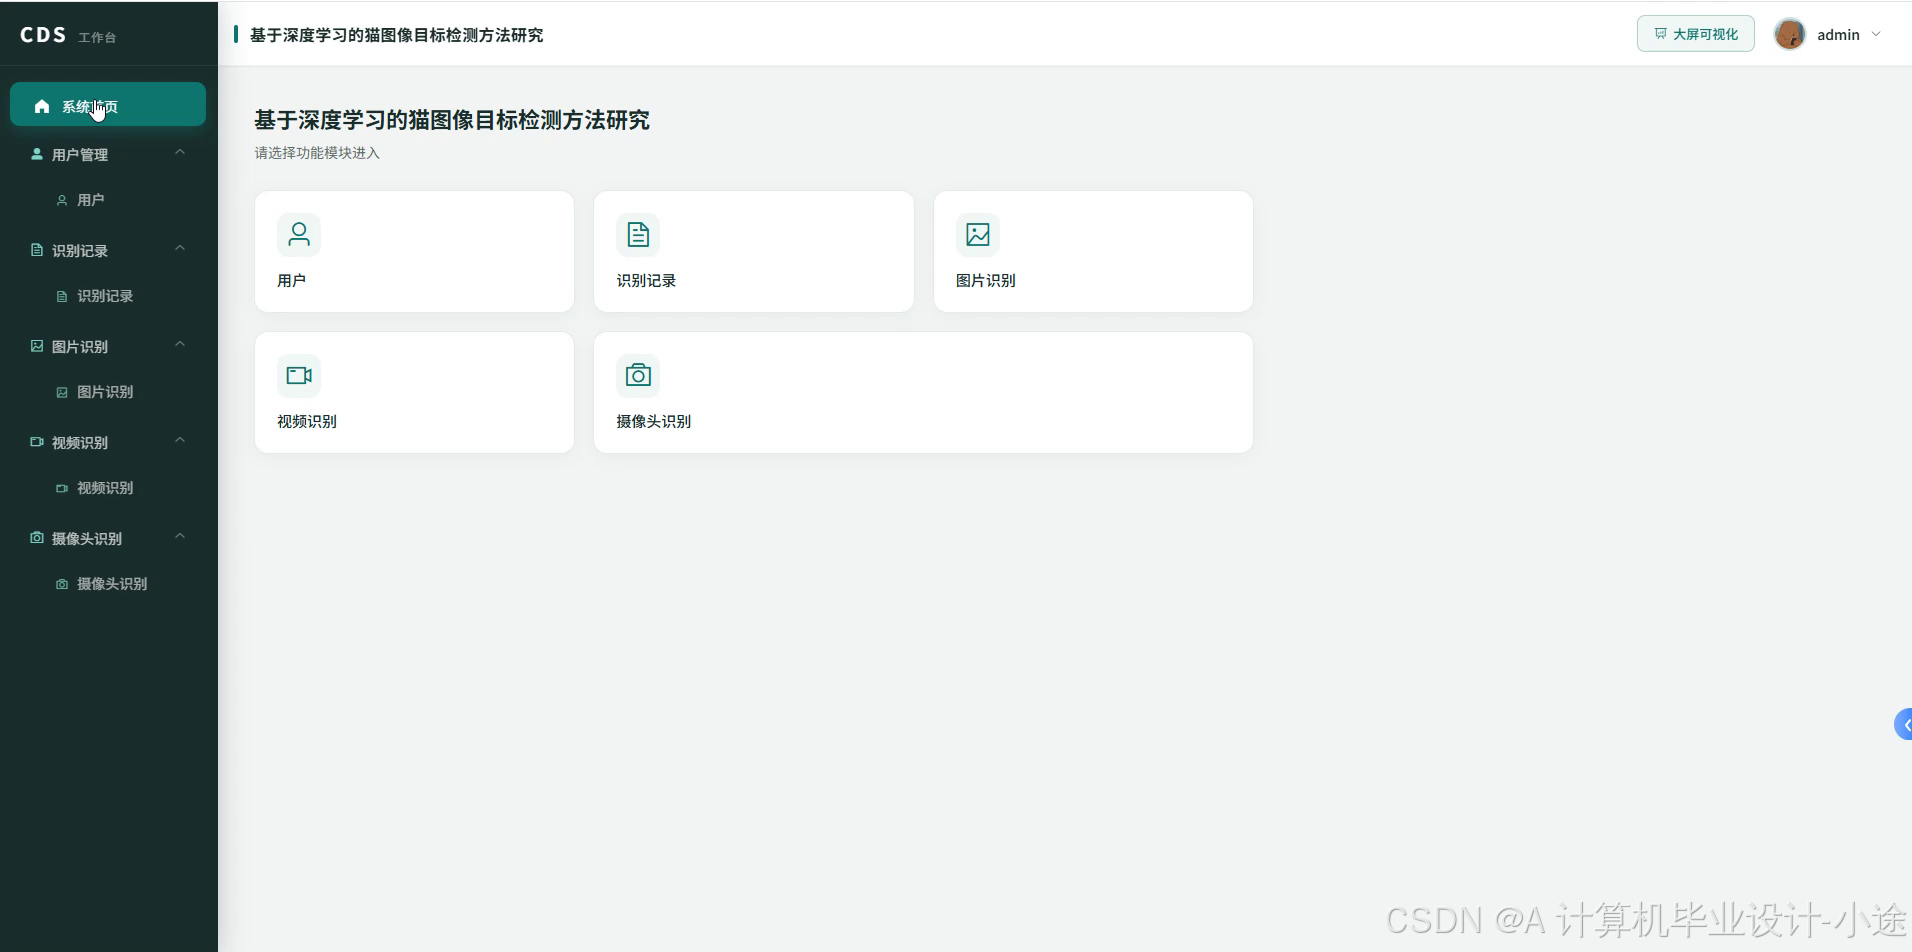
猫图像目标检测方法研究系统代码展示
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("CatDetectionBigDataRef").master("local[*]").getOrCreate()
spark_ref_count = spark.range(1).count()
from django.http import JsonResponse
from ultralytics import YOLO
from datetime import datetime
import base64
import cv2
import json
import numpy as np
import os
import tempfile
def image_detect(request):
if request.method != "POST":
return JsonResponse({"code": 400, "msg": "请使用POST上传图片"}, status=400)
image = request.FILES.get("image")
if not image:
return JsonResponse({"code": 400, "msg": "未收到图片文件"}, status=400)
if not image.name.lower().endswith((".jpg", ".jpeg", ".png", ".bmp")):
return JsonResponse({"code": 400, "msg": "图片格式不支持"}, status=400)
model = YOLO("best.pt")
temp_path = os.path.join(tempfile.gettempdir(), f"cat_img_{datetime.now().timestamp()}_{image.name}")
with open(temp_path, "wb") as f:
for chunk in image.chunks():
f.write(chunk)
results = model(temp_path, conf=0.25, iou=0.45, verbose=False)
boxes = results[0].boxes
detections = []
for box in boxes:
cls_id = int(box.cls[0].item())
conf = float(box.conf[0].item())
xyxy = [round(float(v), 2) for v in box.xyxy[0].tolist()]
detections.append({"class_id": cls_id, "class_name": results[0].names[cls_id], "confidence": round(conf, 4), "bbox": xyxy})
record = RecognitionRecord.objects.create(user_id=request.POST.get("user_id") or None, rec_type="image", source_name=image.name, result_json=json.dumps(detections, ensure_ascii=False), detect_count=len(detections))
os.remove(temp_path)
return JsonResponse({"code": 200, "msg": "图片识别完成", "record_id": record.id, "detections": detections})
def video_detect(request):
if request.method != "POST":
return JsonResponse({"code": 400, "msg": "请使用POST上传视频"}, status=400)
video = request.FILES.get("video")
if not video:
return JsonResponse({"code": 400, "msg": "未收到视频文件"}, status=400)
if not video.name.lower().endswith((".mp4", ".avi", ".mov", ".mkv")):
return JsonResponse({"code": 400, "msg": "视频格式不支持"}, status=400)
model = YOLO("best.pt")
temp_path = os.path.join(tempfile.gettempdir(), f"cat_video_{datetime.now().timestamp()}_{video.name}")
with open(temp_path, "wb") as f:
for chunk in video.chunks():
f.write(chunk)
cap = cv2.VideoCapture(temp_path)
if not cap.isOpened():
os.remove(temp_path)
return JsonResponse({"code": 400, "msg": "视频无法打开"}, status=400)
frame_index = 0
sampled_frames = 0
total_detections = 0
all_detections = []
while True:
ok, frame = cap.read()
if not ok:
break
frame_index += 1
if frame_index % 10 != 0:
continue
sampled_frames += 1
results = model(frame, conf=0.25, iou=0.45, verbose=False)
frame_detections = []
for box in results[0].boxes:
cls_id = int(box.cls[0].item())
conf = float(box.conf[0].item())
xyxy = [round(float(v), 2) for v in box.xyxy[0].tolist()]
frame_detections.append({"class_id": cls_id, "class_name": results[0].names[cls_id], "confidence": round(conf, 4), "bbox": xyxy})
total_detections += len(frame_detections)
if frame_detections:
all_detections.append({"frame": frame_index, "detections": frame_detections})
cap.release()
os.remove(temp_path)
record = RecognitionRecord.objects.create(user_id=request.POST.get("user_id") or None, rec_type="video", source_name=video.name, result_json=json.dumps(all_detections, ensure_ascii=False), detect_count=total_detections)
return JsonResponse({"code": 200, "msg": "视频识别完成", "record_id": record.id, "sampled_frames": sampled_frames, "detect_count": total_detections})
def camera_detect(request):
if request.method != "POST":
return JsonResponse({"code": 400, "msg": "请使用POST上传摄像头帧"}, status=400)
frame_data = request.POST.get("frame") or ""
if not frame_data:
return JsonResponse({"code": 400, "msg": "未收到摄像头帧数据"}, status=400)
if "," in frame_data:
frame_data = frame_data.split(",", 1)[1]
try:
img_bytes = base64.b64decode(frame_data)
except Exception:
return JsonResponse({"code": 400, "msg": "帧数据解析失败"}, status=400)
np_arr = np.frombuffer(img_bytes, np.uint8)
frame = cv2.imdecode(np_arr, cv2.IMREAD_COLOR)
if frame is None:
return JsonResponse({"code": 400, "msg": "帧图片无法读取"}, status=400)
model = YOLO("best.pt")
results = model(frame, conf=0.25, iou=0.45, verbose=False)
detections = []
for box in results[0].boxes:
cls_id = int(box.cls[0].item())
conf = float(box.conf[0].item())
xyxy = [round(float(v), 2) for v in box.xyxy[0].tolist()]
detections.append({"class_id": cls_id, "class_name": results[0].names[cls_id], "confidence": round(conf, 4), "bbox": xyxy})
record = RecognitionRecord.objects.create(user_id=request.POST.get("user_id") or None, rec_type="camera", source_name="camera_frame", result_json=json.dumps(detections, ensure_ascii=False), detect_count=len(detections))
return JsonResponse({"code": 200, "msg": "摄像头识别完成", "record_id": record.id, "detections": detections})
猫图像目标检测方法研究系统文档展示
💖💖作者:计算机毕业设计小途 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目


评论前必须登录!
注册