 网硕互联帮助中心
《Java并发编程之美》第 1 章 并发编程线程基础 阅读笔记 2
1.8 理解线程上下文切换
在多线程编程中,线程个数一般都大于 CPU 个数,而每个 CPU 同一时刻只能被一个线程使用,
为了让用户感觉多个线程是在同时执行的,CPU 资源的分配采用了时间片轮转的策略,
也就是给每个线程分配一个时间片,线程在时间片内占用 CPU 执行任务。
当前线程使用完时间片后,就会处于就绪状态并让出 CPU 让其他线程占用,这就是上下文切换,
从当前线程的上下文切换到了其他线程。那么就有一个问题,让出 CPU 的线程等下次轮到自己占有 CPU 时如何知道自己之前运行到哪里了?
所以在切换线程上下文时需要保存当前线程的执行现场,当再次执行时根据保存的执行现场信息恢复执行现场。
线程上下文切换时机有:
当前线程的 CPU 时间片使用完处于就绪状态时,
当前线程被其他线程中断时。
1.9 线程死锁
1.9.1 什么是线程死锁
死锁是指两个或两个以上的线程在执行过程中,因争夺资源而造成的互相等待的现象,
在无外力作用的情况下,这些线程会一直互相等待而无法继续运行下去,如图 1-2 所示。
图 1-2
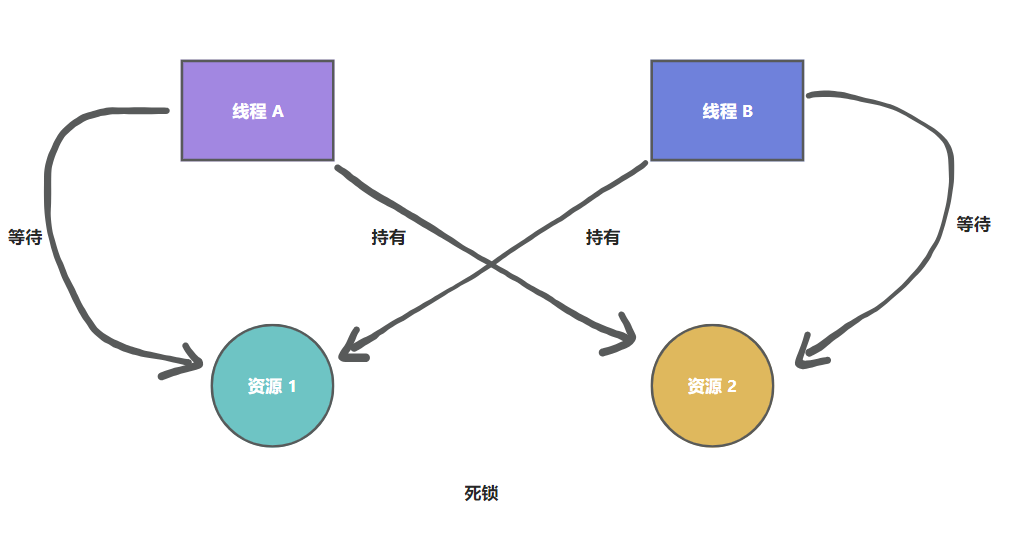
在图 1-2 中,线程 A 已经持有了资源 2,它同时还想申请资源 1,线程 B 已经持有了资源 1,它同时还想申请资源 2,
所以线程 1 和线程 2 就因为相互等待对方已经持有的资源,而进入了死锁状态。
那么为什么会产生死锁呢?学过操作系统的朋友应该都知道,死锁的产生必须具备以下四个条件。
- 互斥条件:指线程对已经获取到的资源进行排它性使用,即该资源同时只由一个线程占用。如果此时还有其他线程请求获取该资源,则请求者只能等待,直至占有资源的线程释放该资源。
- 请求并持有条件:指一个线程已经持有了至少一个资源,但又提出了新的资源请求,而新资源已被其他线程占有,所以当前线程会被阻塞,但阻塞的同时并不释放自己已经获取的资源。
- 不可剥夺条件:指线程获取到的资源在自己使用完之前不能被其他线程抢占,只有在自己使用完毕后才由自己释放该资源。
- 环路等待条件:指在发生死锁时,必然存在一个线程—资源的环形链,即线程集合 {T0, T1, T2, …, Tn} 中的 T0 正在等待一个 T1 占用的资源,T1 正在等待 T2 占用的资源,……Tn 正在等待已被 T0 占用的资源。
下面通过一个例子来说明线程死锁。
package com.yangjunbo.juc.one;
public class DeadLockTest2 {
// 创建资源
private static Object resourceA = new Object();
private static Object resourceB = new Object();
public static void main(String[] args) {
// 创建线程A
Thread threadA = new Thread(new Runnable() {
public void run() {
synchronized (resourceA) {
System.out.println(Thread.currentThread() + " get ResourceA");
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println(Thread.currentThread() + "waiting get sourceB");
synchronized (resourceB) {
System.out.println(Thread.currentThread() + "get esourceB");
}
}
}
});
// 创建线程B
Thread threadB = new Thread(new Runnable() {
public void run() {
synchronized (resourceB) {
System.out.println(Thread.currentThread() + " get ResourceB");
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println(Thread.currentThread() + "waiting get esourceA");
synchronized (resourceA) {
System.out.println(Thread.currentThread() + "get ResourceA");
}
}
;
}
});
// 启动线程
threadA.start();
threadB.start();
}
}
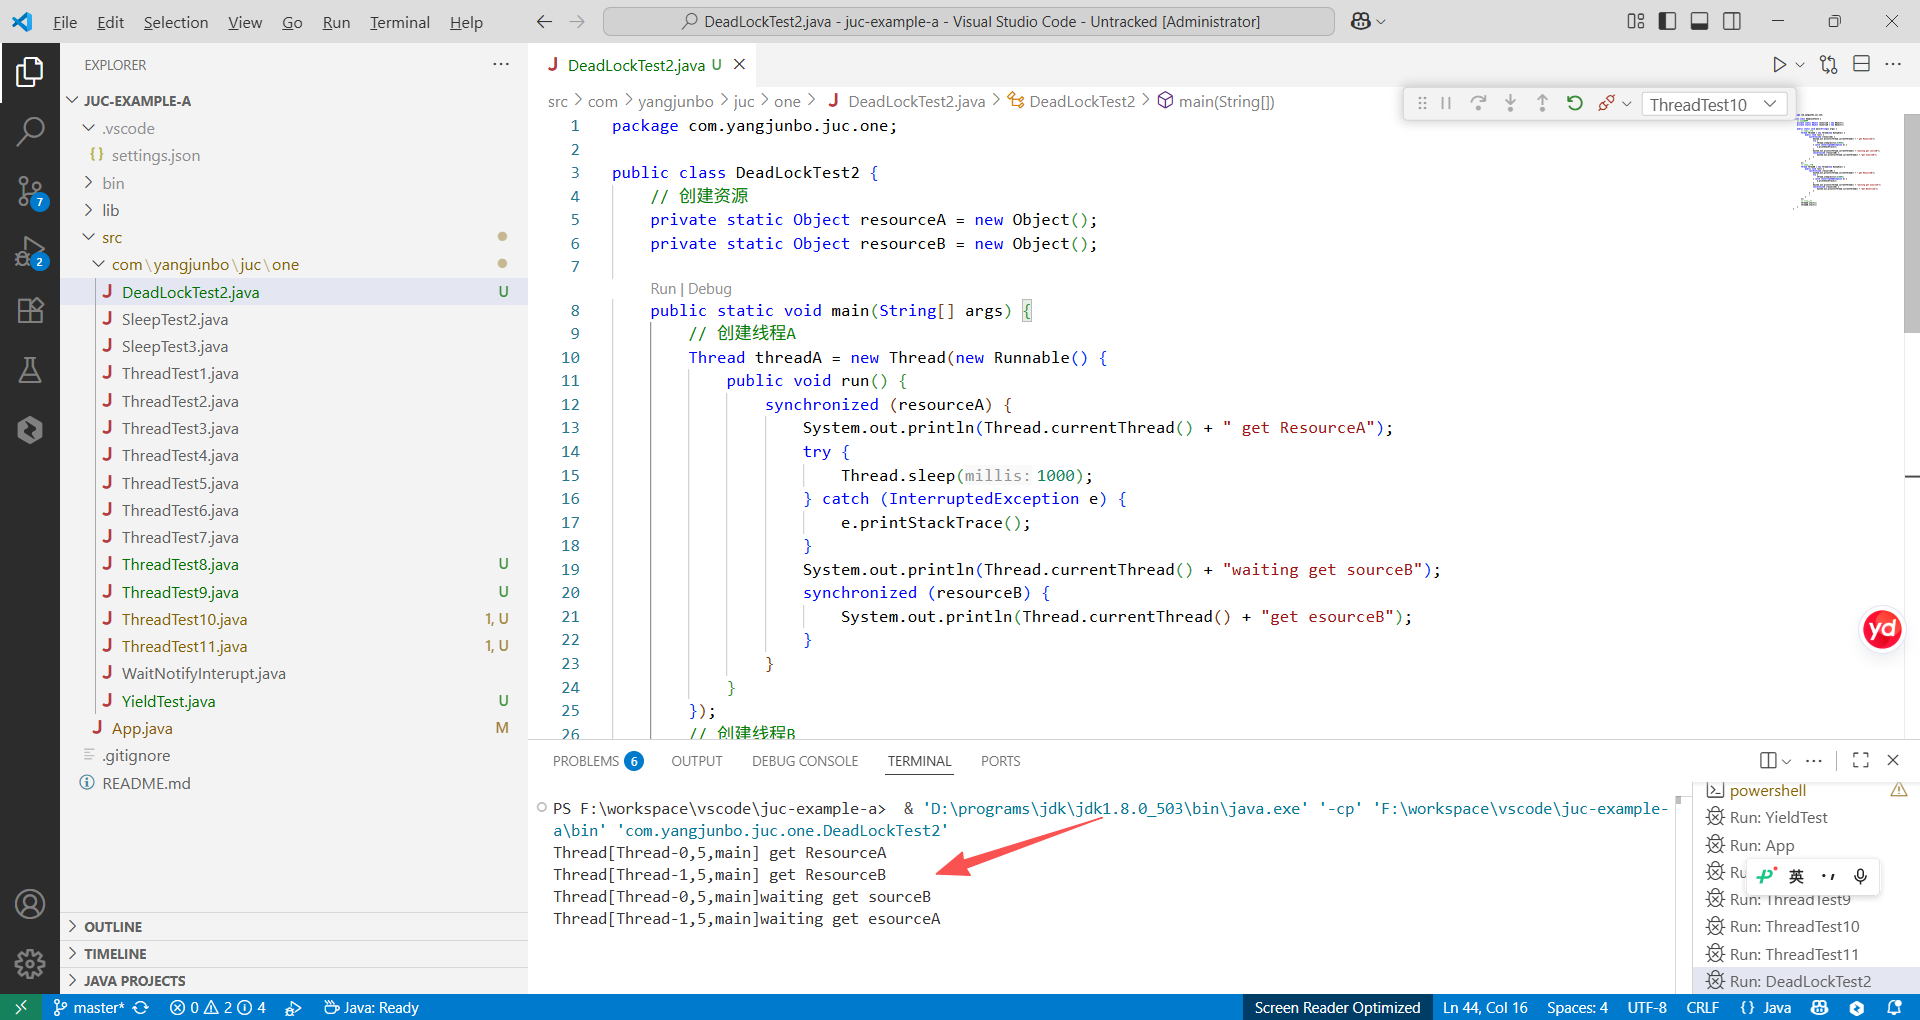
输出结果如下。
下面分析代码和结果:
Thread-0 是线程 A, Thread-1 是线程 B,代码首先创建了两个资源,并创建了两个线程。
从输出结果可以知道,线程调度器先调度了线程 A,也就是把 CPU 资源分配给了线程 A,
线程 A 使用 synchronized(resourceA) 方法获取到了 resourceA 的监视器锁,
然后调用 sleep 函数休眠 1s,休眠 1s 是为了保证线程 A 在获取 resourceB 对应的锁前让线程 B 抢占到 CPU,获取到资源 resourceB 上的锁。线程 A 调用 sleep 方法后线程 B 会执行 synchronized(resourceB) 方法,这代表线程 B 获取到了 resourceB 对象的监视器锁资源,然后调用sleep 函数休眠 1s。
好了,到了这里线程 A 获取到了 resourceA 资源,线程 B 获取到了 resourceB 资源。
线程 A 休眠结束后会企图获取 resourceB 资源,而 resourceB 资源被线程 B 所持有,所以线程 A 会被阻塞而等待。
而同时线程 B 休眠结束后会企图获取 resourceA 资源,而 resourceA 资源已经被线程 A 持有,
所以线程 A 和线程 B 就陷入了相互等待的状态,也就产生了死锁。
下面谈谈本例是如何满足死锁的四个条件的。
首先,resourceA 和 resourceB 都是互斥资源,
当线程 A 调用 synchronized(resourceA) 方法获取到 resourceA 上的监视器锁并释放前,
线程 B 再调用 synchronized(resourceA) 方法尝试获取该资源会被阻塞,
只有线程 A 主动释放该锁,线程 B 才能获得,这满足了资源互斥条件。
线程 A 首先通过 synchronized(resourceA) 方法获取到 resourceA 上的监视器锁资源,
然后通过 synchronized(resourceB) 方法等待获取 resourceB 上的监视器锁资源,这就构成了请求并持有条件。
线程 A 在获取 resourceA 上的监视器锁资源后,该资源不会被线程 B 掠夺走,
只有线程 A 自己主动释放 resourceA 资源时,它才会放弃对该资源的持有权,这构成了资源的不可剥夺条件。
线程 A 持有 resourceA 资源并等待获取 resourceB 资源,而线程 B 持有 resourceB 资源并等待 resourceA 资源,这构成了环路等待条件。
所以线程 A 和线程 B 就进入了死锁状态。
1.9.2 如何避免线程死锁
要想避免死锁,只需要破坏掉至少一个构造死锁的必要条件即可,
但是学过操作系统的读者应该都知道,目前只有请求并持有和环路等待条件是可以被破坏的。
造成死锁的原因其实和申请资源的顺序有很大关系,使用资源申请的有序性原则就可以避免死锁,那么什么是资源申请的有序性呢?
我们对上面线程 B 的代码进行如下修改。把线程 B 的 synchronized (resourceA) 和 synchronized (resourceB) 改为与线程 A 顺序一致。
// 创建线程B
Thread threadB = new Thread(new Runnable() {
public void run() {
synchronized (resourceA) {
System.out.println(Thread.currentThread() + " get ResourceB");
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println(Thread.currentThread() + "waiting get ResourceA");
synchronized (resourceB) {
System.out.println(Thread.currentThread() + "get ResourceA");
}
}
;
}
});
输出结果如下。
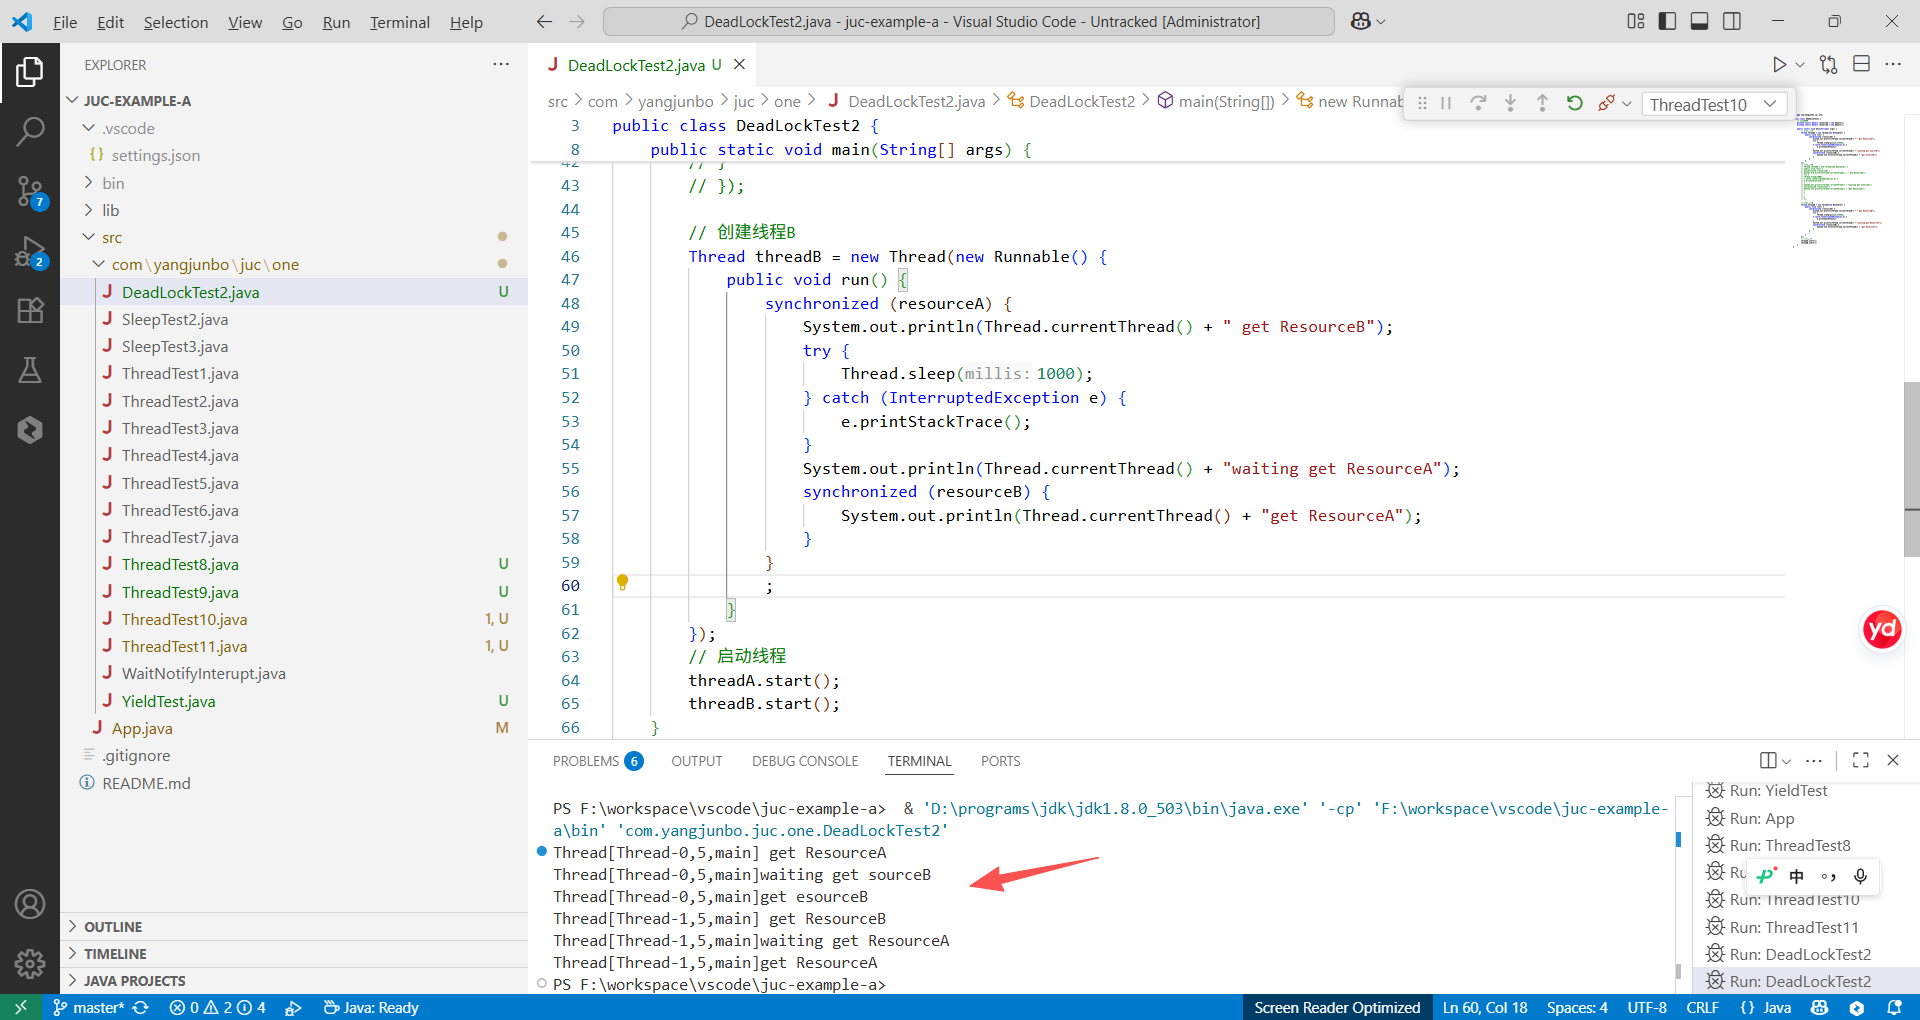
如上代码让在线程 B 中获取资源的顺序和在线程 A 中获取资源的顺序保持一致,其实资源分配有序性就是指,假如线程 A 和线程 B 都需要资源1,2,3, …, n 时,对资源进行排序,线程 A 和线程 B 只有在获取了资源 n-1 时才能去获取资源 n。
我们可以简单分析一下为何资源的有序分配会避免死锁,比如上面的代码,
假如线程 A 和线程 B 同时执行到了 synchronized(resourceA),只有一个线程可以获取到 resourceA 上的监视器锁,
假如线程 A 获取到了,那么线程 B 就会被阻塞而不会再去获取资源 B,
线程 A 获取到 resourceA 的监视器锁后会去申请 resourceB 的监视器锁资源,这时候线程 A 是可以获取到的,
线程 A 获取到 resourceB 资源并使用后会放弃对资源 resourceB 的持有,然后再释放对 resourceA 的持有,
释放 resourceA 后线程 B 才会被从阻塞状态变为激活状态。
所以资源的有序性破坏了资源的请求并持有条件和环路等待条件,因此避免了死锁。
1.10 守护线程与用户线程
Java 中的线程分为两类,分别为 daemon 线程(守护线程)和 user 线程(用户线程)。
在 JVM 启动时会调用 main 函数,main 函数所在的线程就是一个用户线程,
其实在 JVM 内部同时还启动了好多守护线程,比如垃圾回收线程。
那么守护线程和用户线程有什么区别呢?
区别之一是当最后一个非守护线程结束时,JVM 会正常退出,而不管当前是否有守护线程,
也就是说守护线程是否结束并不影响 JVM 的退出。
言外之意,只要有一个用户线程还没结束,正常情况下 JVM 就不会退出。
那么在 Java 中如何创建一个守护线程?代码如下。
public static void main(String[] args) {
Thread daemonThread = new Thread(new Runnable() {
public void run() {
}
});
//设置为守护线程
daemonThread.setDaemon(true);
daemonThread.start();
}
只需要设置线程的 daemon 参数为 true 即可。
下面通过例子来理解用户线程与守护线程的区别。首先看下面的代码。
package com.yangjunbo.juc.one;
public class ThreadTest12 {
public static void main(String[] args) {
Thread thread = new Thread(new Runnable() {
public void run() {
for (;;) {
}
}
});
// 启动子线程
thread.start();
System.out.print("main thread is over");
}
}
输出结果如下。
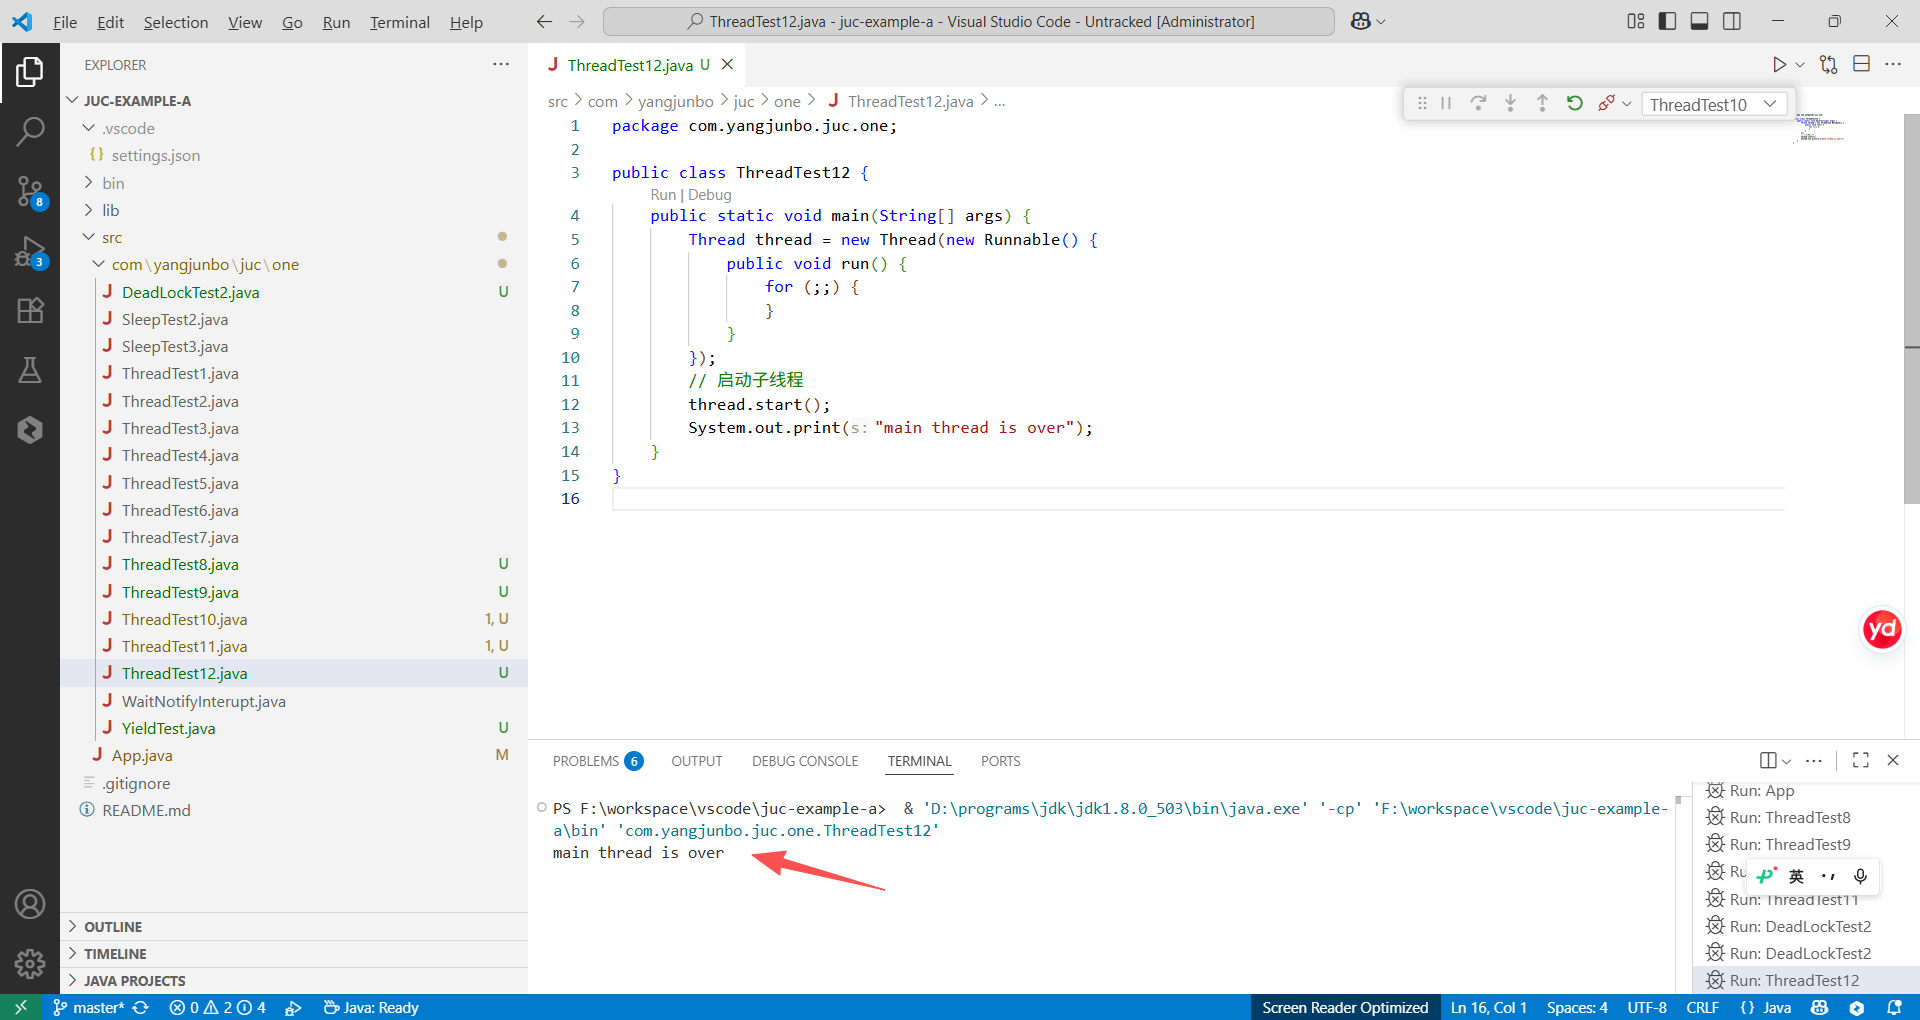
如上代码在 main 线程中创建了一个 thread 线程,在 thread 线程里面是一个无限循环。
从运行代码的结果看,main 线程已经运行结束了,那么 JVM 进程已经退出了吗?
在 IDE 的输出结果右上侧的红色方块说明,JVM 进程并没有退出。
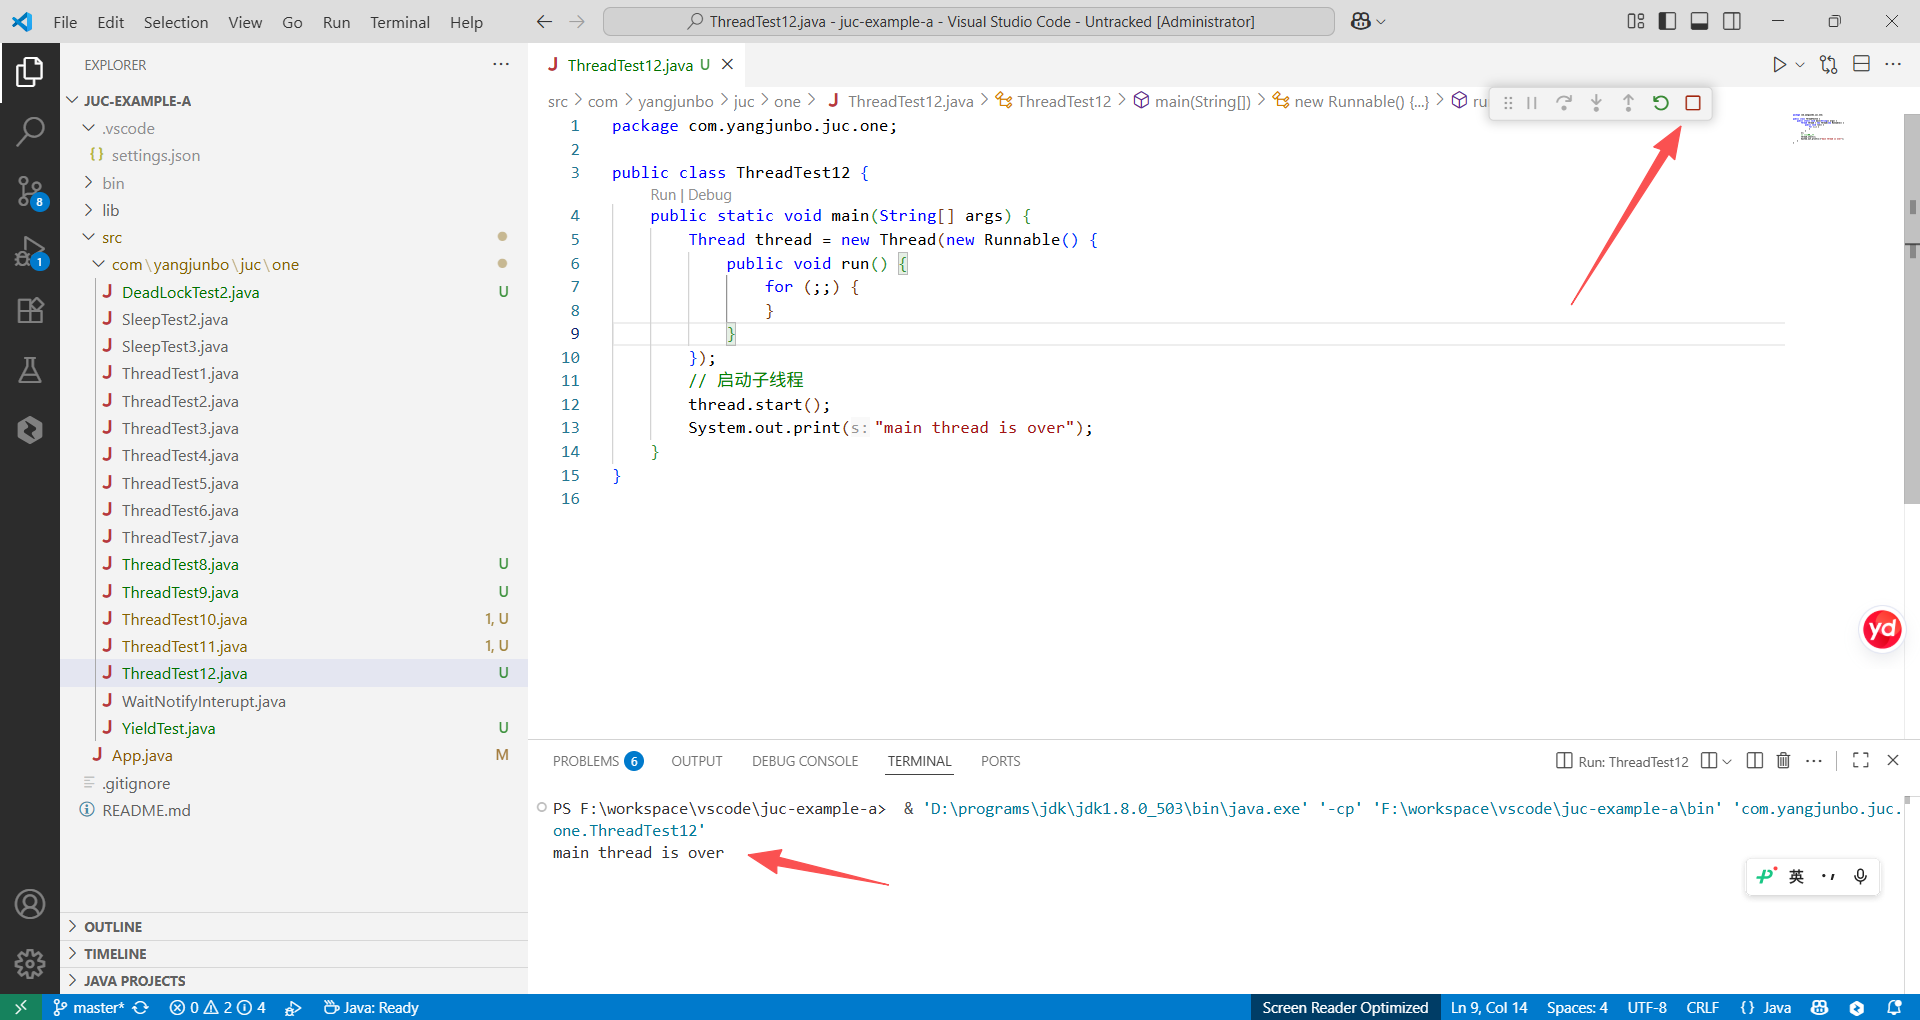
另外,执行 jps 会输出如下结果。
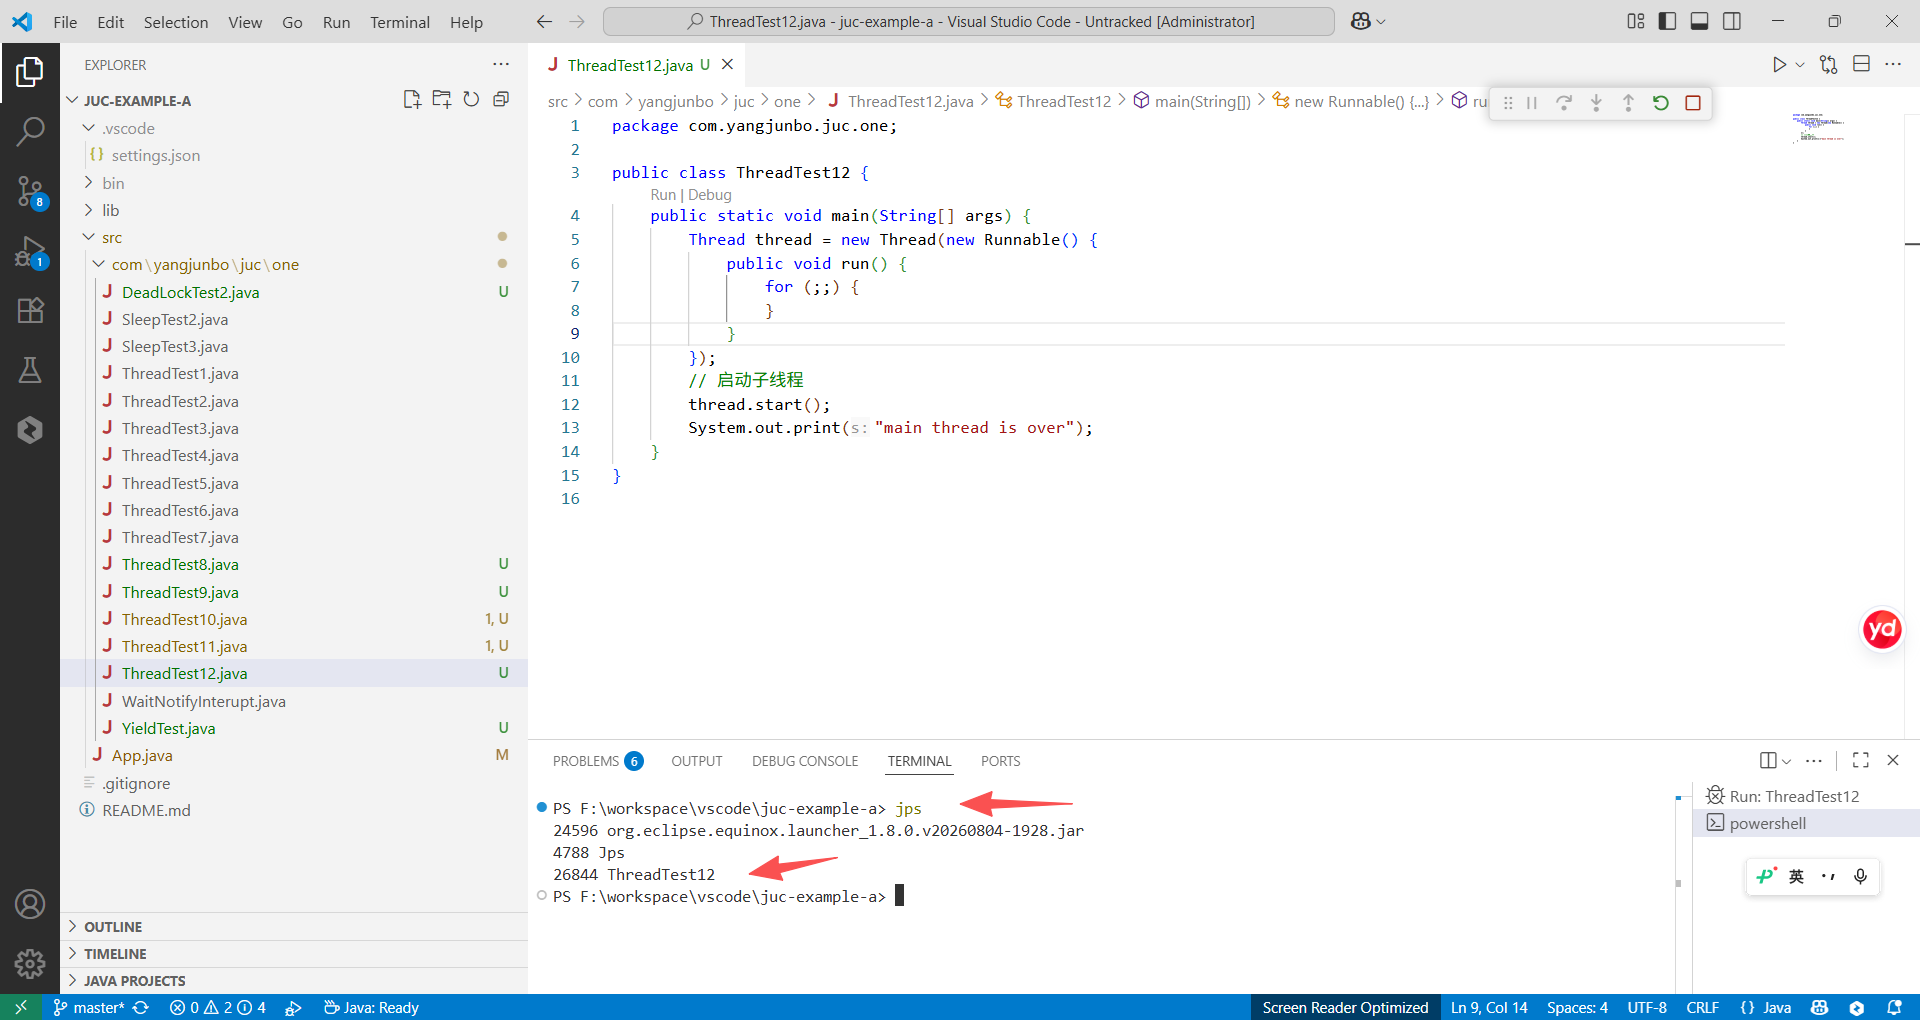
这个结果说明了当父线程结束后,子线程还是可以继续存在的,也就是子线程的生命周期并不受父线程的影响。
这也说明了在用户线程还存在的情况下 JVM 进程并不会终止。
那么我们把上面的 thread 线程设置为守护线程后,再来运行看看会有什么结果:
//设置为守护线程
thread.setDaemon(true);
//启动子线程
thread.start();
输出结果如下。
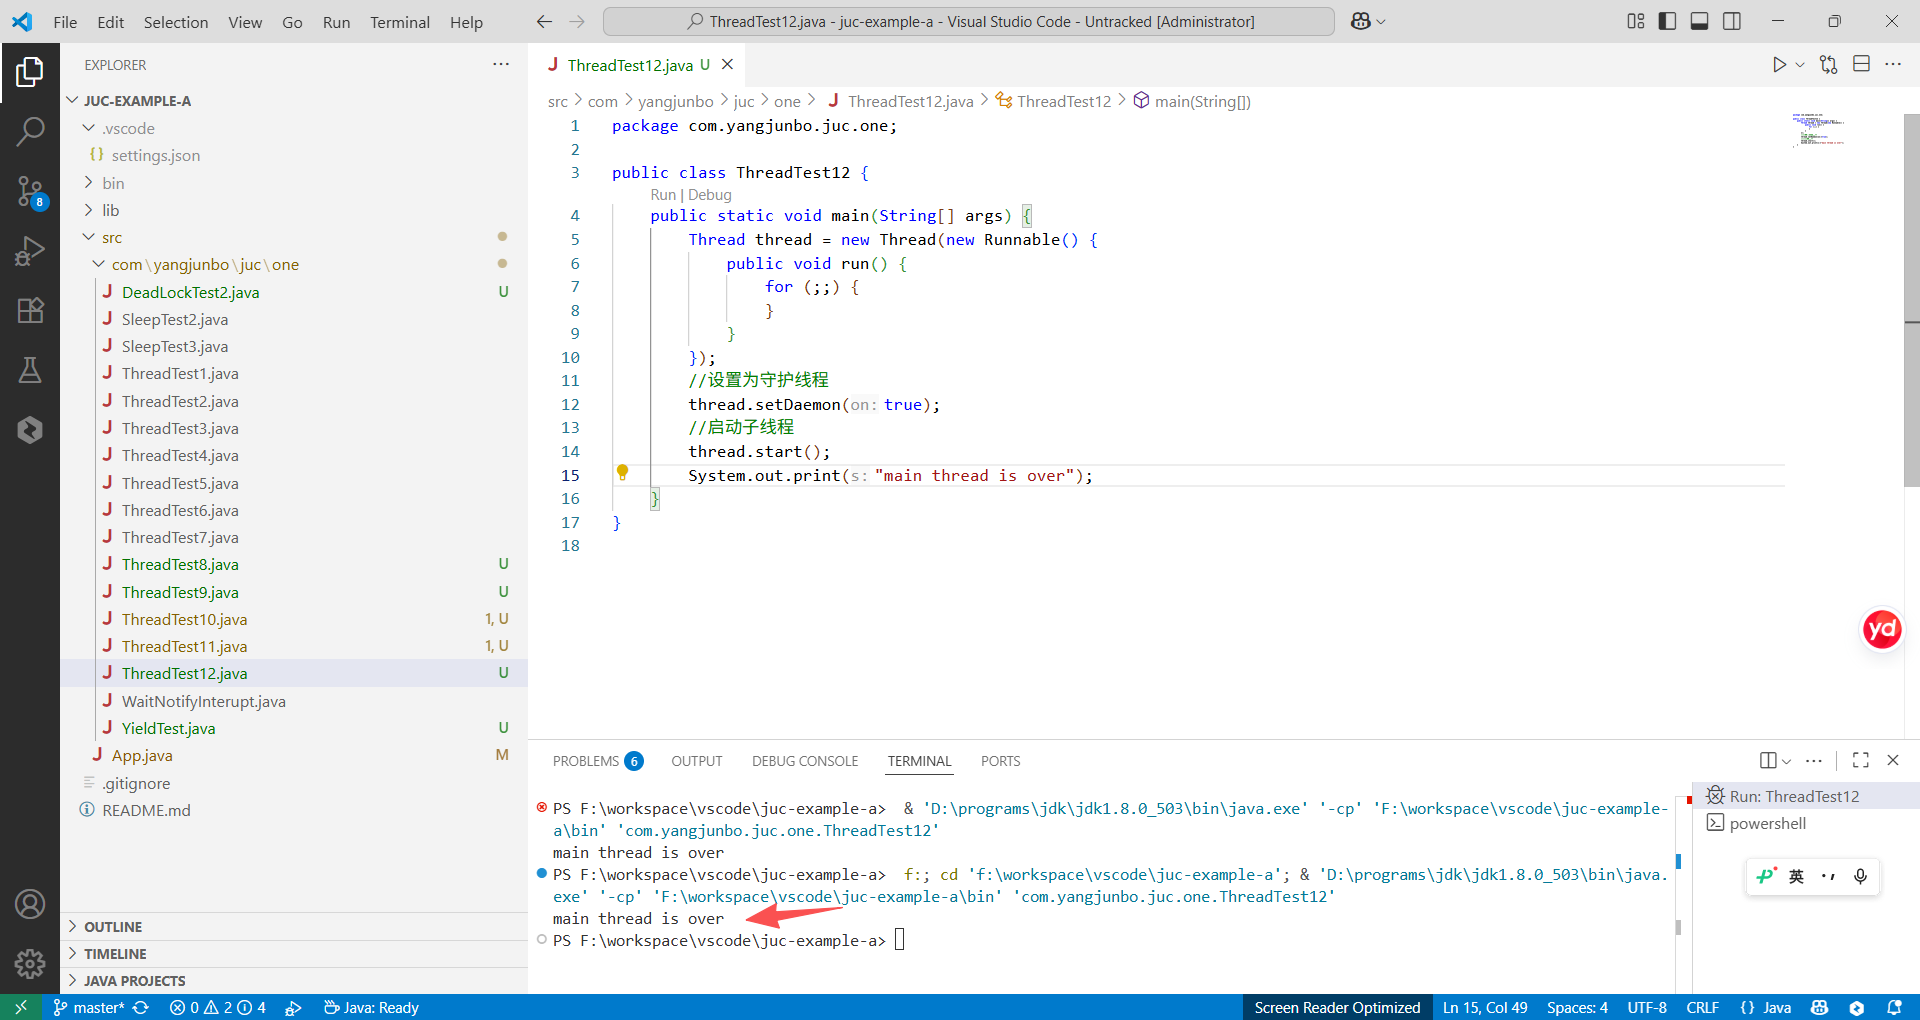
在启动线程前将线程设置为守护线程,执行后的输出结果显示,JVM 进程已经终止了,
执行 jps 也看不到 JVM 进程了。
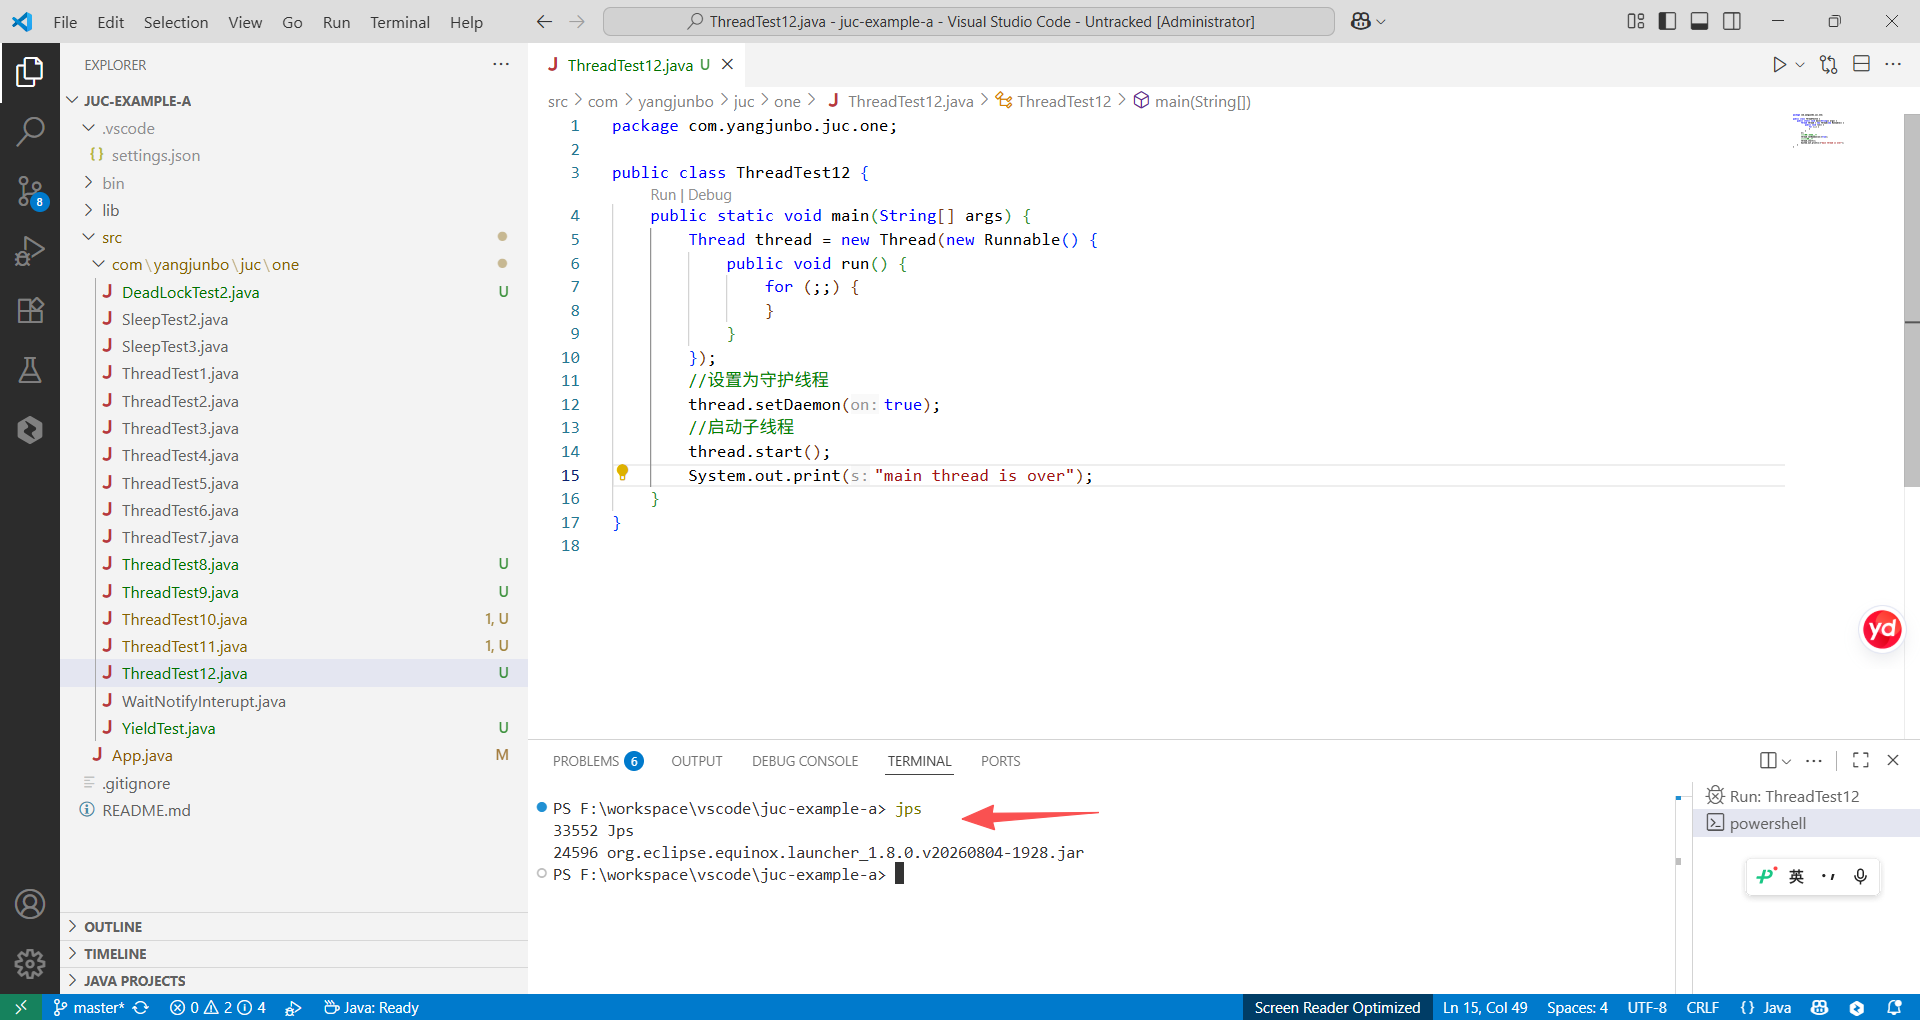
在这个例子中,main 函数是唯一的用户线程,thread 线程是守护线程,
当 main 线程运行结束后,JVM 发现当前已经没有用户线程了,就会终止 JVM 进程。
由于这里的守护线程执行的任务是一个死循环,这也说明了如果当前进程中不存在用户线程,但是还存在正在执行任务的守护线程,
则 JVM 不等守护线程运行完毕就会结束 JVM 进程。
main 线程运行结束后,JVM 会自动启动一个叫作 DestroyJavaVM 的线程,该线程会等待所有用户线程结束后终止 JVM 进程。
下面通过简单的 JVM 代码来证明这个结论。
翻看 JVM 的代码,能够发现,最终会调用到 JavaMain 这个 C 函数。
int JNICALL
JavaMain(void * _args)
{
...
//执行Java中的main函数
(*env)->CallStaticVoidMethod(env, mainClass, mainID, mainArgs);
//main函数返回值
ret = (*env)->ExceptionOccurred(env) == NULL ? 0 : 1;
//等待所有非守护线程结束,然后销毁JVM进程
LEAVE();
}
LEAVE 是 C 语言里面的一个宏定义,具体定义如下。
#define LEAVE() \\
do { \\
if ((*vm)->DetachCurrentThread(vm) ! = JNI_OK) { \\
JLI_ReportErrorMessage(JVM_ERROR2); \\
ret = 1; \\
} \\
if (JNI_TRUE) { \\
(*vm)->DestroyJavaVM(vm); \\
return ret; \\
} \\
} while (JNI_FALSE)
该宏的作用是创建一个名为 DestroyJavaVM 的线程,来等待所有用户线程结束。
在 Tomcat 的 NIO 实现 NioEndpoint 中会开启一组接受线程来接受用户的连接请求,以及一组处理线程负责具体处理用户请求,
那么这些线程是用户线程还是守护线程呢?下面我们看一下 NioEndpoint 的 startInternal 方法。
public void startInternal() throws Exception {
if (! running) {
running = true;
paused = false;
...
//创建处理线程
pollers = new Poller[getPollerThreadCount()];
for (int i=0; i<pollers.length; i++) {
pollers[i] = new Poller();
Thread pollerThread = new Thread(pollers[i], getName() +
"-ClientPoller-"+i);
pollerThread.setPriority(threadPriority);
pollerThread.setDaemon(true); //声明为守护线程
pollerThread.start();
}
//启动接受线程
startAcceptorThreads();
}
protected final void startAcceptorThreads() {
int count = getAcceptorThreadCount();
acceptors = new Acceptor[count];
for (int i = 0; i < count; i++) {
acceptors[i] = createAcceptor();
String threadName = getName() + "-Acceptor-" + i;
acceptors[i].setThreadName(threadName);
Thread t = new Thread(acceptors[i], threadName);
t.setPriority(getAcceptorThreadPriority());
t.setDaemon(getDaemon()); //设置是否为守护线程,默认为守护线程
t.start();
}
}
private boolean daemon = true;
public void setDaemon(boolean b) { daemon = b; }
public boolean getDaemon() { return daemon; }
在如上代码中,在默认情况下,接受线程和处理线程都是守护线程,这意味着当 tomcat 收到 shutdown 命令后并且没有其他用户线程存在的情况下 tomcat 进程会马上消亡,而不会等待处理线程处理完当前的请求。
总结:如果你希望在主线程结束后 JVM 进程马上结束,那么在创建线程时可以将其设置为守护线程,
如果你希望在主线程结束后子线程继续工作,等子线程结束后再让 JVM 进程结束,那么就将子线程设置为用户线程。
1.11 ThreadLocal
多线程访问同一个共享变量时特别容易出现并发问题,特别是在多个线程需要对一个共享变量进行写入时。
为了保证线程安全,一般使用者在访问共享变量时需要进行适当的同步,如图 1-3 所示。
图 1-3
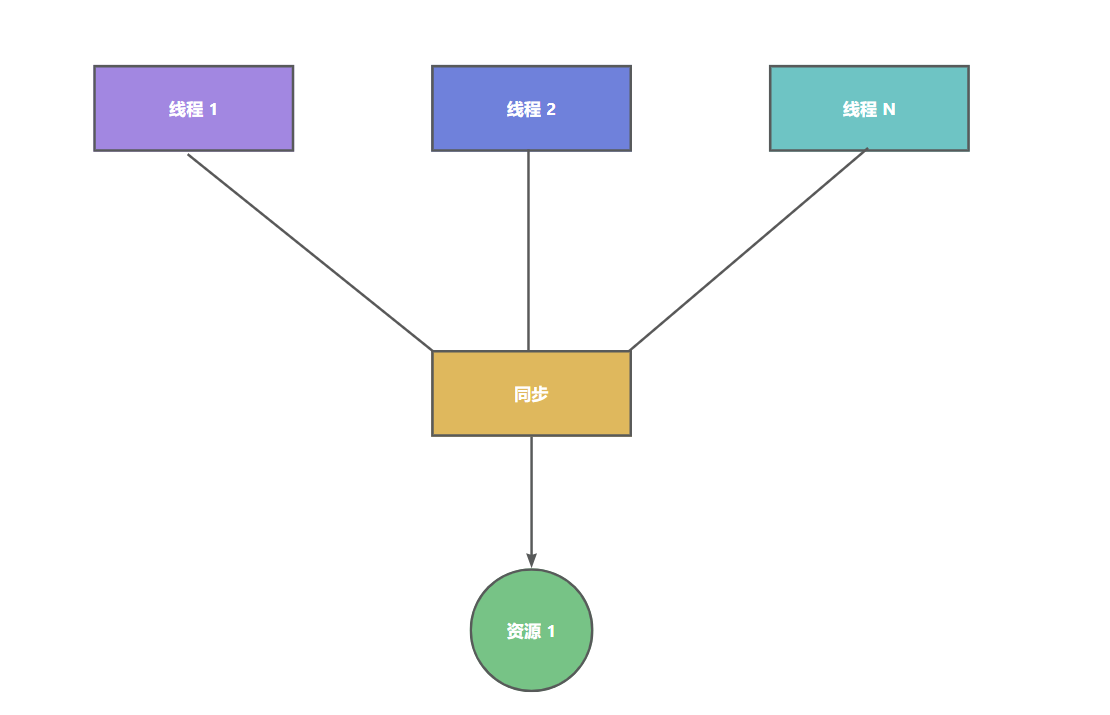
同步的措施一般是加锁,这就需要使用者对锁有一定的了解,这显然加重了使用者的负担。
那么有没有一种方式可以做到,当创建一个变量后,每个线程对其进行访问的时候访问的是自己线程的变量呢?
其实 ThreadLocal 就可以做这件事情,虽然 ThreadLocal 并不是为了解决这个问题而出现的。
ThreadLocal 是 JDK 包提供的,它提供了线程本地变量,
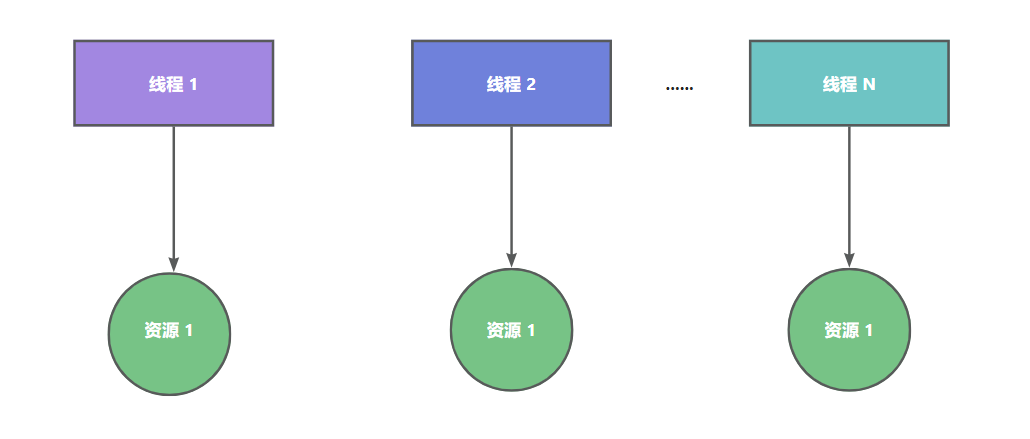
也就是如果你创建了一个 ThreadLocal 变量,那么访问这个变量的每个线程都会有这个变量的一个本地副本。
当多个线程操作这个变量时,实际操作的是自己本地内存里面的变量,从而避免了线程安全问题。
创建一个 ThreadLocal 变量后,每个线程都会复制一个变量到自己的本地内存,如图 1-4 所示。
图 1-4
1.11.1 ThreadLocal 使用示例
本节介绍如何使用 ThreadLocal。
本例开启了两个线程,在每个线程内部都设置了本地变量的值,然后调用 print 函数打印当前本地变量的值。
如果打印后调用了本地变量的 remove 方法,则会删除本地内存中的该变量,代码如下。
package com.yangjunbo.juc.one;
public class ThreadLocalTest {
// (1)print函数
static void print(String str) {
// 1.1 打印当前线程本地内存中localVariable变量的值
System.out.println(str + ":" + localVariable.get());
// 1.2 清除当前线程本地内存中的localVariable变量
// localVariable.remove();
}
// (2) 创建ThreadLocal变量
static ThreadLocal<String> localVariable = new ThreadLocal<>();
public static void main(String[] args) {
// (3) 创建线程one
Thread threadOne = new Thread(new Runnable() {
public void run() {
// 3.1 设置线程One中本地变量localVariable的值
localVariable.set("threadOne local variable");
// 3.2 调用打印函数
print("threadOne");
// 3.3 打印本地变量值
System.out.println("threadOne remove after" + ":" + localVariable.get());
}
});
// (4) 创建线程two
Thread threadTwo = new Thread(new Runnable() {
public void run() {
// 4.1 设置线程Two中本地变量localVariable的值
localVariable.set("threadTwo local variable");
// 4.2 调用打印函数
print("threadTwo");
// 4.3 打印本地变量值
System.out.println("threadTwo remove after" + ":" + localVariable.get());
}
});
// (5)启动线程
threadOne.start();
threadTwo.start();
}
}
运行结果如下。
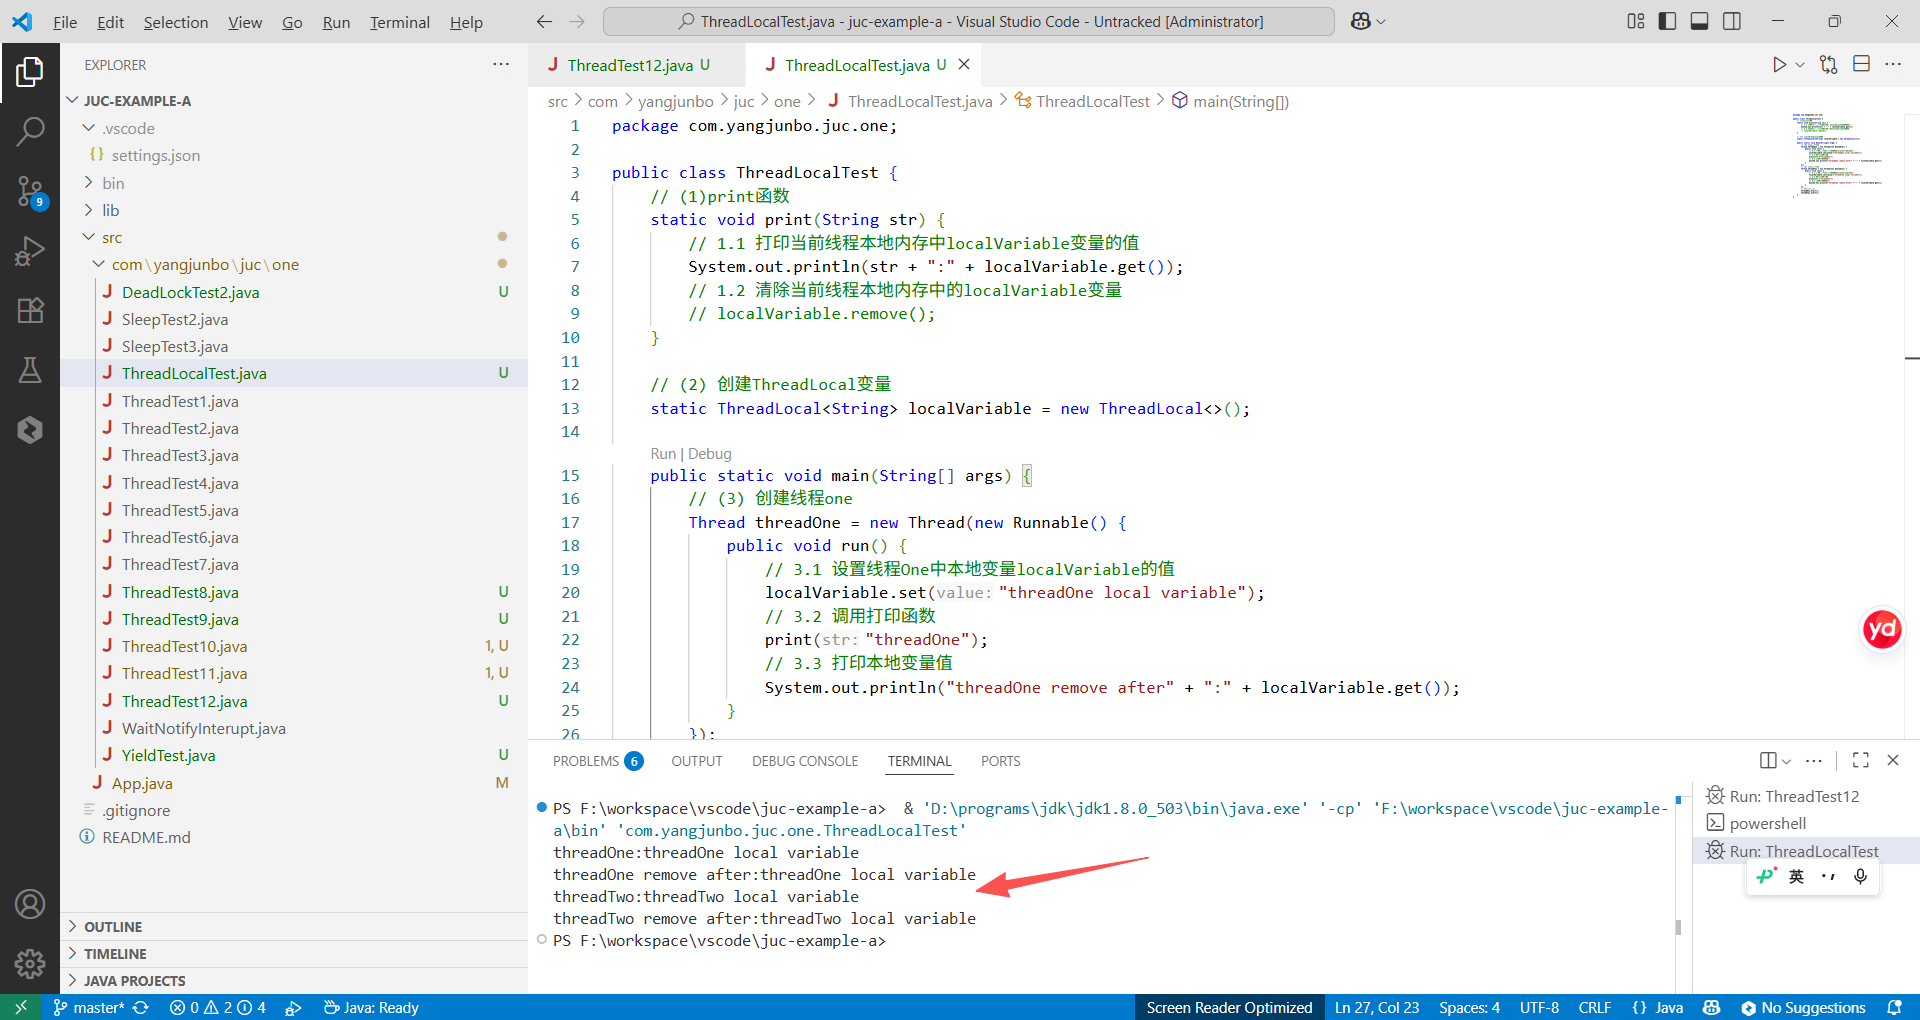
代码 (2) 创建了一个 ThreadLocal 变量。
代码 (3) 和 (4) 分别创建了线程 One 和 Two。
代码 (5) 启动了两个线程。
线程 One 中的代码 3.1 通过 set 方法设置了 localVariable 的值,这其实设置的是线程 One 本地内存中的一个副本,
这个副本线程 Two 是访问不了的。然后代码 3.2 调用了 print 函数,
代码 1.1 通过 get 函数获取了当前线程(线程 One)本地内存中localVariable 的值。
线程 Two 的执行类似于线程 One。
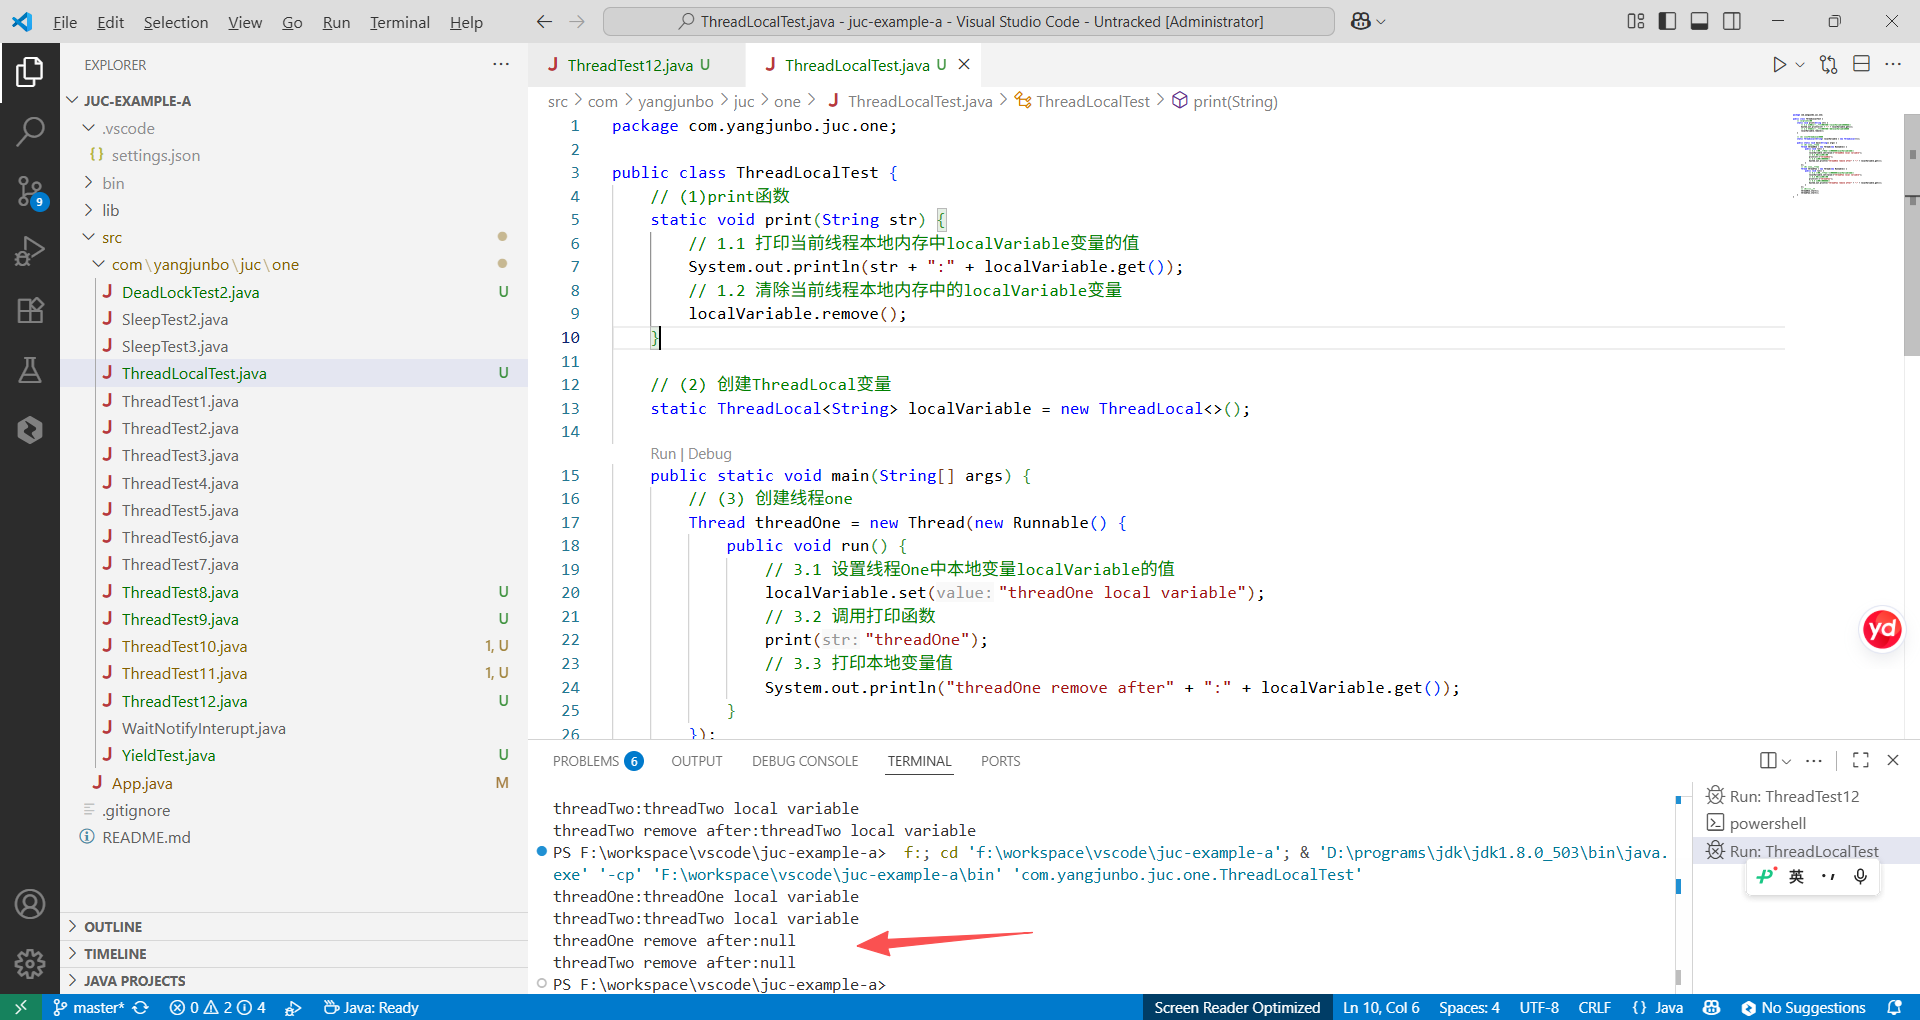
打开代码 1.2 的注释后,再次运行,运行结果如下。
1.11.2 ThreadLocal 的实现原理
首先看一下 ThreadLocal 相关类的类图结构,如图 1-5 所示。
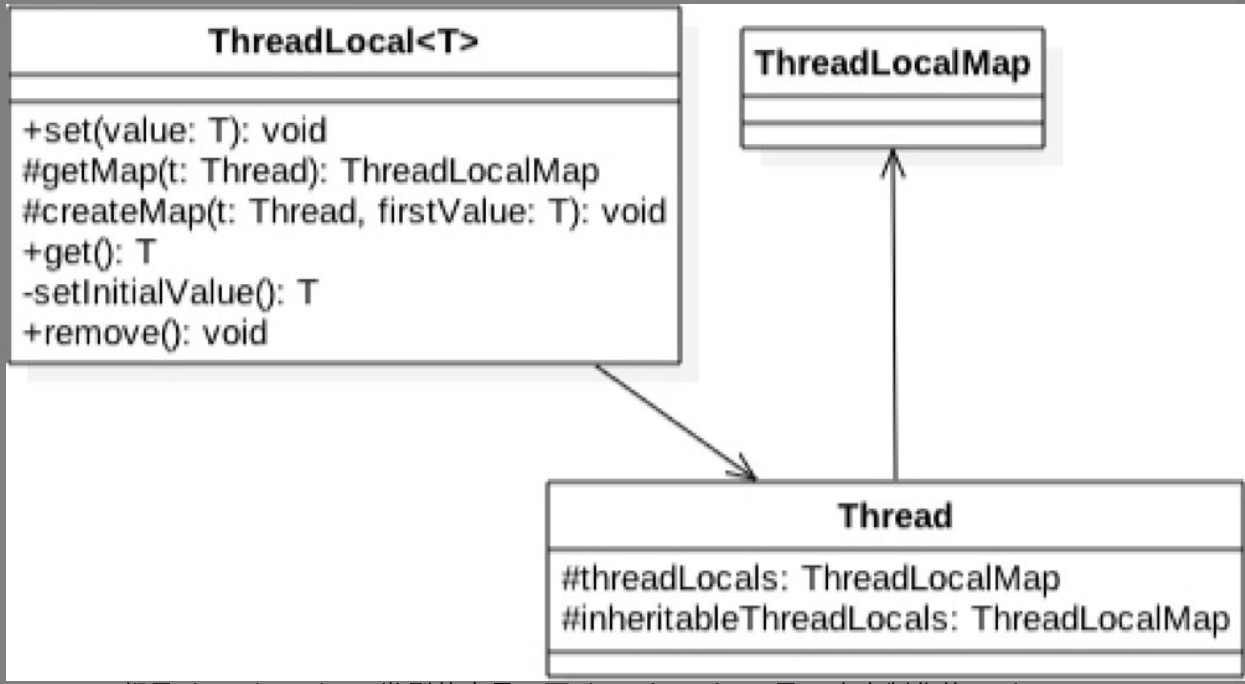
由该图可知,Thread 类中有一个 threadLocals 和一个 inheritableThreadLocals,它们都是 ThreadLocalMap 类型的变量,
而 ThreadLocalMap 是一个定制化的 Hashmap。
在默认情况下,每个线程中的这两个变量都为 null,只有当前线程第一次调用 ThreadLocal 类型的变量的 set 或者 get 方法时才会创建它们。
其实每个线程的本地变量不是存放在 ThreadLocal 类型的变量里面,而是存放在调用线程的 threadLocals 变量里面。
也就是说,ThreadLocal 类型的本地变量存放在具体的线程内存空间中。
ThreadLocal 类型的变量就是一个工具壳,它通过 set 方法把 value 值放入调用线程的 threadLocals 变量里面并存放起来,
当调用线程调用它的 get 方法时,再从当前线程的 threadLocals 变量里面将其拿出来使用。
如果调用线程一直不终止,那么这个 value 值会一直存放在调用线程的 threadLocals 变量里面,
所以当不需要使用这个 value 值时可以通过调用 ThreadLocal 类型的变量的 remove 方法,从当前线程的 threadLocals 变量里面删除该 value 值。
另外,Thread 里面的 threadLocals 为何被设计为 map 结构?很明显是因为每个线程可以关联多个 ThreadLocal 类型的变量。
下面简单分析 ThreadLocal 的 set、get 及 remove 方法的实现逻辑。
1.void set(T value)
public void set(T value) {
//(1)获取当前线程
Thread t = Thread.currentThread();
//(2)将当前线程作为key,去查找对应的线程变量,找到则设置
ThreadLocalMap map = getMap(t);
if (map ! = null)
map.set(this, value);
else
//(3)第一次调用就创建当前线程对应的HashMap
createMap(t, value);
}
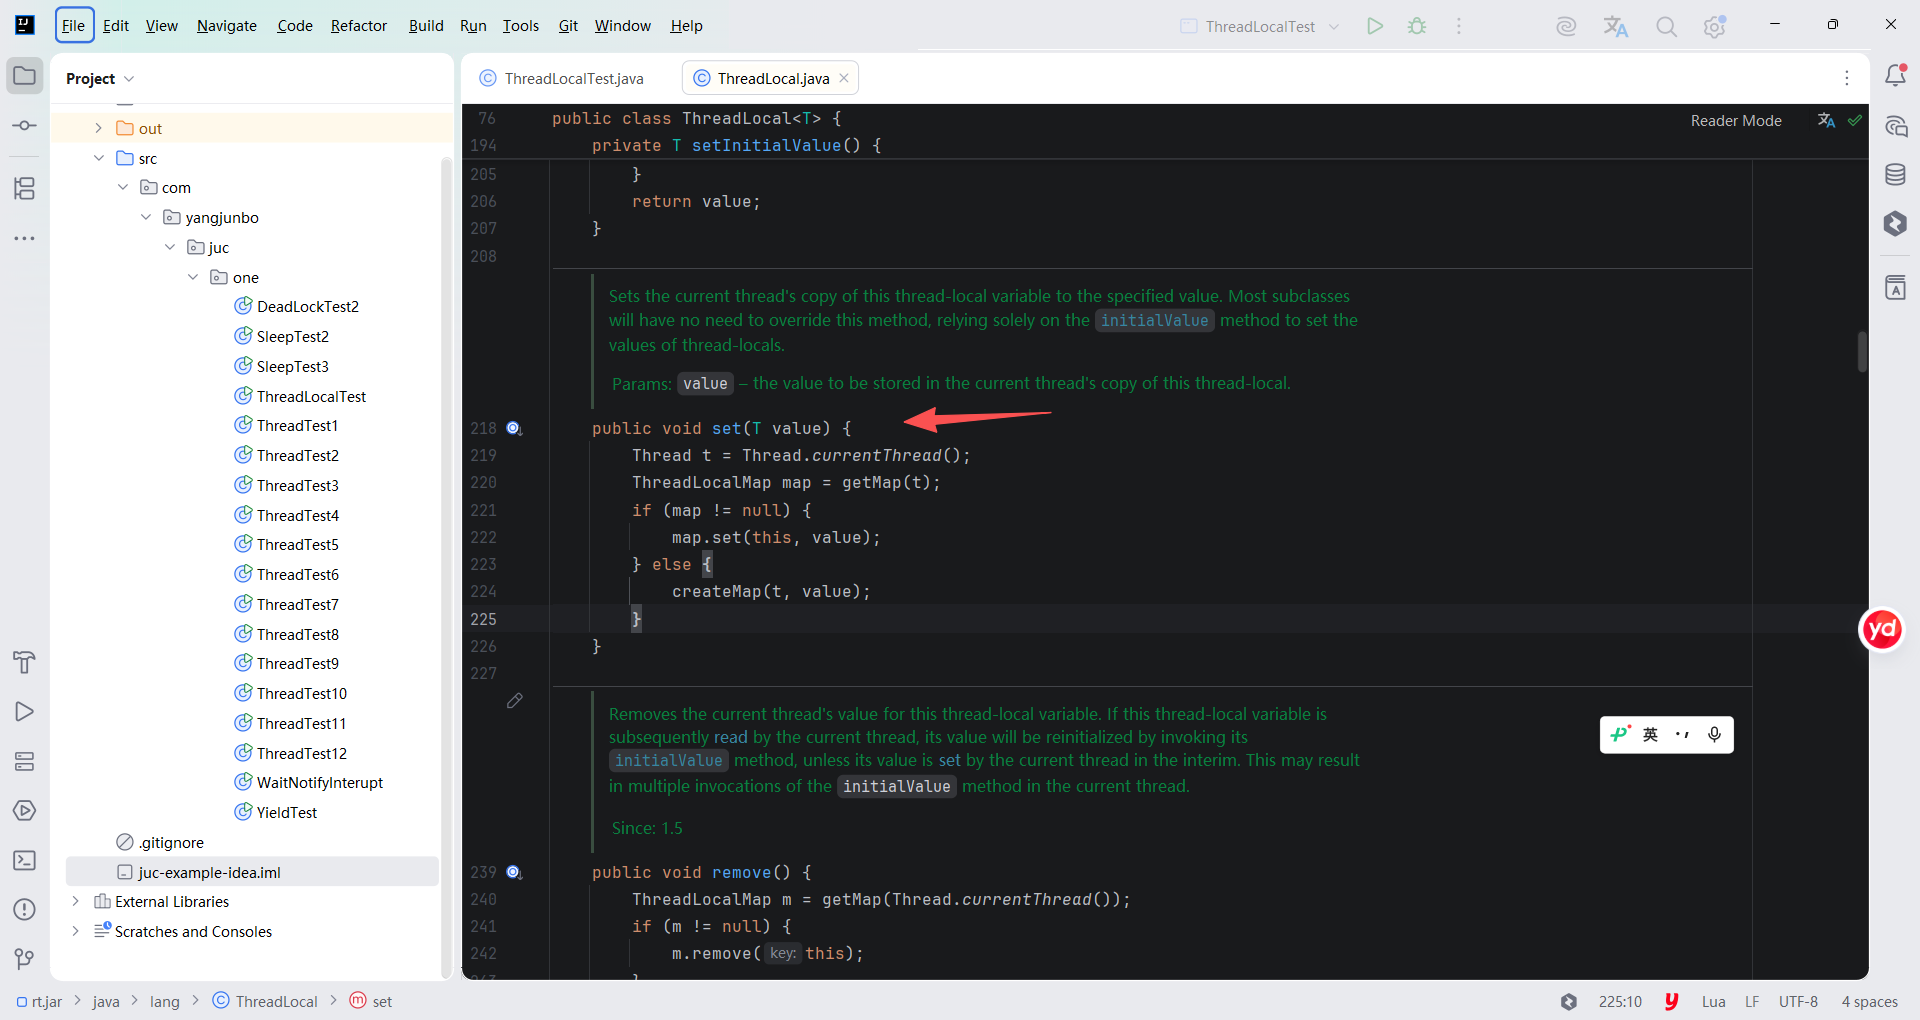
代码(1)首先获取调用线程,然后使用当前线程作为参数调用 getMap(t) 方法,getMap(Thread t) 的代码如下。
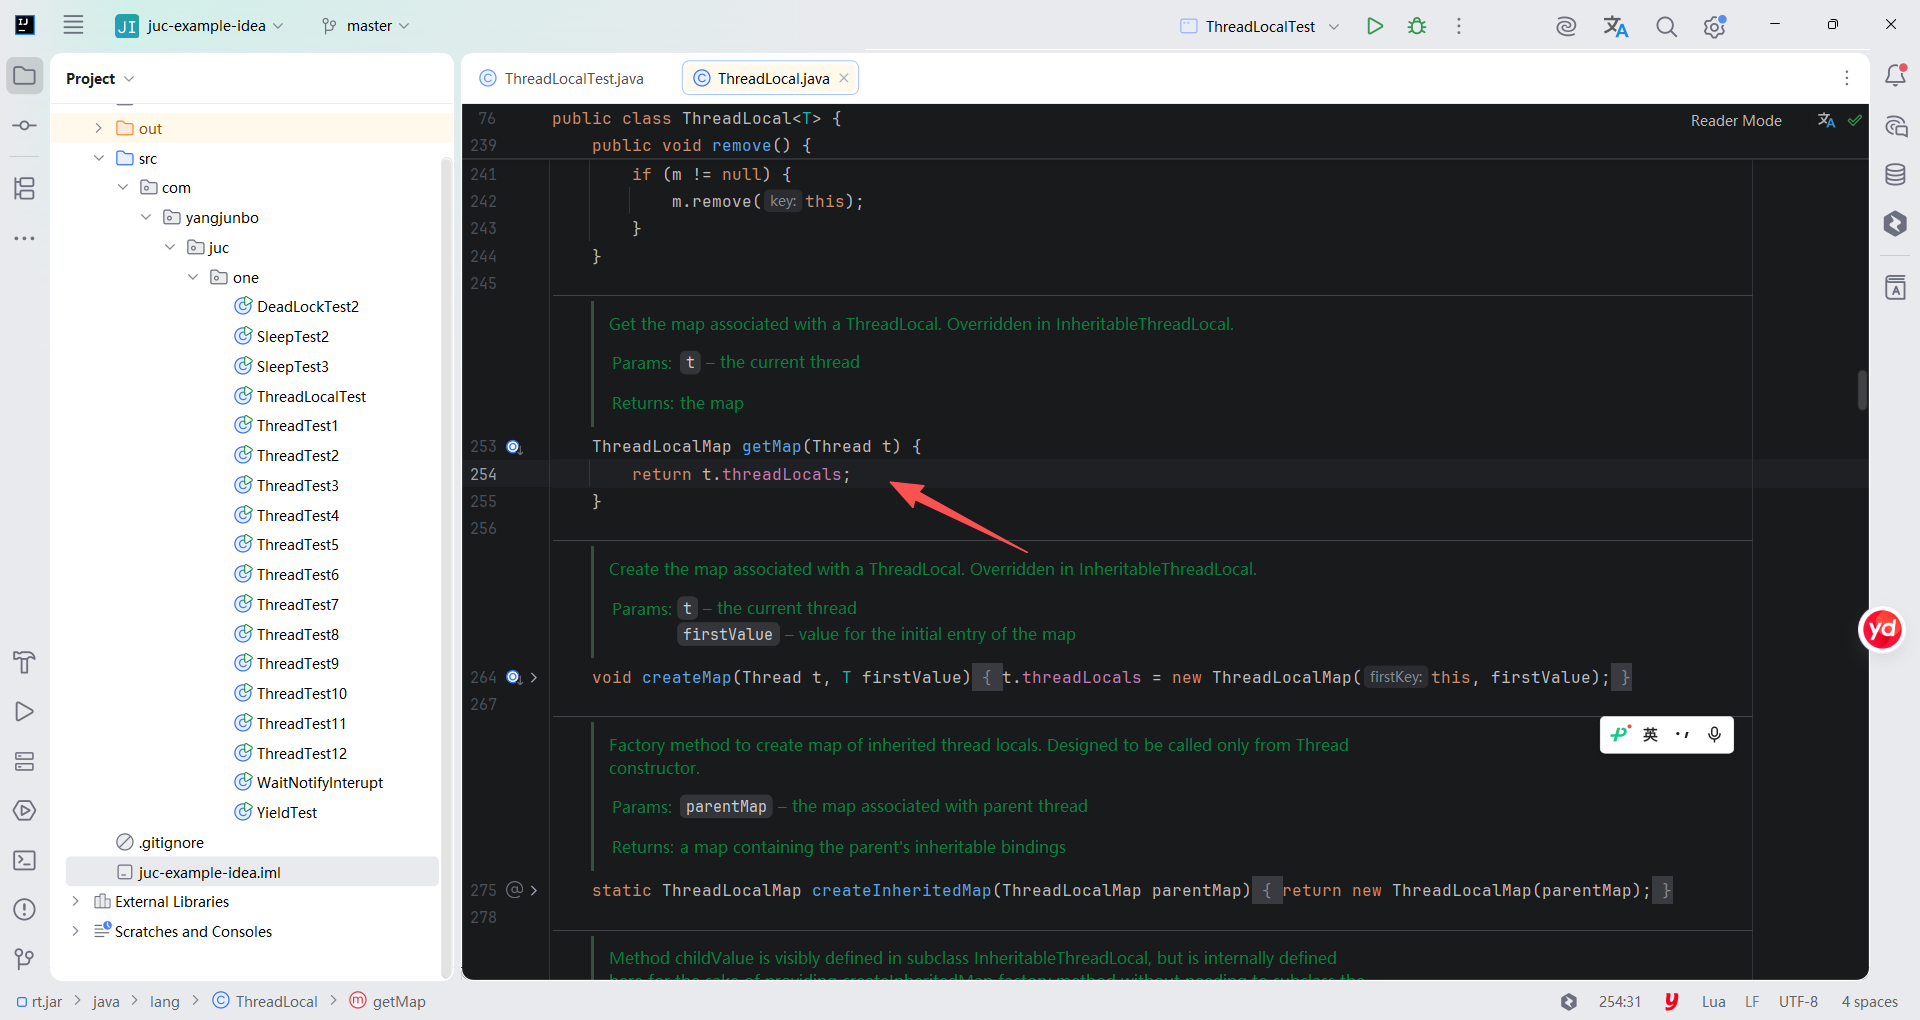
可以看到,getMap(t) 的作用是获取线程自己的变量 threadLocals。
如果 getMap(t) 的返回值不为空,则把 value 值设置到 threadLocals 中,
也就是把当前变量值放入当前线程的内存变量 threadLocals 中。
threadLocals 是一个 HashMap 结构,其中 key 就是当前 ThreadLocal 的实例对象引用,value 是通过 set 方法传递的值。
如果 getMap(t) 返回空值则说明是第一次调用 set 方法,这时创建当前线程的 threadLocals 变量。下面来看 createMap(t, value) 做什么。
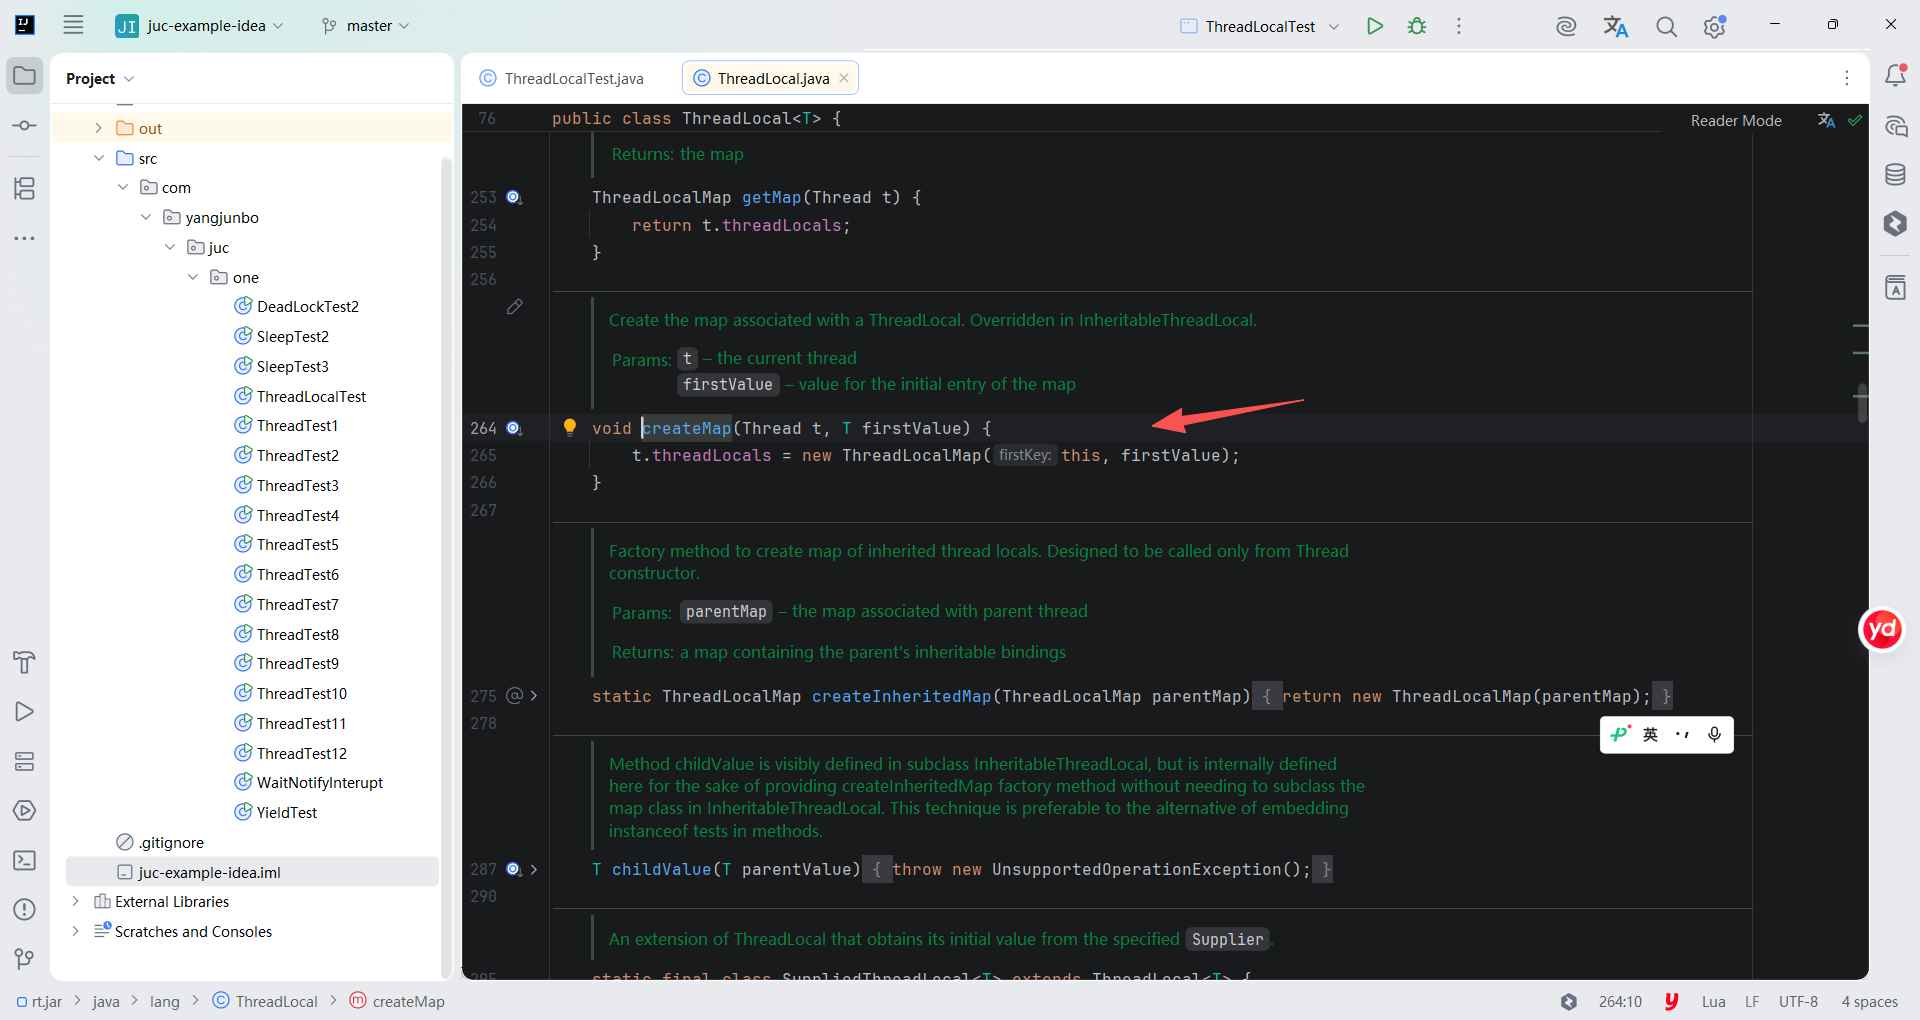
它创建当前线程的 threadLocals 变量。
2.T get()
public T get() {
//(4) 获取当前线程
Thread t = Thread.currentThread();
//(5)获取当前线程的threadLocals变量
ThreadLocalMap map = getMap(t);
//(6)如果threadLocals不为null,则返回对应本地变量的值
if (map ! = null) {
ThreadLocalMap.Entry e = map.getEntry(this);
if (e ! = null) {
@SuppressWarnings("unchecked")
T result = (T)e.value;
return result;
}
}
//(7)threadLocals为空则初始化当前线程的threadLocals成员变量
return setInitialValue();
}
代码(4)首先获取当前线程实例,如果当前线程的 threadLocals 变量不为 null,则直接返回当前线程绑定的本地变量,
否则执行代码(7)进行初始化。setInitialValue() 的代码如下。
private T setInitialValue() {
//(8)初始化为null
T value = initialValue();
Thread t = Thread.currentThread();
ThreadLocalMap map = getMap(t);
//(9)如果当前线程的threadLocals变量不为空
if (map ! = null)
map.set(this, value);
else
//(10)如果当前线程的threadLocals变量为空
createMap(t, value);
return value;
}
protected T initialValue() {
return null;
}
如果当前线程的 threadLocals 变量不为空,则设置当前线程的本地变量值为 null,否则调用 createMap 方法创建当前线程的 threadLocals 变量。
3.void remove()
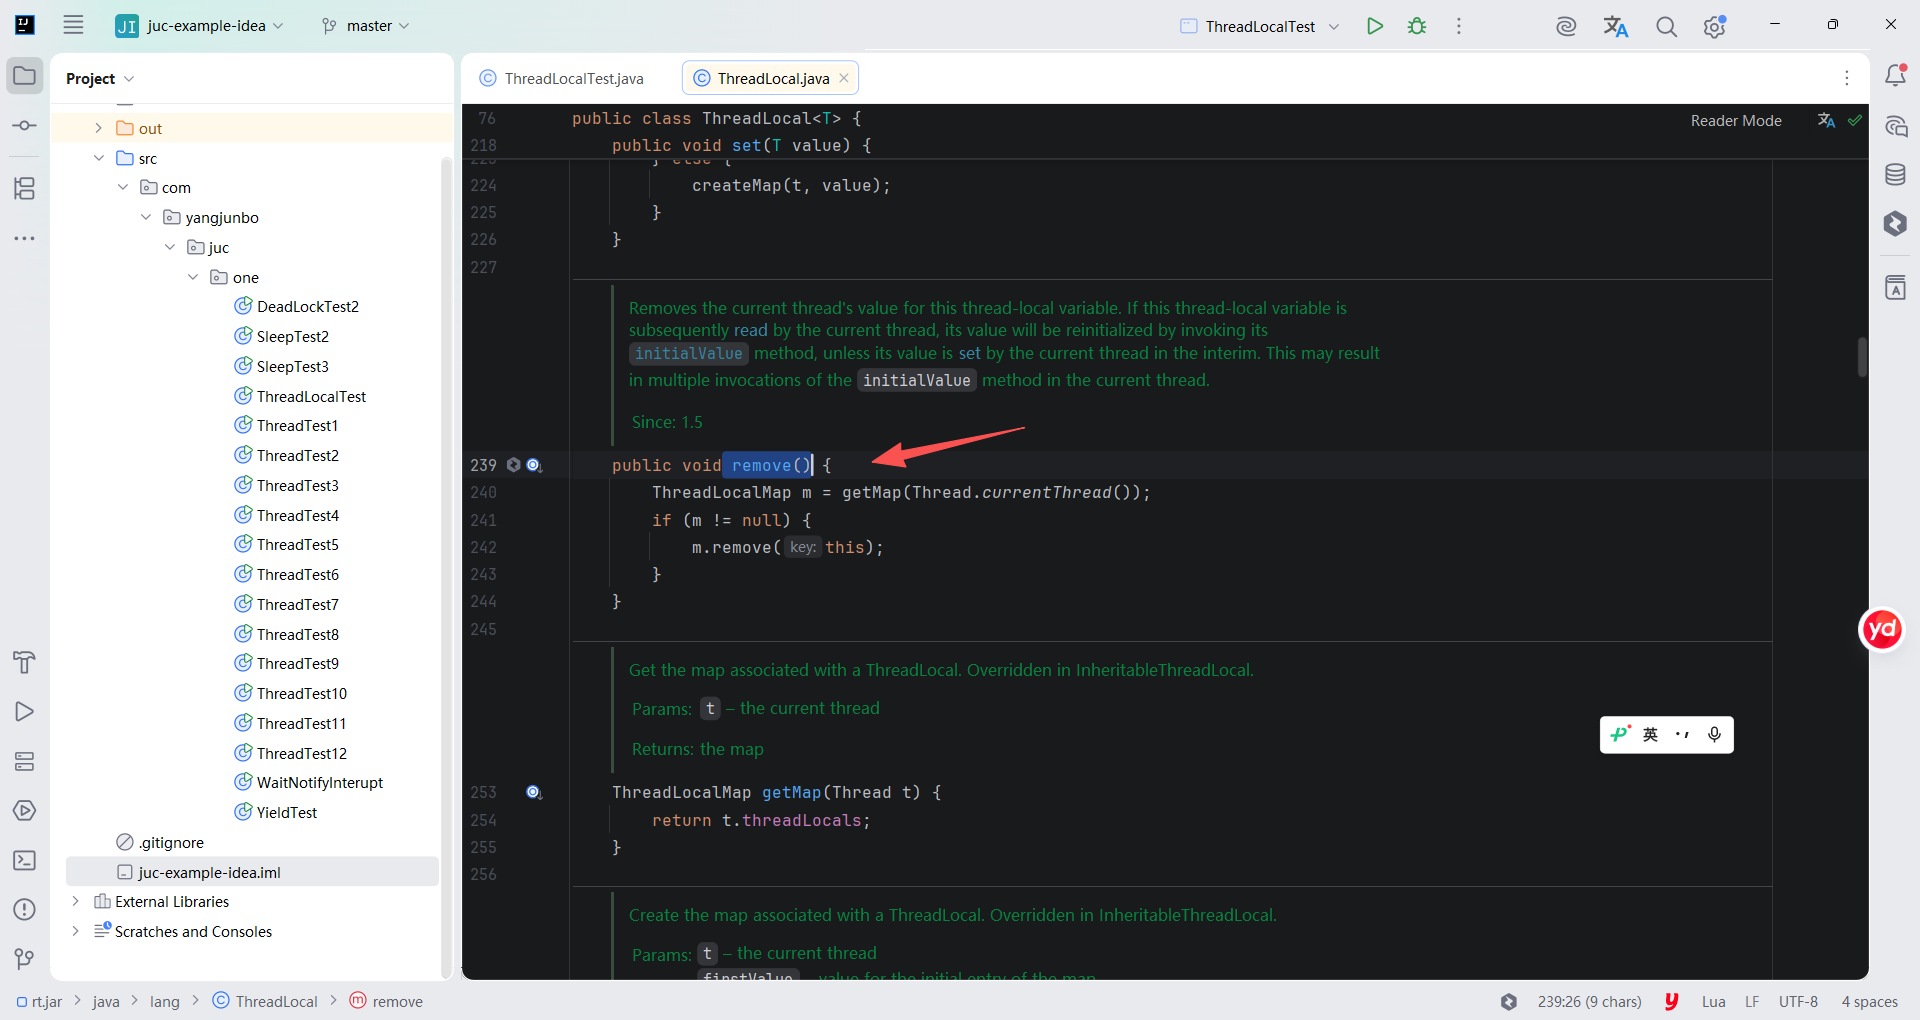
如以上代码所示,如果当前线程的 threadLocals 变量不为空,则删除当前线程中指定 ThreadLocal 实例的本地变量。
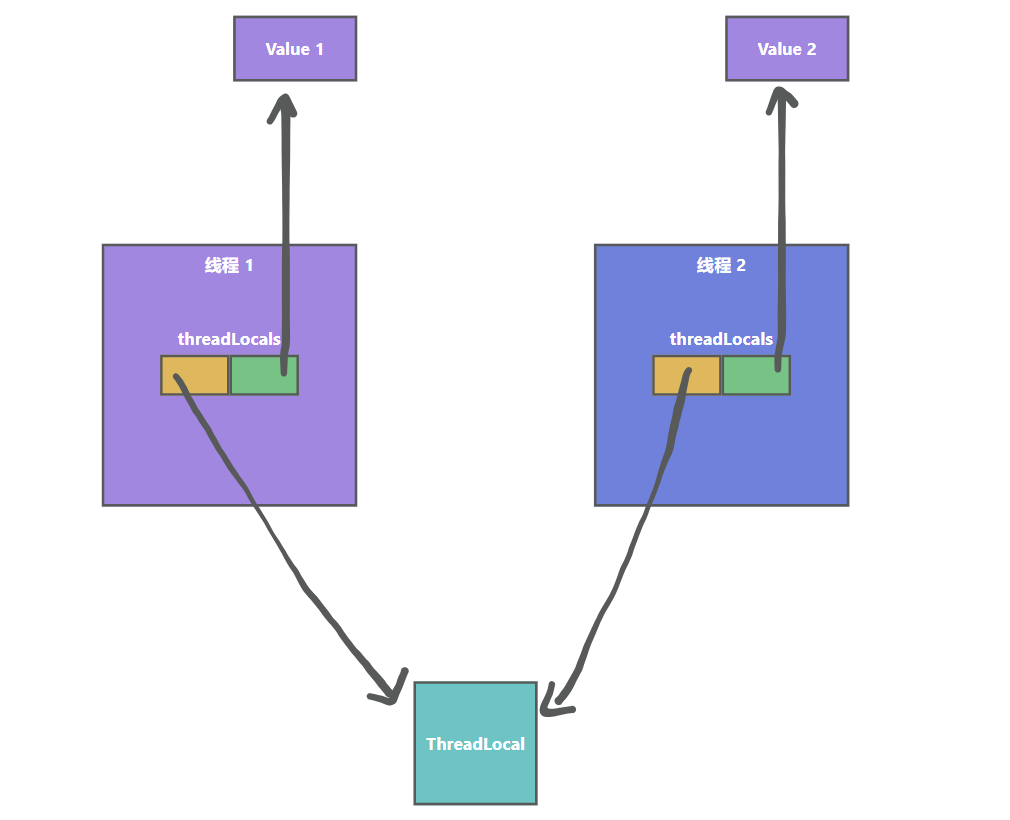
总结:如图 1-6 所示,在每个线程内部都有一个名为 threadLocals 的成员变量,该变量的类型为 HashMap,
其中 key 为我们定义的 ThreadLocal 变量的 this 引用,value 则为我们使用 set 方法设置的值。
每个线程的本地变量存放在线程自己的内存变量 threadLocals 中,如果当前线程一直不消亡,那么这些本地变量会一直存在,所以可能会造成内存溢出,
因此使用完毕后要记得调用 ThreadLocal 的 remove 方法删除对应线程的 threadLocals 中的本地变量。
在高级篇要讲解的 JUC 包里面的 ThreadLocalRandom,就是借鉴 ThreadLocal 的思想实现的,后面会具体讲解。
图 1-6
1.11.3 ThreadLocal 不支持继承性
首先看一个例子。
package com.yangjunbo.juc.one;
/**
* ClassName: TestThreadLocal
* Package: com.yangjunbo.juc.one
* Description:
*
* @Author 杨钧博
* @Create 2026/10/20 9:53
* @Version 1.0
*/
public class TestThreadLocal {
//(1)创建线程变量
public static ThreadLocal<String> threadLocal = new ThreadLocal<String>();
public static void main(String[] args) {
//(2) 设置线程变量
threadLocal.set("hello world");
//(3) 启动子线程
Thread thread = new Thread(new Runnable() {
public void run() {
//(4) 子线程输出线程变量的值
System.out.println("thread:" + threadLocal.get());
}
});
thread.start();
//(5) 主线程输出线程变量的值
System.out.println("main:" + threadLocal.get());
}
}
输出结果如下。
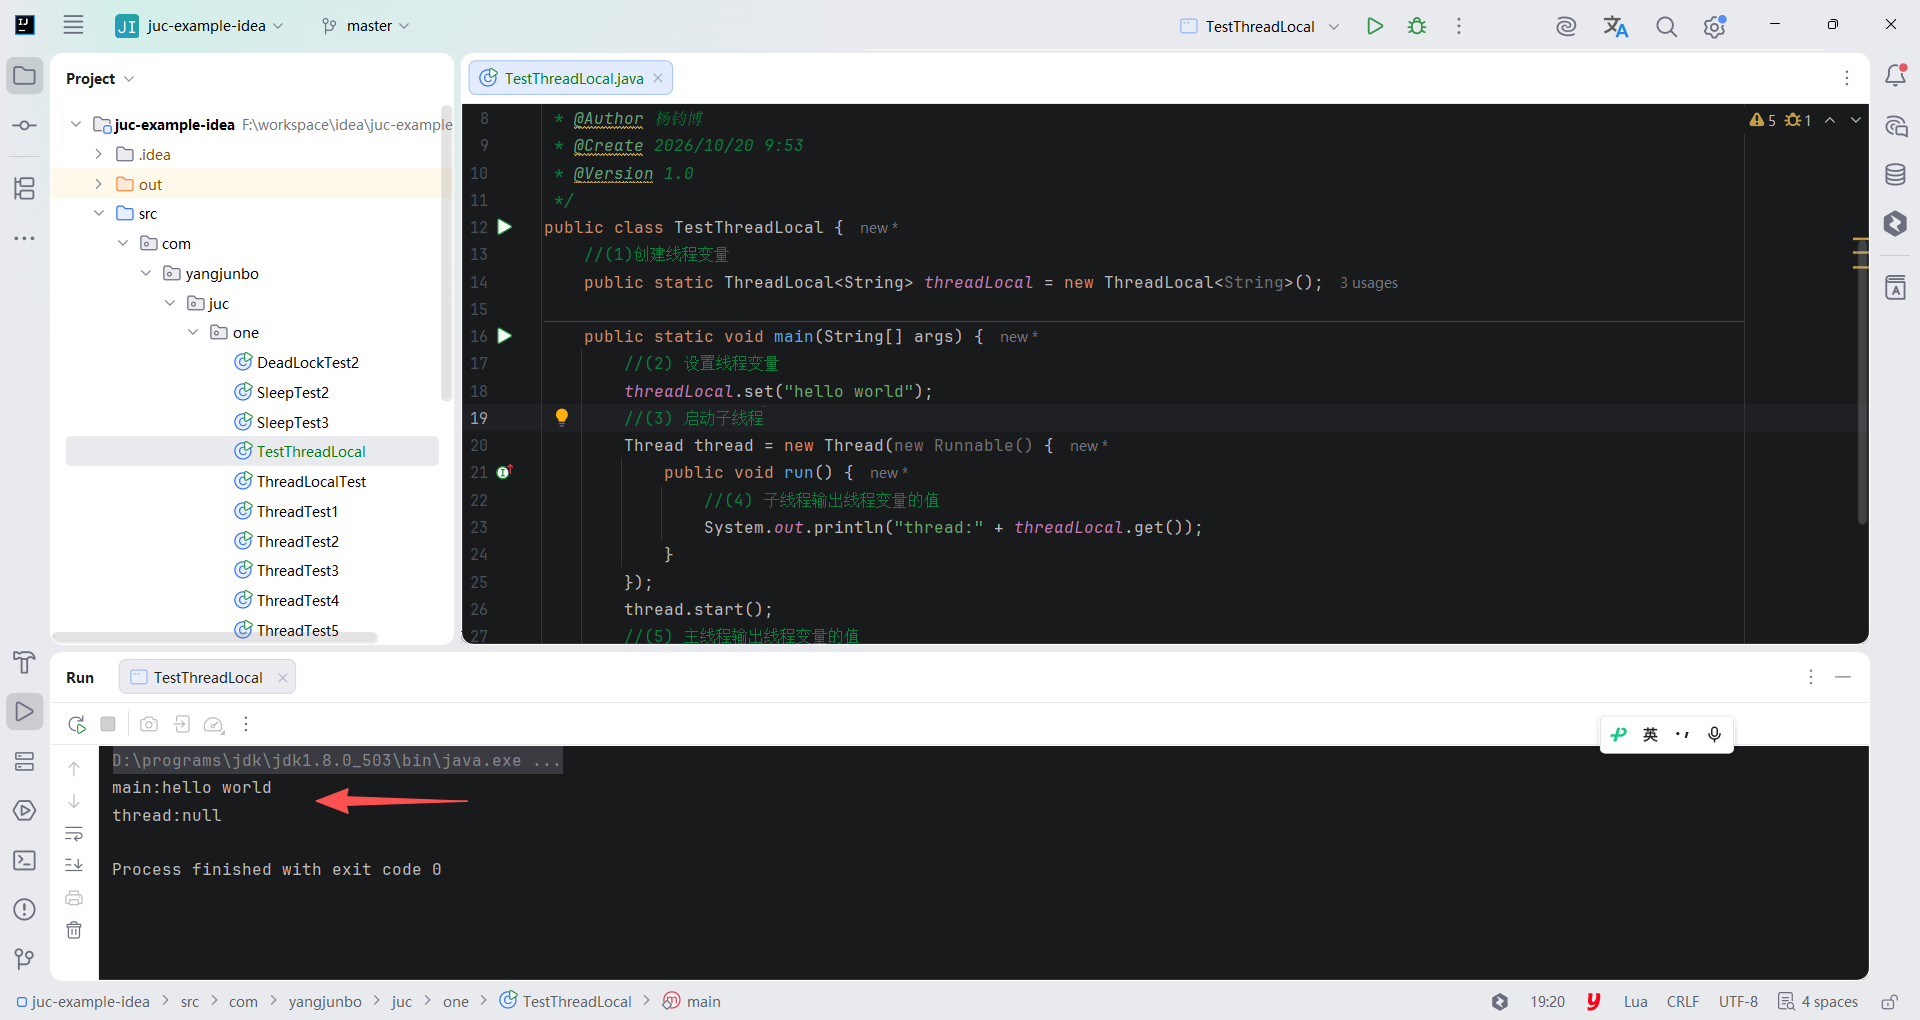
也就是说,同一个 ThreadLocal 变量在父线程中被设置值后,在子线程中是获取不到的。
根据上节的介绍,这应该是正常现象,因为在子线程 thread 里面调用get方法时当前线程为 thread 线程,
而这里调用 set 方法设置线程变量的是 main 线程,两者是不同的线程,自然子线程访问时返回 null。
那么有没有办法让子线程能访问到父线程中的值?答案是有。
1.11.4 InheritableThreadLocal 类
为了解决上节提出的问题,InheritableThreadLocal 应运而生。InheritableThreadLocal 继承自 ThreadLocal,其提供了一个特性,就是让子线程可以访问在父线程中设置的本地变量。下面看一下 InheritableThreadLocal 的代码。
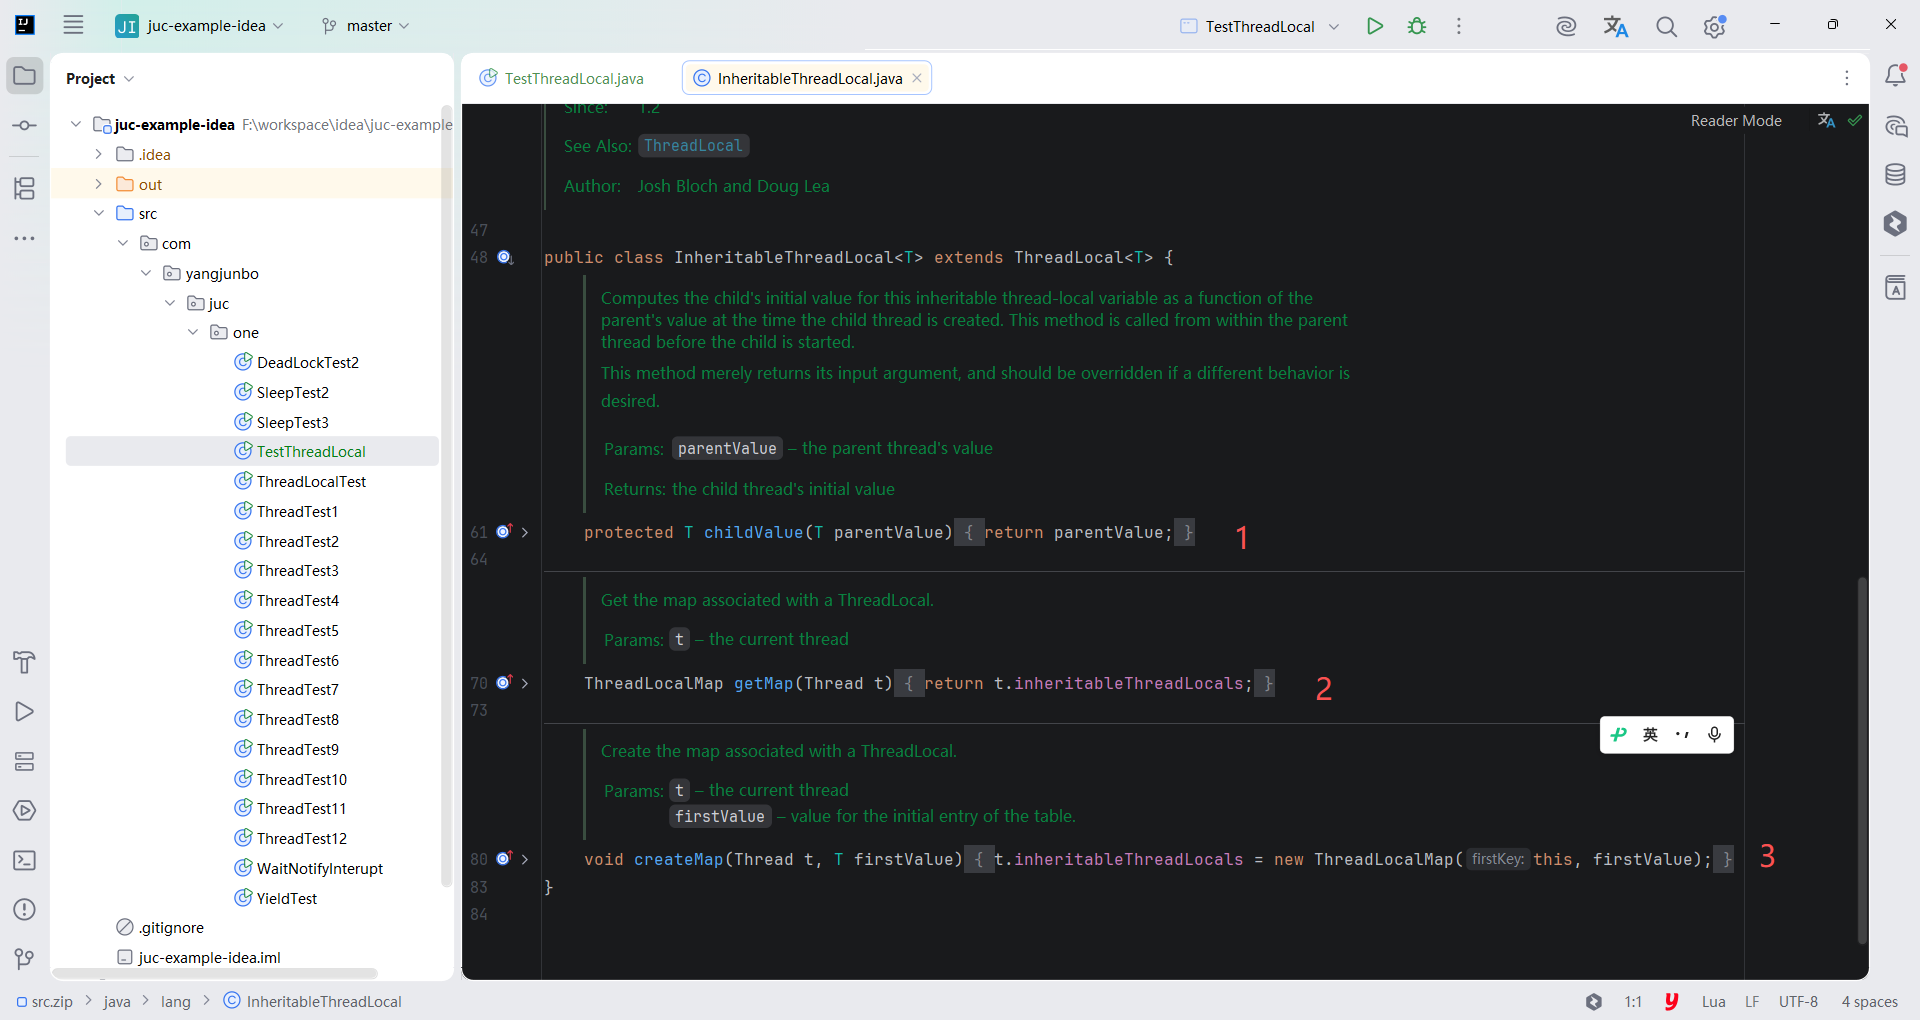
由如上代码可知,InheritableThreadLocal 继承了 ThreadLocal,并重写了三个方法。
由代码(3)可知,InheritableThreadLocal 重写了 createMap 方法,
那么现在当第一次调用 set 方法时,创建的是当前线程的 inheritableThreadLocals 变量而不再是 threadLocals。
由代码(2)可知,当调用 get 方法获取当前线程内部的 map 变量时,获取的是 inheritableThreadLocals 而不再是 threadLocals。
综上可知,在 InheritableThreadLocal 的世界里,变量 inheritableThreadLocals 替代了 threadLocals。
下面我们看一下重写的代码(1)何时执行,以及如何让子线程可以访问父线程的本地变量。
这要从创建 Thread 的代码说起,打开 Thread 类的默认构造函数,代码如下。


public Thread(Runnable target) {
init(null, target, "Thread-" + nextThreadNum(), 0);
}
private void init(ThreadGroup g, Runnable target, String name,
long stackSize, AccessControlContext acc) {
...
//(4)获取当前线程
Thread parent = currentThread();
...
//(5)如果父线程的inheritableThreadLocals变量不为null
if (parent.inheritableThreadLocals ! = null)
//(6)设置子线程中的inheritableThreadLocals变量
this.inheritableThreadLocals =
ThreadLocal.createInheritedMap(parent.inheritableThreadLocals);
this.stackSize = stackSize;
tid = nextThreadID();
}
如上代码在创建线程时,在构造函数里面会调用 init 方法。
代码(4)获取了当前线程(这里是指 main 函数所在的线程,也就是父线程),
然后代码(5)判断 main 函数所在线程里面的 inheritableThreadLocals 属性是否为 null,
前面我们讲了 InheritableThreadLocal 类的 get 和 set 方法操作的是 inheritableThreadLocals,
所以这里的 inheritableThreadLocal 变量不为 null,因此会执行代码(6)。
下面看一下 createInheritedMap 的代码。
static ThreadLocalMap createInheritedMap(ThreadLocalMap parentMap) {
return new ThreadLocalMap(parentMap);
}
可以看到,在 createInheritedMap 内部使用父线程的 inheritableThreadLocals 变量作为构造函数的参数创建了一个新的 ThreadLocalMap 变量,然后赋值给了子线程的 inheritableThreadLocals 变量。
下面我们看看在 ThreadLocalMap 的构造函数内部都做了什么事情。
private ThreadLocalMap(ThreadLocalMap parentMap) {
Entry[] parentTable = parentMap.table;
int len = parentTable.length;
setThreshold(len);
table = new Entry[len];
for (int j = 0; j < len; j++) {
Entry e = parentTable[j];
if (e ! = null) {
@SuppressWarnings("unchecked")
ThreadLocal<Object> key = (ThreadLocal<Object>) e.get();
if (key ! = null) {
//(7)调用重写的方法
Object value = key.childValue(e.value); //返回e.value
Entry c = new Entry(key, value);
int h = key.threadLocalHashCode & (len –1);
while (table[h] ! = null)
h = nextIndex(h, len);
table[h] = c;
size++;
}
}
}
}
在该构造函数内部把父线程的 inheritableThreadLocals 成员变量的值复制到新的 ThreadLocalMap 对象中,inheritableThreadLocals 成员变量类型也是 ThreadLocalMap,等于是创建一个新的 ThreadLocalMap 类型的对象。
其中代码(7)调用了 InheritableThreadLocal 类重写的代码(1)。
总结:InheritableThreadLocal 类通过重写代码(2)和(3)让本地变量保存到了具体线程的 inheritableThreadLocals 变量里面,
那么线程在通过 InheritableThreadLocal 类实例的 set 或者 get 方法设置变量时,就会创建当前线程的 inheritableThreadLocals 变量。
当父线程创建子线程时,构造函数会把父线程里面的本地变量 inheritableThreadLocals 复制一份保存到子线程的 inheritableThreadLocals 变量里面。
把 1.11.3 节中的代码(1)修改为
//(1) 创建线程变量
public static ThreadLocal<String> threadLocal = new InheritableThreadLocal<String>();
运行结果如下。

可见,现在可以从子线程正常获取到父线程变量的值了。
那么在什么情况下需要子线程需要获取父线程的 threadlocal 变量呢?情况还是蛮多的,
比如子线程需要使用存放在 threadlocal 变量中的用户登录信息,再比如一些中间件需要统一把 id 追踪的整个调用链路记录下来。
其实子线程使用父线程中的 threadlocal 方法有多种方式,比如创建线程时传入父线程中的变量,并将其复制到子线程中,或者在父线程中构造一个 map 作为参数传递给子线程,但是这些都改变了我们的使用习惯,所以在这些情况下 InheritableThreadLocal 就显得比较有用。


评论前必须登录!
注册