 网硕互联帮助中心
TPAMI 2026|HomoDiff:在扩散去噪过程中选择更适合配准的单应矩阵
1. 一句话总结
含噪的跨模态图像难以准确配准,而去噪越强也未必配得越准。HomoDiff 沿扩散去噪过程逐步估计单应矩阵,再为每对图像选择预测配准误差最小的结果;在三类多模态数据集的不同噪声条件下取得更低的角点误差。
2. 论文信息
-
题目: HomoDiff: Noise-Robust Multi-modal Homography Estimation via Diffusion Model|HomoDiff:基于扩散模型的抗噪多模态单应性估计
-
发表: TPAMI 2026
-
作者: Yunhan Gao†、Ce Zheng†、Jingyi Xu、Xin Deng*、Ying Chen、Mai Xu*
-
单位: 北京航空航天大学电子信息工程学院;北京航空航天大学网络空间安全学院;阿里巴巴集团;北京航空航天大学虚拟现实技术与系统国家重点实验室;中国人民解放军总医院第一医学中心肾内科、肾脏疾病国家重点实验室及国家肾脏疾病临床医学研究中心。
-
代码:
-
https://github.com/Langweng/HomoDiff.git
-
下载:
-
10.1109/TPAMI.2026.3730469
3. 论文摘要
目前大多数多模态单应性估计的方法都是针对无噪声的情况下的,而噪声会对跨模态的对应关系造成影响。本文发现去噪效果和配准精度之间并没有简单的正相关关系,因此提出了HomoDiff算法,在扩散推理的不同阶段同时进行去噪和单应矩阵的估计,并根据预测到的配准误差来选择最优的结果。实验涵盖了RGB/热红外、RGB/深度以及RGB/近红外等多种场景,在不同的噪声水平下都证明了该方法具有较好的配准精度。
4. 主要创新之处
创新一:统一多模态配准方法
将去噪和单应性估计放在同一个扩散过程中进行,并且用一个模型来应对各种不同的噪声情况,而不需要为每一种噪声都设计出固定的方案。
创新二:“去噪越强不一定越准确”
论文经过实验得出结论,在去噪效果提高之后,角点误差可能会先减小再增大;噪声越大,要得到较好的配准结果一般就需要进行更深层次的去噪操作。这就给逐步生成和挑选配准结果提供了一个理由。
创新三:渐进估计和自适应选择
去噪和单应性估计(Denoising and Homography Estimation,DHE)的主要部分在每个推理步骤都对单应矩阵进行更新;自适应单应性选择(Adaptive Homography Selection,AHS)子网预测每个步骤的配准误差,并根据不同的样本给出不同的结果。
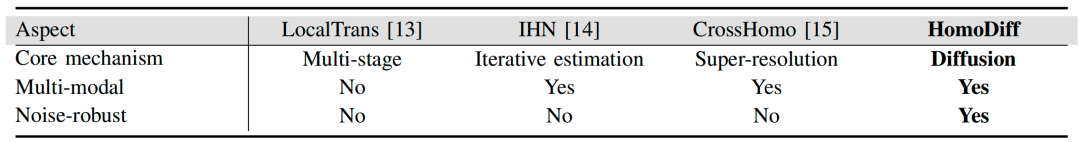
表 1: 代表性的单应性估计方法以及HomoDiff在主要机制、多种模式的支持能力和抗干扰能力方面的对比。
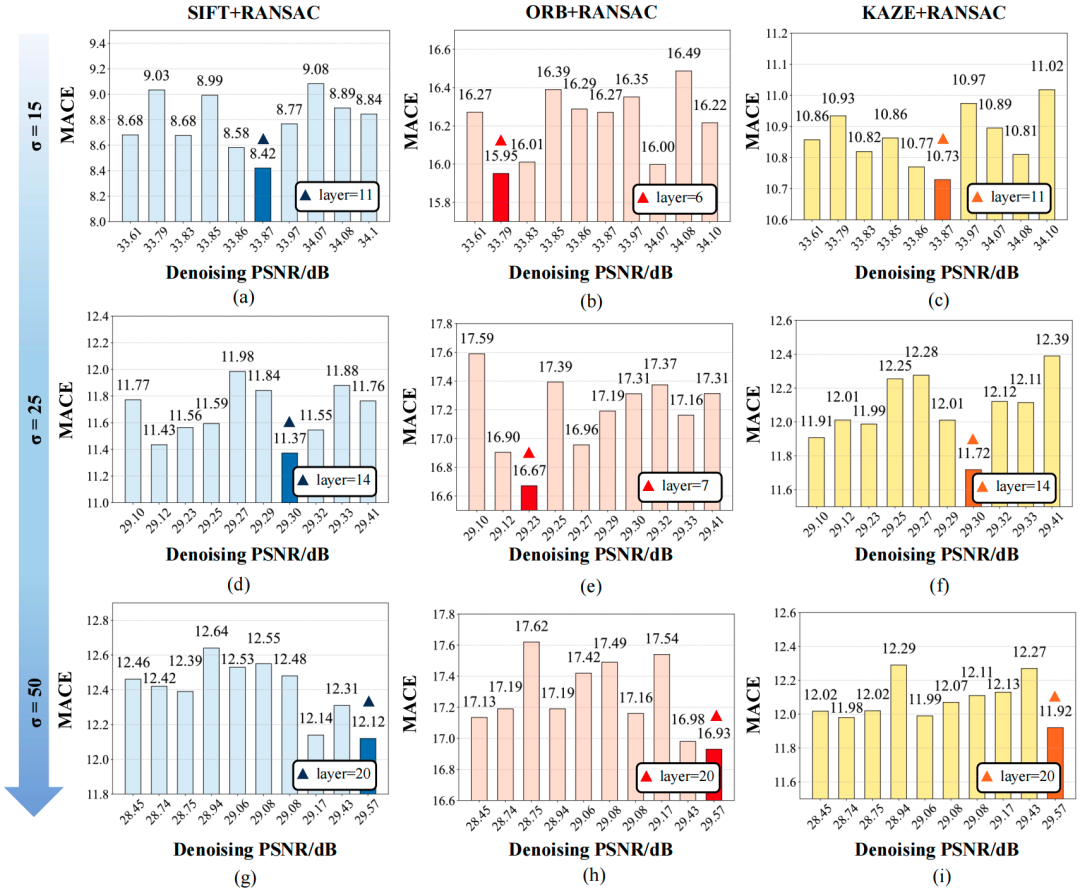
图 1: 在三种噪声水平下不同去噪程度所对应的RGB/近红外配准误差;即最强的去噪并不一定就是最好的配准。
5. 方法详解
5.1 问题的界定以及整个体系的大致结构
输入为带有噪声和需要进行配准的RGB图像以及一个纯净的参照图像;输出是一个表示二者之间空间关系的单应矩阵。HomoDiff首先根据噪声程度将嵌入到扩散过程中的中间状态中去,然后逆向推断出结果:多模态图像去噪子网络产生去噪估计值,多模态单应性估计子网络逐步预测出几何变换,最后由AHS决定输出什么。实际推理用了步。
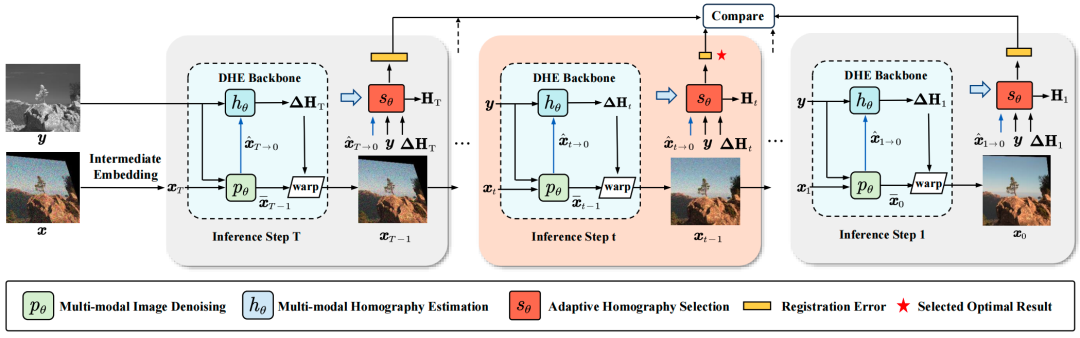
图 2: HomoDiff的整体结构;要关注每一阶段的MID、MHE是如何被串联起来的,AHS又是怎样从各种推理的结果里做出决定的。
5.2 MID:用另外一种方式来给去噪提供指引
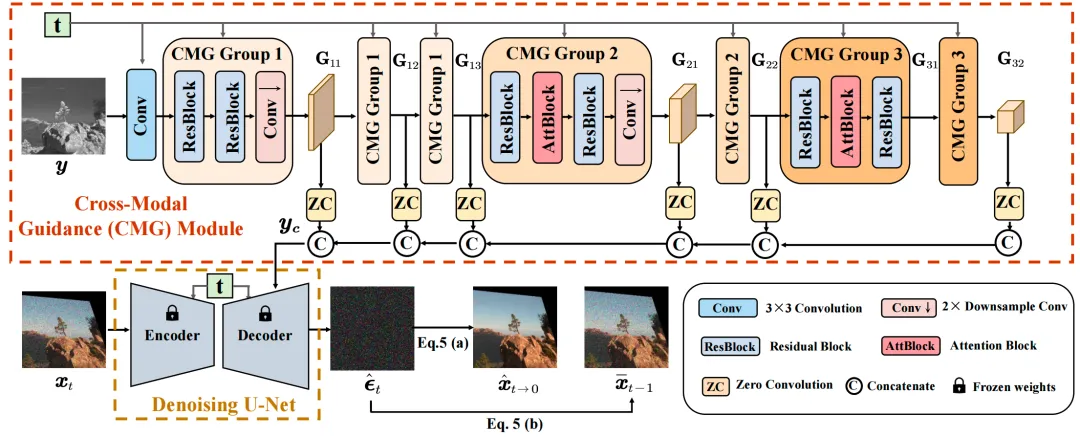
两张图片还没有对齐,在像素级别上直接把参考图融合进去会带来一些错误的信息,所以MID用跨模态引导模块来提取出的不同尺度上的特征,并且用去噪U-Net来推断出当前步长下的噪声值:
代表第步中间含噪图像,为参考图象,为MID子网络,为预测噪声。公式解释:去噪需要当前图像、参考模式以及推理步数来得到不同的去噪效果,在之后的几何估计中起作用。
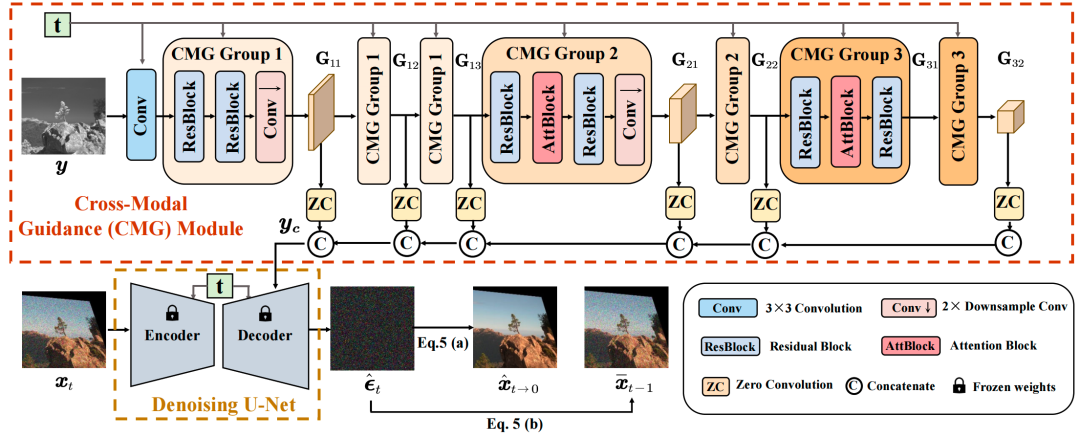
图 3: MID结构;CMG得到跨模态引导特征,去噪U-Net根据它重建出图像。
5.3 MHE:每一阶段都对几何变化进行估算
MHE 从去噪估计和参考图像中抽取多尺度特征,并在局部窗口内求得跨模态的相关性之后再进行四角点位移的预测,最后用直接线性变换(DLT)得到增量单应矩阵:
为 MHE 子网,为步预测的增量单应矩阵。公式解释:每一阶段所得到的结果都是对当前几何关系的一种修正,从而使得配准随着去噪过程而不断改善。
5.4 AHS:根据样本来确定配准的结果
不同的样本所需要的去噪步数是不一样的,AHS 用去噪后的图片、参考图、增量矩阵以及步长来计算出误差,并从中选出误差最小的一组数据作为最终结果:
其中表示累积到第步的单应矩阵,为AHS子网络,为预测误差最小的步骤,最后得到的结果是。公式解释:模型比较的是各个候选的预测配准误差,并不是所有的图像都用同一个步长来计算。
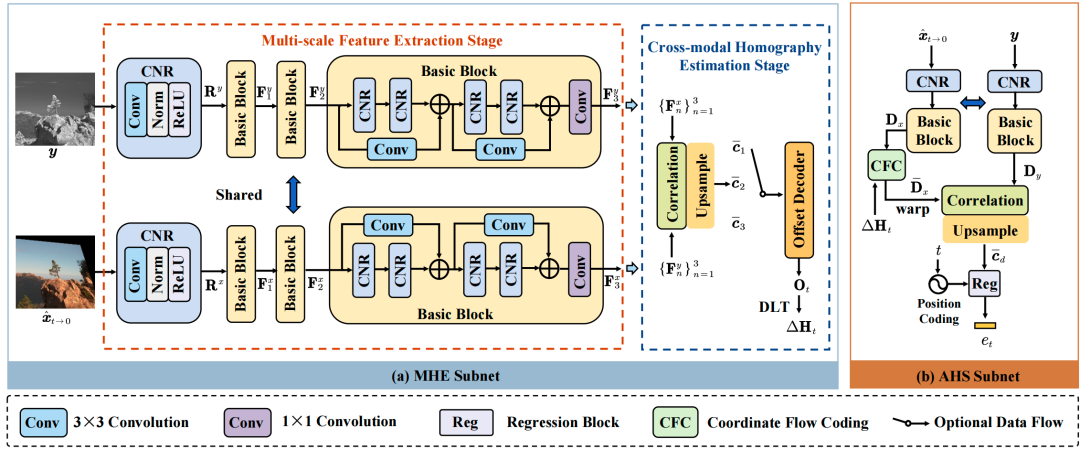
图 4: MHE多尺度相关性和角点位移估计结构、AHS特征对齐及误差预测结构。
5.5 损失函数和训练
训练分为两个阶段,第一阶段是训练DHE,第二阶段是冻结DHE并继续训练AHS。DHE使用的是重建损失和单应性损失:
其中表示从粗到细的不同训练阶段;用来保证去噪后的结果和原图一致,用来保证预测值和真实的四角点偏差一致,、是权重参数,在文中被设置为50和1。公式解释:两个损失函数一起要求图像恢复可靠、几何估计准确。之后AHS通过预测误差与归一化的真值配准误差之间的差异来训练学习规则。
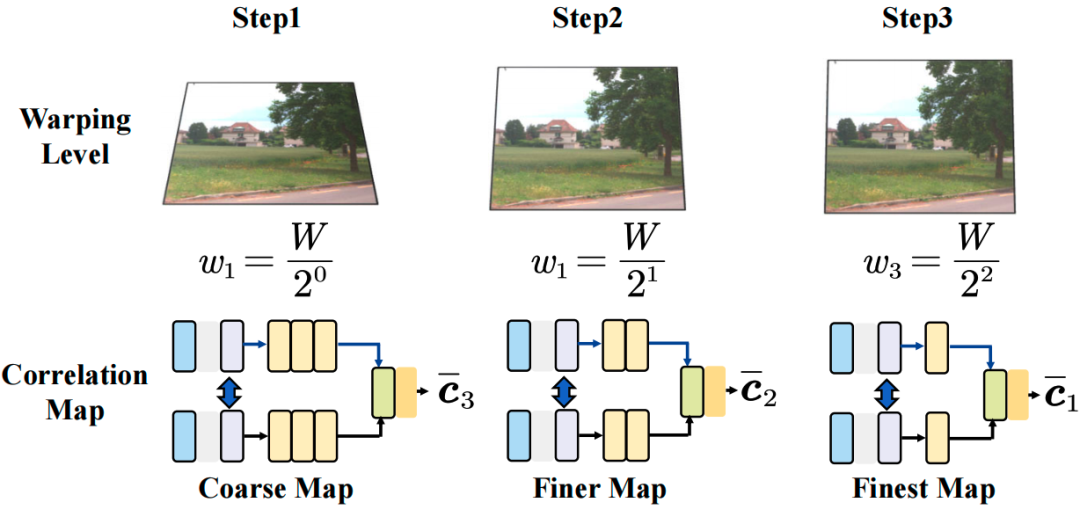
图 5: DHE的三步训练法;变形范围越来越小,相关性图从粗到细变化。
**一句话理解该方法:**沿着去噪路径产生出很多个单应矩阵,然后从中选出当前图片最好的匹配方案。
6. 实验结果
6.1 实验条件
FLIR(RGB/热红外)、HYPERSIM(RGB/深度)、RGB-NIR Scene(RGB/近红外)分别用、、对训练集、验证集和测试集进行划分,并且裁剪后的图片大小为;主要考察高斯噪声的标准差三种情况下的效果,并且比较了种去噪加配准的组合方法以及CrossHomo;DHE三步约训练了次迭代,AHS大约进行了次;Adam的学习率设为,训练和测试均采用单张 NVIDIA GeForce RTX 4090;评价指标包括平均角点误差(MACE)、五像素阈值下的曲线下面积(AUC@5)、十像素阈值下的曲线下面积(AUC@10),其中MACE越小越好,而AUC@5和AUC@10越大越好。HomoDiff 使用一个模型来表示所有的噪声级别,而组合的方法则是按照固定的噪声级别进行训练。
6.2 定量和定性的结果
对于FLIR上σ取值为25、50和100的时候,HomoDiff的MACE分别为3.60、4.23和5.53,在AUC@5上分别为81.14、61.79和56.58,在AUC@10上分别为97.77、96.77和90.32;对于三种噪声情况下的各项指标都处于最优状态;当σ取值为50时,MACE比次优结果低了;在相同的噪声条件下,HYPERSIM和RGB-NIR Scene的MACE分别为3.11和4.27,在AUC@5上分别为85.82和75.90,在AUC@10上分别为96.68和85.80;各项也都处于最优状态;从图6可以看出,在不同的模态场景中,预测出的四个角点的位置更加接近真实的值,尤其是在模态差别很大的FLIR和HYPERSIM之间。

表 2: FLIR在σ=25、50、100时MACE、AUC@5、AUC@10单应性的比较。
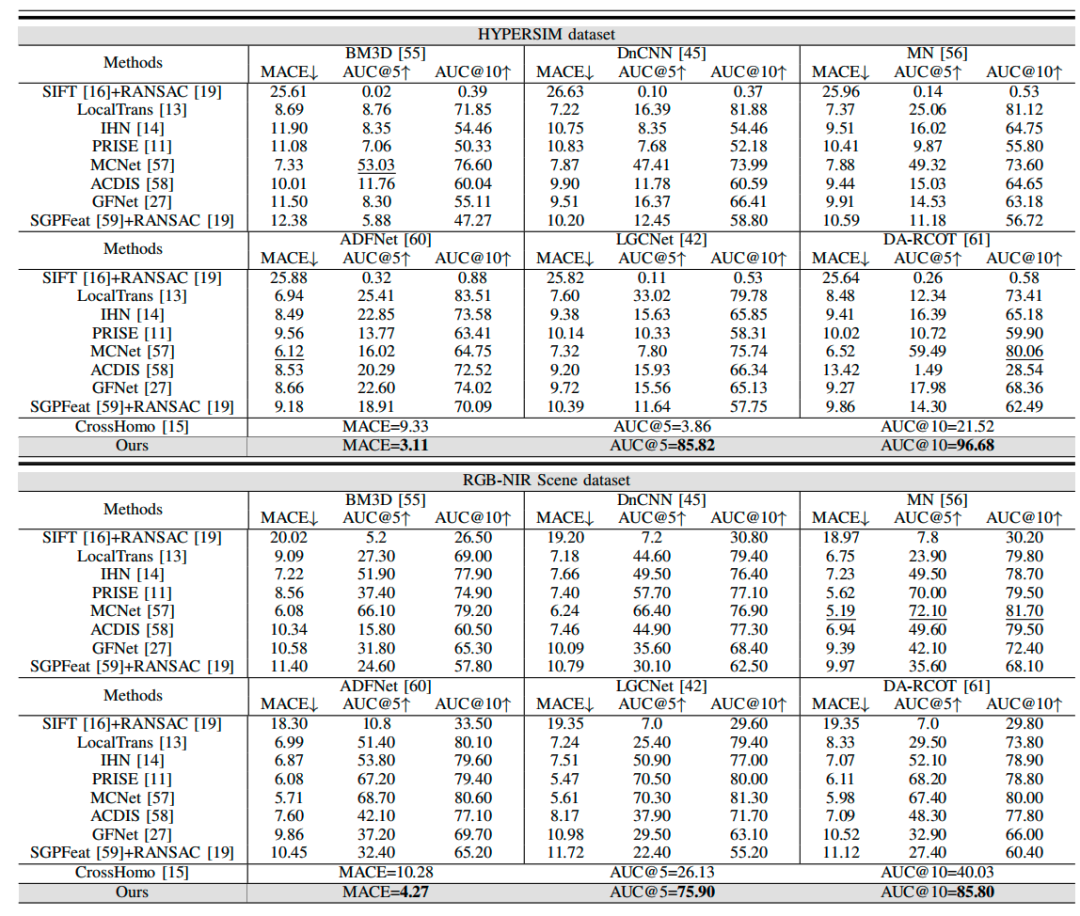
表 3: HYPERSIM和RGB-NIR Scene在σ=50时的三种对齐指标比较。
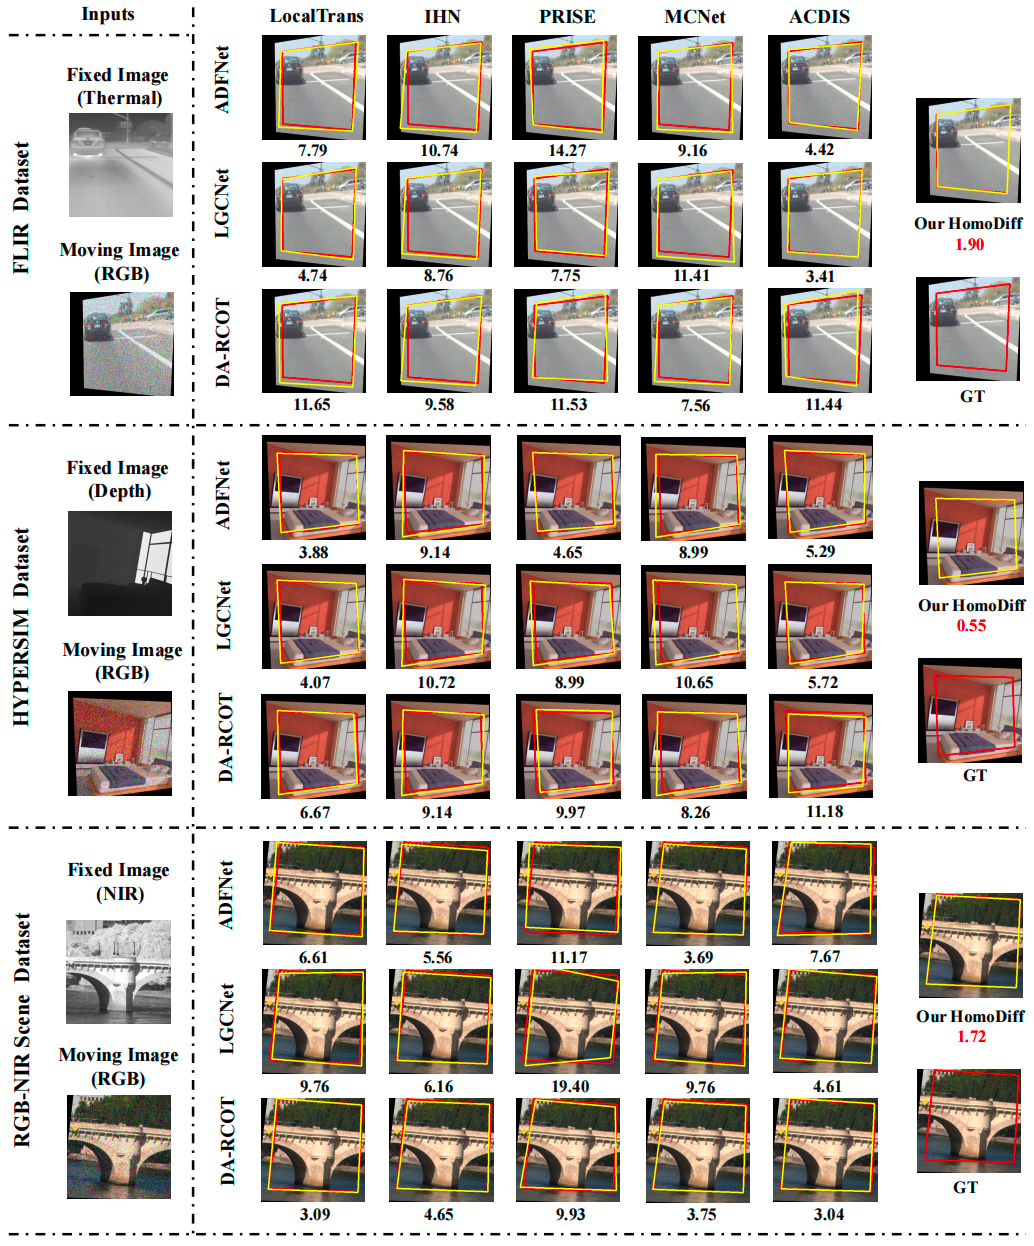
图 6: FLIR、HYPERSIM和RGB-NIR Scene在σ=50时的配准可视化,比较出预测的角点和真实角点的位置。
6.3 消融、速度和真实的噪音
FLIR消融的结果是:去掉 MID 的 CMG 后,MACE 由原来的增加到了现在的;最好的固定步长是第步,此时的 MACE 为,而 AHS 选择之后则变成了。只改变训练变形范围并没有改善误差;加上相关性图由粗到细之后,MACE 从最初的降低到了现在的。局部窗口半径时效果最好。增大形变范围会降低精度,在真实的噪声 Real-NAID 上三种不同等级噪声下的 MACE 分别为、和。本文没有给出目标检测或者语义分割的具体数值。
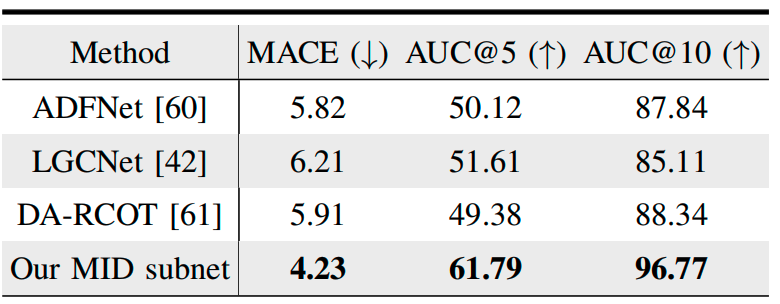
表 4: 用其他的图像去噪算法代替MID之后FLIR配准的结果。
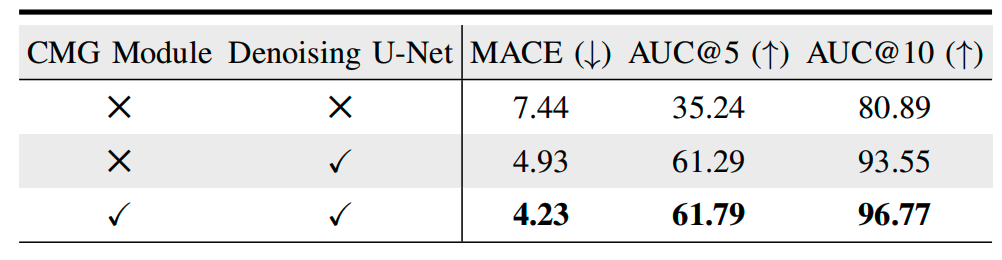
表 5: MID中CMG和去噪U-Net的组件消融情况。
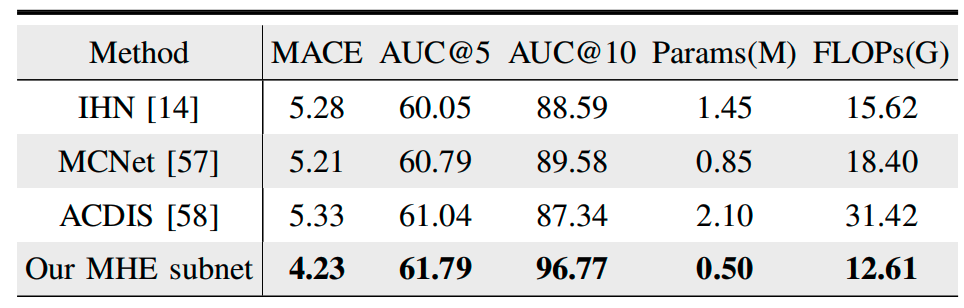
表 6: 用其他的单应性估计方法代替MHE之后的准确性和复杂度对比。
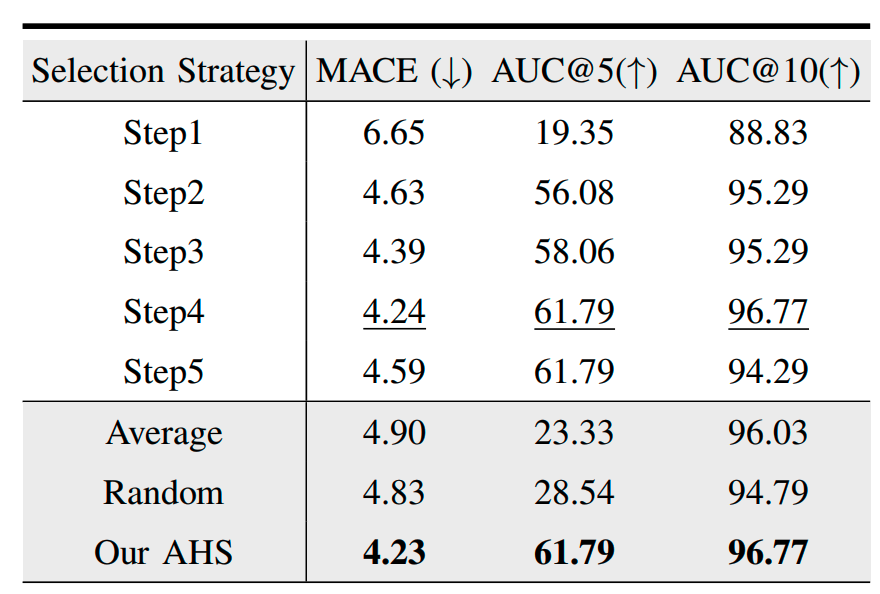
表 7: 固定推理步数以及平均、随机、AHS三种选择策略的配准结果。
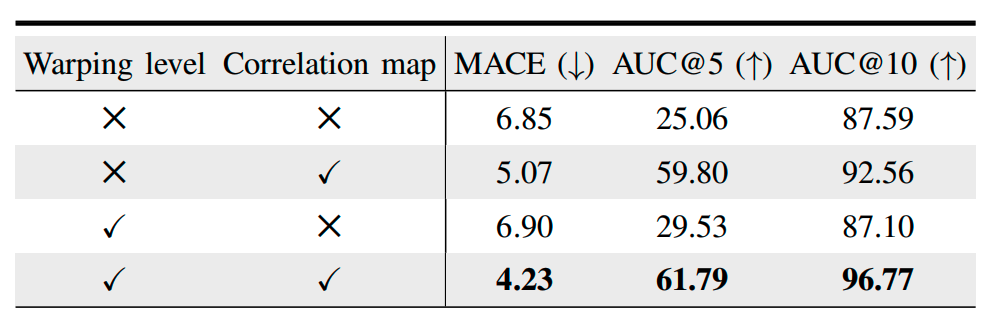
表 8: 形变范围变化以及相关的相关性图变化所采用的训练策略消融。
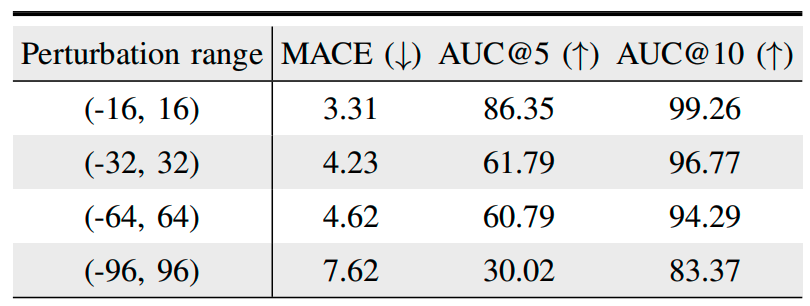
表 9: 不同扰动范围下FLIR配准的结果。
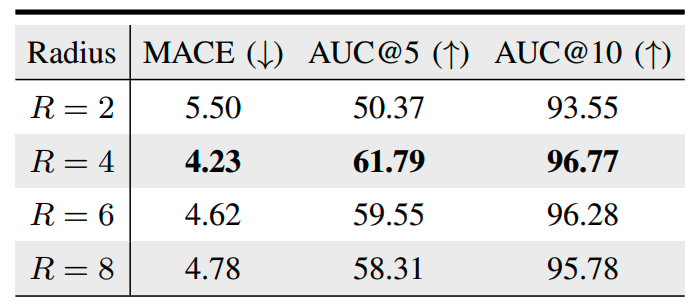
表 10: MHE中不同局部窗口半径所对应的消融情况。
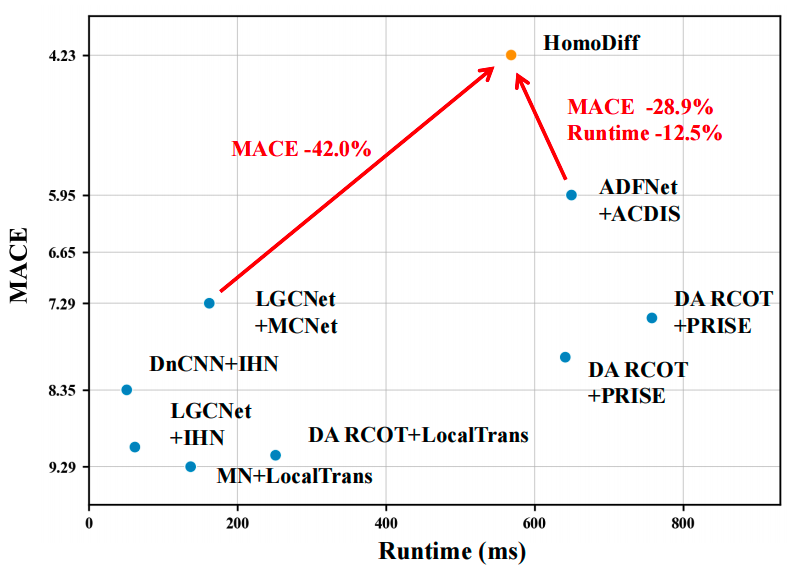
图 7: 平均运行时间和MACE的关系;HomoDiff用步推理,相较于ADFNet+ACDIS,MACE降低了,运行时间减少了。
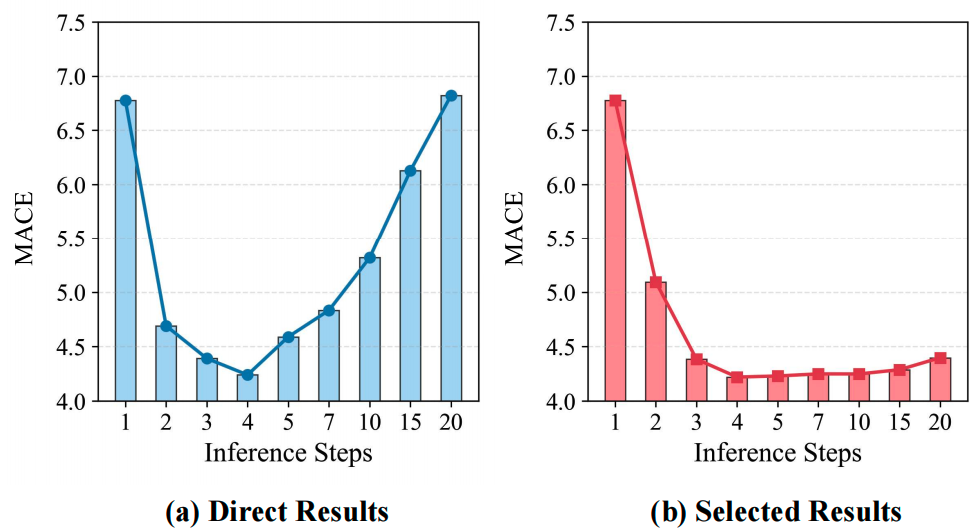
图 8: 推理步骤对直接配准和选择后的结果的影响;选择机制可以减轻过长推理步骤带来的精度降低。
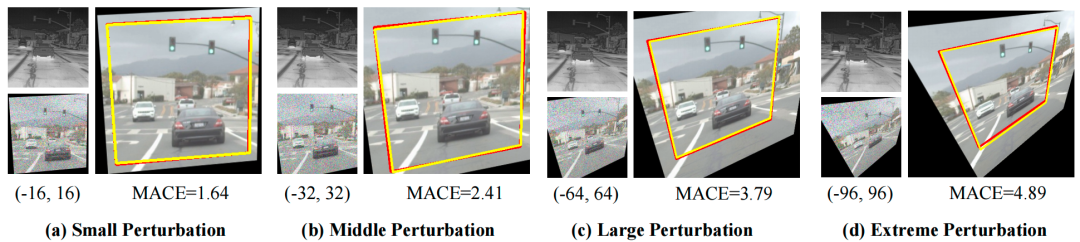
图 9: FLIR在σ=50以及四种不同扰动范围下进行配准时所呈现出来的可视化结果;扰动越大,则该任务就越困难。

表 11: Real-NAID三个等级的真实噪声下MACE、AUC@5和AUC@10的结果。

图 10: 含有真实噪声的RGB/NIR配准实例,红、蓝遮罩分别标示 RGB 图像与方法变换后的 NIR 图像。
6.4 模型复杂度
表6所列的MHE子网的0.50M参数量和12.61GFLOPs不能代表整个HomoDiff模型的成本,图7给出了时间和精度的对比情况,但是没有给出整个模型的参数量以及FLOPs。
7. 结论和预测
HomoDiff 将跨模态引导去噪、逐步单应性估计和误差预测选择结合起来,在合成高斯噪声和真实的噪声数据上进行配准能力的验证,并且提出配准所需要的去噪程度要有利于匹配,而不仅仅是为了提高去噪水平。该文认为减少对标注数据的依赖以及把配准推广到模糊、压缩伪影的情况中去是今后的研究方向。
**一句话总结:**最好的去噪步数由图像决定,HomoDiff 会为每一组有噪声的多模态图像选择一个更适合的单应矩阵。
[#多模态图像配准](javascript:😉 [#TPAMI](javascript:😉 [#多模态信息融合](javascript:😉 [#北京航空航天大学](javascript:😉 [#图像配准](javascript:😉 [#单应性矩阵估计](javascript:😉 [#计算机视觉](javascript:😉
往期推荐




评论前必须登录!
注册