 网硕互联帮助中心
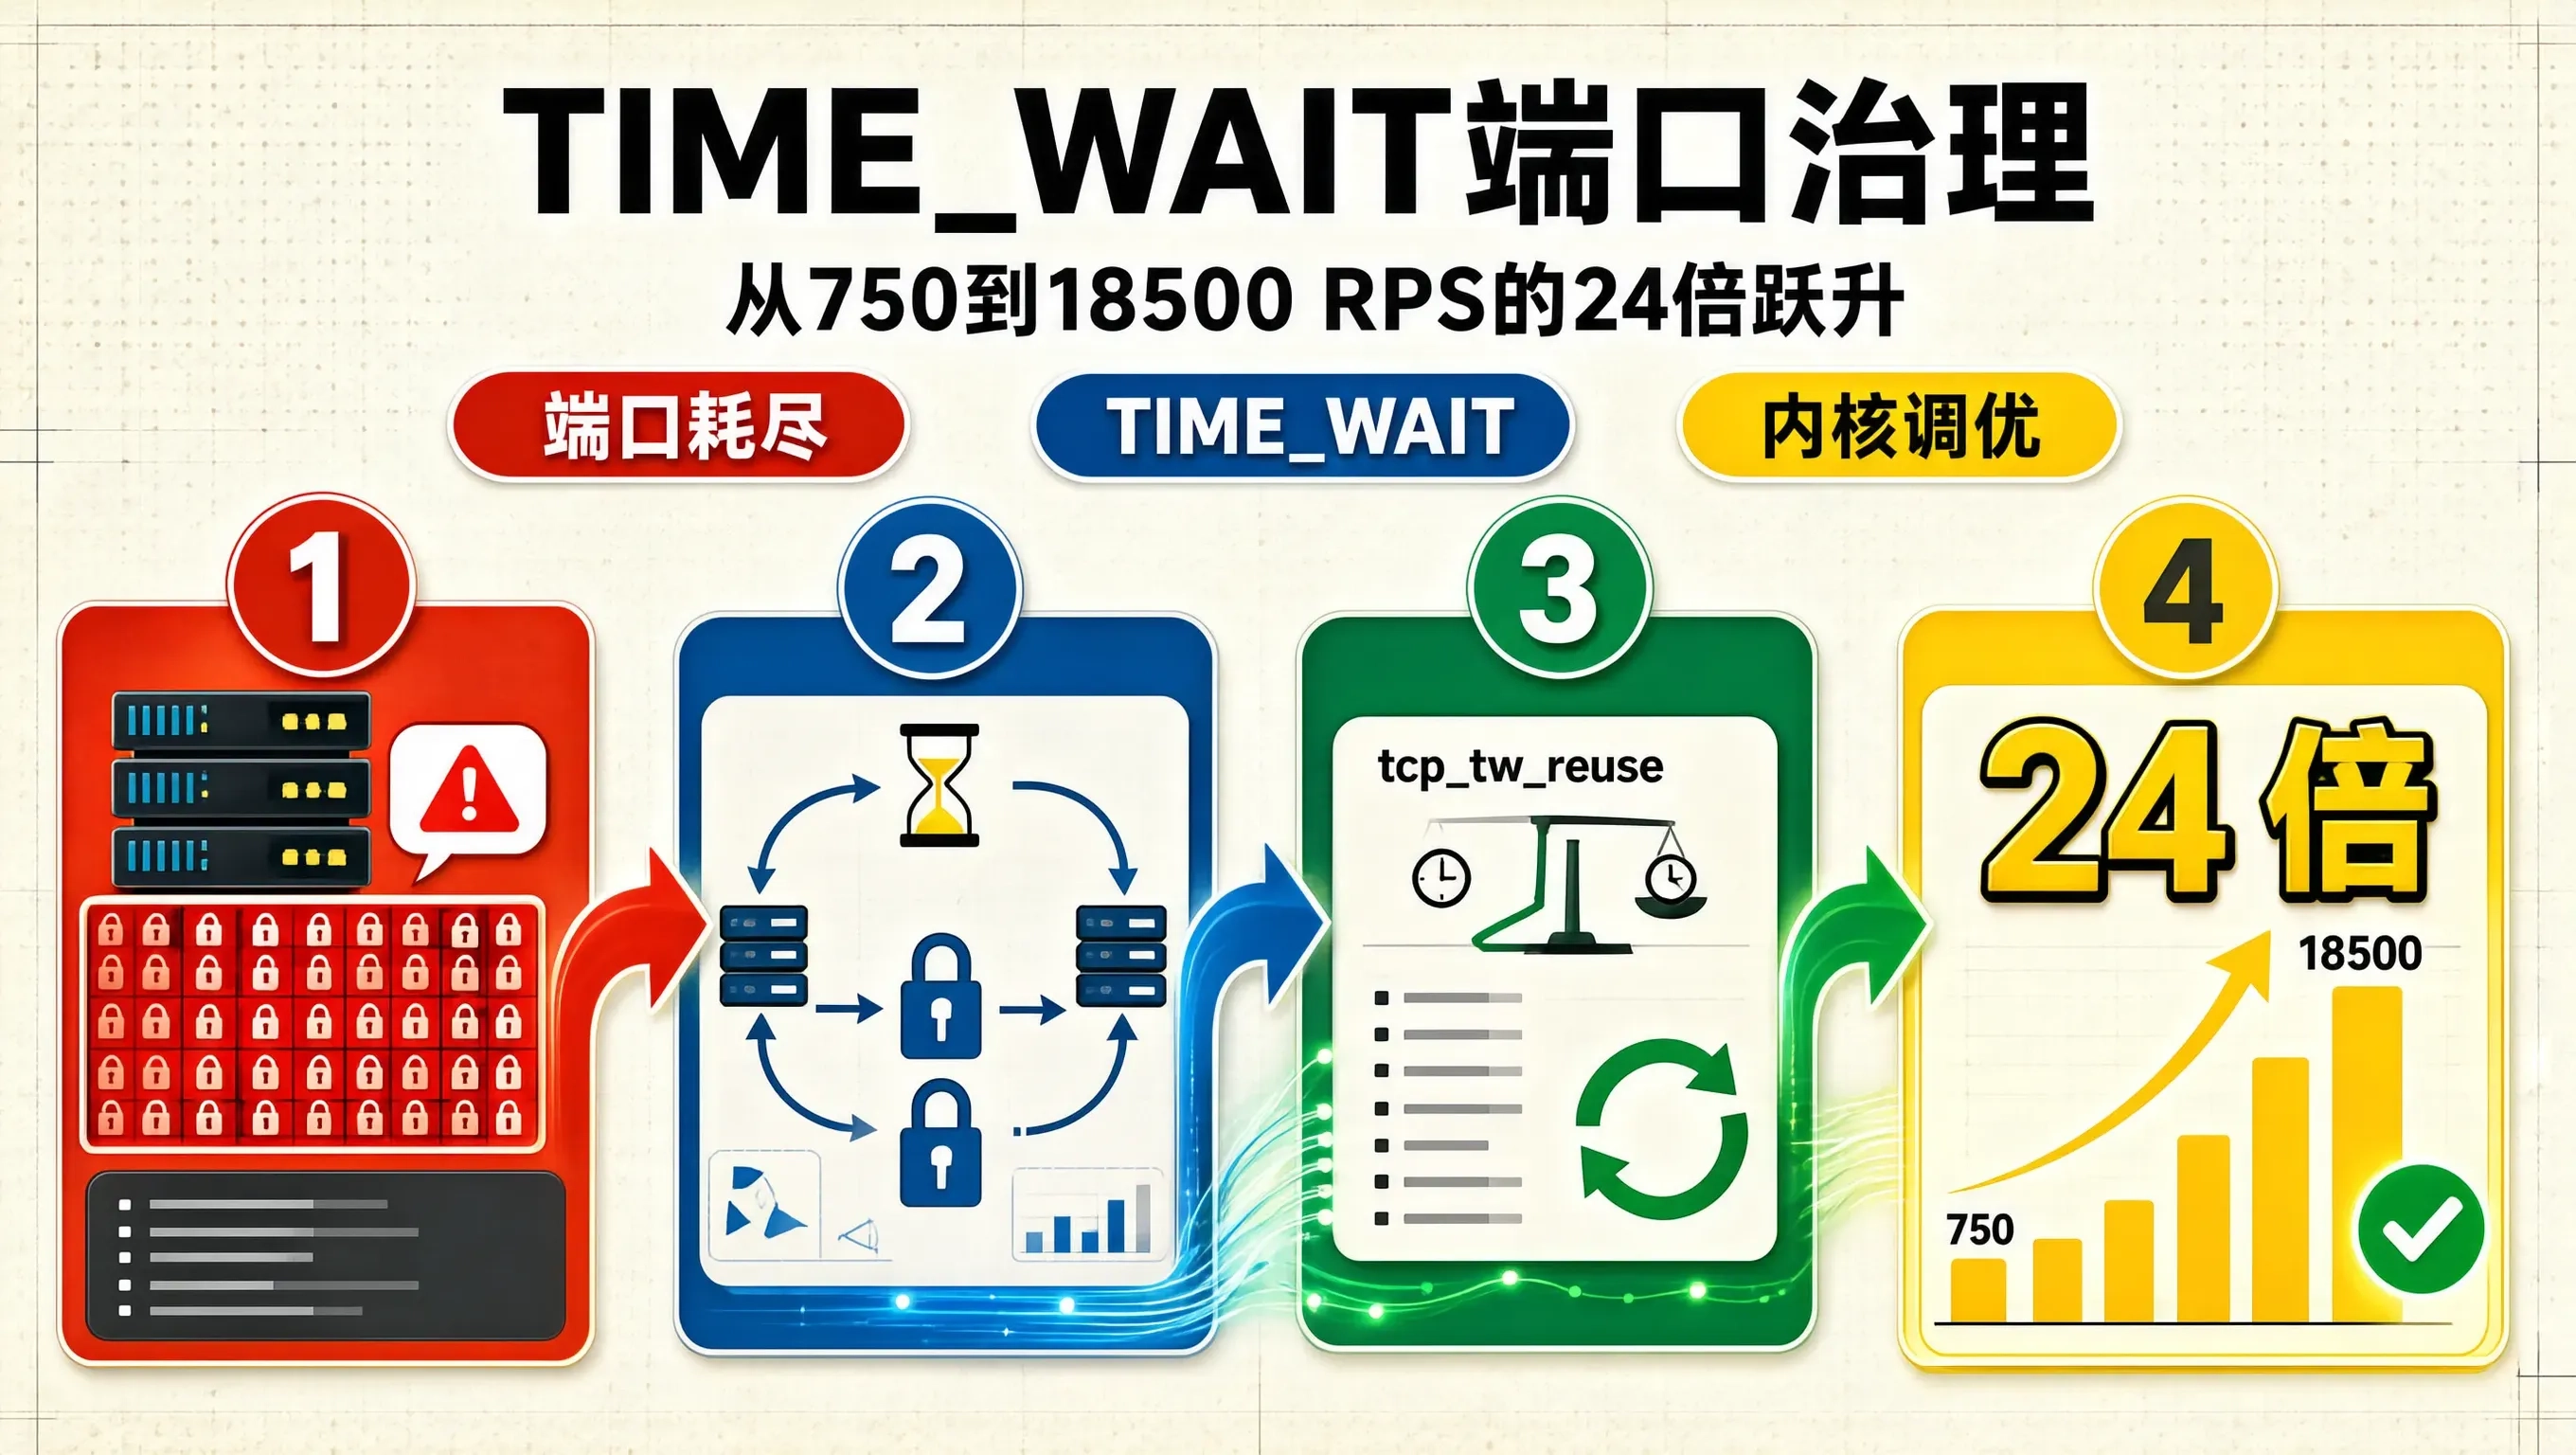
在针对企业级微服务集群与 API 网关执行全真高并发容量压测时,测试团队最常遭遇的、也最具杀伤力的系统级报错,莫过于在压测刚刚进入白热化阶段时,发压终端日志里突然如暴雨般刷出的操作系统级错误:
OSError: [Errno 99] Cannot assign requested address
aiohttp.client_exceptions.ClientConnectorError: Cannot assign requested address
紧接着,无论是 Locust 还是其他自研压测脚本,所有的请求成功率瞬间断崖式暴跌至 0%,发压机全面瘫痪。在很多缺乏底层操作系统网络栈经验的工程师看来,第一反应往往是怀疑“是不是被测的后端服务宕机把端口关掉了?”然而,只要你在发压机终端敲下一行系统诊断命令:
netstat -n | awk '/^tcp/ {++S[$NF]} END {for(a in S) print a, S[a]}'
屏幕上输出的数字会瞬间让你倒吸一口凉气:TIME_WAIT 状态的连接数赫然显示为整整 28,231 条!而当前操作系统的可用临时端口已经被彻底蚕食殆尽,新发起的请求在操作系统内核层根本无法申请到一个合法的本地源端口,被操作系统直接无情扼杀在萌芽之中。
这种“发压机把自己活活憋死”的尴尬灾难,在涉及高密短连接或连接池复用失效的高并发压测中屡见不鲜。本文将深入拆解 TCP 四次挥手协议栈在底层的物理运转逻辑,彻底理清 TIME_WAIT 的前世今生,并给出既符合 RFC 规范、又能在高并发下彻底根除端口耗尽的 Linux 内核工业级治理方案。
一、为什么会有 TIME_WAIT?TCP 协议栈的物理宿命
在 TCP/IP 协议规范(RFC 793)中,连接的正常终止需要经过经典的“四次挥手”。在这个过程中,主动发起关闭连接的一方(Active Closer,通常在压测场景下是客户端发压机自身),在发送出最后一个 ACK 确认报文后,并不能立即将该 Socket 销毁或将其占用的端口重新分配给其他连接,而是必须在内核中强制停留在一个名为 TIME_WAIT 的特殊状态中:
[主动关闭方 (发压客户端)] [被动关闭方 (服务端)]
│ │
├─── 发送 FIN 报文 ────────────────────────────────────►│ (进入 CLOSE_WAIT)
│◄── 回复 ACK 报文 ────────────────────────────────────┤
│ │
│◄── 发送 FIN 报文 ────────────────────────────────────┤ (准备关闭)
├─── 回复最后一个 ACK 报文 ────────────────────────────►│ (进入 CLOSED)
│
▼
[强制进入 TIME_WAIT 状态!]
维持时长: 2 * MSL (Maximum Segment Lifetime,Linux 默认硬编码为 60 秒)
在此长达 60 秒的时间窗口内,该 (源IP, 源端口, 目的IP, 目的端口) 四元组被绝对冻结锁死!
很多工程师会抱怨:“既然双方都已经完成了关闭,为什么还要傻傻地死等 60 秒之久?”在不可靠的物理互联网络中,TIME_WAIT 的存在是为了捍卫两条神圣的因果防线:
因此,按照规范,内核必须等待 $2 \\times \\text{MSL}$(报文最大生存周期的两倍),确保旧连接在物理网络中的所有残存报文全部在传输层自然消亡,才能安全释放该端口。
二、算术账本:为什么发压机会在 30 秒内自杀?
问题在于:压测场景的并发密度远远超越了日常平缓的互联网世界。
在 Linux 默认的内核参数配置下:net.ipv4.ip_local_port_range 通常被保守地配置为:32768 60999。这意味着操作系统留给所有对外发起连接的应用程序的临时源端口总数,仅仅只有:$60999 – 32768 = 28,231$ 个!
假设我们在进行每秒 1,000 次请求的轻量短连接压测:
- 第 1 秒:消耗 1,000 个源端口,进入 TIME_WAIT 锁定 60 秒;
- 第 10 秒:累计锁定 10,000 个端口;
- 第 28 秒:累计锁定 28,000 个端口;
- 第 29 秒:操作系统的 28,231 个可用端口被全量抢光!
此时,操作系统内核的端口分配器在遍历了整个端口位图后,绝望地发现没有一个端口处于空闲状态,只能无奈地向调用方抛出 [Errno 99] Cannot assign requested address。发压机当场猝死。
三、历史毒药 tcp_tw_recycle 与救赎之星 tcp_tw_reuse
很多运维人员在网上搜索解决方案时,经常会看到一些十年前陈旧博客推荐的“万能偏方”:开启 tcp_tw_recycle = 1。这是一个足以摧毁生产环境的致命毒药!
为什么生产严禁开启 tcp_tw_recycle?
tcp_tw_recycle 采用了极其激进的快速回收策略,它强行依赖 TCP 时间戳(Timestamp)的单调递增性来识别旧报文。然而,在现代云计算与企业网络中,绝大多数外部流量都会穿透企业 NAT 网关、F5 负载均衡器或客户端手机运营商的 NAT 代理。同一个公网 IP 背后隐藏着成千上万台物理设备,它们各自的时钟根本不可能完全同步!一旦开启 tcp_tw_recycle,当一台时间戳稍微滞后的客户端发来 SYN 包时,Linux 内核会误判定该数据包属于旧连接的历史迷途报文,直接在内核驱动层将其静默丢弃(Silent Drop)!这会导致成千上万的真实用户遭遇无法建立连接的严重线上惨剧。由于这一机制极其危险,Linux 内核官方在 4.12 版本中已经将其彻底物理拔除废弃!
救赎之星:tcp_tw_reuse 的安全数学原理
真正具备生产级安全性的解决方案是开启 net.ipv4.tcp_tw_reuse = 1。
与盲目回收的 recycle 不同,tcp_tw_reuse 的适用范围被极其克制地严格限定在**客户端对外发起的主动连接(Outgoing Connect)**上:当发压机作为客户端尝试调用 connect() 申请端口,且发现可用端口已经耗尽时,如果开启了该参数,内核会安全地检查那些处于 TIME_WAIT 状态已经超过 1 秒 的端口:只要新发起的连接其 TCP 时间戳严格大于上一次连接记录的时间戳,内核就会安全地让渡并复用该端口!这种复用完全符合 RFC 1323 标准,在数学上绝对杜绝了报文混淆,既保全了网络协议栈的严谨性,又在瞬间解除了端口锁死的绝境。
四、工业级发压机网络参数全量调优脚本
以下为针对分布式发压节点彻底根除 Errno 99 报错的生产级调优自动化脚本:
#!/bin/bash
# ==============================================================================
# 彻底根除压测端 "Cannot assign requested address (Errno 99)" 生产级内核优化
# ==============================================================================
set -e
echo "[STEP 1] 正在解锁操作系统全量临时端口范围…"
# 将可用端口从默认的 2.8 万个大幅扩充至 6.4 万个 (1024 到 65535)
sysctl -w net.ipv4.ip_local_port_range="1024 65535"
echo "[STEP 2] 启用基于时间戳的安全 TIME_WAIT 端口复用…"
# 必须确保 tcp_timestamps 开启,这是 tcp_tw_reuse 安全运转的数学前提
sysctl -w net.ipv4.tcp_timestamps=1
sysctl -w net.ipv4.tcp_tw_reuse=1
echo "[STEP 3] 调大系统 TIME_WAIT 套接字全局回收桶上限…"
# 调大系统所能容纳的 TIME_WAIT 最大数量,防止内核打印 "TCP: time wait bucket table overflow"
sysctl -w net.ipv4.tcp_max_tw_buckets=262144
echo "[STEP 4] 缩短 TCP 孤儿连接与 FIN-WAIT-2 超时时间…"
# 将 FIN-WAIT-2 状态的超时时间从默认的 60 秒收敛至 15 秒,加速死连接销毁
sysctl -w net.ipv4.tcp_fin_timeout=15
echo "[STEP 5] 调大全局单进程文件句柄上限…"
ulimit -n 1048576
# 将配置固化到 /etc/sysctl.conf,防止重启失效
cat << 'EOF' > /etc/sysctl.d/99-stress-test-tw.conf
net.ipv4.ip_local_port_range = 1024 65535
net.ipv4.tcp_timestamps = 1
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_max_tw_buckets = 262144
net.ipv4.tcp_fin_timeout = 15
EOF
sysctl -p /etc/sysctl.d/99-stress-test-tw.conf
echo "[SUCCESS] 发压机本地端口与 TIME_WAIT 治理全量生效!"
五、压测调优实战复盘与成效对比
在双十一大促前夕对某核心 API 网关执行的密集高并发短连接压力测试中,我们在单台发压物理机上进行了调优前后的全真对比测试:
+————————————+—————+—————+——————-+
| 发压机网络参数配置 | 最大持续发压率| Errno 99 报错 | TIME_WAIT 维持峰值|
+————————————+—————+—————+——————-+
| 操作系统默认参数 (未调优) | 750 RPS | 第 28 秒爆发 | 28,200 (打满死锁) |
| 仅调整端口范围 (1024 ~ 65535) | 1,800 RPS | 第 62 秒爆发 | 64,500 (依然耗尽) |
| **全量开启 tcp_tw_reuse + 端口解锁**| **18,500 RPS**| **0 笔 (彻底消除)| **常驻 6.2 万但安全复用**|
+————————————+—————+—————+——————-+
复盘数据揭示出压倒性的工程红利:


评论前必须登录!
注册