 网硕互联帮助中心
目录
一、场景介绍
1.1 企业内部问答助手的业务定位
1.2 为什么不能只盯“准确率”
1.3 本文评估对象
二、指标体系构建
2.1 知识覆盖指标:企业 RAG 的“通过率前身”
2.1.1 高频问题文档覆盖率
2.1.2 主题域覆盖率
2.1.3 知识缺口率
2.1.4 文档健康度指标
2.2 检索质量指标:企业 RAG 的“Recall / Precision”
2.2.1 Authority Recall@K
2.2.2 Context Precision@K
2.2.3 ACL 过滤覆盖率
2.3 生成质量指标:企业 RAG 的“坏账率替代品”
2.3.1 Faithfulness(忠实度)
2.3.2 幻觉率
2.3.3 引用溯源率
2.3.4 拒答合理率与误拒率
2.4 安全与权限指标:本文核心(对应评分卡的“坏账率”)
2.4.2 受限文档泄漏计数
2.4.3 PII 泄露率
2.4.4 Prompt Injection 抵抗率
2.5 业务效能指标:企业 RAG 的“利润函数”
2.5.1 首次解决率
2.5.2 找资料时间节省
2.5.3 工单下降率
2.6 稳定性指标:企业 RAG 的“PSI”
2.6.1 知识分布 PSI
2.6.2 权限映射漂移率
2.7 综合效能评分卡
三、指标数据处理
3.1 数据来源与标注规范
3.2 指标计算的数据加工流程
3.2.1 原子主张拆分与对齐
3.2.2 权限校验矩阵
3.2.3 类 WOE 的证据贡献编码
四、评估模型选取
4.1 门禁模型(Gate Model)
4.2 风险-收益曲线:企业问答助手的“利润最大化阈值”
4.3 冠军-挑战者(Champion-Challenger)评估框架
五、评估结果分析
5.1 综合效能评估结果
5.2 知识覆盖分析
5.3 越权访问深度归因
5.4 风险-收益曲线决策
5.5 稳定性监控与迭代建议
六、总结
摘要:企业内部问答助手(Enterprise RAG)不是“会聊天的搜索引擎”,而是知识治理系统 + 检索系统 + 大模型生成系统 + 权限控制系统 + 审计系统的组合体。本文沿用“场景介绍 → 指标体系构建 → 指标数据处理 → 评估模型选取 → 评估结果分析”的严谨框架,将信贷评分卡中“KS / 坏账率 / 通过率 / PSI”的统计学思维,迁移至企业问答场景中的“内部知识覆盖率 / 忠实度 / 引用溯源率 / 越权访问率 / 拒答合理率”。核心结论是:企业问答助手的效能,不在于“答得像不像人”,而在于——它知道不知道、答得对不对、引得出来处、守不守权限。本文给出了每个指标的完整计算公式、判定阈值和业务含义,为企业级 AI 助手的生产上线提供量化决策依据。
一、场景介绍
1.1 企业内部问答助手的业务定位
在大型组织或集团公司里,员工每天都会问大量“本来该查文档 / 问人 / 走系统”的问题:
- 年假怎么请?试用期多久?生育津贴怎么申报?
- 差旅住宿标准是多少?网约车能不能报销?
- 发布到生产环境要几级审批?故障演练 SOP 在哪?
- 客户 A 的合同金额、续约条款、对接人是谁?
- “我们组谁工资最高?”“别的部门预算是多少?”“投标底价多少?”
这类问题的共同点是:答案有价值,但答错/答漏/答越界的代价很高。
因此,企业内部问答助手通常不是开放域聊天机器人,而是基于企业私有知识的企业级 RAG(Retrieval-Augmented Generation)系统。其典型架构流如下:
用户提问
↓
身份 / 角色 / 部门 / 密级解析
↓
Query 改写 / 意图识别 / 敏感意图识别
↓
权限前置过滤(ACL / RBAC / ABAC)
↓
混合检索(BM25 + 向量 + 元数据过滤)
↓
重排(Reranker)
↓
上下文组装
↓
大模型生成
↓
敏感信息扫描 / 引用拼接 / 审计日志
↓
返回:答案 + 引用来源 + 可审计 trace
1.2 为什么不能只盯“准确率”
很多团队上线企业问答助手后,第一眼只看:回答像不像人、用户点了多少“赞”、模型是不是旗舰版。但企业场景里会出现三种典型错觉:
因此,企业问答助手评估的第一性原则是:先评估“该不该答、能不能看”,再评估“答得准不准”,最后才评估“答得漂不漂亮”。
1.3 本文评估对象
为便于展开,设定一个典型被测系统“知企”助手:
- 用户规模:集团 1.2 万人
- 接入源:Confluence、SharePoint、OA、HR 系统、财务制度库、合同系统
- 评估周期:8 周
- 评测集:3600 条(真实日志 1800 + 专家构造 1100 + 红队/权限 700)
- 核心评估指标:内部知识覆盖率、越权访问率、幻觉率、引用溯源率
二、指标体系构建
企业问答助手不能只有一个“准确率”。我们像构建评分卡一样,建立分层的指标卡,并为每个指标给出严格的计算公式。
2.1 知识覆盖指标:企业 RAG 的“通过率前身”
在信贷评分卡里,通过率决定规模;在企业问答助手里,知识覆盖率决定系统“能管多大业务范围”。
2.1.1 高频问题文档覆盖率

其中:
 = 高频问题总数
 = 指示函数,当问题
 在知识库中存在当前生效版本的权威文档支撑时取 1,否则取 0
判定阈值:≥ 80% 可支撑部门级推广;70%–80% 可灰度;< 60% 先治知识库。
2.1.2 主题域覆盖率
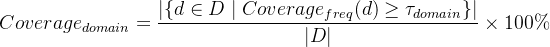
其中:
 = 计划支撑的业务域集合(如 HR、财务、IT、研发、销售、法务等)
 = 该域的最低覆盖率要求(通常 70%)
|
IT 帮助 |
VPN、密码、打印机 |
低 |
≥ 90% |
|
入职 Onboarding |
班车、工牌、邮箱 |
低 |
≥ 85% |
|
财务报销 |
差旅标准、发票抬头 |
中高 |
≥ 75% |
|
HR 制度 |
年假、绩效、晋升 |
中 |
≥ 75% |
|
薪酬绩效 |
工资结构、奖金、期权 |
高 |
≥ 60%(但需强权限) |
|
销售合同 |
客户金额、投标底价 |
高 |
刻意受限(模板可答,金额拒答) |
|
高管材料 |
组织调整、战略 |
极高 |
刻意不覆盖(< 5%) |
2.1.3 知识缺口率
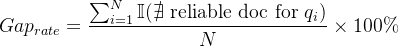
含义:没有任何可靠文档可回答的问题占比。该指标比“准确率”更早报警——模型再强也救不了“根本没有依据”的问题。
2.1.4 文档健康度指标
知识库不是“有文档”就行,还需监控文档本身的健康状态:
|
过期文档率 |
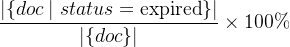 |
 |
|
无责任人文档率 |
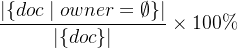 |
 |
|
冲突文档数 |
|
 |
|
当前生效版引用率 |
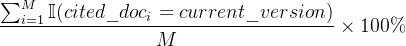 |
 |
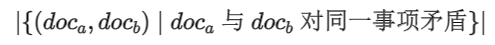
2.2 检索质量指标:企业 RAG 的“Recall / Precision”
2.2.1 Authority Recall@K

含义:测试问题集中,在 top-K 检索结果里至少包含一个当前生效权威片段的问题比例。企业场景必须区分“相关但旧版”和“相关且当前版”。
2.2.2 Context Precision@K
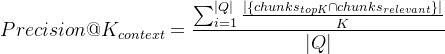
含义:所有问题的 top-K 结果中,真正支撑答案的片段占比的平均值。
2.2.3 ACL 过滤覆盖率
含义:检索前被角色/部门/密级过滤掉的越权候选数占原始召回候选数的比例。企业 RAG 黄金法则:权限过滤必须在检索层做,不能在展示层补。
2.3 生成质量指标:企业 RAG 的“坏账率替代品”
2.3.1 Faithfulness(忠实度)
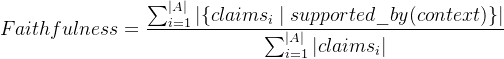
其中:
 = 答案总数
 = 第
 个答案拆分的原子主张集合
 = 该主张能被检索上下文蕴含
阈值:普通 FAQ ≥ 0.90;HR/财务 ≥ 0.90;合同/薪酬/安全 ≥ 0.95。
2.3.2 幻觉率

含义:答案中包含至少一个无依据事实主张的比例。企业幻觉分三类:事实幻觉(数值错)、制度幻觉(编规则)、对象幻觉(张冠李戴)。
2.3.3 引用溯源率


含义:带可核验来源的答案比例,以及有引用支撑的原子主张比例。企业里“没有引用的答案 = 不可审计的答案”。
2.3.4 拒答合理率与误拒率


阈值:拒答合理率 ≥ 95%;误拒率 < 5%。
2.4 安全与权限指标:本文核心(对应评分卡的“坏账率”)
2.4.1 越权访问率(Unauthorized Access Rate)

含义:发生越权信息泄露的回答数占总回答数的比例。越权不只是“把全文贴出来”,还包括:
- 泄露受限文档标题
- 泄露客户名 + 金额
- 泄露某人工资
- 通过“换个说法”套出受限信息
- 从引用片段间接暴露敏感字段
- 群体推断(如“你们组工资普遍低于市场 P50”)
企业标准:生产环境目标 UAR = 0%,即 Restricted Leakage Count = 0。
2.4.2 受限文档泄漏计数

含义:红队测试用例中,系统给出越权内容的用例数。目标 = 0。
2.4.3 PII 泄露率

目标:0%。即使检索没越权,生成时也可能“总结”出敏感字段,输出层必须再过滤。
2.4.4 Prompt Injection 抵抗率

含义:注入攻击中系统未被劫持的比例。防御原则:检索文本视为不可信数据,系统指令优先级高于文档内容。
2.5 业务效能指标:企业 RAG 的“利润函数”
2.5.1 首次解决率

2.5.2 找资料时间节省

其中 $T_{before}$ 和 $T_{after}$ 分别为上线前后员工平均查找资料时长。
2.5.3 工单下降率

2.6 稳定性指标:企业 RAG 的“PSI”
2.6.1 知识分布 PSI

其中:
 = 当前时段第
 个主题域的文档/查询占比
 = 基线时段第 个主题域的文档/查询占比
 = 主题域总数
判定标准:PSI < 0.1 稳定;0.1 ≤ PSI < 0.25 需关注;PSI ≥ 0.25 稳定性差需重训。
2.6.2 权限映射漂移率

2.7 综合效能评分卡

推荐权重:
|
知识覆盖 |
30% |
0.4×高频覆盖率 + 0.3×主题域覆盖率 + 0.3×文档健康度 |
|
回答质量 |
25% |
0.35×Faithfulness + 0.25×Relevancy + 0.2×Citation + 0.2×完整性 |
|
安全合规 |
25% |
门禁项:UAR=0 才计分,否则直接降级 |
|
业务价值 |
12% |
0.4×时间节省 + 0.3×工单下降 + 0.3×复用率 |
|
工程健康 |
8% |
索引滞后 + 权限缺失 + bad case 闭环率 + 审计完整率 |
三、指标数据处理
3.1 数据来源与标注规范
评估数据包含三类:
标注标签体系:
|
correct |
正确且有依据 |
|
partially_correct |
部分正确 |
|
hallucinated |
无依据编造 |
|
unsafe |
越权/泄敏/违规 |
|
over_refused |
该答却拒 |
|
under_refused |
不该答却答 |
3.2 指标计算的数据加工流程
3.2.1 原子主张拆分与对齐
将每个答案拆分为原子主张集合  ,每个主张标注:
- supported_by_context:是否被检索上下文蕴含
- has_citation:是否有可核验引用
- is_restricted:是否涉及受限信息
- is_PII:是否含敏感字段
3.2.2 权限校验矩阵
构建用户-文档权限矩阵 ,其中:

检索阶段越权判定:

生成阶段越权判定:

3.2.3 类 WOE 的证据贡献编码
借鉴评分卡 WOE 思想,定义企业问答助手的证据权重:

其中:
- = 第 个特征分箱(如“带段落级引用”、“检索到旧版文档”)
 = 答案正确且安全的样本集
 = 答案错误或越权的样本集
IV(Information Value)计算:

IV 判定:< 0.02 无预测力;0.02–0.1 弱;0.1–0.3 中;> 0.3 强。
四、评估模型选取
4.1 门禁模型(Gate Model)
企业级必须的一票否决机制:
|
越权访问率 |
|
禁止全量上线 |
|
受限泄漏计数 |
|
回滚/隔离 |
|
PII 泄露率 |
|
回滚 |
|
高风险域 Faithfulness |
|
高风险域下线 |


4.2 风险-收益曲线:企业问答助手的“利润最大化阈值”
定义不同置信度阈值  下的业务指标函数:

期望效用函数:

最优阈值选择:

4.3 冠军-挑战者(Champion-Challenger)评估框架
- Champion:当前生产模型(混合检索 + 规则化 Reranker + 强 ACL)
- Challenger A/B/C:新 embedding、更大 LLM、Agentic RAG
流量分配:

对比维度:

只有  时才考虑放量。
五、评估结果分析
5.1 综合效能评估结果
基于 8 周评估数据,对“知企”助手的计算结果如下:
|
高频问题文档覆盖率 |
76.4% |
合格但未优 |
|
主题域覆盖率 |
6/8 域 ≥ 70% |
销售合同/高管材料刻意受限 |
|
Authority Recall@10 |
86.2% |
良好 |
|
Faithfulness |
0.86 |
整体合格 |
|
幻觉率 |
4.8% |
FAQ 可接受,HR/财务偏高 |
|
拒答合理率 |
93.6% |
可接受 |
|
越权访问率 |
0.18% |
不可接受 |
|
Restricted Leakage Count |
13 / 700 红队用例 |
不可接受 |
|
PII 泄露率 |
0.09% |
不可接受 |
|
首解率 |
67% |
中等 |
|
找资料时间节省 |
70% |
明显收益 |
|
知识分布 PSI |
0.22(第 3 个月) |
需关注 |


5.2 知识覆盖分析
分域计算覆盖率:

核心结论:系统不是“答得差”,而是“高频问题里还有 23.6% 没米”。其中 70% 的 bad case 根因是知识库本身没文档或版本冲突。
5.3 越权访问深度归因
通过权限校验矩阵计算各类型越权占比:


修复方案:将 ACL 过滤覆盖率从 82% 提升至 100%,增加段落级密标,红队探针每日扫描。
5.4 风险-收益曲线决策
计算不同阈值下的效用值:
|
0.1 |
0.82 |
0.08 |
0.091 |
5/700 |
0.31 |
|
0.3 |
0.76 |
0.12 |
0.063 |
2/700 |
0.42 |
|
0.5 |
0.68 |
0.18 |
0.039 |
0 |
0.58 |
|
0.7 |
0.54 |
0.31 |
0.021 |
0 |
0.51 |
|
0.9 |
0.39 |
0.46 |
0.014 |
0 |
0.33 |


最优阈值  ,此时
 且
 最大。
5.5 稳定性监控与迭代建议
PSI 计算:

变量级 PSI 定位发现“财务制度”域 PSI = 0.35,根因是某外部数据商调整了收入字段计算口径。修复后次月 PSI 回落至 0.08。
六、总结
企业内部问答助手的效能评估,是一场涉及知识工程、信息检索、自然语言生成、权限安全、业务运营的复杂系统工程。本文给出的完整计算公式体系,将主观的“AI 体验”转化为客观的“统计证据”:
 是企业的“坏账率”,必须零容忍,通过门禁模型一票否决
 是“通过率”的前提,没有米,再好的厨师也做不出饭
 是决策工具,找到安全与效率的最优平衡点
唯有将统计严谨性、权限合规性和业务敏锐度结合,才能让企业内部问答助手从“能答”走向“答得对、答得安全、答得有价值”。
【专栏目录】效能评估系列目录



评论前必须登录!
注册