 网硕互联帮助中心
文章目录
-
- 1. 相同的数据,可以有三种取出规则
- 2. stack 与 queue:接口简单,但使用习惯不能含糊
-
- 2.1 先用一个小程序观察
- 2.2 用一张表把共同点与区别放在一起
- 2.3 为什么没有 begin 和 end
- 3. 容器适配器:复用存储,改变使用方式
-
- 3.1 “再包一层”不是重新写一个容器
- 3.2 与设计模式的关系
- 4. 可替换底层容器,先看它提供什么
-
- 4.1 第二个模板参数
- 4.2 deque:逻辑上是一列,典型实现中分段存储
- 4.3 为什么默认选 deque
- 5. 两个适配器的简短实现
-
- 5.1 栈:把尾部当作唯一入口和出口
- 5.2 队列:只把删除操作换到头部
- 5.3 为什么没有再次手写析构、深拷贝与赋值
- 6. priority_queue:每次给出当前最高优先级
-
- 6.1 默认大堆与小堆的用法
- 6.2 用数组表示树,不等于把数组排好序
- 7. 比较器与堆调整:规则如何变成算法
-
- 7.1 less 为什么对应大堆
- 7.2 插入:新元素只可能破坏祖先路径
- 7.3 删除:先用末尾元素填根,再向下调整
- 7.4 把存储、比较和调整组合起来
- 7.5 复杂度:把堆算法与容器操作分开看
- 8. 扩展练习
-
- 8.1 用两个栈实现最小栈
- 8.2 用两个栈实现先进先出队列
- 9. 总结
代码仓库:《stack queue的模拟实现》
1. 相同的数据,可以有三种取出规则
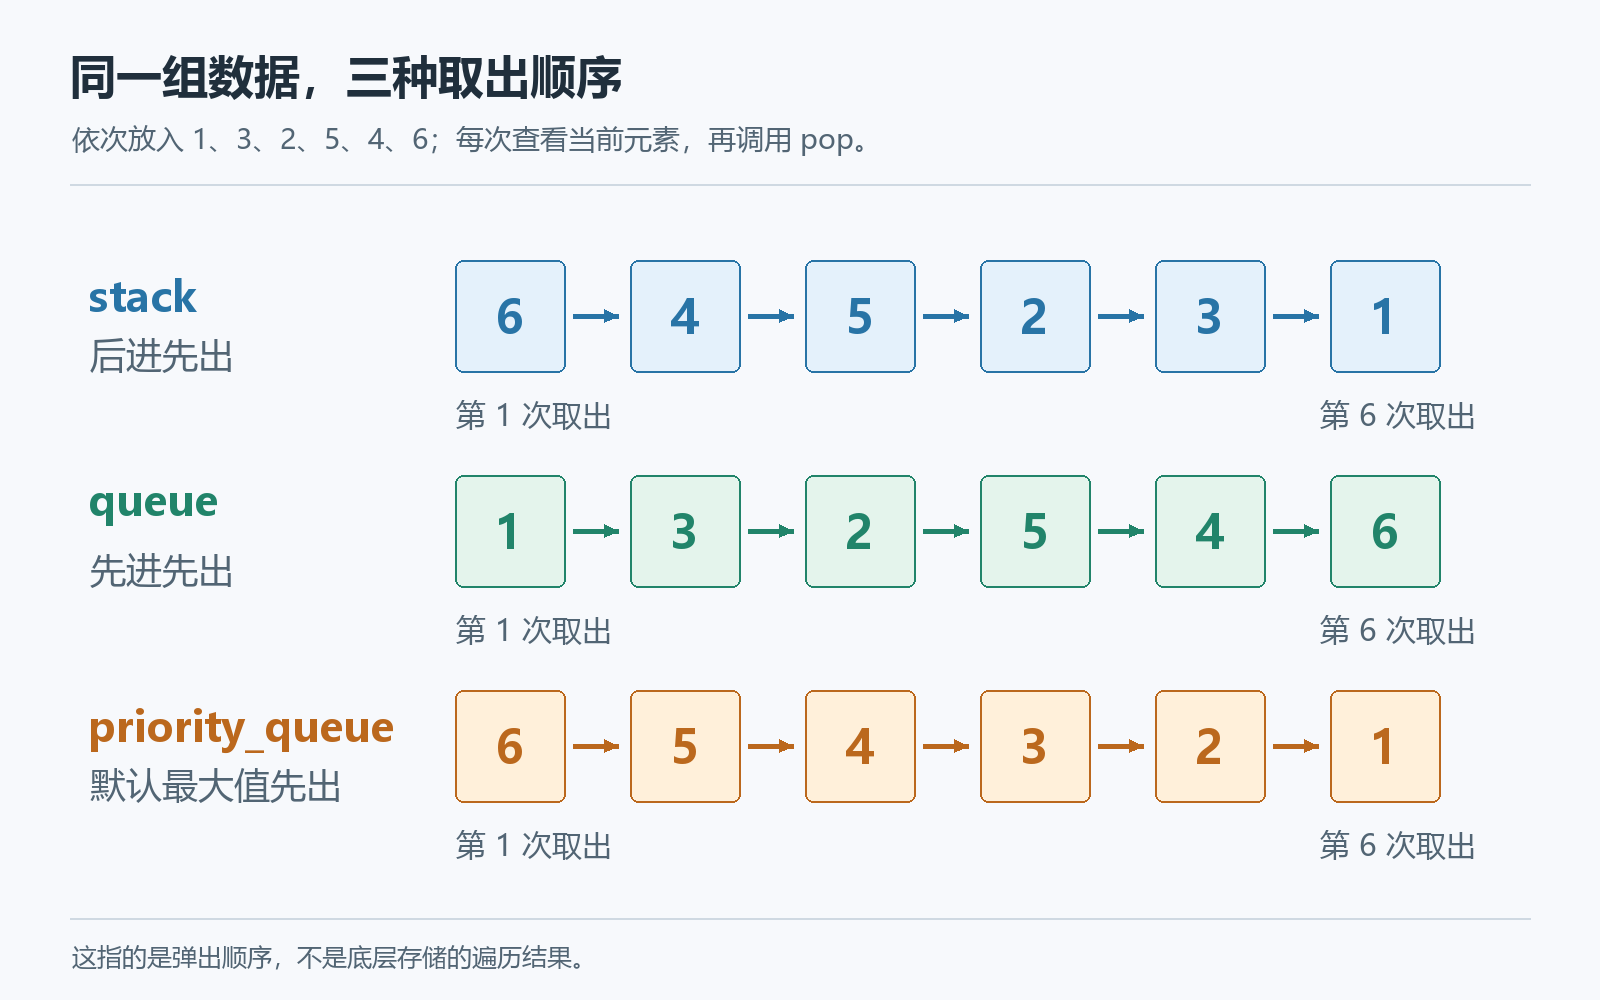
当我们依次在容器中放入 1、3、2、5、4、6,接着再把元素全部取出:
| stack | 6 4 5 2 3 1 | 最后放进去的先出,LIFO |
| queue | 1 3 2 5 4 6 | 最先放进去的先出,FIFO |
| 默认的 priority_queue<int> | 6 5 4 3 2 1 | 当前最大值先出来 |
需要注意的是,这里看的是“每次访问指定位置,然后删除该元素之后继续”的结果,不是遍历底层存储。
栈可以放在数组上,也可以放在链表上;队列可以用链表,也可以用双端队列。
一个有效的理解顺序是:先想想下一次应该处理谁,然后再找合适的接口,而不是看到“存一组数据”就直接选择一个可以任意访问的容器。
- 需要撤销最近一步操作,适合后进先出的规则。
- 需要按到达顺序处理任务,适合先进先出的规则。
- 需要不断处理当前优先级最高的任务,适合优先级队列。
2. stack 与 queue:接口简单,但使用习惯不能含糊
2.1 先用一个小程序观察
stack 的头文件是 <stack>,queue 和 priority_queue 的头文件都是 <queue>。
#include <iostream>
#include <stack>
#include <queue>
int main()
{
std::stack<int> stack;
//压栈1 2 3 4 5
for (int value = 1; value <= 5; ++value) stack.push(value);
//输出栈当前元素个数
std::cout << stack.size() << std::endl;
//逐个打印栈元素
while (!stack.empty()) {
std::cout << stack.top() << (stack.size() == 1 ? '\\n' : ' ');
stack.pop();
}
std::cout << std::endl;
std::queue<int> queue;
//入队列1 2 3 4 5 6
for (int value = 1; value <= 5; ++value) queue.push(value);
//输出队列当前元素个数
std::cout << queue.size() << std::endl;
//按顺序打印栈元素
while (!queue.empty()) {
std::cout << queue.front() << (queue.size() == 1 ? '\\n' : ' ');
queue.pop();
}
std::cout << std::endl;
return 0;
}
运行示例:
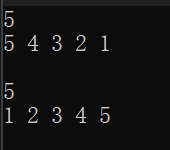
入栈和入队都是 push,区别在取出位置。栈查看 top(),队列查看 front();两者都用 pop() 删除当前应取出的元素。
2.2 用一张表把共同点与区别放在一起
| 默认构造 | 空栈 | 空队列 | 此时只能查询是否为空和数量,不能访问元素 |
| push(x) | 压入栈顶 | 加入队尾 | 保存的是元素副本 |
| pop() | 删除栈顶 | 删除队头 | 返回 void,不返回被删除的值 |
| 访问 | top() | front()、back() | 对象必须非空;非 const 对象可以通过引用修改值 |
| empty() | 是否为空 | 是否为空 | 安全地决定能否进行下一步访问或删除 |
| size() | 元素数量 | 元素数量 | 返回无符号数量类型,不用它表达负数 |
不要误写成 int value = s.pop();。正确顺序是:先确认非空,再读取或复制当前元素,最后删除。
if (!s.empty()) {
int value = s.top();
s.pop();
// value 是独立整数,后面可以继续使用。
}
为什么这里分成两个函数呢?访问只观察或修改元素,删除则改变对象状态;分离后可以只看而不删,也可以先把值保存下来再删。这样也避免了把“复制返回值”和“删除存储”绑定成一个可能失败的动作。
2.3 为什么没有 begin 和 end
标准 stack、queue 没有普通迭代接口,也没有下标访问。
- stack:只允许访问栈顶top()
- queue:只允许访问队头front()、队尾back()
栈 / 队列的本意:你不应该看到、修改中间的数据,只能按规则增删取边界元素。
3. 容器适配器:复用存储,改变使用方式
3.1 “再包一层”不是重新写一个容器
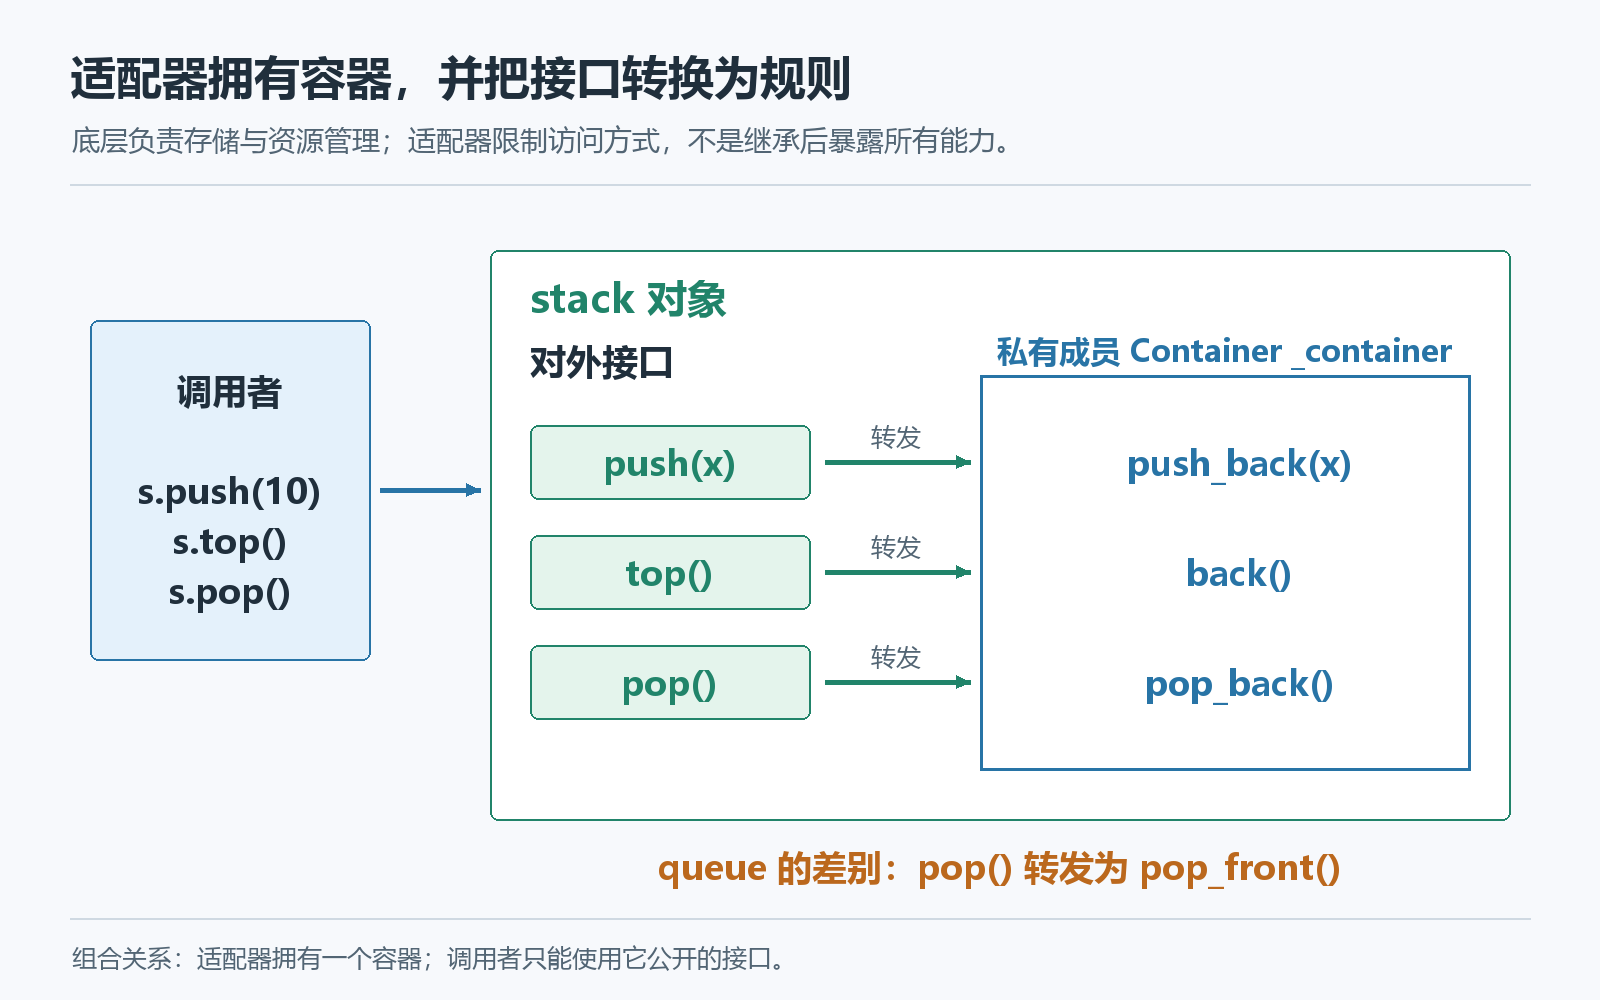
可以看看一些直接的功能映射关系:
| push(x) | push_back(x) | push_back(x) |
| pop() | pop_back() | pop_front() |
| 当前可处理元素 | back() | front() |
| 其他观察 | empty()、size() | back()、empty()、size() |
栈把容器末尾当作栈顶。队列把头部当队头,尾部当队尾。
相比栈与队列来说,其底层容器拥有更多能力,但适配器不把那些能力全部交给使用者。
3.2 与设计模式的关系
设计模式是对反复出现的设计问题与解决办法的总结,不是一组必须背下来的特殊语法。
适配器模式的核心是:把已有接口转换为使用方需要的接口。
一个通俗的例子帮助理解: 电源转换头:插座是已有接口,你的充电器插头规格不一样,转换器就用来做适配;就像 deque 是底层容器,stack 就是转换头,对外只提供栈的接口。
4. 可替换底层容器,先看它提供什么
4.1 第二个模板参数
标准库模板参数的基本形状可以理解为:
template<class T, class Container = std::deque<T>> class stack;
template<class T, class Container = std::deque<T>> class queue;
template<class T, class Container = std::vector<T>,
class Compare = std::less<T>> class priority_queue;
T 决定元素类型,Container 决定存储它们的容器类型。这里模板的第二参数是一个完整类型,例如 std::deque<int>,标准适配器要求 T 与底层容器的元素类型一致。
| stack | deque<T> | 尾插、尾删、尾部访问,另有数量和判空 | deque、vector、list |
| queue | deque<T> | 尾插、头删、头尾访问,另有数量和判空 | deque、list |
| priority_queue | vector<T> | 随机访问迭代器、尾插尾删、首元素访问等 | vector、deque |
对于 queue 来说,普通的 vector 没有 pop_front(),不能直接承担标准 queue 的头删要求。即使可以写 erase(begin()),那也不是 queue 要调用的同名接口,而且这样每次删除头部通常要同步移动后面的元素,效率较低。
list 没有随机访问迭代器,所以其不能承担标准 priority_queue 所需的堆算法接口。这两个对照说明:容器替换取决于操作契约,不取决于“它也能存放数据”。
4.2 deque:逻辑上是一列,典型实现中分段存储
deque 读作双端队列,可以在头尾插入、删除,还支持下标和随机访问迭代器。
典型实现用一个索引结构(中枢数组)管理多个缓冲块。每块内部连续,不同块不保证物理相邻。由此可以提供逻辑上第 0、1、2……个元素的访问,却不能假设所有元素像一个普通数组一样位于整块连续空间中。 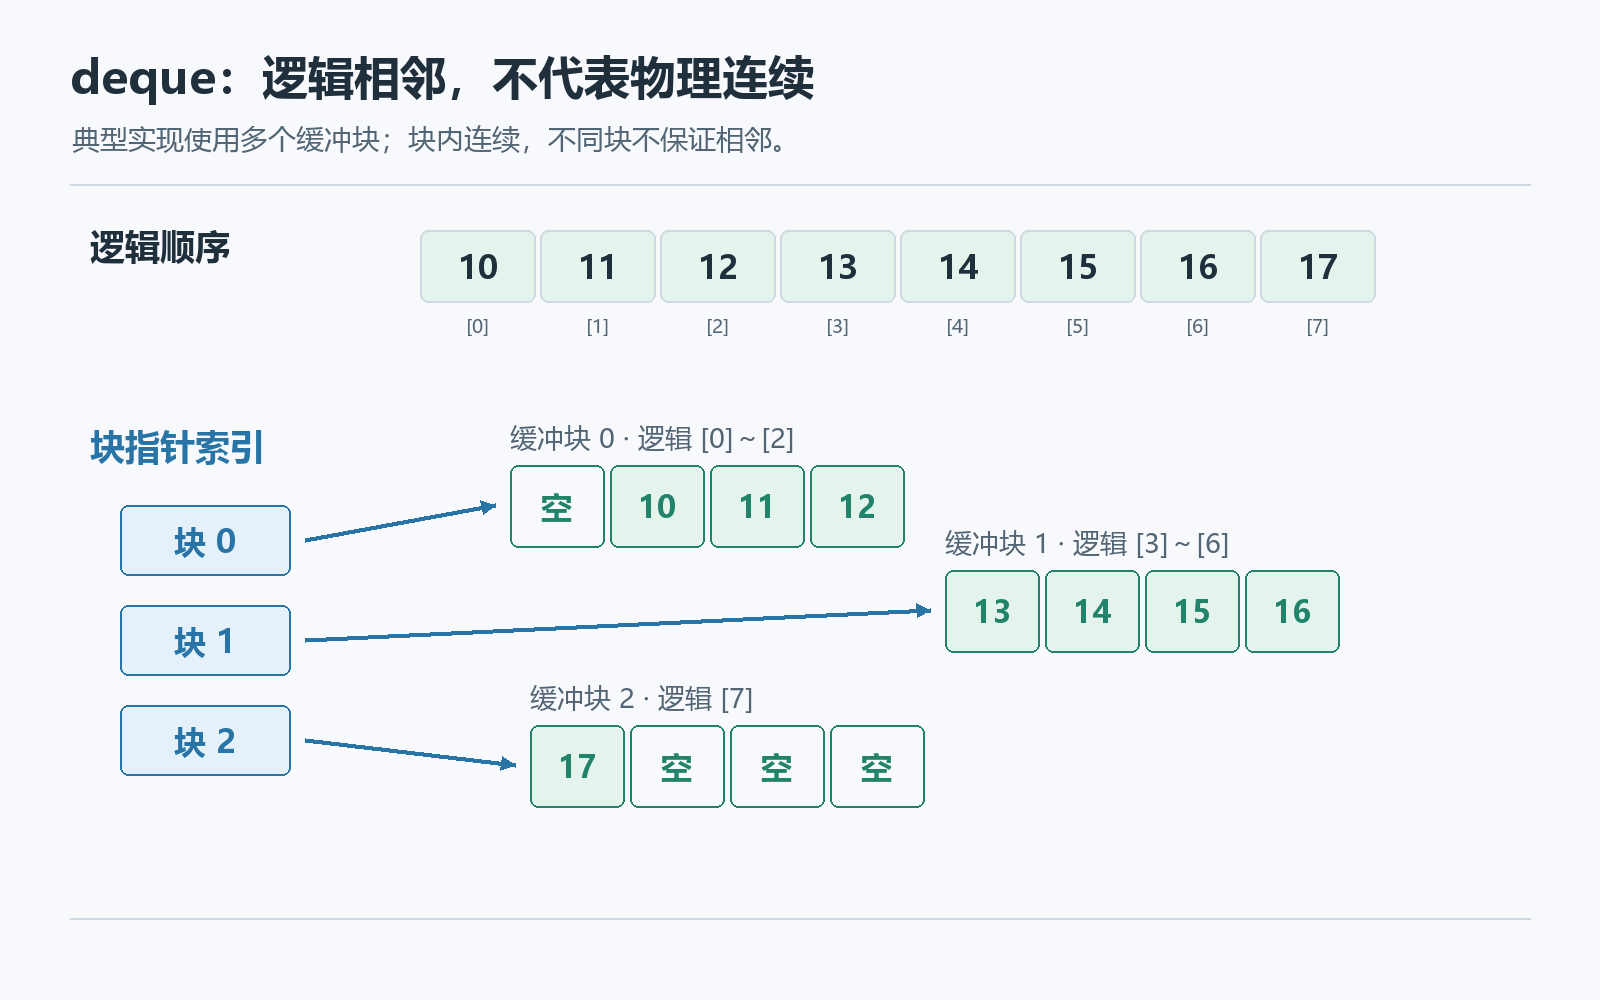
随机访问为什么仍然是常数时间?其底层实现可以用位置和块大小计算目标块与块内偏移,而不需要从头逐个走过去。迭代器跨块时则需要处理边界,所以它通常比一个裸指针更复杂。
4.3 为什么默认选 deque
stack 只用尾部操作,queue 同时用头尾操作,deque 都能够直接支持。
deque双向队列天然高效支持头尾 O (1) 增删,所以作为通用默认底层容器。
这让它成为合理的通用默认选择。但要补上几条边界:
- 顺序连续存储在缓存局部性、简单遍历和预先规划容量等方面可能更有优势;不能断言 deque 做栈永远更快。
- 分块空间仍有未用槽位和索引管理成本,不能说没有额外开销,空间利用率也不能脱离元素大小与数量来比较。
- deque 可以遍历,复杂度仍是线性的。跨块检查和局部性是代价,但不至于说“不适合遍历”或“致命缺陷”。
5. 两个适配器的简短实现
5.1 栈:把尾部当作唯一入口和出口
#pragma once
#include <deque>
namespace by
{
//Container适配转换stack
template<class T, class Container = std::deque<T>>
class stack
{
public:
//由于成员变量是对应的容器,所以此处不需要单独写构造函数
//只需要实现核心功能即可
//入栈(统一把容器的尾部当栈顶)
void push(const T& x)
{
_con.push_back(x);
}
//出栈
void pop()
{
_con.pop_back();
}
//获取栈顶元素
const T& top() const
{
return _con.back();
}
//获取当前数据个数
size_t size() const
{
return _con.size();
}
//判断当前是否为空
bool empty() const
{
return _con.empty();
}
private:
Container _con;
};
}
若写 by::stack<int>,Container 被替换为 std::deque<int>;若写 by::stack<int, std::vector<int>>,成员容器就变成 std::vector<int>。函数体内的规则并没有变化。
5.2 队列:只把删除操作换到头部
#pragma once
namespace by
{
//Container适配转换queue
template<class T, class Container = std::deque<T>>
class queue
{
public:
//队尾插入元素
void push(const T& x)
{
_con.push_back(x);
}
//队头出元素
void pop()
{
_con.pop_front();
}
//获取队头元素
const T& front() const
{
return _con.front();
}
//获取队尾元素
const T& back() const
{
return _con.back();
}
//获取当前元素个数
size_t size() const
{
return _con.size();
}
//判断当前是否为空
bool empty()
{
return _con.empty();
}
private:
Container _con;
};
}
它与栈的共同点是都把存储责任委托给了成员对象。区别只有:入队从尾部进入,出队从头部离开。
5.3 为什么没有再次手写析构、深拷贝与赋值
- 构造:创建适配器对象时,成员容器会自动调用底层容器的默认构造函数。
- 析构:适配器销毁时,成员对象会自动调用它自己的析构函数,释放容器内部资源。不需要手写析构函数。
- 拷贝构造 / 拷贝赋值:编译器合成的默认拷贝、赋值运算符,会对成员做逐成员拷贝,直接调用底层容器自己的拷贝构造、拷贝赋值,完成深拷贝。
6. priority_queue:每次给出当前最高优先级
6.1 默认大堆与小堆的用法
优先级队列不是普通先进先出队列,访问函数是 top(),没有 front()/back();删除的是当前最高优先级元素。
下面用一个简单的小程序,同时观察大堆与小堆的输出顺序。
#include <functional>
#include <iostream>
#include <queue>
#include <vector>
int main()
{
int values[] = { 1, 3, 2, 5, 4, 6 };
//默认第二模板参数less 升序建小堆
std::priority_queue<int> large;
//显式给greater 降序建大堆
std::priority_queue<int, std::vector<int>, std::greater<int>> small;
//各自入队列
for (int value : values)
{
large.push(value);
small.push(value);
}
//输出降序建大堆的顺序
std::cout << "降序建大堆->";
while (!large.empty())
{
std::cout << large.top() << (large.size() == 1 ? '\\n' : ' ');
large.pop();
}
std::cout << std::endl;
////输出升序建小堆的顺序
std::cout << "升序建小堆->";
while (!small.empty())
{
std::cout << small.top() << (small.size() == 1 ? '\\n' : ' ');
small.pop();
}
std::cout << std::endl;
return 0;
}
运行示例: 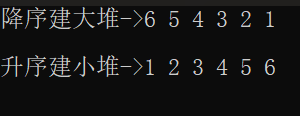 注意这里的“降序减大堆,升序建小堆”需要与堆排序的输出结果加以区分:
- 在堆排序中,小堆堆顶最小,最先与尾部元素交换,交换后整体 size 减 1 ,所以最小元素依次从数组尾部往前排列,最终形成的效果就是降序。
- 在此处优先级队列中则刚好相反,小堆堆顶最小,是最先被输出的元素,然后再依次是剩余最小元素的输出,最终形成的效果就是升序。(大堆同理)
6.2 用数组表示树,不等于把数组排好序
这里的堆是一种数据结构,与 new 申请空间时所说的内存“堆区”不是同一个概念。
具体细节可查看:从树的层次关系到堆的调整算法:二叉树开篇
堆可以用数组按层序表示成一棵完全二叉树。下标从 0 开始时:
| 左孩子 | 2 * parent + 1 |
| 右孩子 | 2 * parent + 2 |
| 非根节点的父亲 | (child – 1) / 2,前提是 child > 0 |
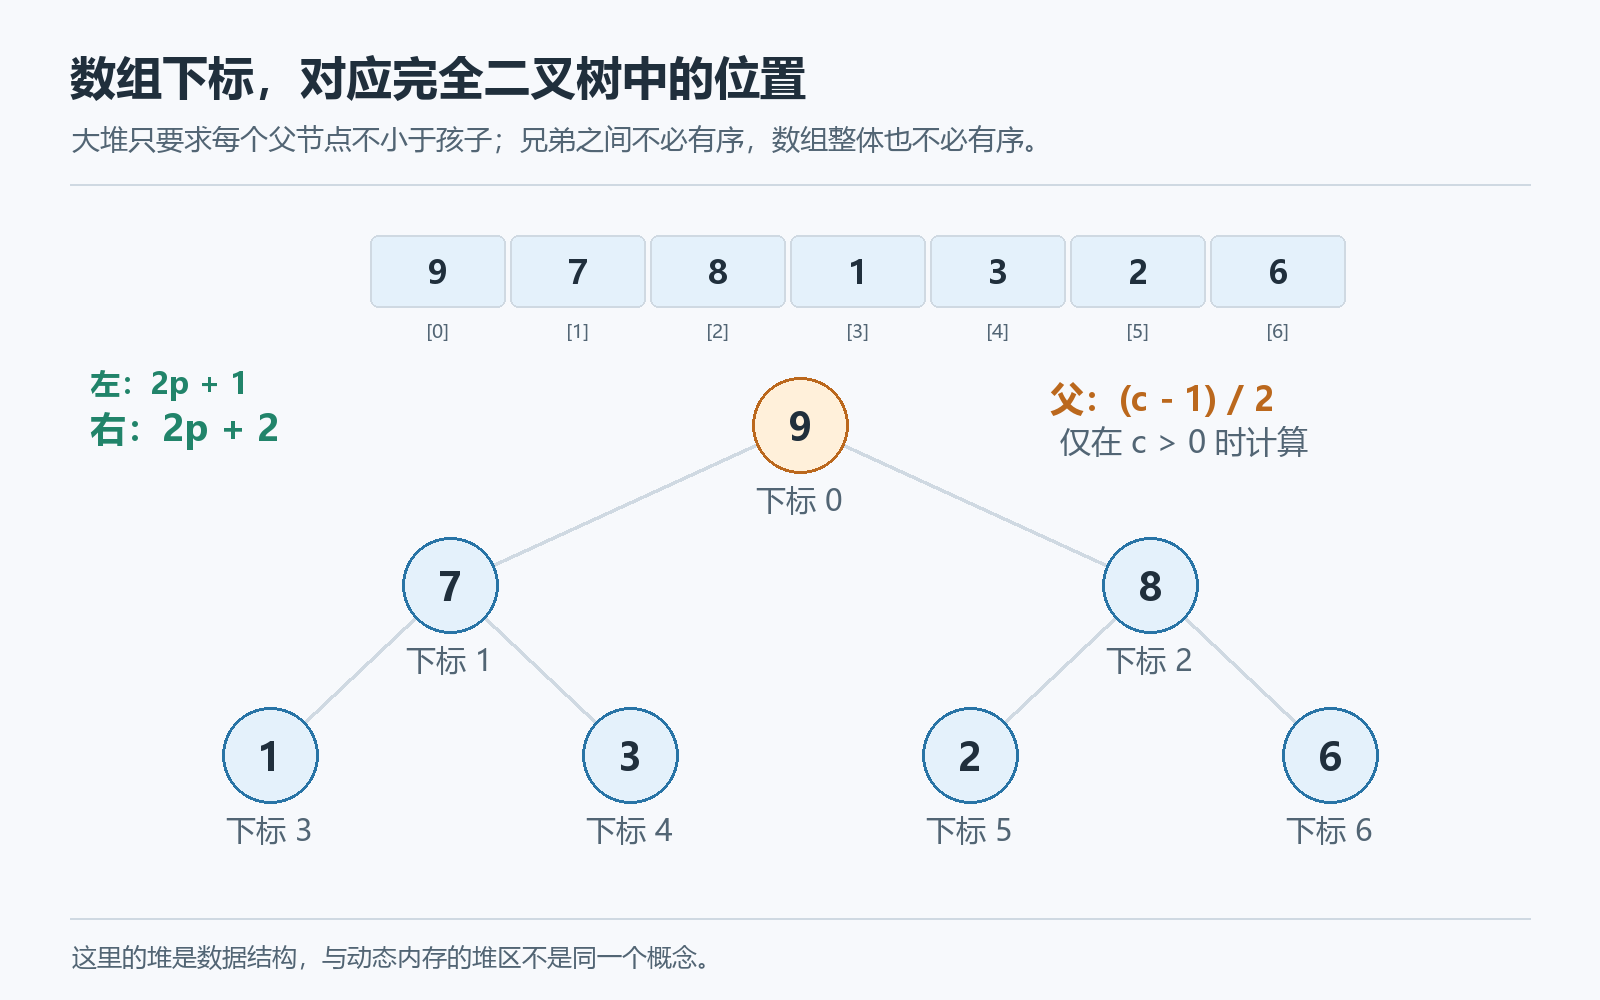
图中数组 9 7 8 1 3 2 6 是一个大堆:每个父节点都不小于孩子。
但注意此时数组并不是完全降序,堆只维护父子关系,就足以保证根节点是当前最大值或最小值。访问堆顶不需要再扫描所有元素。兄弟节点之间没有必须有序的约束
7. 比较器与堆调整:规则如何变成算法
7.1 less 为什么对应大堆
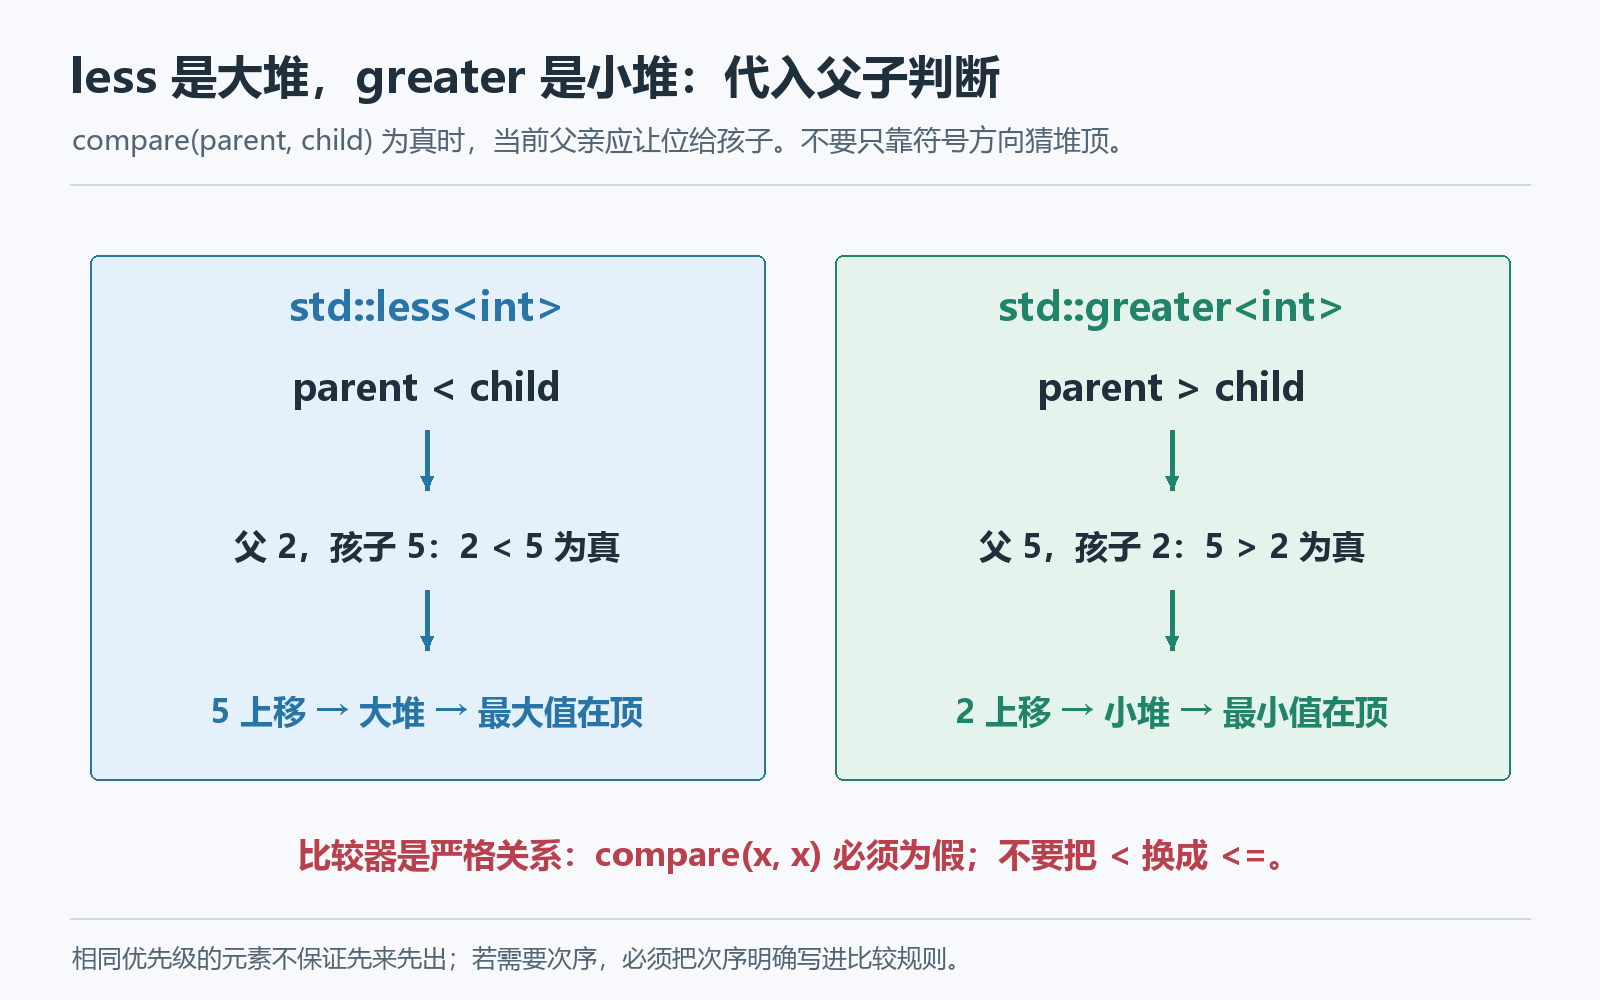
std::less<int> 调用 a < b,std::greater<int> 调用 a > b。它们是可以像函数一样调用的对象,也叫函数对象或仿函数,核心是重载 operator()。
在优先级队列中,比较器表达的是排序关系:compare(a, b) 为真,表示 a 在该关系中位于 b 前面。优先级队列却把这个关系中“靠后”的元素放到堆顶。因此默认 < 关系下,更大的元素在堆顶。
| less<int> | parent < child | 孩子更大,应向上 | 最大值 |
| greater<int> | parent > child | 孩子更小,应向上 | 最小值 |
7.2 插入:新元素只可能破坏祖先路径
原来的数组已经满足堆关系,尾部加入新元素后,完全二叉树的形状仍成立。新元素没有孩子,唯一可能出错的是它与父节点的关系。于是先比较父子,必要时交换,再沿祖先链继续。 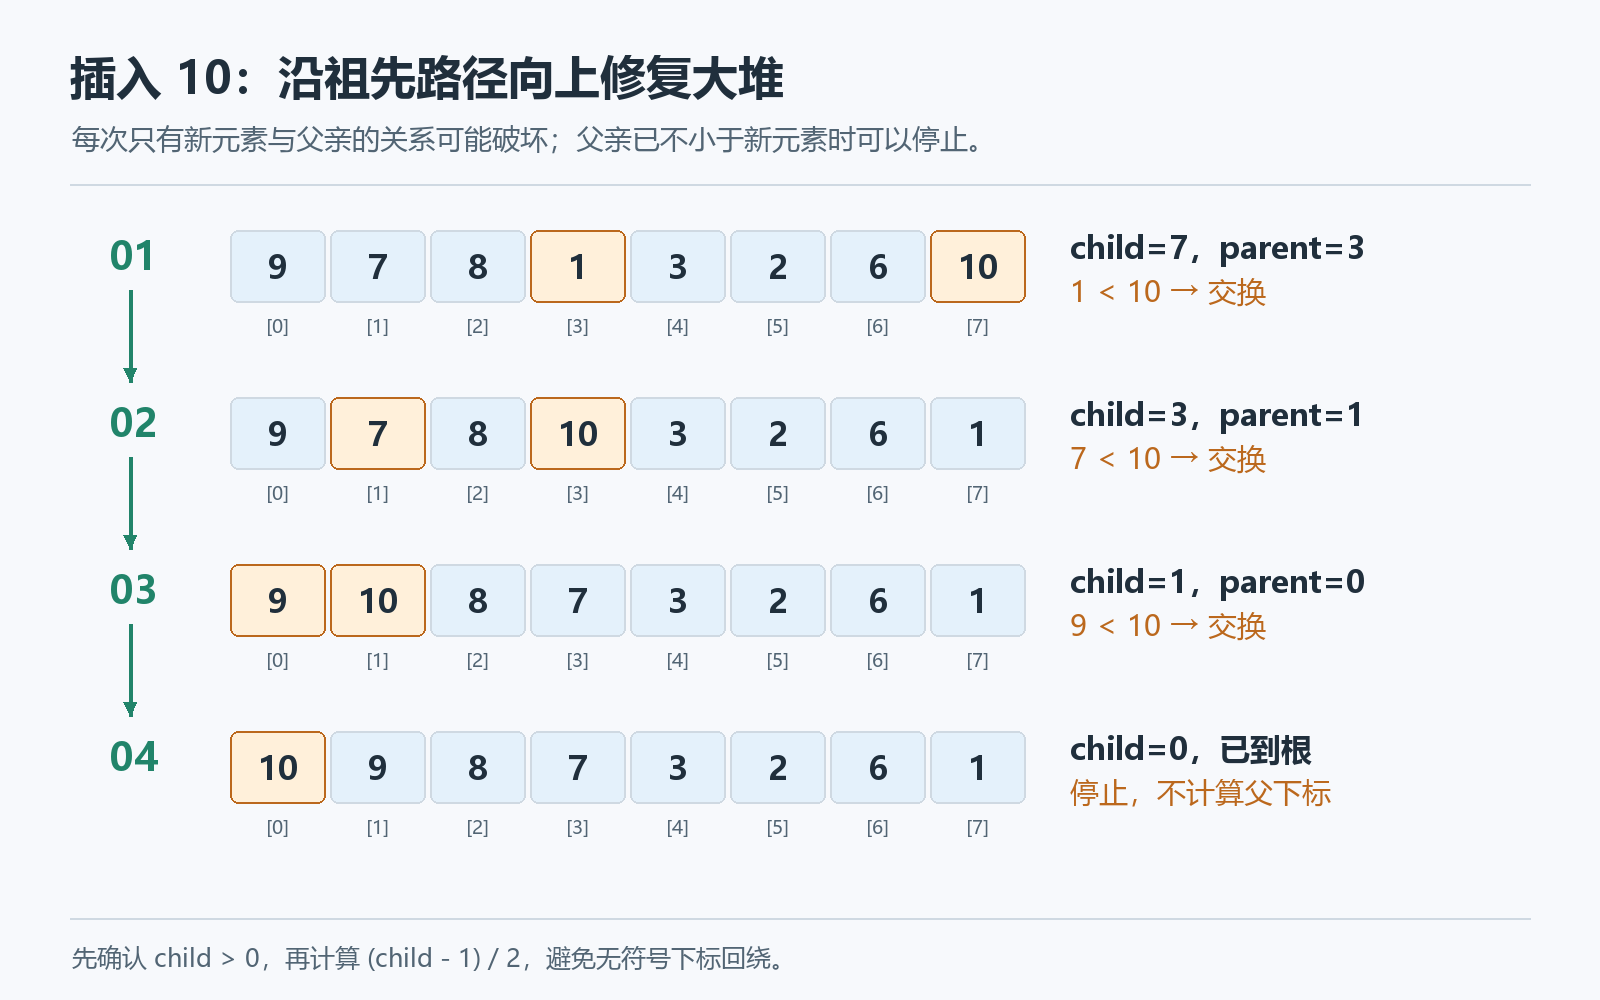 模拟从 9 7 8 1 3 2 6 追加 10:
| 追加后 | 7 | 3 | 1 < 10,交换 |
| 上移一层 | 3 | 1 | 7 < 10,交换 |
| 再上一层 | 1 | 0 | 9 < 10,交换 |
| 到根 | 0 | 不计算 | 没有父亲,结束 |
最后数组为 10 9 8 7 3 2 6 1。不是每次都走到根;若父子关系已经成立,立即停止。
//向上调整算法
void Adjust(int child)
{
Compare com;
size_t parent = (child – 1) / 2;
while (child > 0)
{
// if (_con[child] > _con[parent])
if (com(_con[parent], _con[child]))
{
std::swap(_con[child], _con[parent]);
child = parent;
parent = (child – 1) / 2;
}
else
{
break;
}
}
}
7.3 删除:先用末尾元素填根,再向下调整
如果直接删除数组第一个位置并把所有元素前移,树中的父子关系会大面积改变,还要搬移元素。所以堆删除使用另一条路线:
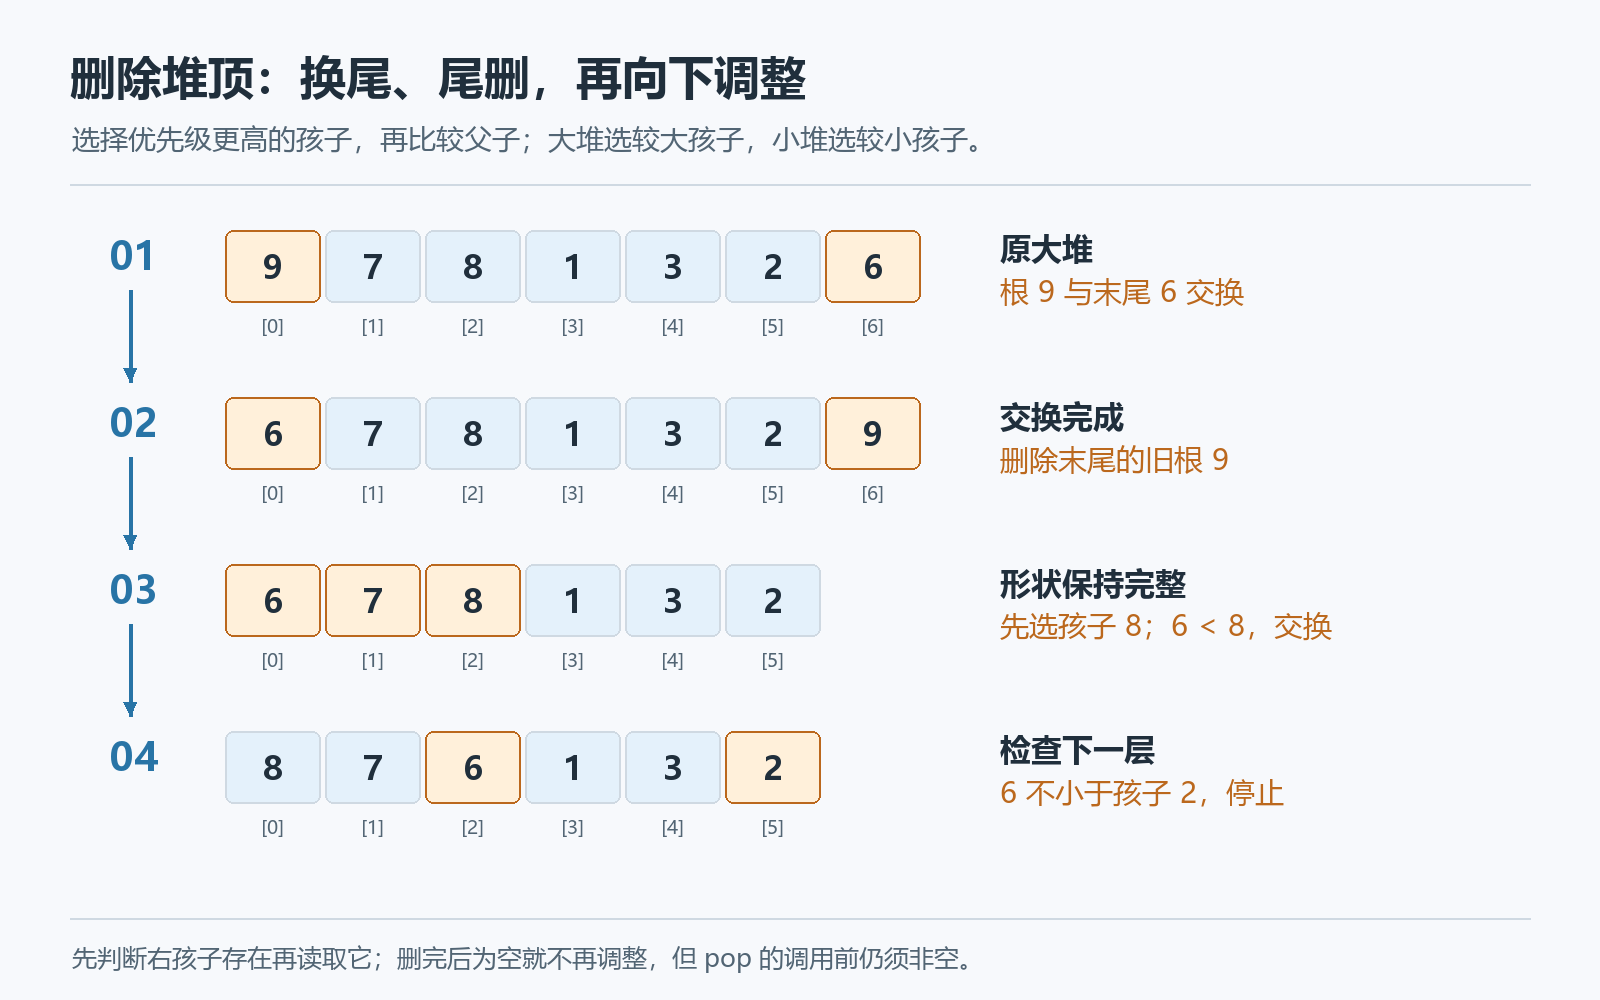 模拟从 9 7 8 1 3 2 6 删除 9:
| 原大堆 | 不计算 | 不计算 | 根 9 与末尾 6 交换 |
| 交换完成 | 不计算 | 不计算 | 删除末尾的旧根 9,得到 6 7 8 1 3 2 |
| 形状保持完整 | 2 | 0 | 选较大孩子 8;6 < 8,交换,得到 8 7 6 1 3 2 |
| 检查下一层 | 5 | 2 | 只有孩子 2;6 ≥ 2,停止 |
为什么先选更大的孩子? 若误选 7 交换,根变成 7,却仍比右孩子 8 小,根的关系就没有修好。对小堆相反,要先选更小的孩子。
//向下调整算法
void AdjustDown(int parent)
{
Compare com;
size_t child = parent * 2 + 1;
while (child < _con.size())
{
//if (child + 1 < _con.size() && _con[child] < _con[child + 1])
if (child + 1 < _con.size() && com(_con[child], _con[child + 1]))
{
child++;
}
//if (_con[parent] < _con[child])
if (com(_con[parent], _con[child]))
{
std::swap(_con[parent], _con[child]);
parent = child;
child = parent * 2 + 1;
}
else
{
break;
}
}
}
7.4 把存储、比较和调整组合起来
//插入数据
void push(const T& x)
{
_con.push_back(x);
Adjust(_con.size() – 1);
}
//删除数据
void pop()
{
std::swap(_con[0], _con[_con.size() – 1]);
_con.pop_back();
AdjustDown(0);
}
const T& top()
{
return _con[0];
}
//获取当前元素个数
size_t size() const
{
return _con.size();
}
//判断当前是否为空
bool empty()
{
return _con.empty();
}
单元素删除时,根与末尾是同一个元素。删除后容器为空,就不再向下调整。
与栈、队列相比,优先级队列多了一层算法责任:容器维护空间,比较器定义顺序,堆算法维护关系。
7.5 复杂度:把堆算法与容器操作分开看
| stack/queue 的观察 | 通常 O(1) | 使用标准底层容器 |
| stack 的插删 | 底层尾插尾删的成本 | 连续存储尾插可能扩容,不忽略迁移成本 |
| queue 的插删 | 底层尾插头删的成本 | 默认 deque 或 list 支持端部操作 |
| priority_queue::top() | O(1) | 已有堆关系,不再扫描 |
| 优先级队列插入、删除的堆调整 | O(log n) | 树高度是对数级;还需加上底层操作成本 |
| 逐个插入 n 个元素 | O(n log n) 的上界 | 每次维护一条祖先路径 |
| 一次对 n 个元素批量建堆 | O(n) | 自底向上调整,不是 n 次从叶子走到根 |
为什么批量建堆不是 n log n?叶子节点不用调整,倒数第二层只需很短路径,能走接近树高的节点非常少。把各层节点数量乘以各自的最大下降距离相加,是线性数量级。
make_heap官方说明批量建堆至多执行 3*N 次比较,也就是 O (n)
8. 扩展练习
8.1 用两个栈实现最小栈
LeetCode 155:最小栈
要求入栈、出栈、查询栈顶、查询当前最小值都为常数级操作。本题规定出栈和访问时对象非空。
思路: 普通栈保存所有元素,辅助栈保存“当前最小值变化记录”。新值小于或等于当前最小值时,辅助栈也压入它;删除的值若等于当前最小值,两个栈一起弹出。
参考答案
class MinStack
{
public:
void push(int value)
{
_values.push(value);
if (_minimum.empty() || value <= _minimum.top())
_minimum.push(value);
}
void pop()
{
if (_values.top() == _minimum.top())
_minimum.pop();
_values.pop();
}
int top() const { return _values.top(); }
int getMin() const { return _minimum.top(); }
bool empty() const { return _values.empty(); }
private:
std::stack<int> _values;
std::stack<int> _minimum;
};
8.2 用两个栈实现先进先出队列
LeetCode 232:用栈实现队列
基本输入输出只需整数,不必引入更复杂的数据类型。
思路: 输入栈接收入队元素,输出栈提供队头。当输出栈为空时,才把输入栈全部倒入输出栈。一次倒转使最早进入的元素来到输出栈顶。
| 入队 1、2、3 | 1 2 3 | 空 | 尚未转移 |
| 首次访问 | 空 | 3 2 1 | 1 |
| 删除 1 后入队 4、5 | 4 5 | 3 2 | 2 |
| 删除 2、3 后再次访问 | 空 | 5 4 | 4 |
参考答案:
class MyQueue {
public:
std::stack<int> st1;
std::stack<int> st2;
MyQueue() {
}
void push(int x) {
st1.push(x);
}
int pop() {
if(st2.empty())
{
while(!st1.empty())
{
st2.push(st1.top());
st1.pop();
}
}
int res = st2.top();
st2.pop();
return res;
}
int peek() {
if(st2.empty())
{
while(!st1.empty())
{
st2.push(st1.top());
st1.pop();
}
}
return st2.top();
}
bool empty() {
return st1.empty() && st2.empty();
}
};
9. 总结
在具体场景要选择容器时,须用需求选择接口,而不是用类名去猜实现。
| 最近加入的先处理 | stack | 限制在栈顶操作 |
| 按加入顺序处理 | queue | 队尾进入、队头离开 |
| 不断取当前最高或最低优先级 | priority_queue | 维护堆关系,堆顶直接可访问 |


评论前必须登录!
注册