 网硕互联帮助中心
回顾传统注意力
这节讲的是注意力变体,先回顾一下传统注意力
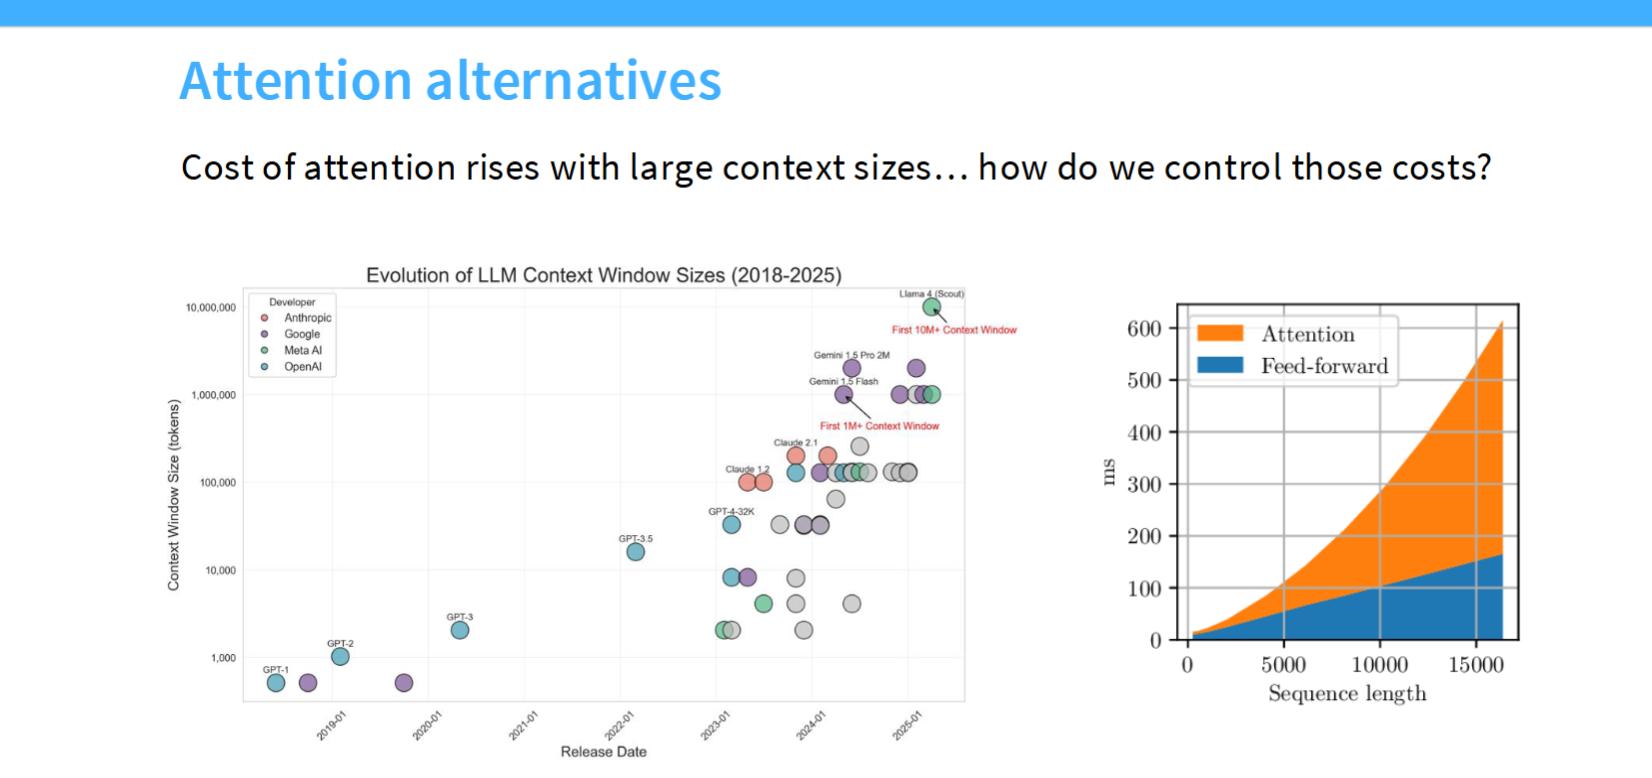
计算开销随上下文窗口是平方量级增长的,也就是O(n)O(n)O(n)上下文,O(n2)O(n^2)O(n2)的计算复杂度,如右图。但是拓展上下文窗口又是很重要的需求,现在模型主流的进化方向之一就是拓展上下文窗口,如左图。
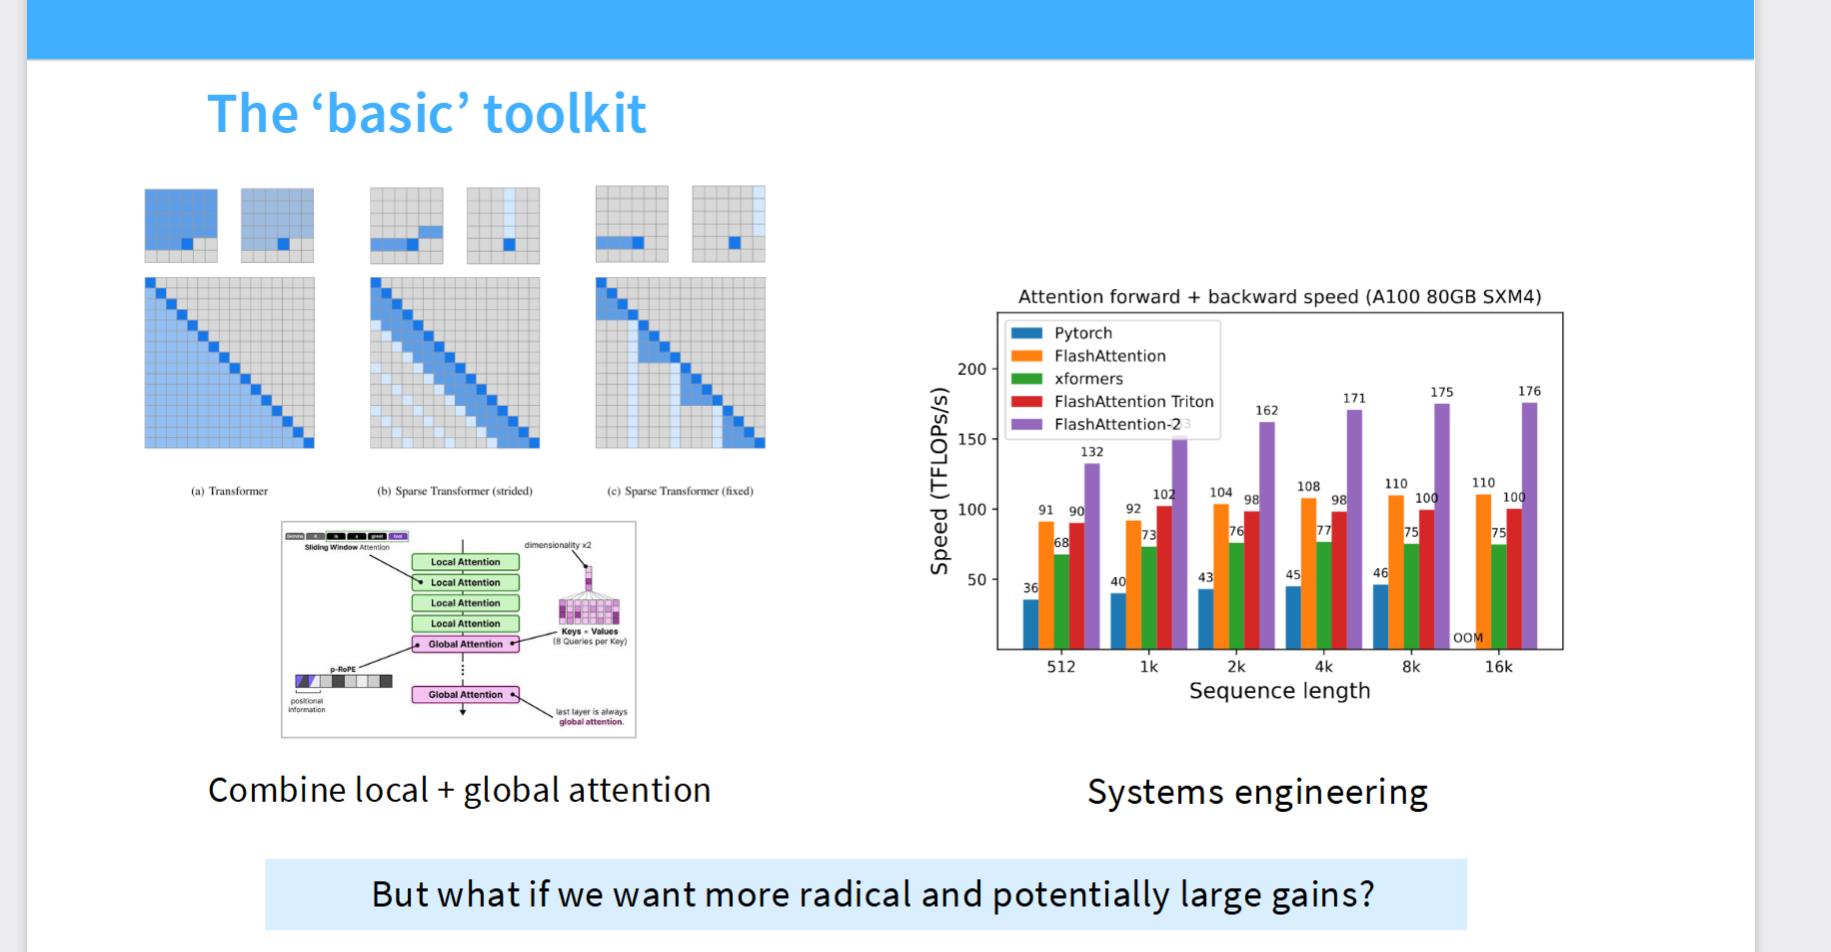
上一讲,对此的解决方式是引入混合注意力,稀疏注意力。如左图,展示了一层注意力模块的层内稀疏,以及层间稀疏,也就是几层稀疏注意力,一层完整注意力。但这样的方式优化效果还是不够好。
另一种优化思路是flashattention为代表的系统级优化,如右图,相比朴素pytorch吞吐有提高,但在上下文窗口拉长时仍然会遇到瓶颈,图中展示的就是上下文窗口增大时,注意力层每秒吞吐量的变化,可以看到在4k后吞吐就几乎不增长了。
因此正如最下方文字所说的,我们要一种更激进的优化,这就是本节前半部分的主题:线性注意力
朴素线性注意力
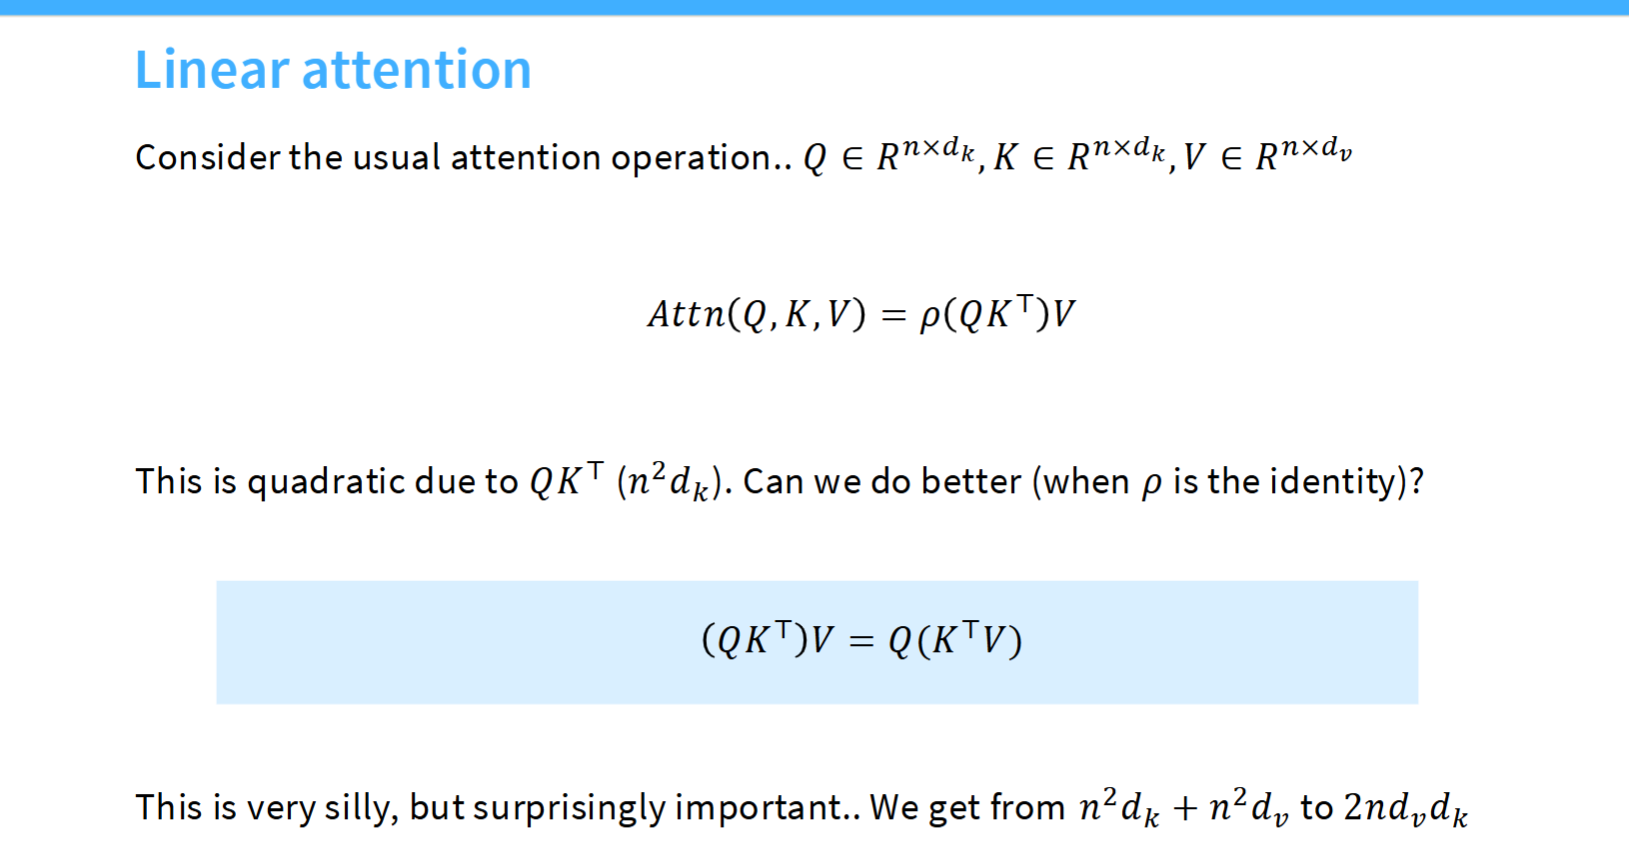
最朴素的线性注意力来源于一个简单的想法,注意原始注意力公式,如果忽略那个softmax函数,就是三个矩阵连乘。矩阵连乘,调整结合优先级可以降低计算量,这是个区间DP的经典问题。在这里只有三个矩阵,实际上只有两种结合方法,QK先结合,KV先结合。标准注意力是QK结合,这里换成KV先结合能否减小计算量?
来分析一下复杂度,QKV都是(n,d)的。标准注意力的QK相乘,复杂度n2dn^2dn2d,注意力得分是(n,n)的,再和V相乘,也是n2dn^2dn2d的。如果先结合KV,注意K依旧是转置的,计算量nd2nd^2nd2,得到的结果是(d,d)的,再和Q相乘,计算量也是nd2nd^2nd2
注意到在模型架构中,隐藏层维度d不变,且一般相对于上下文长度n来说是很小的,可以视为常数。也就是说这个改变计算顺序的简单优化就能把计算复杂度从O(n2)O(n^2)O(n2)优化到O(n)O(n)O(n)!
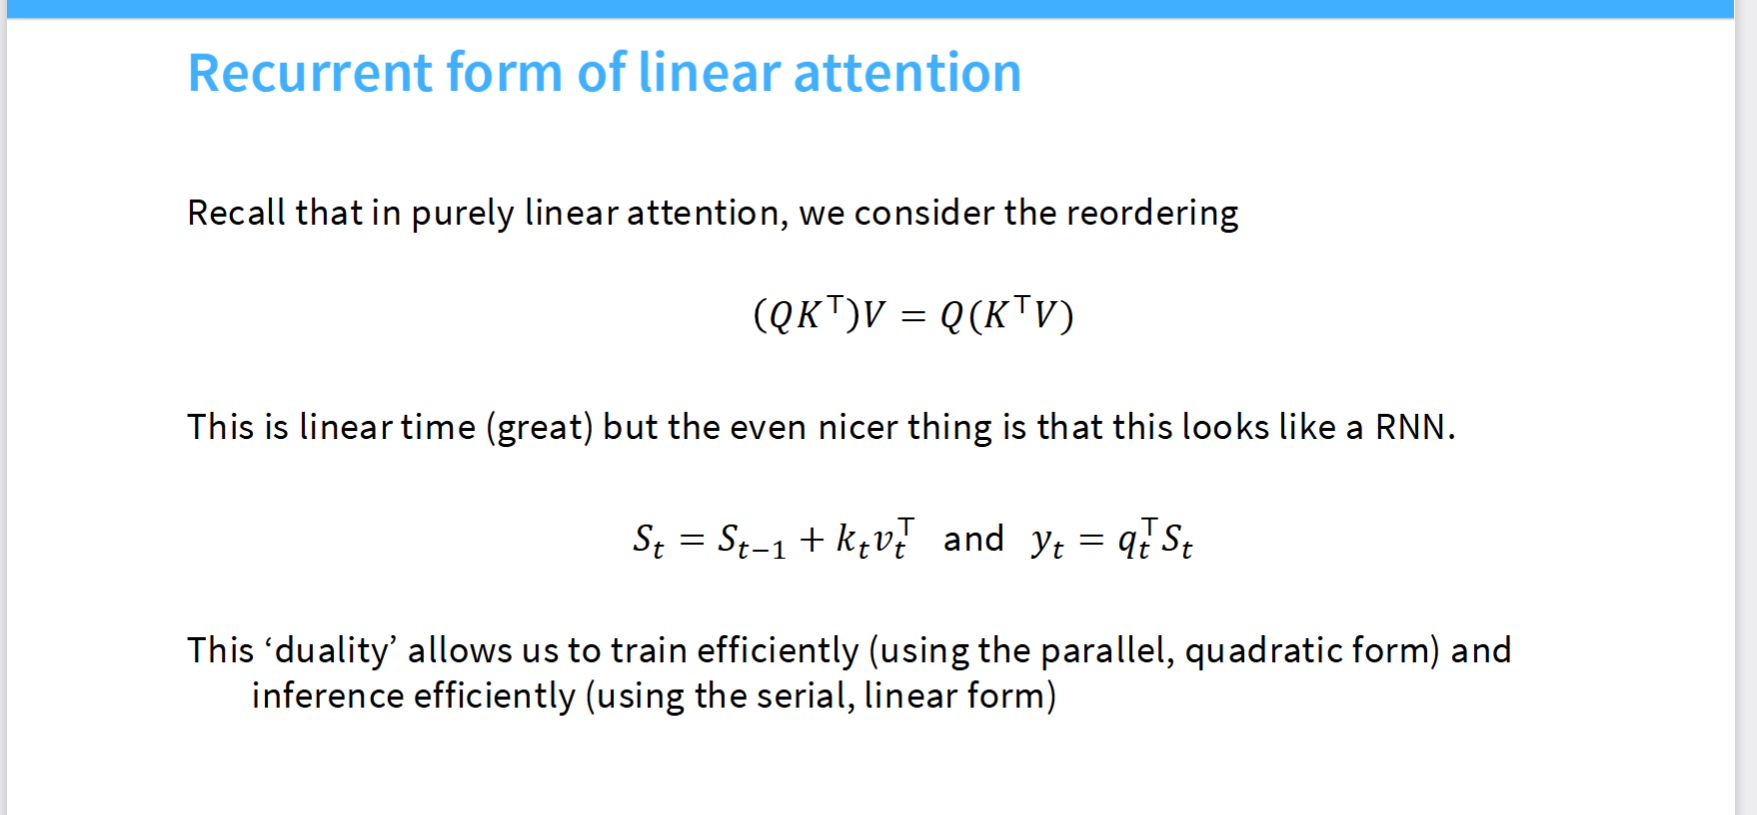
基于这个形式,可以把模型等价转换成一个类RNN的形式,每个token计算ktvtTk_tv_t^TktvtT,得到当前token的(d,d)状态,累加到隐藏层状态StS_tSt上。然后利用隐藏层状态StS_tSt和qtq_tqt计算输出token,这里qtq_tqt就类似RNN的输出门控,kt,vtk_t,v_tkt,vt类似于RNN的输入门控和更新门控。
这样计算是串行的,但是推理时decode本来就是串行的,但通过线性注意力,我们仍然降低了推理的计算量,原来每个token要和前面n个token计算注意力,做一个gemv操作,每个token是O(nd)O(nd)O(nd)的复杂度,现在只用自己做一个ktvtTk_tv_t^TktvtT,是两个(1,d)的向量外积,复杂度O(d2)O(d^2)O(d2)。同样推理一段长n的文本,标准注意力复杂度O(n2d)O(n^2d)O(n2d),这个类RNN的复杂度O(nd2)O(nd^2)O(nd2),和咱们前面分析一致,这里只不过是从推理decode角度分析了一遍。
由于在数学上怎么结合都是等价的,因此我们可以在训练时仍用原来的注意力公式,实现掩码+自回归训练的并行训练。在推理时才用这个RNN形式。这样可以同时获得训练和推理时的加速。
举例:Minimax
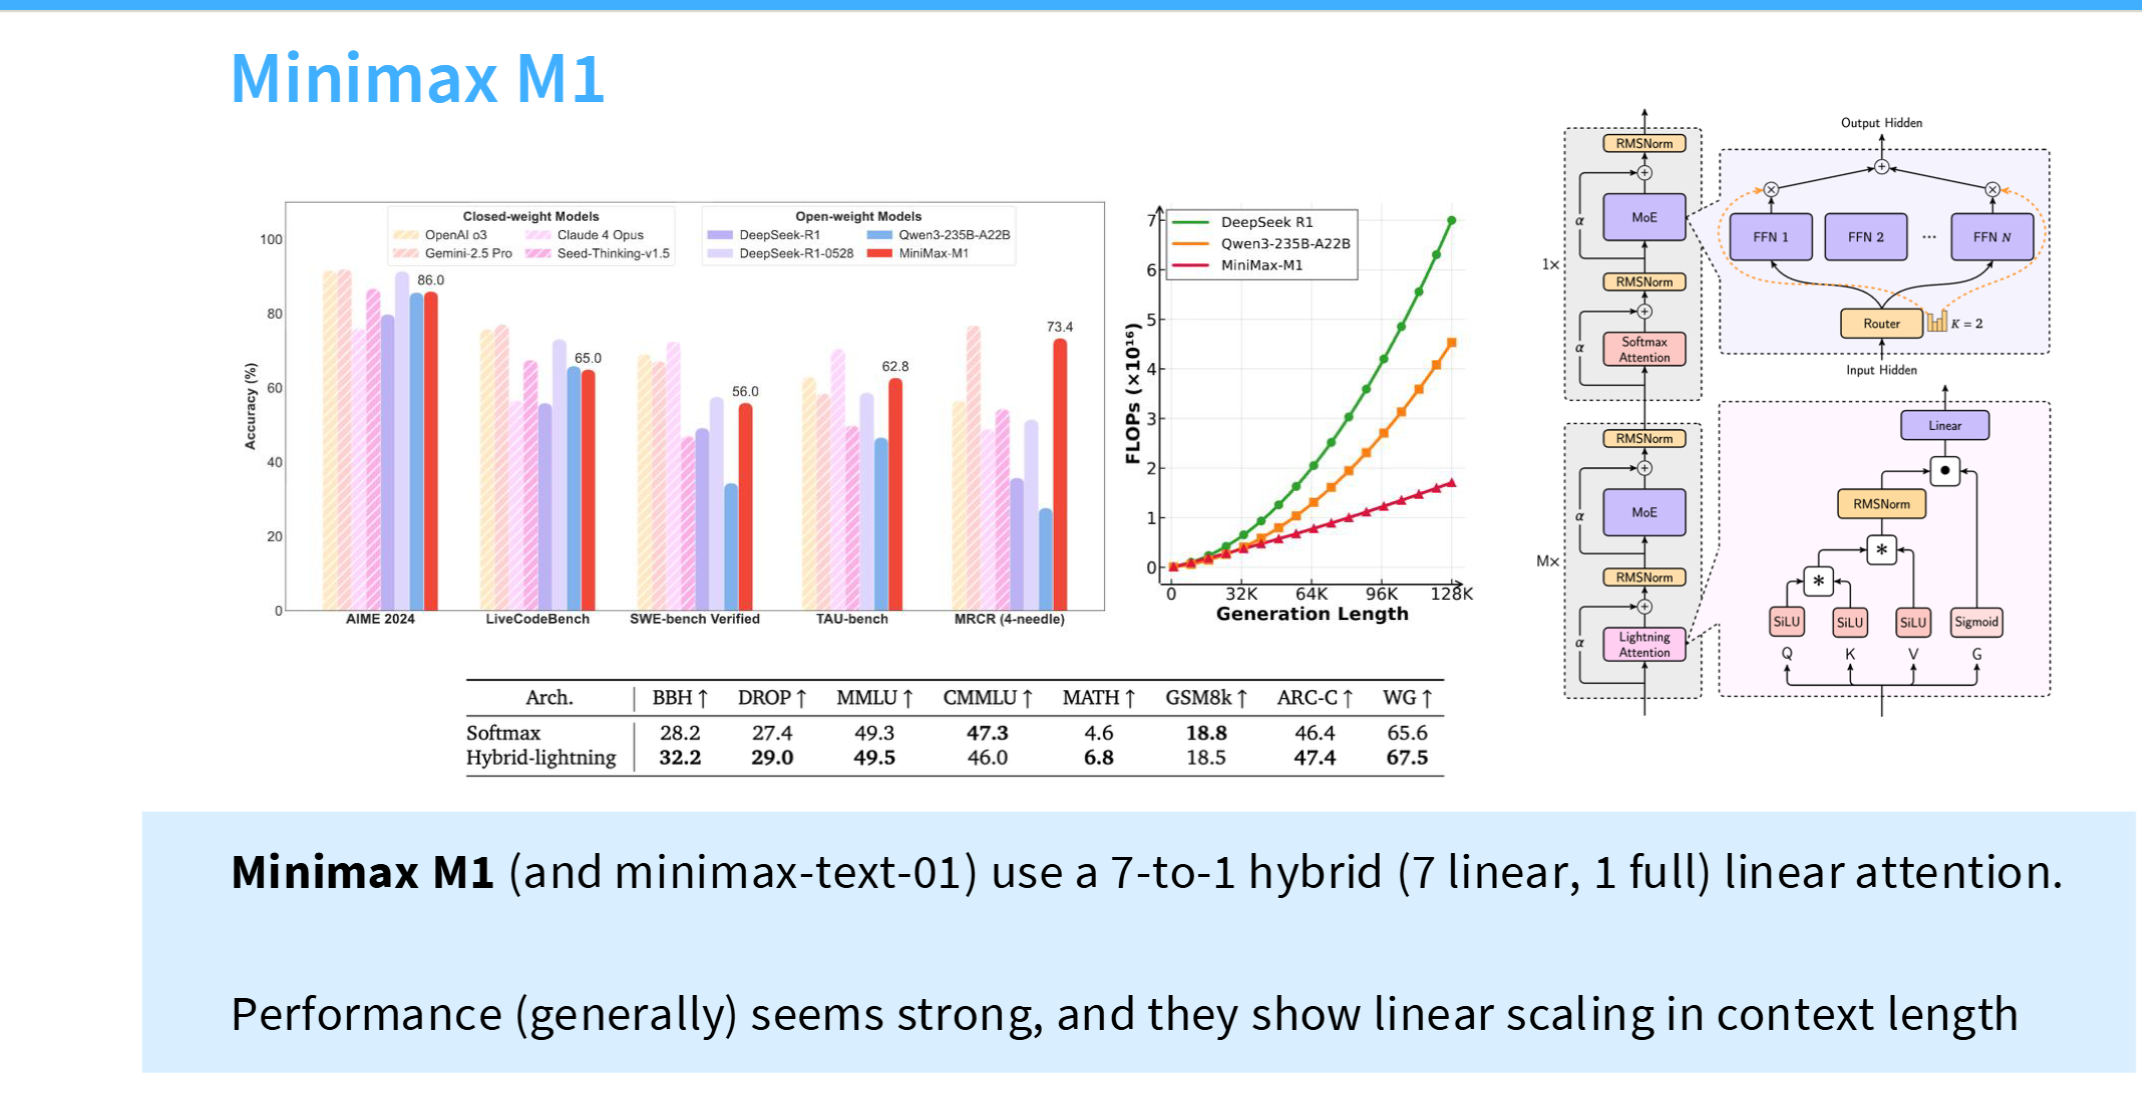
Minimax就采用了线性注意力,准确来说是线性注意力和标准注意力的混合架构,7层线性,1层标准。模型能力不输当时大部分主流模型,见左图,可见线性注意力没有过多的损失性能。但计算量大幅降低,见中图,其他模型的计算量,随上下文增长是平方量级增长的,而Minimax-M1几乎是线性增长的,这就是线性注意力的功劳。
继续改进:Mamba
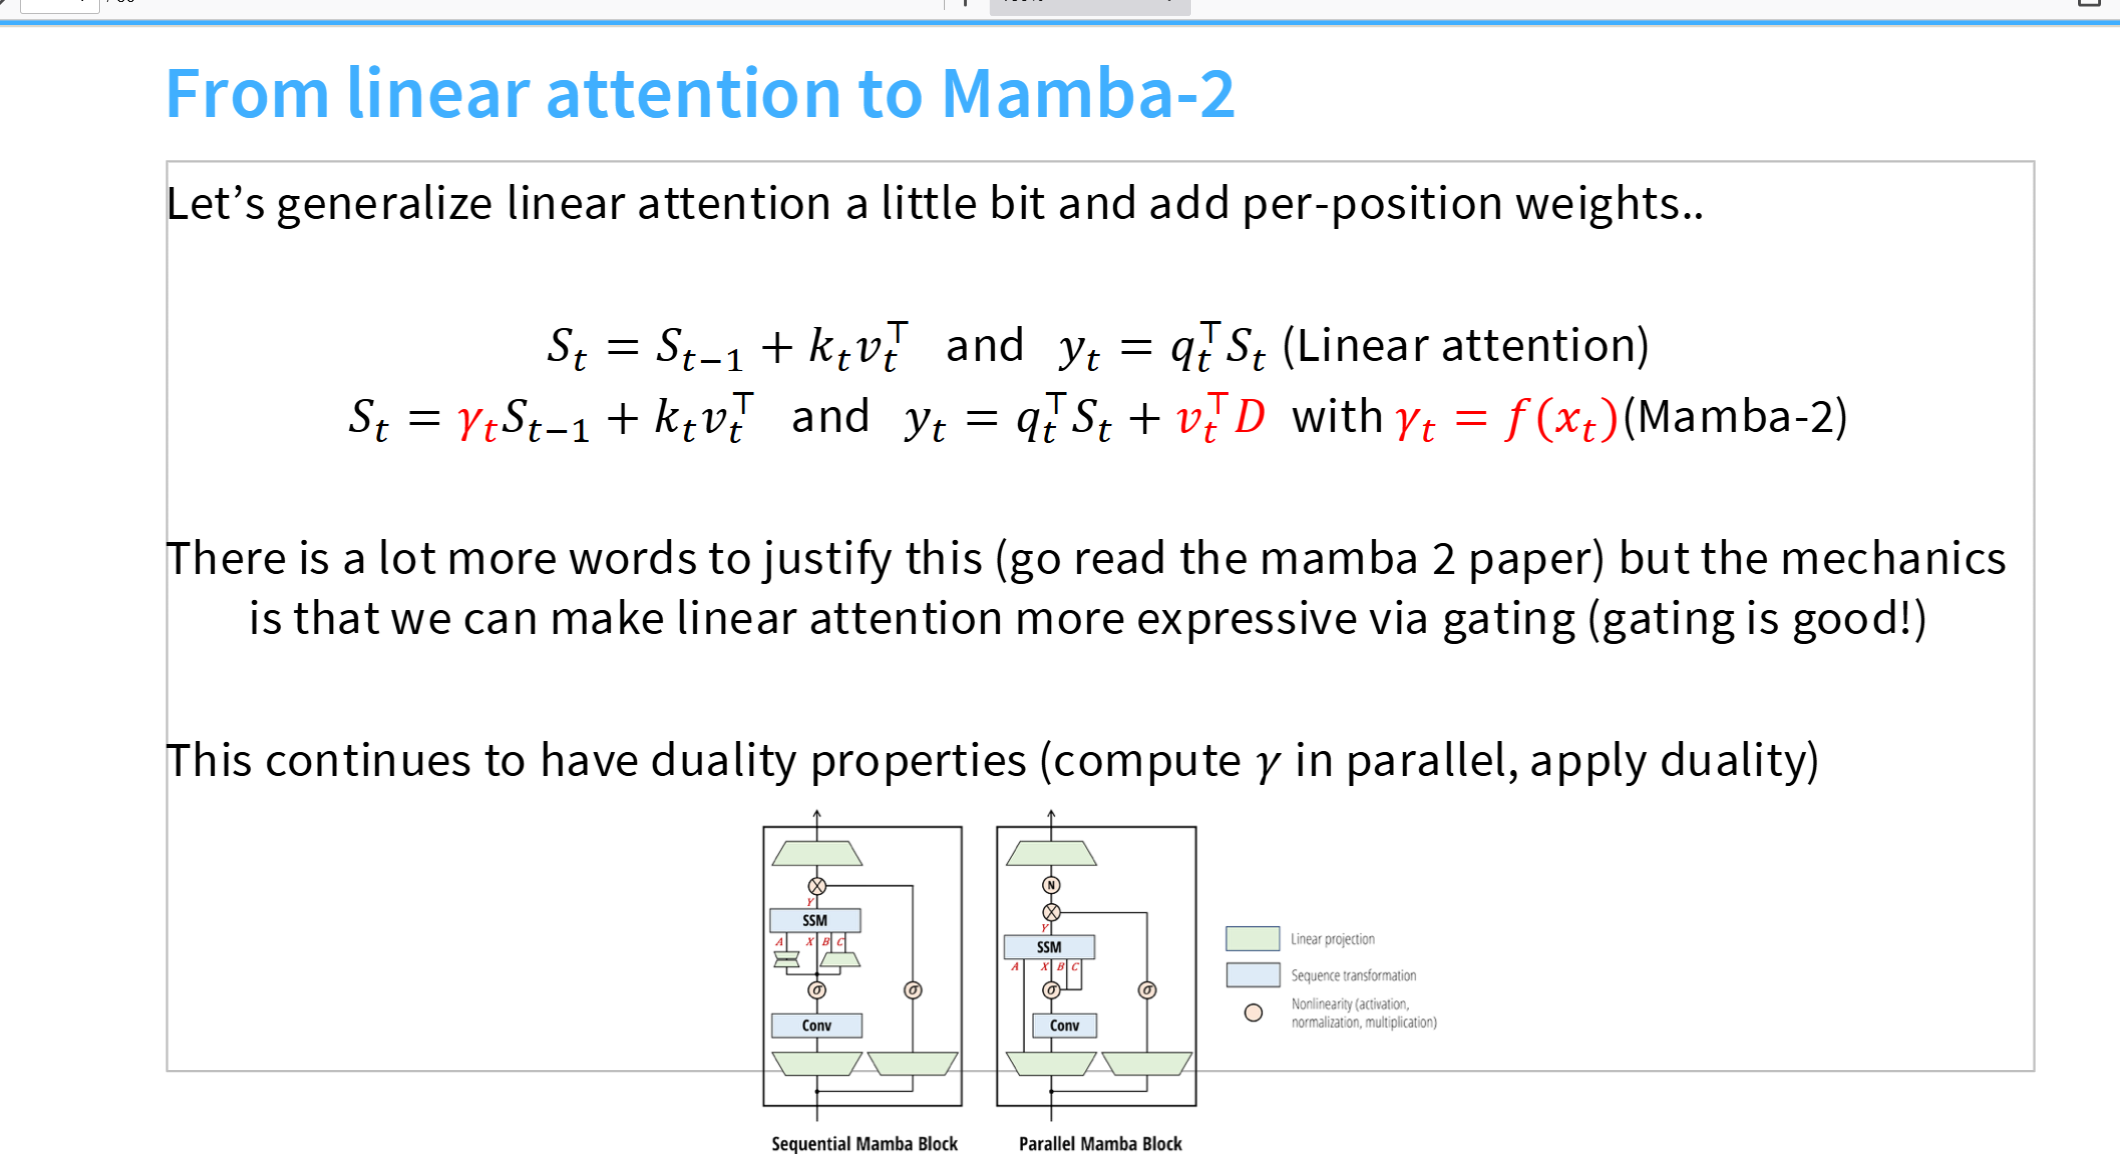
给前面的朴素线性注意力的状态更新时加上了门控γ,门控直接是乘上一个常数,计算量只增加了常数级,但是门控能有效提升模型能力。以及输出时增加了一个含v的项,这类似于ResNet的残差连接项,可以让输入直接影响到输出,不经过隐藏层的压缩,也是可以提升模型能力,同时计算量也只增加了常数级。
举例:Nemotron
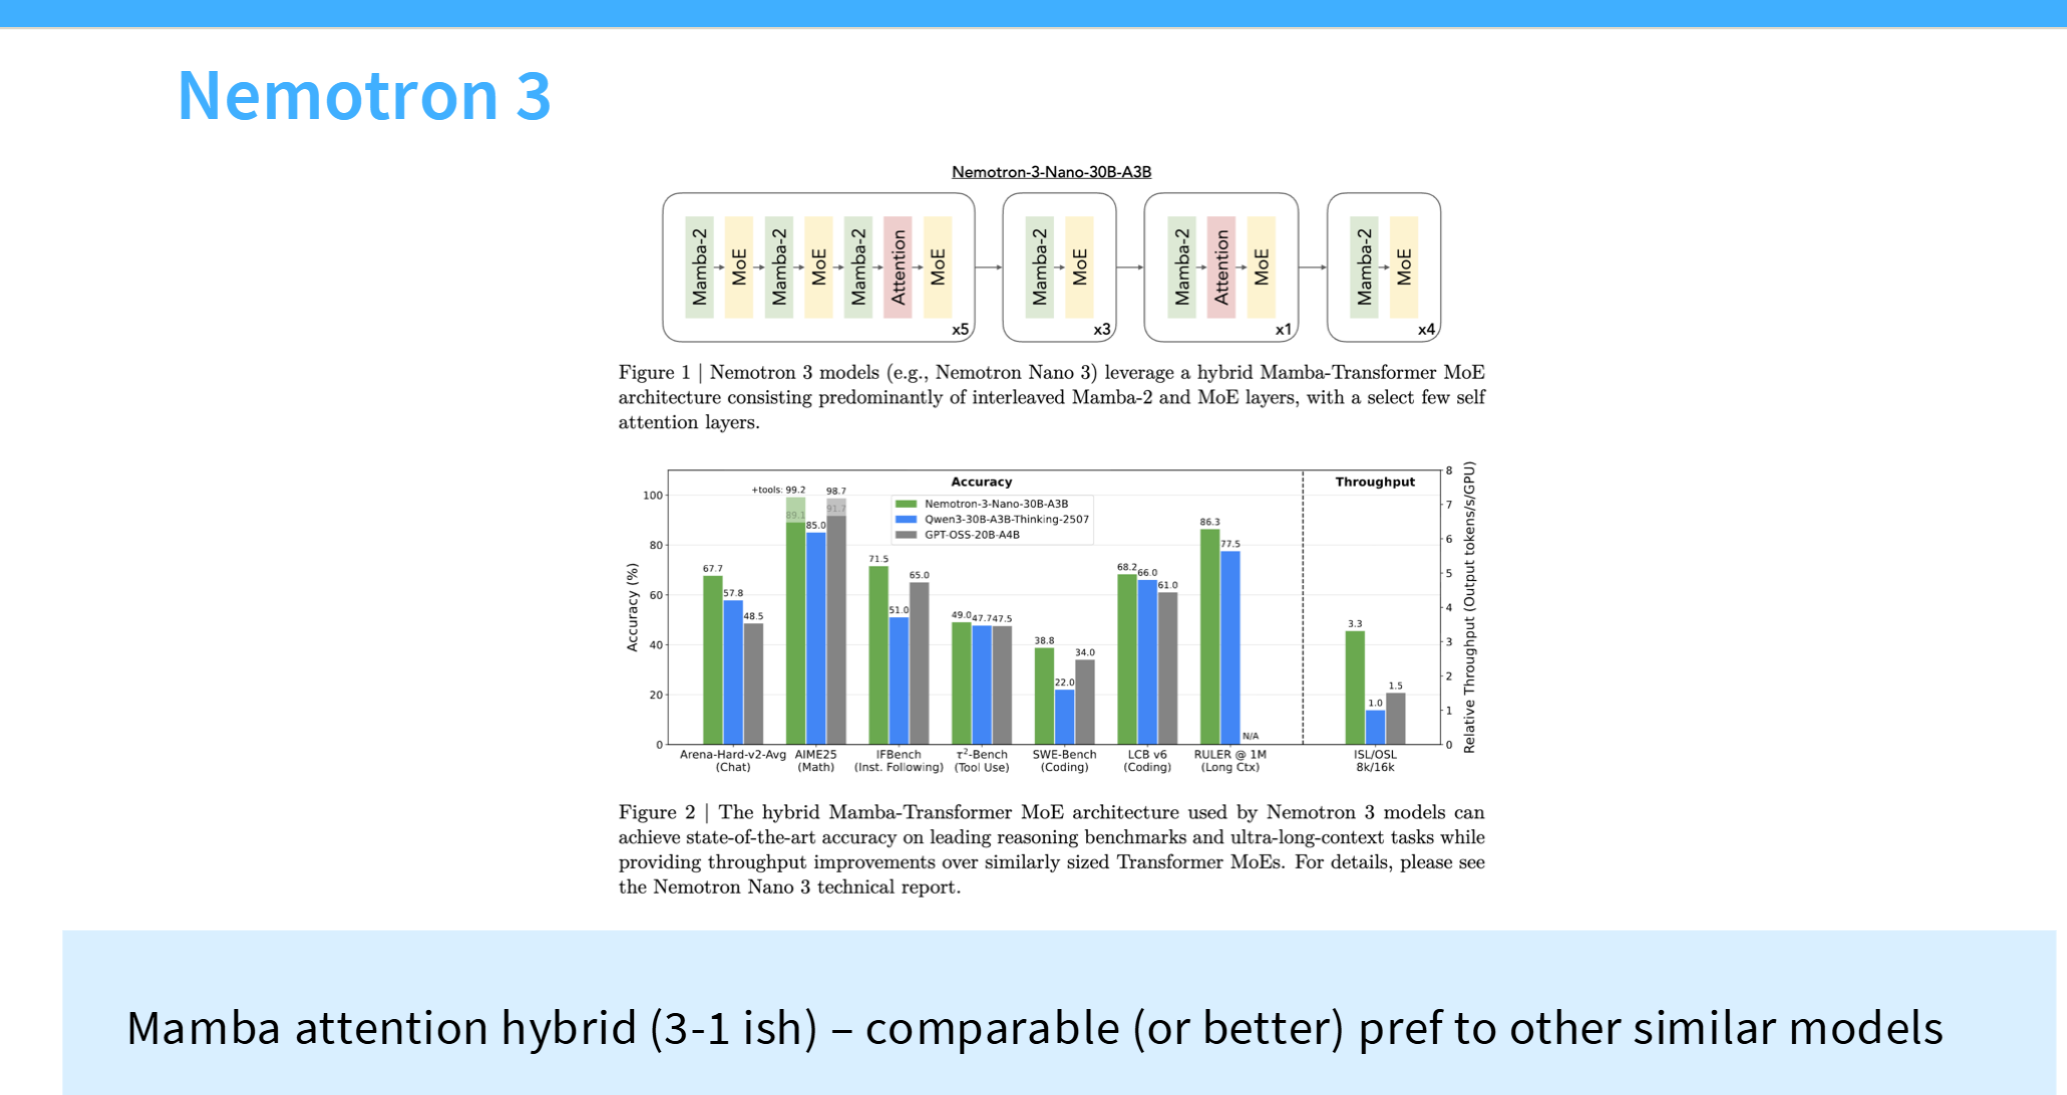
使用Mamba的例子是英伟达开源的Nemotron3,采用的是3层mamba,一层标准注意力的混合架构
继续改进:GDN
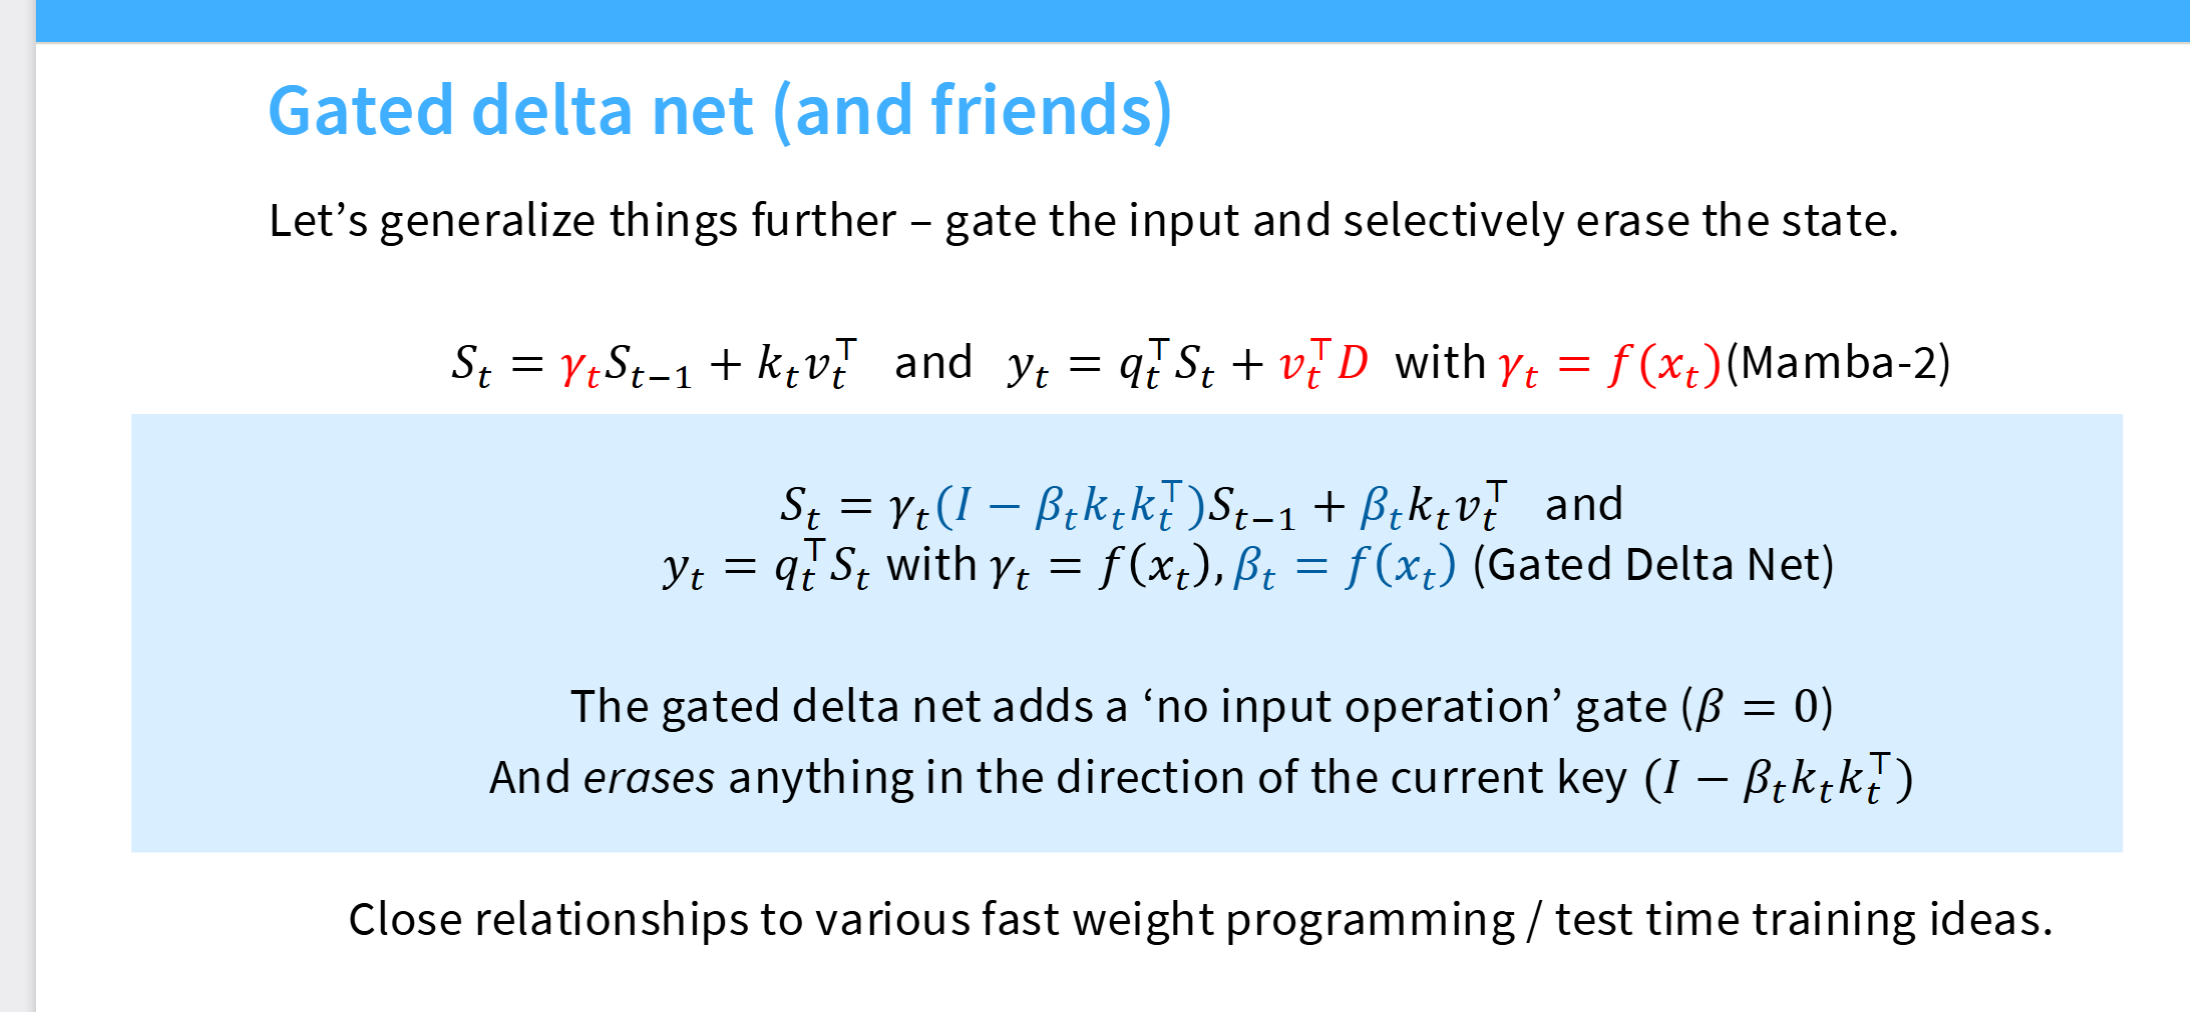
在mamba的基础上,Gated Delta Net,引入了delta规则,同时还保留了门控,这也是他名字里Gated和Delta的来历。核心思想是先乘上一个(It−βtktktT)(I_t-\\beta_tk_tk_t^T)(It−βtktktT)项擦除部分记忆,再加入新token更新记忆,这使得模型表达能力进一步增强。看起来有两个(d,d)的矩阵相乘,单token计算量增长到O(d3)O(d^3)O(d3),但实际上,仍然可以用我们之前提出线性注意力时的技巧,改变矩阵乘法顺序,先做ktTst−1k_t^Ts_{t-1}ktTst−1,再乘上ktk_tkt,整体计算量还是O(d2)O(d^2)O(d2)的,只是常数大一点。
举例:Qwen
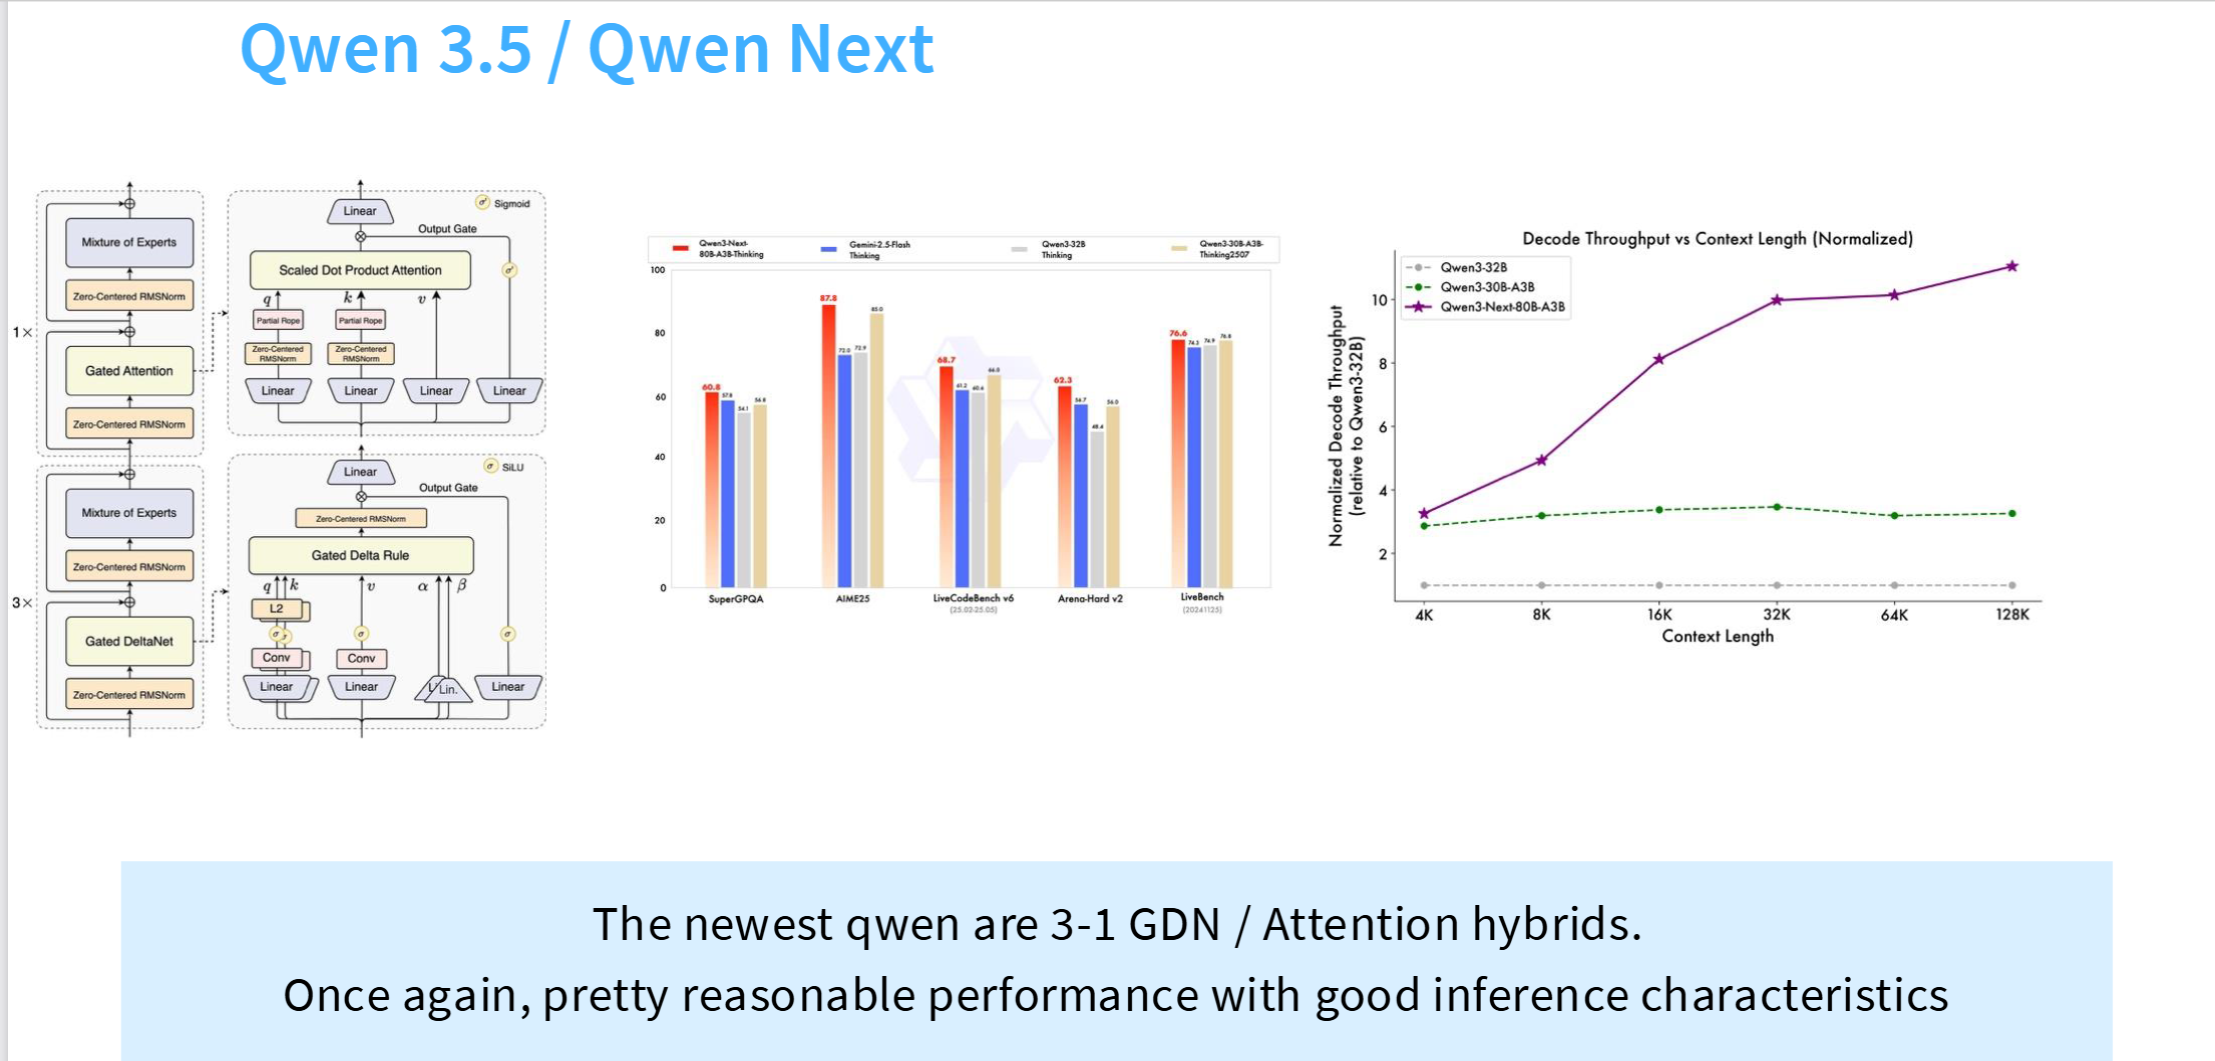
使用GDN最经典的例子是Qwen。如右图,,使用GDN的Qwen Next,相比使用标准注意力的Qwen3,当上下文窗口增长时,吞吐也随之线性增长,而标准注意力的吞吐几乎不变,甚至还略有降低。
消融实验
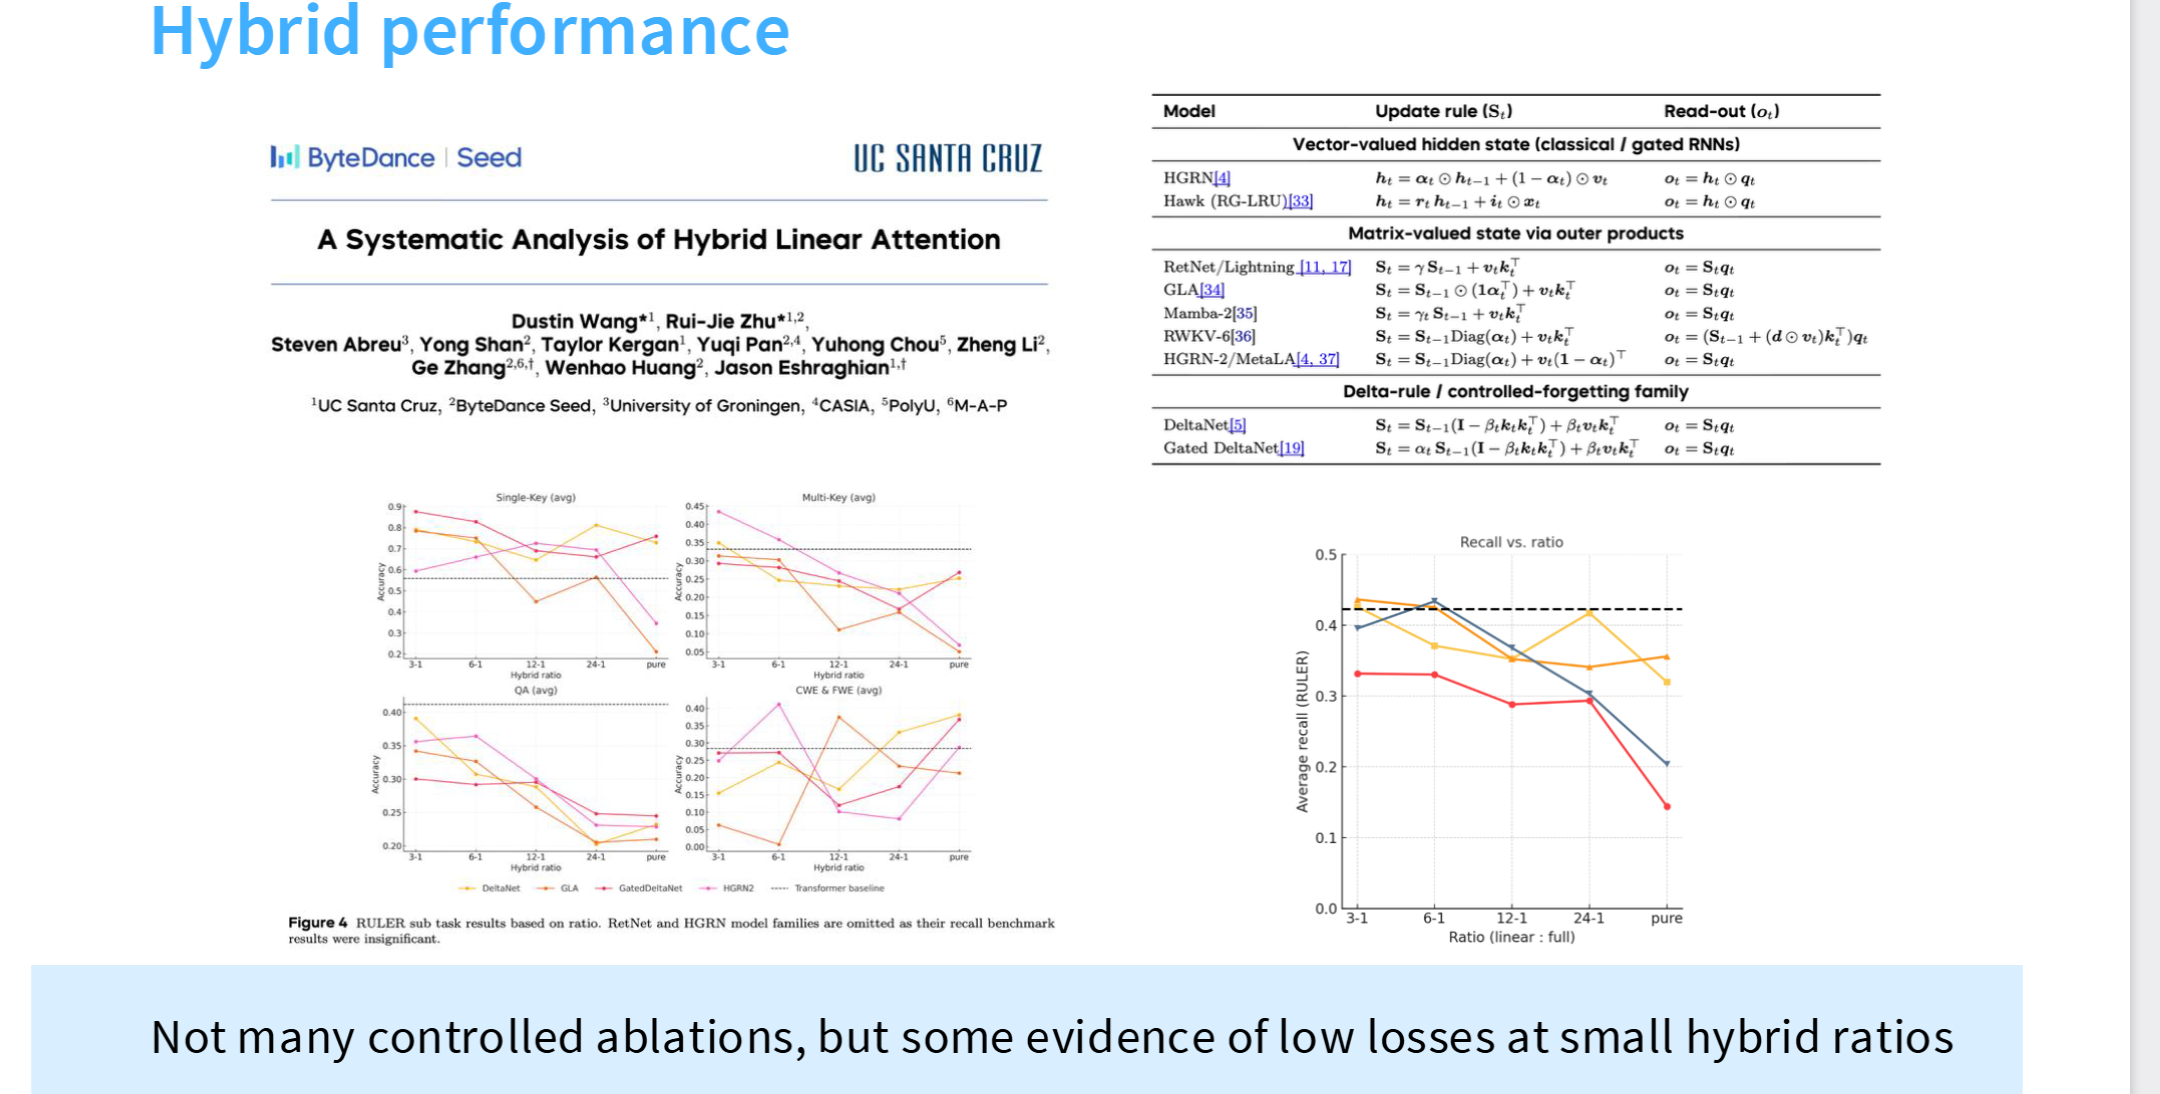
消融实验证明随着线性注意力:标准注意力的比例提升,模型表达能力确实会下降,也就是线性注意力确实会损失表达能力。但是线性注意力比例较低时,模型能力损失的并不多,可以同时获得较好的模型能力,和线性注意力的高吞吐。
另一种注意力变体:DSA
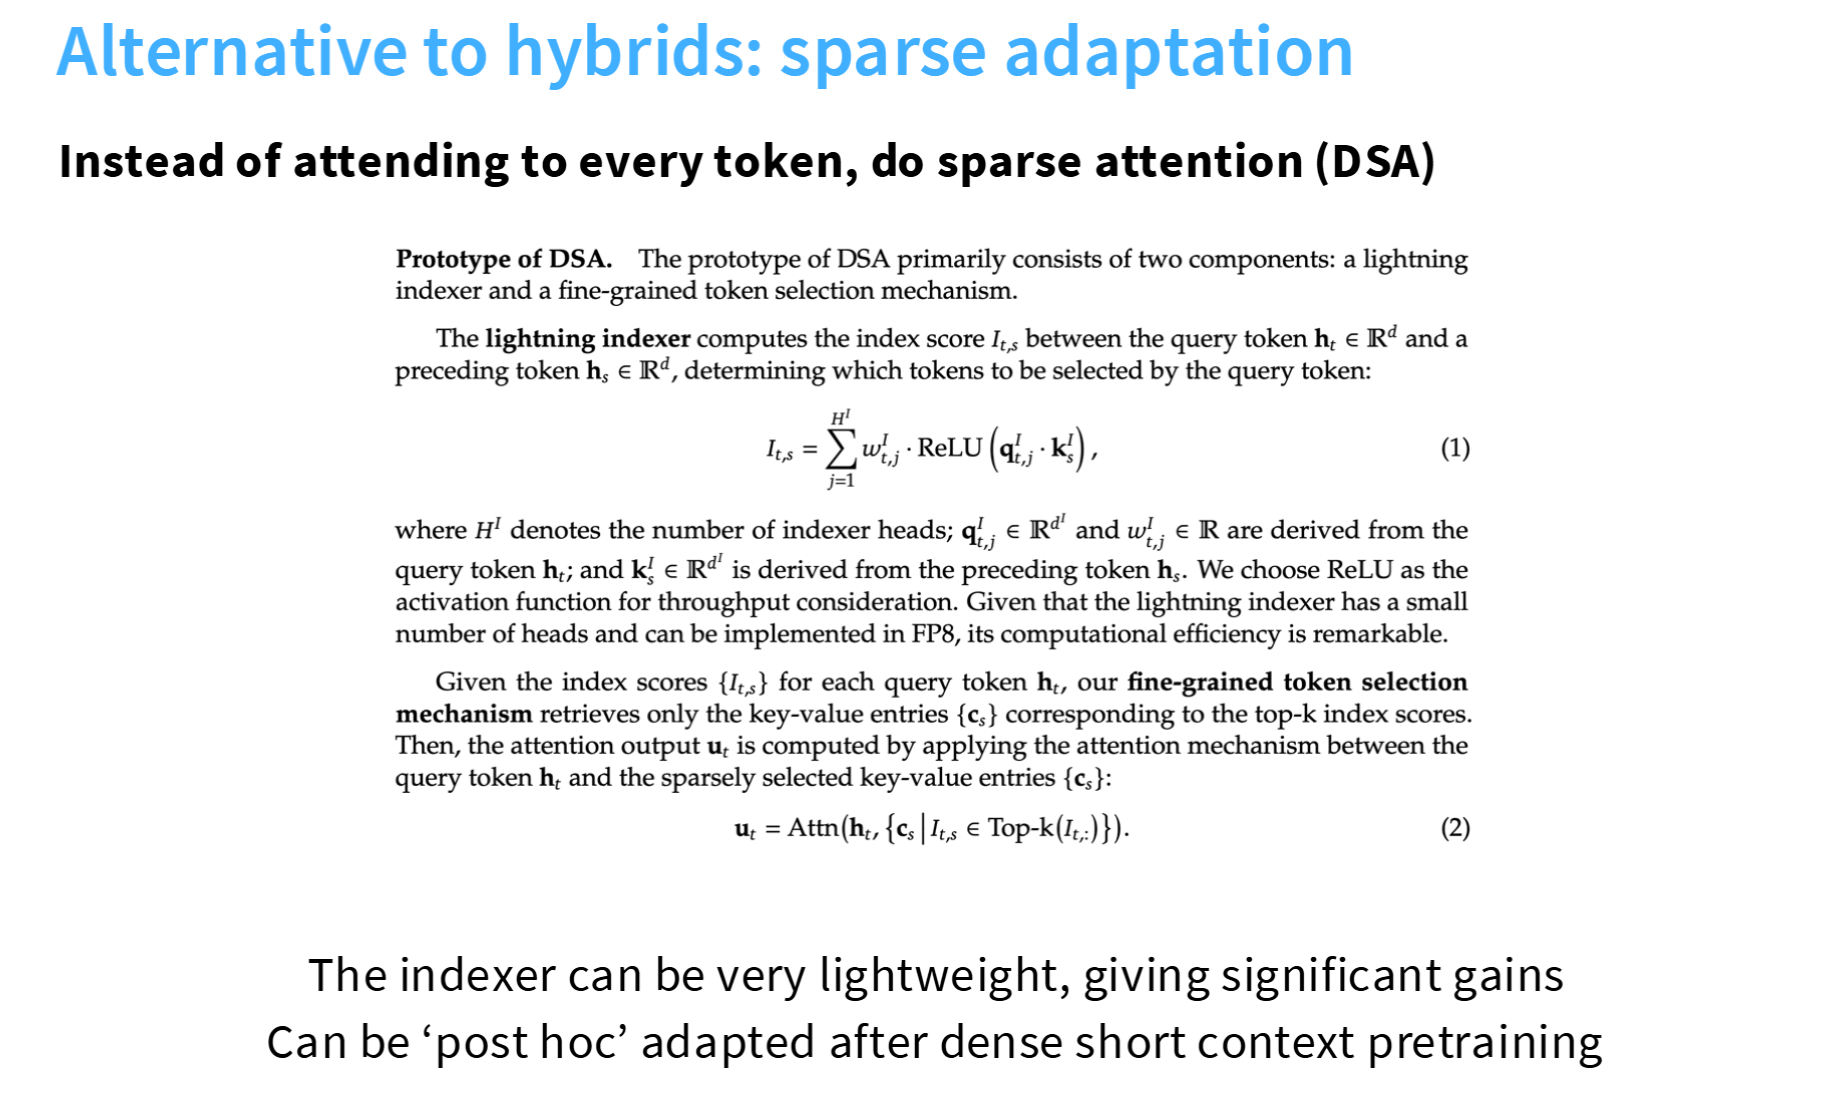
另一种降低注意力复杂度的方法是deepseek提出的deepseek sparse attention,核心思路是先用一个轻量级的索引头indexer,计算出当前token和前面所有token的相关性得分,然后选出topk的token与当前token计算注意力。
优势在于:索引头是很轻的,计算开销很低,接下来只选topk,把计算量从O(n2)O(n^2)O(n2)降低到O(nk)O(nk)O(nk),并且一般k远小于n,且k不随n增长而增大,因此可以视为常数,因此DSA也可以视为O(n)O(n)O(n)复杂度,也是一种线性注意力。
并且索引头是可以单独训练的,也就是可以在一个训练好的标准注意力层上,接上一个indexer,单独训练,只需要一点微调训练即可实现DSA。训练成本也很低。
举例:DeepSeek V3.2/GLM5
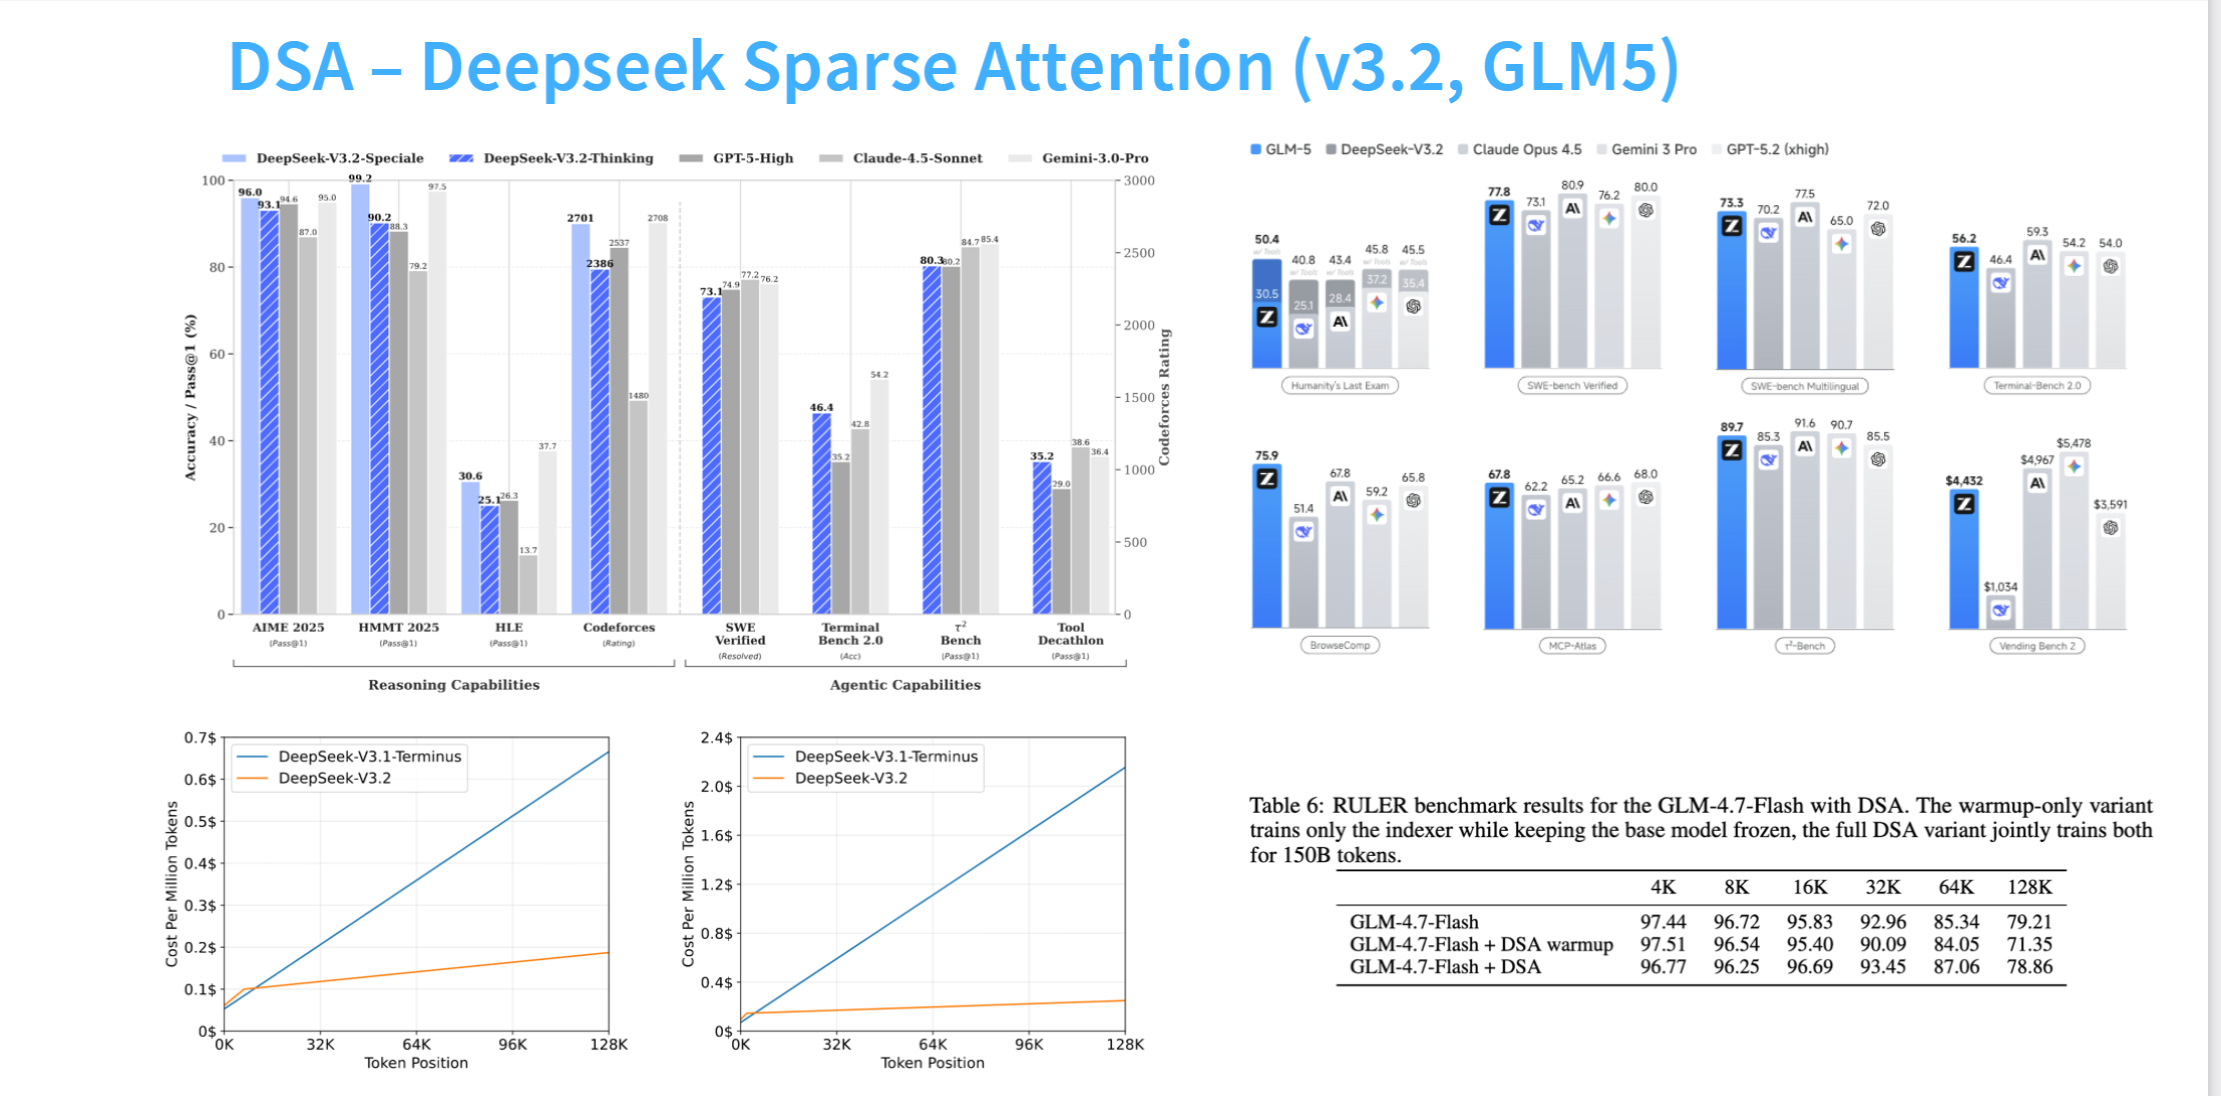
GLM5和DS V3.2都用了DSA架构,模型能都不错。同时注意左下,使用DSA的3.2相比不使用的前代3.1,推理成本大幅下降,随着上下文增长,每百万token的推理成本几乎还是一条直线,斜率低的可怕。这也是deepseek api价格远低于其他公司的原因。


评论前必须登录!
注册