 网硕互联帮助中心
上一篇:第 15 篇《一次完整生成的旅程:预填充与逐词生成》 | 下一篇:第 17 篇《把预训练模型"翻译"成能跑的文件》
一句话导读:推理引擎的自定义格式把事情做在转换时:把"怎么存"直接写进文件,让加载变成"拿来就能算",省下运行时反复搬运的成本。
关键词:推理引擎入门、大模型推理、权重格式(weight format)、固定头、目录(directory)、布局重排
第 3 篇讲过权重文件的样子:一张目录加一堆数字。“头 + 目录 + 数据区"只是骨架,真正决定快慢的是数据在文件里怎么摆。这一篇回答:为什么不用通用格式?答案在"功夫花在什么时候”,以及"怎么保证以后还读得懂"。
① 一句话概念
自定义格式 = 把"怎么存"写进文件。
② 起点:散件家具 vs 预装成品柜
想象你买了一组家具,市面上有两种卖法。
一种是散件:板材、螺丝、五金都装进一个通用的大箱子运来。箱子不大、运费便宜,但到家得自己按图纸组装——先把零件摊开,再一块一块拼起来。零件没问题,费的是"用之前那段装配时间"。
另一种是预装好的成品柜:出厂前拼好拧紧。箱子更大、运费更贵,可开箱就能用。
两种做法用的是同一批板子——材料没变,变的是"什么时候把功夫花掉"。这是取舍:省运费(存储),还是省每次拆箱的力气(使用)。只搬一次、用一次的,散件划算;天天开合的,成品柜更值。
③ 伪代码:先查目录,再按偏移取数
自定义格式把这份"取舍"落到文件上:骨架定死,数据区在转换时就摆好。
文件 = 固定头(432 字节) + 目录(按 64 字节对齐) + 张量数据区(按页边界对齐)
目录项 = { 名字, 形状, 精度标记, 数据起始位置, 长度 }
函数 读(文件, 名字) -> 张量:
项 = 文件.目录[名字] # 先查目录再取数
若 项.版本 != 文件.头.版本: # 版本对不上
报错并停止 # 宁可不加载,也不猜着读
返回 文件.数据区[项.数据起始位置 : 项.数据起始位置 + 项.长度]
逐行要点:
文件的整体结构如图 1 所示。
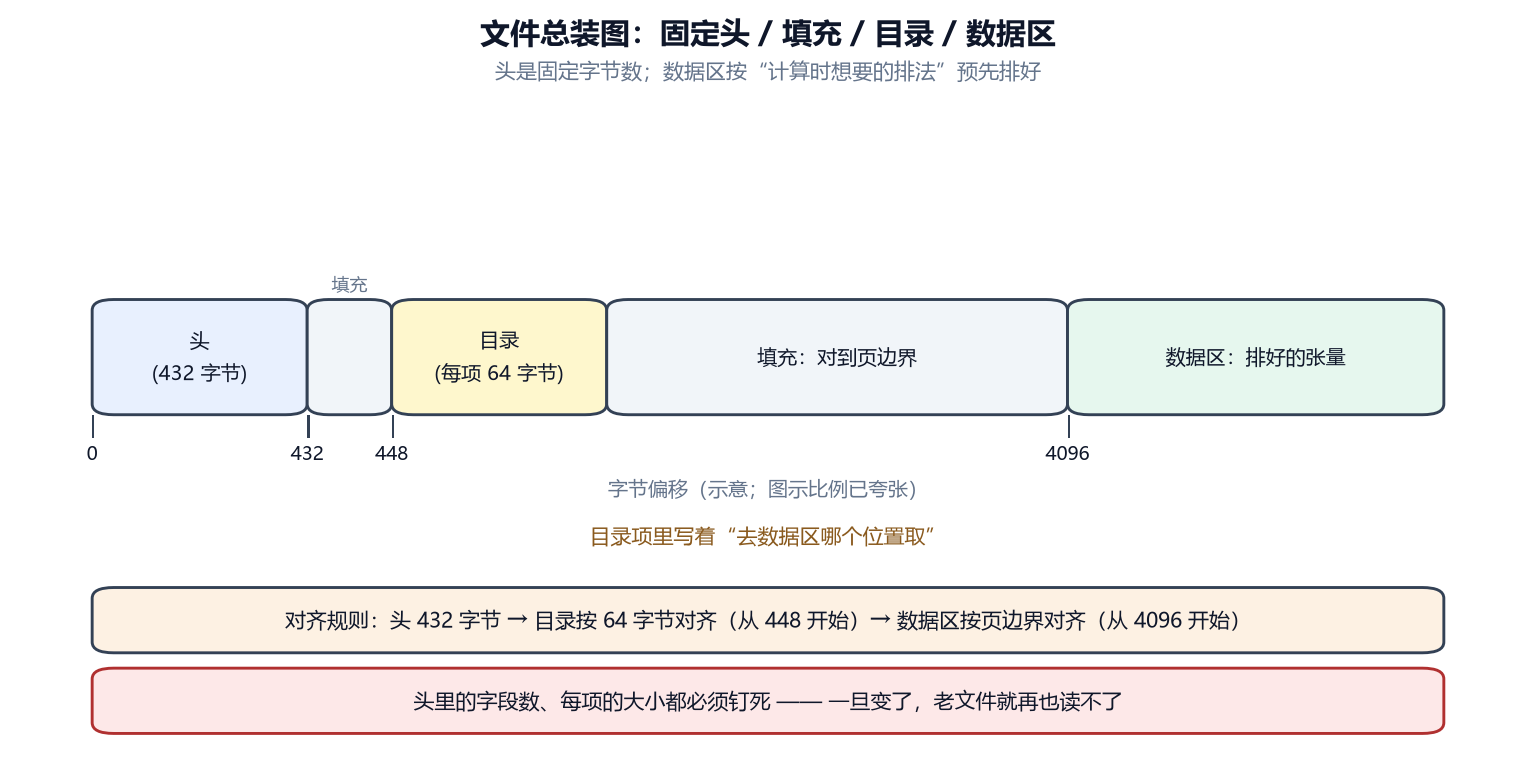
图 1 文件总装图:固定头 / 填充 / 目录 / 数据区:横向条带加一条字节位置标尺,四个关键偏移是 0 / 432 / 448 / 4096——头 432 字节,补 16 字节对齐到 448 放目录,再补到页边界 4096 放数据区;目录区有一支箭头指向数据区,表示"目录项里写着去数据区哪取数"。
④ 纸笔实验(必做)
任务:画一张文件总装图,标出四段起始位置。已知:头固定 432 字节;目录按 64 字节对齐;本例 3 个张量、每项 64 字节;数据区按页边界对齐(每 4096 字节一页)。
- 头:第 0 字节起,占 432 字节 → [0, 432)。
- 目录:432 补到 64 的整数倍 → 从 448 起;3 × 64 = 192 字节 → 占 [448, 640)。
- 数据区:640 补到下一个页边界 → 从 4096 开始。
预期结果:四个位置——头 0、填充 432、目录 448、数据 4096。要记住:要按页对齐的是数据区,不是目录——目录只需 64 字节对齐,中间空出的是填充。
两种存法的差别如图 2 所示。
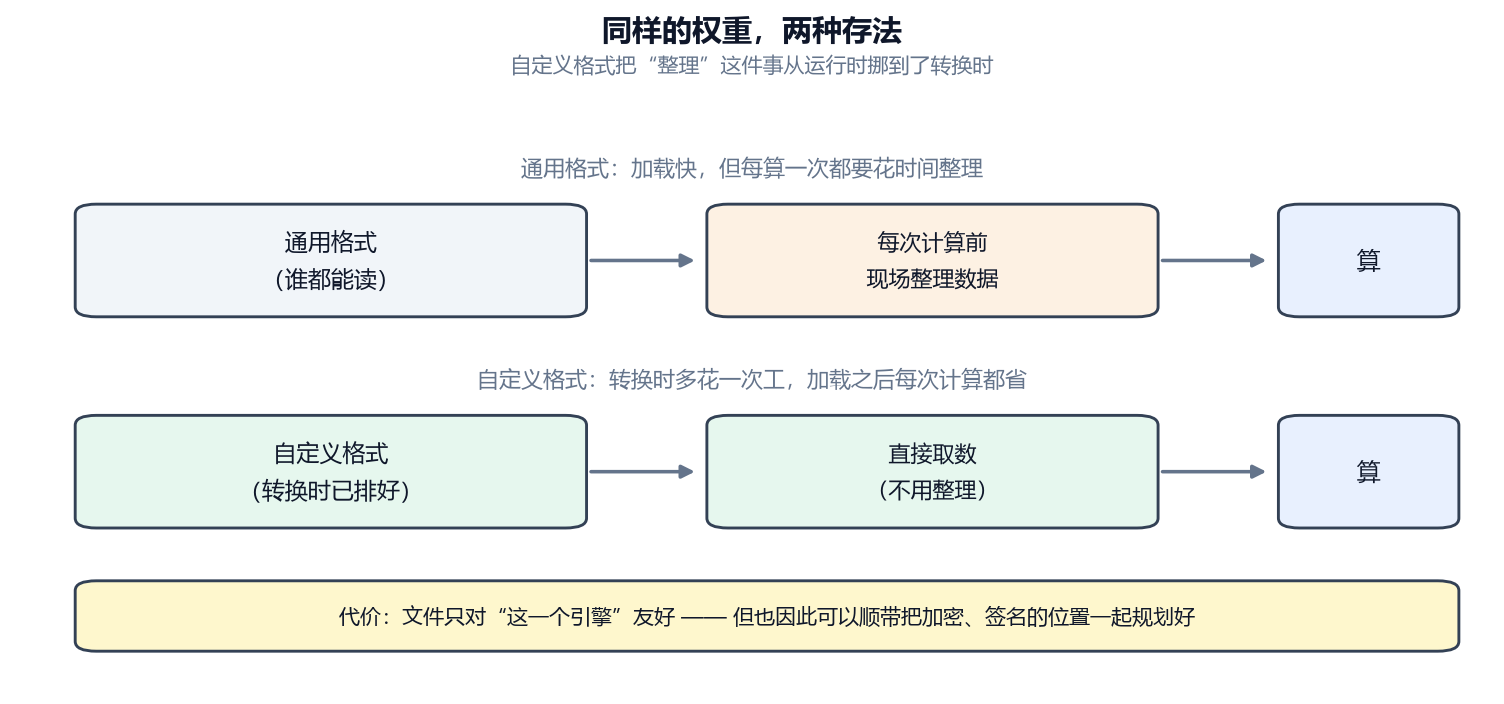
图 2 同样的权重,两种存法:左边是通用格式——每次计算前先重排一遍;右边是自定义格式——重排已在转换时做完,加载后直接能算。
可选 REPL 版:
# 算四个区段的起始位置
头, 页, 目录对齐 = 432, 4096, 64
目录起始 = (头 + 目录对齐 – 1) // 目录对齐 * 目录对齐 # 先补到 64 字节边界
目录长度 = 3 * 64
数据起始 = (目录起始 + 目录长度 + 页 – 1) // 页 * 页 # 数据区再补到页边界
print(头, 目录起始, 目录起始 + 目录长度, 数据起始)
# 输出: 432 448 640 4096
⑤ 进阶锚点
进阶锚点:本篇概念在《30 天手搓推理引擎》Day 16 里被真正实现——
16-1 VQF 的野心:把量化与布局固化到文件 / 16-2 逐字段解剖:VQFHeader / VQFSig / VQFTensor / 16-3 tensor 目录与布局重排的落盘顺序。
入门版到这里就够了;进阶版会多出:VQF 头部逐字段解剖(含 432 字节的固定大小守卫)、tensor 目录的落盘顺序,以及一处"文档注释与真实字节不符"的踩坑复盘(引自进阶系列源码与文档口径)。
想动手 → 仓库 https://gitee.com/pei-xiaoguang/kestrel-llm,从 Day 1 开始。
下篇预告:既然格式是我们自己定的,那别人训练好的模型怎么搬进来?下一篇讲转换:把预训练模型"翻译"成能跑的文件。


评论前必须登录!
注册