 网硕互联帮助中心
深入理解指针(六):sizeof 与 strlen 辨析及指针运算通关
前言
在前几篇《深入理解指针》系列中,我们系统梳理了字符指针、数组指针、函数指针、回调函数以及 qsort 的模拟实现。指针的核心在于对内存布局和类型步长的精准把控。本篇作为指针系列的教学课件,将围绕三个核心主题展开:sizeof 与 strlen 的本质区别、数组与指针的经典笔试题、指针运算。

目录
- 一、sizeof 和 strlen 的对比
- 1.1 本质区别
- 1.2 原创示例代码
- 1.3 一个容易被忽略的细节
- 二、数组和指针笔试题解析
- 2.1 一维数组
- 2.2 字符数组与字符指针
- 2.3 二维数组
- 三、指针运算笔试题解析
- 3.1 指针类型决定步长
- 3.2 结构体指针偏移与强制类型转换
- 3.3 逗号表达式陷阱
- 3.4 指针相减:元素个数而非字节差
- 3.5 二维数组的行指针偏移
- 3.6 指针数组与二级指针
- 3.7 多级指针的内存追踪
- 四、总结
一、sizeof 和 strlen 的对比
1.1 本质区别
sizeof 是 C 语言中的一个单目操作符(关键字),而 strlen 是一个库函数,这是它们最根本的区别。很多人初学时会误以为 sizeof 是函数,实际上它是由编译器直接处理的。
| 本质 | 单目操作符(关键字) | 库函数(需 <string.h>) |
| 求值时机 | 编译期 | 运行期 |
| 功能 | 计算变量或类型占用的字节数 | 统计字符串中 \\0 之前的字符个数 |
| 关注点 | 只关心内存空间大小,不关心内容 | 关心内存中是否有 \\0,无 \\0 会越界 |
| 返回值类型 | size_t | size_t |
1.2 原创示例代码
#include <stdio.h>
#include <string.h>
int main(void) {
int num = 0x12345678;
printf("sizeof(num) = %zu\\n", sizeof(num)); // 4:整型大小
printf("sizeof num = %zu\\n", sizeof num); // 4:sizeof 是操作符,可省略括号
printf("sizeof(long) = %zu\\n", sizeof(long)); // 4 或 8,取决于平台
char text1[] = "C pointer";
char text2[] = {'C', ' ', 'p', 'o', 'i', 'n', 't', 'e', 'r'};
const char *text3 = "C pointer";
printf("sizeof(text1) = %zu\\n", sizeof(text1)); // 10:包含结尾的 '\\0'
printf("strlen(text1) = %zu\\n", strlen(text1)); // 9:不包含 '\\0'
printf("sizeof(text2) = %zu\\n", sizeof(text2)); // 9:数组本身大小
// printf("strlen(text2) = %zu\\n", strlen(text2)); // 危险!无 '\\0',越界查找,结果随机
printf("sizeof(text3) = %zu\\n", sizeof(text3)); // 8 或 4:指针大小
printf("strlen(text3) = %zu\\n", strlen(text3)); // 9:字符串长度
printf("sizeof(*text3) = %zu\\n", sizeof(*text3)); // 1:字符 'C' 的大小
return 0;
}
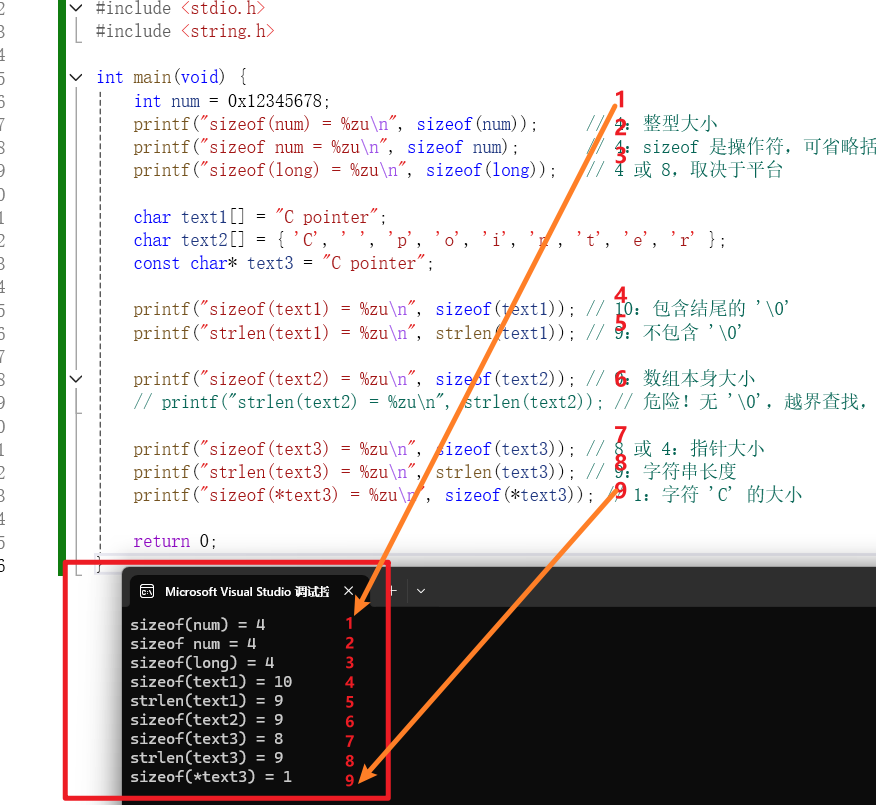
提示:strlen 的参数必须是 char * 类型。如果传入 *text3(即字符 'C',ASCII 值为 67),strlen 会把 67 当作地址去访问内存,导致段错误。这是一个非常隐蔽的陷阱——编译器不会报错,但运行时会崩溃。
1.3 一个容易被忽略的细节
sizeof 在计算表达式大小时,如果表达式包含函数调用,函数并不会被真正执行,因为 sizeof 在编译期就能根据类型确定结果。例如:
#include <stdio.h>
#include <string.h>
int get_length(void) {
printf("该函数被调用了!\\n");
return 0;
}
int main(void) {
int len = 10;
printf("sizeof(len + get_length()) = %zu\\n", sizeof(len + get_length()));
// 输出为 4,且不会打印"该函数被调用了!"
return 0;
}
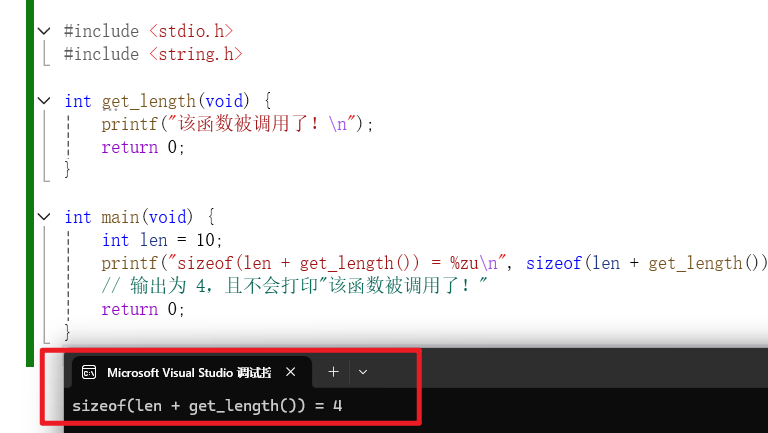
这一特性再次印证了 sizeof 的编译期本质,与 strlen 的运行期求值形成鲜明对比。
二、数组和指针笔试题解析
核心法则:数组名在大多数表达式中会退化为首元素地址,但有两个例外:
2.1 一维数组
#include <stdio.h>
int main(void) {
double d[] = {1.5, 2.5, 3.5, 4.5};
printf("sizeof(d) = %zu\\n", sizeof(d)); // 32:整个数组,4 * 8
printf("sizeof(d + 0) = %zu\\n", sizeof(d + 0)); // 8 或 4:d 退化为 double*,指针大小
printf("sizeof(*d) = %zu\\n", sizeof(*d)); // 8:首元素 double
printf("sizeof(d + 2) = %zu\\n", sizeof(d + 2)); // 8 或 4:指向第三个元素的指针
printf("sizeof(d[2]) = %zu\\n", sizeof(d[2])); // 8:第三个元素 double
printf("sizeof(&d) = %zu\\n", sizeof(&d)); // 8 或 4:整个数组的地址,数组指针
printf("sizeof(*&d) = %zu\\n", sizeof(*&d)); // 32:*&d 等价于 d,整个数组
printf("sizeof(&d + 1) = %zu\\n", sizeof(&d + 1)); // 8 或 4:跳过整个数组后的指针
printf("sizeof(&d[0] + 1) = %zu\\n", sizeof(&d[0] + 1)); // 8 或 4:指向第二个元素的指针
return 0;
}
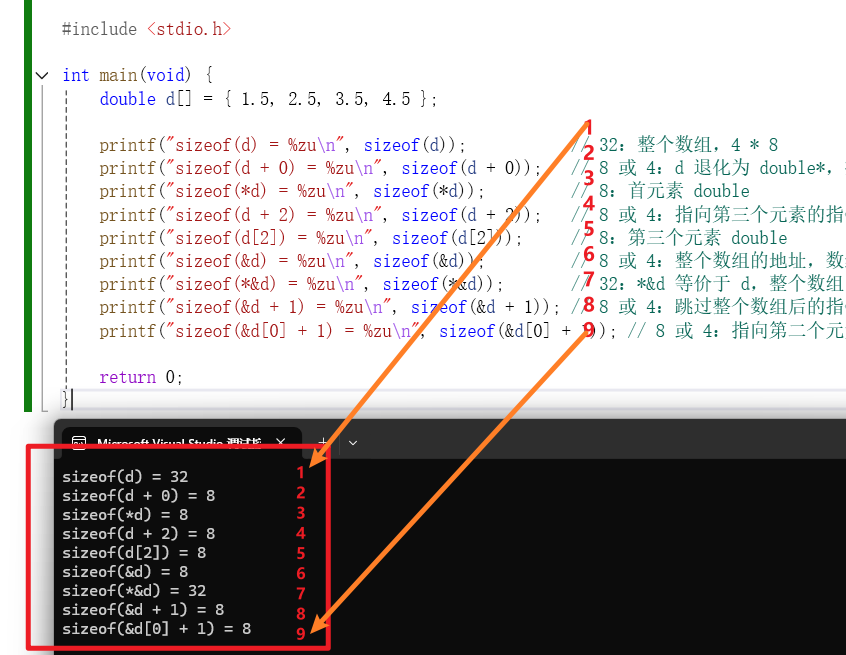
解析:d 和 &d 的值相同,但类型不同。d + 1 跳过 8 个字节(一个 double),而 &d + 1 跳过 32 个字节(整个数组)。理解这一点的关键在于区分指针的值和指针的类型:值相同不代表行为相同,类型才决定了指针的步长。
2.2 字符数组与字符指针
#include <stdio.h>
#include <string.h>
int main(void) {
char s1[] = "hello";
char s2[] = {'h', 'e', 'l', 'l', 'o'};
char *s3 = "hello";
printf("sizeof(s1) = %zu, strlen(s1) = %zu\\n", sizeof(s1), strlen(s1)); // 6, 5
printf("sizeof(s2) = %zu\\n", sizeof(s2)); // 5
// strlen(s2) 未定义,因为 s2 没有 '\\0',不演示
printf("sizeof(s3) = %zu, strlen(s3) = %zu\\n", sizeof(s3), strlen(s3)); // 8/4, 5
printf("sizeof(*s3) = %zu\\n", sizeof(*s3)); // 1
return 0;
}
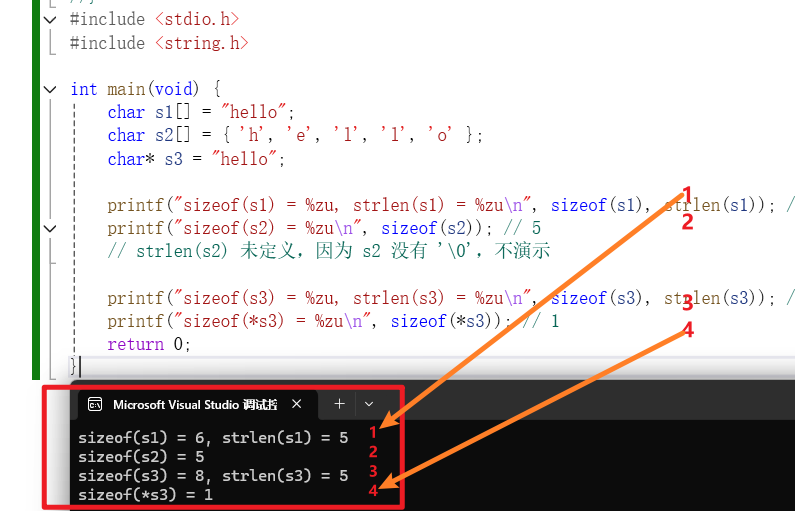
解析:字符数组 s1 由字符串字面量初始化时,编译器会自动在末尾添加 \\0,因此 sizeof(s1) 为 6。而 s2 使用初始化列表逐字符赋值,没有隐式的 \\0,sizeof(s2) 为 5,对其调用 strlen 属于未定义行为。
2.3 二维数组
#include <stdio.h>
int main(void) {
short mat[2][3] = {0};
printf("sizeof(mat) = %zu\\n", sizeof(mat)); // 12:2 * 3 * 2
printf("sizeof(mat[0]) = %zu\\n", sizeof(mat[0])); // 6:第一行,3 * 2
printf("sizeof(mat[0][0]) = %zu\\n", sizeof(mat[0][0])); // 2:一个 short
printf("sizeof(mat + 1) = %zu\\n", sizeof(mat + 1)); // 8 或 4:行指针
printf("sizeof(*(mat + 1)) = %zu\\n", sizeof(*(mat + 1))); // 6:第二行数组
printf("sizeof(&mat[0] + 1) = %zu\\n", sizeof(&mat[0] + 1)); // 8 或 4:行指针
printf("sizeof(*(&mat[0] + 1)) = %zu\\n", sizeof(*(&mat[0] + 1))); // 6:等价于 mat[1]
printf("sizeof(mat[1]) = %zu\\n", sizeof(mat[1])); // 6:第二行数组
return 0;
}
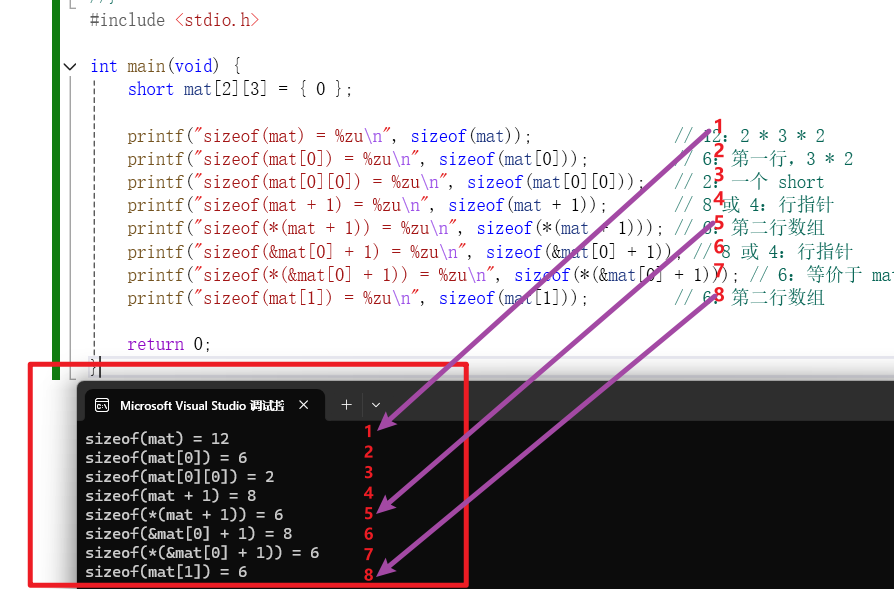
解析:二维数组 mat 是一维数组的数组。mat 退化为指向第一行的指针,类型为 short (*)[3],步长是一整行(6 字节)。mat + 1 跳过第一行,指向第二行的起始地址;而 *(mat + 1) 解引用后得到第二行这个一维数组,大小为 6 字节。
三、指针运算笔试题解析
指针运算的核心在于类型决定步长。《C和指针》中反复强调:指针的算术运算不是简单的整数加减,而是以指针所指向类型的大小为单位进行移动的。理解这一点,是破解所有指针运算题目的关键。
3.1 指针类型决定步长
题目:
#include <stdio.h>
int main(void) {
int arr[6] = {10, 20, 30, 40, 50, 60};
int *p = (int *)(&arr + 1);
printf("%d\\n", *(p – 2));
return 0;
}
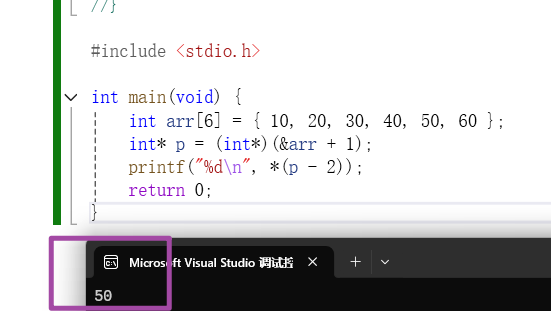
解析:
这道题的关键在于区分 arr 和 &arr 的类型差异。arr 作为数组名,在参与运算时退化为指向首元素的指针,类型为 int *,步长为 4 字节。而 &arr 取出的是整个数组的地址,类型为 int (*)[6],步长为整个数组的大小——24 字节。
因此 &arr + 1 从数组首地址出发,跳过完整的 24 字节,指向数组末尾之后的位置。这个位置本身不能解引用,但我们可以将其强制转换为 int * 类型的指针 p。此时 p 的步长从 24 字节变为了 4 字节。
p – 2 表示从数组末尾之后的位置向前移动 2 个 int,即 8 字节。这个位置指向数组的倒数第二个元素,也就是 50。
输出结果:50
核心法则:指针的步长由指针的类型决定,而不是由它当前指向的数据决定。(int *)(&arr + 1) 先完成了"跳过整个数组"的操作,再通过强制类型转换将步长改回 4 字节,实现了从数组尾部反向访问的能力。
3.2 结构体指针偏移与强制类型转换
题目:假设在 32 位环境下,结构体定义如下,请计算各表达式的值。
#include <stdio.h>
struct Test {
int Num;
char *pcName;
short sDate;
char cha[2];
short sBa[4];
} *p = (struct Test *)0x100000;
int main(void) {
printf("%p\\n", p + 0x1);
printf("%p\\n", (unsigned long)p + 0x1);
printf("%p\\n", (unsigned int *)p + 0x1);
return 0;
}
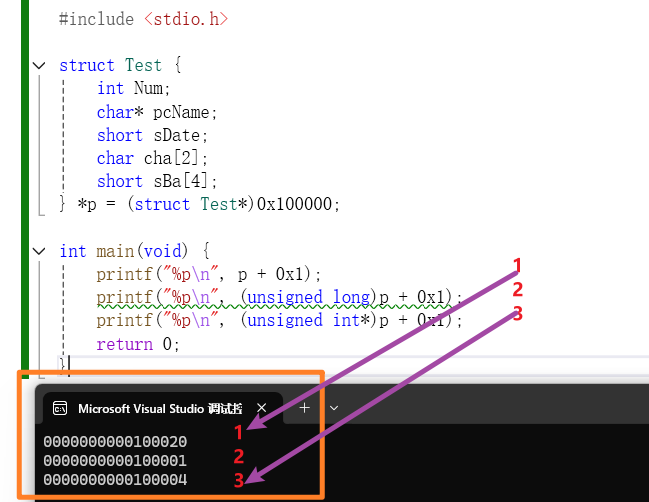
解析:
这道题的实质是考察同一个地址值在不同类型下的不同解释。p 被初始化为 0x100000,但它是一个结构体指针,它的步长由 sizeof(struct Test) 决定。
第一个表达式 p + 0x1:p 是 struct Test * 类型,p + 1 表示跳过一整个结构体。根据题目条件,结构体大小为 20 字节,因此 0x100000 + 20 得到 0x100014。
第二个表达式 (unsigned long)p + 0x1:指针被强制转换为无符号长整型,不再是指针,而是普通的整数。整数加 1 就是数值加 1,结果就是 0x100001。
第三个表达式 (unsigned int *)p + 0x1:指针被强制转换为 unsigned int * 类型,步长变为 4 字节。0x100000 + 4 得到 0x100004。
输出结果:0x100014、0x100001、0x100004
核心法则:指针的类型决定了 +1 的含义。struct Test * 的 +1 是加 20 字节,unsigned long 的 +1 是加 1,unsigned int * 的 +1 是加 4 字节。
3.3 逗号表达式陷阱
题目:以下代码输出什么?
#include <stdio.h>
int main(void) {
int a[3][2] = { (0, 1), (2, 3), (4, 5) };
int *p;
p = a[0];
printf("%d", p[0]);
return 0;
}
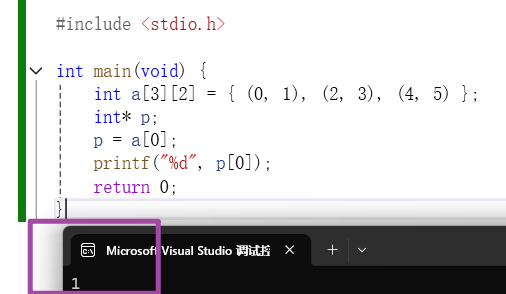
解析:
这道题的陷阱在于初始化列表的写法。(0, 1) 使用的是小括号而不是大括号。在 C 语言中,小括号内的逗号是逗号表达式,它会依次计算每个表达式的值,最终返回最后一个表达式的值。
因此 (0, 1) 的结果是 1,(2, 3) 的结果是 3,(4, 5) 的结果是 5。数组实际上被初始化为:
a[0][0] = 1, a[0][1] = 3
a[1][0] = 5, a[1][1] = 0
a[2][0] = 0, a[2][1] = 0
p = a[0] 让 p 指向数组第一行的首元素。p[0] 就是 a[0][0],即 1。
输出结果:1
核心法则:二维数组初始化时,必须使用嵌套的大括号 {{0, 1}, {2, 3}, {4, 5}} 才能正确初始化。使用小括号会被编译器解释为逗号表达式,数据会错位。这个陷阱也提醒我们:初始化列表是"初始化"而非"赋值",语法上的细微差别可能导致语义完全不同。
3.4 指针相减:元素个数而非字节差
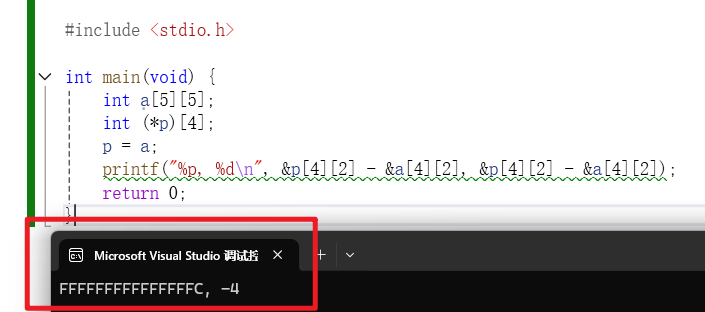
题目:假设环境是 x86(32 位),程序输出的结果是啥?
#include <stdio.h>
int main(void) {
int a[5][5];
int (*p)[4];
p = a;
printf("%p, %d\\n", &p[4][2] – &a[4][2], &p[4][2] – &a[4][2]);
return 0;
}
解析:
这道题是《C和指针》中"指针减法得到的是元素个数"这一规则的经典应用。两个指针相减的结果不是地址的字节差,而是它们之间元素的个数。
首先分析 a 的类型。a 是 int[5][5],作为右值参与运算时退化为指向第一行的指针,类型为 int (*)[5],步长是一整行(5 个 int,20 字节)。
p 被声明为 int (*)[4],步长是一行 4 个 int(16 字节)。
计算 &p[4][2]:p[4] 等价于 *(p + 4),p 跳过 4 行(每行 4 个 int),到达第 5 行。p[4][2] 再偏移 2 个 int。相对于数组首地址,总偏移为 4 * 4 + 2 = 18 个 int。
计算 &a[4][2]:a[4] 等价于 *(a + 4),a 跳过 4 行(每行 5 个 int),到达第 5 行。a[4][2] 再偏移 2 个 int。相对于数组首地址,总偏移为 4 * 5 + 2 = 22 个 int。
两者相减:18 – 22 = -4,得到的是元素个数差,即 -4。
第一个 printf 使用 %p 打印这个差值。在 32 位系统中,-4 的补码表示为 0xFFFFFFFC。第二个 printf 使用 %d 打印有符号整数 -4。
输出结果:0xFFFFFFFC, -4
核心法则:指针相减的前提是两个指针指向同一块连续内存。相减的结果是元素个数(带符号整数),而非字节数。如果地址计算涉及不同的步长(如本题中的 int (*)[4] 和 int (*)[5]),必须分别按各自的步长计算出相对于同一个基地址的偏移量,再相减。
3.5 二维数组的行指针偏移
题目:
#include <stdio.h>
int main(void) {
int aa[2][5] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int *ptr1 = (int *)(aa + 1);
int *ptr2 = (int *)(*aa + 1);
printf("%d, %d", *(ptr1 – 1), *(ptr2 – 1));
return 0;
}
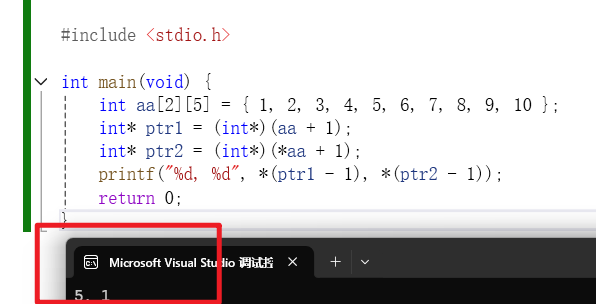
解析:
这道题考察的是二维数组名与解引用操作的不同含义。
aa 作为二维数组名,在参与运算时退化为指向第一行的行指针,类型为 int (*)[5],步长是一整行(20 字节)。aa + 1 跳过第一行,指向第二行的起始地址。强制转换为 int * 后,ptr1 的步长变为 4 字节。ptr1 – 1 从第二行起始位置向前移动 1 个 int,指向第一行的最后一个元素。
*aa 等价于 aa[0],是第一行的数组名。作为右值参与运算时退化为指向第一行首元素的指针,类型为 int *,步长为 4 字节。*aa + 1 指向第一行的第二个元素(值为 2)。强制转换为 int * 后 ptr2 仍指向该位置。ptr2 – 1 向前移动 1 个 int,指向第一行的第一个元素。
输出结果:5, 1
核心法则:aa 和 *aa 的值在数值上相同,都是数组首地址,但类型完全不同。aa 是 int (*)[5],*aa 是 int *。aa + 1 跳过 20 字节,*aa + 1 跳过 4 字节。
3.6 指针数组与二级指针
题目:
#include <stdio.h>
int main(void) {
char *a[] = {"work", "at", "alibaba"};
char **pa = a;
pa++;
printf("%s\\n", *pa);
return 0;
}
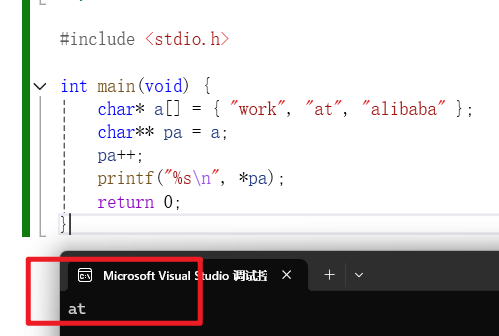
解析:
a 是一个指针数组,每个元素都是 char * 类型,分别指向三个字符串常量。pa 是一个二级指针,被初始化为指向数组 a 的首元素(即 a[0] 的地址)。
pa++ 让 pa 向后移动一个 char * 的大小,指向 a[1]。*pa 解引用得到 a[1] 的值,也就是指向字符串 "at" 的指针。
输出结果:at
3.7 多级指针的内存追踪
题目:
#include <stdio.h>
int main(void) {
char *c[] = {"ENTER", "NEW", "POINT", "FIRST"};
char **cp[] = {c + 3, c + 2, c + 1, c};
char ***cpp = cp;
printf("%s\\n", **++cpp);
printf("%s\\n", *—*++cpp + 3);
printf("%s\\n", *cpp[–2] + 3);
printf("%s\\n", cpp[–1][–1] + 1);
return 0;
}
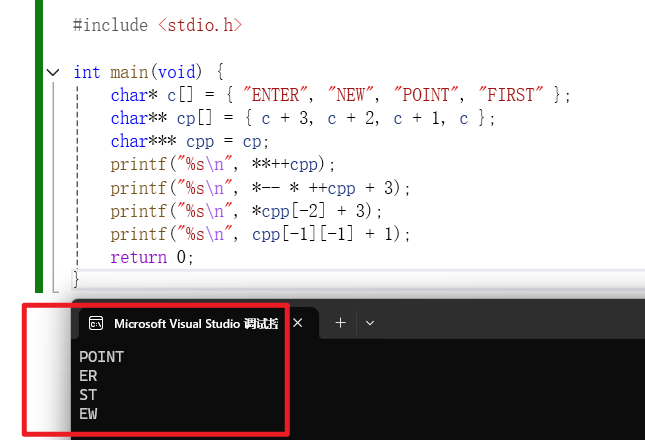
解析:
这道题是《C专家编程》中的经典题目,也是多级指针最极致的考验。它的唯一解法是画内存图。需要注意的是,++cpp 和 — 操作会修改 cpp 和 cp 的实际内容,因此每一步都建立在上一步修改后的状态之上。
初始内存布局:
| c[0] | "ENTER" | 字符串 ENTER |
| c[1] | "NEW" | 字符串 NEW |
| c[2] | "POINT" | 字符串 POINT |
| c[3] | "FIRST" | 字符串 FIRST |
| cp[0] | c + 3 | c[3],即 "FIRST" |
| cp[1] | c + 2 | c[2],即 "POINT" |
| cp[2] | c + 1 | c[1],即 "NEW" |
| cp[3] | c | c[0],即 "ENTER" |
cpp 初始指向 cp[0]。
- 第一行:**++cpp
++cpp 首先自增,cpp 从指向 cp[0] 变为指向 cp[1]。*cpp 得到 cp[1] 的值,即 c + 2。再解引用一次,*(c + 2) 得到字符串 "POINT"。
输出:POINT
此时 cpp 指向 cp[1],保持不变。
- 第二行:*–*++cpp + 3
++cpp 先自增,cpp 从指向 cp[1] 变为指向 cp[2]。
*++cpp 解引用得到 cp[2] 的值,即 c + 1。
–*++cpp:注意 cp[2] 的值被修改,从 c + 1 变为 c。
*–*++cpp 解引用得到 *(c + 0),即字符串 "ENTER"。
+ 3 后,指针从 "ENTER" 的 'E' 位置向后移动 3 个字符,指向 "ER"。
输出:ER
此时 cpp 指向 cp[2],cp[2] 的值变为 c。
- 第三行:*cpp[-2] + 3
cpp[-2] 等价于 *(cpp – 2)。cpp 当前指向 cp[2],cpp – 2 指向 cp[0]。*(cpp – 2) 得到 cp[0] 的值,即 c + 3。
*cpp[-2] 再解引用一次,得到 *(c + 3),即字符串 "FIRST"。
+ 3 后,从 "FIRST" 的 'F' 位置向后移动 3 个字符,指向 "ST"。
输出:ST
注意:cpp[-2] 不修改 cpp,cpp 仍指向 cp[2]。
- 第四行:cpp[-1][-1] + 1
cpp[-1] 等价于 *(cpp – 1)。cpp 当前指向 cp[2],cpp – 1 指向 cp[1]。
cpp[-1] 得到 cp[1] 的值。注意 cp[1] 的值没有被修改过,仍然是 c + 2。
cpp[-1][-1] 等价于 *(*(cpp – 1) – 1)。*(cpp – 1) 是 c + 2,减 1 得到 c + 1。解引用得到 *(c + 1),即字符串 "NEW"。
+ 1 后,从 "NEW" 的 'N' 位置向后移动 1 个字符,指向 "EW"。
输出:EW
最终输出:
POINT
ER
ST
EW
核心法则:多级指针的运算必须一步一步展开,每一步都要明确当前指针指向谁,以及解引用后得到什么值。自增和自减操作会永久修改指针的指向和值,必须追踪这些副作用。画内存图是解决多级指针问题的唯一可靠方法。
四、总结
通过本篇的原创题目,我们可以提炼出以下指针通关心法:
指针的进阶不仅是语法游戏,更是对计算机内存模型的深度理解。希望这篇博客能帮你在指针题海中拨云见日,顺利通关!
如果觉得有帮助,欢迎点赞收藏,留个关注支持一下吧!


评论前必须登录!
注册