 网硕互联帮助中心
大家好,我是晚安code。
假设一个场景:"这个模型说支持 100 万上下文,那我是不是可以把整个项目代码都丢进去?"看了眼账单,没说话。所以我打算把"大模型是什么"这件事从头到尾讲一遍,一个名词都不跳过。
这篇就把话说白:大模型到底是什么,Token、上下文窗口、Temperature、MoE 各自管什么,Chat 模型和基座模型差在哪,普通对话和深度思考怎么选,网页端和 API 该用哪个。看完你至少能自己判断一个模型值不值得用。点个收藏,咱们开始。
一、大模型到底是个什么东西
先说结论:大模型就是一台"下一个 Token 预测机"。它做的事非常朴素——给你一串文本,猜下一个 Token 最可能是什么。
听着像废话对吧?我一开始也这么想。但你要让这个猜测足够准,模型就必须在内部把语法、事实、逻辑关系、代码结构这些东西全部编码进去。就像输入法联想,你打"今天天气",它猜"不错",这背后只统计了几个词的关系;大模型的联想窗口开到了几万亿参数的尺度,"今天天气"后面接着猜的,可能是段能跑的代码。
拆开看,一个模型由三样东西决定:
预训练阶段的目标函数简单到只有一行:最大化下一个 Token 的预测概率。剩下那些"会写代码"“能翻译”"懂比喻"的能力,是数据量堆到一定程度后自己长出来的,业内管这叫涌现。
所以别把大模型想成一本科教书,它更像一个把海量文本压缩进参数里的概率函数。理解这一句,后面四个概念就都顺了。
二、Token 与上下文窗口:它一次能看见多少
Token(词元):大模型处理文本的最小单位,模型不按"字"算,按 Token 算。你可以理解为模型眼里的积木块——中文一个汉字大约 1~2 个 Token,英文一个单词大约 1~3 个 Token。
这个单位为什么重要?因为它同时是计费单位和容量单位。我第一次认真看 API 账单的时候才反应过来:我按字算费用,人家按 Token 算,中文因为分词方式的缘故,同样一段话的 Token 数经常比我想的多。
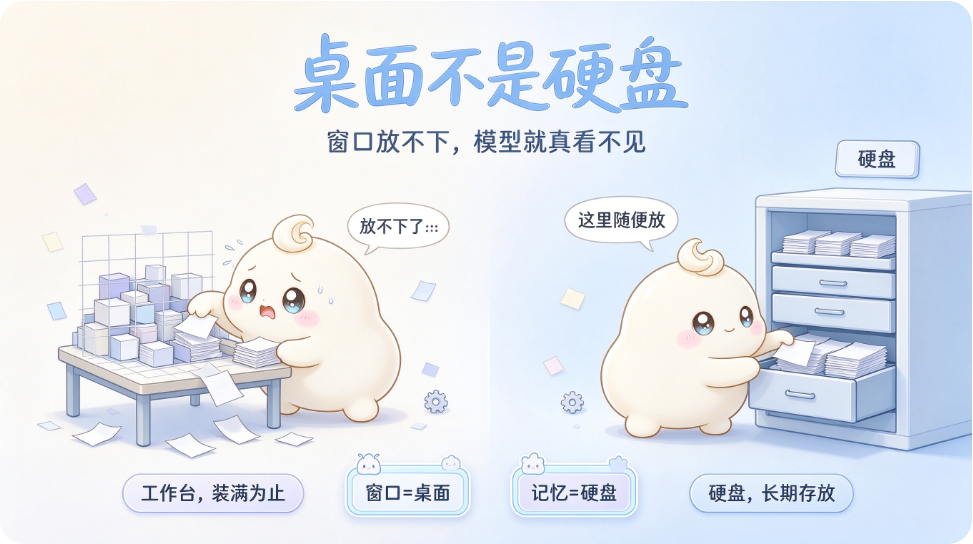
上下文窗口(Context Window):模型单次请求能"看见"的 Token 总数上限,包含你输入的提示词和模型生成的回复。你可以把它理解成一张工作台,所有材料都得摊在这张桌子上,桌子放不下的内容,模型是真看不见。
这里有个特别容易踩的误区:上下文窗口不是硬盘,是桌面。
我见过不少人以为开 100 万 Token 就等于有了 100 万 Token 的记忆,于是把整个仓库的代码一次性塞进去。实际会发生三件事:
所以长窗口的正确用法是"该放的才放"——检索出来的相关片段、当前任务的上下文,而不是无脑全量投喂。
可能有人会问:那我是不是该无脑选上下文最长的那个模型?
不一定。先看你任务的真实长度:日常写代码、做问答,128K 大多用不满。长窗口更适合读整本书、审一整个仓库这种场景,而且用之前最好实测一下它在长输入下的召回表现,厂商标的是最大支持,不是质量保证。
三、Temperature:同一个问题为什么每次回答都不一样
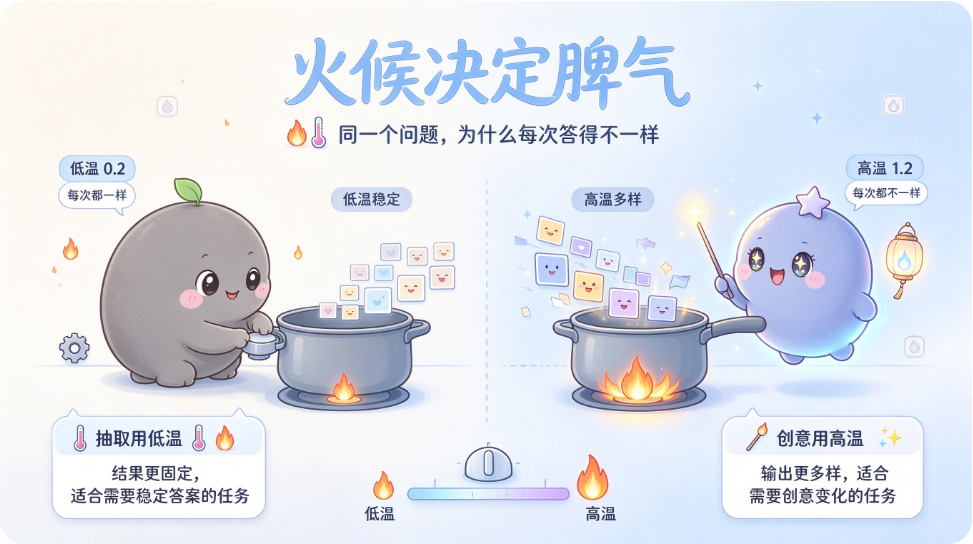
大模型的输出不是查表,是采样。每次生成一个 Token,模型会先算出一整套概率分布,再从里面挑一个——Temperature 就是控制这个"挑"有多随机的旋钮。
Temperature(温度):控制模型输出随机性的采样参数,值越低输出越确定、越可复现,值越高输出越发散、越有意外。你可以理解为做菜的火候——小火慢炖出稳定的味道,大火爆炒出来的东西每次都不一样。
判断句放这儿:Temperature 不是"聪明度"旋钮,它调的是随机性,调高不会让它变聪明,只会让它更敢瞎说。
我踩过的坑很典型:有一次让模型从一段日志里抽结构化字段,怎么改提示词都不稳定,时而多一个字段时而少一个。后来才发现默认温度在那摆着,把它压到 0 附近,输出立刻老实了。
这是我一般会用的取值,仅供参考:
| 代码补全、信息抽取、分类 | 0~0.3 | 要的是可复现,容不得自由发挥 |
| 日常问答、翻译、总结 | 0.5~0.7 | 稳定为主,留一点自然表达空间 |
| 起名、头脑风暴、文案发散 | 0.9~1.2 | 要的就是多样性,撞出意外组合 |
不过要提醒一句:温度不是唯一变量。同一温度下换个模型、换个提示词模板、甚至只是重跑一次,输出不一样都很正常。
四、MoE:为什么 2.8 万亿参数的模型还跑得起
这两年国产模型的参数一个个往万亿上冲,但 API 价格反而在跌。矛盾吗?不矛盾,因为总参数不等于每次推理要算的参数。
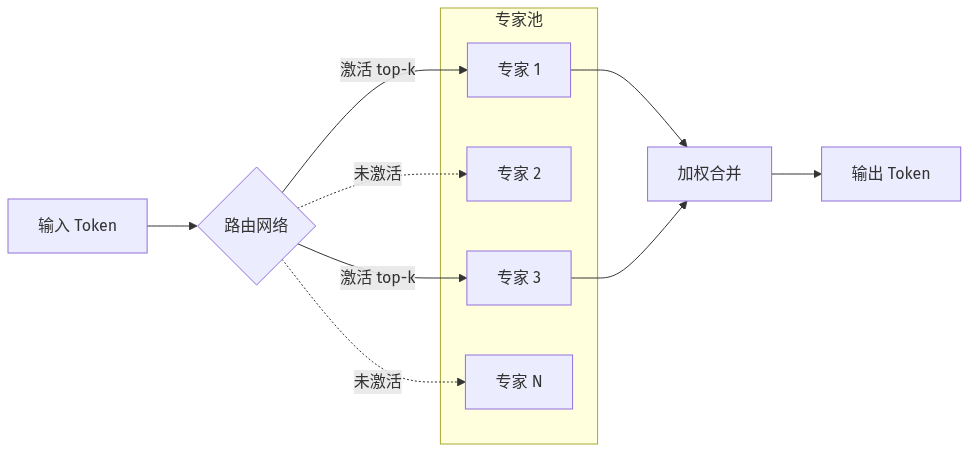
MoE(Mixture of Experts,混合专家):把一个大模型拆成很多个并行的子网络(专家),每次处理一个 Token 时,由路由网络只挑其中一小部分专家来算。你可以理解为一家综合医院——院里几十个科室,你感冒了只挂呼吸科,不用把全院医生都叫来会诊。
和传统稠密模型对比一下就很清楚:
| 每次推理要算的参数 | 全部参数 | 只有被激活的少数专家 |
| 显存占用 | 相对低(参数少) | 高(总参数都得装下) |
| 同等算力下可扩展的上限 | 受算力限制 | 明显更高 |
| 推理延迟 | 稳定 | 路由有额外开销,但总计算量小 |
这里有个特别常见的误读:看到"2.8 万亿参数"就以为跑一次要烧掉 2.8 万亿参数的算力。不是的,真正决定推理成本的是每次激活的那部分参数。
再补一个我自己的观察:MoE 让"参数竞赛"变得没那么直接可比了。厂商发布会报总参数,工程师该看的是激活参数——两个总参一样的模型,激活参数量可能差一个数量级,成本和速度完全不是一回事。
五、Chat 模型不等于"更聪明的基座模型"
判断句:Chat 模型不是基座模型的升级版,它是基座模型被规训之后的样子。
基座模型(Base Model):只做过预训练、目标就是续写下一个 Token 的模型。它知识量大,但不会"回答问题"——你问它"北京在哪",它可能接着给你编出十个类似的问题,因为在它眼里你只是给了它一段待续写的文本。
Chat 模型:在基座之上做过指令微调和对齐的模型,能听懂"请帮我做某事"这类指令,并按助手的口吻回答。你可以理解为同一个人的两种状态——一个是满腹经纶但不看场合的学者,一个是受过职业训练的客服。
从基座到 Chat,中间大致走三步:

对齐换来了"听得懂人话",代价是别的:原始知识密度会被话术稀释,输出多样性下降,模型也更倾向于给出四平八稳的答案。做领域微调的朋友尤其要注意——你要的是把新知识灌进去,还是把回答风格调成助手腔?这决定了你选基座还是选 Chat 版。这不是一个"哪个更好"的问题,是"哪个更合你的事"。
六、普通对话和深度思考,差在哪
先说结论:两者的区别不在谁更聪明,而在要不要给模型发一张草稿纸。
普通对话(Fast / 非思考模式):模型直接开始生成答案,每个 Token 都是最终输出的一部分。你可以理解为脱口而出的回答。
深度思考(Thinking / 推理模式):模型先输出一段内部推理过程,想完了再给结论。这段过程有时直接展示给你,有时被折叠起来,但只要它产生了,就一样计费。
深度思考现在大致有这么几种控制方式,深度也分档:
同一个问题,两种模式的差别集中在四件事上:
| 首字延迟 | 快,几乎立刻出字 | 明显变慢,等几秒到几十秒 |
| Token 消耗 | 只算答案 | 推理过程也计费,常常翻几倍 |
| 稳定性 | 直接,但可能漏步骤 | 多步任务正确率更高 |
| 出错方式 | 答得浅 | 可能想歪,推理链越长越容易跑偏 |
至于什么时候该用,我的判断标准是看任务有没有"中间步骤":
| 数学题、算法题、多步逻辑 | 用,中等强度起步 | 收益最明显 |
| 复杂代码调试、架构权衡 | 用 | 需要连贯的因果链 |
| 信息抽取、格式转换 | 别用 | 规则明确,想多了反而出错 |
| RAG 检索问答、摘要、翻译 | 别用 | 答案在材料里,靠归纳不靠推理 |
| 闲聊、简单改写 | 别用 | 纯烧钱 |
RAG(检索增强生成)的思路是先从知识库捞出相关片段,再让模型基于这些片段作答。它的核心工作是"读懂材料、说清楚",链式推理帮不上忙,还会拖慢响应、推高成本;更麻烦的是,推理链拉长之后,模型有可能偏离检索到的原文,开始自己编。
我踩过一个挺有意思的坑:有次让它算个两位数乘法,顺手开了最高档思考,结果它绕了一大圈,还差点算错。思考强度是预算,不是保险。
七、网页端 AI 和 API 调用,买的不是同一个东西
判断句:网页端和 API 背后往往是同一个模型,但你买到的东西完全不是一回事。
网页端是成品,API 是零件——这个差别决定了它俩各自适合什么活。
| 计费 | 订阅或免费,聊多少不影响钱包 | 按 Token 计费,输入输出都算钱 |
| 参数控制 | 基本没有,Temperature 被藏起来了 | 温度、思考强度、最大长度都能自己设 |
| 系统提示词 | 平台写死的,你改不了 | 完全由你掌控 |
| 上下文 | 平台可能自动截断历史 | 传多少是你的事,费用也归你 |
| 附加能力 | 自带联网、文件解析、画图、记忆 | 裸模型,检索和工具得自己接 |
| 数据流向 | 是否用于训练看平台条款 | 企业版通常可约定不用于训练 |
| 自动化 | 手动点 | 可批量、可嵌进产品、可进 CI |
我第一次把网页端用得很顺的提示词搬到 API 上,效果掉了一截,排查半天才反应过来:网页端的系统提示词里早就替我写好了一堆约束,API 那边是白纸一张,什么都得自己填。
所以怎么选很清楚:偶尔用用、试效果、做调研,网页端更省事;要进生产、要批量跑、要可复现、要私有化,只能走 API。 API 给你的不是更强的模型,是更多的控制权和更多的责任——费用、并发、提示词、数据合规,全都得自己扛。
八、2026 年国产主流大模型举例
截至 2026 年 10 月,国内第一梯队的旗舰基本形成了共识打法:MoE 架构 + 长上下文 + 开源权重。下面这张表是我整理的主流型号,具体参数以各家官方文档为准。
| DeepSeek V4 系列 | 深度求索 | MoE,Pro 版 1.6T 总参 / 49B 激活 | 1M | MIT 开源;2026-09 更新 V4.1 Flash |
| Kimi K3 | 月之暗面 | MoE,2.8T 总参 | 1M | 权重已开源 |
| Qwen3.8 系列 | 阿里 | MoE,Max 级约 2.4T 级参数 | 长上下文 | 多榜国产第一梯队 |
| GLM-5.3 系列 | 智谱 | MoE,Flash 版约 320B 总参 / 18B 激活 | 1M | 原生多模态 |
| 混元 Hy3 preview | 腾讯 | MoE,295B 总参 / 21B 激活 | 256K | 已开源 |
| LongCat-2.0 | 美团 | MoE,1.6T 总参 / 48B 激活 | 1M | 国产算力训练 |
说几个具体感受:
**长上下文已经是标配。**1M 这个词在 2026 年出现得越来越频繁,DeepSeek、Kimi、GLM 这几家都把百万级写进了宣传口径,腾讯混元 Hy3 和讯飞星火 X2-Flash 则停在 256K 一档。但如第二节所说,标称值和使用质量是两回事,上生产前自己压测一轮最稳。
MoE 是默认选项。上面这几家无一例外,全部是稀疏架构,激活参数普遍落在几十 B 的量级。这也意味着参数量这个指标越来越不适合拿来横向比强弱。
**开源是真开源。**DeepSeek 走 MIT,Kimi、GLM、混元都把权重放了出来,这对想私有化部署的团队是实打实的好事——至少你可以先下载下来跑通再说。
回到开头那个问题。大模型是什么?说到底它是一台用海量文本练出来的下一个 Token 预测机,Token、上下文窗口、Temperature、MoE 这些名词,描述的都是这台机器的某个零件怎么转。搞懂零件的代价并不高,但回报很直接——你不再需要听别人替你判断。
以 2026 年 10 月这个时间点看,选国产模型我建议先看激活参数和单价,再看上下文和榜单排名。总参数最唬人,也最不能用来横向比。
参考链接
- DeepSeek V4 预览版发布公告(搜:DeepSeek V4 preview)
- DeepSeek V4.1 Flash 发布说明
- Kimi K3 快速开始文档(搜:Kimi API 平台 文档)
- 腾讯混元 Hy3 preview 发布报道
- 美团 LongCat-2.0 发布报道
- 智谱 GLM 全栈体系研报摘要
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:搞懂大模型是什么这件事上,你被哪个名词绕得最久?


评论前必须登录!
注册