 网硕互联帮助中心
Go 1.25:容器感知 GOMAXPROCS,别再让 128 核拖死 2 核 Pod
Go 1.25 起,Linux 上默认会看 cgroup 的 CPU limit(对应 K8s 的 CPU limit,不看 request),并周期性刷新;手动设 GOMAXPROCS 或相关 GODEBUG 会关掉这套自动行为。
一、旧默认:按整机逻辑核开并行,limit 却只有 2
从 Go 1.5 到 1.24,GOMAXPROCS 的默认值大致等于机器上的逻辑 CPU 数(runtime.NumCPU 那条线)。这对「独占物理机 / 虚拟机」很合理:并行度对齐硬件,少一层多余的 OS 线程调度。
但放到 Kubernetes 一类编排里,事情会拧巴。集群节点可能是 64、128 逻辑核,而你的 Pod 只配了 cpu: "2" 的 limit。旧 runtime 不知道 cgroup 带宽上限,仍按 128 设定能同时跑用户代码的线程上限。结果,应用(以及 GC 一类 runtime 工作)很容易在短窗口里吃掉远超配额的 CPU,Linux CFS 就用硬限流把它按住。典型周期约 100ms,周期内直接暂停执行。官方博客 Container-aware GOMAXPROCS 把这种尾延迟伤害写得很直白。限流是钝刀子;把 GOMAXPROCS 调到接近 limit 则是软约束,两种疼法不一样。
再把两个模型分开记,后面排障会少绕路:
| GOMAXPROCS | 并行度上限:同时跑多少 goroutine(用户代码线程) | =8 时即便有 1000 个 runnable,也只开 8 路并行 |
| CPU limit | 吞吐上限:一段墙钟内可用的 CPU 时间 | 默认周期 100ms 时,「8 CPU」≈ 每 100ms 墙钟内 800ms CPU |
吞吐上限可以「8 线程跑满 100ms」,也可以「16 线程各跑 50ms」凑满同一笔配额;GOMAXPROCS 管的是并行度本身。旧默认把并行度拉到整机核数,再撞上很小的 limit,最容易触发硬限流。官方举的例子正是「128 核机器上只分到 2 CPU 的小容器」。
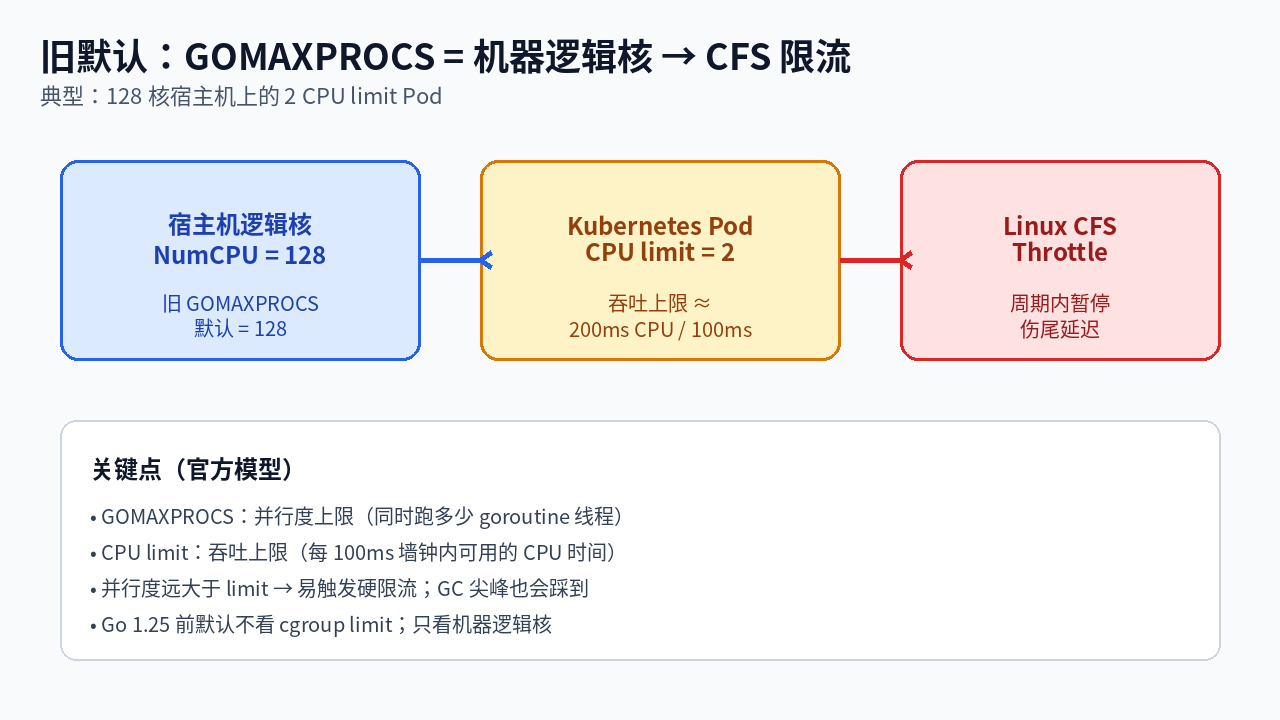
下文依据 Go 1.25 Release Notes、上述官方博客,以及 runtime.GOMAXPROCS / SetDefaultGOMAXPROCS 文档。文中不给压测数字,也不会把「必须给所有容器设 limit」说成官方结论:博客对 limit 的利弊持中立态度。
二、Go 1.25 改了什么:看 limit、会刷新、可关闭
发布说明 · Container-aware GOMAXPROCS 把行为收成两条主线:
两条都会在你「手动接管」时自动关掉:设置了 GOMAXPROCS 环境变量,或调用了 runtime.GOMAXPROCS。也可以用 GODEBUG 精细关:
- GODEBUG=containermaxprocs=0:关掉「按 cgroup limit 定默认」;
- GODEBUG=updatemaxprocs=0:关掉「周期性更新」。
为了能读到更新后的 limit,runtime 会在进程生命周期内缓存相关 cgroup 文件的 FD。这是实现细节,但能解释它为什么敢周期性重算。
runtime 包文档把默认值的输入写得更全:逻辑 CPU 数、进程 CPU affinity 掩码,以及 Linux 上 cgroup 的平均 CPU 吞吐上限(v2 读 cpu.max,v1 读 cfs_quota_us / cfs_period_us)。选取时通常取这些值的较低者,但有两条硬规则值得背进 checklist:
- 分数 limit 向上取整(GOMAXPROCS 必须是正整数,向上取才能吃满配额);
- 默认从不把 GOMAXPROCS 设到小于 2,除非逻辑 CPU 数或 affinity 计数本身就小于 2。
更新频率方面,文档写的是最多大约每秒一次,应用空闲时更少。语言版本 ≤1.24 时,containermaxprocs=0 与 updatemaxprocs=0 是兼容默认。所以光把工具链升到 1.25、go 行还留在旧语言版本,行为可能仍偏旧。要吃新默认,记得让模块的 Go 版本跟上(发布说明与博客的表述是:把 go.mod 里的版本设到 1.25.0 或更高即可启用新默认)。
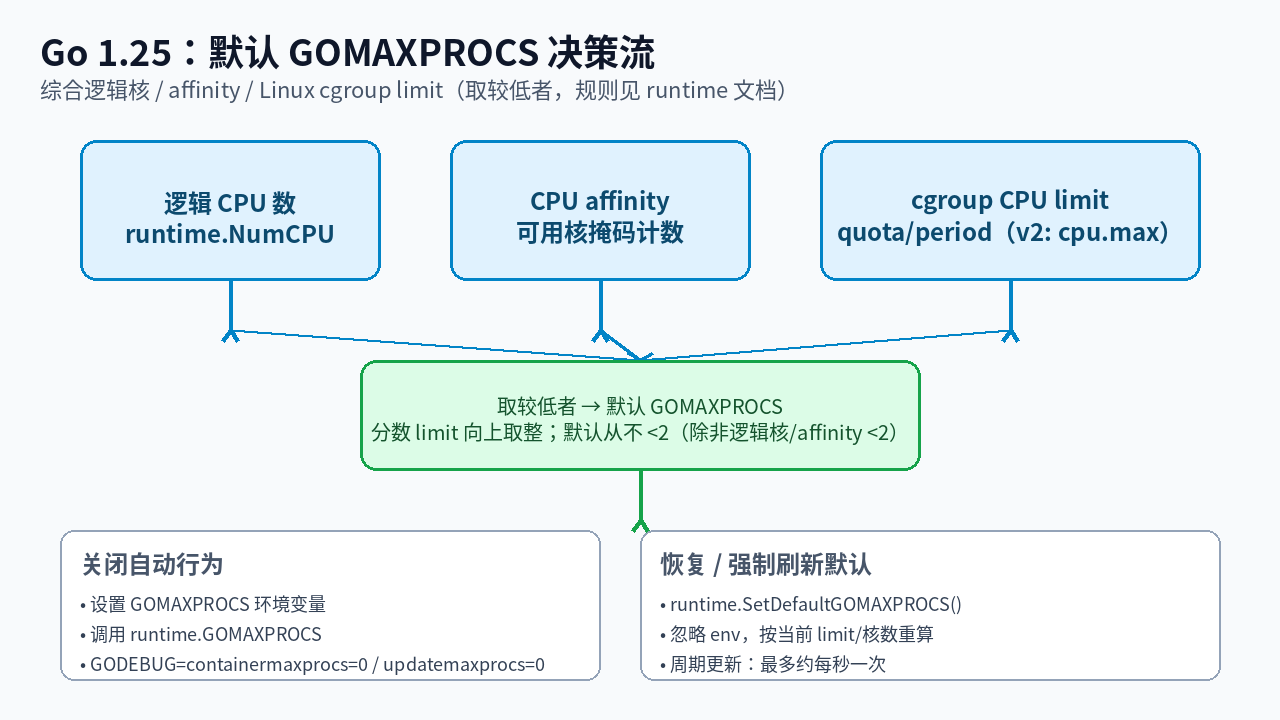
社区里很多人早就用 Uber 的 go.uber.org/automaxprocs 做类似事。官方博客结尾致谢了 automaxprocs 维护者的反馈。现在标准库把「容器感知默认」收进了 runtime,新服务可以少引一个依赖;老服务若仍手动设 GOMAXPROCS,自动路径不会抢戏。
三、代码侧:读当前值、恢复默认、和 env 的关系
下面这段可以粘进排查小工具或启动日志,用来确认「进程以为自己有多少并行度」。它不依赖 K8s API,只问 runtime:
package main
import (
"fmt"
"runtime"
)
func main() {
// n < 1 时只查询、不修改
cur := runtime.GOMAXPROCS(0)
fmt.Printf("GOMAXPROCS=%d NumCPU=%d\\n", cur, runtime.NumCPU())
// 若启动脚本曾 export GOMAXPROCS=…,或某处调用过 runtime.GOMAXPROCS(n),
// 容器感知默认与周期性更新会被关闭。
// 需要重新按「当前 limit / 核数 / affinity」启用默认时:
runtime.SetDefaultGOMAXPROCS()
fmt.Printf("after SetDefaultGOMAXPROCS: %d\\n", runtime.GOMAXPROCS(0))
}
SetDefaultGOMAXPROCS(Go 1.25.0 起)的语义是:把设置恢复成 runtime 默认算法,并且忽略环境变量里的 GOMAXPROCS。文档还点明两个用途:一是自动行为被 env 或先前的 GOMAXPROCS 调用关掉后,重新打开;二是你确信 limit / affinity / 逻辑核已变,想立刻刷一次,不必干等下一轮周期更新。
实操上建议区分三层「谁说了算」:
排查「升到 1.25 了怎么还是整机核数」时,按这个顺序看:语言版本是否 ≥1.25、有没有 env、有没有第三方库在 init 里调 GOMAXPROCS、cgroup 里到底有没有 limit。只有 request、没有 limit 时,runtime 不会拿 request 去压并行度;官方写得很明确,按 request 设会妨碍吃闲置核。
四、和 CPU request、是否设 limit、GOMEMLIMIT 的边界
只配 request、不配 limit 在集群里很常见:为的是闲时能借别人没用完的 CPU。也正因为如此,Go 不能根据 request 自动设 GOMAXPROCS;否则默认就把你锁在「保证最小值」上,闲置容量吃不到。博客同时提醒:超出 request 后,在机器忙时仍会有权重类约束,高 GOMAXPROCS 的尖峰仍可能难受,只是机制比 CFS 硬限流「软」一些。
「那是不是所有容器都该设 CPU limit?」官方没有替你拍板。limit 有利于可预测延迟和自动对齐 GOMAXPROCS;不设 limit 有利于吃闲置、抬高利用率。更值得优先处理的是 mismatch 很大 的场景:例如 128 核节点上只拿到约 2 CPU 有效算力的小规格。这时设明确 limit,或显式设 GOMAXPROCS,都比放任旧默认更稳妥。
另外划清内存线:容器感知只管 CPU 侧的 GOMAXPROCS,不管内存。 GOMEMLIMIT 仍是独立旋钮(环境变量或 debug.SetMemoryLimit),文中也不把它和 cgroup memory limit 当成自动绑定;标准库也没有在 1.25 里宣称「自动读 memory limit 并设 GOMEMLIMIT」。需要软内存上限时,继续显式配置。
若你还在对比实验性 GC:发布说明里的 Green Tea GC(GOEXPERIMENT=greenteagc)是另一条线,和并行度默认无关,这里不展开。
还有一种「看起来升了 1.25、行为却像旧版」的情况,往往是几件事叠在一起:镜像里的 go 工具链已经是 1.25,但构建时 GOTOOLCHAIN、多阶段 Dockerfile 的 builder 标签、或私有代理缓存仍拉到旧编译器;再叠加入口脚本里历史遗留的 export GOMAXPROCS=$(nproc),自动容器感知会被立刻关掉。发布窗口建议把「二进制实际 runtime.Version()」「启动时 GOMAXPROCS(0)」「cgroup 中的 quota/period(或 v2 的 cpu.max)」三条打在同一行日志里,比只看 go.mod 更不容易误判。
若平台组统一用 DaemonSet / 节点 agent 动态改 Pod limit,记得 1.25 的周期性更新最多大约每秒一次:短暂抖动一般会被抹平,但「从 8 限到 2 再瞬间拉回」这类运维动作,业务侧仍应按配额变化做排水或重载,别指望 runtime 在毫秒级完成收敛。反过来,limit 稳定时几乎不用自己写 watch 循环去调 GOMAXPROCS,这类样板代码正是新默认想省掉的。
五、迁移与值班清单(可贴进发布说明)
和「在代码里写死 runtime.GOMAXPROCS(2)」相比,让 1.25 默认跟着 limit 走更适合「同一镜像、多规格部署」:测试环境 1 CPU、预发 2 CPU、生产 4 CPU 时,不必为每个环境各打一套入口脚本。反过来,若你有意让并行度低于 limit(例如给同容器里的 sidecar 或 CGO 线程留余量),继续显式设置仍是正确做法。自动默认兜的是「完全没人管」的情况,手工调参照样有它的位置。
Go 1.25 让默认 GOMAXPROCS 在 Linux 上对齐 cgroup CPU limit,并会跟着配额变;它只看 limit、不看 request,手动设置会退出自动,恢复用 SetDefaultGOMAXPROCS。 小规格跑在大节点上时,这比继续假装自己有 128 核安全得多。


评论前必须登录!
注册