 网硕互联帮助中心
收尾用户态缓冲区、新开磁盘块:一章打通软硬件的 Linux 文件系统
章节主线:本章节没有停留在“怎么写代码”,而是一次从代码到系统、从系统到硬件、再从硬件回归文件系统的视角拉通。重点可以归纳为三大块:
Part 1:用户态缓冲区的真相——为什么 fwrite 不等于 write?
1.1 文件描述符与进程:操作系统打开文件,本质是为进程打开
老师先带我们回顾了一个根本问题:是谁让操作系统打开文件的?
答案是进程。我们在代码里写 fopen,程序运行到这一句时,操作系统才会真正去打开文件。操作系统为每个打开的文件创建一个内核对象 struct file,里面存着标志位、读写位置、内核级缓冲区等;而进程内部通过 task_struct 里的 files_struct 指针,维护一张文件描述符表(一个指针数组)。
我们平时拿到的 fd(文件描述符)本质上就是这张数组的下标。只要拿到下标,内核就能通过系统调用快速索引到对应的 struct file,进而操作文件。
1.2 库函数 vs 系统调用:C 标准库是操作系统提供的“二手接口”
老师特别强调了一组关系:fopen/fwrite/fclose 是 C 库函数,而 open/write/close 是 系统调用。操作系统只认系统调用,C 语言只是在用户层做了一层封装。
比如 fopen 的 "w"、"a" 模式,底层其实是通过位图宏选项(O_CREAT | O_WRONLY | O_TRUNC 或 O_APPEND)组合调用 open 实现的。标准输入/输出/错误(stdin/stdout/stderr)在 C 层被封装成了 FILE* 结构体,而在系统层面对应的就是固定的 fd = 0/1/2。
1.3 重定向的本质:fd 下标里的“偷梁换柱”
很多同学对重定向感到神秘,老师用一句话就戳破了:重定向的本质是“在内核层面复制文件描述符下标的内容”。
比如你先把一个新文件打开,得到了 fd = 3;然后把下标 3 里的指针内容拷贝到下标 1(stdout)里。从此以后,所有往 1 号 fd 写的数据,都流向了新文件,而进程完全感知不到变化。这就是输出重定向。输入重定向、追加重定向同理,区别只在于打开目标文件时用的标志位(是否 O_APPEND)。
补充细节:文件描述符分配遵循**“最小未使用下标”**原则。默认 0/1/2 已被占用,再打开新文件就从 3 开始;如果手动 close 了 1,再打开新文件时,系统就会把这个新文件分配进下标 1,从而实现一种“间接重定向”。
1.4 “一切皆文件”:C 语言层面的多态
老师从源码层面解释了一个操作系统的设计智慧。struct file 内部有一组函数指针,指向底层不同设备的读写方法。磁盘有磁盘的读写、键盘有键盘的读写、网卡有网卡的读写——接口实现完全不同,但对上暴露的接口签名都是 read/write。
进程通过文件描述符看到一个 struct file 时,它只看到统一的读写接口。操作系统用 C 语言的函数指针实现了“多态”,把进程“骗”住了,让进程以为所有东西都是文件。这就是“一切皆文件”在源码层面的落脚点。
1.5 缓冲区的双重实验:为什么数据会“打印两次”?
这是课堂上最经典的**“灵魂实验”**,用来区分用户级缓冲区与内核级缓冲区。
实验代码逻辑大致如下:
printf("hello\\n"); // C 库函数
fprintf(stdout, "world\\n");
write(1, "!", 1); // 系统调用
fork();
当这段代码向显示器打印时,我们看到 3 条消息;但当你把它重定向到文件时,你会发现 C 库函数的输出变成了两份,而 write 的输出只有一份。
老师的解释非常细腻:
- write 是系统调用,直接把数据写进内核级缓冲区,不涉及用户级缓冲区。
- printf/fprintf 先把数据写进了 C 标准库维护的用户级缓冲区。
- 向显示器输出时,刷新策略是行缓冲(遇到 \\n 就刷),所以 fork 之前数据已进内核,子进程不会重复打印。
- 重定向到文件时,刷新策略自动升级为全缓冲!数据一直留在用户级缓冲区里。一旦 fork(),父子进程各自拥有这份缓冲区的副本,结束时双双刷新,于是就打印了两次。
这个实验“一行代码考穿所有概念”:C 库函数维护的是用户级缓冲区,write 直接进内核;刷新策略(核心)决定了数据何时离开用户空间。
1.6 手写一个 my_file:缓冲区不再神秘
为了验证理论,老师带着我们手写了一个极简版 C 标准 IO 库。重点不是工程完备,而是看清缓冲区的运作机理。
核心结构体(对应课堂上的 my_file):
#define MAX_BUFFER 1024
typedef struct {
int fd; // 文件描述符
int flag; // 标志位 r/w
char buffer[MAX_BUFFER];// 用户级缓冲区
int size; // 当前缓冲区有效长度
int flush_method; // 刷新策略:行缓冲/全缓冲/无缓冲
} my_file;
关键函数逻辑:
- my_fopen:底层调用 open 获取 fd,malloc 一个 my_file 对象返回给上层。
- my_fwrite:不是直接 write! 而是把用户数据 memcpy 进 my_file->buffer,更新 size。只有当触发刷新条件时(比如行缓冲遇到了 \\n,或者缓冲区满了),才一次性调用系统 write 把数据刷入内核。
- my_fclose:关闭前强制刷新剩余数据,然后调用系统 close 并释放对象。
- my_fflush:把缓冲区里攒的数据一次性 write 进去,然后清空 size。
课堂实验现象:
老师特意写了一个不带 \\n 的字符串,循环写入 10 秒,最后才调 my_fclose。
const char* msg = "hello world!!!!"; // 故意不带 \\n
for(int i = 0; i < 20; i++) {
my_fwrite(fp, msg, strlen(msg));
sleep(1);
}
my_fclose(fp);
运行的时候观察日志文件:前十几秒文件大小始终是 0!因为缓冲区一直没有满足“行缓冲”条件,数据全攒在用户态。直到进程结束调用 my_fclose 强制刷新,文件一瞬间被写入了全部内容。
如果中途调用 my_fflush,就能肉眼看到数据被一段段刷进文件。这个实验把“缓冲区减少系统调用”的意义彻底坐实了。
1.7 为什么需要用户级缓冲区?——快递箱与内存池
老师用了两个生活类比解释缓冲区的意义:
第二个意义是格式化支持。printf 的格式化输出需要先暂存中间结果,缓冲区就是用来保存这些格式化后的字符串,再统一刷新的。
1.8 强制刷盘:fflush、fsync 与数据库“落盘”
这里有一个极容易被混淆的细节:
- fflush(C 库函数):只把数据从用户级缓冲区刷到内核级缓冲区。
- fsync(系统调用):强制要求操作系统把内核级缓冲区的数据同步到物理外设(磁盘),俗称**“落盘”**。
老师举了一个数据库的场景:MySQL、Redis 这类数据库本质上也是一个进程,它们的数据最终都存在磁盘文件里。当数据提交或需要持久化时,数据库进程先把数据写进内核缓冲区,然后调用 fsync 确保数据真正写到磁盘上。否则如果此时断电,只在内核里的数据还是会丢失。
零碎知识点:Linux 下还有一个 sync 命令,会把当前系统里所有缓存数据一次性刷到外设。
Part 2:磁盘的物理世界——从盘片、磁头到 CHS 三维寻址
2.1 磁盘:计算机里唯一的“机械设备”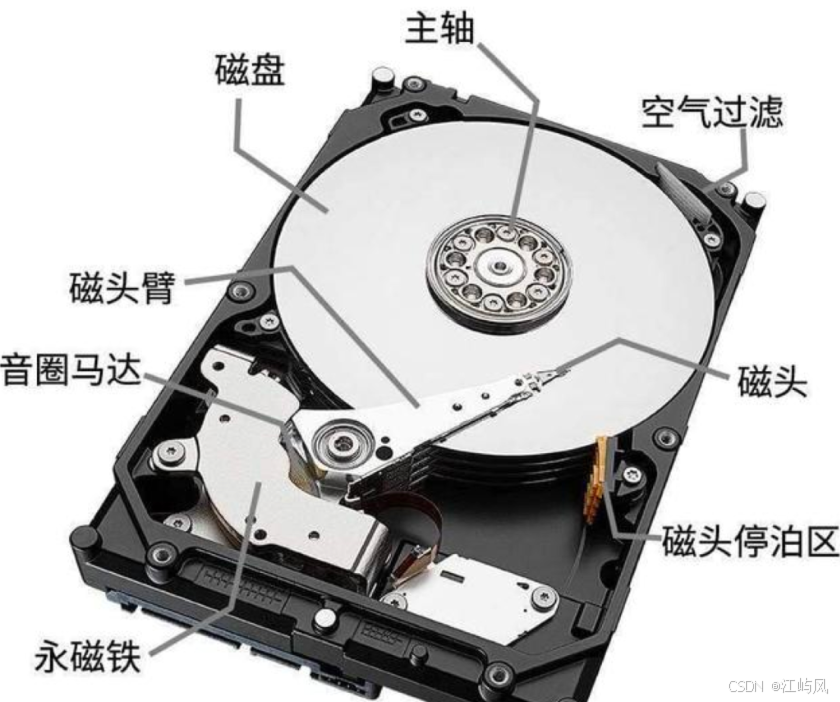
老师提醒我们一个事实:电子计算机里,磁盘(这里指机械硬盘)几乎是唯一的机械设备。它容量极大、价格极便宜(同价位下内存可能只能买 16G,磁盘能买几 T),但也正是因为它是机械设备,速度比内存慢得多。
磁盘在企业后端存储海量数据时仍是主流。我国固态硬盘技术不错,但传统机械磁盘技术仍与国外有差距。磁盘按用途可分为企业级(高转速、高精准、高价格)和桌面级(消费级)。
2.2 磁道、扇区与柱面:磁头为什么要“共进退”
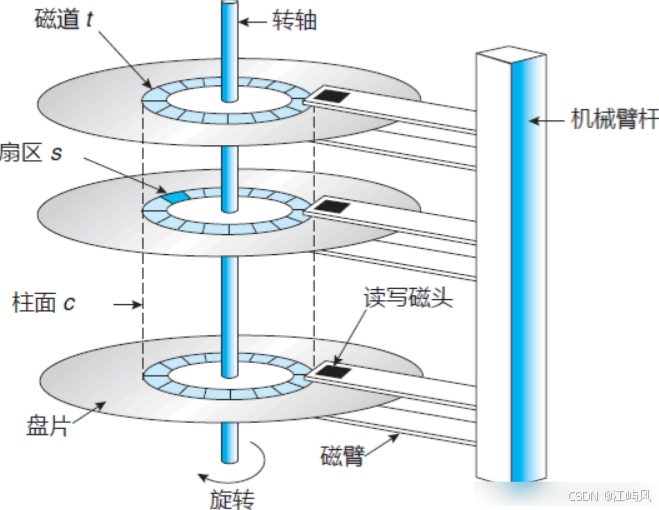
磁盘的物理结构拆解:
- 盘片(Platter):像光盘一样光滑的圆盘,一个磁盘里有多个盘片(比如 3 片),每片正反两面都能存数据。
- 主轴与马达:带动盘片高速旋转,企业级可达每分钟上万转。
- 磁头(Head)与摆臂:磁头在摆臂带动下沿半径方向来回摆动,寻找数据。
存储单元:
- 磁道(Track):盘片上一圈圈同心圆。
- 扇区(Sector):磁道被切分成的一小段,传统大小为 512 字节,是磁盘读写的最小物理单位。
- 柱面(Cylinder):所有盘片上半径相同的磁道,在三维空间里共同构成一个“圆柱面”。由于多个磁头固定在同一个摆臂上,它们共进退——往里走时所有磁头一起往里,往外走时一起往外。所以当定位到一个柱面时,实际上所有盘片的同一半径磁道都已经同时就绪。
零碎知识点:磁头与盘片之间是“飞行”状态,磁盘内部接近真空,密封性是军工级。一旦拆开,磁盘基本报废(普通人意义上的报废)。
2.3 CHS 寻址:把磁盘看成三维数组
既然定位一个扇区需要确定:
这不就是三维数组的三个下标吗?于是早期磁盘用 CHS(Cylinder, Head, Sector)来定位物理地址。
为什么磁盘要这样运动?磁头摆动是为了找磁道/柱面;盘片旋转是为了在磁道内找具体的扇区。如果高速旋转下错过了目标扇区,只能等下一圈——这也是企业级磁盘强调“精准度”的原因。
2.4 企业级 vs 桌面级:转速、摆臂与“错过等下一圈”
这里老师补充了一个行业常识:
- 企业级磁盘:磁头臂摆动频率高、盘片转速高、定位精准。读一遍就能锁定扇区,效率高,贵。
- 桌面级磁盘:转速慢、摆臂慢,可能需要旋转多圈、多次确认才能定位到扇区。便宜。
2.5 磁盘容量怎么算?
虽然现代操作系统不再直接用 CHS,但这个公式能帮你理解磁盘的物理极限:
磁盘容量 = 磁头数 × 磁道数 × 每磁道扇区数 × 512 字节
为什么外部磁道的扇区看起来“更宽”,但容量仍一样?因为现代磁盘通过不同的比特位疏密程度来保证每个扇区都是 512 字节(传统)。当然,先进磁盘也可以做到外部扇区存更多数据,但课堂上作为基础我们不展开。
零碎知识点:CHS 模式支持的容量有限,老式寻址上限约 8.4GB。现代磁盘虽然内部仍用 CHS 物理寻址,但对外已向操作系统隐藏了这些细节。
Part 3:从物理到逻辑——磁带的启示与 LBA 线性抽象
3.1 磁带类比:卷起来是同心圆,拉直就是线性数组
为了让我们理解“抽象”的威力,老师举了一个极具年代感的例子——磁带。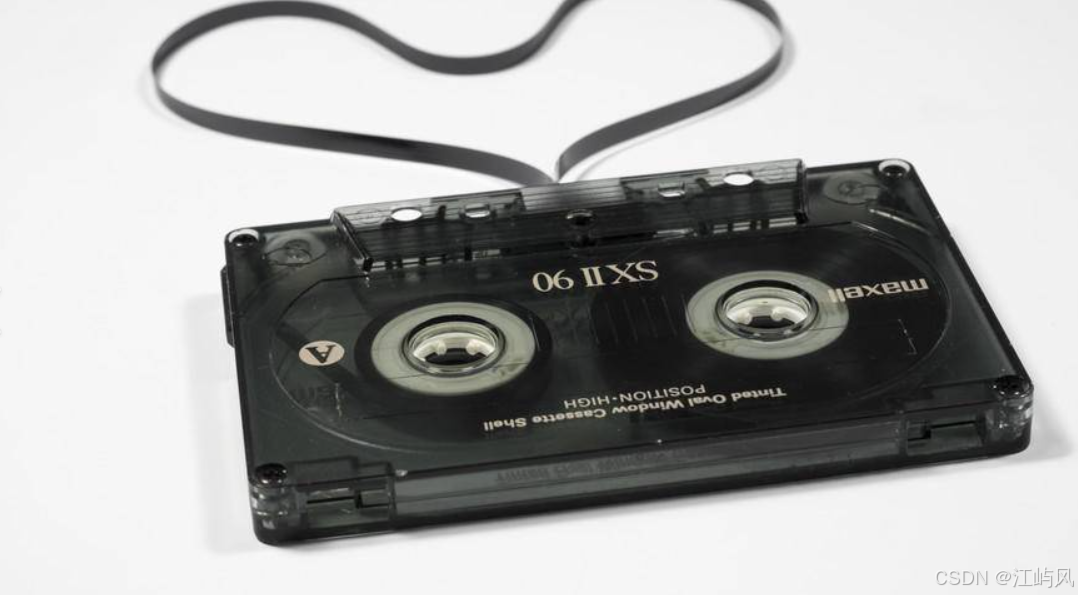
磁带卷起来时,它是一圈圈同心圆;但小时候如果手贱把磁带拉出来,它就变成了一条线性结构,从村东头拉到村西头。
磁盘的盘面同理。虽然盘片是圆的,但我们可以从逻辑上把每一面“剪开拉直”,看成一根线;多面磁盘就是多根线拼在一起。从这一刻起,操作系统管理磁盘的方式从“管理一个三维机械结构”变成了“管理一个一维数组”。
3.2 LBA:操作系统管理磁盘的“黑盒接口”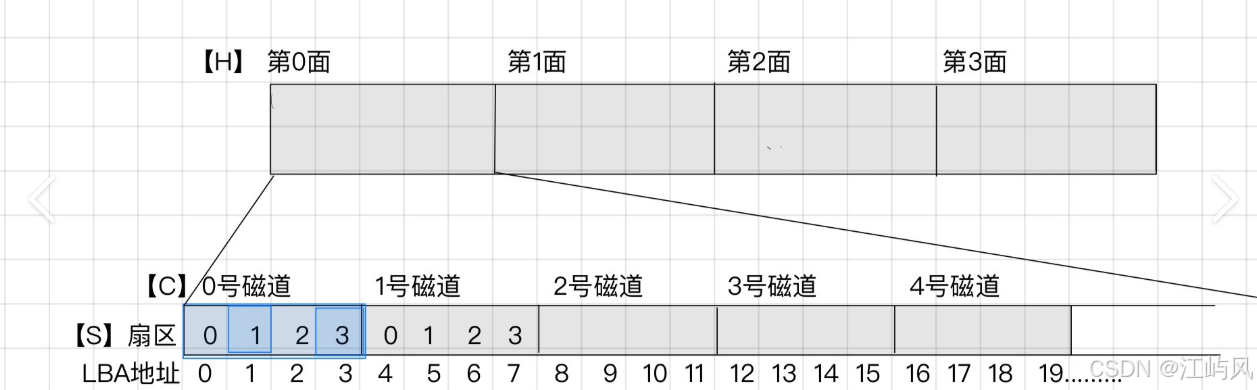
把这个线性结构里的每个扇区编上号,就得到了逻辑块地址(LBA, Logical Block Address)。LBA 从 0 开始连续递增。
操作系统从此不需要知道:
- 磁盘有几张盘片;
- 有几个磁头;
- 磁头在哪一个柱面上。
它只需要知道两个数字:磁盘总容量和每个扇区大小(512 字节)。一除就知道总共有多少个扇区,也就拥有了整个 LBA 地址空间。
零碎知识点:扇区编号通常从 1 开始,而柱面和磁头编号从 0 开始。你常听到的“0 号柱面、0 号磁头、1 号扇区”就是这么来的。
3.3 CHS 与 LBA 的互转:一维下标与三维数组的数学游戏
这是硬件与操作系统的交接处。虽然 OS 只认 LBA,但磁盘固件内部必须能把 LBA 转回 CHS 去驱动机械结构。老师给出了互转的核心思路:
CHS → LBA:
LBA = C × (磁头数 × 每磁道扇区数) + H × 每磁道扇区数 + (S – 1)
(注:因为扇区号 S 从 1 开始,而 LBA 从 0 开始,所以要减 1)
LBA → CHS:
C = LBA // (磁头数 × 每磁道扇区数) // 整除得柱面号
H = (LBA % (磁头数 × 每磁道扇区数)) // 每磁道扇区数 // 得磁头号
S = (LBA % 每磁道扇区数) + 1 // 取余再加1得扇区号
老师用三维数组下标转换来类比:以前学 C 语言,二维数组物理上也是线性存储的;磁盘的多维结构同理,最终都可以拍平成一维。固件负责做这个转换,对操作系统完全透明。
Part 4:文件系统的块管理——从分区到 inode
4.1 块设备与字符设备:随机访问 vs 顺序流淌
操作系统把外设分为两类:
- 块设备(如磁盘):支持随机访问,以“块”为单位读写;
- 字符设备(如键盘、鼠标):支持顺序访问,以字符/字节为单位逐个读取。你可以乱序读磁盘,但不能乱序读键盘——你先按了 A 再按 B,程序不可能先读到 B 再读到 A。
4.2 4KB 块:为什么操作系统不认扇区,只认“块”?
虽然磁盘的最小物理单位是 512 字节扇区,但操作系统觉得一次读 512 字节效率太低。于是引入了一个软件层面的概念——块(Block),大小通常为 4KB,即连续 8 个扇区。
为什么选 4KB?这是大量工程实践的结果,类似于“计算机里很多值都是科学家和工程师试出来的”。一次 IO 读 8 个扇区,可以显著提升吞吐量。
地址转换:
块号 = LBA / 8
块内偏移 = LBA % 8
从此以后,文件系统对磁盘空间的管理,本质上就变成了对“块”的管理——哪个块被占用了,哪个块还空着。
4.3 分区与块组:管理 800GB 磁盘的国家治理术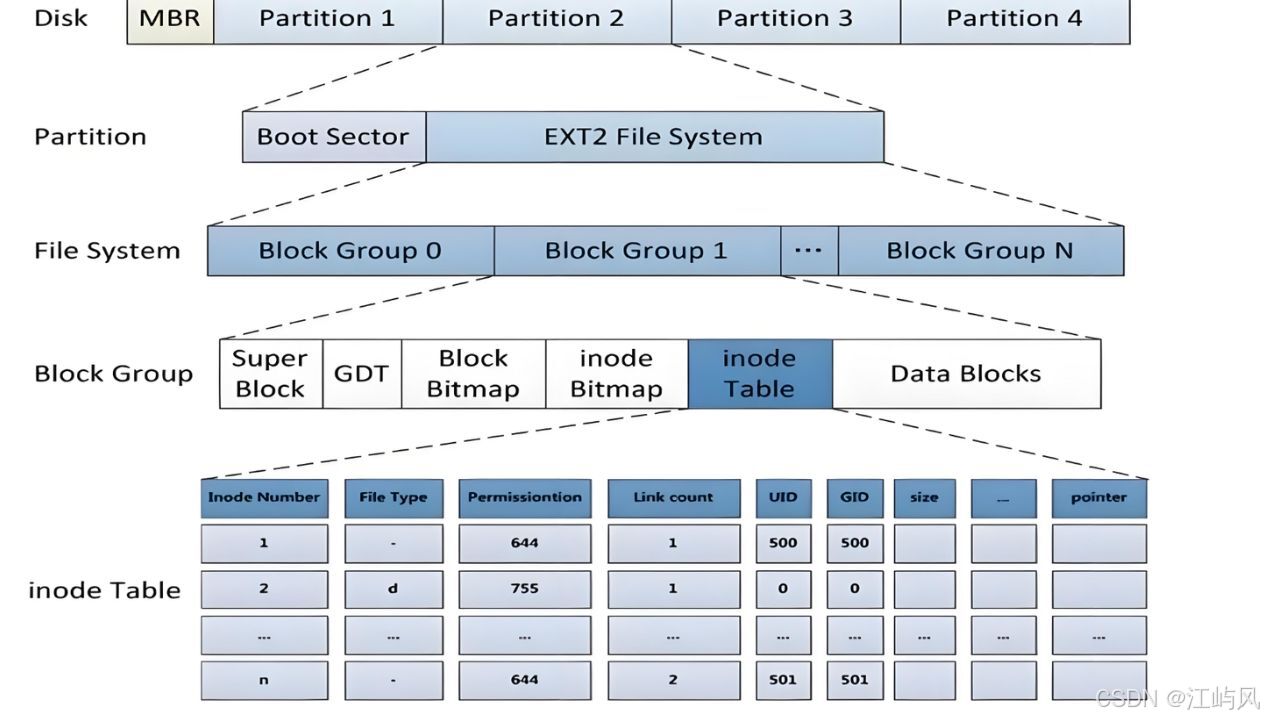
一个磁盘动辄几百 GB 甚至 TB,如果让文件系统直接管理整个磁盘,复杂度太高。老师的类比非常形象:
管理 960 万平方公里的土地不能直接由中央管到底,要分省、分市、分县。
分区(Partition):把磁盘划分为若干独立逻辑区域(比如你的 C 盘、D 盘、E 盘,本质上就是一块物理磁盘的几个分区)。分区表记录每个分区的起始块号和结束块号。
块组(Block Group):在每个分区内再进行细分。比如 300GB 的分区再切成 10 个 30GB 的块组。我们只要设计出一套管理好“一个块组”的方案,Ctrl+C / Ctrl+V 就能管理好整个分区乃至整块磁盘。
零碎知识点:Windows 里的 C 盘、D 盘并不是真的有三块磁盘,而是操作系统“欺骗”了你——那只是一块磁盘上的不同分区。
这种思想叫做分而治之。
4.4 Linux 文件系统的核心设计:内容与属性分离
进入 Linux 文件系统(以 ext2(Second Extended File System)是 Linux 系统中一种经典的文件系统) 为原型),有一个贯穿始终的设计理念:
文件 = 内容 + 属性,但内容和属性在磁盘上是分开存储的。
在一个块组内部,空间被进一步划分:
- Data Blocks(数据块区):由无数个 4KB 小块组成,存放文件的实际内容。如果你的文件有 16KB,就占 4 个数据块;17KB 就占 5 个(最后一个块只用到 1KB)。
- Inode Table(inode 表):存放文件的属性。每个文件都有一个固定大小的属性结构体(通常为 128 字节),里面记录了文件大小、权限、时间戳、类型、引用计数等。这个结构体被称为 inode(index node)。
关键理解:
- 数据块里存的是“你写的字符串、图片二进制、代码文本”等内容数据;
- inode 表里存的是“这个文件是谁、多大、能不能读、什么时候改的”等元数据(描述数据的数据);
- 文件系统通过 inode 去索引它对应的数据块,把属性和内容关联起来。
零碎知识点:内存中的 struct file 里就包含指向 inode 和内核级缓冲区的指针,这是打开文件后内核维护的内存态副本;而磁盘上的 inode 是持久化存储的属性本体。
结语:没被打开的文件在哪里?
最动人的收尾,用菜鸟驿站做一次宏观总结:
- 被打开的文件,就像已经被你拿到手的快递——你可以随时读写它,操作系统通过 struct file 和文件描述符表把它管理在内存里;
- 而绝大多数文件其实并没有被打开,它们静静地躺在磁盘上,像驿站仓库里堆积的包裹。
文件系统的终极使命就是:在几十万个未被打开的“包裹”中,通过路径(绝对路径/相对路径)这种树状结构,精准、快速地找到你要的那一个,等你下达 open 指令时,把它从磁盘加载进内存,变成被打开的文件。
从用户态的 my_file 缓冲区,到磁盘的 CHS 三维寻址,再到 LBA 线性抽象,最后落地到 4KB 块、分区、块组、inode 与数据块的分离存储——这一整条链路,正是操作系统在“效率”与“复杂度”之间反复权衡的艺术。
课后思考题(来自章节彩蛋):
问题:
精炼解答:
为什么 printf 重定向到文件后遇到 fork 会打印两次,而 write 不会?
- printf 走的是 C 库的用户级缓冲区。重定向到文件时刷新策略从行缓冲升级为全缓冲,数据一直攒在用户态;fork 后父子进程各持一份缓冲区副本,结束时双双刷新,所以打印两次。
- write 是系统调用,直接进内核级缓冲区,不经过用户级缓冲区,fork 时没有副本可复制,所以只打印一次。
操作系统只认 LBA,磁盘固件如何驱动磁头找到“块号 3”对应的扇区?
- 固件把 LBA 通过公式换算回 CHS 三维地址:C = LBA // (磁头数 × 每磁道扇区数)、H = (LBA % (磁头数 × 每磁道扇区数)) // 每磁道扇区数、S = (LBA % 每磁道扇区数) + 1。
- 然后摆臂伸缩定位到对应柱面,选择对应磁头,等盘片旋转到目标扇区下方完成读写。这个转换对操作系统完全透明。
为什么分区后,管理难度从“管理 800GB”降到“管理 30GB”?
- 这是分而治之的思想。只要设计出一套管理好一个块组(如 30GB)的方案,就能通过复制这套方案管理整个分区乃至整块磁盘,把复杂的大问题拆解成可复用的小问题,大幅降低管理复杂度。


评论前必须登录!
注册