 网硕互联帮助中心
高并发场景下大模型服务的显存监控:防范长上下文请求引发 OOM
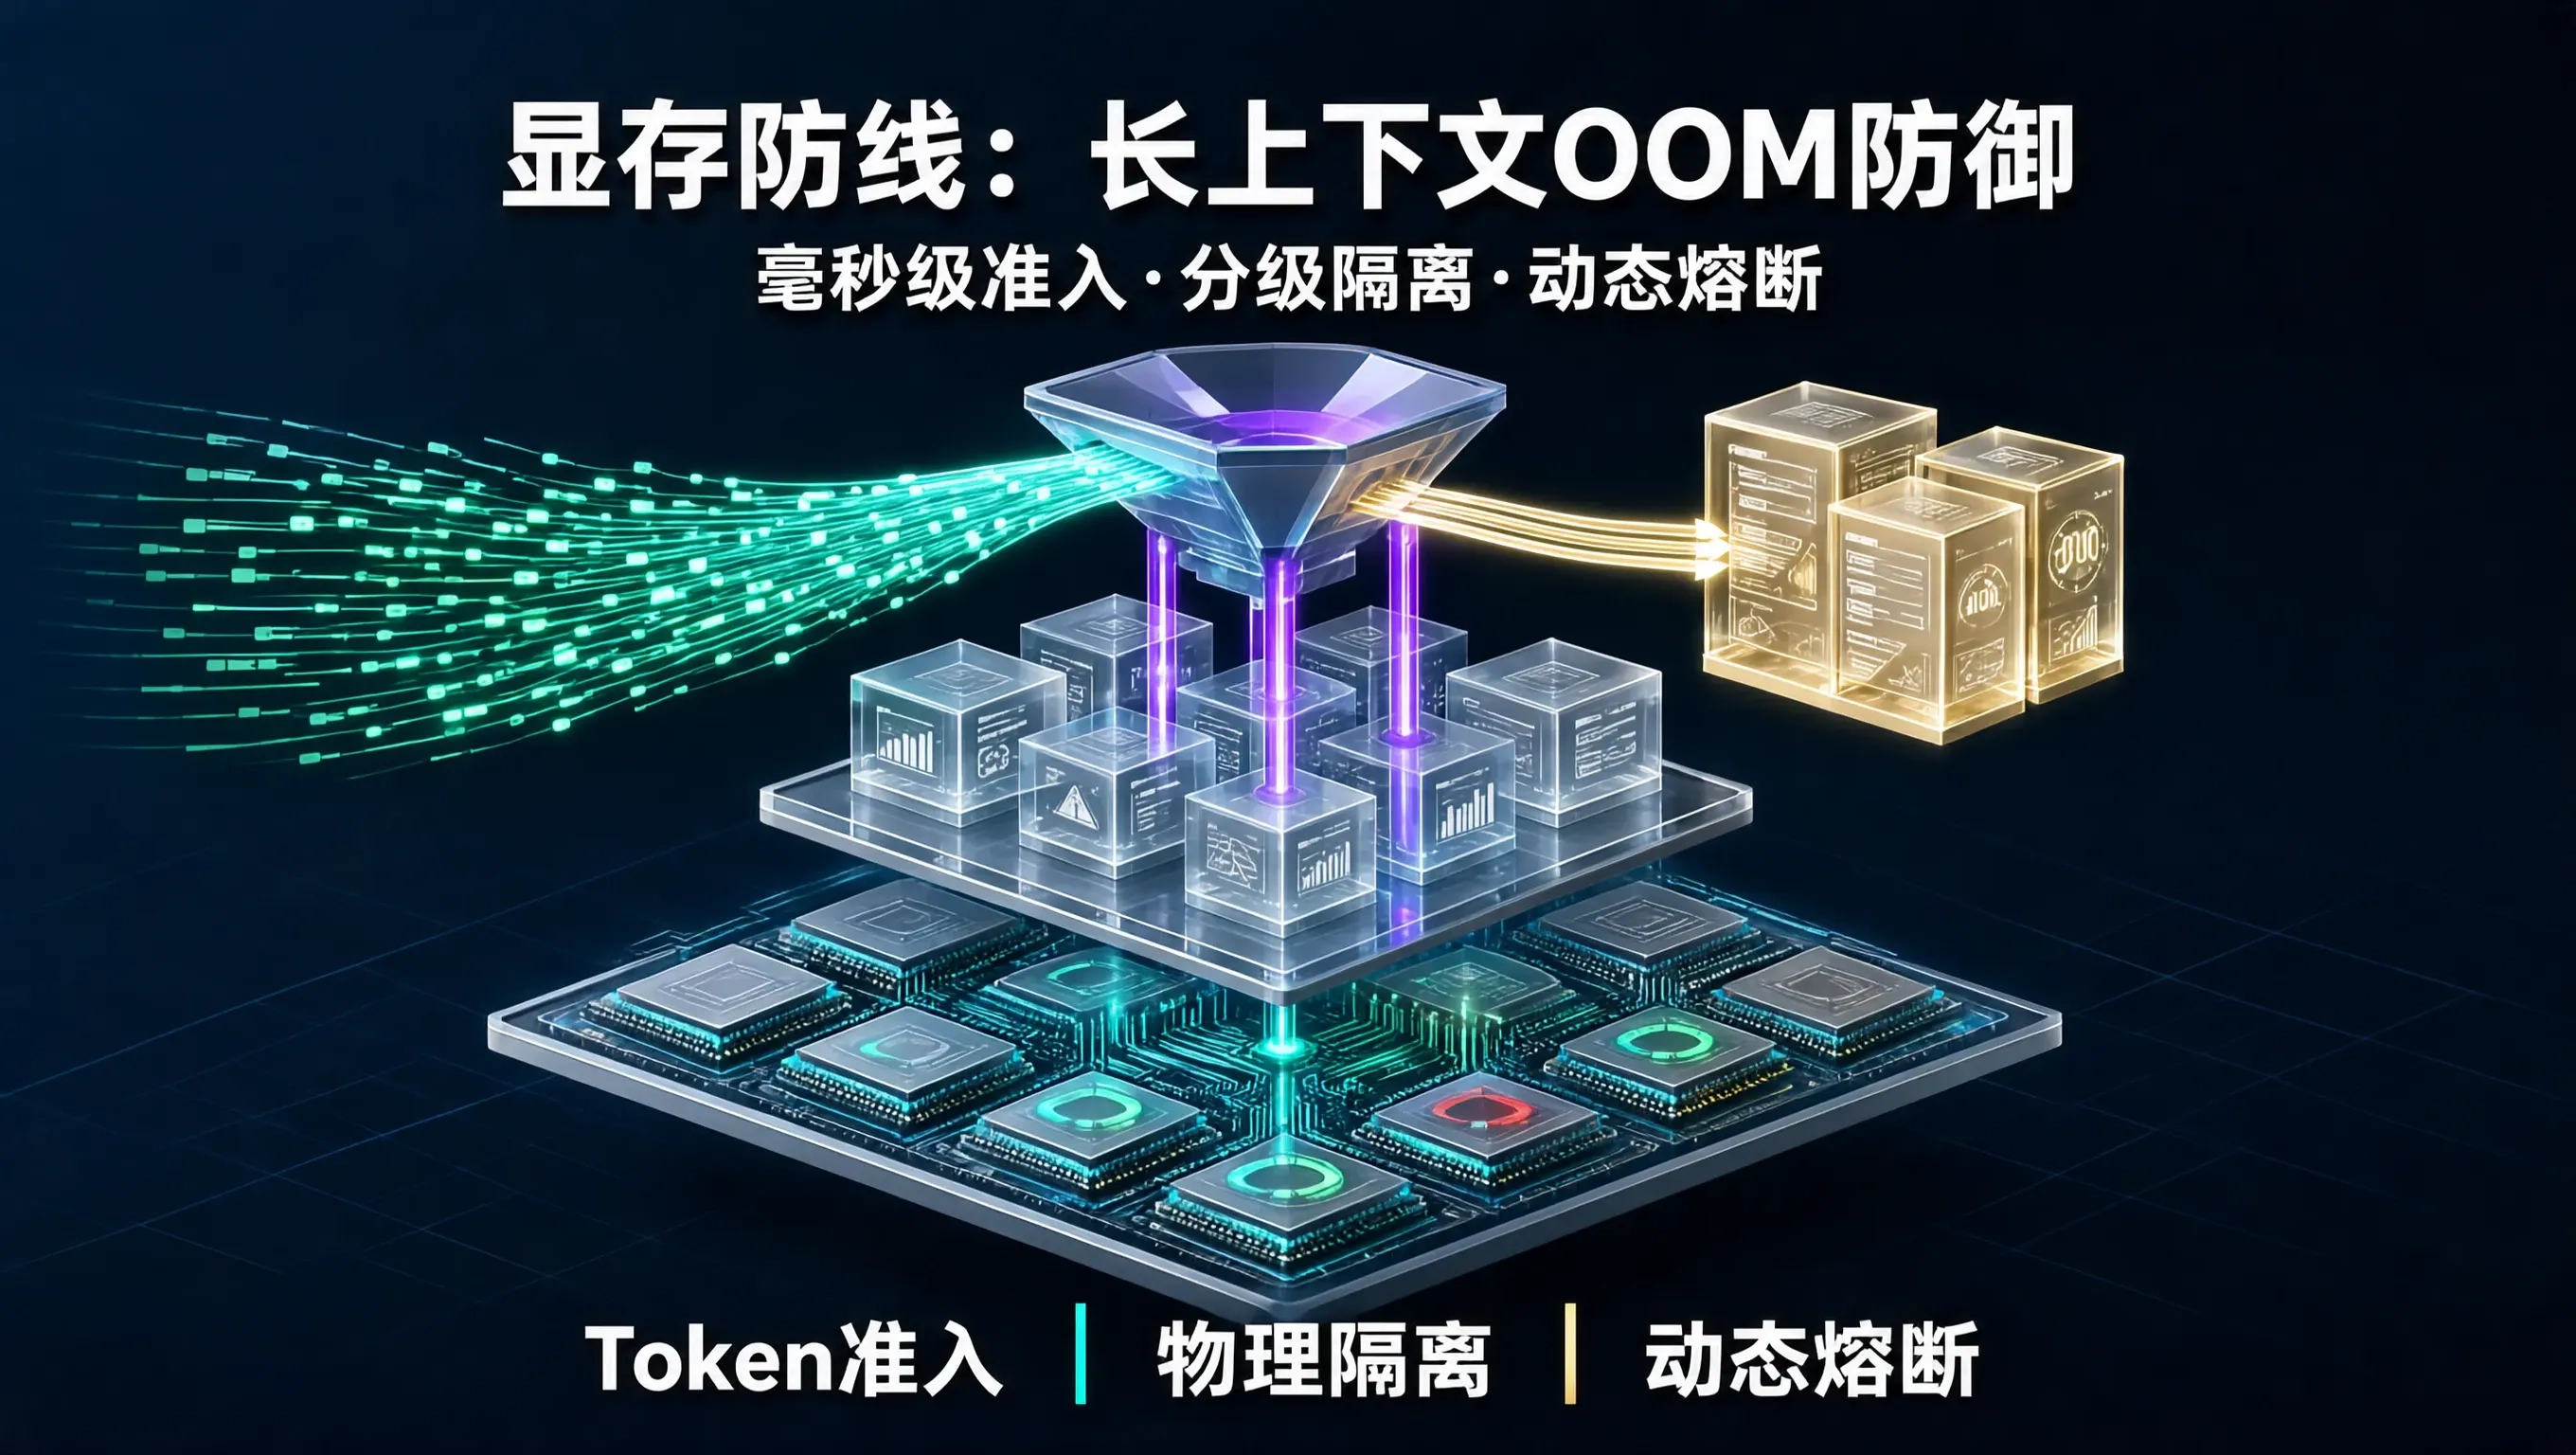
在大模型推理服务(LLM Inference Service)的高并发运维中,最令 SRE 和算法工程师胆战心惊的故障,莫过于**“偶发突发的超长上下文请求(Long-Context Queries)引发的整机 GPU 显存爆仓(OOM Crash)”**。
在常规流量下,用户的提问大多在 500~1000 Token 左右,GPU 显存水位稳定在 70% 的健康区间。
然而,在生产环境中,随时可能发生意外情况:
- 某个上游自动化 Agent 意外向推理服务发送了一个包含 32,000 Token 的巨型代码库快照;
- 某个企业客户上传了一份长达 100 页的 PDF 文档并触发长文本 RAG 问答;
- 当 3~5 个这种“巨无霸”长文本请求在同一秒钟并发涌入同一个 GPU 节点时,KV Cache 的显存需求瞬间呈阶梯式暴涨,突破物理显存极限,直接引发 CUDA 驱动层面的整机崩溃。
构建一套**“毫秒级长文本前置拦截 + 显存动态分级流控 + 智能拆分调度”的高可用防御体系**,是防止大模型服务被突发长请求击穿的重中之重。
长上下文请求引发显存击穿的物理模型
graph TD
A[突发 5 个 32k 超长上下文并发请求] –> B[API Gateway 预估与流量染色]
B –> C{是否超出当前 GPU 剩余 KV Cache 安全容量?}
C –>|是: 触发超长文本安全防御| D[分流至专属 Long-Context 隔离推理集群 或 异步任务队列]
C –>|否: 在安全水位内| E[常规高优先级抢占式调度]
D & E –> F[实时 GPU 显存高频采样 (每 100ms 一次) + 动态熔断]
防御支柱一:网关层 Token 预估与前置准入控制(Admission Control)
在请求进入昂贵的 GPU 显存之前,API 网关必须进行毫秒级的 Token 数量前置预估与准入卡点:
package admission
import (
"context"
"errors"
"net/http"
)
var (
ErrContextTooLong = errors.New("请求上下文超出最大单次实时处理上限 (8192 Tokens)")
ErrClusterSaturated = errors.New("当前 GPU 算力集群处于高危水位,请稍后重试")
)
func FastTokenAdmissionMiddleware(next http.Handler) http.Handler {
return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
// 1. 基于字节长度与轻量 BPE 快速预估 Prompt Token 数
estimatedTokens := fastEstimateTokens(r)
// 2. 强行阻断超过安全阈值的极端恶意/异常请求
if estimatedTokens > 16384 {
http.Error(w, ErrContextTooLong.Error(), http.StatusRequestEntityTooLarge)
return
}
// 3. 针对 4k~16k 的较长请求,检查当前 GPU 显存的动态剩余容量
if estimatedTokens > 4096 {
if !hasEnoughGpuHeadroom(estimatedTokens) {
// 优雅降级:引导转入后台异步队列
routeToAsyncBatchQueue(w, r)
return
}
}
next.ServeHTTP(w, r)
})
}
防御支柱二:集群物理隔离(Traffic Isolation)
严禁将“500 Token 的极速短文本交互”与“32k Token 的长文档分析”混跑在同一个 GPU 节点上:
- 短文本集群(Interactive Pool):实例的 –max-model-len 严格限制为 4096,配置极高的并发数(max-num-seqs=128),保障 95% 日常用户的极速打字体验;
- 长文本专属集群(Long-Context Pool):单独分配大显存节点(如 A100 80GB),开启 FlashAttention-2 与 Chunked Prefill,专门承载长文档与巨型代码分析任务。
通过流量物理隔离,即使长文本集群发生局部排队,也不会波及全站的核心日常问答。
防御支柱三:高频显存监控与抢占式会话排空(Preemption & Swap)
在 vLLM 推理引擎底层,精细化配置 KV Cache 抢占策略:
# vLLM 调度防御参数
args:
– "–gpu-memory-utilization=0.90"
– "–max-num-seqs=96"
– "–enable-chunked-prefill"
– "–swap-space=16" # 开启 16GB 宿主机内存作为 CPU Swap 紧急缓冲池
当突发显存告急时,推理引擎自动根据会话优先级,将部分低优先级的中间会话 KV Cache 临时置换(Swap Out)到宿主机的 CPU 内存中;待高优先级请求处理完毕后,再置换回 GPU 显存继续生成,彻底消除了直接抛出 CUDA OOM 导致进程暴毙的硬伤。
治理成效
通过在网关层建立 Token 准入拦截与长短流量物理隔离:
- 生产环境大模型服务的 72 小时 GPU OOM 崩溃率直接降为 0;
- 短文本交互用户的平均首 Token 延迟(TTFT)稳定在 180ms 以内,完全免受长文档并发的吞噬影响;
- 成功支撑了业务线长文本问答功能的平稳上线。
用严密的准入防线与分级的资源隔离,让大模型服务在高并发与复杂长尾输入的冲击下,始终展现出坚如磐石的高可用底气。


评论前必须登录!
注册