 网硕互联帮助中心
这个栏目写香港公开数据写了三十多篇,评论区隔三差五有人问同一个问题:为什么不直接用 pandas?答案很俗——我一开始也用,是被它的默认行为坑出来的。63 个审计脚本里最后有 35 处手写 csv.reader,今天干脆把这笔账算清楚:拿两份真实的香港官方 CSV(差饷物业估价署的月度/年度楼价指数),把 read_csv 替你做的那些决定逐条实测一遍。
目录
-
- 一、它默认吞掉这 19 种字符串
- 二、第一行不是列头时,它替你做主
- 三、类型推断:三个变形一个惊喜
- 四、25KB 的文件,它要 0.64 秒
- 五、两张嘴脸对照表
- 四个要点收尾
一、它默认吞掉这 19 种字符串
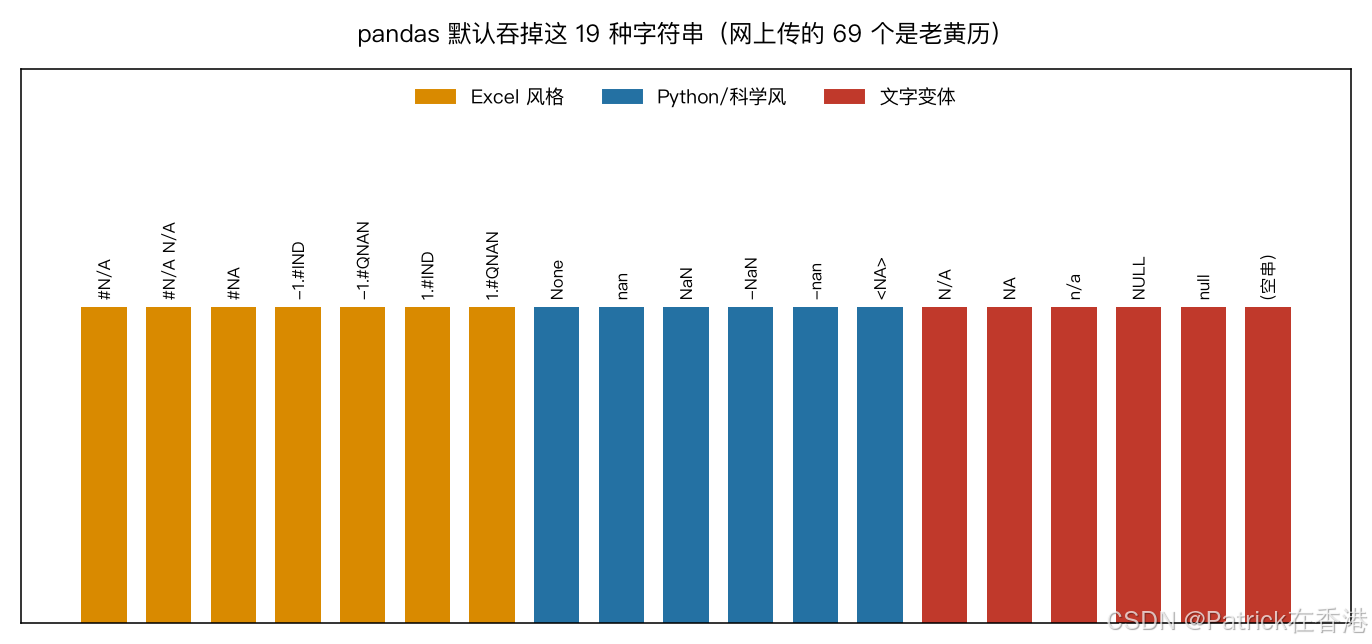
先说最广为流传的那个传说:「pandas 默认把 69 种字符串当 NaN」。实测 pandas 3.0.5:
import pandas as pd
from pandas._libs.parsers import STR_NA_VALUES
print(pd.__version__, len(STR_NA_VALUES))
print(sorted(STR_NA_VALUES))
print("'-' 会被吞吗:", "-" in STR_NA_VALUES)
# 3.0.5 19
# ['', '#N/A', '#N/A N/A', '#NA', '-1.#IND', '-1.#QNAN', '-NaN', '-nan',
# '1.#IND', '1.#QNAN', '<NA>', 'N/A', 'NA', 'NULL', 'NaN', 'None',
# 'n/a', 'nan', 'null']
# '-' 会被吞吗: False
19 个,不是 69——那个数字是老黄历了。但这 19 个里藏着真麻烦,用一个小表看它们怎么工作:
import io
mini = ("id,name,value\\n"
"1,NA,5\\n2,None,7\\n3,NULL,9\\n"
"4,-,11\\n5,—,13\\n6,nan,15\\n")
d_def = pd.read_csv(io.StringIO(mini))
d_keep = pd.read_csv(io.StringIO(mini), keep_default_na=False)
print(list(d_def["name"]))
print(list(d_keep["name"]))
# [nan, nan, nan, '-', '—', nan]
# ['NA', 'None', 'NULL', '-', '—', 'nan']
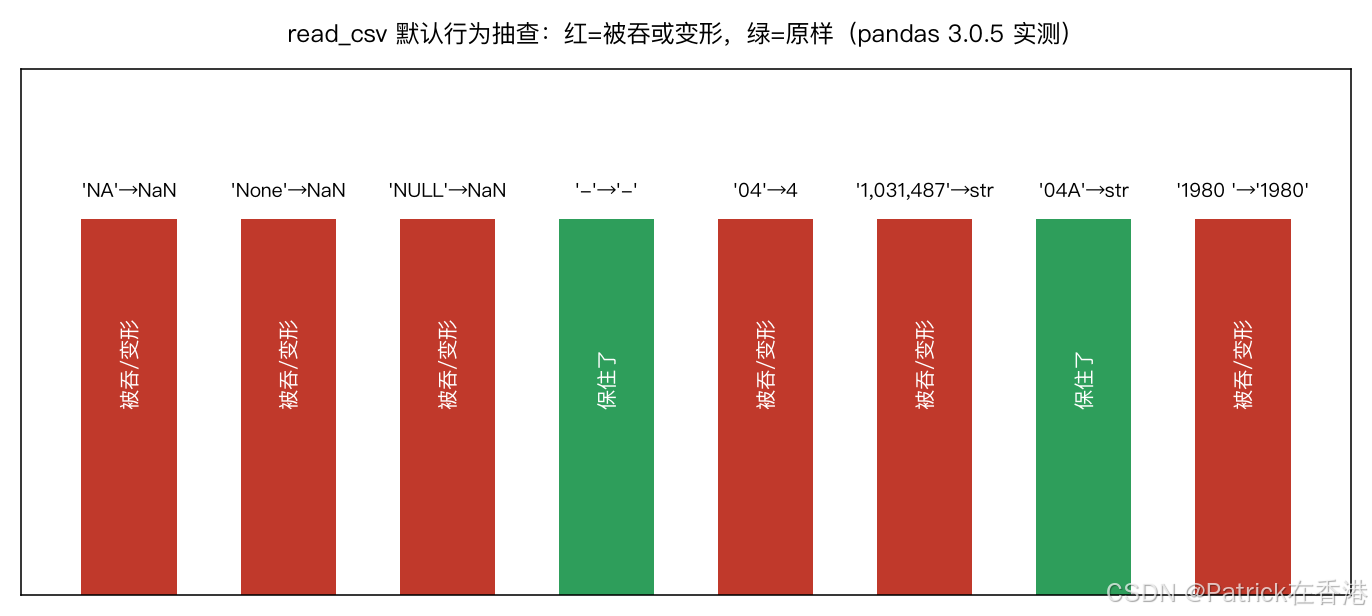
六个名字,默认读取吞掉 5 个:NA、None、NULL、nan 全变 NaN,只剩 na 的变体里没被认出来的横杠和破折号。如果 NA 是纳米比亚的国家代码、None 是 someone 真实填的占位值,你的数据就在无报错的情况下缺了一块。keep_default_na=False 一个参数全部保住。
有一个好消息值得单独说:横杠 – 不在默认清单里。我之前审计香港废物统计时遇到大量用 – 表示「无数据」的官方表格,当时担心 pandas 会把它们吞成 NaN——实测不会,它把 – 当普通字符串。真正的风险来自 NA 和 NULL 这种「看起来像占位符」的合法值。
空字符串也在那 19 个词里,这引出一个反直觉的观察:我在楼价指数表上实测,404 行数据里 Class A 列一个 NaN 都没有——但这张表有 8 个 Remarks 备注列,读进来后满屏 <NaN>(RVD 用空字符串表示「无备注」,pandas 顺手全转成了 NaN)。结果反而好用:df["Class A – Remarks"].dropna() 一行就捞出全部 P/Z 标记行,等于 pandas 替你把「空」和「有内容」分好了堆。同一种默认行为,在值列是坑、在备注列是糖——默认值没有对错,只有和你数据的匹配度。
二、第一行不是列头时,它替你做主
香港差饷物业估价署的 CSV 长这样:第一行是大写标题(PRIVATE DOMESTIC – PRICE INDICES…),第二行才是列头。默认读取的结果:
df = pd.read_csv("原始返回/rvd/1.4M_r0.csv", encoding="utf-8")
print(list(df.columns[:3]))
# ['PRIVATE DOMESTIC – PRICE INDICES BY CLASS ( TERRITORY-WIDE ) [MONTHLY]',
# 'Unnamed: 1', 'Unnamed: 2']
整行标题成了第一列的列名,其余 16 列全部 Unnamed。不报错、有数据,只是后面每一处 df["Class A"] 都会当场 KeyError——错误离现场隔了一整个读取步骤。skiprows=1 才是正确打开方式。这不算 pandas 的错,但它「默认把第一行当列头」的决定,遇到政府统计这种带标题行的文件就翻了车。
三、类型推断:三个变形一个惊喜
同一个三行小表,read_csv 的类型推断会做三件事:
probe = ("code,amount,unit\\n"
"04,\\"1,031,487\\",04A\\n"
"07,\\"231,487\\",12B\\n"
"08,\\"964,136\\",13C\\n")
d = pd.read_csv(io.StringIO(probe))
print(d["code"].tolist(), d["code"].dtype)
print(d["amount"].dtype, repr(d["amount"].iloc[0]))
# [4, 7, 8] int64
# str '1,031,487'
BOM 也顺带测了:本系列在消委会价格监察 CSV 上真实遇到过 BOM(1.07MB 的文件,字节头就是 EF BB BF)。pandas 3.0.5 即使用 encoding="utf-8" 也能自动剥掉;但标准库 csv.reader 不剥,首列名会带着看不见的 \\ufeff 前缀。工具升级把一个老坑填了,可你参考的老教程还在教 utf-8-sig——填坑这件事,文档永远比代码慢一拍。
四、25KB 的文件,它要 0.64 秒
最后一笔账是时间:
import csv, statistics, time
def bench(fn, n=7):
ts = []
for _ in range(n):
t0 = time.perf_counter()
fn()
ts.append(time.perf_counter() – t0)
return round(statistics.median(ts) * 1000, 1)
t_pandas = bench(lambda: pd.read_csv(
"原始返回/rvd/1.4M_r0.csv", encoding="utf-8-sig", skiprows=1))
t_csv = bench(lambda: list(csv.reader(
open("原始返回/rvd/1.4M_r0.csv", encoding="utf-8-sig"))))
print(t_pandas, t_csv)
# 3.1 0.7
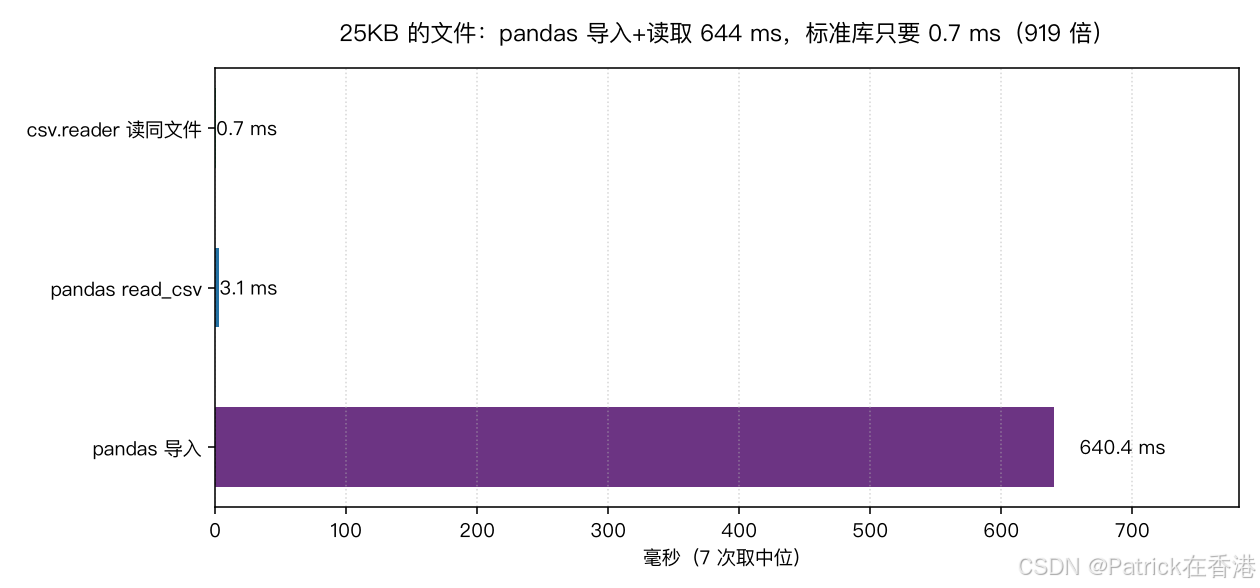
25KB 的月度指数表:pandas 光导入就要 640 毫秒(干净解释器里单独量 import pandas,7 次取中位 640.4 毫秒——__import__ 是幂等的,在已导入的解释器里计时只会得到 0),读取再花 3.1 毫秒;标准库 csv.reader 全程 0.7 毫秒——总耗时差着约 900 倍。批量抓 30 个官方源的自动化脚本里,这个差距乘上任务数就是分钟级。pandas 的价值在向量化运算,不在「把文件读进来」;小文件、单遍扫描的场景,标准库更合适。
五、两张嘴脸对照表
把上面所有实测摆到一起,「同一个文件、两个工具」的差异一目了然:
| 标题行 | 你自己决定跳不跳 | 默认当列头,其余列 Unnamed |
| 'NA'/'NULL'/'None' | 原样字符串 | 静默变 NaN |
| '1980 ' 尾空格 | 原样保留 | 自动 strip 成 '1980' |
| '04' 前导零 | 字符串 '04' | 变整数 4 |
| '1,031,487' | 字符串 | 字符串(dtype 显示 str) |
| BOM | 留在首列名 | 3.0 起自动剥掉 |
| 25KB 读取耗时 | 0.7 ms | 3.1 ms(另加导入 640 ms) |
这张表左边一列全是「你说了算」,右边一列全是「它替你决定」——两种都合法,但混用两边的结果做 join、做对账时,先想清楚每一格是谁做的主。至于什么时候用哪个:一次性分析、要跟 DataFrame 生态衔接,pandas 值得那 640 毫秒;常驻的自动化脚本、逐行流式处理、或者像我这样每天要跟几十个长相各异的官方文件打交道,标准库那 0.7 毫秒和「一切显式」的踏实感更值钱。
四个要点收尾
吐槽完了,该说句公道话:这 63 个脚本里凡是真要做数值分析和画图的,pandas 依然是主力——被骂的从来不是它的能力,是那些没商量就替你做的决定。本文所有数字可复现,脚本和原始返回(RVD 两份文件双轮快照)都在仓库,取数时间 2026-09-28,pandas 3.0.5。
参考链接



评论前必须登录!
注册