 网硕互联帮助中心
别把磁盘冗余和弹性扩容搞混:一篇讲透 Linux RAID 与 LVM 逻辑卷
本文以实践总结的视角,记录 Linux 命令行学习中「存储技术进阶」两大主题的实际操作、踩过的坑和心得,适合新手照着动手练习。
示例提示符:root 用户为 [root@server ~]#。
全文分两大块:
一句话点题:RAID 解决「多块盘怎么协作、坏了怎么办」,LVM 解决「空间不够怎么灵活扩缩」。两者常配合使用(先做 RAID,再在上面做 LVM)。
第一部分:RAID 磁盘冗余阵列
一、环境准备
虚拟机添加 6 块 20G 硬盘,设备名为 sd{b..g}(即 /dev/sdb ~ /dev/sdg)。后面所有 RAID 实验都在这 6 块盘上做。
二、RAID 技术历史
1988 年,美国加州大学伯克利分校的 D. A. Patterson 教授等人在论文 “A Case of Redundant Array of Inexpensive Disks” 中首次提出 RAID 概念,即廉价磁盘冗余阵列(Redundant Array of Inexpensive Disks)。由于当时大容量磁盘昂贵,RAID 的基本思想是把多个容量较小、相对廉价的磁盘有机组合,用较低成本获得与昂贵大容量磁盘相当的容量、性能和可靠性。后来磁盘成本不断下降,「廉价」已无意义,RAID 咨询委员会(RAB)决定用「独立」替代「廉价」,于是 RAID 变成了独立磁盘冗余阵列(Redundant Array of Independent Disks)——只是名称变化,实质没变。
记住:RAID 的精髓就三个词——条带化(提速)、镜像 / 校验(保命)、组合(扩容)。后面所有级别都是这三招的排列组合。
三、RAID 实现方式
从实现角度看,RAID 分三种:
| 软 RAID | 所有功能由操作系统和 CPU 完成,无独立 RAID 芯片和 I/O 芯片,效率最低 | 低 |
| 硬 RAID | 配备专门的 RAID 控制/处理芯片、I/O 芯片和阵列缓冲,不占 CPU | 高 |
| 软硬混合 RAID | 有 RAID 控制/处理芯片,但缺 I/O 处理芯片,需 CPU 和驱动配合 | 中 |
软 RAID 才是本文学的重点:Linux 用 mdadm 工具就能在几块普通盘上做软 RAID,零额外硬件成本。
四、RAID 级别详解
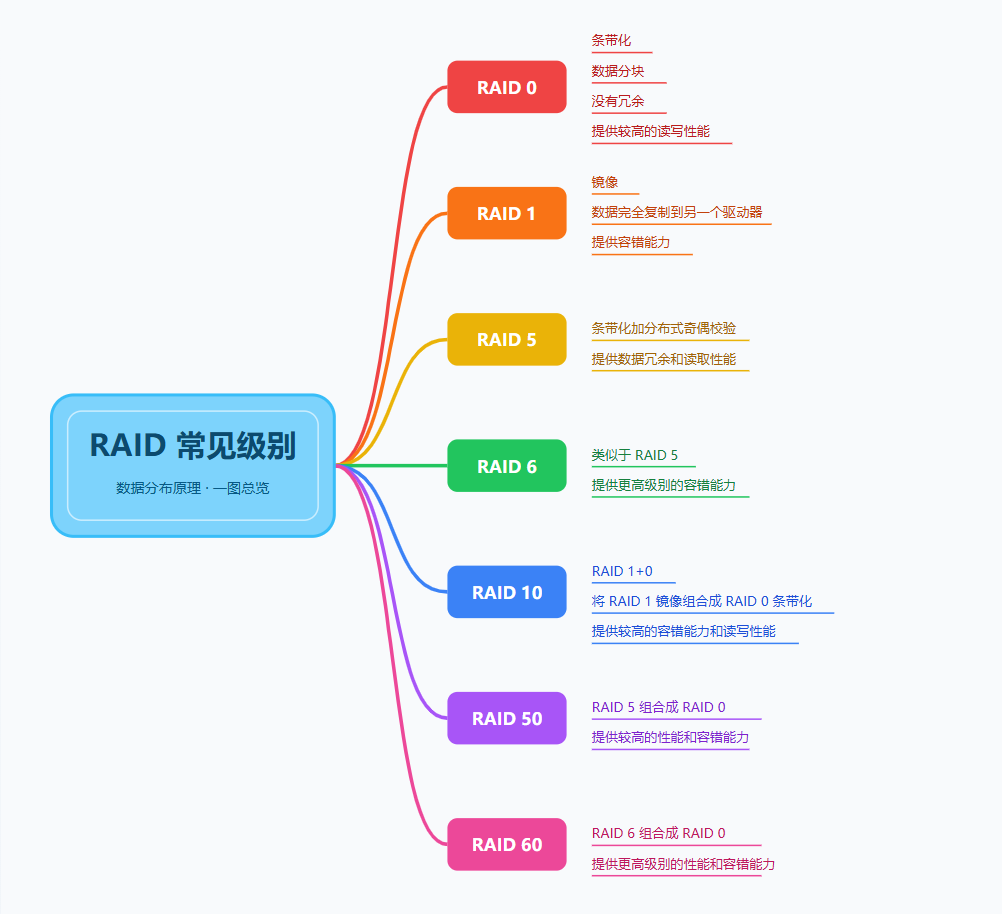
RAID 主要利用数据条带、镜像、数据校验三种技术获得高性能、可靠性、容错和扩展性。Patterson 的论文定义了 RAID1~RAID5,1988 年后又扩展了 RAID0 和 RAID6。目前业界公认标准是 RAID0~RAID5,实际应用最多的级别是 RAID0、RAID1、RAID4、RAID5、RAID6、RAID10。
重要认知:RAID 每个等级代表一种实现方法,等级之间无高低之分,应按可用性、性能、成本综合选择。
4.1 RAID 0(条带,只提速不保命)
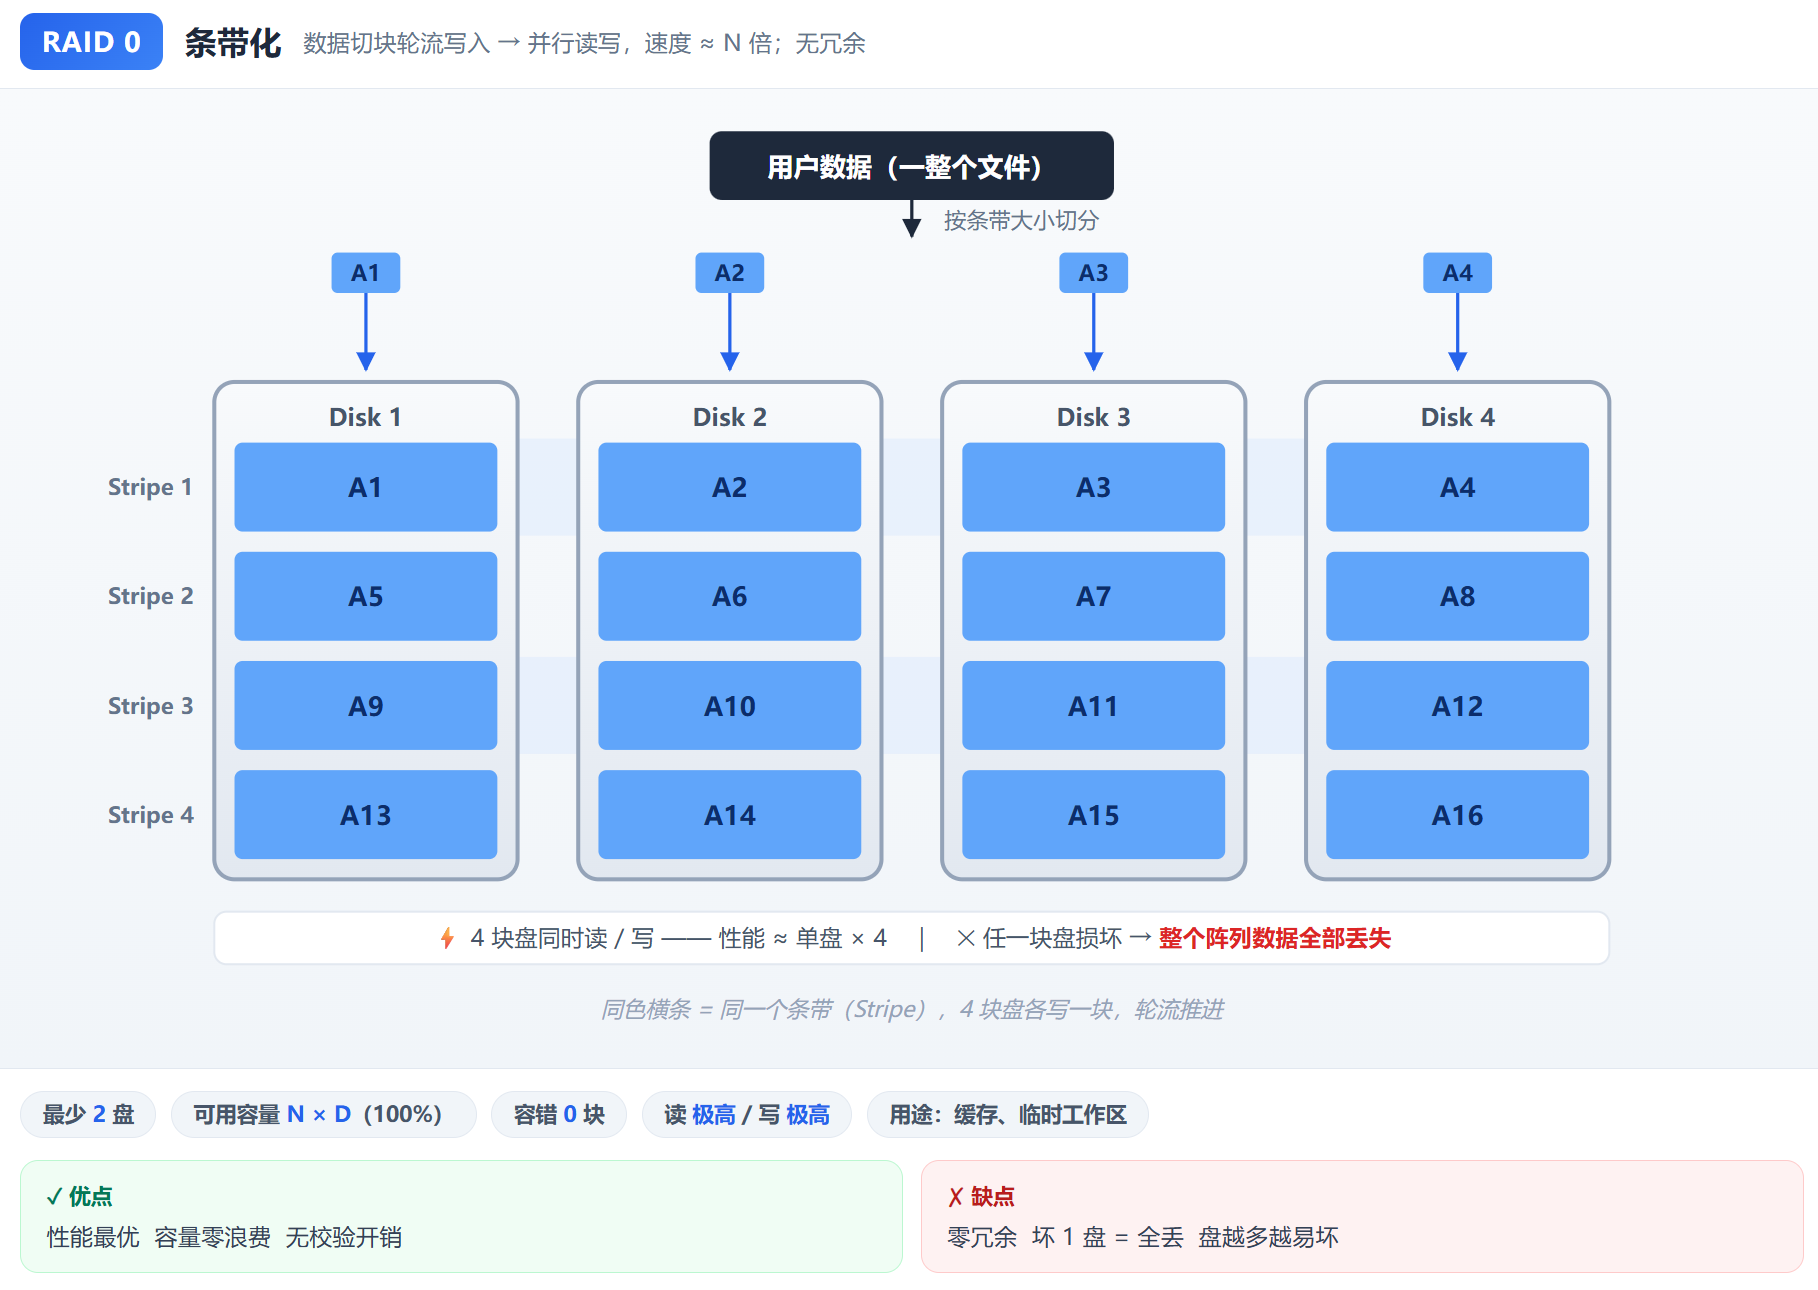
原理:数据条带化(striping),把数据切成固定大小块,依次分散写到多个盘,不做任何冗余备份。两个盘时,第一块数据写 A 盘、第二块写 B 盘,如此循环。因为能同时从多块盘读写,速度大幅提升。
- 适用场景:需要高性能、不在乎冗余——视频编辑、大型数据库查询、实时流媒体。
- 优点:高性能;成本低(不浪费盘做备份)。
- 缺点:无冗余,任何一块盘坏了,所有数据都可能丢;可靠性低。
一句话:RAID 0 是「速度狂魔、身板极脆」,磁盘越多越快也越危险,千万别存重要数据。
4.2 RAID 1(镜像,只保命不提速)
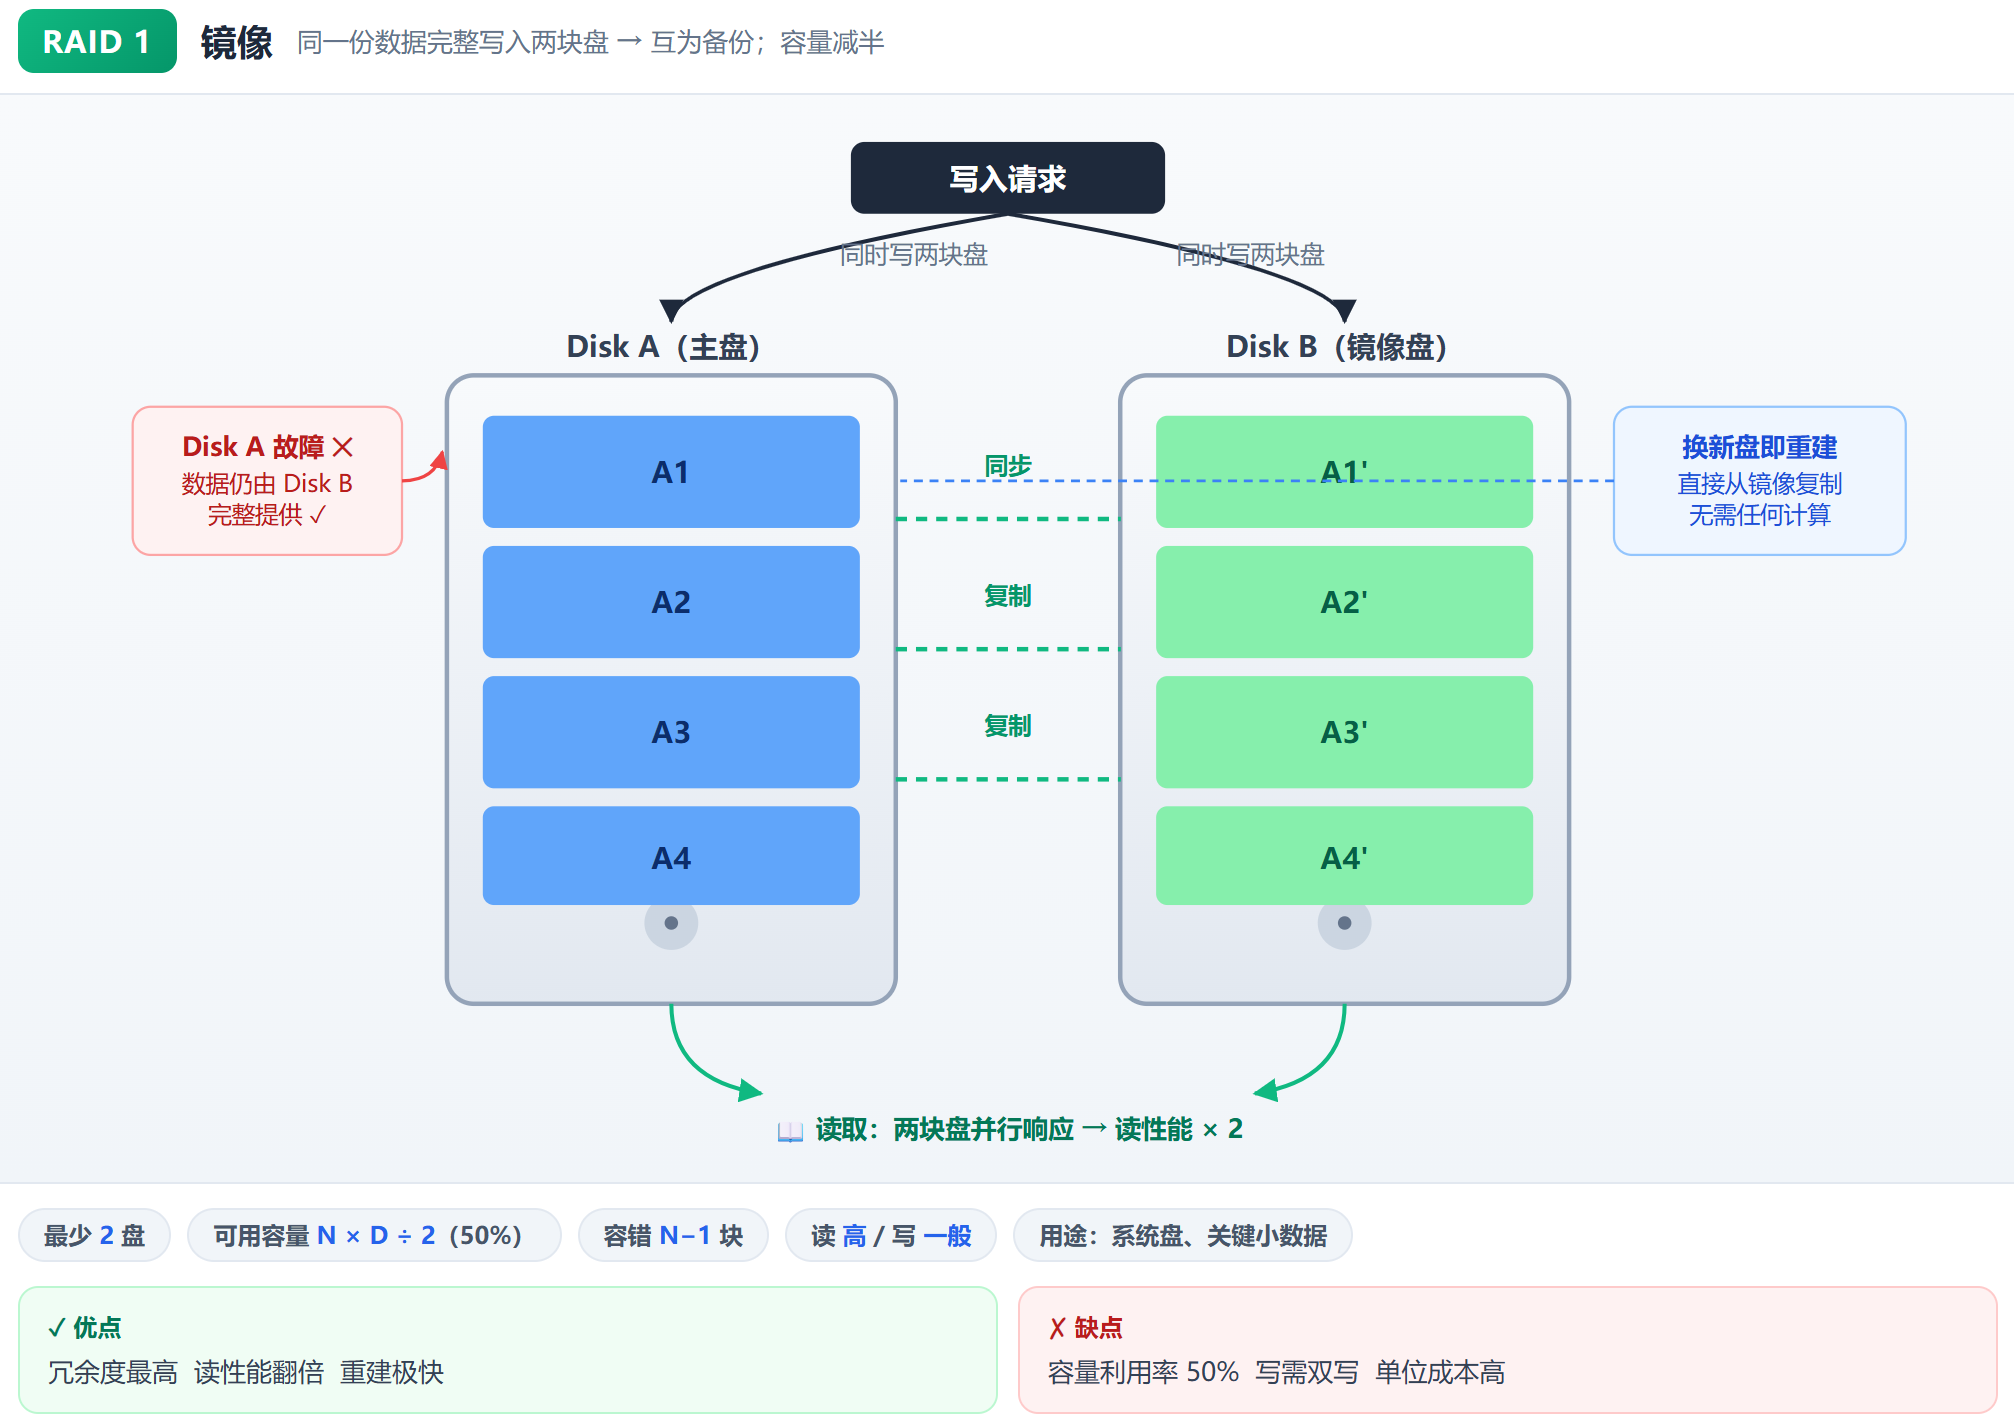
原理:数据镜像(mirroring),写入时把数据完整复制到两块或多块盘,每块盘都是同样的副本。一块盘坏了,还能从另一块读。
- 适用场景:对冗余和高可用要求高的场景——关键数据、数据库服务器、文件服务器。
- 优点:数据冗余;高可用;读取性能略有提升(可并行读)。
- 缺点:成本高(要一半空间做镜像);写性能略低(要写多份)。
一句话:RAID 1 是「双保险」,但容量只有总盘数的一半。
4.3 RAID 5(条带 + 单校验,性价比之王)
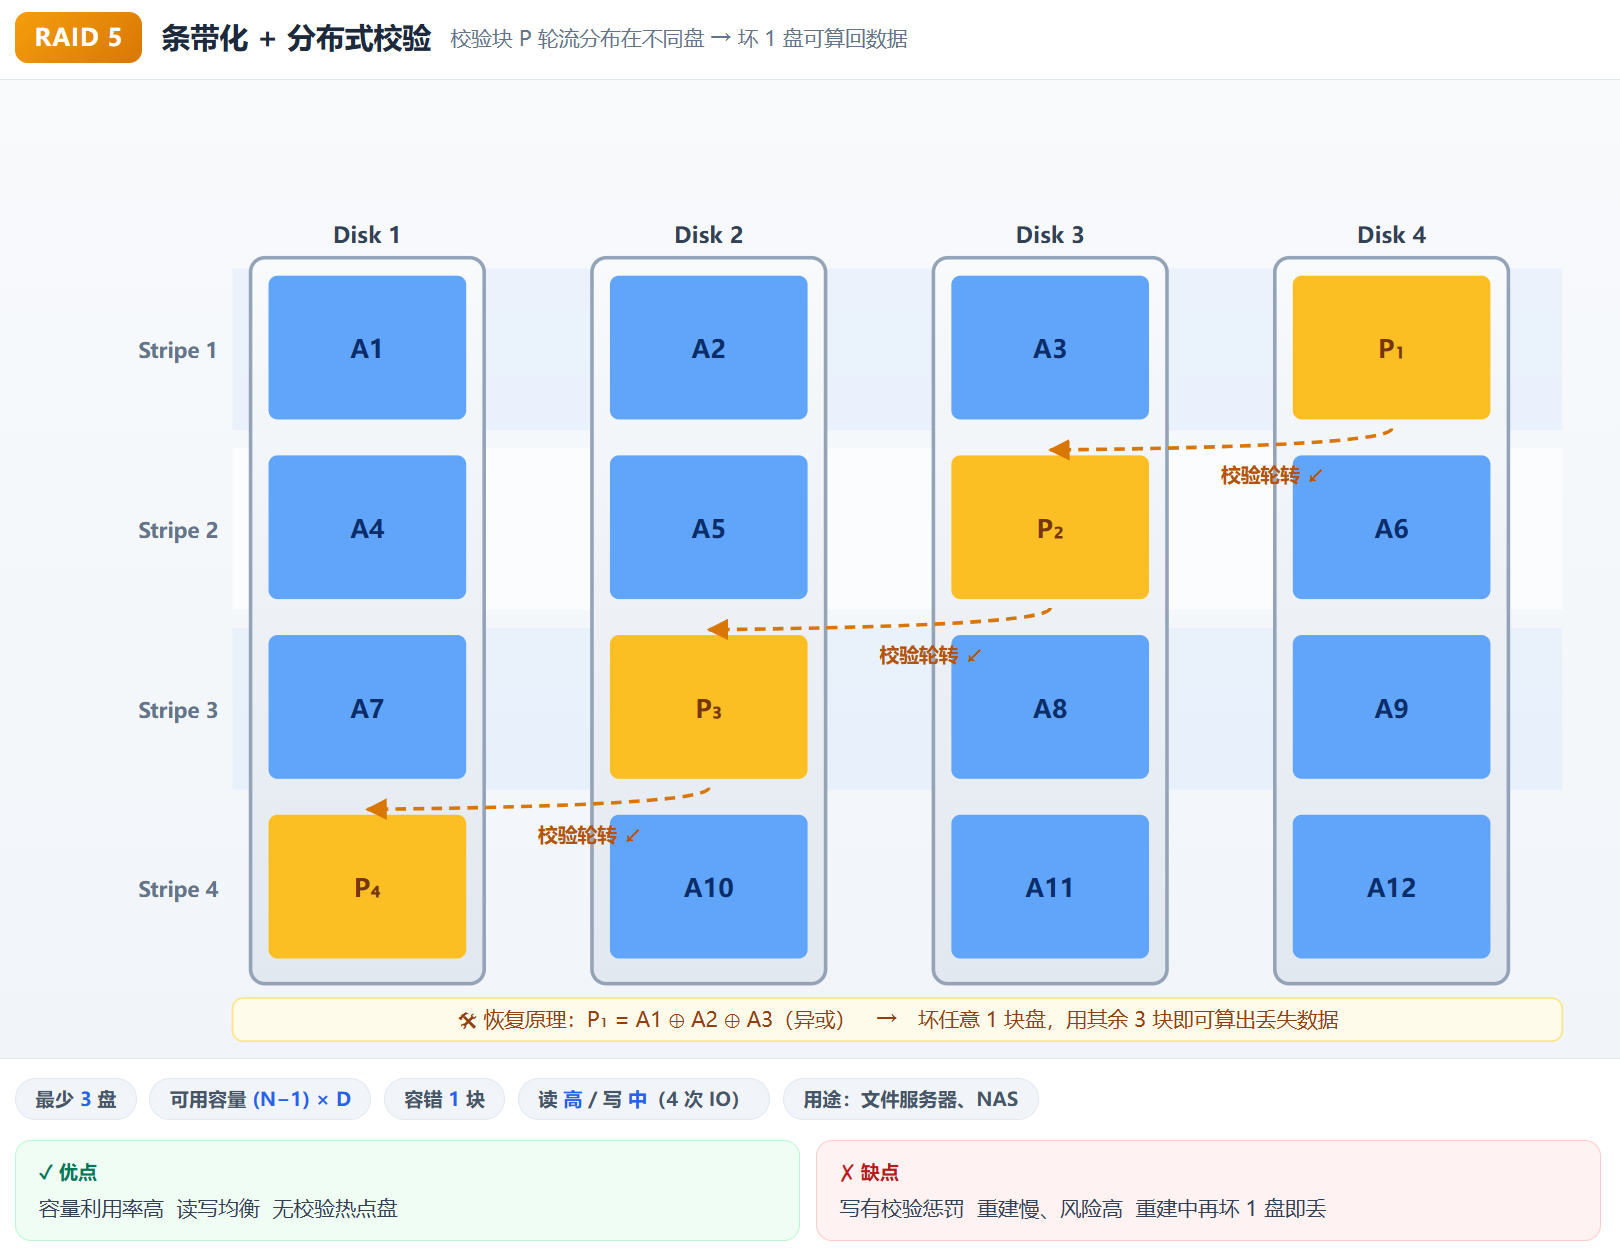
原理:条带化 + 分布式奇偶校验。数据和校验信息交错分散到各盘,坏一块盘时可通过校验信息重算恢复。兼顾性能与冗余。
- 适用场景:性能 + 冗余兼顾——文件服务器、数据库、小型企业。
- 优点:性能较好;有冗余(允许坏 1 块盘);成本低(只浪费 1 块盘做校验)。
- 缺点:写性能偏低(写时要重算校验);坏盘恢复期间访问变慢、有数据完整性风险。
空间公式:N 块盘做 RAID 5,可用容量 = (N-1) 块。最少 3 块盘。
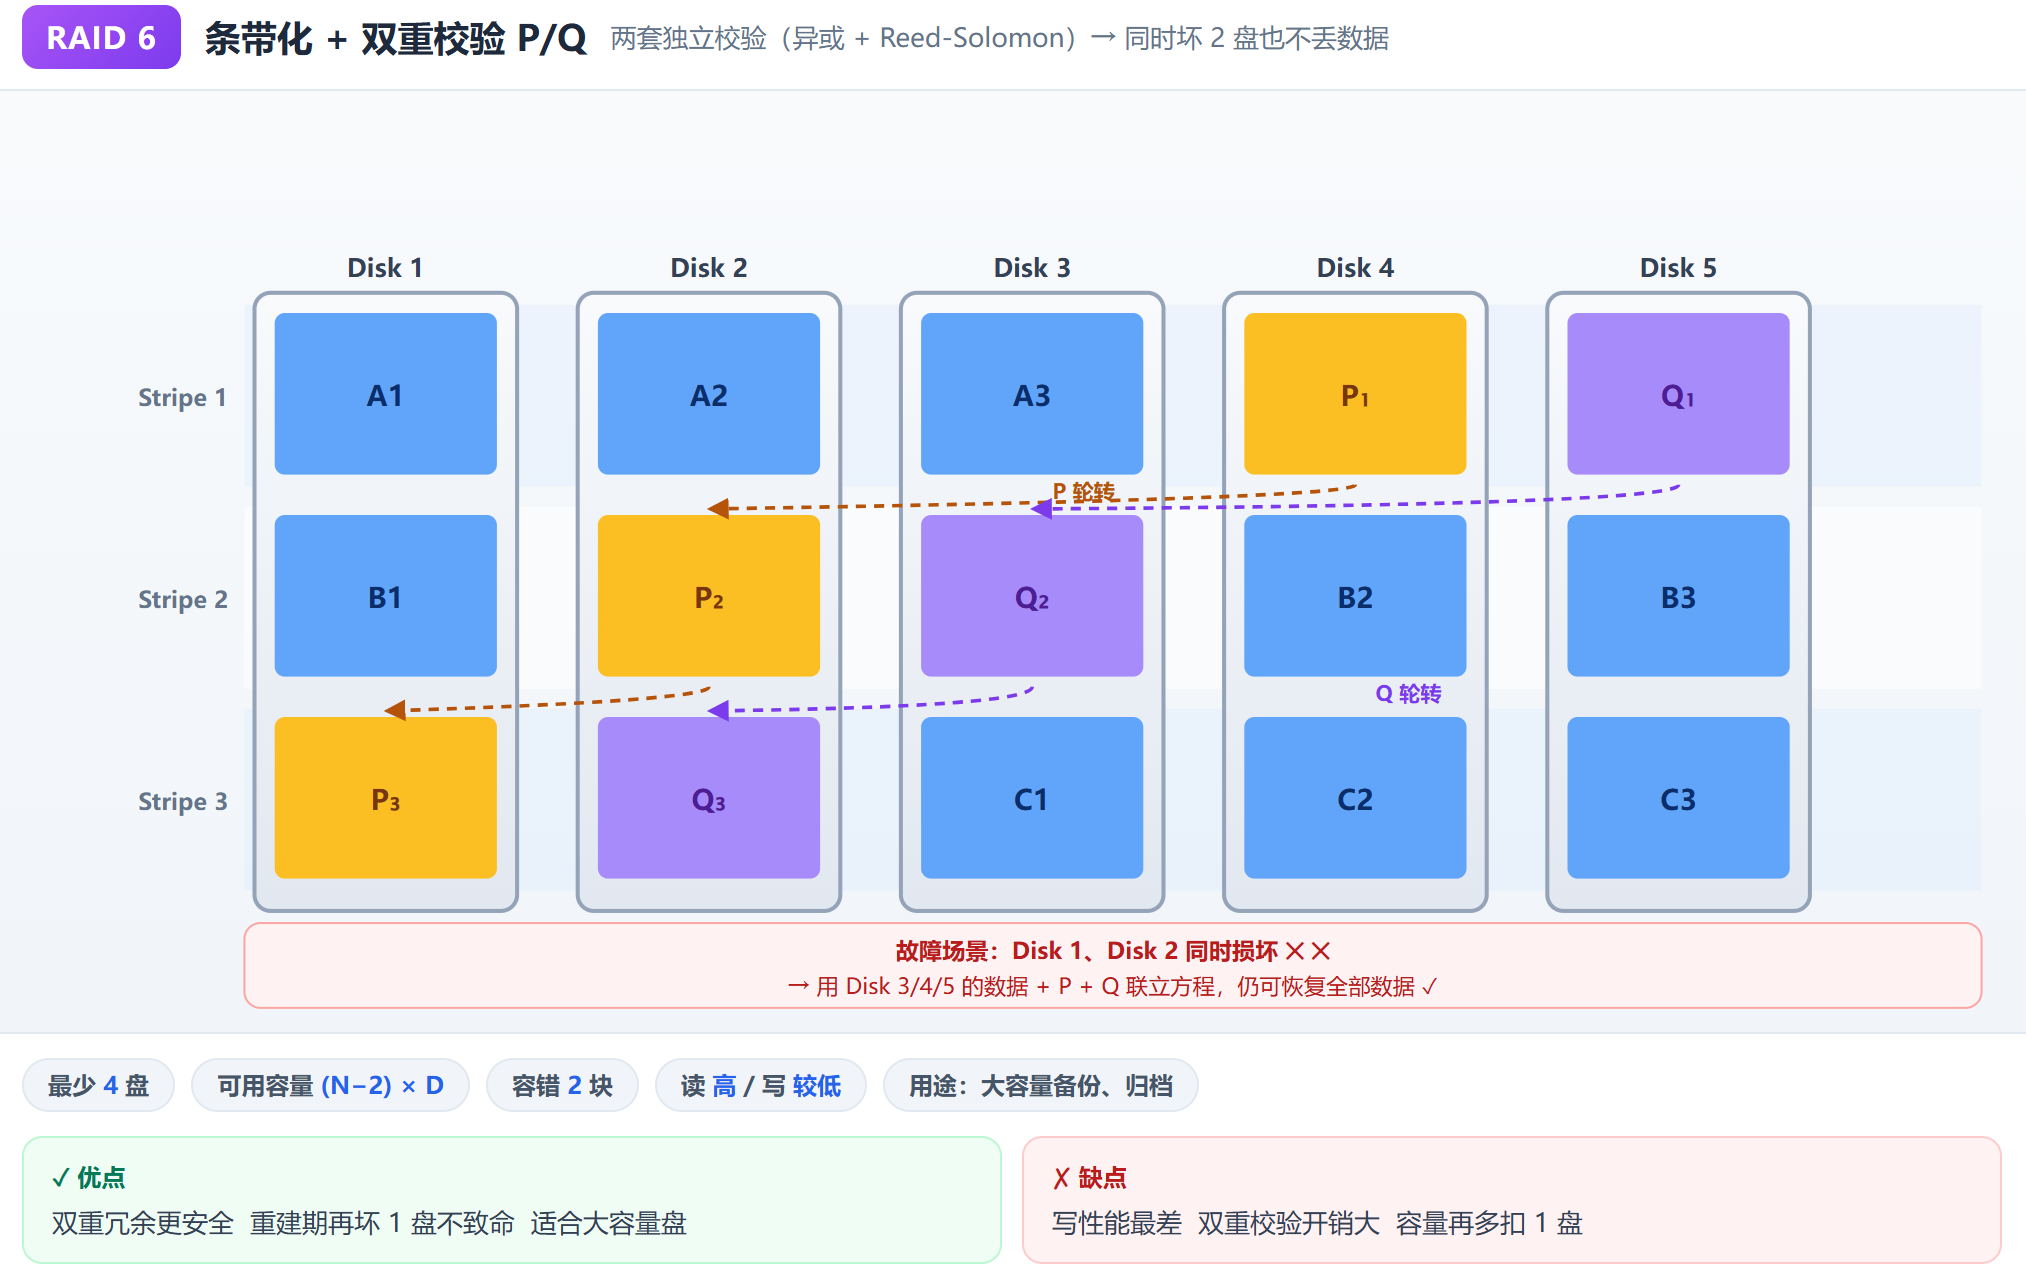
4.4 RAID 6(条带 + 双校验,更抗造)
原理:在 RAID 5 基础上用双重奇偶校验,可同时容忍 2 块盘故障,冗余性更强。
- 适用场景:大容量存储、需要长期运行的关键应用、虚拟化环境。
- 优点:更高级别冗余(坏 2 块盘也能恢复);性能较好。
- 缺点:写性能更低(双重校验计算);成本更高(浪费 2 块盘)。
空间公式:N 块盘做 RAID 6,可用容量 = (N-2) 块。最少 4 块盘。
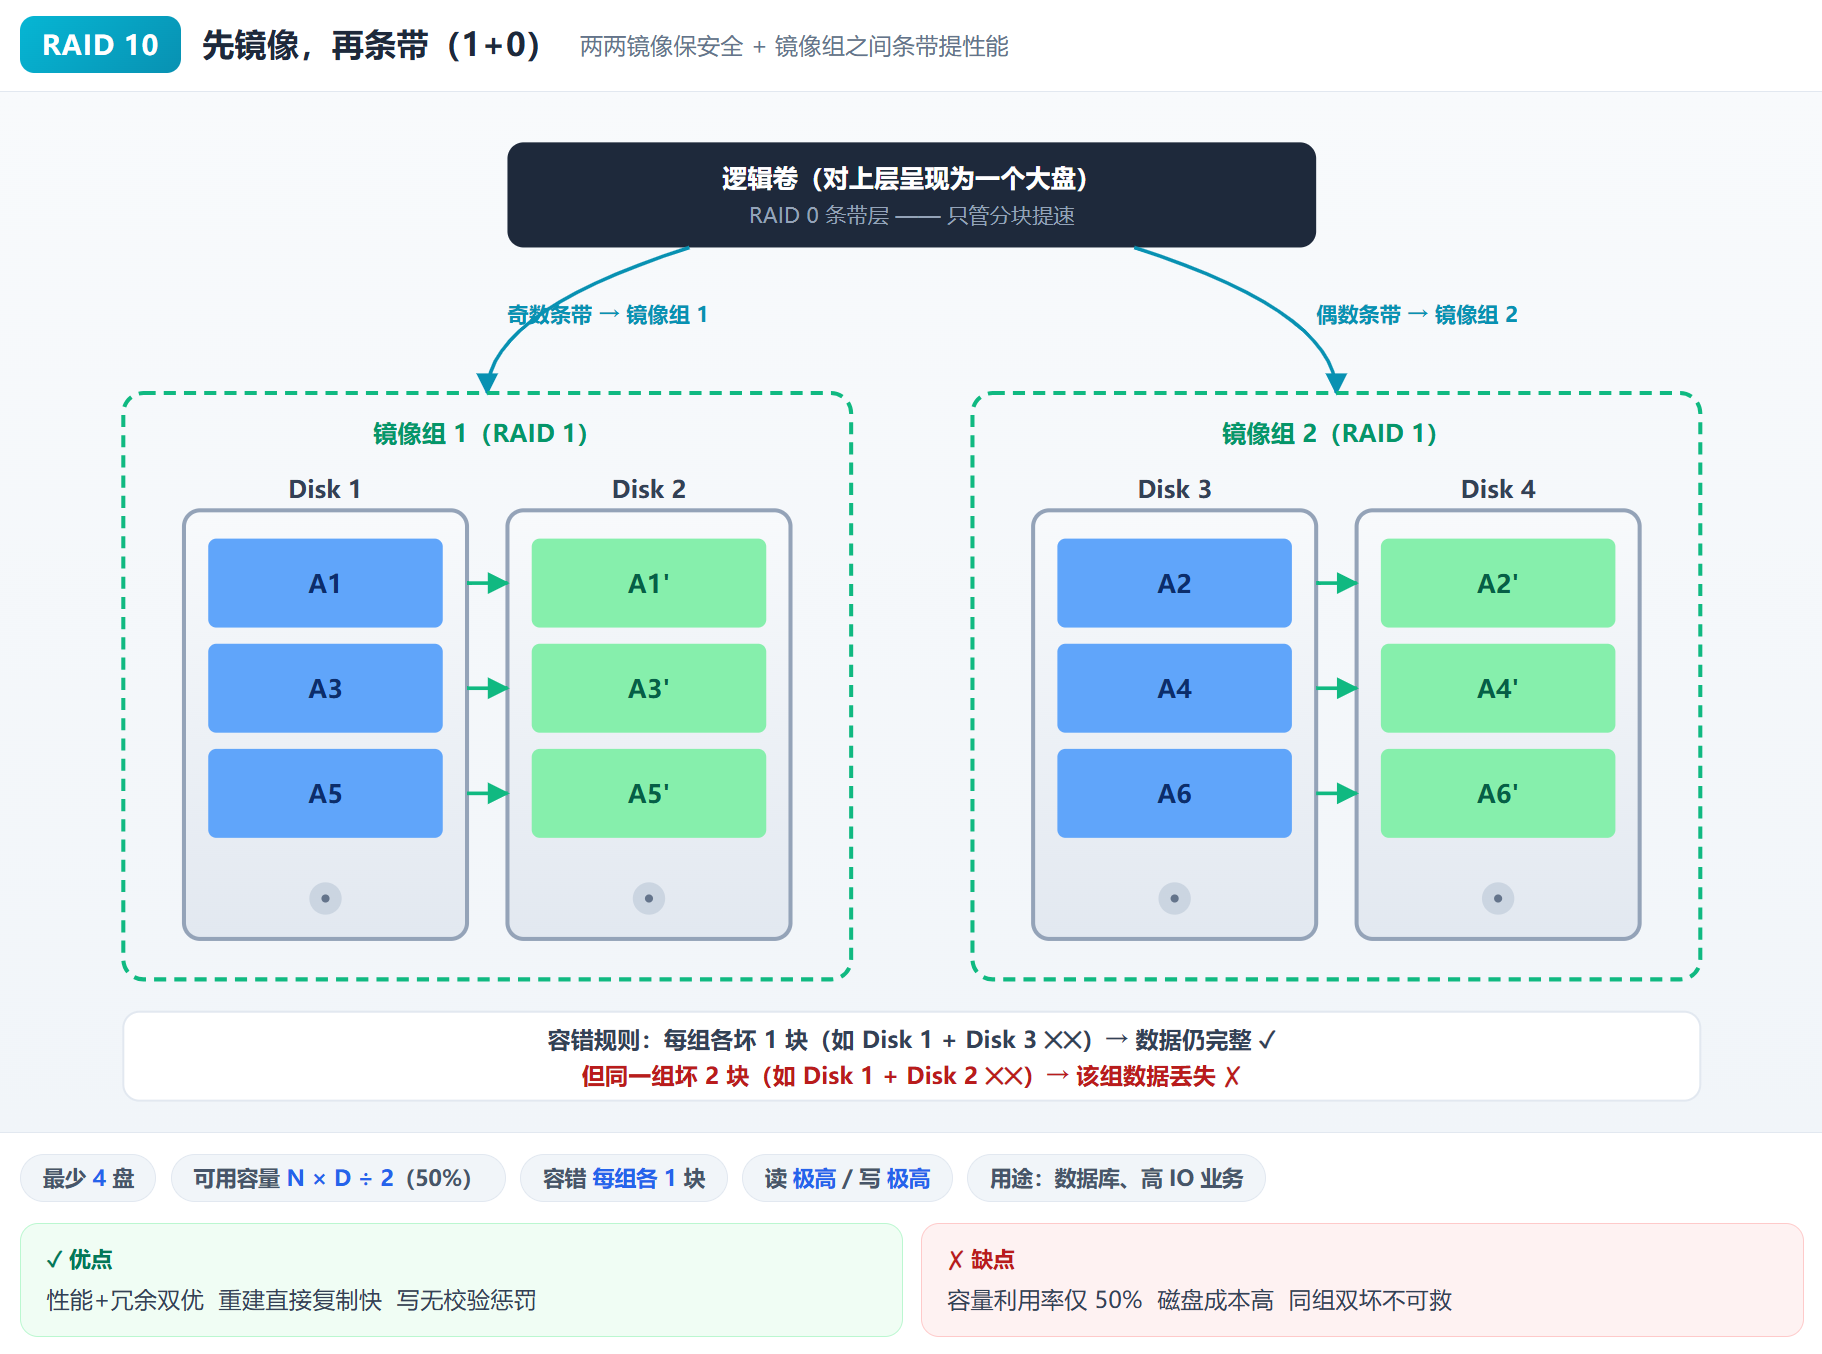
4.5 RAID 10(先镜像再条带,性能+冗余都要)
原理:RAID 0 + RAID 1 的组合——先做镜像(每份数据复制两份),再对镜像组做条带。既有性能又有冗余。
- 适用场景:数据库、虚拟化、关键业务(金融、电商)。
- 优点:高性能;冗余备份;可靠性高;故障恢复快(直接从镜像盘读,无需重算)。
- 缺点:成本高(容量只有一半);空间利用率低。
一句话:RAID 10 是「又稳又快」,代价是一半空间做镜像。注意它和「RAID 01」(先条带再镜像)顺序不同、可靠性也不同,别搞混。
4.6 RAID 50 / RAID 60(多组再条带)
原理:把多个 RAID 5(或 RAID 6)组再通过 RAID 0 条带化组合,规模更大、性能和冗余更强。


- 适用场景:大规模数据存储、图形渲染、虚拟化、大型数据库、大数据分析、视频流媒体。
- 优点:高性能 + 更高级别冗余。
- 缺点:成本高;配置管理复杂。
4.7 RAID 级别总结表
| RAID 0 | 2 | 无 | 0% | 高 | 高 | 低 |
| RAID 1 | 2 | 单个磁盘 | 50% | 高 | 低 | 中 |
| RAID 5 | 3 | 单个磁盘 | 1 / N | 中 | 低 | 中 |
| RAID 6 | 4 | 两个磁盘 | 2 / N | 中 | 低 | 高 |
| RAID 10 | 4 | 多个磁盘 | 50% | 高 | 中 | 高 |
| RAID 50 | 6 | 多个磁盘 | 1 / N | 高 | 中 | 高 |
| RAID 60 | 8 | 多个磁盘 | 50% | 高 | 中 | 高 |
选型口诀:要快不要命→RAID 0;要稳不怕贵→RAID 1;又快又稳还省盘→RAID 5;坏两块也不怕→RAID 6;数据库等关键业务→RAID 10。
第二部分:用 mdadm 管理软 RAID
Linux 提供 mdadm 工具来创建和管理软件 RAID。下面按 RAID0 → RAID1 → RAID5 依次完整走一遍「创建 → 查看 → 格式化挂载 → 故障演练 → 删除」。
五、管理 RAID 0
5.1 创建 RAID 0
# 安装 mdadm
[root@server ~ 16:38:03]# yum install -y mdadm
# 用 2 块盘(sdb、sdc)创建 raid0 设备 /dev/md0
[root@server ~ 17:53:51]# mdadm –create /dev/md0 –level=0 –raid-devices 2 /dev/sd{b,c}
mdadm: Defaulting to version 1.2 metadata
mdadm: array /dev/md0 started.
# 验证:sdb、sdc 挂到了 md0 下
[root@server ~ 17:55:09]# lsblk | grep -B1 md0
sdb 8:16 0 20G 0 disk
└─md0 9:0 0 40G 0 raid0
sdc 8:32 0 20G 0 disk
└─md0 9:0 0 40G 0 raid0
lsblk | grep -B1 md0 里 -B1 表示「显示匹配行以及它的前一行」(能看到 md0 上面挂的是哪块盘)。可以看到 2×20G = 40G 的 raid0 设备 /dev/md0 出现了。
–create 的参数:–level=0 指定级别、–raid-devices 2 指定成员盘数量、/dev/sd{b,c} 是指定的成员盘。
5.2 查看 RAID
# 查看 raid 概要信息(最常用)
[root@server ~ 17:55:32]# cat /proc/mdstat
Personalities : [raid6] [raid5] [raid4] [raid0]
md0 : active raid0 sdc[1] sdb[0]
41908224 blocks super 1.2 512k chunks
unused devices: <none>
# 查看 raid 设备详细信息
[root@server ~ 17:57:10]# mdadm –detail /dev/md0
/dev/md0:
Version : 1.2
Creation Time : Tue Sep 22 17:54:45 2026
Raid Level : raid0
Array Size : 41908224 (39.97 GiB 42.91 GB)
Raid Devices : 2
Total Devices : 2
Persistence : Superblock is persistent
Update Time : Tue Sep 22 17:54:45 2026
State : clean
Active Devices : 2
Working Devices : 2
Failed Devices : 0
Spare Devices : 0
Chunk Size : 512K
Consistency Policy : none
Name : server.feiyun.cloud:0 (local to host server.feiyun.cloud)
UUID : d585cb36:75172246:fde512c2:1ad283ac
Events : 0
Number Major Minor RaidDevice State
0 8 16 0 active sync /dev/sdb
1 8 32 1 active sync /dev/sdc
mdadm –detail /dev/md0 等价于 mdadm -D /dev/md0。需要关注的属性:
- Raid Level: raid0:级别;
- State: clean:状态正常;
- Chunk Size: 512K:条带块大小;
- 底部设备清单:哪些盘参与、各自状态(active sync)。
5.3 格式化和挂载
# 格式化(提示已有文件系统时,加 -f 强制)
[root@server ~ 17:57:24]# mkfs.xfs /dev/md0
mkfs.xfs: /dev/md0 appears to contain an existing filesystem (xfs).
mkfs.xfs: Use the -f option to force overwrite.
[root@server ~ 17:59:06]# mkfs.xfs -f /dev/md0
meta-data=/dev/md0 isize=512 agcount=16, agsize=654720 blks
= sectsz=512 attr=2, projid32bit=1
= crc=1 finobt=0, sparse=0
data = bsize=4096 blocks=10475520, imaxpct=25
= sunit=128 swidth=256 blks
naming =version 2 bsize=4096 ascii-ci=0 ftype=1
log =internal log bsize=4096 blocks=5120, version=2
= sectsz=512 sunit=8 blks, lazy-count=1
realtime =none extsz=4096 blocks=0, rtextents=0
# 建挂载点并挂载
[root@server ~ 17:59:13]# mkdir -p /raid/raid0
[root@server ~ 17:59:26]# mount /dev/md0 /raid/raid0
[root@server ~ 17:59:41]# df -h /raid/raid0
文件系统 容量 已用 可用 已用% 挂载点
/dev/md0 40G 33M 40G 1% /raid/raid0
RAID 设备和普通磁盘分区一样,格式化(mkfs.xfs)→ 挂载(mount)→ 使用,流程完全一致。
5.4 删除 RAID
# 1. 先卸载
[root@server ~ 17:59:50]# umount /raid/raid0
# 2. 停止阵列
[root@server ~ 18:01:04]# mdadm –stop /dev/md0
mdadm: stopped /dev/md0
# 3. 清除每块盘上的 superblock(RAID 元数据)
[root@server ~ 18:01:21]# mdadm –zero-superblock /dev/sd{b,c}
删除 RAID 三步:umount → mdadm –stop → zero-superblock。最后一步清掉成员盘上的元数据,否则重新做 RAID 时可能报「盘已被占用」。当然用 wipefs 也能清。
5.5 补充说明(RAID 0 的限制)
- RAID 0 条带不能增加新成员盘:
[root@server ~ 18:01:52]# mdadm –add /dev/md0 /dev/sdd
mdadm: add new device failed for /dev/sdd as 2: Invalid argument
- RAID 0 条带不能强制故障成员盘(因为它没有冗余,任何一块盘损坏整个阵列就废了):
[root@server ~ 18:03:47]# mdadm –fail /dev/md0 /dev/sdc
mdadm: Cannot remove /dev/sdc from /dev/md0, array will be failed.
六、管理 RAID 1
6.1 创建 RAID 1
[root@server ~ 18:06:04]# mdadm –create /dev/md1 –level=1 –raid-devices 2 /dev/sd{b,c}
mdadm: Note: this array has metadata at the start and
may not be suitable as a boot device. If you plan to
store '/boot' on this device please ensure that
your boot-loader understands md/v1.x metadata, or use
–metadata=0.90
Continue creating array? yes
mdadm: Defaulting to version 1.2 metadata
mdadm: array /dev/md1 started.
# 验证:2×20G 的 raid1,容量还是 20G(镜像)
[root@server ~ 18:07:30]# lsblk | grep -B1 md1
sdb 8:16 0 20G 0 disk
└─md1 9:1 0 20G 0 raid1
sdc 8:32 0 20G 0 disk
└─md1 9:1 0 20G 0 raid1
注意:2 块 20G 盘做 RAID 1,/dev/md1 容量仍是 20G(一半做镜像),印证了「RAID 1 容量减半」。
6.2 查看 RAID
[root@server ~ 18:06:50]# mdadm -D /dev/md1
/dev/md1:
Version : 1.2
Creation Time : Tue Sep 22 18:06:50 2026
Raid Level : raid1
Array Size : 20954112 (19.98 GiB 21.46 GB)
Used Dev Size : 20954112 (19.98 GiB 21.46 GB)
Raid Devices : 2
Total Devices : 2
Persistence : Superblock is persistent
Update Time : Tue Sep 22 18:07:23 2026
State : clean, resyncing
Active Devices : 2
Working Devices : 2
Failed Devices : 0
Spare Devices : 0
Consistency Policy : resync
Resync Status : 37% complete
Name : server.feiyun.cloud:1 (local to host server.feiyun.cloud)
UUID : 63cbbfed:b28b6524:a0d2f936:a14090d9
Events : 5
Number Major Minor RaidDevice State
0 8 16 0 active sync /dev/sdb
1 8 32 1 active sync /dev/sdc
需要关注的属性:
- Raid Level: raid1;
- State: clean, resyncing:正在同步(RAID 1 建好后要把一块盘的数据同步到另一块);
- Consistency Policy: resync:同步策略;
- Resync Status: 37% complete:同步进度;
- 设备清单。
6.3 格式化和挂载
先等同步完成(进度到 100%)再格式化挂载:
[root@server ~ 18:10:46]# mkfs.xfs /dev/md1
mkfs.xfs: /dev/md1 appears to contain an existing filesystem (xfs).
mkfs.xfs: Use the -f option to force overwrite.
[root@server ~ 18:11:06]# mkfs.xfs -f /dev/md1
meta-data=/dev/md1 isize=512 agcount=4, agsize=1309632 blks
= sectsz=512 attr=2, projid32bit=1
= crc=1 finobt=0, sparse=0
data = bsize=4096 blocks=5238528, imaxpct=25
= sunit=0 swidth=0 blks
naming =version 2 bsize=4096 ascii-ci=0 ftype=1
log =internal log bsize=4096 blocks=2560, version=2
= sectsz=512 sunit=0 blks, lazy-count=1
realtime =none extsz=4096 blocks=0, rtextents=0
[root@server ~ 18:11:13]# mkdir /raid/raid1
[root@server ~ 18:11:27]# mount /dev/md1 /raid/raid1
[root@server ~ 18:11:53]# df -h /raid/raid1
文件系统 容量 已用 可用 已用% 挂载点
/dev/md1 20G 33M 20G 1% /raid/raid1
# 创建测试数据
[root@server ~ 18:12:00]# cp /etc/ho* /raid/raid1
[root@server ~ 18:12:37]# ls /raid/raid1
host.conf hostname hosts hosts.allow hosts.deny
6.4 增加热备盘
# 把 sdd 加进来做热备盘
[root@server ~ 18:12:40]# mdadm –add /dev/md1 /dev/sdd
mdadm: added /dev/sdd
[root@server ~ 18:13:16]# mdadm -D /dev/md1 | tail -5
Number Major Minor RaidDevice State
0 8 16 0 active sync /dev/sdb
1 8 32 1 active sync /dev/sdc
2 8 48 – spare /dev/sdd
热备盘(spare):平时不存数据、挂在那待命,一旦某块盘故障就自动顶替。这是 RAID 高可用的关键一环。
6.5 模拟故障(验证热备顶替)
# 手动把 sdc 标记为故障
[root@server ~ 18:13:37]# mdadm –fail /dev/md1 /dev/sdc
mdadm: set /dev/sdc faulty in /dev/md1
[root@server ~ 18:14:30]# mdadm -D /dev/md1 | tail -5
Number Major Minor RaidDevice State
0 8 16 0 active sync /dev/sdb
2 8 48 1 spare rebuilding /dev/sdd
1 8 32 – faulty /dev/sdc
热备盘 /dev/sdd 立刻顶替故障的 sdc,并开始 rebuilding(重建同步)。这是 RAID 1 的容错价值所在。
# 数据依然完好可访问
[root@server ~ 18:14:36]# ls /raid/raid1
host.conf hostname hosts hosts.allow hosts.deny
6.6 删除故障磁盘
# 把故障盘 sdc 移出阵列
[root@server ~ 18:15:45]# mdadm –remove /dev/md1 /dev/sdc
mdadm: hot removed /dev/sdc from /dev/md1
[root@server ~ 18:17:03]# mdadm -D /dev/md1 | tail -5
Events : 40
Number Major Minor RaidDevice State
0 8 16 0 active sync /dev/sdb
2 8 48 1 active sync /dev/sdd
移出故障盘后,阵列恢复正常(sdb + sdd 两块 active)。
6.7 删除 RAID
[root@server ~ 18:17:11]# umount /dev/md1
[root@server ~ 18:23:00]# mdadm –stop /dev/md1
mdadm: stopped /dev/md1
[root@server ~ 18:23:12]# mdadm –zero-superblock /dev/sd{b..d}
6.8 补充说明
RAID 1 的设计初衷是数据冗余和可靠性,而不是增加容量。因此即使添加新硬盘做扩容,由于镜像机制,总容量也不会增加。
七、管理 RAID 5
7.1 创建 RAID 5
# 4 块盘做 raid5,得 60G 可用(4-1)×20G
[root@server ~ 18:24:31]# mdadm –create /dev/md5 –level=5 –raid-devices=4 /dev/sd{b..e}
mdadm: Defaulting to version 1.2 metadata
mdadm: array /dev/md5 started.
# 验证
[root@server ~ 18:25:23]# lsblk | grep -B1 md5
sdb 8:16 0 20G 0 disk
└─md5 9:5 0 60G 0 raid5
sdc 8:32 0 20G 0 disk
└─md5 9:5 0 60G 0 raid5
sdd 8:48 0 20G 0 disk
└─md5 9:5 0 60G 0 raid5
sde 8:64 0 20G 0 disk
└─md5 9:5 0 60G 0 raid5
7.2 查看 RAID
[root@server ~ 18:25:53]# mdadm -D /dev/md5
/dev/md5:
Version : 1.2
Creation Time : Tue Sep 22 18:25:23 2026
Raid Level : raid5
Array Size : 62862336 (59.95 GiB 64.37 GB)
Used Dev Size : 20954112 (19.98 GiB 21.46 GB)
Raid Devices : 4
Total Devices : 4
Persistence : Superblock is persistent
Update Time : Tue Sep 22 18:26:48 2026
State : clean, degraded, recovering
Active Devices : 3
Working Devices : 4
Failed Devices : 0
Spare Devices : 1
Layout : left-symmetric
Chunk Size : 512K
Consistency Policy : resync
Rebuild Status : 83% complete
Name : server.feiyun.cloud:5 (local to host server.feiyun.cloud)
UUID : 8103634a:422d3fec:734dff40:2579d5eb
Events : 14
Number Major Minor RaidDevice State
0 8 16 0 active sync /dev/sdb
1 8 32 1 active sync /dev/sdc
2 8 48 2 active sync /dev/sdd
4 8 64 3 spare rebuilding /dev/sde
需关注:State: clean, degraded, recovering(构建中)、Rebuild Status: 83% complete(构建进度)。RAID 5 刚建好时也在做奇偶校验的初始化构建。
7.3 格式化和挂载
注意:等待 raid 构建完成后再格式化。
[root@server ~ 18:28:13]# mkfs.xfs -f /dev/md5
meta-data=/dev/md5 isize=512 agcount=16, agsize=982144 blks
= sectsz=512 attr=2, projid32bit=1
= crc=1 finobt=0, sparse=0
data = bsize=4096 blocks=15714304, imaxpct=25
= sunit=128 swidth=384 blks
naming =version 2 bsize=4096 ascii-ci=0 ftype=1
log =internal log bsize=4096 blocks=7680, version=2
= sectsz=512 sunit=8 blks, lazy-count=1
realtime =none extsz=4096 blocks=0, rtextents=0
[root@server ~ 18:28:41]# mount /dev/md5 /raid/raid5
[root@server ~ 18:28:55]# df -h /raid/raid5
文件系统 容量 已用 可用 已用% 挂载点
/dev/md5 60G 33M 60G 1% /raid/raid5
# 创建数据
[root@server ~ 18:29:04]# cp /etc/ho* /raid/raid5
[root@server ~ 18:29:48]# ls /raid/raid5
host.conf hostname hosts hosts.allow hosts.deny
7.4 增加热备盘
[root@server ~ 18:29:54]# mdadm –add /dev/md5 /dev/sdf
mdadm: added /dev/sdf
[root@server ~ 18:30:28]# mdadm –detail /dev/md5 | tail -7
Number Major Minor RaidDevice State
0 8 16 0 active sync /dev/sdb
1 8 32 1 active sync /dev/sdc
2 8 48 2 active sync /dev/sdd
4 8 64 3 active sync /dev/sde
5 8 80 – spare /dev/sdf
7.5 模拟故障
# 故障 sdb
[root@server ~ 18:30:49]# mdadm –fail /dev/md5 /dev/sdb
mdadm: set /dev/sdb faulty in /dev/md5
[root@server ~ 18:31:37]# mdadm –detail /dev/md5 | tail -7
Number Major Minor RaidDevice State
5 8 80 0 spare rebuilding /dev/sdf
1 8 32 1 active sync /dev/sdc
2 8 48 2 active sync /dev/sdd
4 8 64 3 active sync /dev/sde
0 8 16 – faulty /dev/sdb
热备盘 /dev/sdf 立刻顶替故障盘,并重建同步。
# 数据依然正常访问
[root@server ~ 18:31:40]# ls /raid/raid5
host.conf hostname hosts hosts.allow hosts.deny
7.6 删除故障磁盘
[root@server ~ 18:32:17]# mdadm –remove /dev/md5 /dev/sdb
mdadm: hot removed /dev/sdb from /dev/md5
[root@server ~ 18:33:11]# mdadm –detail /dev/md5 | tail -5
Number Major Minor RaidDevice State
5 8 80 0 active sync /dev/sdf
1 8 32 1 active sync /dev/sdc
2 8 48 2 active sync /dev/sdd
4 8 64 3 active sync /dev/sde
7.7 扩容 RAID
对于 RAID 5,只能扩容,不能减容。
注意:阵列只有在正常状态下才能扩容,降级(degraded)和重构(rebuilding)时不允许扩容。
# 先看当前状态(sdb、sdg 又作为 spare 加回来了)
[root@server ~ 18:34:26]# mdadm –detail /dev/md5 | tail -8
Number Major Minor RaidDevice State
5 8 80 0 active sync /dev/sdf
1 8 32 1 active sync /dev/sdc
2 8 48 2 active sync /dev/sdd
4 8 64 3 active sync /dev/sde
6 8 16 – spare /dev/sdb
7 8 96 – spare /dev/sdg
# -G 表示 grow(扩展),把成员盘数从 4 扩到 5
[root@server ~ 18:34:41]# mdadm –grow /dev/md5 –raid-devices 5
# 等待重组(reshaping)完成
[root@server ~ 18:35:17]# mdadm –detail /dev/md5
/dev/md5:
Version : 1.2
Creation Time : Tue Sep 22 18:25:23 2026
Raid Level : raid5
Array Size : 62862336 (59.95 GiB 64.37 GB)
Used Dev Size : 20954112 (19.98 GiB 21.46 GB)
Raid Devices : 5
Total Devices : 6
Persistence : Superblock is persistent
Update Time : Tue Sep 22 18:35:27 2026
State : clean, reshaping
Active Devices : 5
Working Devices : 6
Failed Devices : 0
Spare Devices : 1
Layout : left-symmetric
Chunk Size : 512K
Consistency Policy : resync
Reshape Status : 10% complete
Delta Devices : 1, (4–>5)
Name : server.feiyun.cloud:5 (local to host server.feiyun.cloud)
UUID : 8103634a:422d3fec:734dff40:2579d5eb
Events : 72
Number Major Minor RaidDevice State
5 8 80 0 active sync /dev/sdf
1 8 32 1 active sync /dev/sdc
2 8 48 2 active sync /dev/sdd
4 8 64 3 active sync /dev/sde
7 8 96 4 active sync /dev/sdg
6 8 16 – spare /dev/sdb
# 确认 raid 容量:从 60G 变成 80G(增加了 20G,即多了一块盘)
[root@server ~ 18:35:28]# lsblk /dev/md5
NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINT
md5 9:5 0 80G 0 raid5 /raid/raid5
# 扩容后还要扩展文件系统!否则新空间用不上
[root@server ~ 18:40:06]# xfs_growfs /raid/raid5
meta-data=/dev/md5 isize=512 agcount=16, agsize=982144 blks
= sectsz=512 attr=2, projid32bit=1
= crc=1 finobt=0 spinodes=0
data = bsize=4096 blocks=15714304, imaxpct=25
= sunit=128 swidth=384 blks
naming =version 2 bsize=4096 ascii-ci=0 ftype=1
log =internal bsize=4096 blocks=7680, version=2
= sectsz=512 sunit=8 blks, lazy-count=1
realtime =none extsz=4096 blocks=0, rtextents=0
data blocks changed from 15714304 to 20954112
[root@server ~ 18:40:37]# df -h /raid/raid5
文件系统 容量 已用 可用 已用% 挂载点
/dev/md5 80G 34M 80G 1% /raid/raid5
思考:为什么扩容磁盘后还要扩展文件系统?
答:新加的磁盘只让 RAID 设备的块设备容量变大了,但上面的 XFS 文件系统还停留在原来的大小,新空间「没被文件系统接管」,所以要用 xfs_growfs 把文件系统撑大到新容量。块设备扩容和执行文件系统扩容是两步,缺一不可。
7.8 删除 RAID
[root@server ~ 18:40:56]# umount /dev/md5
[root@server ~ 18:44:26]# mdadm –stop /dev/md5
mdadm: stopped /dev/md5
[root@server ~ 18:44:37]# mdadm –zero-superblock /dev/sd{b..g}
7.9 重构(重新装配)RAID
# stop 之后、清除 superblock 之前,想恢复原来的 md5 就用 –assemble,数据不会丢失
[root@centos7 ~]# mdadm –assemble /dev/md5 /dev/sd{b..g}
–assemble(装配)是 –stop 的逆操作:把还在成员盘上的 RAID 元数据重新识别、组装回原来的阵列。关键是 superblock 没被清掉(没做 –zero-superblock)才能装配回来,数据不丢。
第三部分:LVM 逻辑卷管理
八、为什么要用 LVM
8.1 传统硬盘分区方案的缺点
- 硬盘分区空间必须连续,扩容很麻烦——尤其是要扩容的分区后面没有空闲空间时;
- 分区创建的文件系统不能跨多块硬盘,受单块盘容量限制;
- 单块硬盘损坏,其上的文件系统数据也会丢失(没有冗余)。
8.2 逻辑卷管理方案的优点
- 更灵活地扩展和缩减文件系统空间;
- 文件系统可以跨多块硬盘,能创建超大容量文件系统;
- 可以创建镜像卷保证冗余,即使单块硬盘损坏,数据也不会丢失;
- 可以创建快照,保留某一时刻的数据(类似虚拟机快照)。
一句话:传统分区是「定死的格子」,LVM 是「能随意伸缩的存储池」。
九、LVM 基本概念
LVM 是 Logical Volume Manager(逻辑卷管理)的简称。它把若干磁盘或分区连成一个整块的卷组(存储池),管理员可以在卷组上任意创建逻辑卷,再在逻辑卷上建文件系统。
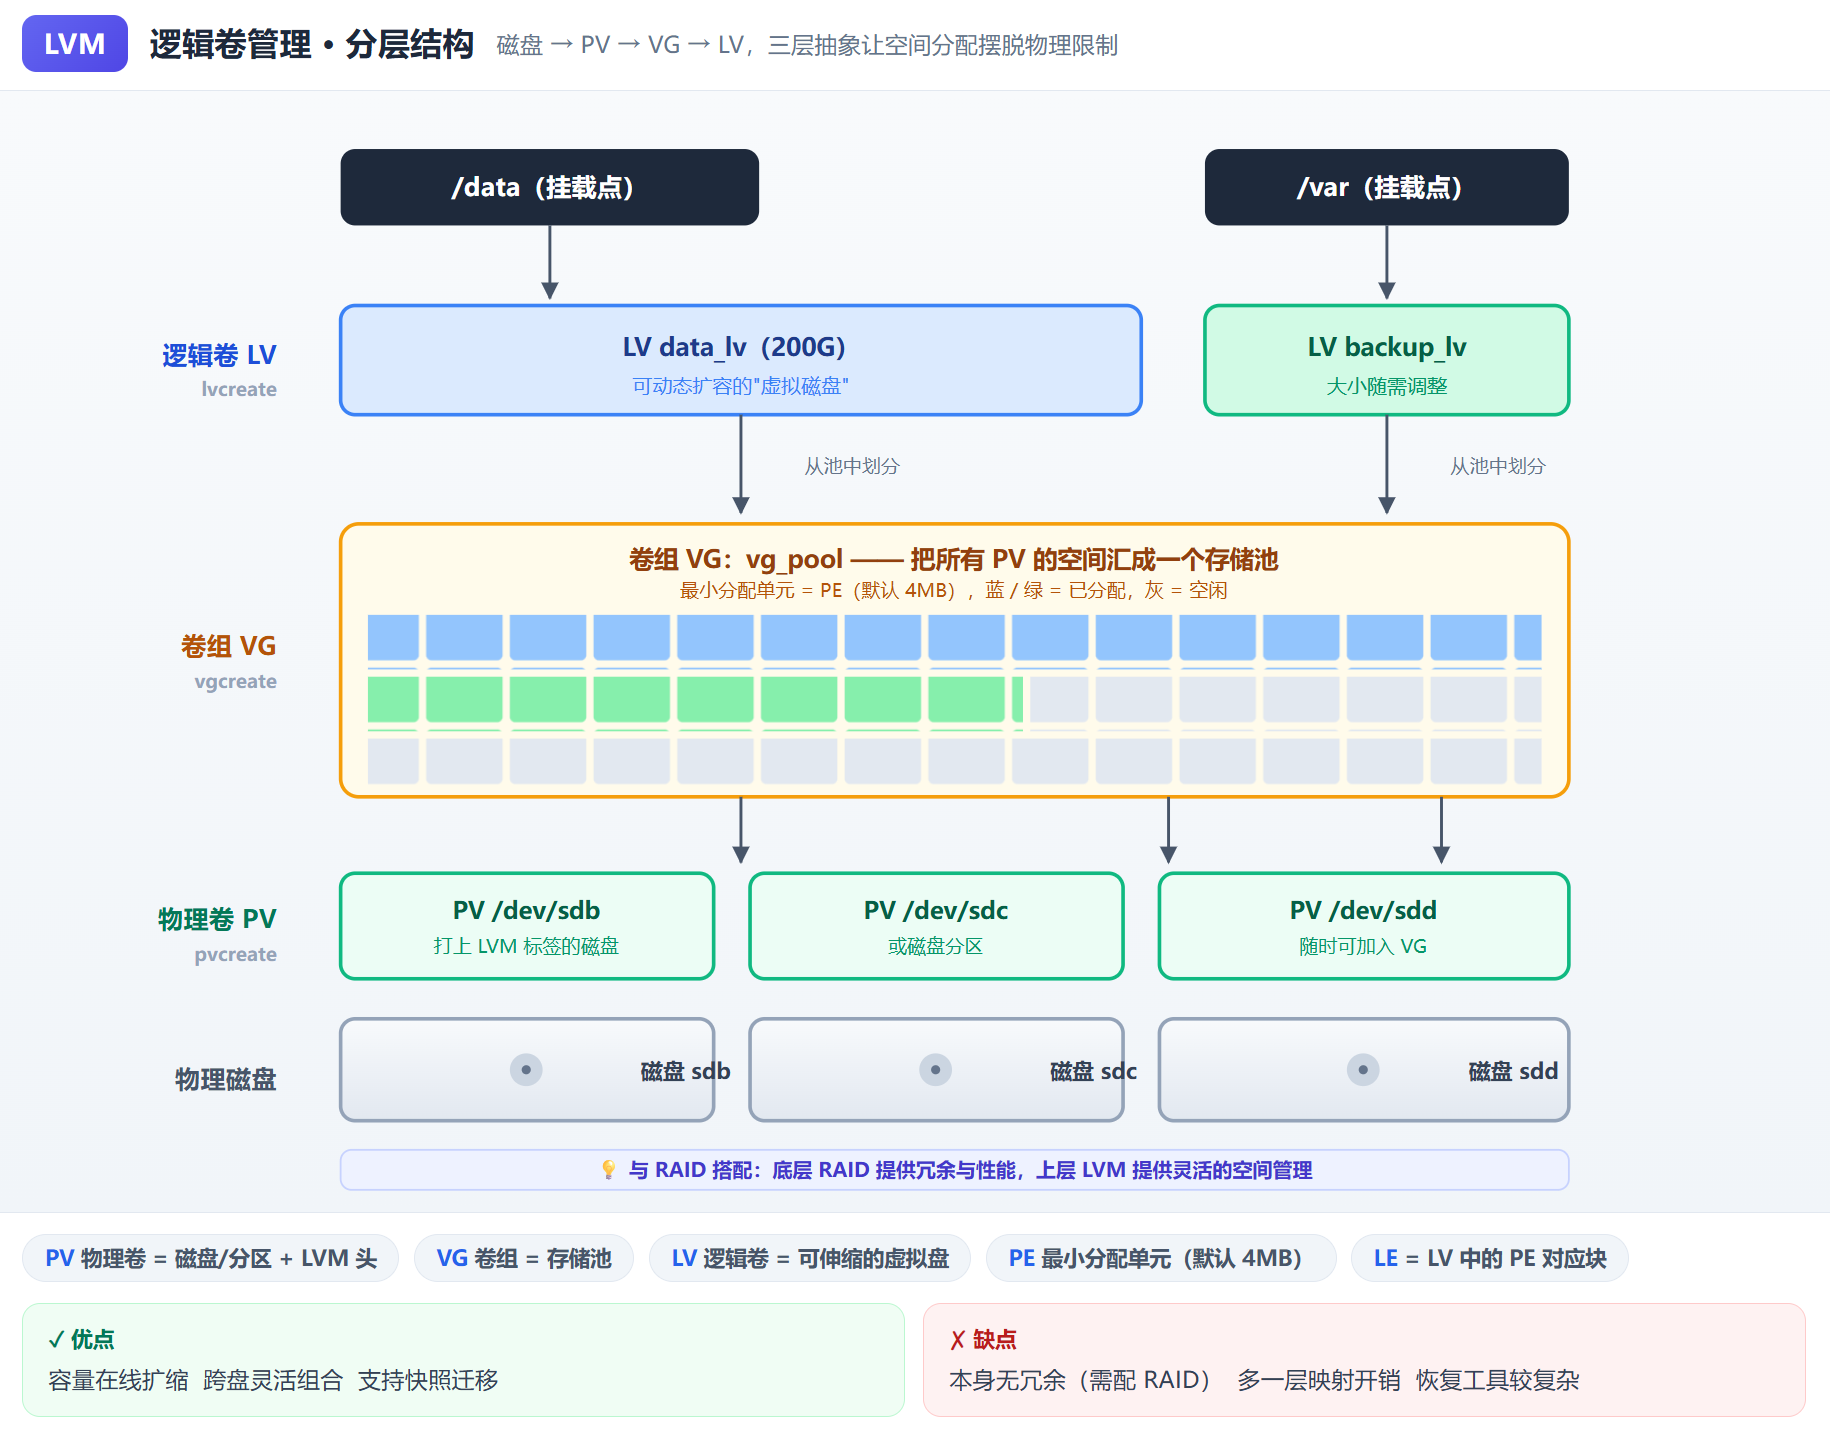
三级结构:
| PV | Physical Volume(物理卷) | LVM 的基本存储块,由块设备(磁盘/分区/RAID)创建 | 一块块硬盘 |
| VG | Volume Group(卷组) | 由一个或多个 PV 组成的逻辑存储空间 | 一个「存储池」 |
| LV | Logical Volume(逻辑卷) | 从 VG 中划分出来的逻辑空间 | 池里的「分区」 |
关系一句话:多个 PV 组成 VG,VG 里创建多个 LV,LV 上建文件系统给用户用。
LVM 基本流程:① 创建物理卷(pvcreate)→ ② 创建卷组(vgcreate)→ ③ 创建逻辑卷(lvcreate)。
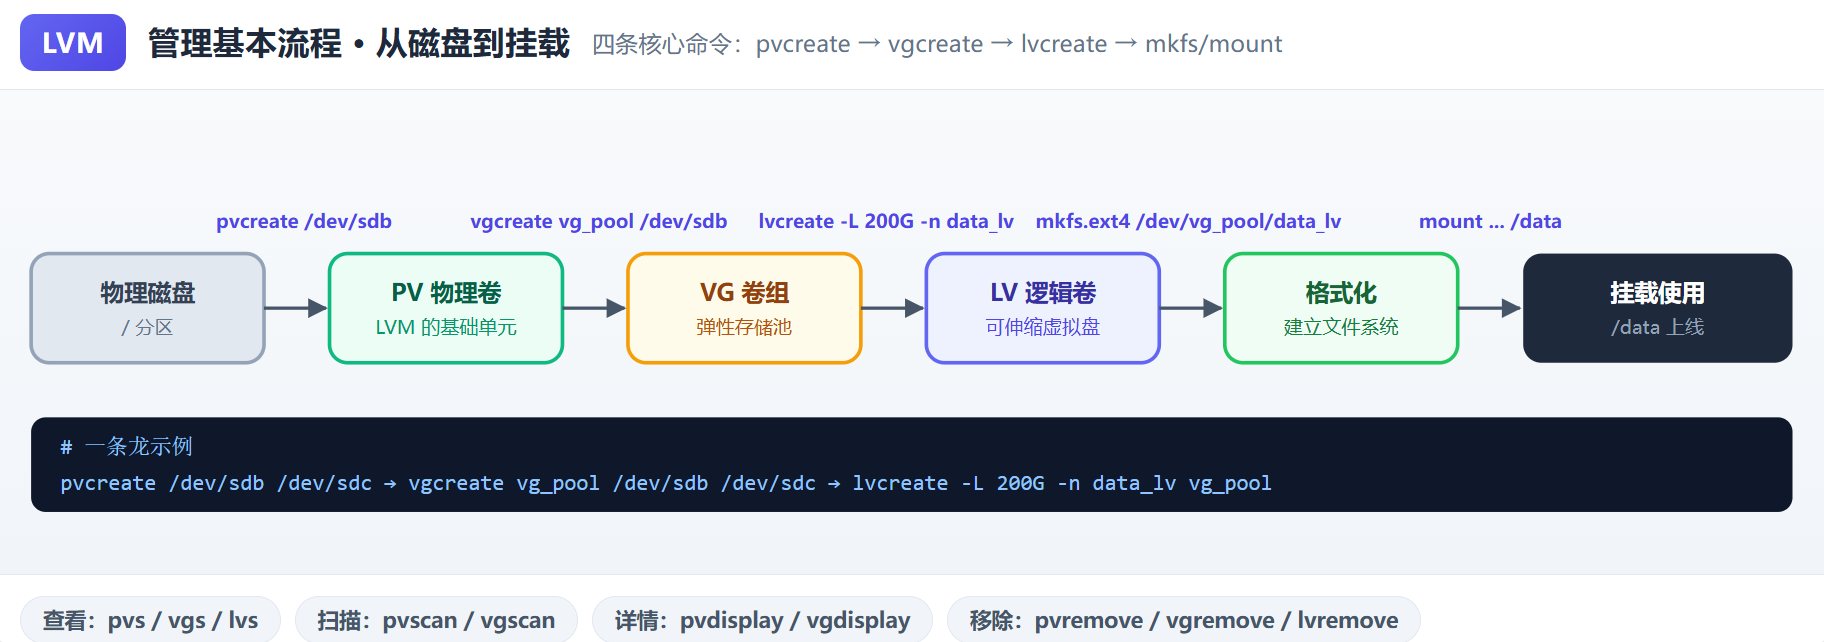
十、逻辑卷基本管理
10.1 创建物理卷(PV)
# 创建单个 PV
[root@server ~ 19:11:26]# pvcreate /dev/sdb
Physical volume "/dev/sdb" successfully created.
# 一次创建多个 PV
[root@server ~ 19:11:36]# pvcreate /dev/sd{c,d}
Physical volume "/dev/sdc" successfully created.
Physical volume "/dev/sdd" successfully created.
# 查看 PV 列表(pvs)
[root@server ~ 19:11:51]# pvs
PV VG Fmt Attr PSize PFree
/dev/sda2 centos lvm2 a– <199.00g 4.00m
/dev/sdb lvm2 — 20.00g 20.00g
/dev/sdc lvm2 — 20.00g 20.00g
/dev/sdd lvm2 — 20.00g 20.00g
# 查看单个 PV 详细信息
[root@server ~ 19:11:54]# pvdisplay /dev/sdb
"/dev/sdb" is a new physical volume of "20.00 GiB"
— NEW Physical volume —
PV Name /dev/sdb
VG Name
PV Size 20.00 GiB
Allocatable NO
PE Size 0
Total PE 0
Free PE 0
Allocated PE 0
PV UUID FeW2jz-KdUB-si74-Qemh-fLBa-4wrU-tHtEGL
pvs 是「list」的简表(类似 ls),pvdisplay 是「detail」的详细版(类似 ls -l)。/dev/sda2 是装系统时 CentOS 自己分的 PV,属 centos 卷组;我们新建的 sdb/sdc/sdd 还没有 VG(VG 列为空)。
10.2 创建卷组(VG)
# 创建包含单个 PV 的 VG
[root@server ~ 19:12:07]# vgcreate webapp /dev/sdb
Volume group "webapp" successfully created
# 创建包含多个 PV 的 VG
[root@server ~ 19:13:24]# vgcreate dbapp /dev/sd{c,d}
Volume group "dbapp" successfully created
[root@server ~ 19:13:39]# pvs
PV VG Fmt Attr PSize PFree
/dev/sda2 centos lvm2 a– <199.00g 4.00m
/dev/sdb webapp lvm2 a– <20.00g <20.00g
/dev/sdc dbapp lvm2 a– <20.00g <20.00g
/dev/sdd dbapp lvm2 a– <20.00g <20.00g
# 查看 VG 列表(vgs)
[root@server ~ 19:13:46]# vgs
VG #PV #LV #SN Attr VSize VFree
centos 1 3 0 wz–n- <199.00g 4.00m
dbapp 2 0 0 wz–n- 39.99g 39.99g
webapp 1 0 0 wz–n- <20.00g <20.00g
# 查看单个 VG 详细信息
[root@server ~ 19:13:51]# vgdisplay dbapp
— Volume group —
VG Name dbapp
System ID
Format lvm2
Metadata Areas 2
Metadata Sequence No 1
VG Access read/write
VG Status resizable
MAX LV 0
Cur LV 0
Open LV 0
Max PV 0
Cur PV 2
Act PV 2
VG Size 39.99 GiB
PE Size 4.00 MiB
Total PE 10238
Alloc PE / Size 0 / 0
Free PE / Size 10238 / 39.99 GiB
VG UUID kHrWwc-Lx8U-eH7v-vWHv-D9eW-IURe-4nC2Le
vgs 里 #PV #LV #SN 分别是:物理卷数、逻辑卷数、快照数。dbapp 由 2 个 PV(sdc+sdd)组成,所以 VSize 约 39.99G。
10.3 创建逻辑卷(LV)
# 从 webapp 卷组建 5G 的 webapp01
[root@server ~ 19:14:04]# lvcreate -n webapp01 -L 5G webapp
Logical volume "webapp01" created.
# 从 dbapp 卷组建 25G 的 data01
[root@server ~ 19:15:53]# lvcreate -n data01 -L 25G dbapp
WARNING: ext4 signature detected on /dev/dbapp/data01 at offset 1080. Wipe it? [y/n]: y
Wiping ext4 signature on /dev/dbapp/data01.
Logical volume "data01" created.
# 查看 LV 列表
[root@server ~ 19:16:17]# lvs
LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert
home centos -wi-ao—- 146.99g
root centos -wi-ao—- 50.00g
swap centos -wi-ao—- 2.00g
data01 dbapp -wi-a—– 25.00g
webapp01 webapp -wi-a—– 5.00g
lvcreate -n 名字 -L 大小 卷组名:-n 指定 LV 名称、-L 指定容量。
逻辑卷设备名支持以下三种写法:
- /dev/vgname/lvname
- /dev/mapper/vgname-lvname
- /dev/dm-N
# 前两种其实是同一个设备的软链接,都指向 /dev/dm-N
[root@server ~ 19:16:49]# ls -l /dev/dbapp/data01 /dev/mapper/dbapp-data01
lrwxrwxrwx 1 root root 7 9月 22 19:16 /dev/dbapp/data01 –> ../dm-4
lrwxrwxrwx 1 root root 7 9月 22 19:16 /dev/mapper/dbapp-data01 –> ../dm-4
查看单个 LV 详细信息:
[root@server ~ 19:17:01]# lvdisplay /dev/dbapp/data01
— Logical volume —
LV Path /dev/dbapp/data01
LV Name data01
VG Name dbapp
LV UUID AnYOcX-46Vd-mYrc-eyGF-Rya7-iAA4-EvUdH9
LV Write Access read/write
LV Creation host, time server.feiyun.cloud, 2026-09-22 19:16:15 +0800
LV Status available
# open 0
LV Size 25.00 GiB
Current LE 6400
Segments 2
Allocation inherit
Read ahead sectors auto
– currently set to 8192
Block device 253:4
# 再看 PV 空间消耗
[root@server ~ 19:17:33]# pvs
PV VG Fmt Attr PSize PFree
/dev/sda2 centos lvm2 a– <199.00g 4.00m
/dev/sdb webapp lvm2 a– <20.00g <15.00g
/dev/sdc dbapp lvm2 a– <20.00g 0
/dev/sdd dbapp lvm2 a– <20.00g 14.99g
可以看到:data01 的 25G 先占满了 /dev/sdc(20G,PFree 变 0),又用了 /dev/sdd 的 5G(PFree 剩 14.99g)。这说明 LV 可以跨多个 PV。
10.4 创建文件系统并挂载
[root@server ~ 19:18:08]# mkfs.xfs /dev/webapp/webapp01
meta-data=/dev/webapp/webapp01 isize=512 agcount=4, agsize=327680 blks
= sectsz=512 attr=2, projid32bit=1
= crc=1 finobt=0, sparse=0
data = bsize=4096 blocks=1310720, imaxpct=25
= sunit=0 swidth=0 blks
naming =version 2 bsize=4096 ascii-ci=0 ftype=1
log =internal log bsize=4096 blocks=2560, version=2
= sectsz=512 sunit=0 blks, lazy-count=1
realtime =none extsz=4096 blocks=0, rtextents=0
[root@server ~ 19:18:45]# mount /dev/webapp/webapp01 /usr/share/nginx/html
逻辑卷的使用方式和普通分区完全一样:格式化 → 挂载 → 用。基于 LVM 的文件系统做持久化挂载,同样要改 /etc/fstab。
10.5 清理(删除 LV → VG → PV)
# 1. 卸载文件系统
[root@server ~ 19:19:07]# umount /dev/webapp/webapp01
# 2. 删除 LV
[root@server ~ 19:19:51]# lvremove /dev/webapp/webapp01 /dev/dbapp/data01
Do you really want to remove active logical volume webapp/webapp01? [y/n]: y
Logical volume "webapp01" successfully removed
Do you really want to remove active logical volume dbapp/data01? [y/n]: y
Logical volume "data01" successfully removed
# 3. 删除 VG
[root@server ~ 19:20:10]# vgremove webapp dbapp
Volume group "webapp" successfully removed
Volume group "dbapp" successfully removed
# 4. 删除 PV
[root@server ~ 19:21:13]# pvremove /dev/sd{b..d}
Labels on physical volume "/dev/sdb" successfully wiped.
Labels on physical volume "/dev/sdc" successfully wiped.
Labels on physical volume "/dev/sdd" successfully wiped.
清理顺序要反过来:卸载 → lvremove → vgremove → pvremove(先删上层 LV,再删 VG,最后删 PV)。不能跳级删。
十一、扩展和缩减卷组
11.1 环境准备
[root@server ~ 19:21:31]# vgcreate webapp /dev/sdb
Physical volume "/dev/sdb" successfully created.
Volume group "webapp" successfully created
[root@server ~ 19:22:20]# lvcreate -n webapp01 -L 10G webapp
WARNING: xfs signature detected on /dev/webapp/webapp01 at offset 0. Wipe it? [y/n]: y
Wiping xfs signature on /dev/webapp/webapp01.
Logical volume "webapp01" created.
小细节:vgcreate 时如果指定的块设备还不是物理卷,会自动先把它创建为 PV(所以上面能看到 “Physical volume created” 的提示)。
11.2 扩展卷组(vgextend)
卷组空间不足时,向卷组里加新的物理卷即可扩展:
# 把 sdc、sdd 加进 webapp 卷组
[root@server ~ 19:22:43]# vgextend webapp /dev/sd{c,d}
Physical volume "/dev/sdc" successfully created.
Physical volume "/dev/sdd" successfully created.
Volume group "webapp" successfully extended
11.3 缩减卷组(vgreduce)
卷组里有多余的 PV、或要更换小容量的 PV 时,把 PV 从卷组里剔除。删除前确保 PV 不在使用中。
[root@server ~ 19:23:29]# pvs
PV VG Fmt Attr PSize PFree
/dev/sda2 centos lvm2 a– <199.00g 4.00m
/dev/sdb webapp lvm2 a– <20.00g <10.00g
/dev/sdc webapp lvm2 a– <20.00g <20.00g
/dev/sdd webapp lvm2 a– <20.00g <20.00g
# 直接把还在使用的 sdb 从 webapp 剔除 → 报错
[root@server ~ 19:23:47]# vgreduce webapp /dev/sdb
Physical volume "/dev/sdb" still in use
# 解决:先把 sdb 上的数据挪走(pvmove)
# 挪到卷组其他 PV(自动分配)
[root@server ~ 19:24:05]# pvmove /dev/sdb
# 或者挪到指定 PV
[root@server ~ 19:24:05]# pvmove /dev/sdb /dev/sdd
/dev/sdb: Moved: 1.52%
/dev/sdb: Moved: 100.00%
# 数据挪走后安装可正常剔除
[root@server ~ 19:24:49]# pvs
PV VG Fmt Attr PSize PFree
/dev/sda2 centos lvm2 a– <199.00g 4.00m
/dev/sdb webapp lvm2 a– <20.00g <20.00g
/dev/sdc webapp lvm2 a– <20.00g <10.00g
/dev/sdd webapp lvm2 a– <20.00g <20.00g
[root@server ~ 19:25:44]# pvs
PV VG Fmt Attr PSize PFree
/dev/sda2 centos lvm2 a– <199.00g 4.00m
/dev/sdb lvm2 — 20.00g 20.00g
/dev/sdc webapp lvm2 a– <20.00g <10.00g
/dev/sdd webapp lvm2 a– <20.00g <20.00g
关键套路:vgreduce 报 still in use → 先用 pvmove 把该 PV 上的数据搬到别的 PV → 再 vgreduce 剔除。pvmove 就是把数据在线搬移,搬完这块盘就腾空了。
十二、扩展和缩减逻辑卷
12.1 扩展逻辑卷(lvextend)
卷组空间充足时,可以扩展逻辑卷:
# +2G(在原来的基础上加 2G)
[root@server ~ 19:25:50]# lvextend -L +2G /dev/webapp/webapp01
Size of logical volume webapp/webapp01 changed from 10.00 GiB (2560 extents) to 12.00 GiB (3072 extents).
Logical volume webapp/webapp01 successfully resized.
[root@server ~ 19:28:36]# lvs /dev/webapp/webapp01
LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert
webapp01 webapp -wi-a—– 12.00g
-L +2G 是「加 2G」,-L 12G 是「直接设成 12G」,注意 + 号的含义。
12.2 缩减逻辑卷(lvreduce)
# -2G(减 2G)
[root@server ~ 19:28:45]# lvreduce -L -2G /dev/webapp/webapp01
WARNING: Reducing active logical volume to 10.00 GiB.
THIS MAY DESTROY YOUR DATA (filesystem etc.)
Do you really want to reduce webapp/webapp01? [y/n]: y
Size of logical volume webapp/webapp01 changed from 12.00 GiB (3072 extents) to 10.00 GiB (2560 extents).
Logical volume webapp/webapp01 successfully resized.
[root@server ~ 19:29:13]# lvs /dev/webapp/webapp01
LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert
webapp01 webapp -wi-a—– 10.00g
十三、扩展和缩减文件系统
前面扩/缩的都是「块设备」层面,最终落地到文件系统时,不同文件系统支持的能力不同:
| XFS | ✅ 支持 | ❌ 不支持 |
| EXT4 | ✅ 支持 | ✅ 支持 |
13.1 扩展 XFS 文件系统
XFS 只支持扩展,不支持缩减。
环境准备(格式化、挂载、建数据):
[root@server ~ 19:29:21]# mkfs.xfs /dev/webapp/webapp01
meta-data=/dev/webapp/webapp01 isize=512 agcount=4, agsize=655360 blks
= sectsz=512 attr=2, projid32bit=1
= crc=1 finobt=0, sparse=0
data = bsize=4096 blocks=2621440, imaxpct=25
= sunit=0 swidth=0 blks
naming =version 2 bsize=4096 ascii-ci=0 ftype=1
log =internal log bsize=4096 blocks=2560, version=2
= sectsz=512 sunit=0 blks, lazy-count=1
realtime =none extsz=4096 blocks=0, rtextents=0
[root@server ~ 19:30:07]# mkdir /usr/share/nginx/html
[root@server ~ 19:30:18]# mount /dev/webapp/webapp01 /usr/share/nginx/html
[root@server ~ 19:30:47]# cp /etc/ho* /usr/share/nginx/html
[root@server ~ 19:30:58]# ls /usr/share/nginx/html
host.conf hostname hosts hosts.allow hosts.deny
扩展两步走:
# 第一步:扩展逻辑卷
[root@server ~ 19:32:28]# lvextend -L 15G /dev/webapp/webapp01
Size of logical volume webapp/webapp01 changed from 10.00 GiB (2560 extents) to 15.00 GiB (3840 extents).
Logical volume webapp/webapp01 successfully resized.
[root@server ~ 19:32:37]# lvs /dev/webapp/webapp01
LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert
webapp01 webapp -wi-ao—- 15.00g
# 第二步:扩展文件系统(xfs_growfs)
[root@server ~ 19:32:46]# xfs_growfs /usr/share/nginx/html
meta-data=/dev/mapper/webapp-webapp01 isize=512 agcount=4, agsize=655360 blks
= sectsz=512 attr=2, projid32bit=1
= crc=1 finobt=0 spinodes=0
data = bsize=4096 blocks=2621440, imaxpct=25
= sunit=0 swidth=0 blks
naming =version 2 bsize=4096 ascii-ci=0 ftype=1
log =internal bsize=4096 blocks=2560, version=2
= sectsz=512 sunit=0 blks, lazy-count=1
realtime =none extsz=4096 blocks=0, rtextents=0
data blocks changed from 2621440 to 3932160
[root@server ~ 19:33:03]# df -h /usr/share/nginx/html/
文件系统 容量 已用 可用 已用% 挂载点
/dev/mapper/webapp-webapp01 15G 33M 15G 1% /usr/share/nginx/html
# 数据完好
[root@server ~ 19:33:25]# ls /usr/share/nginx/html
host.conf hostname hosts hosts.allow hosts.deny
# 一步到位:lvextend -r 同时扩块设备和文件系统(r = resize)
[root@server ~ 19:33:32]# lvextend -rL 20G /dev/webapp/webapp01
Size of logical volume webapp/webapp01 changed from 15.00 GiB (3840 extents) to 20.00 GiB (5120 extents).
Logical volume webapp/webapp01 successfully resized.
meta-data=/dev/mapper/webapp-webapp01 isize=512 agcount=6, agsize=655360 blks
= sectsz=512 attr=2, projid32bit=1
= crc=1 finobt=0 spinodes=0
data = bsize=4096 blocks=3932160, imaxpct=25
= sunit=0 swidth=0 blks
naming =version 2 bsize=4096 ascii-ci=0 ftype=1
log =internal bsize=4096 blocks=2560, version=2
= sectsz=512 sunit=0 blks, lazy-count=1
realtime =none extsz=4096 blocks=0, rtextents=0
data blocks changed from 3932160 to 5242880
[root@server ~ 19:34:46]# lvs /dev/webapp/webapp01
LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert
webapp01 webapp -wi-ao—- 20.00g
[root@server ~ 19:34:53]# df -h /usr/share/nginx/html
文件系统 容量 已用 可用 已用% 挂载点
/dev/mapper/webapp-webapp01 20G 33M 20G 1% /usr/share/nginx/html
lvextend -r 的妙用:-r(resizefs)会自动调用 xfs_growfs/resize2fs 同步扩展文件系统,省去「先 lvextend 再 xfs_growfs」两步。
13.2 扩展 EXT4 文件系统
EXT4 既支持扩展也支持缩减。
环境准备(格式化、挂载、建数据):
[root@server ~ 19:35:08]# umount /usr/share/nginx/html
[root@server ~ 19:35:39]# mkfs.ext4 /dev/webapp/webapp01
[root@server ~ 19:35:51]# mount /dev/webapp/webapp01 /usr/share/nginx/html
[root@server ~ 19:36:21]# df -h /usr/share/nginx/html
文件系统 容量 已用 可用 已用% 挂载点
/dev/mapper/webapp-webapp01 20G 45M 19G 1% /usr/share/nginx/html
[root@server ~ 19:36:28]# cp /etc/ho* /usr/share/nginx/html
[root@server ~ 19:36:38]# ls /usr/share/nginx/html
host.conf hostname hosts hosts.allow hosts.deny lost+found
注意 EXT4 格式化后挂载,目录里多了个 lost+found(XFS 没有),它是 ext 系列文件系统放损坏恢复文件的地方。
扩展两步走:
# 第一步:扩展逻辑卷
[root@server ~ 19:36:44]# lvextend -L 25G /dev/webapp/webapp01
Size of logical volume webapp/webapp01 changed from 20.00 GiB (5120 extents) to 25.00 GiB (6400 extents).
Logical volume webapp/webapp01 successfully resized.
[root@server ~ 19:37:12]# lvs /dev/webapp/webapp01
LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert
webapp01 webapp -wi-ao—- 25.00g
# 第二步:扩展文件系统(EXT4 用 resize2fs)
[root@server ~ 19:37:24]# resize2fs /dev/webapp/webapp01
resize2fs 1.42.9 (28-Dec-2013)
Filesystem at /dev/webapp/webapp01 is mounted on /usr/share/nginx/html; on-line resizing required
old_desc_blocks = 3, new_desc_blocks = 4
The filesystem on /dev/webapp/webapp01 is now 6553600 blocks long.
[root@server ~ 19:37:36]# df -h /usr/share/nginx/html
文件系统 容量 已用 可用 已用% 挂载点
/dev/mapper/webapp-webapp01 25G 44M 24G 1% /usr/share/nginx/html
[root@server ~ 19:37:53]# ls /usr/share/nginx/html
host.conf hostname hosts hosts.allow hosts.deny lost+found
# 一步到位:块设备和文件系统一并扩展
[root@server ~ 19:38:00]# lvextend -rL 30G /dev/webapp/webapp01
[root@server ~ 19:39:03]# lvs /dev/webapp/webapp01
LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert
webapp01 webapp -wi-ao—- 30.00g
[root@server ~ 19:39:18]# df -h /usr/share/nginx/html
文件系统 容量 已用 可用 已用% 挂载点
/dev/mapper/webapp-webapp01 30G 44M 28G 1% /usr/share/nginx/html
XFS 扩文件系统用 xfs_growfs,EXT4 用 resize2fs——这是最容易记混的一对,务必分清。
13.3 缩减 EXT4 文件系统
缩减 EXT4 的注意事项:
- 不支持在线缩减,必须先卸载再缩减;
- 缩减后的容量不能小于当前已使用的容量。
EXT4 减容流程(五步):
# 1. 卸载
[root@server ~ 19:39:32]# umount /usr/share/nginx/html
# 2. 检查文件系统(-f 强制检查)
[root@server ~ 19:40:07]# e2fsck -f /dev/webapp/webapp01
e2fsck 1.42.9 (28-Dec-2013)
第一步: 检查inode,块,和大小
第二步: 检查目录结构
第3步: 检查目录连接性
Pass 4: Checking reference counts
第5步: 检查簇概要信息
/dev/webapp/webapp01: 16/1966080 files (0.0% non-contiguous), 167447/7864320 blocks
# 3. 缩减文件系统到 10G
[root@server ~ 19:40:31]# resize2fs /dev/webapp/webapp01 10G
resize2fs 1.42.9 (28-Dec-2013)
Resizing the filesystem on /dev/webapp/webapp01 to 2621440 (4k) blocks.
The filesystem on /dev/webapp/webapp01 is now 2621440 blocks long.
# 4. 缩减逻辑卷到 10G
[root@server ~ 19:40:37]# lvreduce -L 10G /dev/webapp/webapp01
WARNING: Reducing active logical volume to 10.00 GiB.
THIS MAY DESTROY YOUR DATA (filesystem etc.)
Do you really want to reduce webapp/webapp01? [y/n]: y
Size of logical volume webapp/webapp01 changed from 30.00 GiB (7680 extents) to 10.00 GiB (2560 extents).
Logical volume webapp/webapp01 successfully resized.
# 5. 挂载测试
[root@server ~ 19:41:13]# mount /dev/webapp/webapp01 /usr/share/nginx/html
[root@server ~ 19:41:33]# ls /usr/share/nginx/html
host.conf hostname hosts hosts.allow hosts.deny lost+found
[root@server ~ 19:41:36]# df -h /usr/share/nginx/html
文件系统 容量 已用 可用 已用% 挂载点
/dev/mapper/webapp-webapp01 9.8G 37M 9.2G 1% /usr/share/nginx/html
减容顺序与扩容正好相反:扩容是「先扩 LV 再扩文件系统」,减容是「先缩文件系统再缩 LV」。道理很简单——文件系统必须先收缩到比 LV 小(或相等),再缩 LV,否则数据会被截断。
补充说明:如果文件系统是构建在磁盘分区(而非 LVM 逻辑卷)上,扩展/缩减文件系统容量的操作原理相同。
十四、全文小结(实践心得)
1. RAID 级别速查表
| RAID 0 | 2 | 无 | 100% | 快但脆 | 视频编辑、临时数据 |
| RAID 1 | 2 | 1 块 | 50% | 镜像保命 | 关键数据、系统盘 |
| RAID 5 | 3 | 1 块 | (N-1)/N | 性价比之王 | 文件/数据库服务器 |
| RAID 6 | 4 | 2 块 | (N-2)/N | 更抗造 | 大容量存档 |
| RAID 10 | 4 | 多块 | 50% | 又快又稳 | 数据库、虚拟化 |
2. mdadm / LVM 命令速查表
| mdadm –create /dev/mdX –level=N –raid-devices=M /dev/sd.. | 创建软 RAID |
| mdadm -D /dev/mdX / cat /proc/mdstat | 查看 RAID 状态 |
| mdadm –add /dev/mdX /dev/sdX | 添加热备盘 |
| mdadm –fail /dev/mdX /dev/sdX | 模拟故障 |
| mdadm –remove /dev/mdX /dev/sdX | 移除故障盘 |
| mdadm –grow /dev/mdX –raid-devices=N | RAID 扩容 |
| mdadm –stop / –assemble / –zero-superblock | 停止 / 装配 / 清元数据 |
| pvcreate / pvs / pvdisplay | 建 PV / 列 PV / 看 PV 详情 |
| vgcreate / vgs / vgextend / vgreduce | 建 VG / 列 / 扩容 / 缩减 |
| lvcreate / lvs / lvextend / lvreduce | 建 LV / 列 / 扩 LV / 缩 LV |
| xfs_growfs / resize2fs | 扩 XFS / 扩缩 EXT4 |
| pvmove /dev/sdX [目标盘] | 在线搬移 PV 数据 |
3. 核心要点
4. 记忆口诀
- RAID 选型:快不要命 0、稳不怕贵 1、又快又稳又省 5、坏两块也不怕 6、关键业务上 10。
- mdadm 故障演练套路:–fail 制造故障 → 热备盘顶替重建 → –remove 移除坏盘。
- LVM 一句关系:PV 是硬盘、VG 是池子、LV 是分区。
- 扩缩方向:扩容「先块后文件系统」,减容「先文件系统后块」。
- 扩文件系统命令分家:XFS 用 xfs_growfs,EXT4 用 resize2fs。
5. 三个易错点
持续更新中……下一部分继续学习新的 Linux 技能。


评论前必须登录!
注册