 网硕互联帮助中心
语音联络是大模型在业务端最容易被低估的落地路径。本文不谈概念,只拆工程:三层系统架构如何承载并发,对话引擎如何从关键词匹配走到检索增强,人机协同的状态机怎么设计,50 万通量级的成本账怎么算,以及上线前必须确认的合规边界。适合正在评估语音智能体方案的技术与业务负责人对照自查。
一、传统外呼机器人 vs 大模型呼叫:差别不在“能打多少”,而在“能听懂多少”
很多企业第一次接触外呼机器人,关注的是“一天能打多少通”。传统机器人确实能打到800-1200通/天,人工坐席只有100-300通。但真正的问题在于:接通之后,能不能准确理解客户意图,能不能把对话推进下去。
上一代智能客服的意图理解准确率大约在85%-95%,语音识别准确率85%左右,只支持普通话和英文,交付周期通常要1天到10天。而基于大模型+RAG的呼叫系统,意图理解可以做到99%,即使识别错误也能通过语义纠错正确理解,支持多语种和方言,交付速度可以压缩到1-10分钟。
技术上的关键差异在于:传统方案靠关键词、正则表达式、图形化流程树;大模型方案靠语义向量、RAG知识库、Prompt工程。前者遇到“客户不按脚本说话”就容易卡住,后者可以动态生成回复,还能记住上下文。
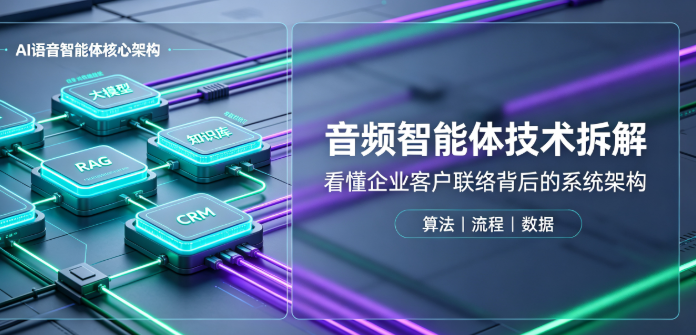
二、三层架构:业务层、基础服务层与支撑能力层
- 业务层:坐席管理、话术编排、流程与节点配置、变量填槽、实时打断、多轮对话、意向收集、录音与质检、数据报表。面向运营人员,要求无代码可配置。
- 基础服务层:任务配置、呼叫配置、对话管理、通话记录统计、数据回传、短信与评价管理,承担调度与状态一致性。
- 支撑能力层:ASR 语音识别、NLP 语义理解、TTS 语音合成,叠加通信能力(SIP 软交换、智能路由、空号识别)与黑白名单策略。
分层的关键收益是解耦:业务侧改话术不必动引擎,引擎升级不必停机。支撑层的并发设计直接决定上限,成熟方案普遍以万级并发集群为目标水位。
三、对话引擎:从关键词匹配到检索增强
上一代智能客服依赖"关键词—表达式"的规则映射,典型表现是意图命中靠词表,命中率随行业术语增长而衰减。新一代做法是三层叠加:
公开披露的工程指标中,语义识别准确率可做到 95% 一线,语音识别通用场景 90% 以上、特定场景接近 97%,转接成功率 99% 以上。这些数字与测试集强相关,评估时应要求供应商给出场景化测试方法,而非只看单一指标。
四、人机协同:AI实时转人工,转接成功率99%以上
很多企业担心“机器人搞不定怎么办”。成熟的方案是AI实时转人工:
- 通话过程中达成条件、关键词或特定流程触发转人工。
- 多种分配模式,无空闲坐席自动暂停,当前坐席未接听自动转其它坐席。
- 坐席接线同时接受AI沟通记录及完整客户信息。
- 支持边接听边手动分享、推送、发送短信。
- 一键将客户转为销售线索,数据支持CRM流转或直接导出。
转接成功率可以做到99%以上,系统内部转接一次计费,通话保质,转接保量。
五、数据运营:从“打完就完”到“越打越准”
传统外呼的问题是:打完没有沉淀,客户标签混乱,转化过程难管。大模型呼叫系统在数据层面做了几件事:
- 多维度运营数据分析:接通率、呼叫状态、性别地区、呼叫时段,支持跨时间多任务交叉统计。
- 多级标签结构:实现更多层级的客户分析。
- 话后事件分析:杜绝投诉等事态扩大。
- A/B测试:对多数据集进行对比分析,为下一次呼叫提供参考。
- 完整API接口:与品牌CRM系统打通,支持全量外呼通话记录存储。
万科集案例中,API接口输出25个统计维度,统计报表按规则导入万科服务系统,再进行派单。不同场景数据建模,协助分析业务。
六、上线前必须确认的合规边界
把这几项写进技术验收清单,比事后补救成本低得多。
详细落地方案可后台咨询了解~




评论前必须登录!
注册