 网硕互联帮助中心
一、引言
在大数据数据集成与同步领域,随着数据平台与系统的不断发展与建设,通常面临以下问题:
- 数据源多样:常用数据源有数百种,版本不兼容。 随着新技术的出现,更多的数据源不断出现。 用户很难找到一个能够全面、快速支持这些数据源的工具。
- 同步场景复杂:数据同步需要支持离线全量同步、离线增量同步、CDC、实时同步、全库同步等多种同步场景。
- 资源需求高:现有的数据集成和数据同步工具往往需要大量的计算资源或JDBC连接资源来完成海量小表的实时同步。 这增加了企业的负担。
- 缺乏质量和监控:数据集成和同步过程经常会出现数据丢失或重复的情况。 同步过程缺乏监控,无法直观了解任务过程中数据的真实情况。
- 技术栈复杂:企业使用的技术组件不同,用户需要针对不同组件开发相应的同步程序来完成数据集成。
- 管理和维护困难:受限于底层技术组件(Flink/Spark)不同,离线同步和实时同步往往需要分开开发和管理,增加了管理和维护的难度。
Apache SeaTunnel 是一个面向批处理、流处理、CDC、数据湖/数仓写入、多表同步等场景的分布式数据集成平台。它要解决的数据集成问题包括数据源种类繁多、版本不兼容、多模态数据集成、同步场景复杂、资源消耗高、监控与质量保障不足,以及离线与实时同步分散管理等问题。
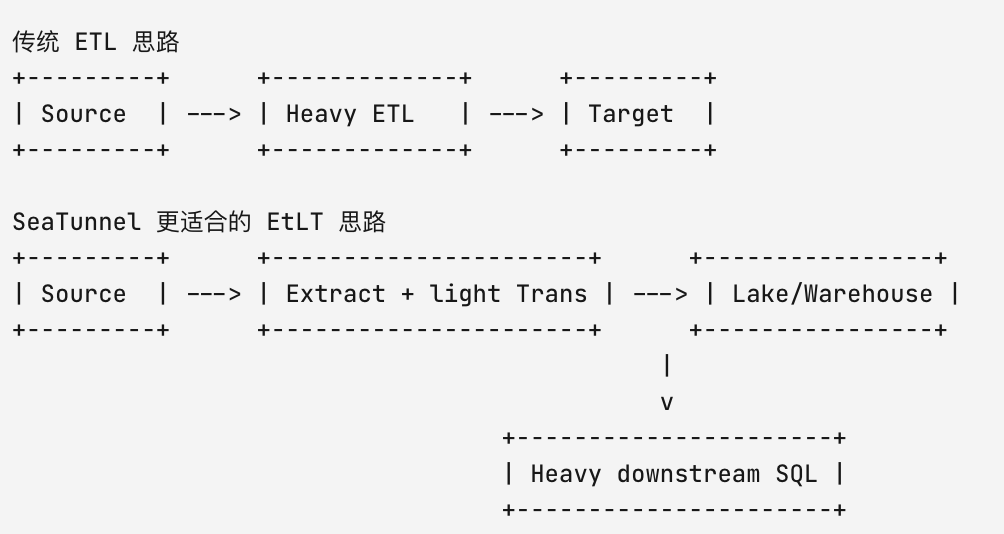
传统 ETL 工具往往更强调“抽取、转换、加载”的完整链路,但在现代数据架构中,重型转换通常更适合放在数仓、湖仓或专门的计算引擎中完成。SeaTunnel 的定位更接近 EL(T) 或 EtLT:它负责把数据可靠地从源端抽取出来,做必要的轻量转换,然后写入目标系统;复杂建模、宽表加工、指标计算则交给下游数仓、湖仓或计算平台处理。
二、SeaTunnel核心定位
SeaTunnel 的核心定位可以概括为三句话:统一作业模型、统一 Connector 抽象、多执行引擎运行。SeaTunnel 支持实时同步海量数据,支持批流一体、多引擎、分布式快照、多表或整库同步、JDBC 连接复用、实时监控等能力,并且默认使用 SeaTunnel Engine,也可以使用 Flink 或 Spark 作为执行引擎 。
它主要解决四类问题:
|
问题 |
SeaTunnel 的解决方式 |
|
数据源太多 |
通过 Source、Transform、Sink Connector 连接异构系统 |
|
批流割裂 |
同一套 Connector API 支持离线、实时、全量、增量等同步场景 |
|
引擎绑定 |
Connector 与执行引擎解耦,通过翻译层适配 SeaTunnel Engine、Flink、Spark |
|
运维复杂 |
SeaTunnel Engine 面向数据同步场景内置集群管理、HA、Checkpoint、REST API、Web UI 等能力 |
不过,SeaTunnel 并不是通用计算引擎,SeaTunnel 中的 Transform 更适合列名变更、大小写转换、列拆分等轻量转换,而不是复杂业务建模或大规模分析计算 。这种定位很适合大数据平台中的“数据搬运层”,它不是要替代 Flink、Spark 或数仓计算,而是把数据同步、数据接入和异构系统连接这部分能力标准化。
三、SeaTunnel架构原理
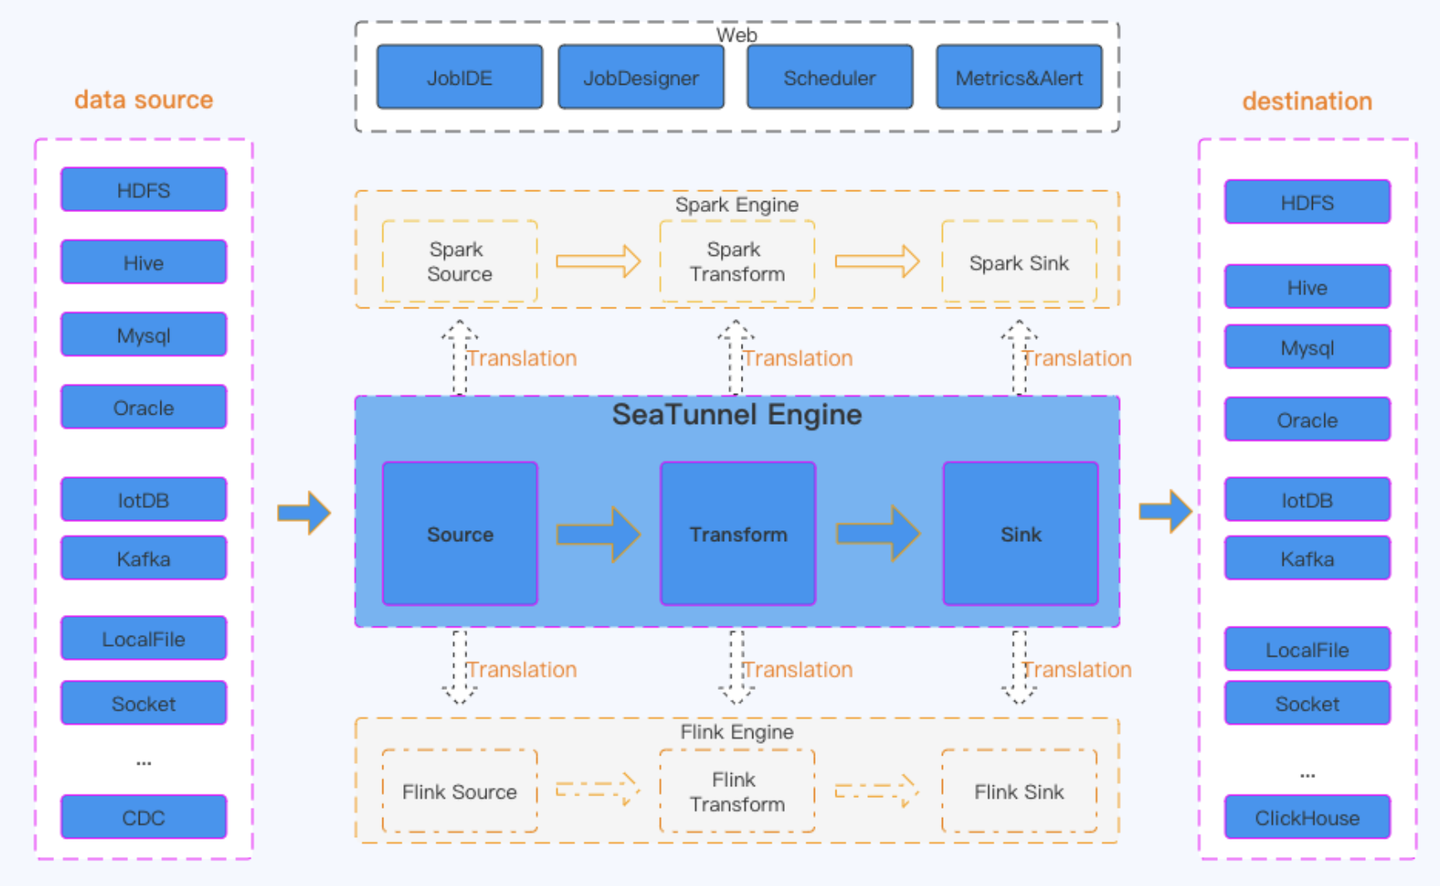
SeaTunnel 采用分层架构:最上层是用户配置层,中间是 API 层和 Connector 生态,再往下是翻译层,最后落到具体执行引擎。官方架构文档将其拆为 Configuration Layer、API Layer、Connector Layer、Translation Layer 和 Engine Layer,各层分别负责作业定义、接口抽象、数据源实现、引擎适配和任务执行。

这套架构的关键是“接口稳定,执行可替换”。Source、Sink、Transform Connector 按 SeaTunnel API 开发,执行时可以通过 Translation Layer 适配不同引擎。Engine Independence 是 SeaTunnel 的设计目标之一,即把 Connector 逻辑从具体执行引擎中解耦出来,使同一 Connector 可运行在 SeaTunnel Engine、Flink 或 Spark 上。
四、数据流模型
一个 SeaTunnel 作业通常由 Source、Transform、Sink 三部分组成。Source Connector 负责并行读取数据,Transform 负责可选的轻量转换,Sink Connector 负责写入目标端;如果用户选择 Flink 或 Spark,SeaTunnel 会把 Connector 打包成相应引擎的程序提交运行。
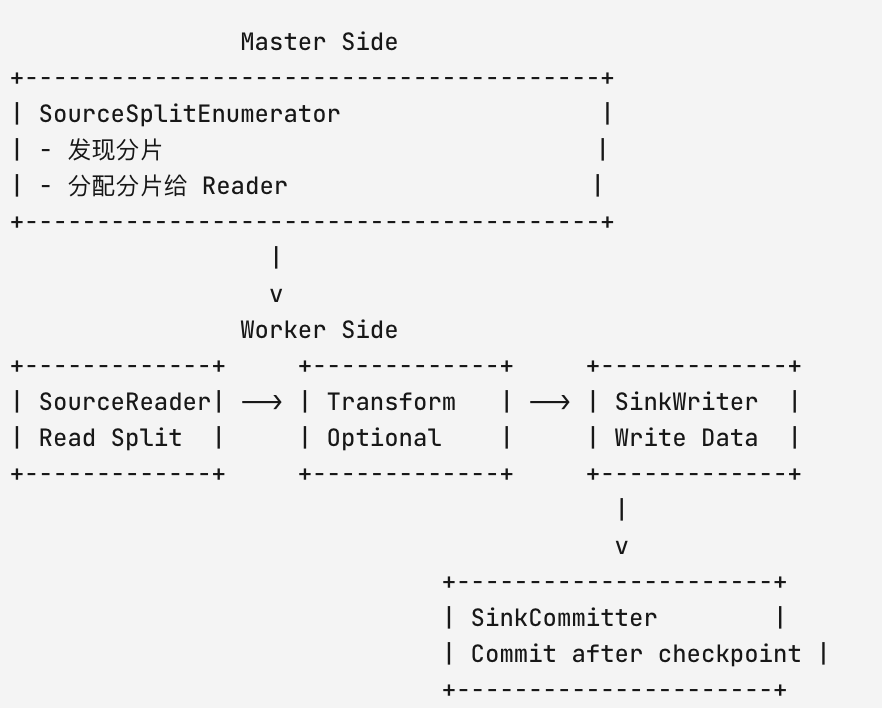
数据源会被拆成 Split,例如文件块、数据库分片、Kafka 分区;SourceSplitEnumerator 在 Master 侧生成并分配 Split,SourceReader 在 Worker 侧读取 Split 并输出 SeaTunnelRow,随后经过可选 Transform 链,最终由 SinkWriter 写入目标端 。
这种 Split-based Parallelism 让大表、文件集合、Topic 分区可以并行读取,也让失败恢复更容易,因为 Split 状态会随 Checkpoint 保存,失败后可以从最近一次成功快照恢复 。
SeaTunnel工作流图示例如下:
五、执行引擎
SeaTunnel 支持三类执行引擎:SeaTunnel Engine,也称 Zeta;Apache Flink;Apache Spark。如果没有既有 Flink 或 Spark 基础设施,新项目优先选择 SeaTunnel Engine;如果企业已有 Flink 集群并希望复用流处理运维体系,可以选择 Flink;如果已有 Spark 且任务主要偏批处理,可以选择 Spark 。
|
引擎 |
官方定位 |
更适合的场景 |
|
SeaTunnel Engine |
为数据集成原生构建的执行引擎 |
新项目、数据同步、CDC、多表迁移、低资源环境 |
|
Apache Flink |
分布式流处理引擎 |
已有 Flink 基础设施、复杂流处理、Flink 生态集成 |
|
Apache Spark |
分布式批流处理引擎 |
已有 Spark 基础设施、大规模批处理、离线数仓加载 |
SeaTunnel Engine、Flink、Spark 都支持批处理、流处理、Exactly-Once、多表同步、Web UI、Standalone 和 Cluster 模式;CDC 支持在 SeaTunnel Engine 与 Flink 上可用,Spark 不支持;Schema Evolution 在 SeaTunnel Engine 与 Flink 上可用,Spark 不支持 。
如何选择执行引擎
Start
|
v
已有 Flink / Spark 基础设施?
|
+– 否 ———————> SeaTunnel Engine
|
+– 是
|
v
是否希望复用现有引擎运维体系?
|
+– 是,偏实时/流处理 —-> Flink Engine
|
+– 是,偏批处理 ——–> Spark Engine
|
+– 否 —————–> SeaTunnel Engine
六、功能特性
SeaTunnel 的功能特性可以分为连接能力、运行能力、可靠性能力和运维能力,包括丰富且可扩展的 Connector、Connector 插件化、批流一体、分布式快照、多引擎支持、JDBC 复用、多表或整库日志解析、高吞吐低延迟、实时监控,以及代码和画布式两种作业开发方式等。
|
能力 |
说明 |
|
Connector 生态 |
支持 Source、Transform、Sink 插件,连接数据库、文件系统、云存储、消息系统、SaaS 等 |
|
批流一体 |
同一套 Connector API 面向离线、实时、全量、增量、CDC 等场景 |
|
多引擎 |
同一 Connector 可适配 SeaTunnel Engine、Flink、Spark |
|
分布式快照 |
基于分布式快照保障一致性恢复 |
|
Exactly-Once |
通过 Checkpoint 与两阶段提交配合实现端到端一致性语义 |
|
多表同步 |
支持多表或整库同步,适合大量小表迁移和 CDC 同步 |
|
监控能力 |
可观察同步过程中的读取数量、写入数量、数据大小、QPS 等信息 |
Exactly-Once 是很多数据同步场景中的关键能力,SeaTunnel 通过分布式快照和两阶段提交实现容错与一致性:SinkWriter 在 Checkpoint 阶段准备提交信息,Checkpoint 完成后由 SinkCommitter 提交,如果失败则在提交前回滚;同时要求 SinkCommitter 操作具备幂等性,以处理重试场景 。
Exactly-Once 简化过程
1. SourceReader 读取数据
|
v
2. SinkWriter 写入临时状态或预提交状态
|
v
3. Checkpoint 成功
|
v
4. SinkCommitter 正式提交
|
v
5. 失败恢复时从最近成功 Checkpoint 继续
Schema Evolution 和 Multi-Table Support 也是 SeaTunnel 面向数据库同步和 CDC 的重要能力,SeaTunnel 支持捕获 ADD、DROP、MODIFY columns 等 DDL 变更,支持在管道中映射 schema change,并动态应用到目标表;同时支持单个作业同步多张表,并通过 TablePath 路由记录到正确目标端。
七、适用场景
SeaTunnel 最适合出现在“数据在系统之间移动”的位置,而不是“数据在系统内部被复杂计算”的位置。包括大规模批量数据迁移、带 CDC 的实时数据集成、向 Iceberg、Hudi、Delta Lake 等数据湖或数仓写入,以及带 Schema Evolution 的多表同步 。
|
场景 |
是否适合 |
原因 |
|
MySQL 到 Doris/ClickHouse 实时同步 |
适合 |
CDC、多表同步、低延迟写入是典型数据同步诉求 |
|
Kafka 到湖仓落地 |
适合 |
Source/Sink 模式清晰,适合流式数据接入 |
|
Oracle/PostgreSQL 到 Hive/Iceberg 批量迁移 |
适合 |
批处理、异构源端与目标端连接能力匹配 |
|
大量小表整库同步 |
适合 |
官方强调多表同步、JDBC 复用和数据库日志多表解析能力 |
|
复杂指标建模 |
不作为首选 |
更适合放在 Flink、Spark、SQL 数仓或湖仓计算层中 |
|
复杂 CEP 或业务事件计算 |
视情况 |
如果已有 Flink 生态,复杂流计算仍应优先考虑 Flink 原生能力 |
可以把 SeaTunnel 放在数据平台的接入层或同步层:

这种架构下,SeaTunnel 负责“可靠搬运”,下游系统负责“深度加工”。这能减少同步脚本散落在不同项目中的问题,也更容易统一治理 Connector、监控、失败恢复和版本升级。
八、部署使用
SeaTunnel Engine 的部署使用分为单节点和集群部署两条路径:单节点适合验证安装、Connector 和作业配置;集群部署适合测试、预发或生产类环境。
本地部署前需要安装 Java,并设置 JAVA_HOME;从 2.2 起,二进制包默认不再提供 Connector 依赖,首次使用需要运行 sh bin/install-plugin.sh 安装 Connector,或手动下载 Connector 放入 ${SEATUNNEL_HOME}/connectors/目录 。
一个最小作业配置通常包含 env、source、transform、sink 四段。示例如下:
env {
parallelism = 1
job.mode = "BATCH"
}
source {
FakeSource {
plugin_output = "fake"
row.num = 16
schema = {
fields {
name = "string"
age = "int"
}
}
}
}
transform {
FieldMapper {
plugin_input = "fake"
plugin_output = "fake1"
field_mapper = {
age = age
name = new_name
}
}
}
sink {
Console {
plugin_input = "fake1"
}
}
运行命令如下:
./bin/seatunnel.sh –config ./config/v2.batch.config.template -m local
如果要跑真实链路,比如 MySQL 到 Doris,需要先在config/plugin_config中声明connector-jdbc和connector-doris,再运行sh bin/install-plugin.sh安装 Connector;MySQL JDBC Driver 需要放到${SEATUNNEL_HOME}/lib/目录,作业配置里再分别写 JDBC Source 和 Doris Sink 参数。



评论前必须登录!
注册