 网硕互联帮助中心
项目类型:Agent Runtime / Plugin-native Agent Harness 赏析目标:学习一个真实 Agent 项目如何把 Agent、Session、Event、Plugin、Runtime、Extension 组织成一套可组合系统 核心问题:为什么它敢把「Agent Loop 本身」也变成插件? 源码版本:deepseek-ai/deepseek-harness,main 分支,commit ddefc45,版本 0.1.6-alpha.2(2026-09-17)
前面八个项目赏析,我走过了这样一条路:
LangGraph → 任务怎么编排
OpenHands → Agent 怎么执行真实动作
browser-use → Agent 怎么感知真实界面
DeerFlow 2.0 → 长任务怎么跑不死
Hermes Agent → Agent 怎么自我进化
OpenCode → Terminal Agent 怎么组织产品
Goose → 工具怎么变成 MCP 服务
这八个项目,虽然语言、路线、定位都不同,但它们有一个共同点:
它们的 Agent 内核都是「自己写死的」。
OpenHands 有自己一套 Runtime,DeerFlow 有自己一套 harness,OpenCode 有自己一套 Session 处理器。你可以换工具、换模型、换沙箱,但你换不掉 Agent Loop 本身——那是程序的骨架。
DeepSeek Harness(下文简称 dsh)做的事情,恰好相反:
它把 Agent Loop 也做成了插件。
官方 README 的第一句话就是:
它构建于一切皆插件的架构之上,由 Cordis 驱动,其设计参见论文 A Programming Paradigm for Spatiotemporal Composability。
而 docs/architecture.zh.md 把这句话说得更狠:
产品的每一部分都是插件,包括模型适配器、工具注册表、会话日志,以及 agent loop(智能体循环)本身,因此每个都可以从配置替换。
不存在需要打补丁的特权内核:扩展 dsh 的方式是把插件挂载到其他插件旁边,而各项注册都是副作用,会在其插件卸载时撤销。
"不存在需要打补丁的特权内核"——这句话是整篇文章的钥匙。
这篇赏析要回答三个问题:
一、先看清这是一个什么量级的项目
在谈设计之前,先说清楚它的规模——因为这决定了"这套架构是不是过度设计"的判断基准。
| 版本 | 0.1.6-alpha.2(开发者预览阶段) |
| 最新提交 | ddefc45,2026-09-17 |
| 包数量 | 54 个(packages/) |
| TypeScript 文件 | 3198 个 |
| 代码行数 | 119 万行(含测试)/约 63 万行(排除 tests/) |
| 测试文件 | 1329 个 |
| 决策记录(Agent Notes) | 2206 篇(.agents/notes/) |
| 中文文档 | 166 篇(docs/**/*.zh.md) |
| 官方故障复盘 | 4 篇(docs/postmortem/) |
| 应用形态 | Web / Desktop(Electron) / CLI / SDK(TypeScript & Python) / ACP |
几个数字值得停下来看一眼:
- 2206 篇决策记录。这不是普通的 changelog,而是每一处架构决策的"为什么"。比如 2026-09-02-system-prompt-as-surface-node.zh.md(为什么系统提示词要变成 surface 节点)、2026-09-01-v2-embedded-assistant-streams.zh.md(为什么 assistant stream 要内嵌进事件)。
- 4 篇 postmortem。官方主动公开自己的事故复盘——这在开源项目里极其罕见,也是这篇赏析最有价值的素材来源(后面会专门用一节讲其中一次故障)。
- 54 个包,但主干只有 6 个。packages/ 下大部分是能力提供方(LLM 适配器、沙箱、工具、UI),主干由 packages/core/ 的六个包承担。
这一节先给一个判断:54 个包 + 2206 篇决策记录 + 6 个主干包,说明这套架构不是为小项目设计的。它面向的是"一个要被反复重新组装的产品"。这个前提很重要,因为后面讨论"代价"时,衡量标准不是"理解它难不难",而是"它要解决的问题值不值这个复杂度"。
二、第一个反直觉事实:它没有自研插件框架
这是我最没想到的一点。
一个以"一切皆插件"为卖点、还把设计写成论文的项目,我以为它会自己实现一套插件框架。结果没有。
docs/rescope.zh.md 写得很清楚:
| vendor/cordis/ | cordis | @deepseek-ai/cordis | 4.0.0-rc.7 | 框架核心:Context、Service、Fiber、事件 |
| vendor/cosmokit/ | cosmokit | @deepseek-ai/cosmokit | 1.8.1 | 基础工具 |
| vendor/schemastery/ | schemastery | @deepseek-ai/schemastery | 3.18.0 | 配置 schema |
| vendor/loader/ | @cordisjs/plugin-loader | @deepseek-ai/cordis-plugin-loader | 1.0.0-rc.5 | 配置装载 |
| vendor/include/ | @cordisjs/plugin-include | … | 1.0.4 | 配置包含与 patch 叠加 |
| vendor/hmr/ | @cordisjs/plugin-hmr | … | 1.0.15 | 插件与配置热替换 |
Cordis 是一个现成的第三方插件框架(来自 cordiverse 生态,即 Koishi 机器人家族背后的框架)。dsh 做的事情是:把它的源码 vendor 进仓库,改掉 npm scope 名,然后在这套框架之上写自己的 Agent 产品。
为什么要改名?rescope.zh.md 给的理由很实在:
每个 harness 包都把框架声明为 peer dependency,发布 harness 就会连带发布这一层,用上游名发布等于在 registry 上占用别人的名字。
这件事本身就是一堂工程课:
在最想展示"我们架构很先进"的地方,他们选择了用别人的框架。
对比一下前面的项目就更清楚了:
OpenHands → 自己造 Runtime / Event System
DeerFlow → 站在 LangGraph 肩上(langchain.agents.create_agent)
OpenCode → 用 Effect-TS 做依赖注入
Hermes → 手搓状态机 loop
Goose → 直接用 MCP 当扩展机制
dsh → vendor 一个第三方插件框架,专注写业务
"一切皆插件"是个架构主张,但"插件框架"是个已经解决的问题。 dsh 把两件事分开了:框架用别人成熟的,自己的创新放在 Agent 语义上。
这个判断在后面的所有设计里都能看到——它没有重新发明依赖注入,而是用别人的依赖注入,去解决 Agent 特有的问题。
三、核心命题:不是"可扩展",是"时空可组合性"
"Everything is a Plugin" 听起来像是一句"可扩展性"的口号。但如果我们只理解成"可以加插件",就会看错这个项目。
真正的关键词在论文标题里:Spatiotemporal Composability(时空可组合性)。
拆开看,它是两个维度:
空间维度(Spatial) → Scope
同一份代码,可以按 agent 隔离出不同的注册作用域
"这个工具只在 A 会话里存在,B 会话看不到"
时间维度(Temporal) → 可逆副作用
每个注册都返回 disposer
插件卸载时,它贡献的一切自动撤销
这两个维度合起来,才让"连 Agent Loop 都是插件"真的成立——因为 loop 装上去、可以卸下来、可以被另一个实现替换,而不留下孤儿注册。
如果用一句话概括整套架构的设计目标:
不是"能让别人扩展我",而是"我自己也可以被换掉"。
这个区别非常关键。前者是开放扩展点,后者是把自己也变成可替换的一层。
而一旦接受了这个目标,后面两个看起来"过度设计"的选择就都变得必要了(第 六、七 节会细讲):
- Session 必须事件溯源——因为如果历史单独存一份、由 loop 维护,那么换掉 loop,历史就断了。
- Agent Loop 必须是无特权的——因为它是"可以被替换的一层",而不是"程序骨架"。
四、读懂源码的门槛:Cordis 的五个概念
想读懂 dsh 的源码,先得懂 Cordis。好在官方专门写了 docs/cordis-primer.zh.md,把它压缩成五个概念:
| 插件是实现 Service 的对象 | 可以是带 inject 和 apply(ctx) 的函数,也可以是 Service 子类 |
| 上下文是服务的容器 | 一个服务占一个稳定的 ctx.<key>(如 ctx.tools、ctx.llm、ctx.sessions);其他插件通过 key 查找,而不是导入具体实现 |
| inject 声明服务依赖 | 声明所需服务后自动等待其就绪;加载顺序由依赖表达,而非手工编排 |
| 类型化事件用于通信 | TypeScript 声明合并注册事件名,五种分发方式 |
| 注册是可逆的副作用 | 通过 ctx.effect() / ctx.on() 安装,reload 和 teardown 时撤销 |
第三点值得特别注意:"其他插件通过 key 查找服务,而非导入具体实现"。这是依赖倒置的具体落地——扩展插件只依赖 agent 这个接口包,而绝不直接依赖 agent-loop。官方在 core.zh.md 里把这条规矩写成了硬约束:
扩展插件依赖 agent——包括需要发起 Agent 时——而绝不直接依赖 agent-loop,因此循环保持可替换。
"绝不"两个字,是整套架构能不能成立的分水岭。 只要有一个扩展插件 import 了 agent-loop 的内部实现,"loop 可替换"就只是纸面承诺。
再看第五点的实现方式——五种事件分发模式:
| emit | 否 | 按注册顺序观察 | 否 |
| waterfall | 否 | 按注册顺序 | 是 |
| parallel | 是 | 全部并行 | 否 |
| serial | 是 | 按注册顺序 | 是 |
| bail | 否 | 到首个 bail 值停止 | 是 |
其中 waterfall 是理解 dsh 的关键,它的语义很像 Koa 的洋葱模型中间件:
ctx.waterfall 是环绕中间件。监听器接收 (…args, next)。调用 next() 会执行下游监听器;下游返回值通过 next() 返回当前包装层,可由该层包装后继续向外返回。不调用 next() 直接返回则短路。
这就解释了 dsh 里"拦截"机制的统一形态——想观察就调用 next(),想接管就直接返回。比如 agent/pre-step(决定是否接纳本步骤的输入)就是一个 waterfall:
Driver → agent/pre-step (waterfall)
← 监听器:调用 next() 表示"我不管,往下走"
← 监听器:直接返回 reject/enter,表示"我拍板"
用同一套机制表达"观察、包装、拍板"三件事,这是 Cordis 给 dsh 的最大红利。
五、主干:一个轮次如何流经六个包
dsh 的 packages/core/ 只有六个包,但它们构成了一条完整的循环:
| session/ | 仅追加的 SessionEvent 日志与内存 store——唯一真源 | ctx.sessions |
| system-prompt/ | 提示词段落与工具 schema 组装 | ctx.systemPrompt |
| tools/ | 带作用域的工具注册表与受保护的执行流水线 | ctx.tools |
| agent/ | Agent 接口、实时注册表、agent/* 事件词汇 | ctx.agents |
| agent-loop/ | 实现公开 Agent 约定的具体 driver | ctx.agentLoop |
| scope/ | 按 agent 划分作用域的注册原语(零依赖库,不是服务) | 无 |
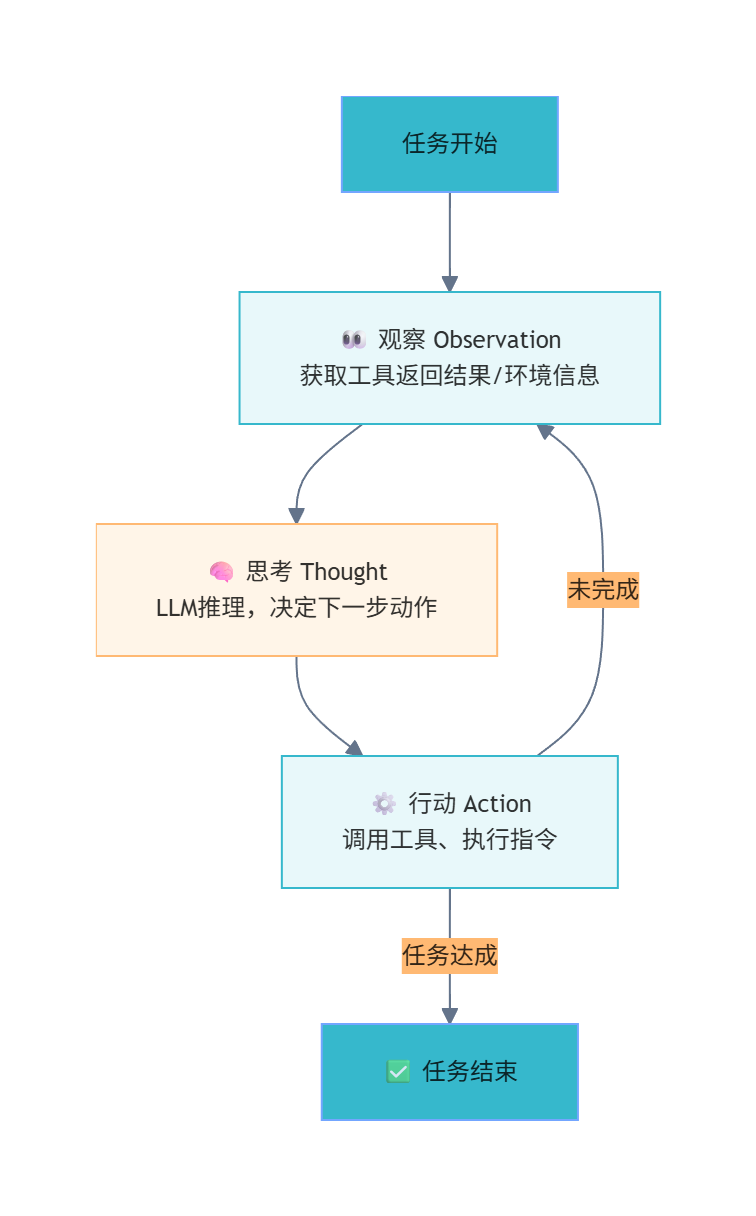
先记住两个术语,官方定义得非常清楚:
一个步骤(step)是一次模型请求加上它调用的工具。一个轮次(turn)包含零个或多个步骤:它在领取首条输入之前打开,并在不再欠下任何工作时关闭。
而 docs/architecture.zh.md 给出的轮次流程是整个项目最核心的一段伪代码:
turn/start
claim next-step input plus one queued message
assemble prompt sections + tool schemas; project runtime context
-> agent/pre-step reject | enter(messages, startsRequestSeries?)
reject, or a first enter rewritten empty -> close the turn with no step
step/start
agent/request -> prepareCall (cancellation commits neither system nor users)
reconcile system/message using the prepared call capability
append entered messages as user/message; log request/header and request/context as needed
derive and freeze model history from the log
stream the bound prepared call -> llm/stream -> agent/assistant-stream start
agent/assistant-stream chunk*
assistant/message | assistant/attempt -> agent/assistant-stream end
tool/call* -> tools/pre-execute -> tools/execute -> tools/post-execute -> tool/result*
step/end
tools owe another request, or next-step input arrived -> claim -> next step
-> agent/turn-stopping
turn/end
如果你只看这段伪代码里的动词,会发现一些非常有意思的措辞:
claim 领取 —— 输入不是"被推送",而是被"认领"
derive 派生 —— 模型历史不是"存储",而是"从日志推导"
freeze 冻结 —— 请求一旦构造就不可变
reconcile 校准 —— 系统提示词按节点对齐
owe 欠 —— 是否还有工作是"债务"关系
这些动词不是随便选的,它们各自对应一条设计约束:
| claim | 输入在 inbox 里排队,由 loop 主动认领;循环节奏由 loop 掌控,不被外部打断 |
| derive | 模型可见的历史从日志派生 → 日志是唯一真源 |
| freeze | 请求构造后不可变 → 重试不必重新组装,也不会产生分叉 |
| reconcile | 系统提示词按节点对齐 → 提示词变化可被记录、可被回放 |
| owe | "还欠不欠一次请求"决定步骤是否继续 → 循环终止条件是可判定的 |
而这段流程里,只有 8 个事件是持久会话事件(turn/*、step/*、system/message、user/message、assistant/message、assistant/attempt、tool/*),其余都是实时扩展点。
"持久"与"实时"的分界线,就是"要不要在重启后还能重建"的分界线。
六、闪光点一:Session 是 append-only 日志,message history 是派生的
这是 dsh 最有辨识度的设计,也是它和几乎所有其他 Agent 框架最不一样的地方。
大多数框架是这么做的:
Agent
├── self.messages = [] ← 消息历史自己存一份
└── self.state = {…} ← 状态也自己存一份
dsh 是这么做的:
Session = SessionEvent[] ← 仅追加的事件日志,唯一真源
↓ deriveMessages()
Message[] ← 模型历史"派生"出来,从不单独存储
docs/subsystems/session.zh.md 开门见山:
Session 是一份由类型化 SessionEvent 组成的仅追加日志,是 agent 完整交互历史的唯一真源。LLM 消息历史从日志派生而来,从不单独存储;回放即从同一组事件重新派生。
而源码里这条规则非常朴素——packages/core/session/src/surface.ts:119 的 deriveEventMessage() 就是一个纯函数:
export function deriveEventMessage(
event: SessionEvent,
projectedMessages?: ReadonlyMap<SessionSeq, Message>,
): Message | null {
const projected = projectedMessages?.get(event.seq)
if (projected !== undefined) return projected
// Intentionally non-exhaustive: only message-producing events derive
// history; turn/step boundaries, failed attempts, and errors are trace/replay
// data.
switch (event.type) {
case 'user/message': {
return event.data
}
case 'system/message':
case 'assistant/message': {
if (event.data.message.content.length === 0) return null
return event.data.message
}
case 'tool/result': {
return event.data.message
}
default:
// A non-surface event (boundary, attempt, log-only record) projects to
// no message. Merge-extensible union: no assertNever here.
return null
}
}
注意这个 default: return null 的注释——"边界事件、失败的尝试、纯日志记录,都不投影成消息"。
也就是说:
turn/start, step/start, step/end, turn/end → 结构信息,不给模型看
assistant/attempt → 失败的尝试,只留档,不给模型看
user/message, system/message → 给模型看
assistant/message, tool/result → 给模型看
日志比"模型看到的东西"多。 日志里有完整的执行轨迹(谁在什么时候开了一个步骤、哪次请求失败了、token 用了多少),但模型只看其中一部分。
这是事件溯源(Event Sourcing)的经典形态。但 dsh 在此之上加了一条非常强硬的不变量:
模型可见即已记录。
抵达模型请求的一切都必须能从日志重建,并由一项运行时不变量断言这一点。 新增模型可见输入需要一个会话事件。
这条规则看起来只是"日志要完整",但它其实是在回答一个更难的问题:
如果 Agent Loop 可以被替换,谁保证"换了 loop 之后历史还在"?
答案是:不靠 loop 保证,靠日志格式保证。
只要新 loop 遵守"模型可见即已记录",它往日志里追加事件,历史就自动成立;而所有消费者(UI、回放、fork、评估、遥测)都只读日志,不读 loop 的内部状态。所以:
旧 loop 卸载 ──✗──→ 不带走历史(历史不在 loop 里)
新 loop 挂载 ──✓──→ 读同一份日志,继续跑
这就是第六节开头那个问题的答案:Session 要事件溯源,不是因为"日志好看",而是因为"loop 可替换"这个目标要求状态必须离开 loop。
顺带一个漂亮的副产品:fork
因为历史是"事件序列 + 派生函数",fork 就变成了一个纯操作。SessionStore.fork():
fork(source, boundary?, childSessionId?)
它选取到某个 SessionSeq 为止的源事件(默认最后一个),要求所选前缀结束时没有开放轮次,然后创建子会话。
注意"要求前缀结束时没有开放轮次"——这是一个拒绝非法输入的例子。文档明确写:
显式 boundary 允许调用者从任意稳定的轮次间位置 fork……API 拒绝结束于开放轮次内的前缀,而不是静默截断。
另外有个细节很见功力:fork 会追加一条 session/end-seed { inherited: true } 边界标记。为什么需要它?
它之所以必要,是因为种子历史与实时工作在字节层面完全相同,这会让任何拥有独立开/闭括号的插件失效:一个未配对的 compaction/start,无论写入方是在压缩中途崩溃、还是此刻正在压缩,读起来都一样。
也就是说:如果 A 会话在压缩中途被 fork 出 B 会话,B 的历史里会留着一个"未闭合的压缩开始"。没有这条边界标记,B 根本无法分辨"这是我继承来的死括号"还是"我现在正在压缩"。
一行标记解决一个语义歧义——这是"事件溯源做对了"的样子。
七、闪光点二:Agent Loop 本身是插件
现在回答文章标题里的问题。
在前面八个项目里,Agent Loop 是程序骨架:
OpenHands / DeerFlow / OpenCode / Hermes / Goose
↓
你可以换 Tool、换 Model、换 Sandbox
但你换不掉 "loop 长什么样"
dsh 把这件事翻了:
packages/core/agent/ → 定义 Agent 接口 + agent/* 事件词汇
packages/core/agent-loop/ → 只是一个"实现"
源码证据在 packages/core/agent-loop/src/agent.ts:72:
/** Drives one session through turn and step boundaries. */
export class ReactLoopAgent implements Agent {
注意这个类名——ReactLoopAgent,不是 Agent。
它 implements Agent,说明它只是一个实现了公开接口的实现类。而 packages/core/agent/src/types.ts 里的 Agent 接口才是契约。
文档把这条边界写得很硬:
具体实现为 dsh-agent-loop 包内部细节;循环外没有任何组件依赖它。
而 ctx.agentLoop 这个键的存在,意味着 loop 可以通过配置替换:
| 让某个会话拥有不同的能力集合 | 组装一个 agent preset |
| 替换循环实现 | 在 ctx.agentLoop 上注册另一个实现 |
那么,把 loop 做成插件到底换来了什么?
我认为有三个层次的收益,一层比一层实在:
第一层:可替换(理论收益)
理论上你可以写一个 PlanExecuteLoopAgent、ReflexionLoopAgent,装上去就换掉了整个推理范式。
这一层最容易宣传,但实际收益有限——大多数团队并不会真的重写 loop。
第二层:可拦截(真实收益)
因为 loop 不拥有特权,它和所有插件一样要走事件:
agent/pre-step ← 决定是否接纳这一步的输入
agent/request ← 构造请求前一拍
agent/assistant-stream ← 流式输出过程
agent/turn-stopping ← 自然停止前的最后检查点
agent/request-error ← 请求失败,可以返回"重试"或保留原错误
这意味着"我要在每次请求前加一层上下文压缩"这类需求,不需要改 loop 源码。dsh 自己就是这么干的——dsh-compaction-basic 插件就是通过 agent/pre-step 处理上下文压力的:
dsh-compaction-basic 在派生请求之前通过 agent/pre-step 处理压力,而 agent/request-error 仅用于规范的上下文溢出。
压缩是插件,不是 loop 的内置功能。 这是"loop 无特权"的直接兑现。
第三层:可组合(架构收益)
这是最容易被忽略、但最重要的一层。
因为 loop 只是"一棵插件树上的一个节点",它就可以和别的节点自由组合:
同一个 loop 实现
+
不同的 agent preset(每个会话能力集不同)
+
不同的 Profile(web / headless / sdk / acp)
+
不同的 Scope(每个 agent 独立注册作用域)
=
N 种产品形态
对比一下前八个项目:
| OpenHands | ✅ 换 Runtime | ❌ 骨架 |
| DeerFlow | ✅ 换 Sandbox | ❌ 骨架(走的 create_agent) |
| OpenCode | ✅ 换 Provider/Tool | ❌ 骨架 |
| Hermes | ✅ 换 Provider/Memory | ❌ 骨架(手搓状态机) |
| dsh | ✅ 换一切 provider | ✅ 换 loop |
"能不能换掉自己",是这一层架构和前八个项目真正的分界线。
一个必须说清的代价
把 loop 做成插件,意味着每一个原本"顺序执行的函数调用"都变成了"事件分发"。
用事件表达流程,得到的是解耦;付出的是——你无法再靠阅读一个函数来理解执行顺序。想搞清"一次请求到底发生了什么",得同时看:
架构文档的轮次流程伪代码
+ agent-lifecycle.zh.md 的时序图
+ 每个事件的生产方/消费方(event-producer-consumer.zh.md)
+ 各个插件的监听器
文档里甚至专门提供了 docs/event-producer-consumer.zh.md(事件映射:每个事件的生产方与消费方)和 docs/graph-atlas.zh.md(图集)——需要专门写工具来帮你理解自己的系统,这本身就是复杂度的度量。
八、闪光点三:三类事件域,各管一件事
dsh 最让我欣赏的一个设计决定,是它没有把所有东西都塞进一个 event bus,而是把事件分成了三个域,并给出明确的选型规则:
| 会话事件(session/event) | 追加到日志的持久事实 | 当某个事实必须在重新加载后仍然存在时 |
| Agent 事件(agent/*) | 携带活跃 Agent 的实时信号:inbox、步骤、状态、请求、验证、续跑 | 要观察或拦截进行中的工作时 |
| 能力事件(fs/*、tools/*、telemetry/*) | 向某个 seam 附加策略和适配器 | 需要不引入循环依赖地挂策略时 |
文档原话:
事件就是扩展点,而选对事件域是大多数改动的第一个决定。
这句话解决了一个真实痛点。在单 event bus 的架构里,你经常会看到这种混乱:
同一个事件流里混着:
– "用户说了什么"(要持久化)
– "当前状态是 running"(不要持久化,是瞬时的)
– "要不要拦截这次工具调用"(是一次决策,不该进日志)
三种东西的生命周期完全不同,塞在一起就必然要打标记区分。 dsh 的做法是:生命周期不同,就不要放在一起。
这个设计有一个很自然的推论——判断标准是"要不要在重启后重建",而不是"这个信息重不重要"。所以:
turn/start, step/start → 持久(重启后要能看出"上次跑到哪一步了")
agent/status: running → 实时(进程死了,这个状态就该消失)
tools/pre-execute → 实时决策(拦截是此刻的行为,不是历史事实)
assistant/message → 持久(模型看到过什么,必须留下)
agent/assistant-stream chunk → 瞬态(流式增量,settlement 后由完整 stream 取代)
最后一条尤其精妙。文档说:
agent/assistant-stream 发布进程本地 start、瞬态 chunk 与 end frame。loop 会在 committed end frame 前把完整紧凑 stream 提交为一个 message 或仅日志 attempt。
如果进程在 settlement 前硬中断,则不会留下持久 attempt stream。
也就是说:流式输出是"直播",成品的 stream 是"录像"。 直播可以丢,录像必须完整。丢失一次的代价是"这次输出没留下痕迹"(而不是"日志里多了一个半截的垃圾")。
"宁可不留,也不留半截"——这是事件日志设计的正确洁癖。
九、闪光点四:Scope —— 空间维度的可组合性
前面说过,"时空可组合性"有两个维度。时间维度是"可逆副作用"(ctx.effect() 返回 disposer),空间维度就是 Scope。
packages/core/scope/ 是六个主干包里唯一的零依赖库(不是服务)。它的核心类型简单得出奇:
// packages/core/scope/src/index.ts:15
/** An opaque, identity-compared scope key. */
export type ScopeKey = object
一个不透明对象身份。文档解释:
已交付的 agent loop 使用活跃的 Agent 对象作为自身的 key,但该原语从不检视该对象。
"从不检视该对象"——这是个很克制的设计。scope 不关心 key 是什么类型、有什么字段,它只做身份比较。所以:
ScopeKey 可以是一个 Agent 对象
也可以是一个会话 id
也可以是任何你想要的"作用域边界"
而这个原语解决的问题是:
同一注册上下文同时表达每个 agent 的可见性和共享生命周期所有权。
用人话说:同一个 ctx.tools 注册表,可以让不同 agent 看到不同的工具集。
这在多 Agent 场景下是刚需。回想一下前面几个项目怎么处理这个问题的:
OpenHands → 每个会话一个 Runtime,靠进程/容器隔离
DeerFlow → sub-agent 有独立执行上下文
Goose → 每个 agent 一份 extension 列表
它们靠"多实例"来隔离,dsh 靠"作用域"来隔离。 前者要复制整个世界,后者只在你需要的地方加一层过滤。
docs/subsystems/scope.zh.md 里还有一个细节值得注意——有个叫 ToolRestriction 的概念:
ToolRestriction——单个作用域对其继承内容的实时过滤器。
注意"实时"和"继承":作用域是可以继承的(scopeChainOf、bindScopeParent),而限制是动态生效的。这就允许一种很实用的模式:
父作用域:注册 20 个工具
↓ 继承
子作用域(某个受限 agent):实时过滤掉 15 个危险工具
同一份真源,不同的可见性视图。 这和 Session 的做法(一份日志,多种派生)在哲学上完全一致:
dsh 里到处都在做同一件事:保持唯一真源,用投影/过滤器产生不同视图。
十、闪光点五:Capability Seam —— 替换一个 provider,改变整个产品
docs/capability-seams.zh.md 定义了一个叫 seam 的概念:
一个 seam 是一项可替换能力,包含三种角色:声明接口的 Service Definition、实现它的 Service Provider,以及使用它的 Consumer(通常是面向模型的工具)。
一个包可以合并承担多个角色,但单一角色本身不是 seam;添加一项能力意味着把三者一并设计。
它给出的例子,是整个项目里最能说明"为什么这样设计"的一段:
seam 正是替换一个提供方就能改变整个产品的原因。文件系统与进程提供方共享同一个执行世界,因此把它们指向远程沙箱,也就把 Bash、PTY 和 LSP 一并搬了过去,无需提供方专用 fork。
这句话值得反复读。它说的是:
不是"给 bash 加一个远程模式"
而是"把文件系统和进程的 provider 换掉"
↓
bash 跟着走了
PTY 跟着走了
LSP 跟着走了
因为它们共享同一个"执行世界"。
这就和前面几个项目的做法形成了鲜明对比:
| OpenHands | 专门的 Runtime 抽象(Docker/Remote/Modal/Runloop) | 每个 Runtime 实现要覆盖所有能力 |
| DeerFlow | sandbox/tools.py + 多 provider(E2B/AIO/local) | 沙箱提供的能力要显式对齐 |
| Goose | Builtin 扩展开 use_docker | Docker 是扩展的一个开关 |
| dsh | 换掉 fs + subprocess 两个 provider | bash/PTY/LSP 一起搬家,无需专用 fork |
dsh 的做法有个隐含前提:"执行世界"要先被抽象成少数几个基础 provider。 如果 bash 是直接调 child_process.spawn,那就做不到。
所以 seam 的价值不在于"多一个抽象层",而在于"把抽象层画在正确的位置"。 画对了,换一个 provider 就搬走了整个执行世界;画错了,就变成"每加一个环境,就要改五个地方"。
seam 也要给 subagent 用
文档里还有一句很值得注意:
subagent 提供方在同一个接口之后同样千差万别,从新建一个子 agent,到把一个轮次委派给另一个产品。
也就是说:"派生子代理"这件事本身也是 seam。它的两种极端实现是:
实现 A:新建一个子 Agent(进程内,共享 runtime)
实现 B:把一个轮次委派给另一个产品(比如把任务转给别的 Agent 产品)
dsh 甚至把实验性的 Agent Teams 也做成了 seam:
实验性 Agent Teams 是 ctx.agentTeams 上公开发布、显式启用的协作 seam,在可继续 subagent 之上提供持久 roster、任务板和 mailbox。
把"多 Agent 协作"降格为一个可开关的 seam,而不是内核能力——这是"无特权内核"理念贯彻到底的表现。
十一、闪光点六:Profile / Bundle —— 组装即"有序 patch 层"
前面讲的都是"零件怎么设计"。但零件再多,也得有人把它们拼起来。
dsh 的组装模型是:运行中的 dsh 是一棵插件树,由启动时按序叠加的各层组合而成。
两个概念:
Profile:具名组装,存放在 Harness home。它列出自己叠放的组合包,存放树外插件,并保存用户的 cordis.patch.yml。随发行版交付的有 web、headless、sdk、sdk-minimal、acp 五套模板。
组合包(Bundle):Cordis 配置项及其挂载代码的分发格式。
两者都在自己的 package.json 里声明。这是真实的验证结果:
// packages/bundle/base/package.json
{
"name": "@deepseek-ai/dsh-base",
"dsh": {
"bundle": { "patch": "./cordis.patch.yml" }
}
}
而 cordis.patch.yml 长这样(packages/bundle/base/cordis.patch.yml):
# The dsh-base bundle patch: the shared core of each base-backed profile, applied as
# ONE insert over the empty profile root. Later bundle patches and the user's
# profile cordis.patch.yml address these rows by id, with the last write
# winning per row.
#
# A patch replaces the targeted row's whole `config` rather than merging into
# it, so a row whose value differs by mode does NOT live here…
#
# Row order carries no load semantics (activation is service-availability
# driven); the grouping is for readers.
– insert:
– id: tool-plugin-manager
name: '@deepseek-ai/dsh-plugin-manager/tools'
disabled: true
– id: plugin-manager
name: '@deepseek-ai/dsh-plugin-manager'
disabled: !!js "!ctx.get('profileContext')"
– id: llm
name: '@deepseek-ai/dsh-llm'
– id: session
name: '@deepseek-ai/dsh-session'
…
这段 YAML 的注释里藏着三个设计决定,每一个都值得学:
① 一条 patch 替换整块 config,而不是合并进去
A patch replaces the targeted row's whole config rather than merging into it.
为什么?因为部分合并会产生"没人能推理出最终值"的风险。如果三层 patch 各改了 config 的一个字段,最终值要人脑拼。替换整块虽然啰嗦(mode bundle 要重述完整配置),但结果永远是确定的。
这是个很成熟的取舍:用"写起来啰嗦"换"读起来确定"。
② 行的顺序不承载加载语义
Row order carries no load semantics (activation is service-availability driven); the grouping is for readers.
插件不是按你在 YAML 里的顺序启动的,而是由"服务可用性"驱动——也就是 inject 声明的依赖关系。你在文件里把 session 写在 llm 前面或后面,结果一样。
这正是依赖注入相对"手工编排启动顺序"的最大优势。 而且它解决了一个实际痛点:加一个新插件,你不需要知道该插在第几位。
③ 分层顺序是固定的
最终生效顺序是:
空条目列表
↓ 按 profile 列出的顺序,逐个应用组合包 patch
↓ profile 的 cordis.patch.yml
↓ home 级的那份 cordis.patch.yml
↓ 任意 –patch overlay
"最后写入者胜出,逐行生效"。用户永远站在最上层,能覆盖任何东西——包括禁用一个官方插件。
官方还提供了一个很好用的自检命令:
dsh –profile web –dump-config
它打印出的任何条目,都可以由你自己的 patch 替换。
"任何条目都能被替换"这句话,是"无特权内核"最直白的表达。
十二、闪光点七:工具执行流水线
ctx.tools.execute() 的流程(docs/subsystems/tools.zh.md):
tools/pre-execute (可重排的 allow/deny/ask waterfall)
↓
已注册的单调 guard
↓
tools/execute (环绕分派包装层)
↓
tools/post-execute (检查/替换结果)
↓
最终产出 ToolExecutionResult
这个设计里有两个词特别关键:
"可重排的 waterfall" —— 多个策略插件(权限、审计、配额)可以通过 waterfall 组合,而且顺序可以被重排。这解决了一个现实问题:权限检查应该在最外层还是最内层?
"单调 guard" —— 注意是"单调"(monotonic)。这个词意味着策略只能越来越严格,不能放松。这是一个很聪明的约束:
插件 A:这个工具允许
插件 B:不,这个工具禁止 ← 单调:禁就是禁,后续插件不能翻回来
如果 guard 是可放松的,那么"安全策略"就变成了"最后注册的那个插件说了算"——这是个安全漏洞。用"单调"把语义钉死,说明设计者真的想过这个问题。
调度:屏障 + 滚动池
工具调用的调度方式也值得一提:
/**
* Scheduling mode for one pending call. `parallel` may overlap with siblings;
* `exclusive` runs alone and forms an ordering barrier.
*/
type ToolExecutionMode =
| { kind: 'parallel' }
| { kind: 'exclusive' }
对应文档里的:
agent loop 向注册表查询每个待处理调用的执行模式,并据此形成独占屏障和滚动池并行执行。
也就是说:并行是有边界的。
工具 A(parallel) ┐
工具 B(parallel) ├─ 滚动池:并行执行
工具 C(exclusive) ┘─ 屏障:等前面全完,独占执行,后面再等它
为什么需要 exclusive?因为有些操作天然不能并行——比如改同一个文件、提交 git、写数据库。
大多数框架要么全串行(慢),要么全并行(危险)。 dsh 让工具自己声明自己的执行模式,由 loop 按声明调度。这是个"把并发语义交还给能力提供方"的设计。
十三、闪光点八:不变量机制 —— 每个包为自己的契约负责
这是我在这八个项目里第一次见到的设计。
packages/runtime-diagnostics/invariants/ 提供 ctx.invariants——一个可配置的运行时不变式检查注册表:
每个工作区包发布一个 ./invariant 配套插件,以自己确切的 npm 包名注册检查。
也就是说:
dsh-session → 发布 session/src/invariant.ts
dsh-agent-loop → 发布 agent-loop/src/invariant.ts
dsh-tools → 发布 tools/src/invariant.ts
(我验证过,这三个文件都真实存在。)
为什么这个设计好?
因为它把"谁最懂自己的不变量"这个问题回答对了:
| 核心写一堆全局检查 | 核心要知道所有包的内部约定 → 必然耦合 |
| 每个包自己检查 | ✅ 包最懂自己的契约,核心只管调度和归因 |
文档还特别强调了两件事:
① 检查的边界
检查可以断言什么(权威事件流或可变数据,绝不是服务或方法是否存在)
"绝不是服务或方法是否存在"——这条禁令很精确。因为"某个服务存在吗"是依赖注入该管的事(inject 机制已经保证了),让不变量去查这个,等于重复实现一套机制。
不变量该管的是语义:比如"同一个步骤里的 tool/call 和 tool/result 必须配对"(assertToolResultRewrite)、"轮次与步骤编号必须单调"(seq-ranges.ts)。
② 可以为特定包开关
interface Config {
/** Global switch; defaults to `true`. */
readonly enabled?: boolean
/** Case-sensitive JavaScript regex sources that admit package names; empty admits all. */
readonly package_allowlist?: string[]
/** Case-sensitive JavaScript regex sources that exclude package names after allowlist matching. */
readonly package_blocklist?: string[]
}
用正则 allowlist/blocklist 选择要跑哪些包的检查。而且有个细节——
校验在服务启动时明确报错:空白、首尾带空白、重复或无效的条目会抛出异常,而不是被跳过。
配置写错了要炸,不能静默跳过。 这条规则和后面要讲的那次故障(!!js 静默没生效)恰好是同一个教训的两面——能报错的就一定要报错,因为静默失效是最贵的 bug。
十四、代价:一次真实故障,比任何架构图都有说服力
前面讲的都是收益。现在讲代价——而这一次,我不打算自己推测,因为官方自己写了复盘。
docs/postmortem/0002-js-expression-disabled-filesystem-tools.zh.md,标题是:
事故复盘 0002:文件系统快照工具被永久禁用
摘要:
ACP 示例试图通过 disabled: !!js … 有条件地启用文件系统插件,但 Cordis 仅在插件 config 内部对 JavaScript 表达式求值。原始的表达式对象为 truthy,因此文件系统栈始终处于禁用状态。
根因写得更清楚:
实现时假设 !!js 适用于整个 Loader 配置项。实际只有 entry.options.config 使用它:Entry._resolveConfig() 对该字段进行插值,而 Entry.disabled 直接测试 entry.options.disabled,不经过插值。
YAML 标签在语法上合法,因此加载过程不产生任何诊断信息。
请仔细看这段。这是"声明式插件配置"最典型的失败模式:
配置写法:disabled: !!js "someExpression()"
↓
YAML 语法:✅ 合法
加载过程:✅ 无报错
运行结果:❌ 表达式对象恒为 truthy → 插件永久禁用
语法合法 + 静默失效 = 最难查的 bug。
更可怕的是第二部分:测试还通过了
复盘里写了对影响范围的说明:
七个文件系统场景和一个混合工作区编辑场景调用了注册表中不存在的工具。其结构化会话日志携带 ToolNotFoundError(code 为 UNKNOWN_TOOL),stdout 渲染出通用的失败工具卡片。
快照套件通过了,因为结构化会话日志和 stdout 渲染出的通用失败工具卡片均与刷新后的 fixture(测试前置数据)匹配;它证明的是回归的确定性回放,而非文件系统行为的正确性。
这是我看过最值得引用的测试教训:
快照测试通过 ≠ 功能正确。
当"预期输出"是从"实际输出"刷新出来的,测试就从"验证行为"退化成"记录行为"。
一个工具被禁用到"完全不存在",测试套件依然全绿——因为测试记录的是"失败长什么样",而不是"应该成功"。
复盘给出的四条教训
官方列出了教训,我原样引用,因为它们比任何"最佳实践清单"都真实:
- 语法上被接受的配置值不一定在该位置被求值;应记录并验证具体对哪些字段进行插值。
- 快照刷新是 fixture 的生产过程,不是正确性审查。 诸如已注册工具缺失这类语义上不可能的结果,需要独立于预期输出的断言。
- 权限控制只应描述其实际管辖的能力。
- (防护措施)verify-cordis-config 解析仓库中的 Cordis YAML,拒绝 Loader 配置项元数据中的表达式节点。
注意最后一条——他们的修复方式不是"改完之后更小心",而是加了一个静态检查:解析所有 Cordis YAML,只要发现 disabled 这类元数据里出现表达式节点,就报错。
这是"把踩过的坑变成工具"的正确姿势。
这一节想说什么
我想说的是:"Everything is a Plugin" 的代价,不是"抽象层太多",而是"失败模式变隐蔽了"。
在传统的写死架构里:
文件系统工具没注册 → 代码里 grep 一下就知道为什么
在插件化架构里:
文件系统工具没注册
→ 配置语法没错
→ 加载日志没报错
→ 但某个字段没被求值
→ 而它长得很像会被求值
插件化的收益是"改配置就能改行为";代价是"改错了不一定报错"。
而 dsh 的应对(verify-cordis-config 静态守卫 + 启动时抛异常而不是静默跳过 + 快照拒绝结构化错误结果)恰好给出了通用答案:
插件化架构的成熟度,不体现在"有多少扩展点",而体现在"有多少道防线"。
十五、代价:抽象层数与学习成本
除了失败模式,还有更朴素的成本——要理解它,你得先学多少东西。
我实际走了一遍,门槛大概是这样的:
第 1 层:Cordis 的五个概念
(插件 / Context / inject / 类型化事件 / 可逆副作用)
第 2 层:五种事件分发模式
(emit / waterfall / parallel / serial / bail)
+ waterfall 的"环绕中间件"语义
第 3 层:三类事件域如何选
(会话事件 / Agent 事件 / 能力事件)
第 4 层:主干六个包 + 54 个包的分布
第 5 层:Profile / Bundle / patch 叠加顺序
第 6 层:Scope 的作用域继承与过滤
第 7 层:seam 三角色(Definition / Provider / Consumer)
官方很坦诚地承认了这个门槛——docs/architecture.zh.md 第一句就是:
改动 packages/ 下的任何内容之前,请先阅读本文。本文假定你已了解 Cordis;如果尚未了解,请先阅读入门或教程。
建议使用 agent 探索代码库并理解其架构。
最后一句很有意思:项目自己建议你用 AI Agent 来理解它。 这既是坦诚(承认复杂度高),也侧面说明了规模——2206 篇决策记录、3198 个 TS 文件,人力通读不现实。
对简单场景,它确实是过度设计
一个诚实的判断:
| 一个 Agent + 3 个工具 + 1 个模型 | 别用 dsh,100 行手写 loop 更快 |
| 需要多模型 + 多会话 + 可恢复 | 用 LangGraph / DeerFlow 级别就够 |
| 要做一个会被反复重组的产品(多端 + 多 profile + 可换 loop + 多租户作用域) | dsh 这类架构开始有意义 |
docs/architecture.zh.md 里有一句话说明了它的目标场景:
受支持的 Node 应用通过具名 dsh profile 启动。随附 profile 为 web、headless、sdk、sdk-minimal 和 acp。
五个 profile、四种端(Web/Desktop/CLI/SDK)、两种语言 SDK(TypeScript + Python)——这才是它要支撑的东西。
所以对它的架构评价,标准应该是:
不是"它简单不简单",而是"它用这份复杂度,换到了多少组装自由度"。
我的判断是:换到了。 但前提是你真的是在做产品,不是一个项目。
十六、代价:开发者预览阶段的不稳定
最后一个代价,写在 README 里:
开发者预览
DeepSeek Harness 处于 开发者预览 阶段,正在快速迭代。未来将出现破坏兼容性的变更。
版本号 0.1.6-alpha.2 也印证了这一点。
这意味着两件事:
① 现在学它,学到的是"思路",不是"API"。
具体代码会变,但"三类事件域"、"无特权内核"、"可逆副作用"这些设计判断,是能带走的。
② 它自己的文档就在处理这种不稳定。
Session 格式有版本化迁移机制:
JSONL v0 使用 session.jsonl[.zstd],v1 及后续版本使用小写 session.vN.jsonl[.zstd];已提交 generation 路径绝不重命名、替换或删除。
注意"绝不重命名、替换或删除"——已发布的数据格式当成不可变契约。而且迁移是逐级的:
每个相邻迁移包只负责一个 vN -> vN+1 步骤。
而不是 v0 → v5 一个大迁移。 这样 N 个版本只需要 N-1 个迁移,而不是 N² 个。这是个能直接用在你项目里的模式。
十七、和前面八个项目放在一起看
现在做一次横向对照。这是我认为这次赏析最有价值的部分——九个项目,九种对同一个问题的不同回答。
| LangGraph | 自建 StateGraph | 图状态 + checkpoint | Node + Tool | 加节点/边 | 编排能力 ↔ 图复杂度 |
| OpenHands | 自建 reasoning-action loop | Event Stream | Runtime 内建 | 加 Runtime/工具 | 执行能力 ↔ 安全边界 |
| browser-use | 自建 step 循环 | 单状态消息覆盖 | 进程内 Tool | 注册工具 | 感知精度 ↔ 上下文成本 |
| DeerFlow 2.0 | create_agent + middleware | Checkpoint + RunStore | 可插拔 provider | 加 middleware/subagent | 长任务健壮 ↔ 协调复杂度 |
| Hermes | 手搓 _LoopState | Memory Provider | 插件化 | Memory/Skill Provider | 自我进化 ↔ 记忆污染 |
| OpenCode | 流式 processor + 三态返回 | Session + compaction | 惰性注册 Tool | 加 Tool/Provider | 交互体验 ↔ 抽象层(Effect-TS) |
| Goose | 状态机 reply_with_state_machine | Session | MCP Extension | 加 MCP server | 无限扩展 ↔ 配置复杂度 |
| dsh | 插件(可实现可替换) | append-only 日志(派生历史) | seam + 流水线 | 挂插件到插件旁 | 组装自由度 ↔ 失败隐蔽性 |
看这张表能发现一条清晰的演进:
LangGraph → 编排层的可组合
OpenHands → 执行层的可替换(Runtime)
browser-use → 感知层的可组合
DeerFlow → 任务层的可替换(middleware/subagent)
Hermes → 记忆层的可替换(Memory Provider)
OpenCode → 能力层的可组合(Tool/Provider)
Goose → 工具层的可替换(MCP 协议边界)
dsh → 把上面这些"层"全部统一成同一种东西:插件
前八个项目,各自在某一层做可替换;dsh 把"可替换"变成了架构的默认形态。
而 dsh 和前八个最本质的一个差别是:
其他项目的作者知道自己是"框架/产品";dsh 的设计者知道自己是在定义"一种组装方式"。
证据就是那篇论文——它不只是写了个 Agent 框架,它把这件事抽象成了"时空可组合性编程范式"。
十八、如果你想读它,建议的路线
基于我的实际阅读经验,给你一条效率最高的路线:
第 1 步 README.zh.md(10 分钟)
知道它是什么、什么阶段、怎么跑
第 2 步 docs/cordis-primer.zh.md(15 分钟)
★ 最关键的一步。不懂 Cordis 的五个概念,后面全是天书
第 3 步 docs/architecture.zh.md(40 分钟)
三个 anchor 要读透:turn-flow / events / 能力 seam
特别是「新行为的归属位置」那张表——它把"想做什么 → 该动哪里"完全对上了
第 4 步 docs/agent-lifecycle.zh.md(20 分钟)
那份 Mermaid 时序图,一次轮次的完整生命周期
第 5 步 docs/subsystems/session.zh.md(60 分钟)
事件词汇 + 派生历史 + fork API
★ 如果只读一个子系统,读这个
第 6 步 docs/subsystems/core.zh.md(60 分钟)
Agent 句柄、创建与所有权、agent/* 事件
重点看「Agent 句柄」一节——那个 cancel 的语义文档写得极细
第 7 步 docs/postmortem/0002-*.zh.md(10 分钟)
★ 全项目性价比最高的一篇。10 分钟读到一个真实故障的完整因果链
第 8 步 按需读子系统(tools / persistence / scope / invariants / capability-seams)
不要从 frontend 开始
不要从 packages/ 逐个读源码(3198 个文件)
不要跳过 cordis-primer —— 跳过它,后面每一步都要回头
然后读源码,建议只看这三处(每处都很短、很值):
packages/core/session/src/surface.ts:119 deriveEventMessage ← 派生历史的心脏
packages/core/session/src/types.ts SessionEventMap ← 事件词汇的定义
packages/core/agent-loop/src/agent.ts:72 ReactLoopAgent ← "loop 是插件"的落点
十九、我认为最值得带走的三个工程原则
如果这篇赏析只留下三句话,我会留这三句。
第一:状态不该住在"那个可能被替换的东西"里
❌ Agent
├── self.messages ← 换了 Agent 就断了
└── self.state
✅ EventLog(唯一真源)
↓ derive
Message[](派生,随时可重建)
唯一真源 = 一个 append-only 日志 + 一个纯派生函数。
这条原则的通用价值远超 Agent:
数据库 → WAL + 物化视图
前端 → 单向数据流(state → view)
协作编辑 → CRDT 操作日志
Agent → SessionEvent[] + deriveMessages()
它们都在做同一件事:把"当前状态"降级为"历史的投影"。
第二:注册必须可逆,否则谈不上可组合
ctx.effect() → 返回 disposer
ctx.on() → 卸载时自动撤销
"可组合"的前提不是"能加",而是"能干净地去掉"。
这一条直接推翻了很多项目里那句"我们支持插件"——如果不能卸载,那不叫插件,那叫在启动时调用你一次。
而 dsh 把这条做到极致的表现是:连 Agent Loop 都能卸下来。
第三:插件化架构的成熟度,体现在"防线"上,不在"扩展点"上
回看那次故障:
配置语法合法 ✅
加载无报错 ✅
插件永久禁用 ❌
测试全绿 ✅ ← 最可怕的在这里
修完之后,他们加了四道防线:
静态守卫 verify-cordis-config 解析所有 YAML,拒绝元数据里的表达式
启动校验 配置非法直接抛异常,不静默跳过
不变量 每个包为自己的契约发布 invariant 检查
测试守卫 快照拒绝结构化 UNKNOWN_TOOL 结果
扩展点越多,静默失效的路径就越多。所以架构越灵活,越需要自动化防线。
这句话可以反过来检验任何一个自称"高度可扩展"的项目:
你的防线在哪?
二十、工程评价
我不会简单地说"dsh 架构很先进"。按维度拆开:
| 架构一致性 | ★★★★★ | "无特权内核"从 README 贯彻到每一个包,没有例外 |
| 依赖注入的应用 | ★★★★★ | vendor 成熟框架 + 用 key 查找服务 + 绝不导入具体实现 |
| 状态管理设计 | ★★★★★ | append-only 日志 + 派生历史 + "模型可见即已记录"不变量 |
| 可组合性 | ★★★★★ | 空间(Scope)+ 时间(可逆副作用)两个维度都做了 |
| 可观测/可回放 | ★★★★★ | 事件溯源天然支持 replay / fork / resume |
| 自我反思透明度 | ★★★★★ | 2206 篇决策记录 + 4 篇公开故障复盘(罕见) |
| 文档质量 | ★★★★★ | 中文双语 + 生成式目录 + 与源码交叉校验 |
| 初学者友好度 | ★★☆☆☆ | 必须先学 Cordis;官方自己建议"用 agent 帮你读" |
| 排查难度 | ★★☆☆☆ | 事件流解耦了执行顺序;一次故障可能静默无声 |
| 稳定性 | ★★☆☆☆ | developer preview,明确会有破坏性变更 |
| 小项目适用性 | ★☆☆☆☆ | 54 个包对"1 Agent + 3 工具"是彻底的过度设计 |
| 工程参考价值 | ★★★★★ | 这是目前我见过把"可组合性"做得最彻底的开源 Agent 项目 |
它最大的优点:
把"可替换"从一句口号变成了一整套可执行的机制——包括让最核心的 Agent Loop 也成为可卸载、可拦截、可替换的一层。
它最大的缺点:
它把"理解成本"变成了使用门槛,而把"静默失效"变成了主要失败模式。 前者靠文档(他们做得很好)缓解,后者只能靠防线(他们在补)。
最值得你立刻拿走的两点:
① "模型可见即已记录" + deriveMessages()
→ 状态离开主体,主体才可能被替换
② postmortem 0002 那条教训
→ "语法上被接受的值不一定在该位置被求值"
→ 给所有"声明式配置"依赖加静态检查
二十一、不要抄 dsh,要学 dsh
和前面八篇一样,最后都要说这一句:别照搬。
如果看完这篇你就把自己的项目改成"一切皆插件",那大概是这次赏析最坏的结果。因为:
你的项目:1 个 Agent + 5 个工具 + 1 个模型
dsh 的答案:54 个包 + 6 个主干 + 三类事件域 + 五层 patch
它的每个设计决定,都对应它要解决的具体问题:
| 一切皆插件 | 产品要支持 5 个 profile × 4 种端 × 2 种 SDK | 你有多个交付形态 |
| Agent Loop 可替换 | 别人(或未来的你)要换推理范式 | 你确实要实验不同 loop |
| Session 事件溯源 | loop 可换后,历史不能断 | 你要支持 replay/fork/审计 |
| Scope 作用域 | 多 Agent 共享代码、隔离可见性 | 你有真正的多租户/多 Agent |
| 三类事件域 | 持久/实时/决策三种生命周期混在一起会乱 | 你的事件开始打架 |
| seam 三角色 | 换一个 provider 要能搬走整个执行世界 | 你有多种执行环境 |
而如果你的答案是"都不需要",那就老老实实写一个 300 行的 loop。
这才是 dsh 自己教给我们的东西——它的 architecture.zh.md 里有一句话,我认为是整个项目最值得记住的一句:
不存在需要打补丁的特权内核:扩展 dsh 的方式是把插件挂载到其他插件旁边。
这句话的另一面是:
在你有能力把每一层都做成插件之前,先想清楚哪一层真的需要被替换。
二十二、结语
回到标题那个问题。
为什么 DeepSeek 把整个 Agent 都做成了 Plugin?
我的答案分三层:
第一层(表面):为了可扩展。加模型、加工具、加沙箱不用改内核。
第二层(较深):为了可替换。它连自己都可能被换掉——包括 Agent Loop 这个"程序骨架"。
第三层(最深处):因为它要做的不是"一个 Agent 产品",而是"一种组装产品的方式"。README 引用的那篇论文标题说得很明白——时空可组合性:
空间维度:Scope —— 同样的代码,能按作用域产生不同可见性
时间维度:可逆副作用 —— 任何注册都能干净地撤销
当"可组合"成为第一目标时,所有的具体设计(append-only 日志、事件三域、seam、profile、bundle、scope)就都成了同一个命题的不同投影:
保持唯一真源,其余都是投影。 别让任何东西成为不可替换的骨架。
而它付出的代价也同样清晰:
你换来的是"一切都能换",你付出的是"换错了不一定报错"。
所以真正值得从 dsh 身上学的,不是它的 54 个包,而是它把这两件事同时摆出来的诚实——README 里写"开发者预览、会有破坏性变更",文档里写"建议用 agent 帮你读代码",postmortem 里写"我们的快照测试证明的是回放,不是正确性"。
一个把成本和收益都摊开讲的项目,比一个只讲"我们架构先进"的项目,值得学得多。
附录 · 本文引用到的真实位置
| "一切皆插件"主张 | README.zh.md |
| Cordis 五个概念 / 五种分发模式 | docs/cordis-primer.zh.md |
| 无特权内核 / Profile 与组合包 / 轮次流程 / 新行为归属表 | docs/architecture.zh.md |
| 轮次与步骤时序图 | docs/agent-lifecycle.zh.md |
| SessionEventMap / 派生历史 / fork API / TurnEndReason | docs/subsystems/session.zh.md |
| 主干逐包速览 / Agent 句柄 / AgentHandle | docs/subsystems/core.zh.md |
| 工具执行流水线 / 单调 guard / 执行模式 | docs/subsystems/tools.zh.md |
| 运行时不变式注册表 | docs/subsystems/invariants.zh.md |
| Scope 原语 | docs/subsystems/scope.zh.md |
| seam 三角色 | docs/capability-seams.zh.md |
| vendored 框架改名表 | docs/rescope.zh.md |
| 故障复盘 0002 | docs/postmortem/0002-js-expression-disabled-filesystem-tools.zh.md |
| deriveEventMessage() | packages/core/session/src/surface.ts:119 |
| ReactLoopAgent implements Agent | packages/core/agent-loop/src/agent.ts:72 |
| ScopeKey = object | packages/core/scope/src/index.ts:15 |
| AgentHandle | packages/core/agent/src/index.ts |
| Agent 接口 | packages/core/agent/src/types.ts |
| Bundle 声明 | packages/bundle/base/package.json → dsh.bundle.patch |
| 组合包 patch 实物 | packages/bundle/base/cordis.patch.yml |
系列导读:本文是「AI Agent 项目赏析」系列第 9 篇。
1. LangGraph → Workflow Agent(任务怎么编排)
2. LangGraph(进阶) → Agent Orchestration
3. OpenHands → Coding Agent(怎么执行真实动作)
4. browser-use → 浏览器 Agent(怎么感知真实界面)
5. DeerFlow 2.0 → SuperAgent(长任务怎么跑不死)
6. Hermes Agent → Persistent Agent(怎么自我进化)
7. OpenCode → Terminal Agent(产品怎么组织)
8. Goose → MCP-native Agent(工具怎么变成服务)
9. DeepSeek Harness → Plugin-native Runtime(连 Loop 都是插件)← 本篇
下一篇计划:OpenMAIC —— 看一个 Agent 如何自主构建完整的交互式课程,重点落在「Durable Agent Runtime」与「Agent 如何生产真正可交付的产品」。


评论前必须登录!
注册