 网硕互联帮助中心
从「闭卷考试」到「开卷考试」——用 80 行 Python 从零搭一条跑得通的 RAG,把切块、向量、检索、重排每一步都拆开看
目录
一、大模型为什么会"一本正经地胡说八道"
二、RAG 三个字母,拆开就是一句大白话
三、RAG 只做两件事,但每件事都有一堆讲究
四、手搓一个最小可运行的 RAG
五、"住酒店"为什么搜不到"住宿"?
六、切块:最不起眼,却最致命的一步
七、生产环境里的 RAG,还装了什么"选装件"
八、三个真实的落地案例
九、RAG 的边界:什么时候你不该用 RAG
十、怎么判断你的 RAG 做得好不好
十一、给零基础的落地路线
十二、常见问题
数据时效声明
参考资料
先讲一个我很喜欢的场景。
某公司内部上线了一个 AI 助手,员工可以问它各种规章制度。上线第一周口碑不错,直到有位同事问:"出差住宿一晚最多能报多少钱?"
助手回答得又快又自信:"根据公司规定,住宿标准为每晚不超过 1500 元,超标部分可申请特批。"
这位同事真的按 1500 元订了酒店。回来报销时才发现,公司规定是一线城市 600 元,没有任何"特批"条款。那个 1500 元,是模型自己编出来的。
更麻烦的是:你很难从回答里看出它在编。它的语气和答对时一模一样,格式工整、条理清晰、甚至还"贴心地"补充了不存在的例外情况。
这就是今天要讲的东西——RAG。它解决的正是这个问题:怎么让 AI 说错的时候,至少不要说得那么理直气壮;以及怎么让它说的话,你能翻到出处。
这篇文章我会把 RAG 从"三个字母"一路拆到"能跑起来的代码"。你不需要任何 AI 基础,只要会一点点 Python(甚至不会也行,代码我都配了逐行解释),就能完整看懂这条链路到底发生了什么。
而且我不打算只用比喻糊弄你。文章里有三段代码是真的能跑的——你在自己电脑上复制粘贴就能复现,连 API Key 都不用。包括那个"住酒店报多少钱"的真实检索失败案例,我会让你亲眼看它错一次、再修好一次。
一、大模型为什么会"一本正经地胡说八道"
要理解 RAG,得先理解大模型的一个根本特征:它的知识被"冻"在了训练结束的那一刻。
训练完,知识就凝固了
大模型是通过阅读海量文本训练出来的。训练过程中,它把看到的东西压缩进了自己的参数里——你可以粗暴地理解成:它把整个互联网"背"了一遍。
但"背"有三个麻烦:
第一,背完就定型了。模型训练结束的那一天之后发生的事情,它一概不知道。公司昨天新发的通知、上个月改的报销标准、今天早上更新的产品价格,它的脑子里都没有。
第二,背得不精确。人背书会串行,模型也一样。它记住的是"大概意思"和"语言规律",而不是一份逐字逐句的档案。你问它某个文件的第 3 条第 2 款写了什么,它答不出来——它可能连这个文件是否存在都不知道。
第三,也是最要命的:它不会说"我不知道"。
幻觉不是 bug,是它的本能
这里有个反直觉的点,值得你停下来想一想。
大模型的本质工作,是预测下一个字最可能是什么。你给它一句话,它算出接下来最该出现的词,然后一个字一个字往下接。
注意:它的任务从来不是"说真话",而是"说出最像真的那段话"。
所以当它遇到一个知识空档时,它不会停下来,它会用语言规律把空档填平——因为它被训练成"必须接下去"。这个填空出来的内容,语法通顺、逻辑自洽、语气笃定,看起来和真话没有任何区别。
这就是"幻觉"的本质:它不是模型坏掉了,而是它在忠实地执行"把话接完整"这个任务。
一个几乎必然发生的推论
理解了上面这些,你会发现一个结论几乎是必然的:
光靠换一个更大、更强的模型,解决不了这个问题。因为模型再强,它的知识依然是凝固的、大概的、无法溯源的。
你可能会想:那我把它训练得更准一点行不行?可以,但代价很大——每次知识更新都要重训一次模型,而且你依然无法保证它对答如流时不编造。
于是有人提出了另一个思路:别指望模型自己记住,我们把资料准备好,在它回答之前递给它。
这就是 RAG。
二、RAG 三个字母,拆开就是一句大白话
RAG 是三个英文单词的缩写:Retrieval-Augmented Generation,中文通常翻译成"检索增强生成"。
这个名字听起来很学术,但拆开看,它其实就是在描述一个非常朴素的流程。这一节我们把三个字母一个一个掰开。
Retrieval:检索,去把相关资料捞出来
用户提问后,系统先去一个资料库里翻找,把和问题最相关的内容捞出来。
关键是:这个资料库是你自己的,而且是你随时可以改的。公司的制度文档、产品手册、客服工单、历史邮件,都可以放进去。
Augmented:增强,把捞到的东西塞进提示词
"Augmented"是"增强、补充"的意思。增强的对象是提示词(Prompt)——也就是你发给大模型的那段输入。
原来你发给模型的只有一句"出差住宿能报多少钱";现在你发的是:
|
提示词 · 发送给大模型的输入 |
|
你是公司内部助手。请严格依据下面的资料回答问题, 资料里没有的内容不要编造,直接回答"资料中没有相关信息"。 资料: [1] 差旅标准:住宿标准按城市分级:一线城市每晚不超过 600 元…… 问题:出差住宿能报多少钱? 回答: |
这一步是整个 RAG 的核心动作。模型看到的不再是一个孤零零的问题,而是"问题 + 一份参考资料"。
Generation:生成,让模型照着资料说话
模型基于这些资料生成回答。因为它手里有了依据,回答就变成了"从资料里提取 + 组织语言",而不是"从记忆里硬凑"。
而且,因为资料是你给的,你可以顺手做两件事:
这两件事,就是 RAG 相比"裸模型"最大的价值:答案从"不可验证"变成了"可追溯到具体文档"。
|
对比项 |
裸模型(闭卷考试) |
RAG (开卷考试) |
|
知识来源 |
训练时背下来的 |
你当场递给它的资料 |
|
知识更新 |
要重新训练模型 |
改文档、重建索引就行 |
|
能否溯源 |
不能,全靠它自己说 |
能,每条答案能指到原文 |
|
遇到不知道的 |
大概率编一个 |
可以要求它说 " 资料里没有 " |
|
适用场景 |
通用闲聊、写作 |
企业知识库、客服、专业问答 |
|
一句话记住:RAG 不是让模型变聪明,而是让模型"有资料可查",并且告诉你资料在哪一页。 |
这个名字的来历
RAG 这个词不是营销概念,它有明确的学术出处。
2020 年 5 月 22 日,Facebook AI Research(现 Meta AI)联合伦敦大学学院、纽约大学的研究者,在 arXiv 上发布了一篇论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》(论文编号 arXiv:2005.11401),随后发表在 NeurIPS 2020 上。十三位作者中包括 Patrick Lewis、Douwe Kiela 等人。
那篇论文里的原始设计是这样的:用 BERT 训练一个检索器(叫 DPR,稠密段落检索),把 2100 万个、每个约 100 词的维基百科段落事先编码成向量、用 FAISS 建好索引;再用 BART 做生成器。用户提问时,检索器先找出相关段落,生成器再基于这些段落产出答案。
论文的实验结论是:在 Natural Questions、TriviaQA、WebQuestions 三个开放域问答任务上,这套方案超过了纯参数化的模型,而且生成的文本"更具体、更多样、更符合事实"。
七年过去,模型换了好几代,向量库从 FAISS 换成了各式各样的产品,但这套"先检索、再生成"的骨架,一个字都没变。
三、RAG 只做两件事,但每件事都有一堆讲究
RAG 听起来像个复杂系统,但它的骨架其实只有两条流水线。
一条在离线时跑,负责把资料整理成"可被检索"的形态;一条在在线时跑,负责每次回答用户的问题。下面这张图把两条流水线画在一起了。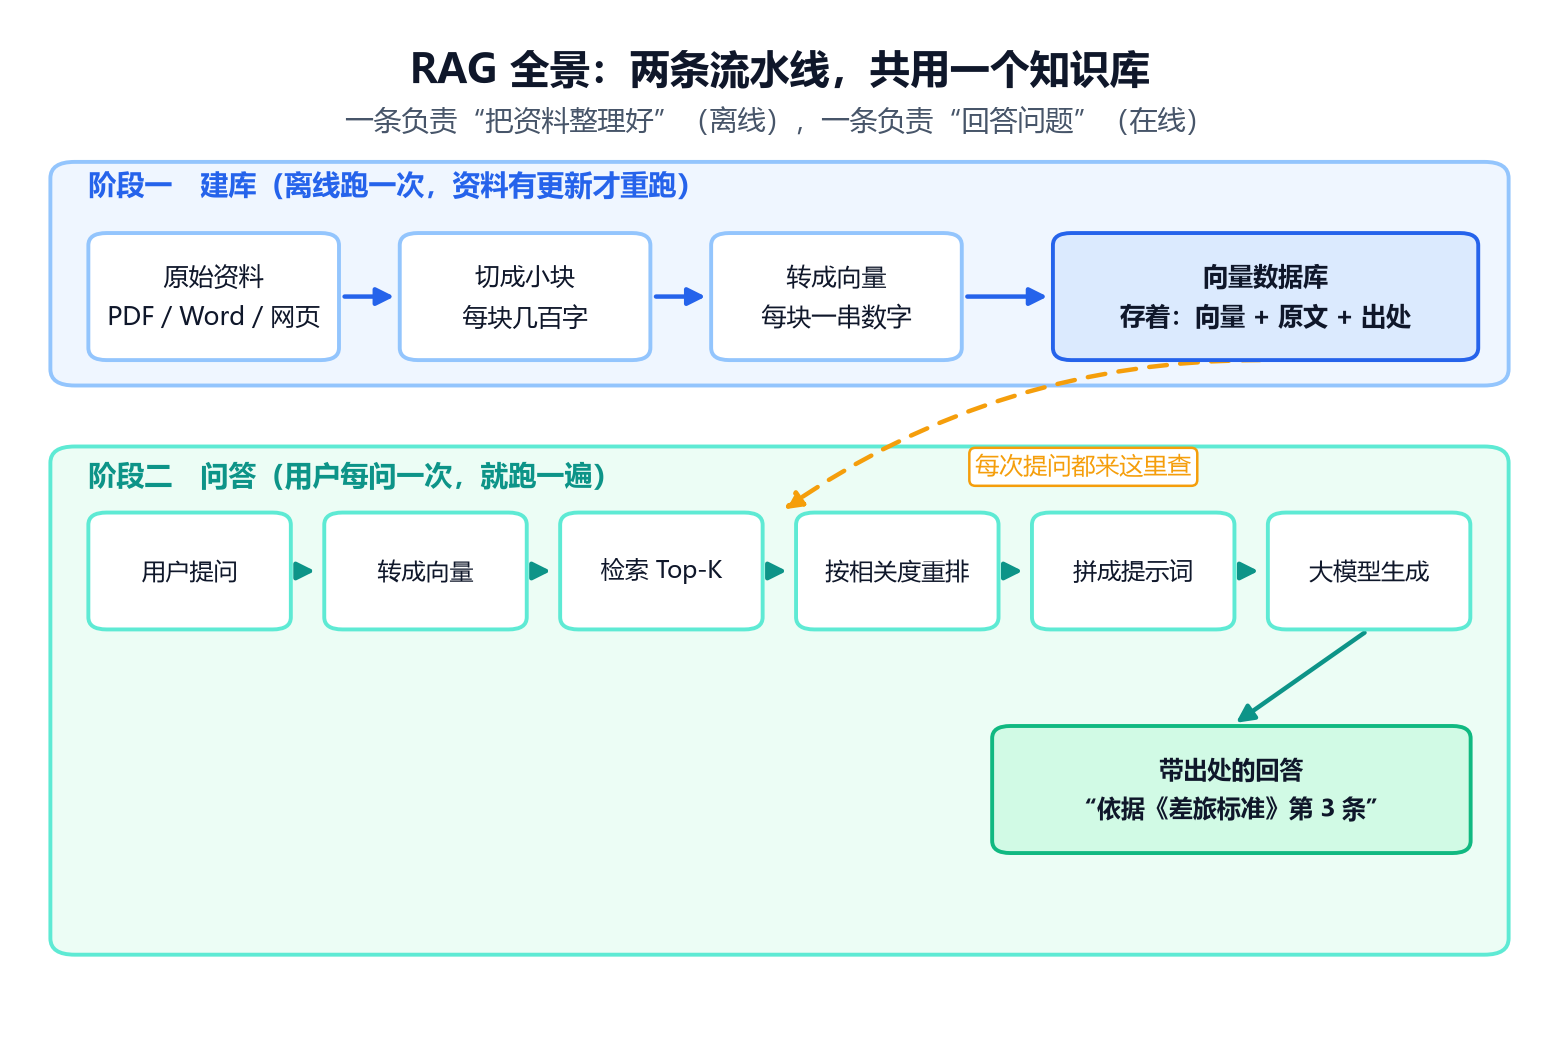 RAG 全景架构图
阶段一:建库(离线跑一次)
这一步的目标是:把一堆乱七八糟的文档,变成一个"按意思就能查"的库。
它包含四个动作:
这一步跑一次可能几分钟到几小时,取决于资料量。只有资料更新时才需要重跑。
阶段二:问答(用户每问一次跑一遍)
这一步的目标是:在几秒钟内,找到最相关的那几段,然后让模型照着说。
一个关键认知
看完这两条流水线,有个事情值得单独拎出来说:
RAG 从头到尾没有改变模型本身。
模型还是那个模型,参数一个都没动。RAG 做的所有事情,都发生在模型的外面——在它张嘴之前,把"该看的材料"摆到它面前。
这个认知非常重要,它直接解释了 RAG 的两个特点:
- 为什么它便宜:不需要标注数据、不需要训练、不需要 GPU 集群,改文档就能改答案;
- 为什么它快:知识更新只需要重建索引,而不是重训模型(一次索引可能几分钟,一次训练要几天)。
|
一句话记住:RAG 不改模型,改的是喂给模型的东西。 |
四、手搓一个最小可运行的 RAG
前面讲了这么多概念,现在我们来动手。
下面这段代码不到 90 行,只用了 Python 标准库——不装任何第三方包,不要 API Key,你复制到本地存成 rag_demo.py 就能直接跑。
它实现了一个完整的 RAG:切块 → 向量化 → 检索 → 拼提示词。虽然简陋,但骨架和工业级系统完全一样。
|
Python |
|
""" 最小可运行 RAG 演示 —— 只用 Python 标准库,不需要任何 API Key。 运行:python rag_demo.py """ import math from collections import Counter # ============================================================ # 第 0 步:知识库(真实项目里是一堆 PDF / Word / 网页,这里手写成小块) # ============================================================ DOCS = [ ("报销制度", "员工出差产生的交通费、餐费和差旅费,需在返回后 15 个工作日内提交报销单。" "单笔金额超过 5000 元,需要部门总监审批;超过 20000 元,还需要财务总监审批。"), ("请假制度", "员工请假需要提前 1 个工作日在系统内提交申请。连续请假 3 天以内由直属主管审批," "超过 3 天需要部门总监审批。"), ("年假规则", "入职满 1 年享有 5 天年假,之后每满 1 年增加 1 天,上限 15 天。" "年假当年有效,最多可以结转 5 天到下一年度。"), ("差旅标准", "住宿标准按城市分级:一线城市每晚不超过 600 元,二线城市 450 元," "其他城市 350 元。超标部分需要员工自行承担。"), ("故障码说明", "错误码 TS-999 表示网关与鉴权服务之间的握手超时,通常由服务器时钟不同步引起," "建议先检查 NTP 服务状态。"), ] # ============================================================ # 第 1 步:切词 # 中文不像英文有空格,正常项目会用 jieba 分词;这里为了不装任何库, # 用一个偷懒但有效的办法:把连续两个字当作一个"词"(bigram)。 # ============================================================ def to_terms(text): text = "".join(ch for ch in text if not ch.isspace()) return [text[i:i + 2] for i in range(len(text) – 1)] # ============================================================ # 第 2 步:把每个文本块变成一个向量(一串数字) # 用经典的 TF-IDF:一个词在本块里出现越多、在所有块里出现越少,权重越高。 # 真实项目会换成 embedding 模型,但"文本 -> 一串数字"这件事是一样的。 # ============================================================ def build_index(docs): term_sets = [to_terms(text) for _, text in docs] df = Counter() # 记录每个词出现在多少个文本块里 for terms in term_sets: for t in set(terms): df[t] += 1 n = len(docs) vectors = [] for terms in term_sets: tf = Counter(terms) vec = {} for term, count in tf.items(): idf = math.log((n + 1) / (df[term] + 1)) + 1 # 平滑 IDF vec[term] = (1 + math.log(count)) * idf # 对数 TF * IDF vectors.append(vec) return vectors, df # ============================================================ # 第 3 步:算"两段文字有多像" —— 余弦相似度 # 把两个向量看成两支箭,夹角越小越像。取值 0 到 1,越大越像。 # ============================================================ def cosine(a, b): common = set(a) & set(b) if not common: return 0.0 dot = sum(a[t] * b[t] for t in common) norm_a = math.sqrt(sum(v * v for v in a.values())) norm_b = math.sqrt(sum(v * v for v in b.values())) return dot / (norm_a * norm_b) def vectorize_query(query, df, n_docs): tf = Counter(to_terms(query)) vec = {} for term, count in tf.items(): idf = math.log((n_docs + 1) / (df.get(term, 0) + 1)) + 1 vec[term] = (1 + math.log(count)) * idf return vec # ============================================================ # 第 4 步:检索 —— 把问题也变成向量,然后找出最像的几块 # ============================================================ def retrieve(query, docs, vectors, df, top_k=2): q_vec = vectorize_query(query, df, len(docs)) scored = [(cosine(q_vec, d_vec), idx) for idx, d_vec in enumerate(vectors)] scored.sort(reverse=True) return scored[:top_k] # ============================================================ # 第 5 步:拼提示词 —— 把检索结果塞进大模型的输入 # ============================================================ def build_prompt(query, hits, docs): context = "\\n".join( "[%d] %s:%s" % (rank + 1, docs[idx][0], docs[idx][1]) for rank, (_, idx) in enumerate(hits) ) return ( "你是公司内部助手。请严格依据下面的资料回答问题," "资料里没有的内容不要编造,直接回答"资料中没有相关信息"。\\n\\n" "资料:\\n%s\\n\\n问题:%s\\n\\n回答:" % (context, query) ) if __name__ == "__main__": vectors, df = build_index(DOCS) print("知识库共 %d 个文本块,建好索引后词表大小 = %d\\n" % (len(DOCS), len(df))) for q in ["出差回来多久之内要报销?", "TS-999 是什么问题?"]: print("=" * 62) print("用户提问:%s" % q) hits = retrieve(q, DOCS, vectors, df, top_k=2) print("检索结果(相似度越高越相关):") for score, idx in hits: print(" %.3f <- [%s]" % (score, DOCS[idx][0])) print("\\n— 最终送给大模型的提示词 —") print(build_prompt(q, hits, DOCS)) print() |
跑出来是什么样
我在本机把这段代码跑了一遍,真实输出是这样的:
|
运行结果 |
|
知识库共 5 个文本块,建好索引后词表大小 = 221 ============================================================== 用户提问:出差回来多久之内要报销? 检索结果(相似度越高越相关): 0.057 <- [报销制度] 0.000 <- [故障码说明] — 最终送给大模型的提示词 — 你是公司内部助手。请严格依据下面的资料回答问题,资料里没有的内容不要编造, 直接回答"资料中没有相关信息"。 资料: [1] 报销制度:员工出差产生的交通费、餐费和差旅费,需在返回后 15 个工作日内提交报销单。单笔金额超过 5000 元,需要部门总监审批;超过 20000 元,还需要财务总监审批。 [2] 故障码说明:错误码 TS-999 表示网关与鉴权服务之间的握手超时,通常由服务器时钟不同步引起,建议先检查 NTP 服务状态。 问题:出差回来多久之内要报销? 回答: ============================================================== 用户提问:TS-999 是什么问题? 检索结果(相似度越高越相关): 0.196 <- [故障码说明] 0.000 <- [差旅标准] |
看到那个提示词的最后一行了吗?"回答:"后面是空的。
因为这一步只是拼好提示词,真正说话的是大模型。把这段文字原样发给任何一个大模型 API(OpenAI、Claude、通义千问、DeepSeek 都行),它就会基于你给的资料回答问题——而且因为你在提示词里明确要求了"资料里没有的内容不要编造",它大概率会老老实实答"15 个工作日",或者在你问它没收录的问题时说"资料中没有相关信息"。
这就是一个 RAG 的全部骨架。
几个值得注意的细节
跑完这段代码,有几个点你可以留意一下。
第一,相似度分数都很小。 0.057、0.196 这样的数字,看起来像是"几乎不相关"。其实不是——在这个稀疏向量的场景下,绝对数值本身没有意义,我们只看相对排序:谁排第一,谁就是最相关的。生产环境里用真正的 embedding 模型时,分数通常在 0.6 到 0.9 之间,但同样的道理,排序比数值重要。
第二,0.000 意味着"一个字都没对上"。 那几行 0.000 表示这个文本块和问题在字面上完全没有共同片段。这个细节很关键,我们下一章就来讲它带来的麻烦。
第三,注意 top_k=2 这个参数。 它决定"捞几段资料"。捞太少可能漏掉关键信息,捞太多会把噪声一起塞给模型(后面第七节会讲为什么"太多"也是问题)。
五、"住酒店"为什么搜不到"住宿"?
上一节的代码跑起来感觉还不错,那是因为我挑了两个"好问题"。
现在我们换一个真实用户会问的问题试试:"住酒店一晚上最多能报多少钱?"
亲眼看看它怎么错的
我在同一个脚本里补了一个对照实验:同一份知识库、同一个问题,跑两遍——第一遍用纯字面匹配,第二遍在切词前加一层"语义归一化"。
|
Python |
|
# 一张"同义词表"。真实项目里这张表由 embedding 模型自动学出来,不需要手写; # 这里手写,只是为了让你亲眼看到"语义归一化"到底在做什么。 SYNONYMS = [ ("最多能报多少钱", "金额上限"), ("一晚上", "每晚"), ("住酒店", "住宿"), ("酒店", "住宿"), ("宾馆", "住宿"), ("多少天", "天数"), ("多久", "时间"), ] def normalize(text, use_synonyms): if not use_synonyms: return text for src, dst in SYNONYMS: # 长词在前,避免"酒店"先被替换掉 text = text.replace(src, dst) return text |
真实输出(两个方案的检索排名对比):
|
运行结果 |
|
################################################################## # 方案 A:纯字面匹配(不做任何语义处理) ################################################################## 提问:住酒店一晚上最多能报多少钱? 第1名 0.029 年假规则 第2名 0.000 故障码说明 第3名 0.000 差旅标准 ################################################################## # 方案 B:加一层语义归一化 ################################################################## 提问:住酒店一晚上最多能报多少钱? 第1名 0.082 差旅标准 第2名 0.041 年假规则 第3名 0.036 报销制度 |
请仔细看方案 A 的结果,因为这里藏着一个非常经典的陷阱。
正确答案"差旅标准"的得分是 0.000。
一个字都没对上。为什么?因为文档里写的是"住宿",用户问的是"住酒店";文档里写的是"每晚不超过 600 元",用户问的是"最多能报多少钱"。从字面看,这两句话没有任何共同片段。
而"年假规则"却拿到了 0.029 分,排到了第一名。
它凭什么?因为"年假规则"里有一句"最多可以结转 5 天",而问题里有个"最多"。就这么两个字的重合,系统就把一段和住宿毫无关系的年假规定,判定成了最相关内容。
如果这个系统后面接着大模型,接下来会发生什么?模型会拿到一段关于年假的规定,然后被要求回答住宿报销的问题。运气好,它会说"资料中没有相关信息";运气不好,它会拿着年假的数据硬答——而这是它自己编的,用户完全看不出来。
这就是 embedding 要解决的问题
方案 B 里我手写了一张同义词表,把"住酒店"映射成"住宿"、"一晚上"映射成"每晚"、"最多能报多少钱"映射成"金额上限"。改完之后,得分从 0.000 跳到 0.082,正确答案稳稳排在第一。
但我必须强调:真实项目里没人会手写这张表。
这就是 embedding 模型存在的原因。它的工作,就是自动学会"住酒店"和"住宿"是一回事、"报销"和"费用"是一回事、"多久"和"时间期限"是一回事——而且不是靠人列规则,是从海量文本里自己学出来的。
下面这张图解释它的原理: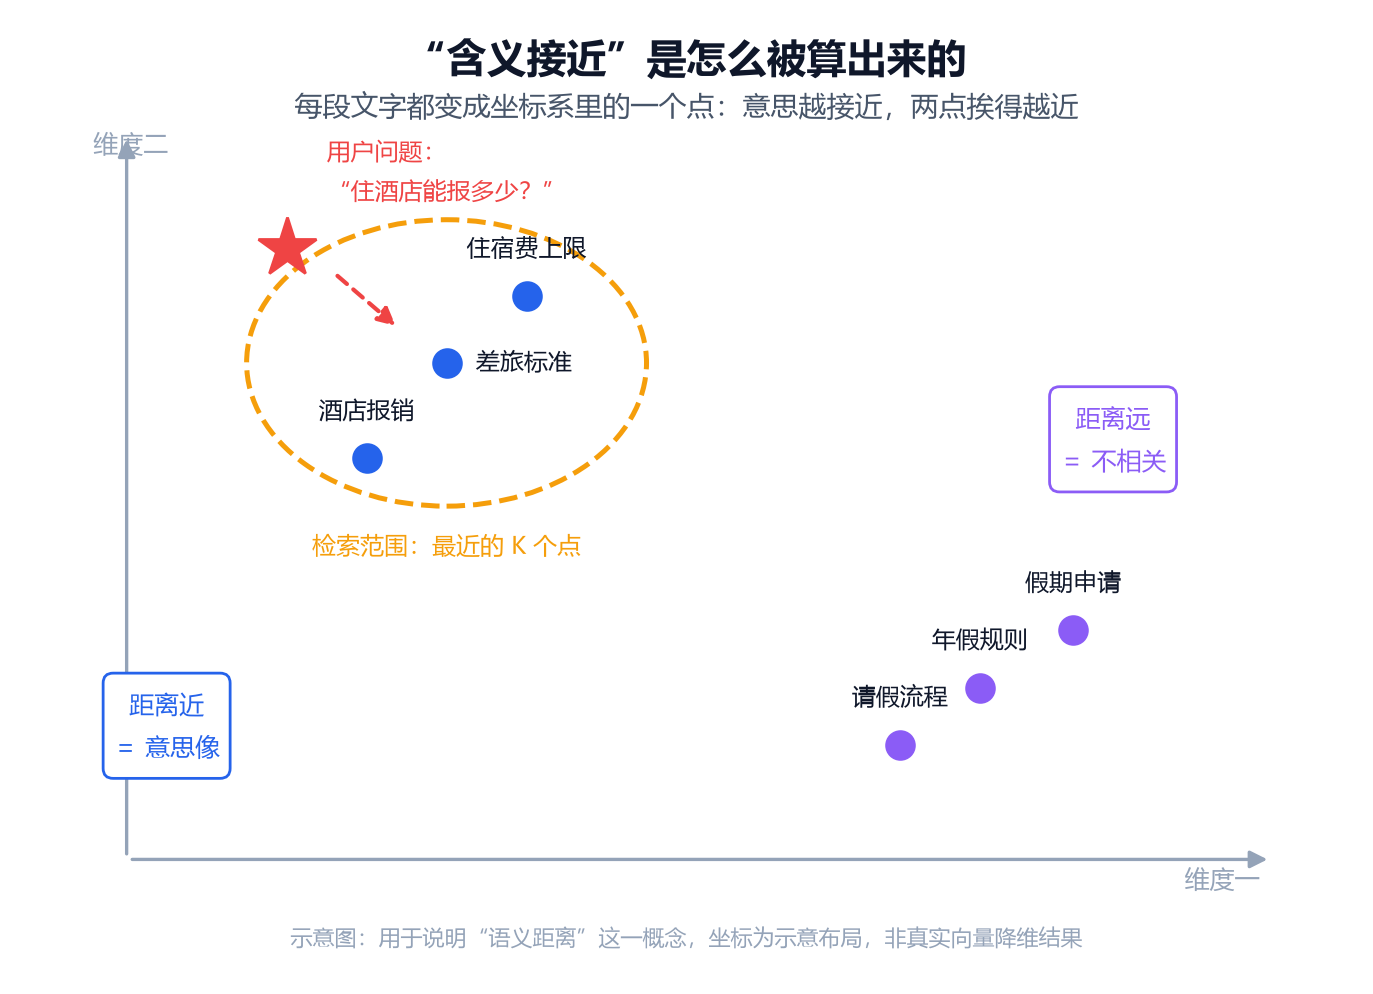 向量空间示意图
每一段文字被转换成一串数字,也就是坐标系里的一个点。"差旅标准""住宿费上限""酒店报销"这几个点和用户的问题挨得很近,因为它们讲的是同一件事;而"年假规则""请假流程"被放到了远处。
检索这件事,到这里就变成了一个非常朴素的几何问题:找出离问题那个点最近的几个点。
实际项目里怎么用真正的 embedding
回头看第一节那个"交通费、餐费和差旅费"的例子——真实项目里,你会这样写:
|
Python |
|
# 示意代码:需要安装 openai 库并配置 API Key,本文未实跑 from openai import OpenAI client = OpenAI(api_key="你的 API Key") def embed(texts): """把一批文本转成向量。一次可以传多条,比一条条调用快得多。""" resp = client.embeddings.create( model="text-embedding-3-small", # 也可以用 BGE-M3、通义 embedding 等 input=texts, ) return [d.embedding for d in resp.data] # 建库时:把每个文本块转成向量,存进向量数据库 chunk_vectors = embed([text for _, text in DOCS]) # 检索时:把问题也转成同样的向量,然后算距离 query_vector = embed(["住酒店一晚上最多能报多少钱"])[0] |
要注意一点:建库和检索必须用同一个 embedding 模型。换模型等于换了一整套坐标系,旧的向量就全对不上了——这也是为什么"升级 embedding 模型"在生产环境里往往意味着一整轮全量重建索引。
|
踩坑预警:字面匹配在真实用户面前非常脆弱。用户不会按你文档的措辞提问。如果你的 RAG 只做了关键词匹配,它会在演示时表现良好(因为演示问题通常是精心设计的),在真实使用中暴露得一塌糊涂。 |
六、切块:最不起眼,却最致命的一步
前面讲了检索环节的问题。但如果你以为 RAG 的质量天花板在检索,那就错了——真正决定上限的,往往是更早的一步:切块。
这一节我们做一个更小的实验,只改一个变量:切块方式。
两个真实的切块方案对比
原文只有一句话:
|
文档内容 |
|
住宿标准按城市分级。一线城市每晚不超过600元。二线城市每晚450元。其他城市每晚350元。超标部分需要员工自行承担。 |
我们用两种方式切它,然后问同一个问题:"二线城市住宿上限是多少"。
|
Python |
|
def fixed_chunk(text, size): """切法 A:每 size 个字硬切一刀,不管切在哪""" return [text[i:i + size] for i in range(0, len(text), size)] def sentence_chunk(text): """切法 B:按句子边界切,保证每句话完整""" return [s + "。" for s in text.split("。") if s.strip()] |
真实输出:
|
运行结果 |
|
============================================================ 固定长度切块(每块 20 字) ============================================================ 块1: 住宿标准按城市分级。一线城市每晚不超过6 块2: 00元。二线城市每晚450元。其他城市每 块3: 晚350元。超标部分需要员工自行承担。 提问:二线城市住宿上限是多少 第1名 0.163 00元。二线城市每晚450元。其他城市每 第2名 0.158 住宿标准按城市分级。一线城市每晚不超过6 第3名 0.000 晚350元。超标部分需要员工自行承担。 ============================================================ 按句子边界切块 ============================================================ 块1: 住宿标准按城市分级。 块2: 一线城市每晚不超过600元。 块3: 二线城市每晚450元。 块4: 其他城市每晚350元。 块5: 超标部分需要员工自行承担。 提问:二线城市住宿上限是多少 第1名 0.211 二线城市每晚450元。 第2名 0.124 住宿标准按城市分级。 第3名 0.084 一线城市每晚不超过600元。 第4名 0.033 其他城市每晚350元。 第5名 0.000 超标部分需要员工自行承担。 |
对比一下两组数字,差距非常直观。
切法 A 的第一名,得 0.163 分;第二名 0.158 分。 两个分数几乎一样,系统分不出谁更相关。更糟的是,第一名那个块长这样:
|
文档内容 |
|
00元。二线城市每晚450元。其他城市每 |
它以"00元"开头——"600 元"被切成了"6"和"00元"分在两块里;结尾是"其他城市每","每晚"的"每"字孤零零留在这块,跟下半句分家了。而正确答案"二线城市每晚450元"确实在这个块里,但它混在一堆被切碎的残句中间。
切法 B 的第一名,得 0.211 分,而且它就是干净的一句"二线城市每晚450元。" 第二名只有 0.124。差距拉开了一倍,系统一眼就能确定该用哪块。
为什么差这么一点,后果这么严重
因为切块的影响会被后面的每一步放大。
想象一下切法 A 的块被检索出来、送进大模型。模型看到的是"00元。二线城市每晚450元。其他城市每"——一段没有头没有尾的文字。它得猜:"00元"是什么东西的 00 元?"其他城市每"后面原本接的是什么?
它不会说"这段我看不懂",它会猜一个最合理的补全。于是幻觉就这样诞生了。
这就是为什么我在前面说,RAG 的问题往往不在模型,而在给它喂的材料。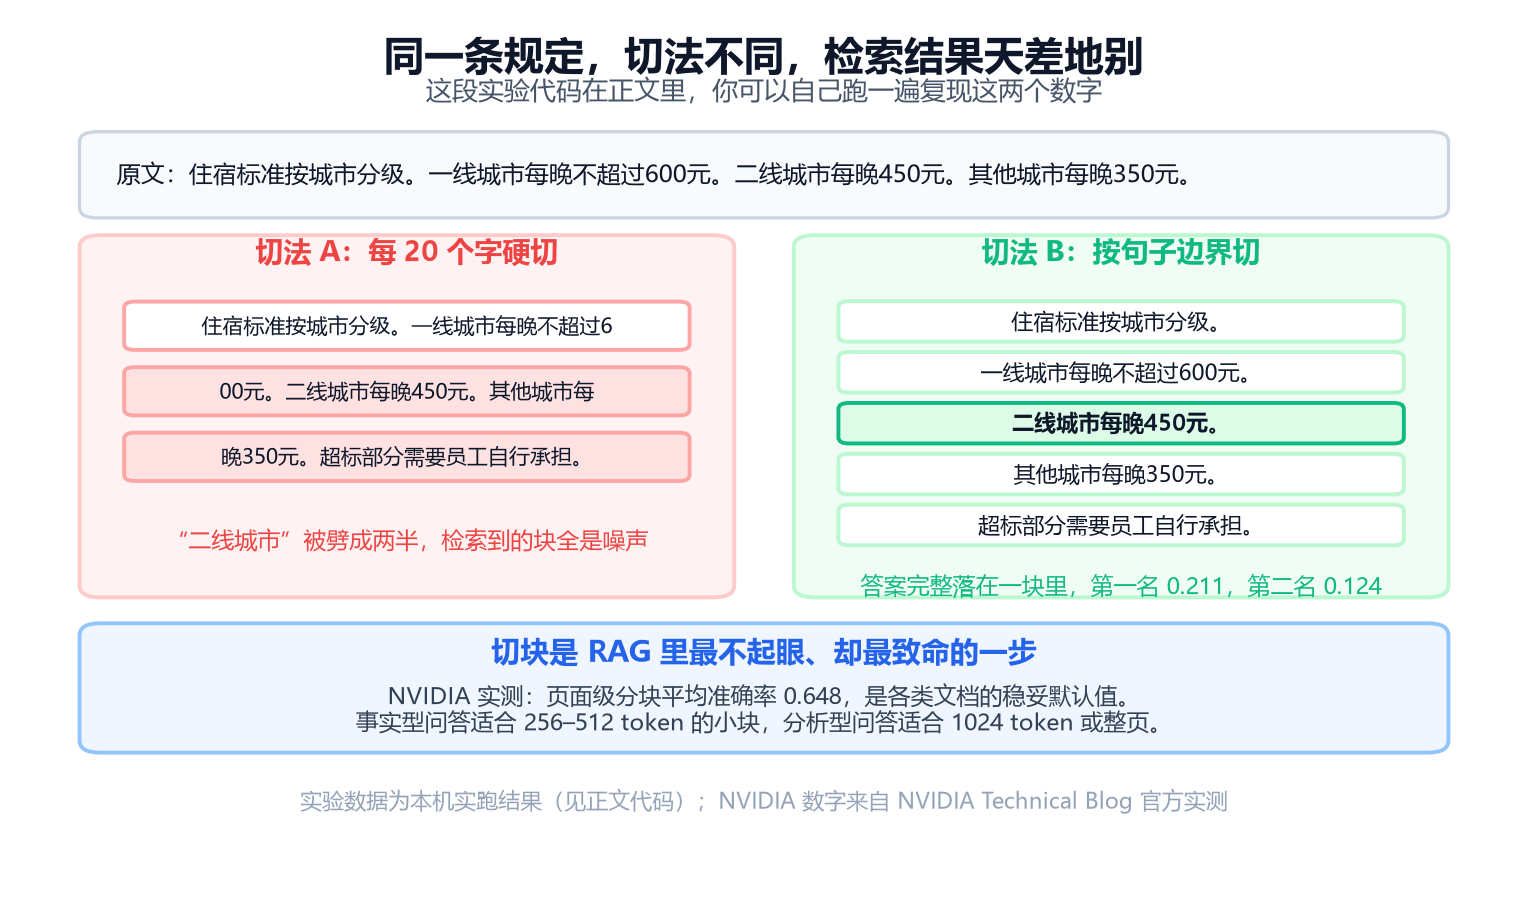 切块方式对比图
没有万能的切法
那到底该怎么切?很遗憾,答案不是"用一个固定数值就完事"。
NVIDIA 在官方技术博客里公布过一组实测数据,覆盖了多种文档类型和切块策略。几个关键结论挺反直觉的:
|
结论 |
具体数据 |
|
页面级切分平均表现最好 |
平均准确率 0.648 ,且方差最小,是最稳妥的默认选择 |
|
太小和太大都不行 |
128 token 和 2048 token 两块极端表现普遍垫底 |
|
事实型问题适合小块 |
财报类数据集在 512 token 达到峰值 0.681 |
|
分析型问题适合大块 |
FinanceBench 上 1024 token ( 0.579 )反而优于页面级( 0.566 ) |
|
表格密集文档要当心 |
金融表格常跨页,按页切会把一个完整表格劈成两半 |
NVIDIA 给出的落地建议也很实在:先把页面级切分当基线,然后根据你的文档类型再挑一到两种策略做小规模对比评测。他们也强调,页面级的另一个好处是"引用稳定"——页码是天然边界,用户说"第 8 页"你就能定位;而按 token 切的块编号会随参数变化而漂移,引用起来很不方便。
|
踩坑预警:切块策略不能照抄别人的配置。同一套参数,换一份语料,效果可能天差地别。你必须在自己的数据上测。 |
七、生产环境里的 RAG,还装了什么"选装件"
到这里,一个能跑的 RAG 你已经完全掌握了。但"能跑"和"敢上线"之间,还隔着一段距离。
这一节讲三个工业界几乎标配的"加装件"。它们都不改变基本骨架,只是让检索更准、回答更稳。
加装件一:给每个小块补上"身份"
先回到第一节那个经典难题。
假设你有一堆财报,切块之后有一块长这样:
|
文档内容 |
|
公司营收较上一季度增长了 3%。 |
这块单独拿出来看,你根本不知道它在说哪家公司、哪一年、哪个季度。这就是切块的原罪:切碎了上下文。
Anthropic 在 2024 年公布了一个非常巧妙的解法,叫"上下文检索"(Contextual Retrieval)。做法是:在把每个块编码成向量之前,先让一个便宜的小模型为它写一段 50 到 100 词的说明,讲清"这一块在整个文档里是什么位置、讲的是什么",然后把这句说明拼在块的前面。
刚才那个匿名块就变成了:
|
文档内容 |
|
这一块来自 ACME 公司 2023 年第二季度的 SEC 文件,上一季度营收为 3.14 亿美元。 公司营收较上一季度增长了 3%。 |
Anthropic 公布的实测数据(用"Top-20 检索失败率"衡量,即正确答案没能进入前 20 名的比例):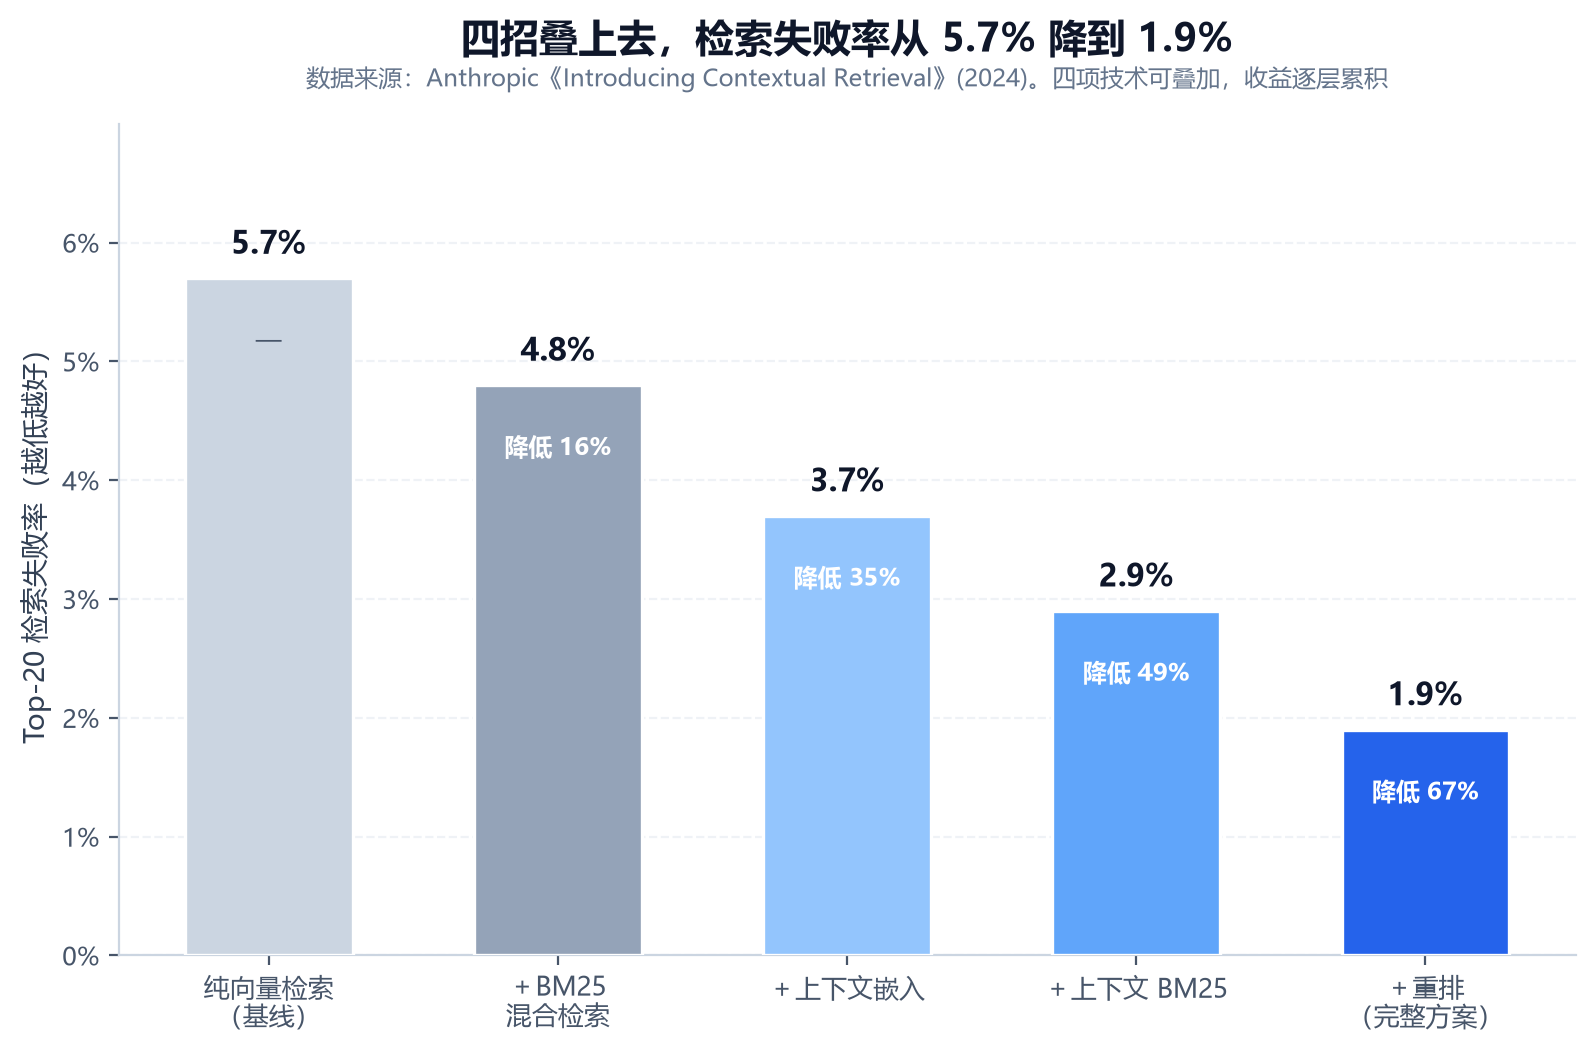 Anthropic 上下文检索检索失败率对比
|
技术组合 |
Top-20 失败率 |
相对降幅 |
|
纯向量检索(基线) |
5.7% |
— |
|
加上 BM25 混合检索 |
4.8% |
降低 16% |
|
加上上下文嵌入 |
3.7% |
降低 35% |
|
上下文嵌入 + 上下文 BM25 |
2.9% |
降低 49% |
|
再叠加交叉编码器重排 |
1.9% |
降低 67% |
这里要提醒一个小细节,很多二手文章会把它讲错:"降低 67%"是失败率的相对降幅,不是准确率提升 67%。 准确的说法是:从"每 100 个问题有 5.7 个检索失败"变成"每 100 个问题只有 1.9 个失败"。相对降幅很惊人,绝对数字看着不大——但两个说法都是真的,只是角度不同。
Anthropic 还给了个成本参考:配合提示词缓存(Prompt Caching),一次性处理 100 万个文档 token 大约只要 1.02 美元。也就是说,给全公司文档做一遍上下文增强,成本可能还不到一杯咖啡。
加装件二:向量检索和关键词检索一起用
你可能会问:既然有语义检索,为什么还要加什么 BM25(一种经典的关键词检索算法)?
因为语义检索有个天生的短板:它对精确的字串不敏感。
设想用户在技术支持库里搜"错误码 TS-999"。语义模型可能给你返回一堆"关于错误码的通用说明",因为它理解的是"错误码"这个概念;而它可能恰恰漏掉那条标题就叫"TS-999"的文档,因为"TS-999"这种字符串在语义空间里没有多少"意思"可讲。
BM25 恰好相反。它不懂语义,但它是字面匹配的高手,找 ID、型号、专有名词、错误码特别准。
所以工业界的标准做法是两路一起跑,再把结果融合。最常用的融合算法叫 RRF(Reciprocal Rank Fusion,倒数排名融合),思路简单到可以用一句话说清:不比较分数,只看排名,在各路里排得靠前的,融合后也靠前。
|
检索方式 |
擅长 |
短板 |
|
语义向量检索 |
理解同义表达、模糊描述 |
漏掉精确字符串、编号、型号 |
|
关键词检索( BM25 ) |
精确匹配 ID 、错误码、专有名词 |
用户换个说法就完全找不到 |
|
两路融合( RRF ) |
兼顾上面两者 |
要多维护一路索引 |
加装件三:注意"中间失落"效应
最后一个加装件是个"注意事项"——它可能颠覆你对"上下文窗口越大越好"的想象。
斯坦福等机构的研究者在 2023 年发表了一篇很有名的论文《Lost in the Middle: How Language Models Use Long Contexts》(后发表于 TACL 2024)。他们做了一个精心设计的实验:把包含答案的那份材料,放在上下文的第 1、5、10、15、20 位,看模型答题准确率怎么变。
结果是那条经典的 U 型曲线: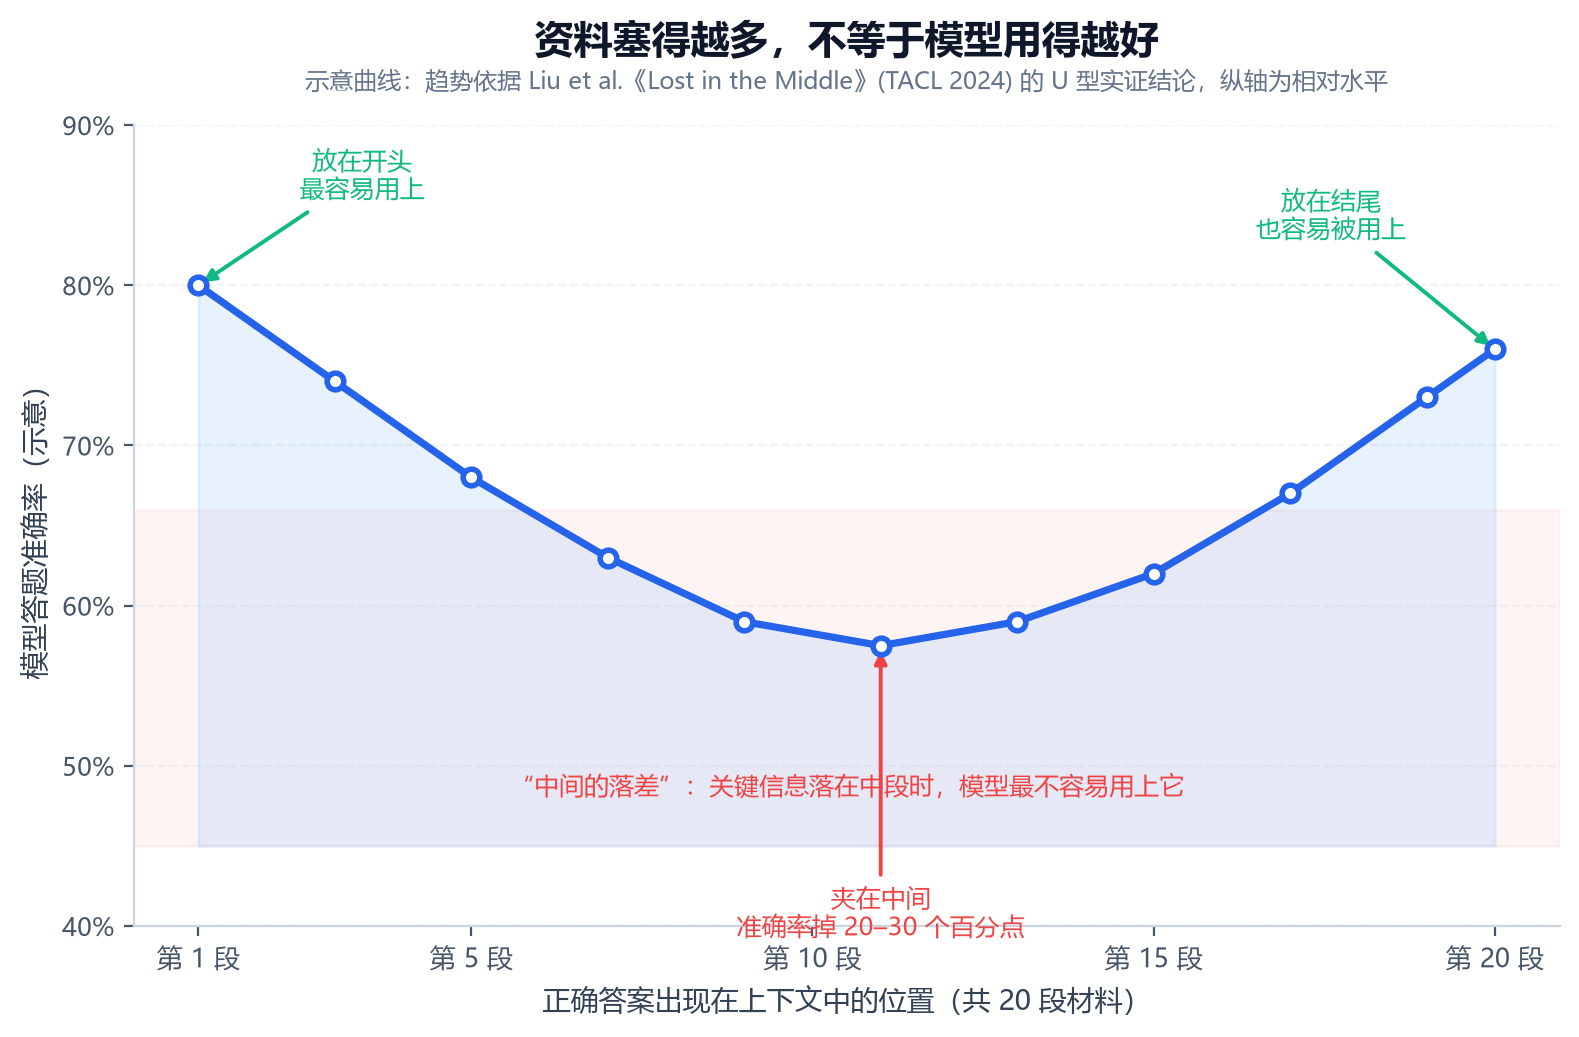 Lost in the Middle U 型曲线
模型对开头和结尾的信息用得很好,而夹在中间的信息,准确率会比首尾低 20 到 30 个百分点。更有意思的是,在某些设置下,把信息放在中间,模型的表现甚至不如"完全不给它这份材料"——这些多出来的文字不但没帮上忙,反而干扰了它。
这对 RAG 的设计有非常具体的指导意义:
- 别贪心。检索 20 段资料一股脑塞进去,未必比精选 5 段更好。中间那些段落很可能被"无视"。
- 注意排序。既然首尾位置最受关注,那就把最相关的资料放在最前面或最后面。
- 重排很值钱。把真正重要的内容重新排到高注意力位置,这件事的收益可能比换一个更强的模型还大。
|
一句话记住:检索质量决定了回答质量的上限。而在所有优化手段里,重排(Rerank)往往是性价比最高的一笔投入——它单项就能贡献可观的失败率下降。 |
八、三个真实的落地案例
讲了这么多原理,你可能会想:这事儿真有人在做吗?做得怎么样?
这一节讲三个有公开记录的真实案例。我尽量用可查证的数字,并用表格把"他们做了什么"和"得到了什么"对应起来。
案例一:摩根士丹利的内部 AI 助手
这是目前公开资料里最常被引用的 RAG 落地案例。
背景很典型:摩根士丹利财富管理部门有大约 16000 名财务顾问,公司积累了超过 10 万份研究报告和文档、约 100 万页机构知识。顾问们每天要花大量时间在这些资料里翻找答案,而不是服务客户。
他们 2023 年 9 月上线了基于 GPT-4 的 RAG 助手。有两点值得注意:
第一,他们没有微调模型。 整套方案靠的是检索层——把新发布的研报和监管变更即时索引进去,模型本身不动。
第二,他们设计了"人在环中"。 顾问在把 AI 输出交给客户之前会自己审核——这在受监管的金融行业是必须的。
|
项目 |
公开数据 |
|
服务对象 |
约 16000 名财务顾问 |
|
知识库规模 |
超过 10 万份文档、约 100 万页 |
|
检索层能处理 |
超过 35 万份文档 |
|
采用率 |
超过 98% 的顾问团队在使用 |
|
效率提升 |
顾问每天节省约 20–45 分钟的信息检索时间 |
|
是否微调模型 |
没有,完全靠检索层 |
公司负责人的一句原话被广泛引用:"这项技术让你和组织里最聪明的人一样聪明。"
案例二:微软 PIKE-RAG 在昕诺飞的知识管理场景
这个案例的价值在于,它展示了"朴素 RAG 不够用"时该怎么办。
昕诺飞(Signify,原飞利浦照明)服务的是专业用户,产品有数千个型号、参数复杂、文档版本多。他们的客服系统原本已经用了 RAG,但效果卡在瓶颈上。
卡在哪?三类问题:非标准化的表格(比如不同电流下的电压范围对照表)、电路接线图这类图形、以及需要多步推理的复杂问题。
微软亚洲研究院的 PIKE-RAG 方案做了三件事:
结果:相比原有系统,回答准确率提升了 12%,而且是在没有针对任何单个问题做定制化调整的前提下取得的。
|
维度 |
改进前 |
改进后 |
|
表格、图形类问题 |
无法有效处理,或只提取出混乱片段 |
能识别表格结构、解析图中参数 |
|
多步推理问题 |
一问一答模式,难以应对 |
动态分解为子任务,多跳推理 |
|
领域规则 |
靠提示词反复调优 |
通过领域提示模块动态注入 |
|
准确率 |
基线 |
提升 12% |
案例三:一个能落地的评估做法
第三个案例不讲具体公司,讲一个我觉得最有普适价值的经验,来自一份 2026 年的 RAG 生产实践总结。
里面提到一家中型 SaaS 公司的客服知识库:
- 第一个版本用的是朴素方案——单次检索、直接用主流模型生成。用户反馈"答错"的比例大概是 22%。
- 改造之后加了四样东西:BM25 混合检索、重排模型、查询改写、语义缓存。
- 三个月后:答错率降到 4%,而且因为语义缓存抵消了重排的算力开销,每次查询的成本反而降了 38%。
同一份资料里还提到另一个案例,我觉得更能说明问题:一家律所的内部研究助手,最初上线时用户不信任它——因为系统会编造判例引用。
他们的修法不是换模型,而是加了两层:一是让模型按结构化格式输出引用,二是加了一个"校验器",把每一个引用的出处拿去和检索到的原文比对。改完之后,忠实度指标从 0.71 升到 0.96,用户反馈的幻觉问题下降到接近零。
这两个案例指向同一个结论:RAG 的质量提升,绝大多数来自工程细节,而不是换更贵的模型。
九、RAG 的边界:什么时候你不该用 RAG
看到这里,你可能会觉得 RAG 是个万能药。不是的。这一节专门讲它的边界,以及它和另外两条技术路线的取舍。
和"微调"比:不是对手,是分工
很多人纠结"该用 RAG 还是微调"。先看一组真实数据。
Menlo Ventures 在 2024 年的企业生成式 AI 调研中(样本为 600 位企业 IT 决策者)发现:
|
技术路线 |
生产环境采用率( 2024 ) |
上一年 |
|
提示词设计 |
居首 |
— |
|
RAG |
51% |
31% |
|
智能体架构 |
12% |
首次出现 |
|
微调 |
9% |
— |
RAG 的采用率一年内从 31% 涨到 51%,而微调只有 9%。差了将近六倍。
这个差距很好理解,因为两者解决的根本不是同一类问题:
|
你的需求 |
应该选 |
|
知识经常变(政策、产品文档、价格) |
RAG—— 改文档重建索引就生效 |
|
需要溯源、可审计(法律、医疗、金融) |
RAG—— 每条答案能指到原文 |
|
需要特定的说话风格、输出格式 |
微调 ——RAG 教不了风格 |
|
对延迟极其敏感 |
微调 —— 微调后的模型推理更快 |
|
两者都要 |
混合:微调管 " 怎么说 " , RAG 管 " 说什么 " |
有一份 2026 年的行业研究甚至拿汽车制造业做实验(用了两个宝马集团的封闭数据集),结论是:在看起来最"必须微调"的高专业度场景里,RAG 依然是成本效益最好的方案,开源模型加上 RAG 之后,质量能追平顶尖的闭源模型。
和"长上下文"比:窗口大,不等于读得好
过去两年还有一个反复出现的争论:既然模型上下文窗口已经能到百万 token,那我直接把所有资料塞进去,是不是就不需要 RAG 了?
Anthropic 在官方文章里给了半肯定的答案,也划了边界:如果你的知识库小于 20 万 token(大约 500 页),你确实可以直接把全部内容放进提示词,根本不需要 RAG。 配合提示词缓存,这种做法还能把延迟降低一倍以上、成本降低最多 90%。
但一旦超过这个规模,RAG 就回来了。原因有三条:
|
场景 |
更合适的选择 |
|
知识库小于 500 页,查询量不大 |
直接塞进上下文,不用折腾 RAG |
|
知识库大、更新频繁 |
RAG |
|
需要跨全库汇总( " 总结我和这个客户的所有会议 " ) |
长上下文或分层摘要,不是 top-K 检索 |
|
需要引用出处、需要权限隔离 |
RAG |
|
查询量大、对成本敏感 |
RAG |
十、怎么判断你的 RAG 做得好不好
"我感觉它答得还不错"——这是最危险的评估方式。
生产级的 RAG 必须能被量化评估,否则你连"这次改动是变好了还是变坏了"都说不清。这一节讲三个最常用的指标,以及一个最容易被忽视的失败模式。
三个核心指标
|
指标 |
它在问什么 |
怎么测 |
|
检索命中率( Recall@K ) |
正确的资料,有没有被捞进前 K 名? |
准备一批标注好的问题,看标准答案所在的块有没有出现 |
|
忠实度( Faithfulness ) |
回答里的每句话,都能在检索到的资料里找到依据吗? |
用评估模型逐句比对答案与资料 |
|
答案相关度( Answer Relevancy ) |
回答有没有真正回答用户的这个问题? |
评估模型打分,或人工抽样 |
这三个指标要分开看,因为它们对应的是链路的不同环节:检索命中率低,说明问题出在切块或 embedding;忠实度高但相关度低,说明检索来的资料不对题;相关度高但忠实度低,说明模型在自由发挥。
有个很实用的做法:在写第一行检索代码之前,先把评估集建起来。 从你的真实业务里挑 50 个有代表性的问题,标注好每个问题的标准答案在哪个文档。这 50 个问题会成为你后续所有优化的标尺——你会发现它逼着你把"感觉"变成"数字"。
最阴险的失败:测试全过,用户不满意
有一类失败极难发现:你的系统在所有指标上都达标,但用户就是不买账。
原因通常是:你的测试集是"标准问法",而用户说的是人话。
测试集里的问题是"出差住宿的报销标准是什么",用户问的是"我上次去上海住的那个酒店,能报多少来着"。前者能命中,后者全线崩溃。
这也是为什么"查询理解"在生产环境里很重要——系统需要能处理含混的、指代不清的、甚至语法不完整的问题,必要时反问用户澄清,或者把"它理解成了什么"显式说出来让用户纠正。
还有一类静默失败值得单独提:索引漂移。源文档更新了,向量索引没同步。系统照常返回结果,只是返回的是过期内容。这类问题不会报错,只会慢慢让用户失去信任。解法是给每份文档打上版本和时间戳,检索时按时间过滤。
十一、给零基础的落地路线
如果你读到这里,想自己动手做一个,这一节给你一条能走通的路。我不会建议你一步到位,因为那样大概率会卡死在中途。
五步走
第一步:先用"不用 RAG"的方式跑通
把你的文档整理成一个纯文本文件,直接塞进模型上下文,问几个问题看看效果。如果你的资料本来就不到 500 页,你可能根本不需要 RAG——这一步就能帮你省下大量时间。
第二步:建一个 50 题的小评估集
从真实业务里挑 50 个问题,标注每个问题的答案在哪个文档。这一步看着枯燥,但它决定了你后面所有优化是不是"瞎调"。
第三步:实现最小可用版本
按本文第四节的思路,先跑通"切块 → 向量化 → 检索 → 生成"的完整链路,哪怕用的是最朴素的方案。先让它能端到端跑起来,再谈优化。
第四步:按顺序加装(顺序很重要,别跳)
第五步:把评估接进流程
每改一个参数,跑一遍那 50 题,对比数字。不要凭感觉上线。
工具怎么选
|
环节 |
常见选择 |
说明 |
|
编排框架 |
LangChain / LlamaIndex / 自己写 |
自己写能看清每一步,学习阶段推荐;框架适合快速搭生产 |
|
向量数据库 |
pgvector / Qdrant / Milvus / Chroma |
已经有 PostgreSQL 的话, pgvector 最省事 |
|
Embedding 模型 |
text-embedding-3 系列 / BGE-M3 / 通义 |
中文场景建议优先测中文友好的模型 |
|
重排模型 |
Cohere Rerank / BGE-reranker |
效果提升明显,是常见的第一步优化 |
|
评估工具 |
Ragas / ARES / 自己写脚本 |
也可以用本文讲的三个指标自己实现 |
用 LangChain 写同样的链路,代码大概会变成这样(示意代码,未实跑):
|
Python |
|
# 示意代码:需要安装 langchain 相关依赖 from langchain_community.document_loaders import TextLoader from langchain_text_splitters import RecursiveCharacterTextSplitter from langchain_openai import OpenAIEmbeddings from langchain_chroma import Chroma loader = TextLoader("员工手册.txt", encoding="utf-8") docs = loader.load() # 框架帮你封装了切块:按段落 -> 句子 -> 词的顺序递归切 splitter = RecursiveCharacterTextSplitter(chunk_size=512, chunk_overlap=64) chunks = splitter.split_documents(docs) # 向量库、编码、检索三件事,各一行 vectorstore = Chroma.from_documents(chunks, OpenAIEmbeddings()) retriever = vectorstore.as_retriever(search_kwargs={"k": 5}) hits = retriever.invoke("住酒店一晚上最多能报多少钱") for i, d in enumerate(hits, 1): print(i, d.page_content[:60], d.metadata.get("source")) |
代码短了很多,代价是每一步都成了黑箱。我的建议是:先用标准库手写一遍,理解每一步;再用框架搭生产版本。
十二、常见问题
这一节回答几个我被问过最多的问题。有些答案可能和你的直觉相反。
Q1:RAG 能彻底消除幻觉吗?
不能。
准确的表述是"显著降低"。公开实践里常见的数字是能把一部分幻觉压下去、把答错率从百分之二十几降到个位数,但做不到归零。而且要注意:RAG 甚至可能让错误变得更难发现——因为一个更强的模型会用更自信的语气,把检索到的错误信息包装得更像真的。
所以配套手段是必须的:要求标注出处、加引用校验、对高风险问题保留人工审核。
Q2:我需要先把文档整理干净吗?
需要,而且这一步的价值被严重低估。
真实的文档里充满了 PDF 表格错乱、页眉页脚混进正文、扫描件没有文字层、同一份文件有五个版本。这些脏数据会直接变成检索噪声。很多团队在检索算法上折腾很久,最后发现问题其实出在文档解析环节。
建议的顺序是:先做文档解析和清洗,再谈切块,最后才是检索优化。
Q3:向量数据库该选哪个?
如果你已经有 PostgreSQL,先用 pgvector——少维护一个组件,比什么都重要。
只有当你的向量规模(通常到百万级以上)或性能要求确实顶不住时,再考虑上专门的向量数据库。前期过早引入新组件,往往只是在给自己增加运维负担。
Q4:RAG 和"给模型加联网搜索"是一回事吗?
原理上是同一类思路——都是"先去拿资料,再基于资料回答"。
区别在资料的范围和可控性:联网搜索面向公开互联网,你无法控制它取到什么;RAG 面向你自己的知识库,你能控制内容、更新节奏和访问权限。企业场景绝大多数用 RAG,因为需要可控和可审计。
Q5:RAG 是不是已经过时了,现在都讲 Agent?
恰恰相反。
进入 2026 年,确实有很多文章在说"RAG 已死",但主流观察是:RAG 不是被取代了,而是被吸收了——它变成了智能体工具箱里的一件工具。智能体决定"要不要检索、检索几次、用什么方式检索",而底下干活的仍然是检索层。
从企业数据看,RAG 的采用率是在持续上升的(31% → 51%),智能体架构则是从零起步、正在增长。这两个不是替代关系。
数据时效声明
本文涉及的所有第三方数据均来自公开渠道,采集时间为 2026 年 9 月 17 日。
需要特别说明的是:AI 领域的产品参数、价格和模型能力变化很快,本文引用的具体数字(尤其是价格、模型版本、基准分数)请以官方最新文档为准。以下是几个值得留意的时效点:
- Anthropic 的上下文检索数据发布于 2024 年,其原始文章在后来有过补充说明;文中引用的成本数字基于当时的提示词缓存价格。
- Menlo Ventures 的采用率数据来自 2024 年调研(样本 600 位企业 IT 决策者),该机构 2025 年的报告采用了不同的统计口径,两组数字不宜直接比较。
- NVIDIA 的切块策略基准来自其官方技术博客,测试数据集以英文金融与技术文档为主,中文语料的实际表现需要自行验证。
- 本文第四、五、六节的代码输出均为本机实跑结果,运行环境为 Python 3.13,可复现。
参考资料
下面这些是我在写作过程中实际查阅过的公开资料,按在文中首次出现的顺序排列。其中的链接我都逐条访问核对过,文中引用的数字均能在这些来源中找到。
- Lewis et al.,《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,arXiv:2005.11401,NeurIPS 2020(arxiv.org/abs/2005.11401)
- Anthropic,《Introducing Contextual Retrieval》(www.anthropic.com/news/contextual-retrieval)
- Liu et al.,《Lost in the Middle: How Language Models Use Long Contexts》,TACL 2024
- NVIDIA Technical Blog,《Finding the Best Chunking Strategy for Accurate AI Responses》(developer.nvidia.com)
- Menlo Ventures,《2024: The State of Generative AI in the Enterprise》(menlovc.com)
- 微软亚洲研究院,《当工业知识遇上 PIKE-RAG:昕诺飞客服效率跃升背后的技术突破》(www.microsoft.com/en-us/research)
- Databricks Mosaic Research 关于长上下文与 RAG 的对比实验(经第三方文献综述转引)


评论前必须登录!
注册