 网硕互联帮助中心
🔥小叶-duck:个人主页
❄️个人专栏:《Data-Structure-Learning》《C++入门到进阶&自我学习过程记录》 《Linux系统从入门到实践》《Linux网络从入门到实践》 《Qt 方寸极境》 《MySQL》
✨未择之路,不须回头 已择之路,纵是荆棘遍野,亦作花海遨游
目录
前言
一、TCP 核心知识点回顾
二、 TCP 发送数据的两种工作模式
2.1 串行发送模式(停等协议 Stop-and-Wait)
2.2 并行发送模式(流水线模式 Pipelining)
三、TCP 序号与确认序号机制
3.1 序号的本质
3.2 确认序号定义与累积确认机制
3.3 序号的三大核心功能
3.4 缓冲区与序号的逻辑关系
3.5 经典场景:中间报文丢包的处理
3.5.1 前置基础定义
3.5.2 正常无丢包场景的序号流转
3.5.3 报文 3 丢失、报文 4 乱序提前到达场景
3.5.4 补齐缺失报文后的确认应答
3.5.5 核心结论
3.6 问题:为什么同时需要序号和确认序号?
3.6.1 全双工通信要求双方都能发送和确认
3.6.2 捎带应答:一个报文同时承载数据和 ACK
3.6.3 区分:捎带应答&&纯ACK应答
3.6.4 小结
四、TCP 16 位窗口大小与流量控制
4.1 流量控制产生背景
4.2 接收方接收能力的量化标准
4.3 16 位窗口大小字段含义
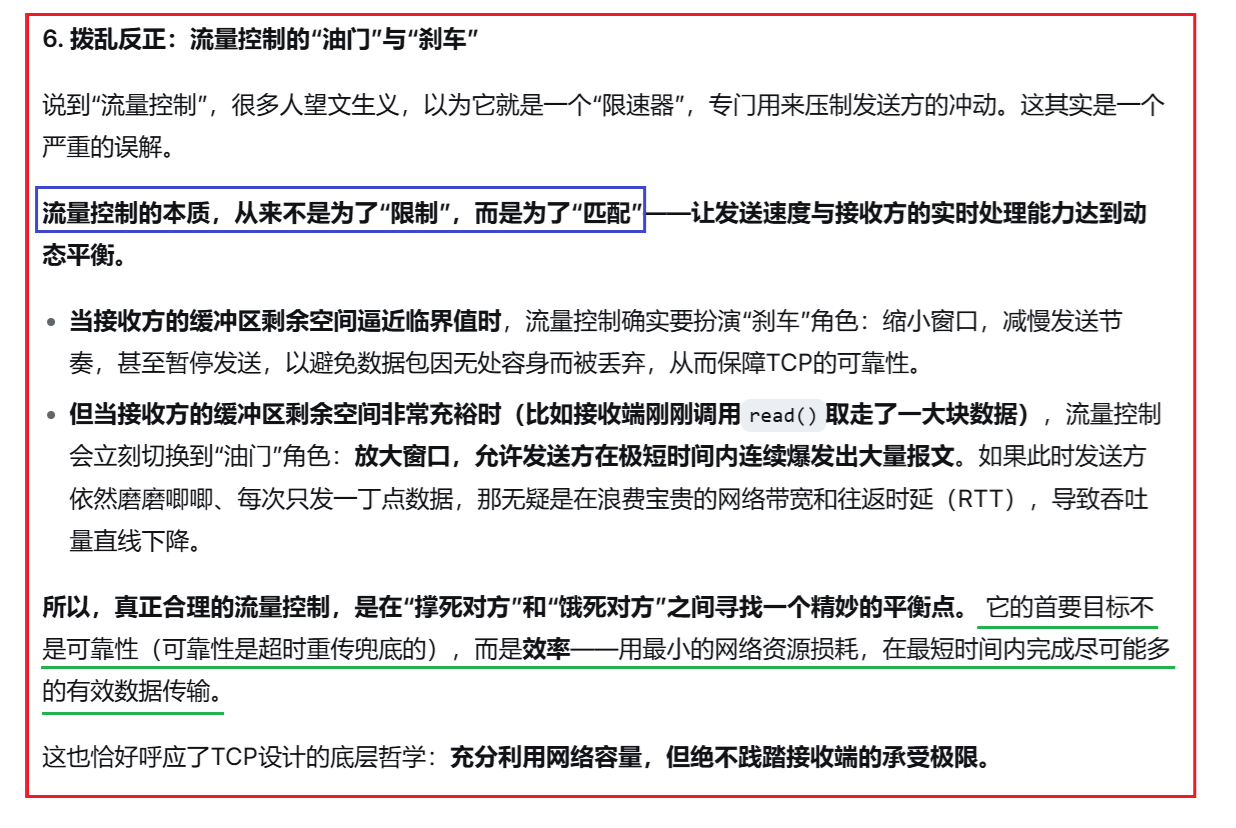
4.4 流量控制的本质:提高效率
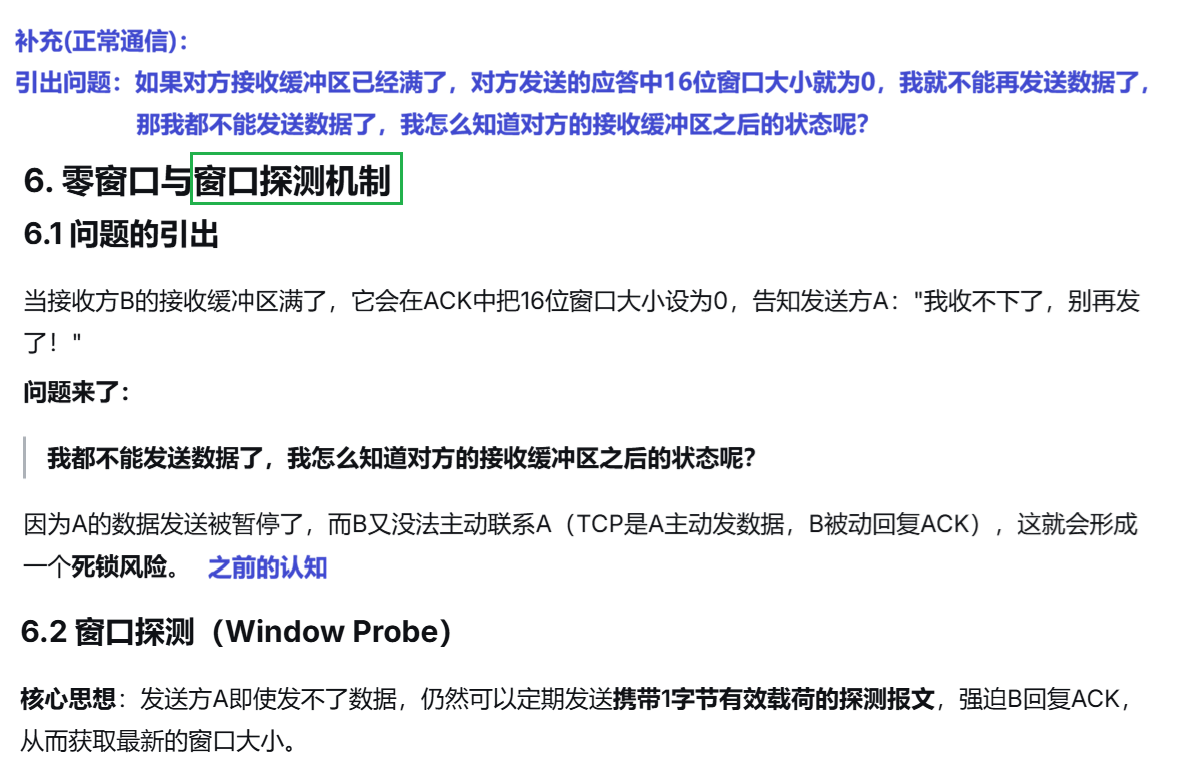
4.5 窗口探测机制(零窗口死锁规避)
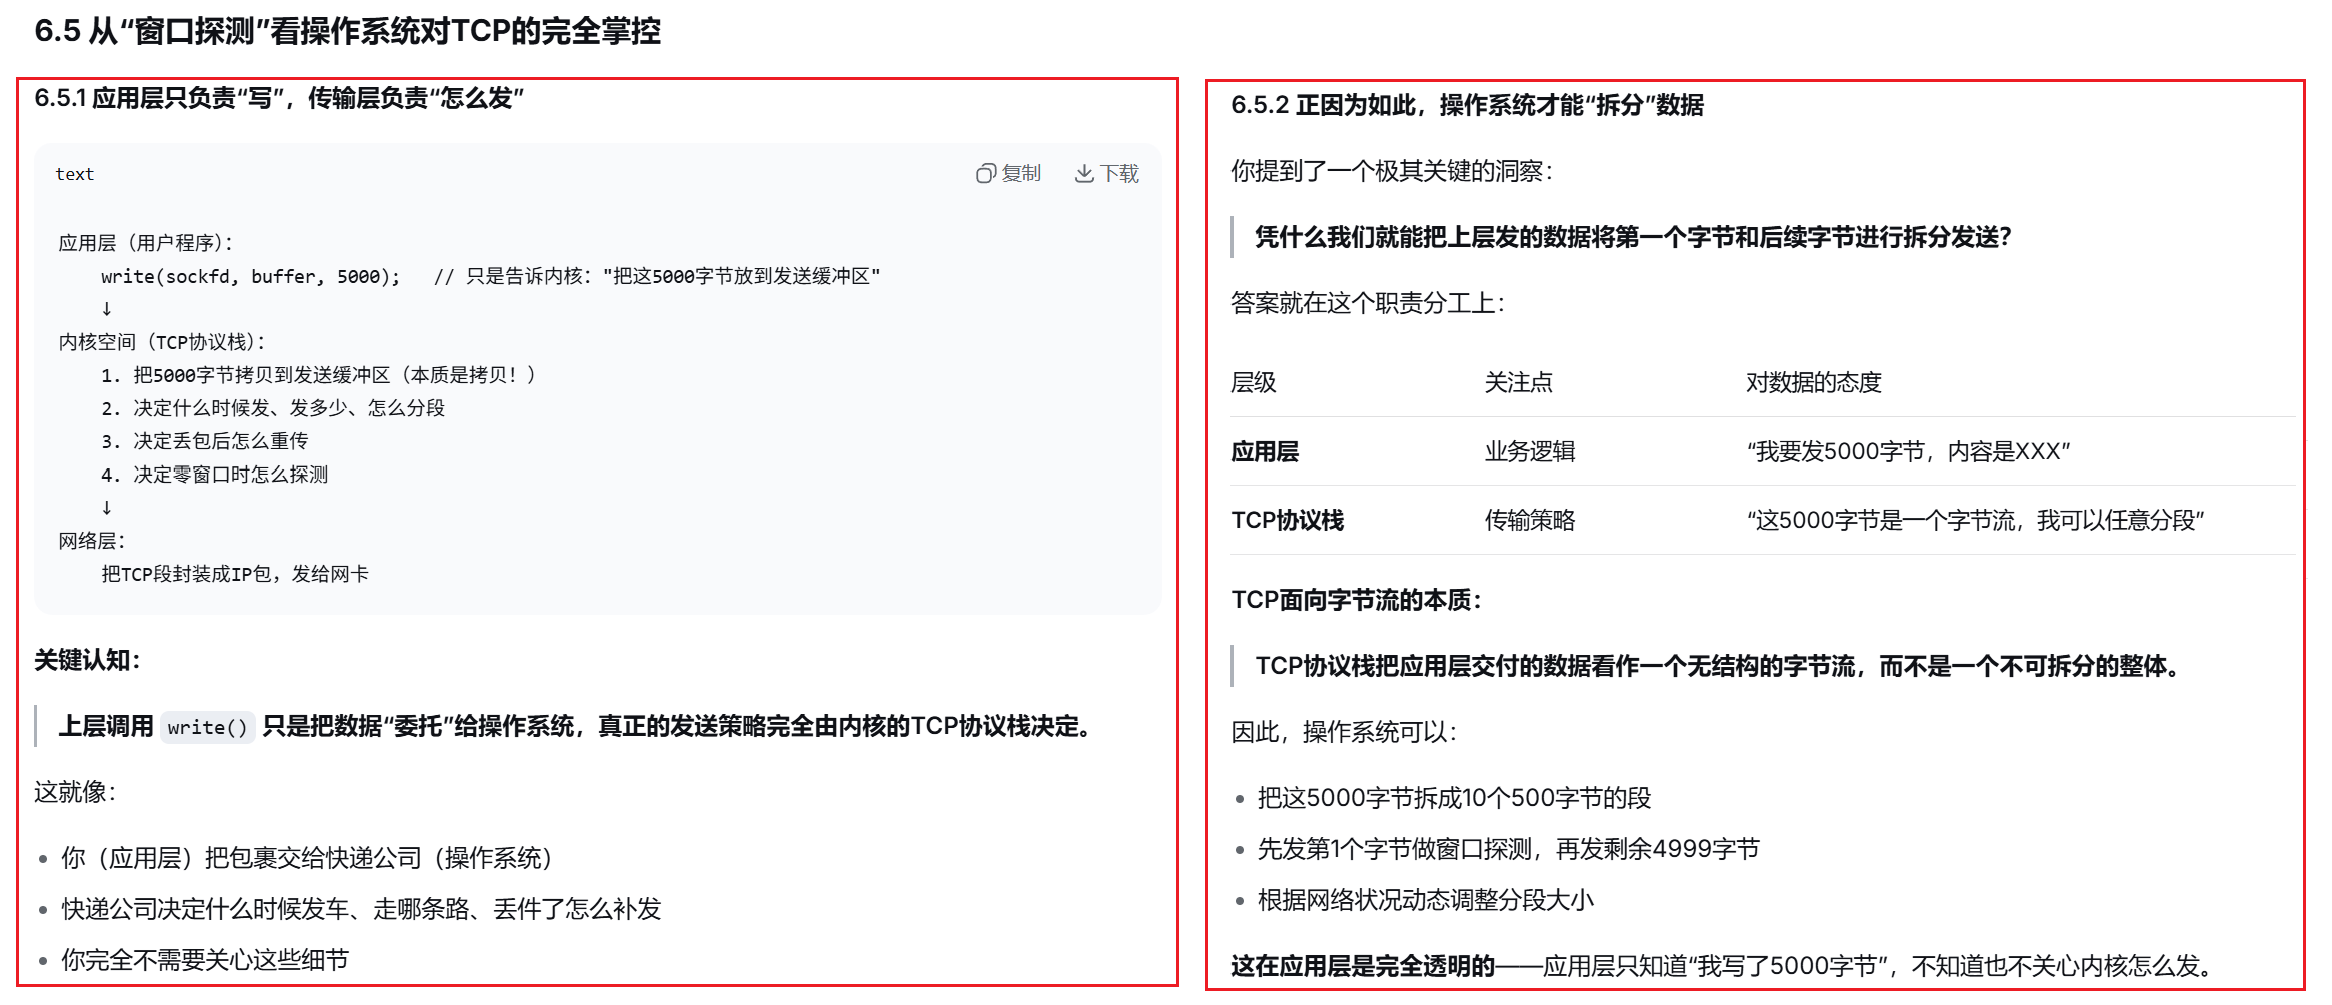
4.5.1 窗口探测视角:理解TCP面向字节流
4.6 核心总结
结束语
前言
在上一篇文章中,我们深度解析了 TCP 报头中 4 位首部长度字段的设计精髓,以及可靠性最底层的两大基石 —— 确认应答与超时重传机制。但 TCP 的复杂之处远不止于此:为了提高传输效率,TCP 不会像停等协议那样发一个等一个,而是支持并行发送多个报文;面对多个报文同时发送带来的丢包、乱序、重复等问题,TCP 依靠序号与确认序号这套字节级编号体系来化解;为了避免发送方发送过快导致接收方缓冲区溢出,TCP 引入了流量控制机制,并借助 16 位窗口大小字段实时同步双方的接收能力。
本文将继续沿着 TCP 协议的设计思路往下走,先从数据发送的两种工作模式讲起,厘清停等协议与流水线模式的取舍;再深度拆解序号与确认序号的核心作用,还原丢包、乱序场景下 TCP 的真实处理逻辑;随后详解流量控制与窗口探测机制。所有内容均严格基于 TCP 协议规范和 Linux 内核实现,力求做到理论与实践相结合。
一、TCP 核心知识点回顾
在开始本篇文章新内容之前,我们先梳理上篇文章中TCP的基础核心结论,作为后续内容理解的前提:
二、 TCP 发送数据的两种工作模式
TCP 为适配不同的数据传输场景,设计了两套发送工作模式:串行发送与并行流水线发送模式。
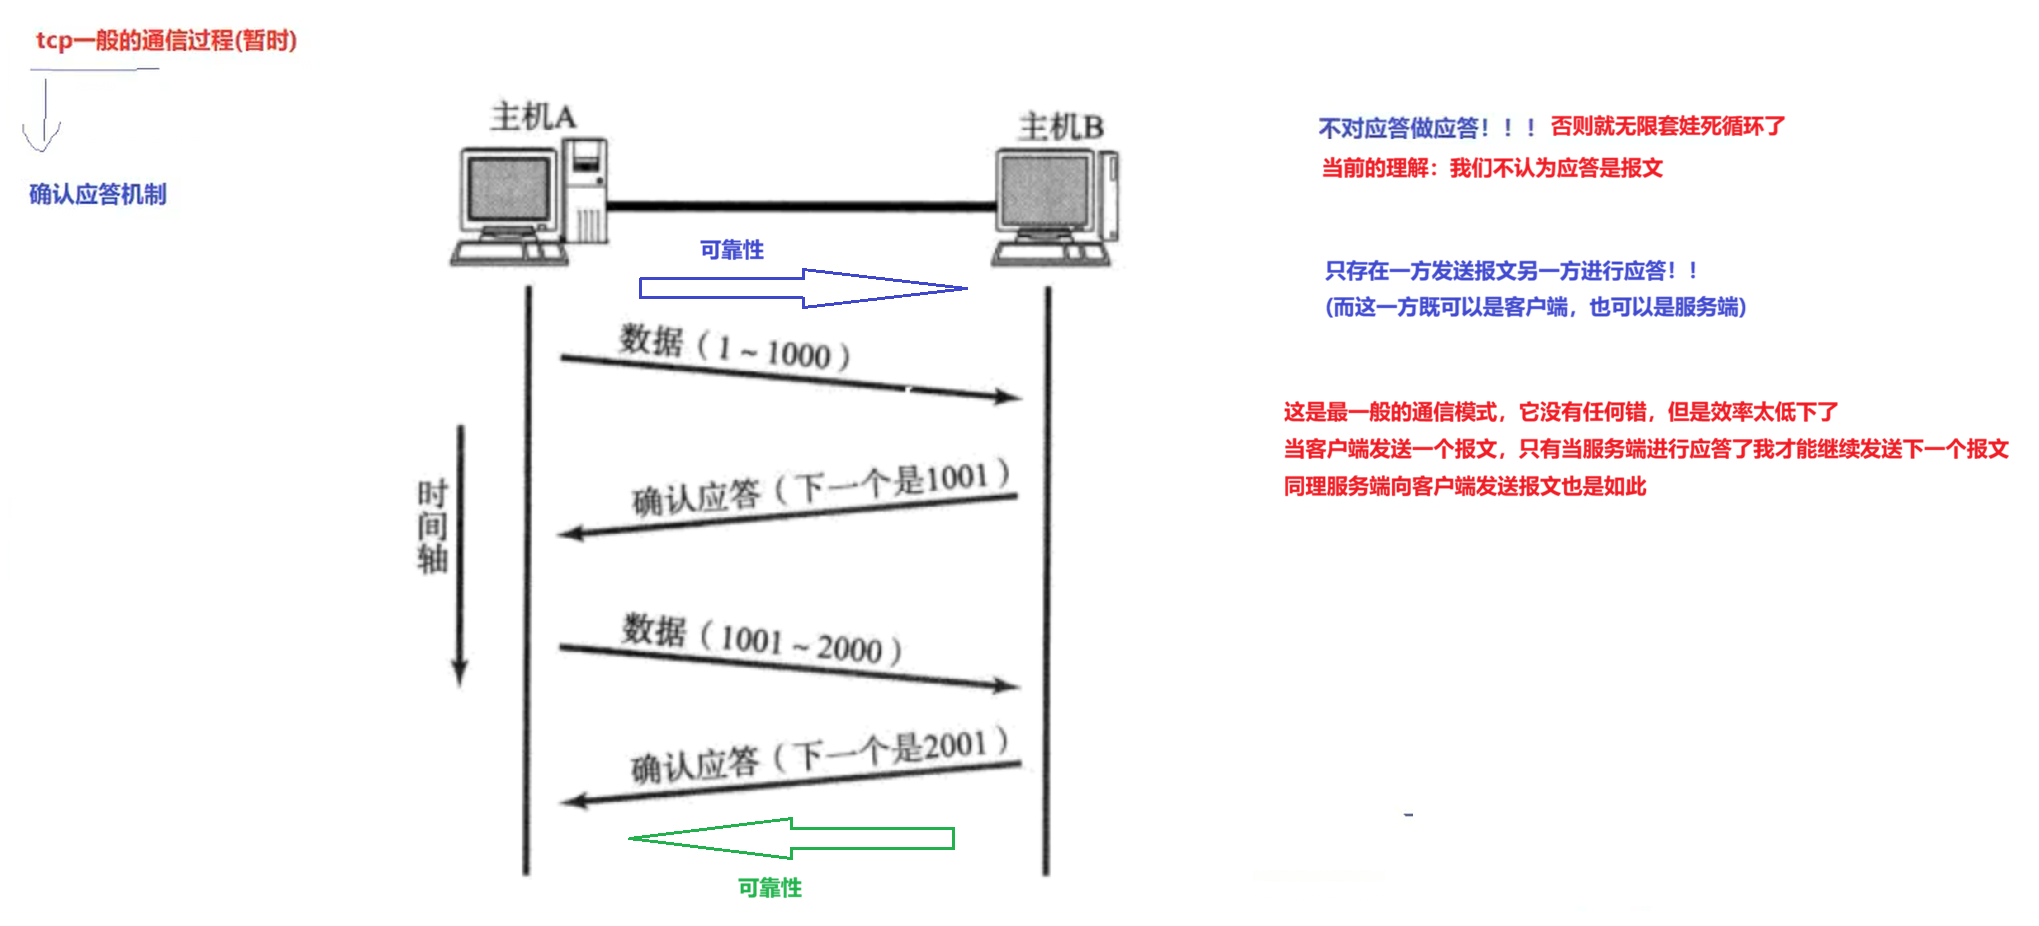
2.1 串行发送模式(停等协议 Stop-and-Wait)
工作逻辑:发送方每发出 1 个报文之后,就暂停发送,原地等待接收方返回对应的 ACK 应答。必须收到应答,才可以继续发送下一份报文。
- 优点:逻辑简单,天然不会出现报文乱序、重复接收的问题,实现成本低。
- 缺点:传输效率很低。在等待 ACK 的 RTT 往返时间内,网络链路处于空闲状态,带宽资源被浪费。
- 适用场景:只适合少量数据传输场景,在真实 TCP 通信里很少单独使用。
主机A 主机B
|—- 数据1 ——>|
| |
|<—- ACK1 ——-|
| |
|—- 数据2 ——>|
| |
|<—- ACK2 ——-|
2.2 并行发送模式(流水线模式 Pipelining)
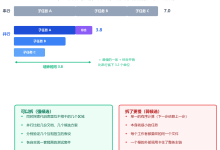
这是 TCP 实际通信里主流默认使用的发送模式。 工作逻辑:发送方不需要等待上一个报文的 ACK 应答,就可以连续向外发送多个报文,不需要等待一轮 RTT。多个报文的收发时间可以相互重叠,充分利用链路带宽,大幅提升网络吞吐与传输效率。
主机A 主机B
|—— 数据1 ——>|
|—— 数据2 ——>|
|—— 数据3 ——>|
|<—– ACK1 ——-|
|<—– ACK2 ——-|
|—— 数据4 ——>|
|<—– ACK3 ——-|
并行流水线模式虽然解决了性能瓶颈,但同时引入了新难题:
为了解决并行流水线带来的丢包识别、报文排序、去重等一系列问题,TCP 协议在报头中定义了两个核心字段:32 位序号(Sequence Number) 和32 位确认序号(Acknowledgment Number)。
三、TCP 序号与确认序号机制
序号与确认序号是 TCP 实现可靠传输与流水线高效传输的核心,TCP 绝大多数可靠性机制都建立在这两个字段之上。
3.1 序号的本质
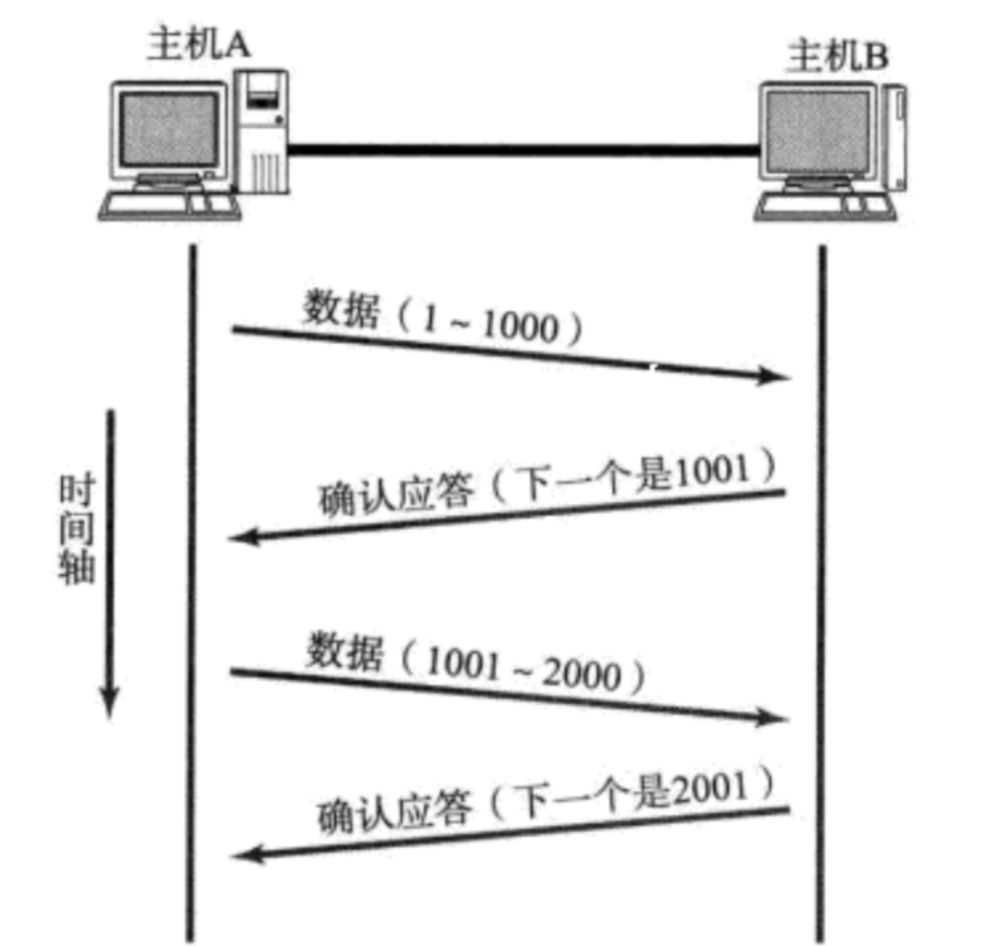
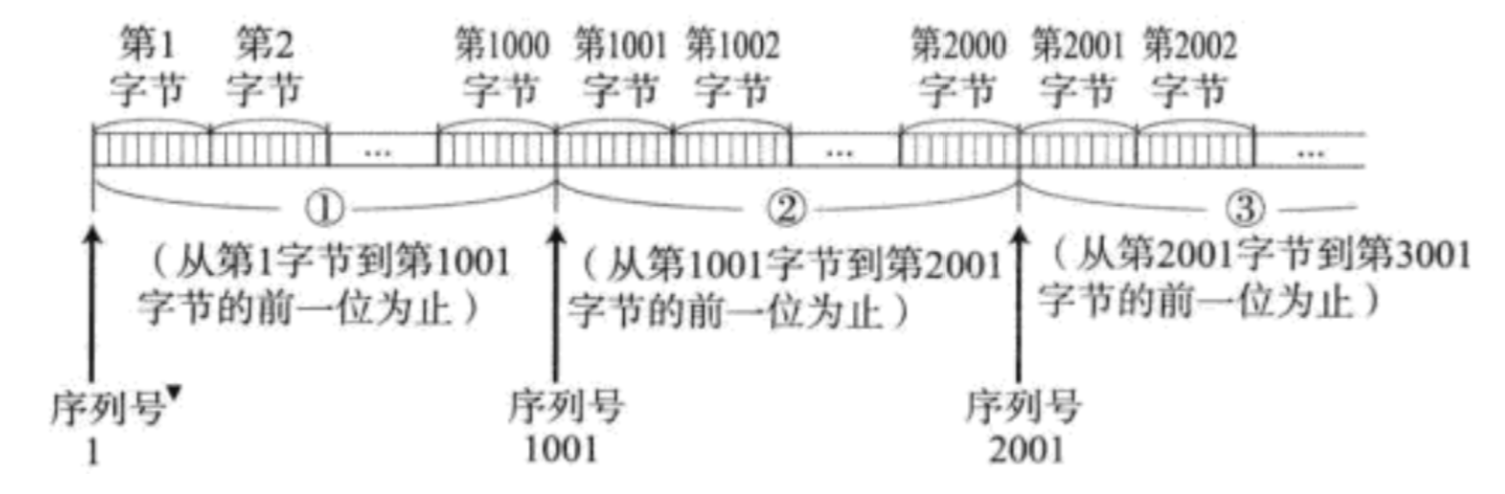
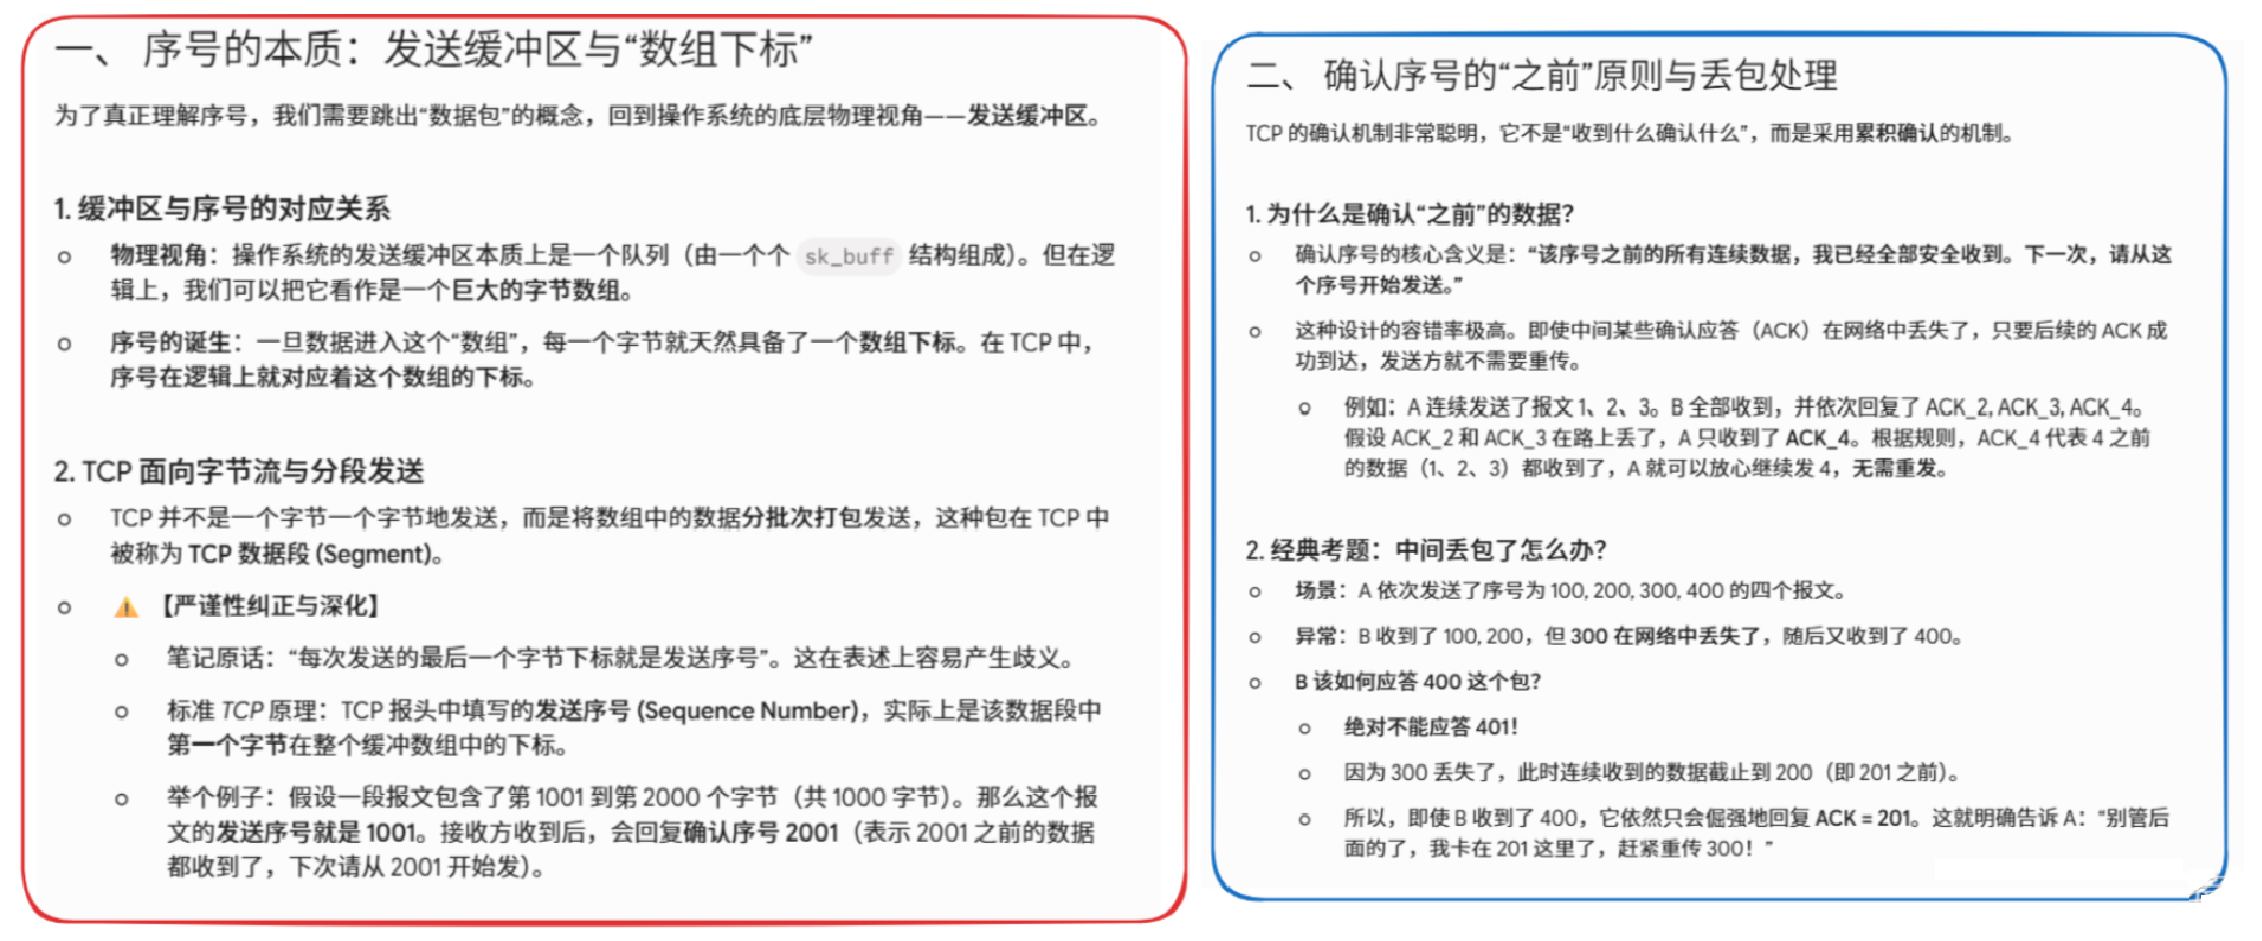
操作系统内核维护发送缓冲区与接收缓冲区,底层依靠sk_buff存储报文。逻辑层面,TCP 把缓冲区中的数据流视为一个巨大连续字节数组,序号就是这个字节数组的下标。 TCP 不会逐字节发送数据,而是将数据分批封装成 TCP 数据段(Segment)进行传输。
举例:
- 报文承载第 1~1000 字节数据,该报文的序号 = 1
- 下一段承载 1001~2000 字节,序号 = 1001
- 再下一段承载 2001~3000 字节,序号 = 2001
3.2 确认序号定义与累积确认机制
确认序号计算公式:确认序号 = 收到的最后一个完整字节的序号 + 1 含义:确认序号 N,代表 N 之前所有字节全部接收完毕,下一次期望从序号 N 开始接收数据。
示例:
- 主机 B 收到 1~1000 字节的数据段,回复确认序号 1001;
- 主机 B 收到 1001~2000 字节的数据段,回复确认序号 2001。
TCP 采用累积确认,这是非常关键的特性: 如果主机 B 已经收到 1~1000、2001~3000,但中间 1001~2000 还未收到,此时只能回复确认序号 1001。 哪怕后面的字节提前到达,也不会确认后面的数据,以此保障 TCP 有序交付。
累积确认优势:容错能力强,中间部分 ACK 报文在网络丢失也不会造成严重影响,只要后续 ACK 抵达,发送方就能确认数据。
3.3 序号的三大核心功能
正是依靠序号和确认序号,流水线并行发送带来的各类难题得以解决:
- 保障传输可靠性:接收方通过确认序号反馈接收进度,发送方能精准判断哪些数据成功送达、哪些报文丢失,触发超时重传。
- 报文去重:超时重传场景下接收端可能收到重复报文,依靠序号识别重复数据并丢弃。
- 实现乱序重组:网络传输时报文可能乱序抵达,接收缓冲区利用序号重新排序,整理成有序数据流再交付应用层。
3.4 缓冲区与序号的逻辑关系
发送缓冲区、接收缓冲区在内核中以 sk_buff 队列物理存储。逻辑上等效为连续字节数组,缓冲区里的每一字节数据,都对应唯一序号下标。 TCP 数据段发送时,按字节范围打包。 例如一段报文包含 1000 字节,起始序号 1,覆盖字节 1~1000;下一段就从 1001 开始。不同数据段的序号自然不连续,根源是每个 TCP 段携带的数据长度不一样。
3.5 经典场景:中间报文丢包的处理
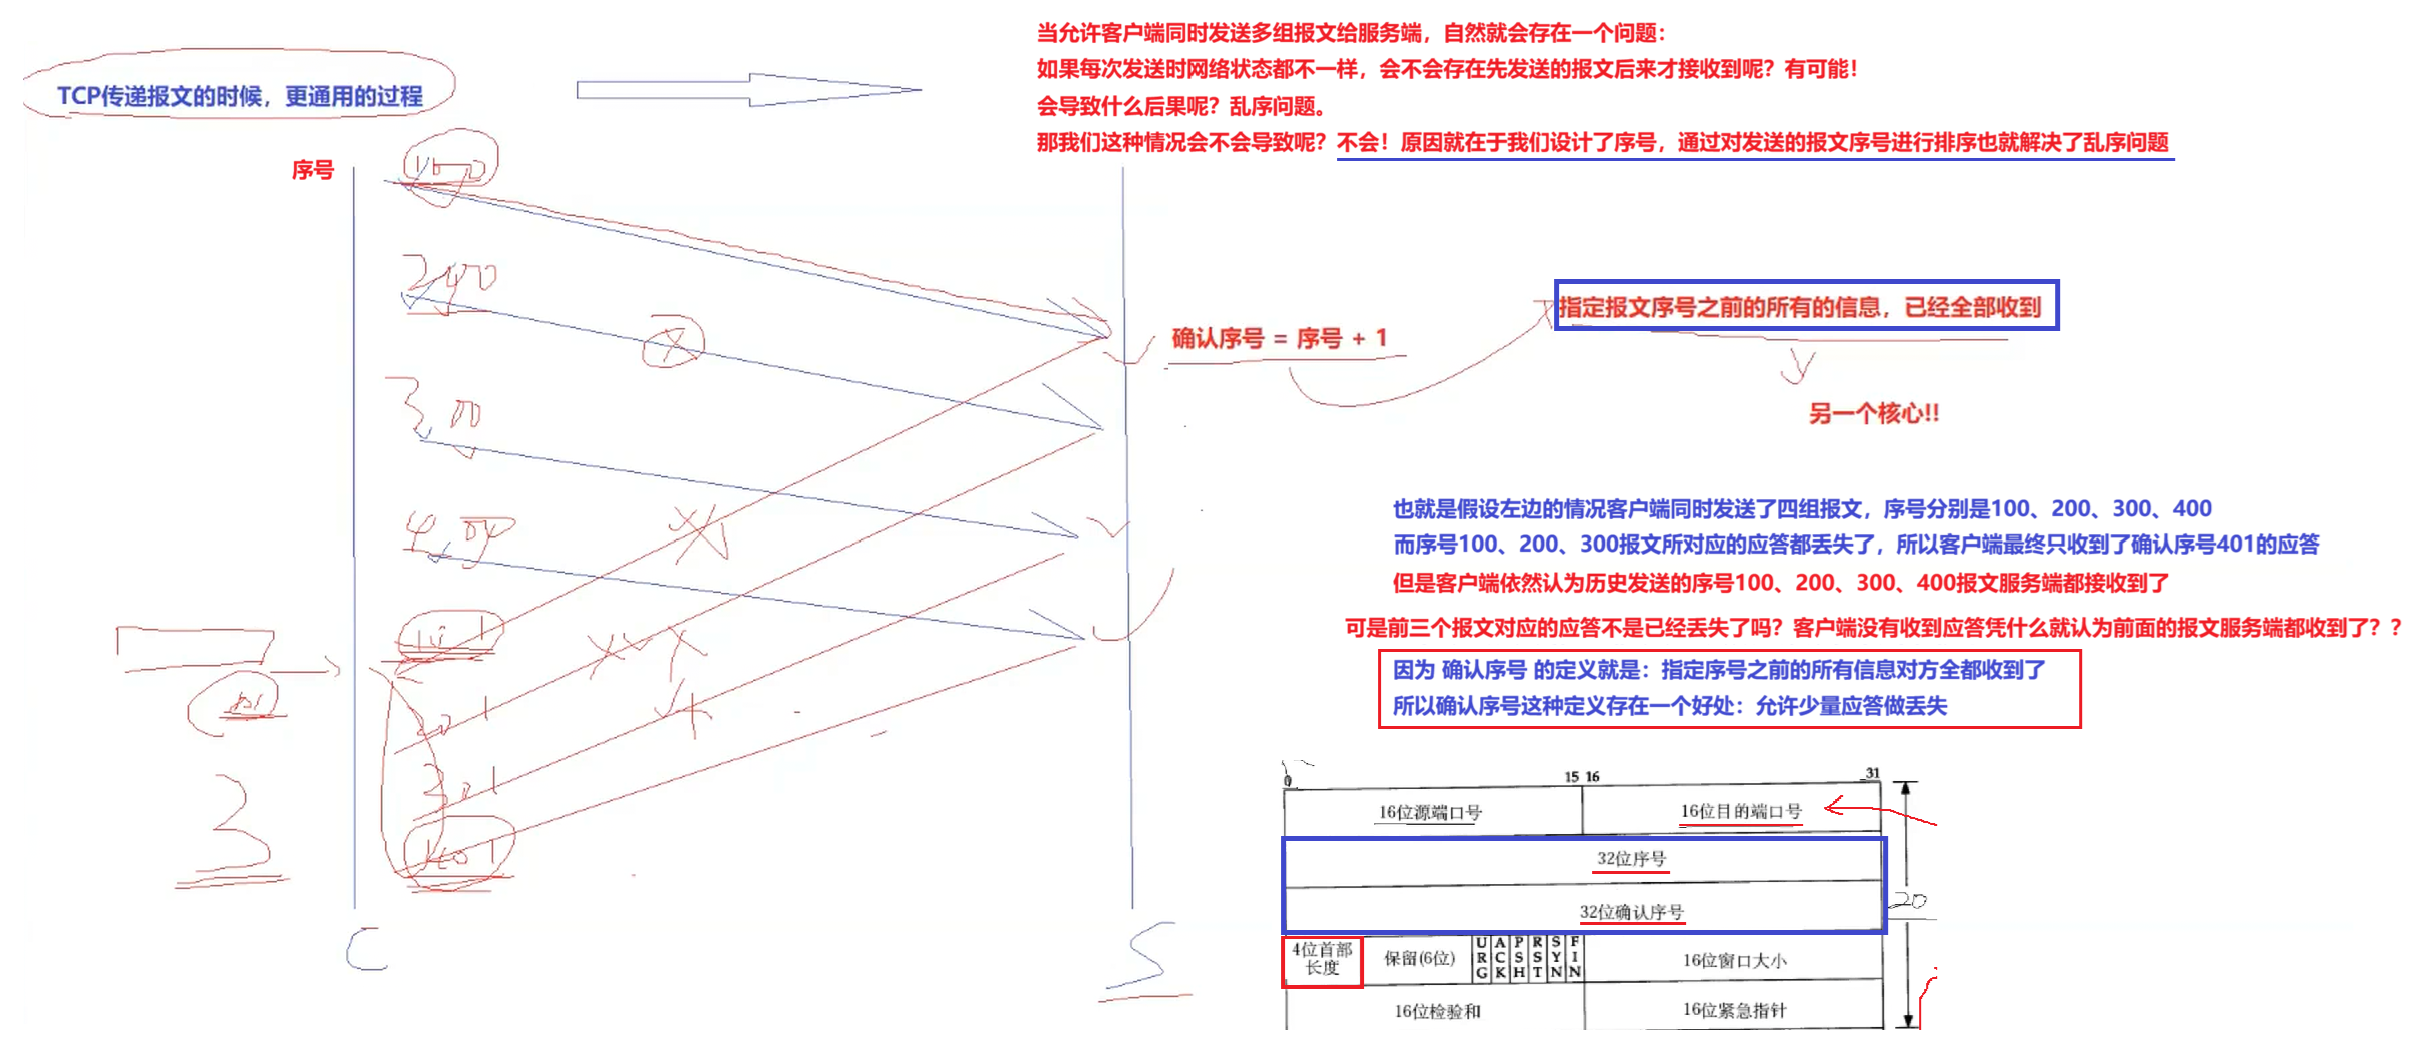
场景:发送方依次发送序号 100、200、300、400 四段报文;序号 300 的报文在传输途中丢失,400 报文先抵达接收端。 此时接收方不能直接应答 400,仍然持续回复确认序号 300。 即便收到 400 这一段,接收端也会告知发送方:300 之前的数据已经全部收到,请从 300 继续发送。只有 300 号报文补齐之后,确认序号才会继续向后推进。
面试小结:确认序号只确认连续的前置字节,后面提前到达的数据不会单独确认,这就是累积确认。
3.5.1 前置基础定义
TCP 是面向字节流的协议,全部数据都会按字节分配连续序号,序号对应内核接收缓冲区的字节下标。
- 报文起始序号:该报文携带的第一个字节的下标
- 报文结束序号:该报文携带的最后一个字节的下标 = 起始序号 + 报文长度 – 1
- 确认序号 ACK:接收方返回期望收到的下一个字节下标,含义:我已经完整收到 ACK 序号之前的全部字节,这就是 TCP 累积确认的核心规则。
3.5.2 正常无丢包场景的序号流转
连续发送 4 个报文,每个报文固定承载 100 字节数据:
| 报文 1 | 1 | 1~100 | 100 | 101 |
| 报文 2 | 101 | 101~200 | 200 | 201 |
| 报文 3 | 201 | 201~300 | 300 | 301 |
| 报文 4 | 301 | 301~400 | 400 | 401 |
网络正常无丢包、不乱序时,接收方收到报文后回复对应的确认序号:
- 收到报文 1 → 返回 ACK=101:1~100 字节已全部接收,下次从 101 开始发送
- 收到报文 2 → 返回 ACK=201:1~200 字节已全部接收,下次从 201 开始发送
- 收到报文 3 → 返回 ACK=301:1~300 字节已全部接收,下次从 301 开始发送
- 收到报文 4 → 返回 ACK=401:1~400 字节已全部接收,下次从 401 开始发送
3.5.3 报文 3 丢失、报文 4 乱序提前到达场景
发送方按顺序发送:报文 1 → 报文 2 → 报文 3 → 报文 4。 网络传输发生异常:报文 1、报文 2 正常抵达接收端;报文 3(201~300 字节)在传输途中丢失;报文 4(301~400 字节)绕过路由,先于报文 3 到达接收方。
接收方缓冲区当前状态:
- ✅ 连续完整收到:1~200 字节(报文 1、报文 2)
- ✅ 提前零散收到:301~400 字节(报文 4,临时存放在接收缓冲区)
- ❌ 缺失空缺段:201~300 字节(报文 3)
重点说明: 虽然报文 4 已经提前到达并存入接收缓冲区,接收方依然只能回复 ACK=201,不能返回 ACK=401。 累积确认有硬性约束:确认序号只能标记已经连续收到的最大字节的下一位,不能跳过中间缺失的字节。 如果返回 ACK=401,会误导发送方,让发送方认为 1~400 全部收到,不会重传丢失的 201~300 这一段,最终造成数据永久丢失。 接收端只会暂存提前抵达的报文 4,但不会更新确认序号,必须等空缺的 201~300 字节补齐之后,确认序号才会向后推进。
👉 悬念:此时发送方收到 ACK=201 重复应答,如何判断是报文 3 发生丢失、需要重传报文 3?该部分依赖滑动窗口、快速重传机制,我们留到后面章节详细讲解。
3.5.4 补齐缺失报文后的确认应答
发送方触发重传,重新发送报文 3(201~300 字节)。接收端收到重传的报文 3 后,缓冲区 1~400 字节全部补齐,此时接收方返回 ACK=401。 ACK=401 属于累积确认,它的含义是:1~400 的所有字节我都完整收到。
- 中间的 ACK=201、ACK=301 应答报文就算在网络中丢失也没关系
- 只要发送方收到最高确认序号 ACK=401,就代表前置全部字节送达
- 不需要重复重传任何报文,直接从 401 序号继续传输后续数据
3.5.5 核心结论
3.6 问题:为什么同时需要序号和确认序号?
在前面的例子里,我们看到确认序号可以表示 “我已经收到了哪些字节”。 于是有人会问:既然确认序号已经能说明接收进度,为什么不直接只用一个32位序号字段?应答时把序号加 1 再添到32位序号中返回不就行了?
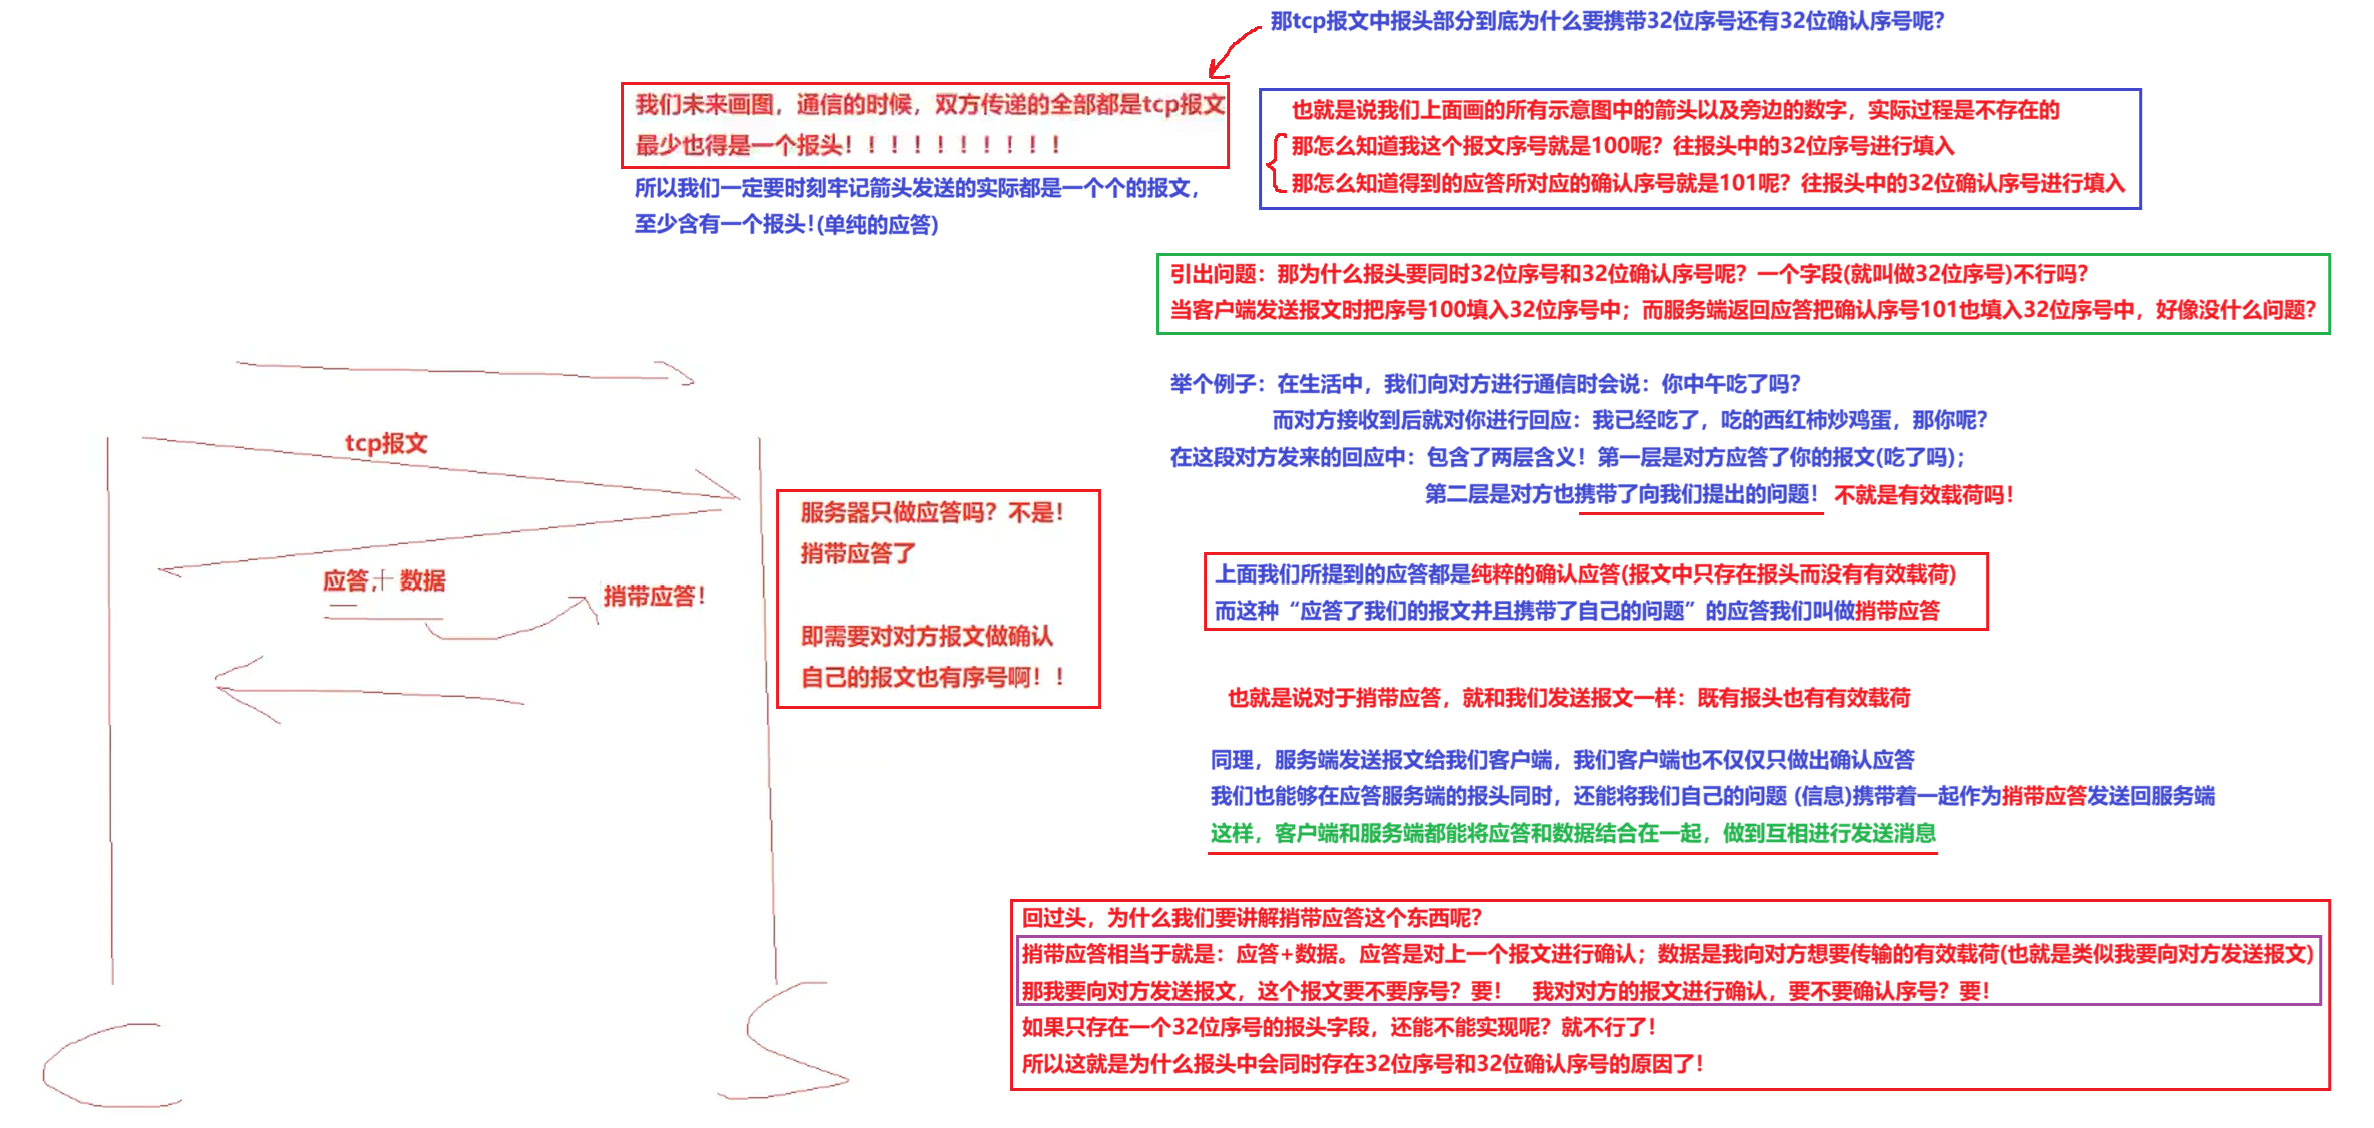
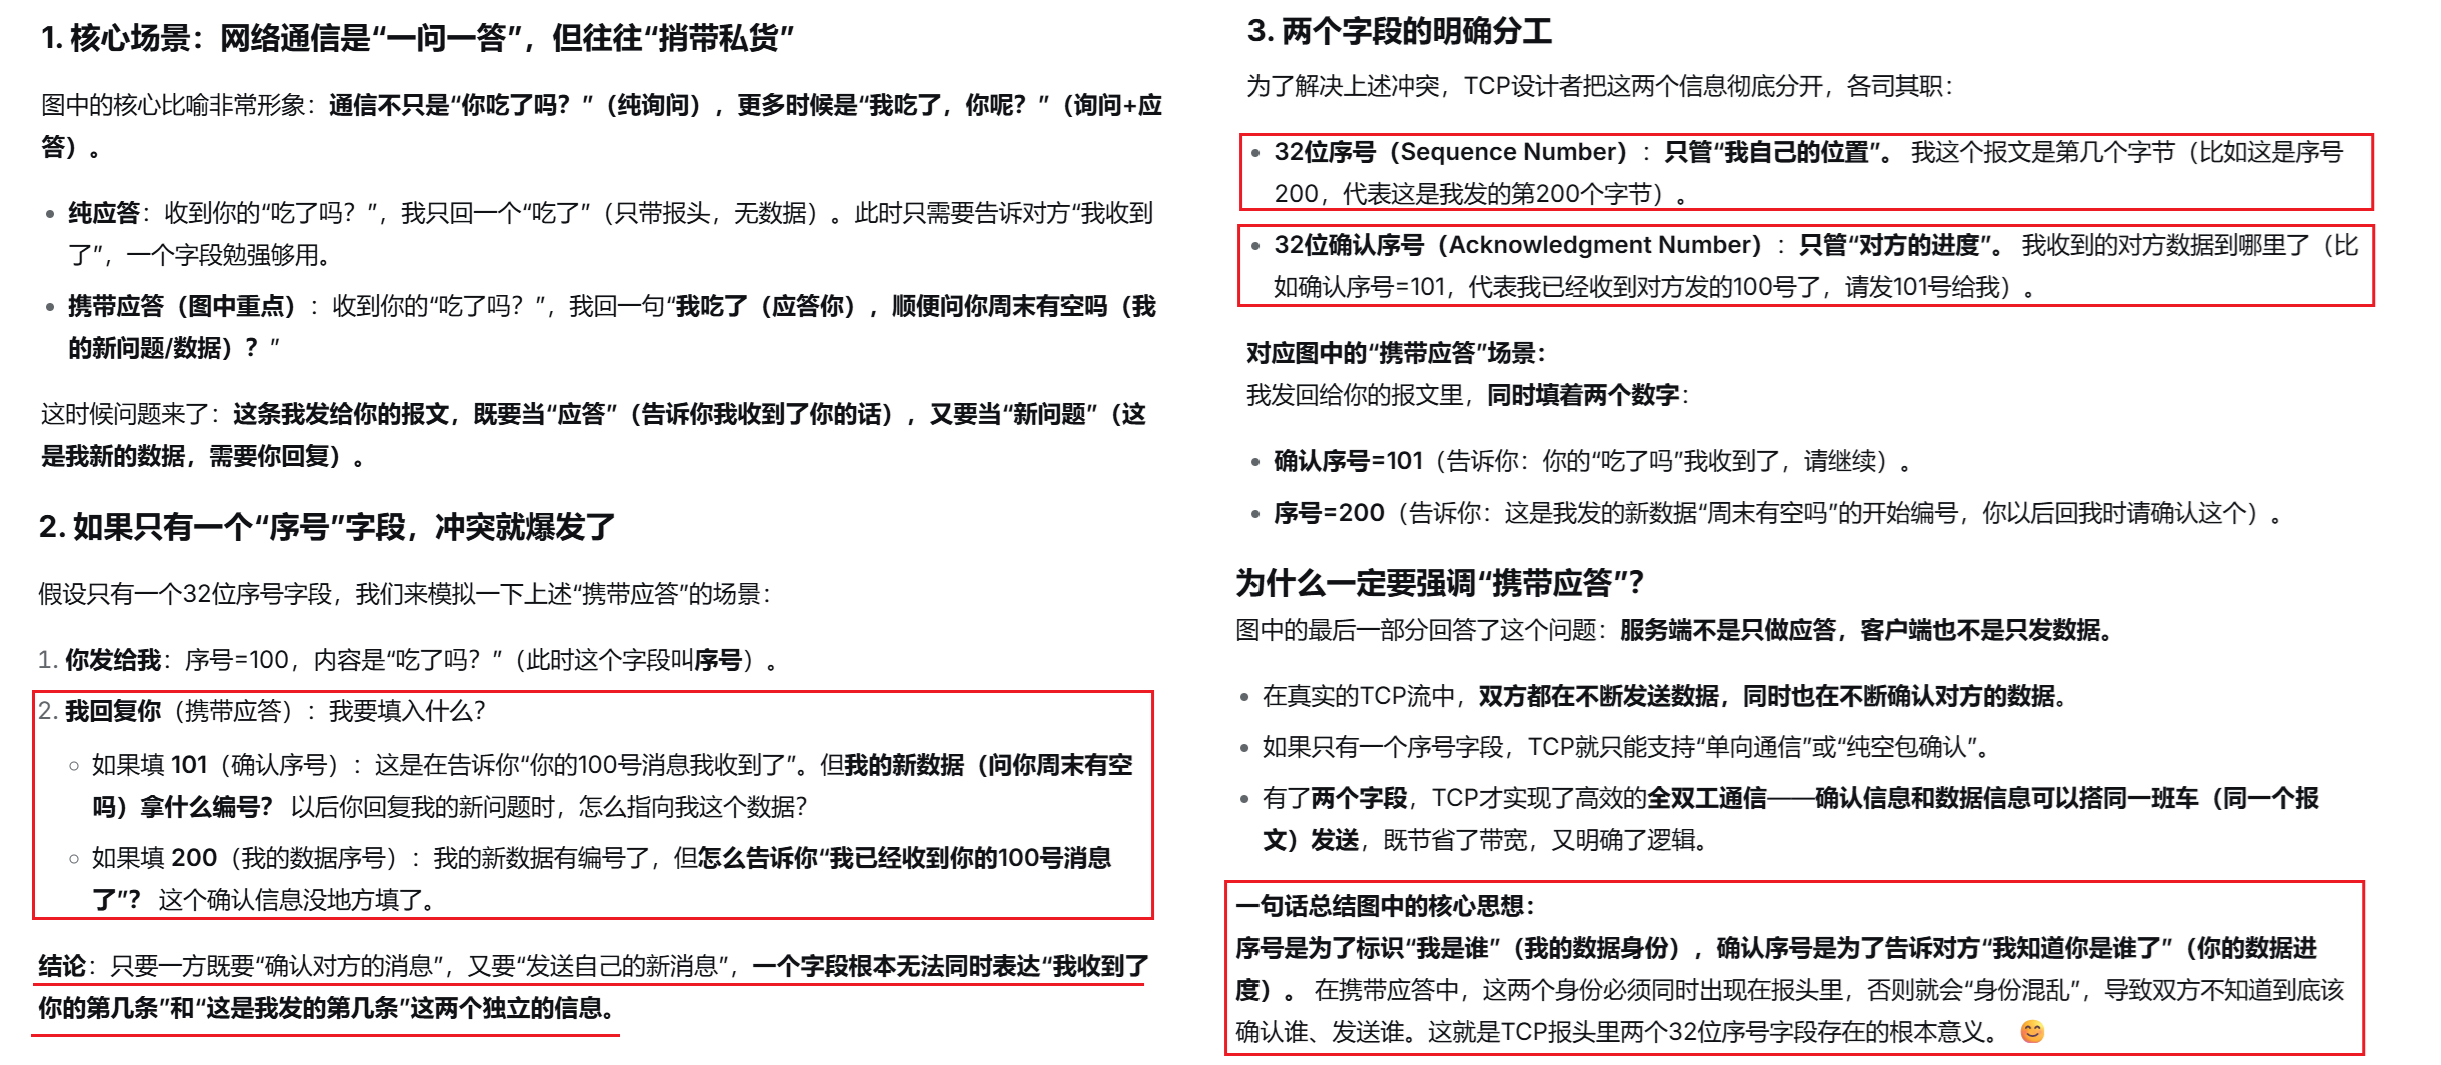
这个问题的关键在于:TCP 是全双工协议,通信双方可以同时发送数据。 在这种情况下,发送方不仅要标识 “自己发的数据到了哪里”,还要标识 “自己确认收到了对方哪些数据”。
3.6.1 全双工通信要求双方都能发送和确认
TCP 允许两端同时传输数据。主机 A 可以向主机 B 发送数据,主机 B 也可以同时向主机 A 发送数据。这意味着:
- 每一端都需要一个 “发送序号”,用来标记自己发送数据的字节位置;
- 每一端也需要一个 “确认序号”,用来告诉对方:我已经收到了你的哪些数据。
如果只有一个序号字段,就无法同时区分:
- 当前报文是在描述 “我发送到哪里”;
- 还是在描述 “我确认收到了哪里”。
因此,序号和确认序号是两个独立职责:
| 序号 | 标识本报文携带的数据在发送方字节流中的位置 |
| 确认序号 | 标识接收方已经连续收到的最大字节位置 |
3.6.2 捎带应答:一个报文同时承载数据和 ACK
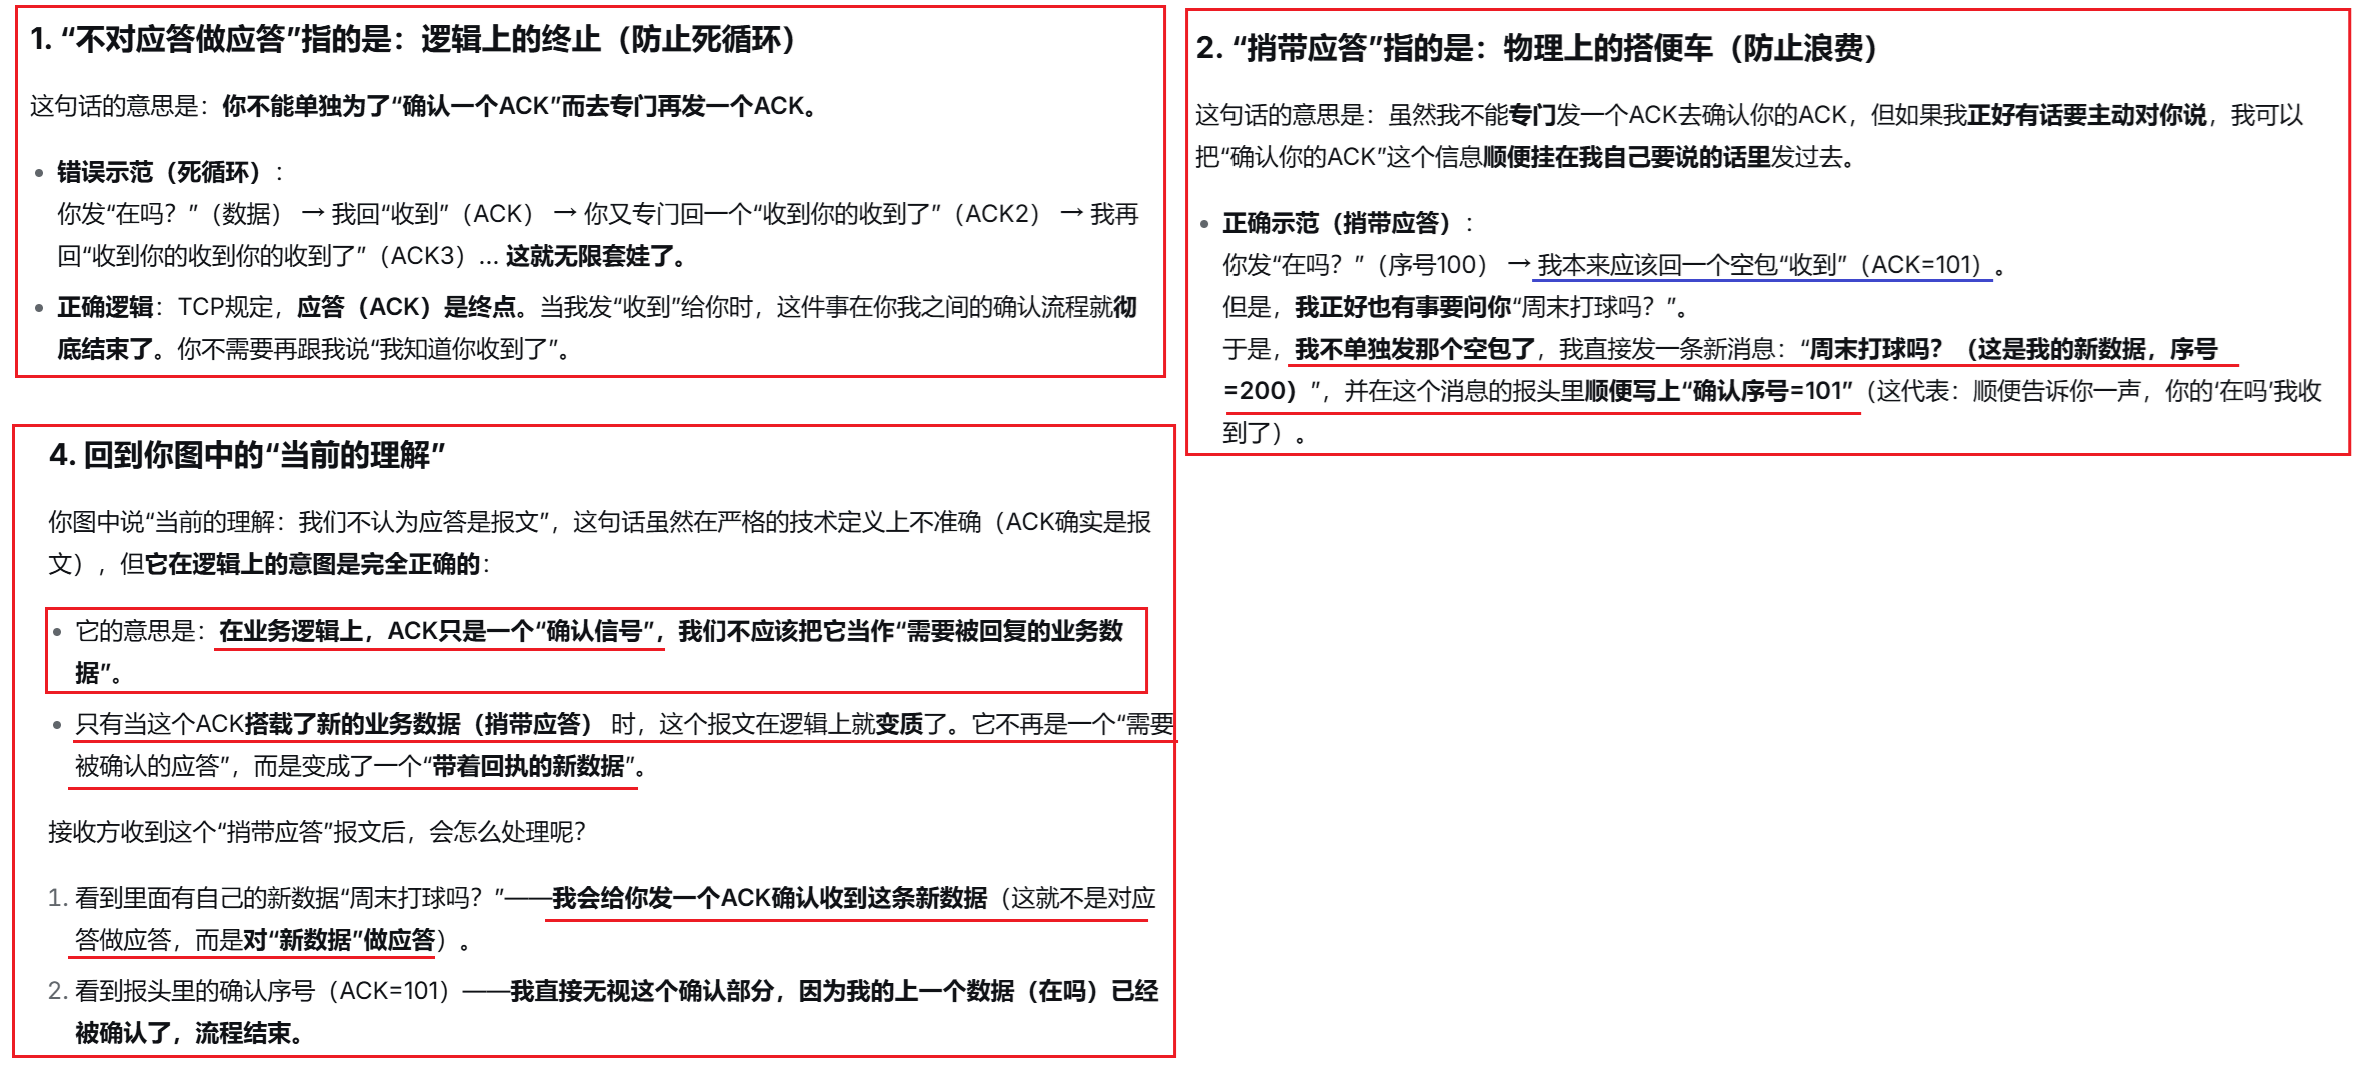
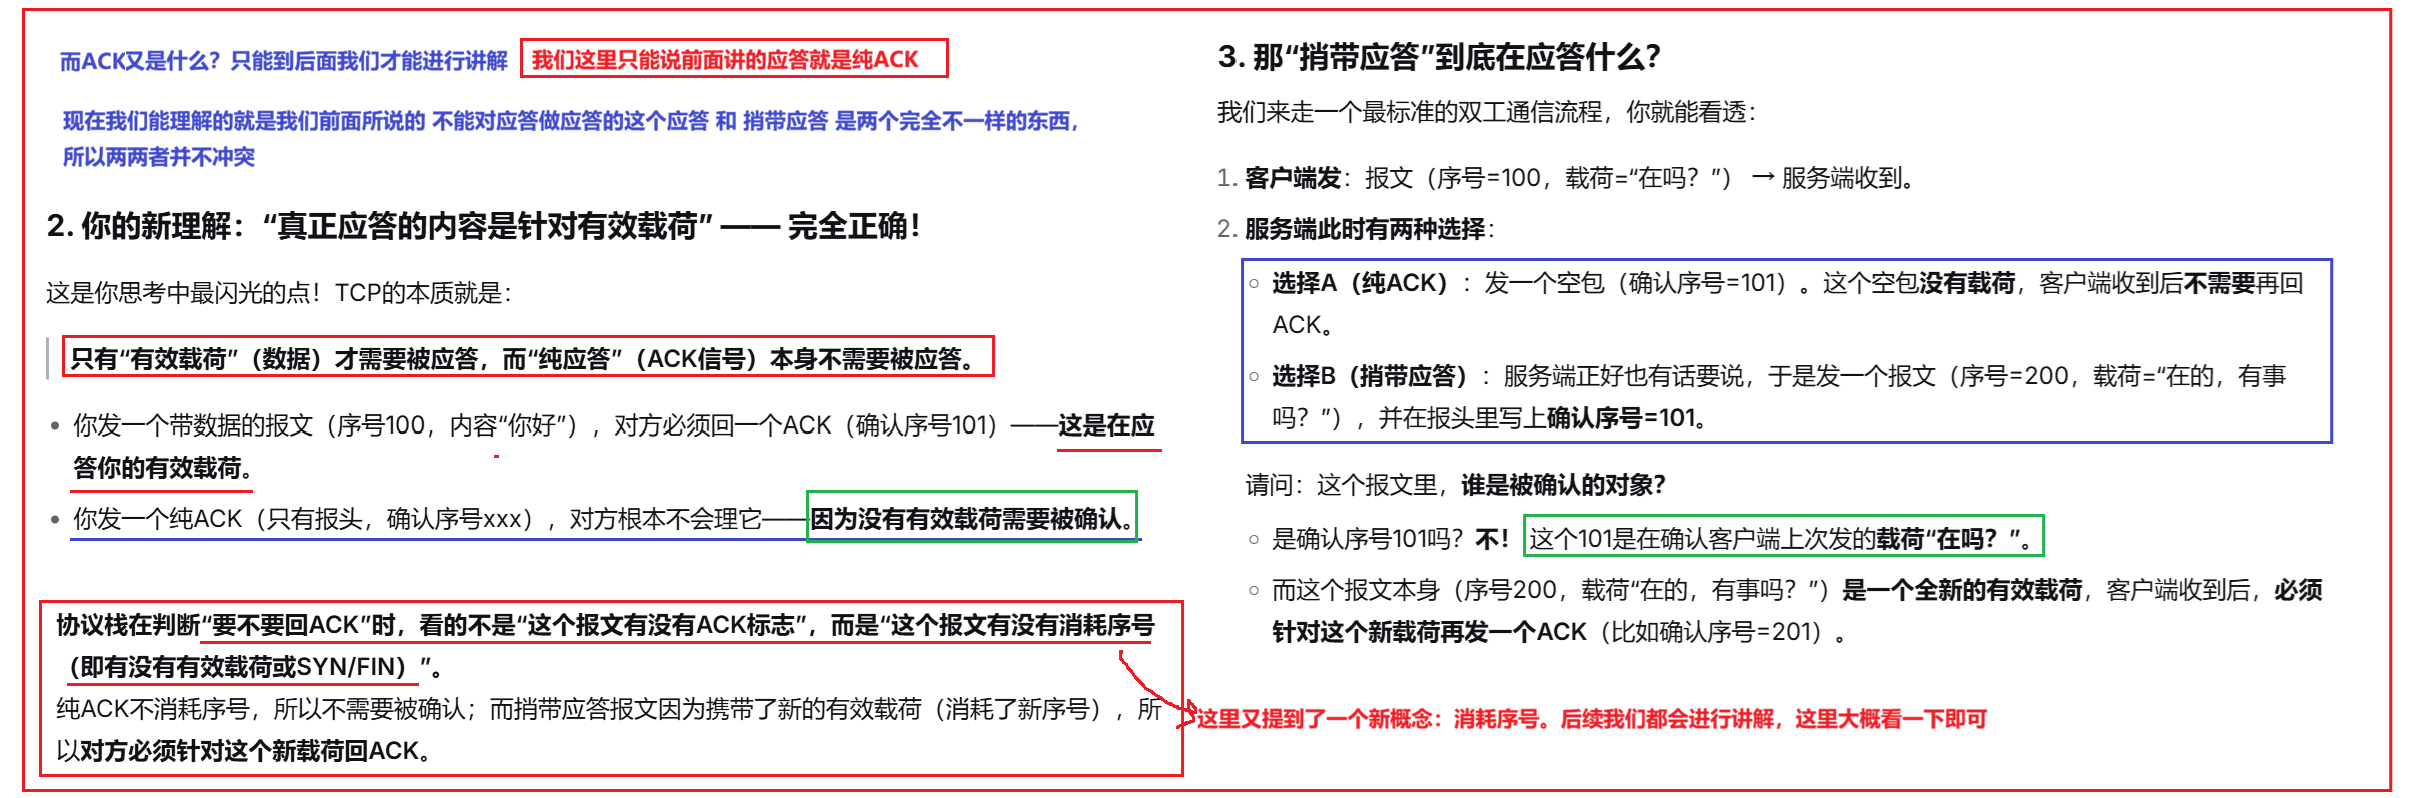
TCP 的全双工特性带来了一个重要优化:捎带应答。 当主机 B 需要向主机 A 发送数据时,它不必单独发送一条空的 ACK 报文,而是可以把对主机 A 的确认信息,直接放到自己的业务数据报文中一起发送。
例如:
这样,这个报文既携带了主机 B 的业务数据,又完成了对主机 A 的确认,减少了单独 ACK 报文的数量,提高了传输效率。
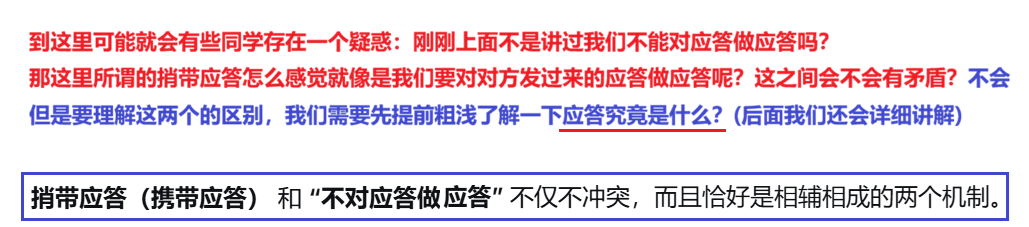
3.6.3 区分:捎带应答&&纯ACK应答
引出问题:
3.6.4 小结
TCP 之所以同时需要序号和确认序号,根本原因有两个:
这也进一步说明:序号和确认序号并不是两个孤立的数字,而是 TCP 可靠性、顺序控制和流量控制的重要基础。后续讲解滑动窗口时,还会看到这两个字段如何配合窗口大小,共同决定发送方可以连续发送多少数据。
四、TCP 16 位窗口大小与流量控制
4.1 流量控制产生背景
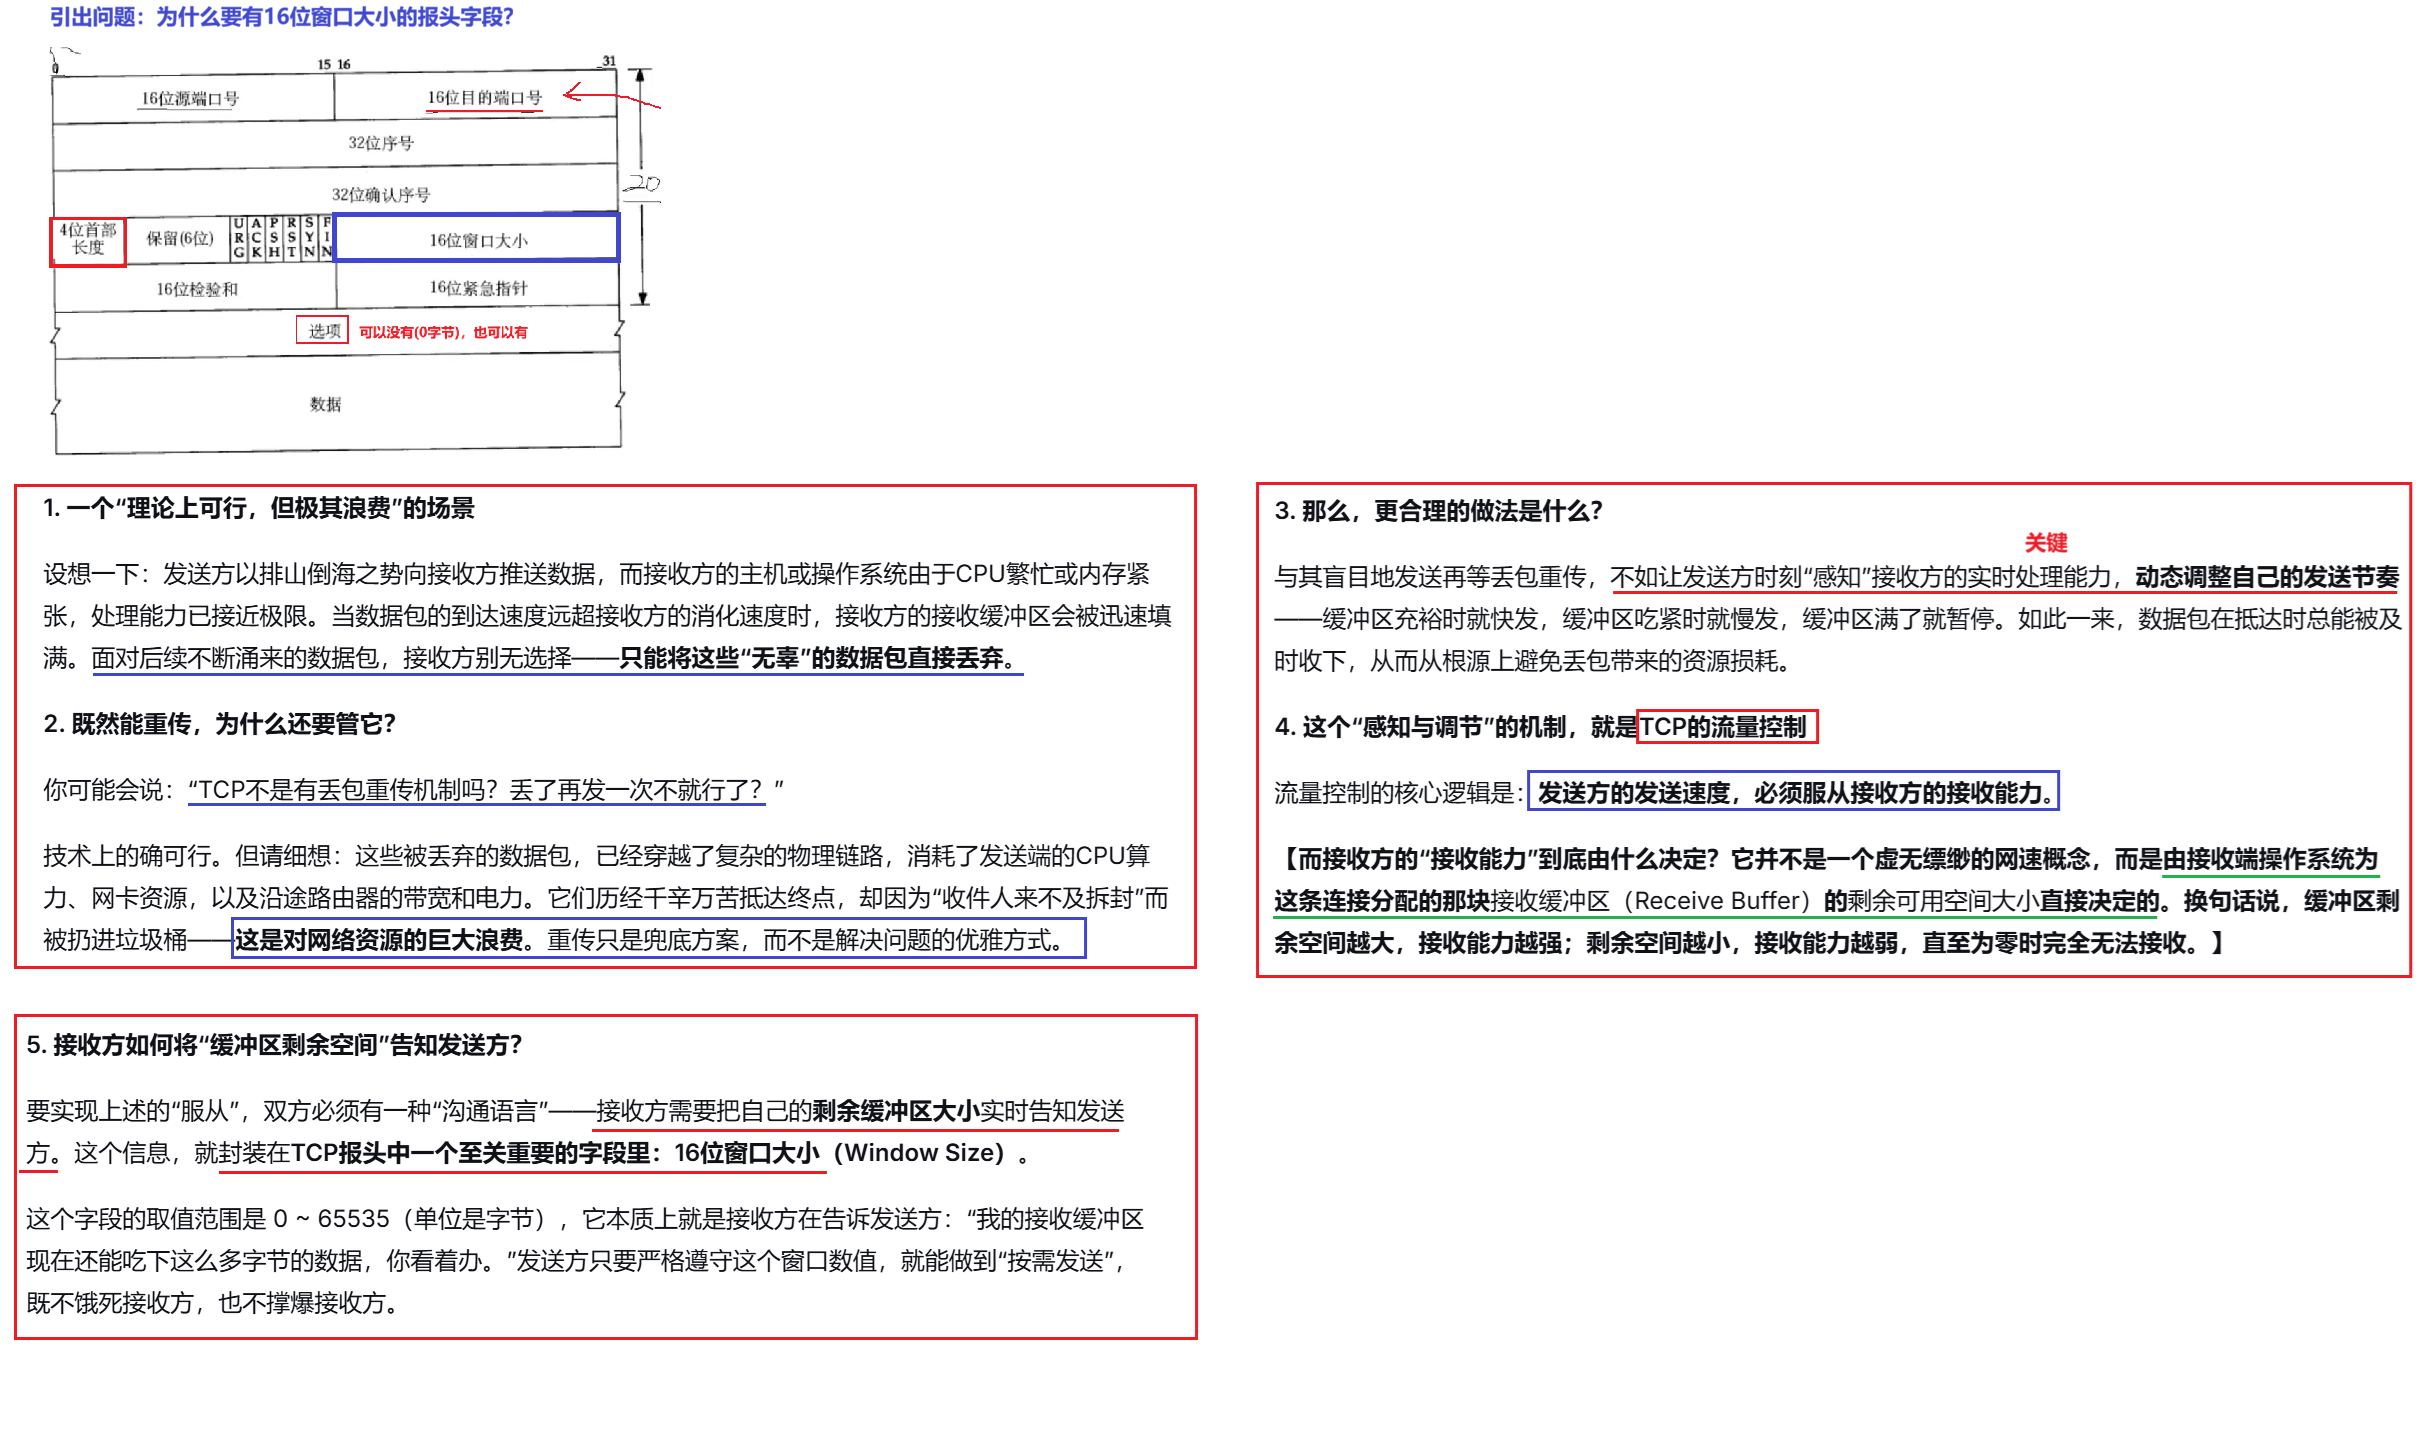
即便网络带宽充足,发送方也不能无限制持续发送数据。接收主机的处理能力存在上限,如果发送速率过快,内核接收缓冲区会被迅速填满,后续到达的数据会直接丢弃。 数据包一旦丢失,会触发 TCP 超时重传,反复重传会浪费网络带宽、主机 CPU 以及内存资源,传输效率大幅下降。TCP 引入流量控制解决这个问题,而 TCP 头部的16 位窗口大小字段就是流量控制的核心载体。
4.2 接收方接收能力的量化标准
接收方的接收能力,由内核接收缓冲区的剩余空闲空间决定:
- 接收缓冲区的剩余空间越大,代表接收能力越强,可以接收更多数据;
- 接收缓冲区的剩余空间越小,接收能力越弱;
- 接收缓冲区的剩余空间为 0,缓冲区已满,无法接收新数据。
4.3 16 位窗口大小字段含义
窗口大小字段表示接收方当前接收缓冲区剩余空闲字节数量,单位是字节。 接收方在回复 ACK 应答报文时,会把自身接收缓冲区剩余空间写入窗口大小字段,告诉发送方当前还能接收多少字节的数据。 发送方读取 ACK 中的窗口值,动态调整发送速度:
- 窗口大:接收方处理压力小,发送方可以持续发送较多数据;
- 窗口小:接收方缓冲区剩余空间紧张,发送方需要降低发送速率;
- 窗口为 0:接收缓冲区已满,发送方必须暂停发送业务数据。
计算公式:窗口大小 = 接收缓冲区总大小 – 缓冲区已使用字节数
4.4 流量控制的本质:提高效率
4.5 窗口探测机制(零窗口死锁规避)
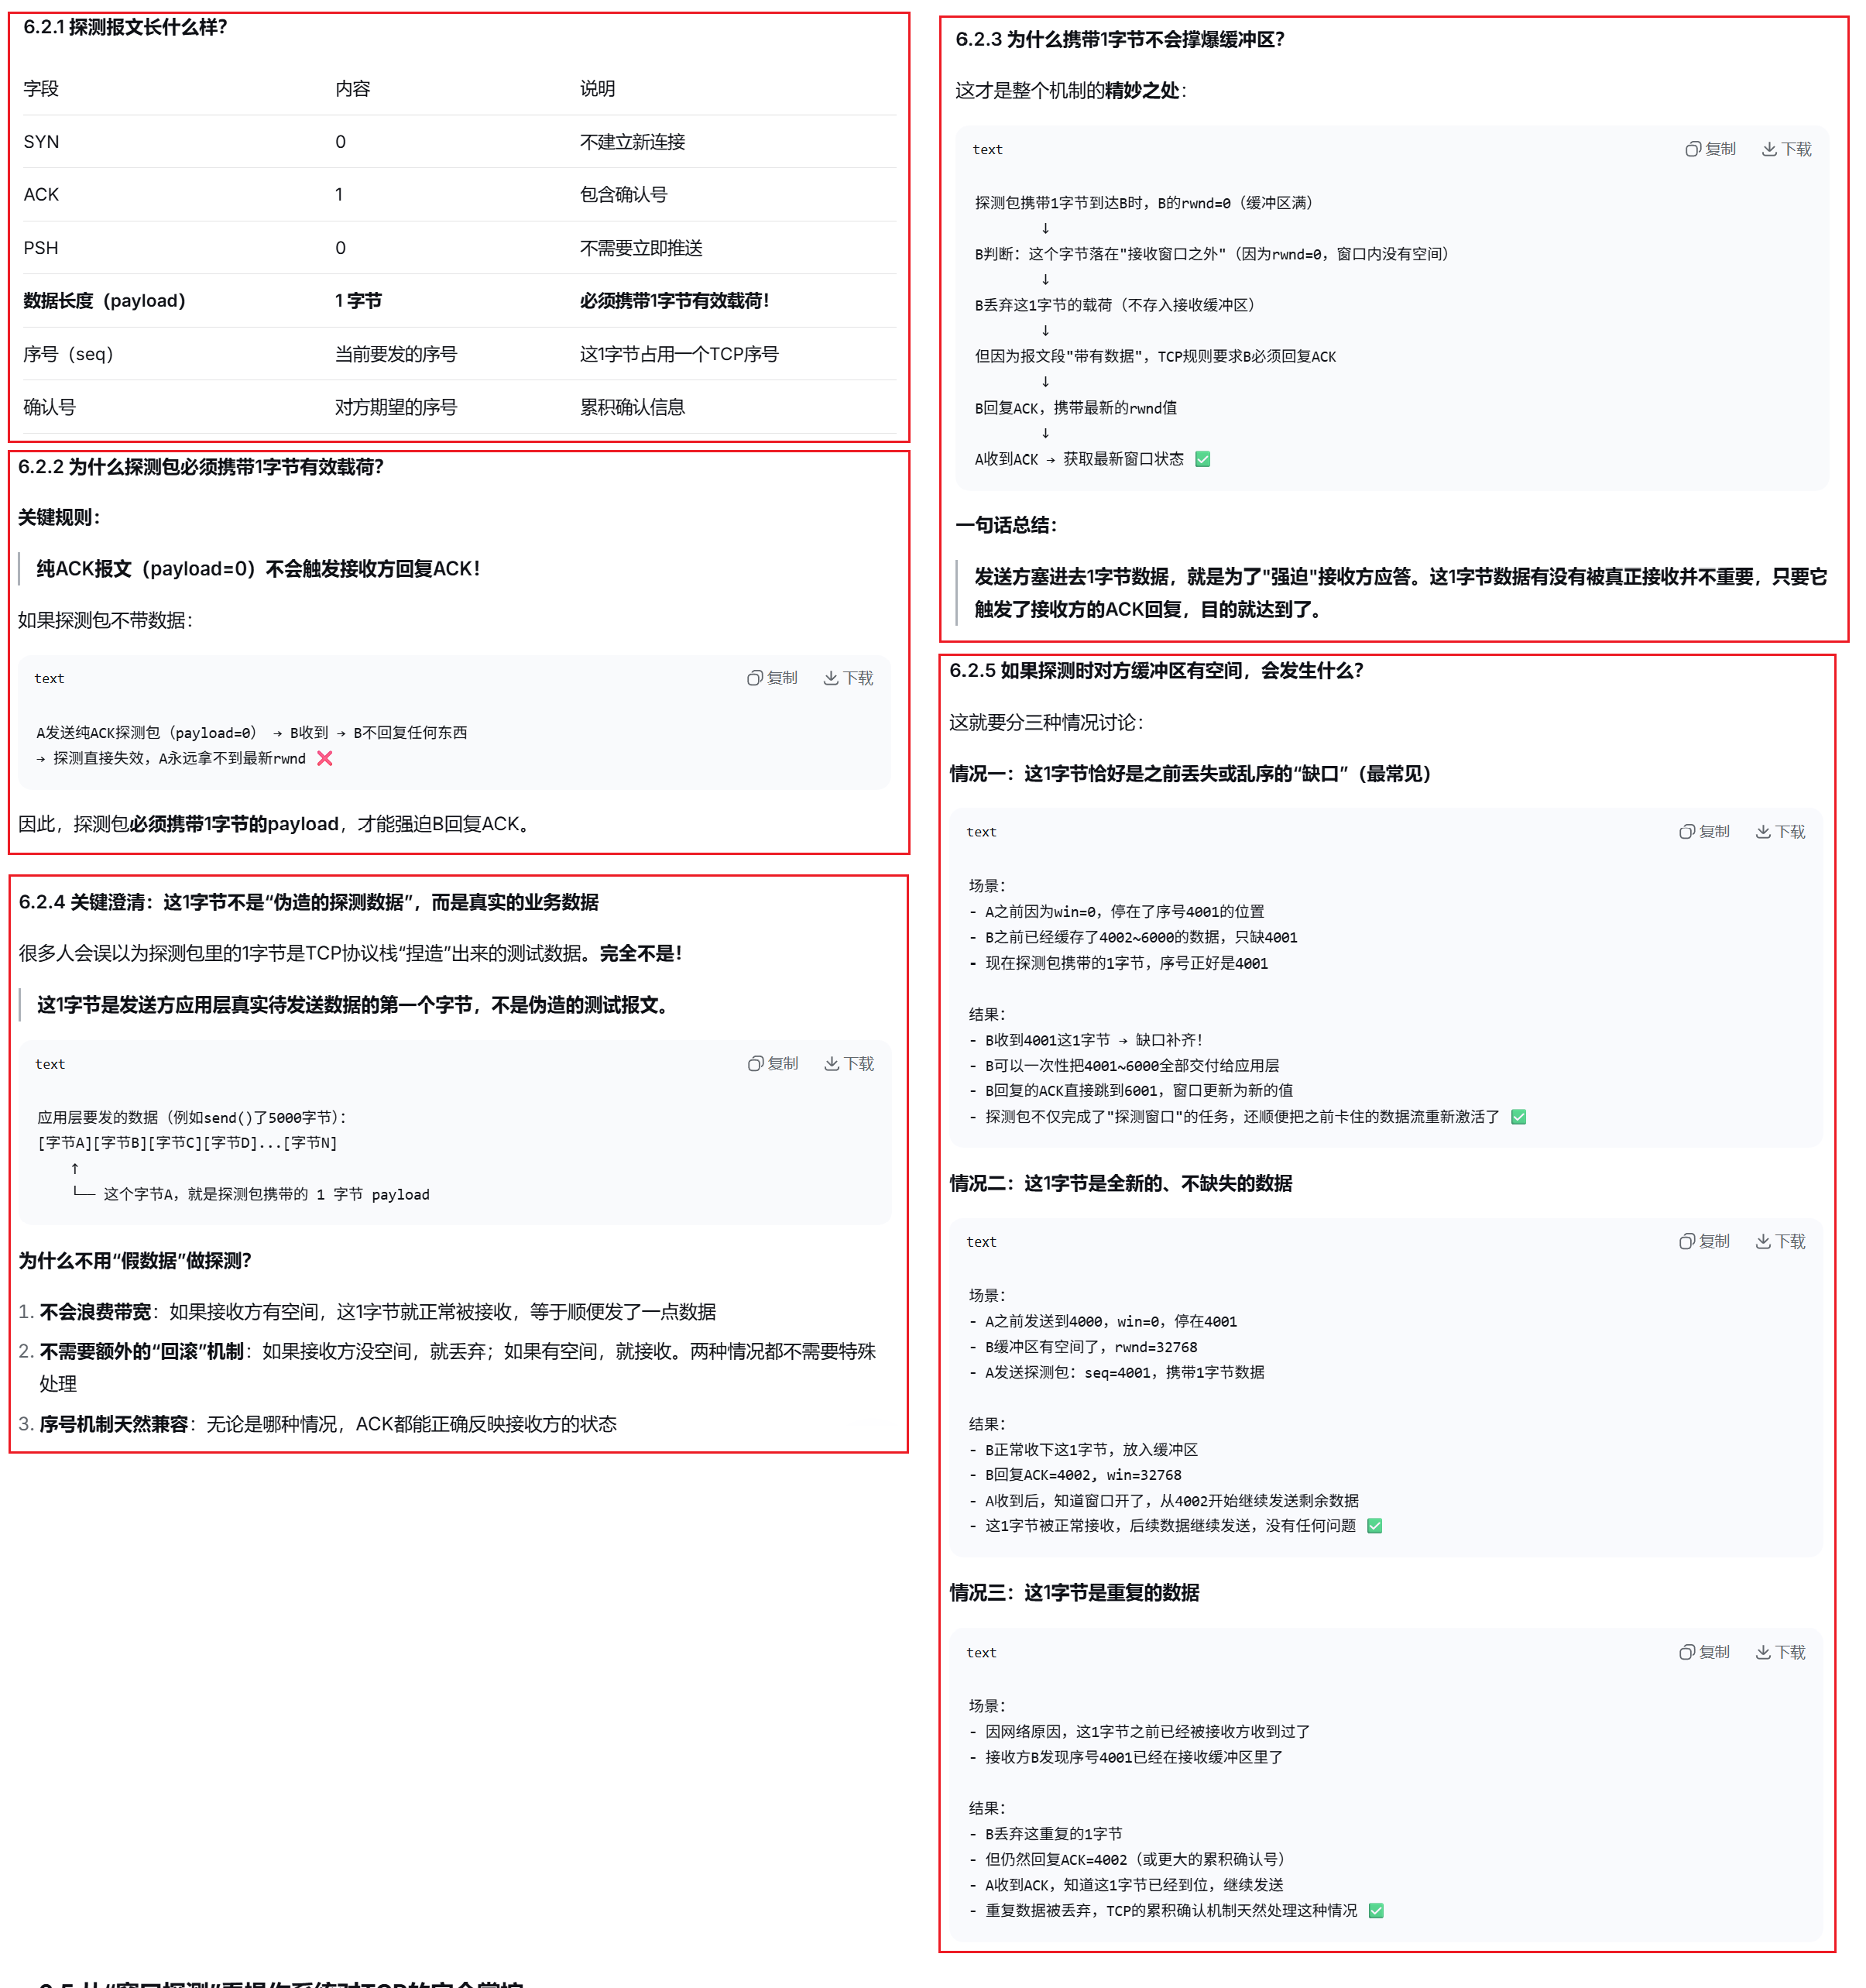
当接收方窗口等于 0,发送方停止发送业务数据。 这里存在一个风险:接收方后续窗口更新的 ACK 报文,如果在网络传输中丢失,发送方会一直阻塞等待,双方陷入死锁。 TCP 引入窗口探测机制解决该问题: 发送方收到窗口为 0 的 ACK 后,会周期性发送仅携带 1 字节数据的窗口探测报文,用来询问接收方当前最新窗口大小。
- 如果接收方窗口已经恢复,返回携带新窗口值的 ACK,发送方恢复数据传输;
- 如果窗口依旧为 0,接收方回复窗口 0,发送方继续等待,下一次周期再探测。
4.5.1 窗口探测视角:理解TCP面向字节流
4.6 核心总结
结束语
回顾本篇,我们承接上一篇文章对确认应答与超时重传的讲解,把视角从 "数据怎么保证送达" 推进到 "数据怎么传得又快又稳"。我们先是理清了停等协议与流水线两种发送模式的区别,明白 TCP 之所以默认采用并行发送,是为了消除等待应答的往返空档,充分榨取链路带宽。
随之而来的丢包定位、乱序重组、重复报文识别,则依靠序号与确认序号这套字节级编号体系解决。通过丢包场景的推演,我们看到累积确认如何保证有序交付,也理解了为什么序号和确认序号两个字段缺一不可。最后,流量控制机制借助 16 位窗口字段动态调节发送速率,解决了接收方缓冲区溢出的隐患,窗口探测则化解了零窗口下的死锁风险。
值得注意的是,流量控制针对的是收发两端处理能力不匹配的问题,与后续要讲的拥塞控制并非同一概念。序号、窗口、重传这些机制环环相扣,共同撑起 TCP 复杂而严谨的传输控制体系,也为下一部分学习三次握手、四次挥手与连接管理打下了坚实基础。


评论前必须登录!
注册