 网硕互联帮助中心
⭐️在这个怀疑的年代,我们依然需要信仰。
个人主页 :YYYing.
⭐️设计模式系列专栏:设计模式系列
系列下期内容:暂无
目录
前言:
1.1 优秀设计的特征
1.1.1 代码复用(Code Reuse)
1.1.2 扩展性(Extensibility)
1.1.3 可维护性与可复用性:一对孪生目标
1.2 面向对象设计原则总览
1.3 SOLID 原则
1.3.1 单一职责原则 SRP
反例:RoleDataOperation
重构后
⚠️ 注意事项
1.3.2 开闭原则 OCP
反例:刷怪塔
重构:多态 + 注册表
⚠️ 注意事项
1.3.3 里氏替换原则 LSP
替换规则
正面示例:兼容 LSP 的设计
反面示例:不兼容 LSP
TIP:现在的问题是谁应该对违反 LSP 负责?
TIP:常见的 LSP 违规
1.3.4 依赖倒置原则 DIP
落地要求
依赖注入(Dependency Injection, DI)
反例:DataBiz 针对具体实现编程
重构:抽象 + 依赖注入 + 配置文件
C++ 视角的关键收益
1.3.5 接口隔离原则 ISP
"接口"的两种不同含义
反例:一个包办所有的胖接口
重构后:按角色拆分成小接口
⚠️ 使用接口隔离原则时的注意事项
1.4 组合复用原则 CRP
为什么优先组合?
白箱复用 vs 黑箱复用
一般而言的判断标准
案例:多维度扩展导致的子类爆炸
重构:用组合替代多维继承
C++ 视角的补充收益
1.5 迪米特法则 LOD
1.5.1 法则目标
1.5.2 狭义的迪米特法则
1.5.3 广义的迪米特法则
1.5.4 案例
1.5.4.1 与直接朋友通信
1.5.4.2 减少对朋友的了解
1.5.5 使用注意事项
1.6 小结
面试/复习八问
一句话记忆版
原则之间的关系
附录:七大原则速查表(复习用)
前言:
相信我们很多人在学习网上的项目的时候,会有一个最大的迷惑,就是“为什么这里要这么设计?”,设计模式就是来回答这个问题的,我相信哪怕只看下去这一篇,那么对于做过一些质量比较高的项目的人,都会在你的项目中找到对应的设计点,不说了我们马上开始。
1.1 优秀设计的特征
在开始学习实际的模式之前,先看看软件架构的设计过程 —— 搞清楚要达成什么目标,以及要避开哪些陷阱。
1.1.1 代码复用(Code Reuse)
无论是开发何种软件产品,成本和时间都是最重要的两个维度:
-
较短的开发时间意味着可以比竞争对手更早进入市场;
-
较低的开发成本意味着能够留出更多营销资金,从而更广泛地覆盖潜在客户。
而代码复用是降低开发成本时最常用的方式之一。
💬 人话:复用不是"抄代码",而是"这段逻辑我只维护一份"。 判断一段代码值不值得抽出来复用,就问一句:同样的 bug,你愿意修几次? 如果答案是"两次以上",那就该抽出来。
1.1.2 扩展性(Extensibility)
变化是程序员生命中唯一不变的事情。
-
比如你在 Windows 平台下发布了一款游戏火了,玩家要求发布 Mac 版;
-
比如你设计了一款漂亮的数字验证码插件,但是用户要求滑块验证码;
-
比如你刚刚完成一个功能,此时需求变了(太常见了)。
因此在设计程序架构时,所有有经验的开发者会尽量选择支持未来任何可能变更的方式。
在支持可维护性(Maintainability)的同时,提高系统的可复用性(Reusability)是一个至关重要的问题。如何同时提高一个软件系统的可维护性和可复用性,是面向对象设计需要解决的核心问题之一。
💬 人话:需求变化不是"意外",而是"常态"。好的设计不是祈祷需求别变,而是让变化的代价尽可能小。 一个朴素的衡量标准:需求变了,你要动几个文件?改完之后,你敢不敢不重新测一遍全部功能?
1.1.3 可维护性与可复用性:一对孪生目标
| 可维护性 | Maintainability | 系统能被理解、修改、排错、升级的难易程度 | 半年后你还能看懂自己写的代码 |
| 可复用性 | Reusability | 已有的设计/实现能被用在别的场景 | 这段代码换个项目还能直接用 |
面向对象设计原则,就是为了支持"可维护的复用"而诞生的。
1.2 面向对象设计原则总览
面向对象设计原则为支持可维护性复用而诞生。这些原则蕴含在很多设计模式中,它们是从许多设计方案中总结出的指导性原则。
面向对象设计原则也是后续设计模式学习的基础 —— 每一个设计模式都符合一个或多个设计原则,是评价设计模式使用效果的重要指标之一。
常见的设计原则如下图所示:
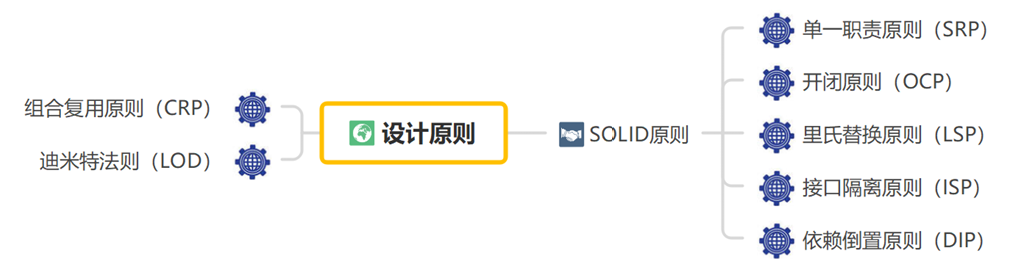
| 单一职责原则 | Single Responsibility Principle, SRP | 一个类只干一件事 |
| 开闭原则 | Open-Closed Principle, OCP | 对扩展开放,对修改关闭 |
| 里氏替换原则 | Liskov Substitution Principle, LSP | 子类必须能替换父类 |
| 依赖倒置原则 | Dependence Inversion Principle, DIP | 依赖抽象,别依赖具体 |
| 接口隔离原则 | Interface Segregation Principle, ISP | 接口要小而专 |
| 组合/聚合复用原则 | Composite/Aggregate Reuse Principle, CRP/CARP | 优先组合,慎用继承 |
| 迪米特法则 | Law Of Demeter, LOD | 只和直接朋友说话 |
其中前五个(SRP、OCP、LSP、DIP、ISP)合称 SOLID 原则,是面向对象设计的纲领。
💬 人话:这七条不是"考试提纲",而是七种不同的"闻味道"的方法。 你写完一段代码觉得"哪里不对但又说不上来"时,逐条对一遍,通常能定位到问题:
-
一个类改起来牵连很多 → 可能是 SRP 或 LOD 的问题
-
加个功能要动老代码 → OCP 的问题
-
重写子类方法时心里发虚 → LSP 的问题
-
换个实现要重新编译半个项目 → DIP 的问题
-
实现一个接口被迫写一堆空方法 → ISP 的问题
-
继承层次深到看不清 → CRP 的问题
1.3 SOLID 原则
1.3.1 单一职责原则 SRP
单一职责原则(Single Responsibility Principle, SRP)是最简单的设计原则,它用来控制类的颗粒度大小。
官方定义:
Every object should have a single responsibility, and that responsibility should be entirely encapsulated by the class.
一个对象应该只包含单一的职责,并且该职责被完美地封装在一个类中。
另一种更实用的表述(Robert C. Martin):
A class should have only one reason to change.
一个类应该只有一个引起它变化的原因。
💬 人话版 "职责"不是"方法少",而是"变化的来源"只有一个。 一个类里,如果因为"数据库换了"要改它,因为"业务规则变了"也要改它,因为"报表格式改了"还要改它 —— 那它就有三个职责。 反过来说:如果两个功能永远是同时变、同时不变,那放在一个类里也没问题。 拆分不是目的,"让变化互不干扰"才是目的。
反例:RoleDataOperation
RoleDataOperation 类同时承载了三种功能职责:
数据库连接 —— 拼连接串、加载驱动、管账号密码、开关连接
数据库数据操作 —— 对 Role 表做增删改查
存档数据业务操作 —— 存档校验、序列化、加锁、读档数据修复等业务规则
// ❌ 违反 SRP:一个类三个变化的来源
class RoleDataOperation {
public:
// ── 职责一:数据库连接 ──────────────────
Connection* getConnection() {
// 拼 URL、加载驱动、账号密码……
}
void closeConnection();
// ── 职责二:数据库数据操作(CRUD)────────
void insert(const Role& role);
void update(const Role& role);
void deleteById(int id);
Role selectById(int id);
// ── 职责三:存档业务逻辑 ────────────────
void saveRole(Role& role) {
// 合法性校验 → 序列化 → 加分布式锁 → 调 insert/update
}
Role loadRole(int id) {
// 调 selectById → 反序列化 → 旧版本数据兼容修复
}
};
它有什么问题?
| 数据库从 MySQL 换成 PostgreSQL | ✅ 要改 |
| Role 表加了一个字段 | ✅ 要改 |
| 存档规则改了(比如要加密) | ✅ 要改 |
| 想把存档逻辑复用到另一个模块 | ❌ 无法复用,被连接和 CRUD 绑死了 |
四个问题里三个要改同一个类 —— 这就是"职责过多"的信号。
重构后
// ✅ 职责一:只管连接
class DBUtil {
public:
static Connection* getConnection();
static void closeConnection(Connection* conn);
};
// ✅ 职责二:只管 Role 的 CRUD
class RoleDAO {
public:
void insert(const Role& role);
void update(const Role& role);
void deleteById(int id);
Role selectById(int id);
};
// ✅ 职责三:只管存档业务
class RoleDataOperation {
DBUtil* m_db;
RoleDAO* m_dao;
public:
void saveRole(Role& role) {
checkRole(role); // 业务校验
std::string blob = serialize(role);
m_dao->insert(role); // 只调 DAO,不碰连接细节
}
Role loadRole(int id) {
Role r = m_dao->selectById(id);
fixLegacyData(r); // 旧版本兼容
return r;
}
};
重构收益(人话版):
-
数据库换代 → 只动 DBUtil
-
表结构变更 → 只动 RoleDAO
-
存档规则调整 → 只动 RoleDataOperation
-
存档逻辑要复用到"角色背包"模块 → 直接拿走 RoleDataOperation
💬 类比 一家餐厅里,采购员、厨师、服务员是三个人。如果让同一个人全包:采购出问题,全店停摆;厨师请假,没人接待客人。 而且"要换个供应商"这件事,本不该惊动厨师。
⚠️ 注意事项
-
职责划分没有绝对标准,取决于业务场景和变化频率,不要为了"拆"而拆。
-
方法级也适用 SRP:一个方法同时干了"取数据 + 算业务 + 拼输出",同样该拆。
-
常见错误:把 SRP 理解成"一个类只能有一个 public 方法" —— 那会导致类爆炸。
1.3.2 开闭原则 OCP
开闭原则(Open-Closed Principle, OCP)是面向对象的可复用设计的第一块基石,它是最重要的面向对象设计原则。
开闭原则由 Bertrand Meyer 于 1988 年提出,其定义如下:
Software entities should be open for extension, but closed for modification.
软件实体应对扩展开放,而对修改关闭。
在开闭原则的定义中,"软件实体"可以指一个软件模块、一个由多个类组成的局部结构或一个独立的类。
开闭原则就是指:软件实体尽量在不修改源码的情况下进行扩展。
开闭原则是评价基于某个设计模式设计的系统是否具备灵活性和可扩展性的重要依据。
💬 人话版 开闭原则要表达的是:当新需求来时,你只"加代码",不"改老代码"。
为什么强调"不改老代码"?因为老代码是已经测过、已经上线、正在跑的。改一行,就可能要回归测试整个模块 —— 而纯新增的代码,风险范围是可控的。
⚠️ 但要破除一个误解:绝对的开闭是不可能的。 你不可能预知所有变化。正确的姿势是:识别出这个系统中"可预期的变化点",把它设计成扩展点;对于预料之外的变化,坦然接受修改。 为想象中的变化过度设计(比如到处加抽象层),比不设计更糟 —— 这叫过度工程(Over-engineering)。
反例:刷怪塔
假设有一个"刷怪塔",createMonster 用如下实现:
// ❌ 违反 OCP
Monster* createMonster(int type) {
Monster* monster = nullptr;
if (type == 1) {
Boss* boss = new Boss();
monster = boss;
// Boss 扩展处理
} else if (type == 2) {
Elite* elite = new Elite();
monster = elite;
// 精英扩展处理
} else {
Soldier* soldier = new Soldier();
monster = soldier;
// 普通怪扩展处理
}
// 怪物对象通用处理(初始化数据、添加到对象池)
monster->init();
m_pool.add(monster);
return monster;
}
此时如果新增一种类型的怪物,那么必然会修改 createMonster 的业务逻辑,不符合开闭原则。
更糟的是,改动引入了回归风险:你只是在末尾加了个 else if,却必须重新验证 type == 1 / type == 2 / else 三条老分支有没有被影响。
💬 这段代码的本质问题 它把"有哪些怪物"和"怪物怎么创建、怎么通用处理"混在了一个函数里。 "有哪些怪物"是会变的;"创建完要初始化、要进对象池"是不变的。 开闭原则的做法就是:把会变的部分抽出去,让不变的骨架留下来。
重构:多态 + 注册表
// ── 抽象层:不变的部分 ────────────────────────────
class Monster {
public:
virtual ~Monster() = default;
virtual void init() = 0; // 各自的扩展处理
virtual Monster* clone() const = 0;
};
// ── 具体怪物:会变的部分,用"新增类"来承载 ──────────
class Boss : public Monster {
public:
void init() override { /* Boss 扩展处理 */ }
Monster* clone() const override { return new Boss(*this); }
};
class Elite : public Monster {
public:
void init() override { /* 精英扩展处理 */ }
Monster* clone() const override { return new Elite(*this); }
};
class Soldier : public Monster {
public:
void init() override { /* 普通怪扩展处理 */ }
Monster* clone() const override { return new Soldier(*this); }
};
// ── 工厂:创建逻辑的骨架,★ 从此不再改动 ─────────────
class MonsterFactory {
public:
using Creator = std::function<Monster*()>;
static MonsterFactory& instance() {
static MonsterFactory inst;
return inst;
}
void registerMonster(int type, Creator creator) {
m_registry[type] = std::move(creator);
}
Monster* createMonster(int type) {
auto it = m_registry.find(type);
if (it == m_registry.end()) return nullptr;
Monster* monster = it->second()(); // 多态创建,不需要 if-else
monster->init(); // 通用处理,骨架不变
m_pool.add(monster);
return monster;
}
private:
std::map<int, Creator> m_registry;
};
新增一种怪物时(比如"梦魇"):
class Nightmare : public Monster {
public:
void init() override { /* 梦魇扩展处理 */ }
Monster* clone() const override { return new Nightmare(*this); }
};
// 只需新增一个类 + 一行注册,createMonster 一个字都不动
static bool _reg = [] {
MonsterFactory::instance().registerMonster(4, [] { return new Nightmare(); });
return true;
}();
对比:
| 新增怪物 | 改 createMonster 加 else if | 新增一个类 + 注册 |
| 老分支回归风险 | 有 | 无 |
| 通用处理逻辑 | 散在 if-else 之间 | 集中在工厂里 |
| 配置文件驱动 | 做不到 | 可配合 conf.properties + 反射,改配置重启即可 |
💬 人话版总结 开闭原则不是"禁止修改代码",而是"让大多数变化以新增的方式发生"。 判断标准很简单:这次需求变更,我改的是"新文件"还是"老文件"?
⚠️ 注意事项
-
抽象不能凭空设计,要从已有的具体实现中提炼(先写两三个具体类,再抽公共父类)。
-
不要为"将来可能有的变化"提前造抽象层 —— 那叫猜测,不叫设计。
-
常见实现手段:抽象类/接口 + 多态 + 配置文件 + 反射/注册表(后面几种设计模式会反复用到)。
1.3.3 里氏替换原则 LSP
里氏替换原则(Liskov Substitution Principle, LSP)由 2008 年图灵奖得主、美国第一位计算机科学女博士 Barbara Liskov(芭芭拉·利斯科夫)教授和卡内基·梅隆大学 Jeannette Wing(珍妮特·温)教授于 1994 年提出。
严格表述:
If for each object o1 of type S there is an object o2 of type T such that for all programs P defined in terms of T, the behavior of P is unchanged when o1 is substituted for o2 then S is a subtype of T.
如果对每一个类型为 S 的对象 o1,都有类型为 T 的对象 o2,使得以 T 定义的所有程序 P 在所有的对象 o1 替换 o2 时,程序 P 的行为没有变化,那么类型 S 是类型 T 的子类型。
这个定义比较拗口且难以理解,因此我们一般使用它的另一个通俗版定义:
Functions that use pointers or references to base classes must be able to use objects of derived classes without knowing it.
所有引用基类(父类)的地方必须能透明地使用其子类的对象。
💬 人话版 把父类换成子类,调用方的代码一行都不用改,程序行为也不能变。
换句话说:子类必须"少要求、多保证",绝不能"多要求、少保证"。
-
输入(前置条件)只能放宽,不能收紧 → 父类接受任意路径,子类不能要求"必须 .mp3 结尾"
-
输出(后置条件)只能加强,不能放松 → 父类保证"返回非空列表",子类不能返回空
还有一句大白话:继承不是"蹭"父类的代码省点事,而是当众立下字据 ——"谁要一个 A,拿我去顶就行。" 顶不住这个位置,就别继承。
替换规则
里氏替换原则告诉我们:
-
正向成立:将一个基类对象替换成它的子类对象,程序将不会产生任何错误和异常。
-
反向不成立:如果一个软件实体使用的是一个子类对象,那么它不一定能够使用基类对象。
例如:
有两个类,一个类为 BaseClass,另一个是 SubClass 类,并且 SubClass 类是 BaseClass 类的子类。那么一个方法如果可以接受一个 BaseClass 类型的基类对象 base 的话,如:method1(base),那么它必然可以接受一个 BaseClass 类型的子类对象 sub,method1(sub) 能够正常运行。
反过来的代换不成立。如果一个方法 method2 接受 BaseClass 类型的子类对象 sub 为参数:method2(sub),那么一般而言不可以有 method2(base),除非是重载方法。
里氏替换原则是实现开闭原则的重要方式之一。由于使用基类对象的地方都可以使用子类对象,因此在程序中尽量使用基类类型来对对象进行定义,而在运行时再确定其子类类型,用子类对象来替换父类对象。
💬 人话版 这就是"多态"能成立的契约保障。 因为你写好 download(Product* p) 之后,脑子里假设的是"只要是个 Product,就能 download"。 LSP 就是在说:这个假设,子类必须给我兑现。
正面示例:兼容 LSP 的设计
类图:
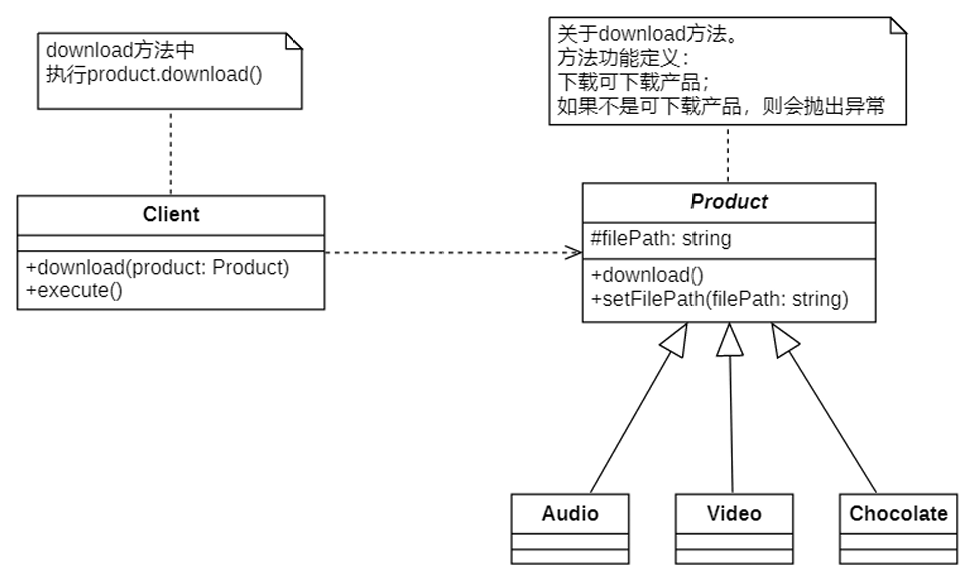
兼容 LSP 的 execute 方法:
// 创建 Audio 产品对象
Product* audio = new Audio();
audio->setFilePath("audio.mp3");
// 创建 Video 产品对象
Product* video = new Video();
video->setFilePath("video.mp4");
// 呼叫下载方法下载不同的产品
download(audio); // ✅ 正常
download(video); // ✅ 正常
对应的抽象与实现:
class Product {
public:
virtual ~Product() = default;
virtual void setFilePath(const std::string& path) { m_path = path; }
/**
* 此方法仅用于下载"可下载的产品"。
* 如果产品不可下载,则抛出异常。
*/
virtual void download() {
if (!canBeDownloaded())
throw std::logic_error("product can not be downloaded");
// … 真正下载 m_path 指向的资源
}
protected:
std::string m_path;
virtual bool canBeDownloaded() const { return true; }
};
class Audio : public Product { /* 音频下载逻辑 */ };
class Video : public Product { /* 视频下载逻辑 */ };
反面示例:不兼容 LSP
// ❌ 违反 LSP
class Chocolate : public Product { // ← 错误从这个继承决定开始
public:
// 收到什么路径都无视 —— 前置条件被"作废"了
void setFilePath(const std::string&) override {
m_path = "Chocolate can not be downloaded.";
}
// 基类契约说"不可下载则抛异常",但它连"可下载"的情况都不存在
void download() override {
throw std::logic_error("Chocolate can not be downloaded.");
}
};
// 客户端代码
Product* chocolate = new Chocolate();
chocolate->setFilePath("Chocolate can not be downloaded.");
download(chocolate); // 💥 抛异常 —— 客户端措手不及
为什么这违反了 LSP?
调用方 download(Product*) 是在"以 T(Product)定义的程序 P"里工作的。它认为 Product 都能下载。把 Chocolate 塞进去,程序行为变了(抛异常)—— 这正是严格定义里说的"behavior of P is unchanged"被破坏了。
💬 人话版 Chocolate 让 download() 从"能下载"变成了"必定失败"。能力变弱了,就是违约。
TIP:现在的问题是谁应该对违反 LSP 负责?
-
是 download() 函数的创建者吗?
-
是产品类的创造者吗?
-
还是巧克力类的创造者?
分析:
有人可能会说是 download() 函数的创建者。
因为 Chocolate 和 Product 之间存在 IS-A 关系。
download() 函数的创建者有权做出这样的假设:download() 函数仅用于维护可下载的产品。
另一方面,总的来说,巧克力类的创造者没有违反 LSP —— 巧克力确实不能下载,这个事实没错。
但是,是谁从产品类扩展了巧克力类?
请注意,Product 类的 download() 方法的文档块,它表示此方法将仅用于下载可下载的产品,如果产品不可下载,则抛出异常。
如果作者需要不同的下载逻辑,那么他/她可以在子类中做,或实现全新的逻辑。
但是,如果作者实现的内容少于或多于基类的 doc 块所说的内容,那么这样做就违反了 LSP。
💬 人话版(责任归属)
-
download(Product*) 的作者没错。他读了 Product 的文档,文档白纸黑字写着"仅下载可下载的产品"。他有权这么假设。
-
Chocolate 的作者也没错。巧克力不能下载,这是客观事实。
-
错的是"让 Chocolate 继承 Product"这个决定。
巧克力不是一种"(可下载的)产品"。这是一个 IS-A 关系判断失误。
✅ 正确做法:把职责拆开,让继承关系回到真实的语义上。
class Downloadable { public: virtual void download() = 0; }; // 可下载的
class Deliverable { public: virtual void deliver() = 0; }; // 可配送的
class Audio : public Downloadable { /* … */ };
class Video : public Downloadable { /* … */ };
class Chocolate : public Deliverable { /* 巧克力走配送,不走下载 */ };
🔑 一句话 文档块(契约)就是合同。子类做的比合同少或多,都算违约。
TIP:常见的 LSP 违规
① 子类中的退化方法
如果基类有一个方法,但基类的子类不需要该方法,那么如果子类的作者再次退化该方法,这将是可替代的违规。
class Bird {
public:
virtual void fly() { /* 拍翅膀飞 */ }
};
class Ostrich : public Bird { // ❌ 鸵鸟是鸟,但不会飞
public:
void fly() override {
throw std::logic_error("ostrich can not fly"); // 退化实现
// 或者写成空函数体 —— 同样违规,而且更隐蔽
}
};
② 从子类抛出异常
LSP 违规的另一种形式是向子类添加异常,而基类不希望这样。因为那时基类不能被子类替代。
class FileLoader {
public:
virtual std::string read(const std::string& path); // 契约:读不到返回空串,不抛异常
};
class NetworkFileLoader : public FileLoader { // ❌ 凭空多出异常
public:
std::string read(const std::string& path) override {
throw std::runtime_error("network unreachable"); // 基类契约里没这条
}
};
C++ 视角的补充:
| 基类析构函数非 virtual | delete basePtr 只析构基类部分,派生类资源泄漏 | 最隐蔽的一种 LSP 违规 |
| 子类把 public 方法改 private | C++ 允许收紧访问权限(Java 不允许编译) | 父类说"你能叫这个服务",子类说"不给你叫" |
| 前置条件收紧 | 父类接受任意路径,子类要求必须是 .mp3 | 要求变多了 |
| 后置条件放松 | 父类保证返回非空,子类可能返回空 | 保证变少了 |
| 改变父类的语义 | Circle 继承 Ellipse,但 setWidth 会同时改高 | 长得像 ≠ IS-A |
💬 圆-椭圆问题 数学上"圆是椭圆的一种",但代码里 Ellipse 有 setWidth / setHeight 两个独立方法,而 Circle 必须让两者相等 —— 调用方拿到 Ellipse* 后调 setWidth(5) 再调 setHeight(3),期望得到一个 5×3 的椭圆,结果 Circle 给不了。 这就是最经典的 LSP 悖论:数学上的 IS-A,不等于代码契约上的 IS-A。
1.3.4 依赖倒置原则 DIP
如果说开闭原则是面向对象设计的"目标"的话,那么依赖倒置原则(Dependence Inversion Principle, DIP)就是面向对象设计的"主要实现机制"之一,它是系统抽象化的具体实现。
依赖倒置原则是 Robert C. Martin(Bob 大叔)在 1996 年为 "C++ Reporter" 所写的专栏 Engineering Notebook 的第三篇,后来加入到他在 2002 年出版的经典著作 Agile Software Development, Principles, Patterns, and Practices 一书中。
定义如下:
High-level modules should not import anything from low-level modules. Both should depend on abstractions. Abstractions should not depend on details. Details should depend on abstractions.
高层模块不应该从低层模块导入任何东西,两者都应该依赖于抽象。抽象不应该依赖于细节,细节应当依赖于抽象。
可能有点不是令人理解,另一句广为流传的表述:
Program to an interface, not an implementation.
即:针对接口编程,而不是针对实现编程。
💬 人话版 先解释"倒置"倒的是什么。
传统写法(不倒置): 业务层说"我需要一个 XML 转换器",于是 #include "XMLConvert.h",直接 new XMLConvert()。 依赖箭头是:业务层 ──→ 具体实现。业务层被具体实现"锁死"了。
倒置写法: 业务层说"我需要一个转换器",于是依赖 DataConvert 抽象。 依赖箭头变成:业务层 ──> DataConvert <── XMLConvert。 具体实现反过来依赖抽象 —— 箭头被"倒"过来了。
好处: 业务层的代码里,永远不出现任何一个具体类的名字。换实现、加实现,业务层一个字都不用改,甚至不用重新编译。
也许可能还是有点抽象,没事我们先记住概念,等会看代码和类图。
落地要求
依赖倒置原则要求我们在程序代码中传递参数时或在关联关系中,尽量引用层次高的抽象层类,即:
-
使用接口和抽象类进行变量类型声明、参数类型声明、方法返回类型声明,以及数据类型的转换等;
-
而不要用具体类来做这些事情。
为了确保该原则的应用,一个具体类应当只实现接口或抽象类中声明过的方法,而不要给出多余的方法,否则将无法调用到在子类中增加的新方法。
在引入抽象层后,系统将具有很好的灵活性。在程序中尽量使用抽象层进行编程,而将具体类写在配置文件中。这样一来,如果系统行为发生变化,只需要对抽象层进行扩展,并修改配置文件,而无须修改原有系统的源代码,在不修改的情况下来扩展系统的功能,满足开闭原则的要求。
依赖注入(Dependency Injection, DI)
在实现依赖倒置原则时,我们需要针对抽象层编程,而将具体类的对象通过依赖注入的方式注入到其他对象中。
依赖注入是指:当一个对象要与其他对象发生依赖关系时,通过抽象来注入所依赖的对象。
常用的注入方式有三种:
| 构造注入 | 通过构造函数传入具体类对象 | 对象一旦造好就处于"完整可用"状态,不可变,线程安全友好 | 依赖多时构造函数参数会很长 |
| 设值注入(Setter 注入) | 通过 Setter 方法传入具体类对象 | 灵活,可随时替换 | 对象可能处于"半成品"状态,用之前必须先设好 |
| 接口注入 | 通过在接口中声明的业务方法来传入具体类对象 | 语义明确 | 需要额外定义注入接口,侵入性较强 |
这些方法在定义时使用的是抽象类型,在运行时再传入具体类型的对象,由子类对象来覆盖父类对象。
💬 人话版 "依赖倒置"是设计思想,"依赖注入"是把它落地的具体手法。 思路就是:我不主动去 new 我要用的东西,而是让别人从外面"送"进来。
生活类比:你要喝咖啡。
-
不倒置:你自己在办公室里装了台烘焙机、磨豆机、意式机(业务层直接依赖全部细节)。
-
倒置 + 注入:你只说"我要一杯咖啡"(依赖抽象 Coffee),楼下咖啡店把成品送上来(外部注入具体实现)。明天换成奶茶店,你改的只是"下单对象",你的办公室布局一点没变。
反例:DataBiz 针对具体实现编程
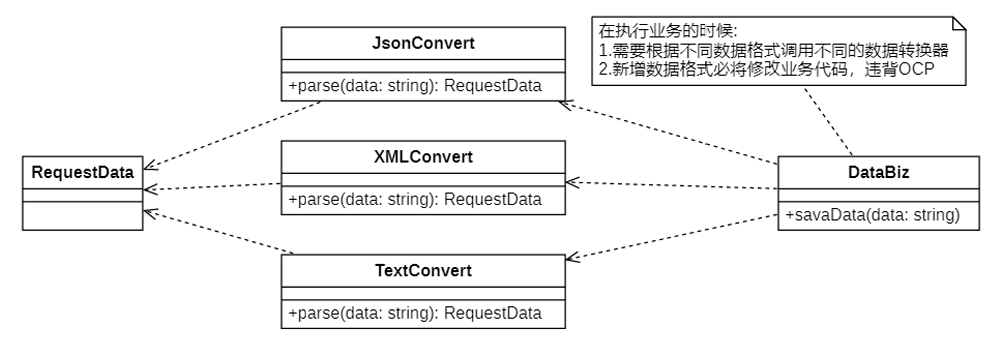
// ❌ 违反 DIP:高层业务直接依赖低层实现
class DataBiz {
public:
void doWork(const std::string& data) {
XMLConvert convert; // ← 硬编码具体实现
// JSONConvert convert; // 改成 JSON 就得改源码、重新编译
std::string result = convert.convert(data);
// … 业务处理
}
};
上面示例中 DataBiz 是典型的针对具体实现进行编程,因此在数据格式变更的时候就需要反复地修改代码。
重构:抽象 + 依赖注入 + 配置文件
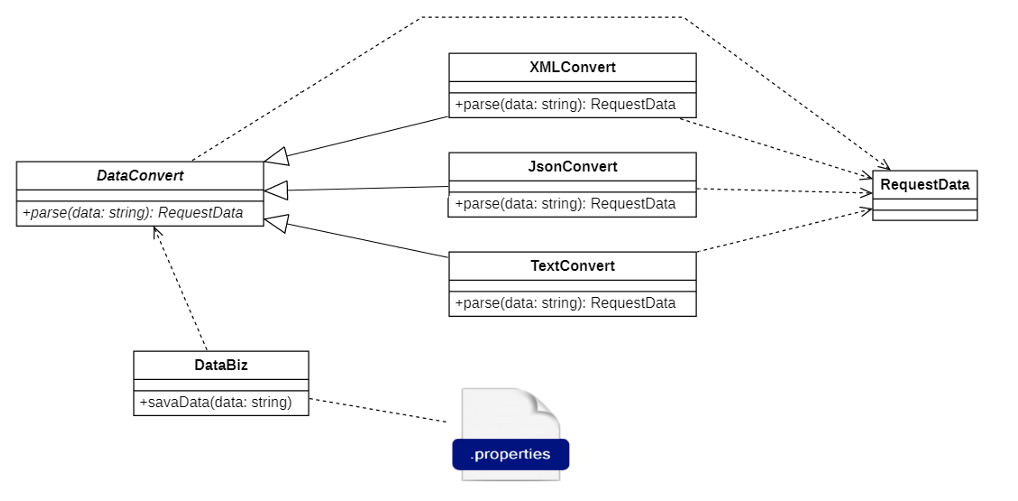
// ── 抽象层:高层与低层共同依赖的东西 ─────────────────
class DataConvert {
public:
virtual ~DataConvert() = default;
virtual std::string convert(const std::string& data) = 0;
};
// ── 低层实现:依赖抽象 ─────────────────────────────
class XMLConvert : public DataConvert {
public:
std::string convert(const std::string& data) override { /* XML 转换 */ return {}; }
};
class JSONConvert : public DataConvert {
public:
std::string convert(const std::string& data) override { /* JSON 转换 */ return {}; }
};
// ── 高层业务:只认识抽象 ───────────────────────────
class DataBiz {
DataConvert* m_convert;
public:
explicit DataBiz(DataConvert* convert) : m_convert(convert) {} // 构造注入
void setConvert(DataConvert* convert) { m_convert = convert; } // 设值注入
void doWork(const std::string& data) {
std::string result = m_convert->convert(data); // 只调抽象方法
// … 业务处理
}
};
配置驱动:
convert.class = JSONConvert
// 运行时 + 配置文件决定用哪个具体实现(配合工厂/反射)
DataConvert* convert = ClassHelper::createFromConfig("convert.class");
DataBiz biz(convert);
biz.doWork(payload);
基于依赖倒置原则,新增一个抽象的转换器 DataConvert,DataBiz 针对 DataConvert 进行编程;然后根据里氏替换原则,程序运行时对父类进行替换;根据开闭原则,将运行对象指定设置到配置文件中。
🔑 三大原则的协作关系
在上述重构过程中,我们使用了开闭原则、里氏代换原则和依赖倒转原则。在大多数情况下,这三个设计原则会同时出现:
| 开闭原则 | 目标 —— 我们要"不修改就能扩展" |
| 里氏代换原则 | 基础 —— 保证子类能安全替换父类,多态才成立 |
| 依赖倒转原则 | 手段 —— 通过依赖抽象,达成上面的目标 |
它们相辅相成,相互补充,目标一致,只是分析问题时所站角度不同而已。
💬 人话版总结
-
开闭回答"要达成什么"
-
里氏回答"凭什么能替换"
-
依赖倒置回答"具体怎么做"
C++ 视角的关键收益
// 重构前:DataBiz.cpp
// 重构后:DataBiz.cpp
编译期依赖方向变了 —— 这才是 DIP 在 C++ 这类编译型语言里的最大价值:减少重编译范围,缩短构建时间,同时让模块可以被单独测试(注入 Mock 实现)。
1.3.5 接口隔离原则 ISP
接口隔离原则(Interface Segregation Principle, ISP),其定义如下:
Clients should not be forced to depend upon interfaces that they do not use.
客户端不应该依赖那些它不需要的接口。
根据接口隔离原则,当一个接口太大时,我们需要将它分割成一些更细小的接口,使用该接口的客户端仅需知道与之相关的方法即可。
每一个接口应该承担一种相对独立的角色,不干不该干的事,该干的事都要干。
💬 人话版 接口好比餐厅的菜单。如果一张菜单上有 200 道菜,而你只想喝杯水,你却得把整张菜单从头看到尾 —— 这不合理。 更好的做法是拆成"早餐单""午市单""饮品单"。
判断依据不是"接口大不大",而是:有没有哪个实现类/调用方,被迫面对它根本不用的方法?
"接口"的两种不同含义
| 逻辑抽象 | 一个类型所具有的方法特征的集合,仅仅是一种逻辑上的抽象 | 可以理解成一种角色。一个接口只能代表一种角色,此时也可以称之为"角色隔离原则" |
| 语言级接口 | 某种语言具体的 "interface" 定义,有严格的定义和结构(如 Java 中的 interface) | 接口仅仅提供客户端需要的行为,客户端不需要的行为则隐藏起来。应当为客户端提供尽可能小的单独的接口,而不要提供大的总接口 |
💬 人话版(C++ 视角) C++ 没有 interface 关键字,我们用的是只有纯虚函数的抽象类。 所以"接口隔离"在 C++ 里更需要注意 —— 因为一个抽象类很容易被顺手加上数据成员和实现,逐渐"变质"成大杂烩。
反例:一个包办所有的胖接口
// ❌ 违反 ISP:胖接口(Fat Interface)
class IUserService {
public:
virtual ~IUserService() = default;
// 认证相关
virtual bool login(const std::string& user, const std::string& pwd) = 0;
virtual void logout() = 0;
virtual void registerUser(const User& user) = 0;
// 查询相关
virtual User queryById(int id) = 0;
virtual std::vector<User> queryAll() = 0;
// 数据导入导出
virtual void exportExcel(const std::string& file) = 0;
virtual void importExcel(const std::string& file) = 0;
// 通知相关
virtual void sendSms(const std::string& phone) = 0;
virtual void sendEmail(const std::string& addr) = 0;
};
后果:
// 我只想做一个"用户查询服务",却被迫实现 10 个方法
class UserQueryServiceImpl : public IUserService {
public:
User queryById(int id) override { /* 真正想做的事 */ }
std::vector<User> queryAll() override { /* 真正想做的事 */ }
bool login(const std::string&, const std::string&) override {
throw std::logic_error("not supported"); // ❌ 被迫写空实现/抛异常
}
void exportExcel(const std::string&) override {
throw std::logic_error("not supported"); // ❌ 顺带违反了 LSP
}
// … 还有 6 个
};
⚠️ 注意这里的连锁反应 被迫实现的空方法/抛异常方法,同时违反了里氏替换原则(1.3.3 里的"子类中的退化方法")。 这就是为什么 SOLID 五条原则经常需要一起看。
重构后:按角色拆分成小接口
// ✅ 按"角色"拆分,每个接口只服务一类客户端
class IAuthService { // 认证角色
public:
virtual ~IAuthService() = default;
virtual bool login(const std::string& user, const std::string& pwd) = 0;
virtual void logout() = 0;
virtual void registerUser(const User& user) = 0;
};
class IUserQueryService { // 查询角色
public:
virtual ~IUserQueryService() = default;
virtual User queryById(int id) = 0;
virtual std::vector<User> queryAll() = 0;
};
class IUserDataService { // 数据导入导出角色
public:
virtual ~IUserDataService() = default;
virtual void exportExcel(const std::string& file) = 0;
virtual void importExcel(const std::string& file) = 0;
};
class INotifyService { // 通知角色
public:
virtual ~INotifyService() = default;
virtual void sendSms(const std::string& phone) = 0;
virtual void sendEmail(const std::string& addr) = 0;
};
现在:
// 只依赖需要的接口,方法一个不多、一个不少
class UserQueryServiceImpl : public IUserQueryService {
public:
User queryById(int id) override { /* … */ }
std::vector<User> queryAll() override { /* … */ }
};
// 需要组合能力时,用多继承"按需拼装",而不是被一个胖接口绑死
class FullUserService : public IAuthService,
public IUserQueryService,
public INotifyService {
// …
};
⚠️ 使用接口隔离原则时的注意事项
控制接口的粒度:
-
接口不能太小 —— 如果太小会导致系统中接口泛滥,不利于维护;
-
接口也不能太大 —— 太大的接口将违背接口隔离原则,灵活性较差,使用起来很不方便。
一般而言,接口中仅包含为某一类用户定制的方法即可,不应该强迫客户依赖于那些它们不用的方法。
💬 人话版 拆接口和拆类一样,没有绝对标准。判断依据是"有没有客户端被迫面对它不用的东西",而不是"接口里方法超过 N 个就该拆"。 拆过头,你会得到 50 个只有一个方法的接口 —— 那是另一种灾难。
1.4 组合复用原则 CRP
组合复用原则(Composite Reuse Principle, CRP)又称为组合/聚合复用原则(Composition/Aggregate Reuse Principle, CARP),其定义如下:
Favor composition of objects over inheritance as reuse mechanism.
优先使用对象的组合,而不是使用继承来达到复用的目的。
在面向对象设计中,可以通过两种方法在不同的环境中复用已有的设计和实现,即通过组合/聚合关系或通过继承,但首先应该考虑使用组合/聚合。
💬 人话版 这句话听起来像"组合比继承好",但它真正的意思是: 继承是"最紧"的一种耦合,所以要用在最确定的地方;组合是"松"的,适合用在会变的地方。 不是禁止继承,而是把继承降级为"备选项",而不是"默认项"。
为什么优先组合?
① 通过继承来进行复用的主要问题:
继承复用会破坏系统的封装性,因为继承会将基类的实现细节暴露给子类。由于基类的内部细节通常对子类来说是可见的,所以这种复用又称 "白箱"复用。
-
如果基类发生改变,那么子类的实现也不得不发生改变;
-
从基类继承而来的实现是静态的,不可能在运行时发生改变,没有足够的灵活性;
-
而且继承只能在有限的环境中使用(如类没有声明为不能被继承)。
② 组合/聚合复用的优势:
由于组合或聚合关系可以将已有的对象(也可称为成员对象)纳入到新对象中,使之成为新对象的一部分,因此新对象可以调用已有对象的功能。
-
这样做可以使得成员对象的内部实现细节对于新对象不可见,所以这种复用又称为 "黑箱"复用;
-
相对继承关系而言,其耦合度相对较低,成员对象的变化对新对象的影响不大;
-
可以在新对象中根据实际需要有选择性地调用成员对象的操作;
-
组合复用可以在运行时动态进行,新对象可以动态地引用与成员对象类型相同的其他对象。
白箱复用 vs 黑箱复用
| 封装性 | ❌ 破坏 —— 基类实现细节对子类可见 | ✅ 保持 —— 只通过公开接口交互 |
| 耦合度 | 高(编译期强耦合) | 低(可面向抽象) |
| 复用时机 | 静态,编译期确定 | 动态,运行时确定 |
| 复用范围 | 全部继承(不能只挑一部分) | 有选择性地只调用需要的操作 |
| 基类/成员变化影响 | 基类改动 → 子类可能被迫改动 | 成员对象变化影响小 |
| 灵活性 | 低 | 高 |
💬 人话版
-
继承是"生下来就定了" —— 你是这种船,你这辈子就是这种船。
-
组合是"出门前再挑" —— 我今天装蒸汽机,明天装核动力。
还有一句关键区别:继承是"全部拿走",组合是"按需取用"。 你继承一个基类,就得连它那些你根本用不上的方法一起继承过来;而组合一个对象,你可以只用它的一个方法。
一般而言的判断标准
如果两个类之间是 "Has-A" 的关系应使用组合或聚合,如果是 "Is-A" 关系可使用继承。
💬 人话版
-
Is-A(是一个):狗 是 动物 → 可以用继承
-
Has-A(有一个):汽车 有 发动机 → 必须用组合
但注意:即使是 Is-A,也要满足 1.3.3 的里氏替换原则,才能用继承。 (圆是椭圆吗?数学上是,代码契约上不是 —— 那就别继承。)
案例:多维度扩展导致的子类爆炸
在几个维度上扩展一个类(货物类型 × 发动机类型 × 导航类型)可能会导致子类的组合爆炸。
// ❌ 用继承去覆盖多个独立的"变化维度"
class Ship { /* … */ };
// 维度一:货物类型
class CargoShip : public Ship {};
class TankerShip : public Ship {};
// 维度二:发动机类型 —— 每个货物类型都要再分叉
class CargoShipSteam : public CargoShip {};
class CargoShipNuclear : public CargoShip {};
// 维度三:导航类型 —— 又要再分叉
class CargoShipSteamGPS : public CargoShipSteam {};
class CargoShipSteamStarChart : public CargoShipSteam {};
// … 组合数继续增长
如您所见,每增加一个参数都会增加子类的数量。子类之间有很多重复的代码,因为一个子类不能同时继承两个类。
子类数量 = 各维度取值数之积:
2(货物:普通 / 危险) × 2(发动机:蒸汽 / 核) × 2(导航:GPS / 星图) = 8 个子类
再加一个"船体材质"维度(钢 / 木) → 16 个
再加一个"涂装"维度(3 种) → 48 个
这不是线性增长,是乘法增长。
💬 人话版 想象你要买一件衣服:领型 × 袖长 × 颜色 × 材质。 如果每个组合都要单独生产一款 —— 那工厂得开多少条产线? 现实中的做法是:你挑一个领子,挑一个袖子,挑一种颜色,现场拼起来。
重构:用组合替代多维继承
// ── 维度一:货物类型 ────────────────────────
class Cargo {
public:
virtual ~Cargo() = default;
virtual int riskLevel() const = 0;
};
class NormalCargo : public Cargo { public: int riskLevel() const override { return 0; } };
class DangerousCargo : public Cargo { public: int riskLevel() const override { return 5; } };
// ── 维度二:发动机类型 ──────────────────────
class Engine {
public:
virtual ~Engine() = default;
virtual void start() = 0;
};
class SteamEngine : public Engine { public: void start() override { /* … */ } };
class NuclearEngine : public Engine { public: void start() override { /* … */ } };
// ── 维度三:导航类型 ────────────────────────
class Navigation {
public:
virtual ~Navigation() = default;
virtual void navigate() = 0;
};
class GPS : public Navigation { public: void navigate() override { /* … */ } };
class StarChart : public Navigation { public: void navigate() override { /* … */ } };
// ── 组合:一个类写一次,维度随便拼 ─────────────
class Ship {
Cargo* m_cargo; // Has-A
Engine* m_engine; // Has-A
Navigation* m_nav; // Has-A
public:
Ship(Cargo* cargo, Engine* engine, Navigation* nav)
: m_cargo(cargo), m_engine(engine), m_nav(nav) {}
void sail() {
m_engine->start();
m_nav->navigate();
}
// ★ 运行时动态替换 —— 继承做不到这一点
void replaceEngine(Engine* engine) { m_engine = engine; }
};
效果对比:
| 类数量 | 2 × 2 × 2 = 8 个(还会继续翻倍) | 2 + 2 + 2 + 1 = 7 个(线性增长) |
| 加一个维度(船体材质,2 种) | 8 → 16 个类 | +2 个类 |
| 运行时换发动机 | ❌ 做不到 | ✅ replaceEngine() |
| 重复代码 | 大量(一个子类不能同时继承两个类) | 无 |
| 复用粒度 | 全部继承 | 按需调用 |
💬 人话版总结 继承复用是"复制一份并特化",组合复用是"持有并委托"。 当变化的维度超过一个时,继承会让类数量指数爆炸;组合让类数量线性增长。
C++ 视角的补充收益
// Ship.h —— 只前向声明,不 include 具体实现
class Engine; // 前向声明
class Navigation;
class Ship {
Engine* m_engine;
Navigation* m_nav;
public:
void sail();
};
// Ship.cpp —— 只有这里才 include 具体头文件
好处: 换一个发动机实现,Ship.h 不变,所有 #include "Ship.h" 的文件都不需要重新编译。
这在 C++ 里是实打实的构建时间收益 —— 而继承方案里,Ship.h 一改,全项目重编译。
⚠️ 但也别走极端 不是所有继承都该换成组合:
-
真正满足 IS-A 且满足 LSP 的场景,继承是更简洁、更符合直觉的表达;
-
需要多态替换(面向抽象编程)时,继承(或接口实现)仍然是必需的。
-
判断口诀:先用组合,实在不合适再继承;用继承,就必须守 LSP。
1.5 迪米特法则 LOD
迪米特法则(Law Of Demeter, LOD)来自于 1987 年美国东北大学(Northeastern University)一个名为 "Demeter" 的研究项目。
迪米特法则又称为最少知识原则(Least Knowledge Principle, LKP),也就是说,一个对象应当对其他对象有尽可能少的了解。
其定义有如下几种形式:
Each unit should have only limited knowledge about other units: only units "closely" related to the current unit.
每一个软件单位对其他单位尽可能少的了解,而且局限于哪些与本单位密切相关的软件。
Each unit should only talk to its friends; don't talk to strangers.
每个单位应该只和它的朋友们通信,不与陌生人通信。
Talk only to your immediate friends.
只和直接的朋友通信。
💬 人话版 一句话:"别越级找人办事。"
你要办什么事,就跟你的直接对接人说,让他去安排。 不要"通过朋友认识了他朋友,然后绕过朋友直接找人家"。
因为一旦你越级,中间那个人换了、改了、甚至不存在了,你都要跟着改 —— 你被迫知道了太多不该知道的东西。
1.5.1 法则目标
如果一个系统符合迪米特法则,那么当其中某一个模块发生修改时,就会尽量少地影响其他模块,扩展会相对容易。
这是对软件实体之间通信的限制:迪米特法则要求限制软件实体之间通信的宽度和深度。
迪米特法则可降低系统的耦合度,使类与类之间保持松散的耦合关系。
💬 人话版
-
限制宽度:不跟无关的人说话(只跟该说的对象说)
-
限制深度:不跟"朋友的朋友"说话(不链式调用 a->getB()->getC()->doThing())
1.5.2 狭义的迪米特法则
迪米特法则要求我们在设计系统时,应该尽量减少对象之间的交互。如果两个对象之间不必彼此直接通信,那么这两个对象就不应当发生任何直接的相互作用。
如果其中的一个对象需要调用另一个对象的某一个方法的话,可以通过第三者转发这个调用。
简言之,就是通过引入一个合理的第三者来降低现有对象之间的耦合度。
对于一个对象,其直接朋友包括以下几类:
当前对象本身(this);
以参数形式传入到当前对象方法中的对象;
当前对象的成员对象;
如果当前对象的成员对象是一个集合,那么集合中的元素也都是朋友;
当前对象所创建的对象。
不是直接朋友的典型情况:只出现在方法体内部的类对象 —— 比如通过 a->getB()->getC() 拿到的 c,它不是你的朋友,它是"你朋友的朋友"。
💬 人话版(朋友清单) 你的"直接朋友"就是:你自己、你的成员、别人递给你的、你亲手造的、以及你成员集合里的元素。 除此之外都是陌生人 —— 尤其是那种"一层套一层取出来的对象"。
代码味道:如果你写出 order->getCustomer()->getAddress()->getCity(),这就是典型的"和陌生人说话"(也叫火车残骸 Train Wreck)。
⚠️ 缺点:
遵循类之间的迪米特法则会是一个系统的局部设计简化,因为每一个局部都不会和远距离的对象有直接的关联。 但是,这也会造成系统的不同模块之间的通信效率降低,也会使系统的不同模块之间不容易协调。
💬 人话版(代价) 为了"不越级",系统里会多出一堆只为转发而存在的方法(纯中转代码)。 这是用一点"啰嗦"换"低耦合" —— 大多数时候这笔买卖划算,但不要为了它把系统切得七零八落。
1.5.3 广义的迪米特法则
-
在类的结构设计上,每一个类都应当尽量降低其成员变量和成员函数的访问权限;
-
在类的设计上,只要有可能,一个类型应当设计成不变类;
-
在对其他类的引用上,一个对象对其他对象的引用应当降到最低。
💬 人话版 广义的 LOD 其实就是一句话:"能不给别人看的,就别给别人看。"
-
private 优先,protected 次之,public 是最后选择
-
能做成不可变的(所有成员 const / 构造后不可改),就做成不可变 —— 别人改不了,就不可能因为别人改而出 bug
-
持有别人的引用越少,被牵连的可能越小
1.5.4 案例
1.5.4.1 与直接朋友通信
问题场景(原讲义配图,此处用文字还原):
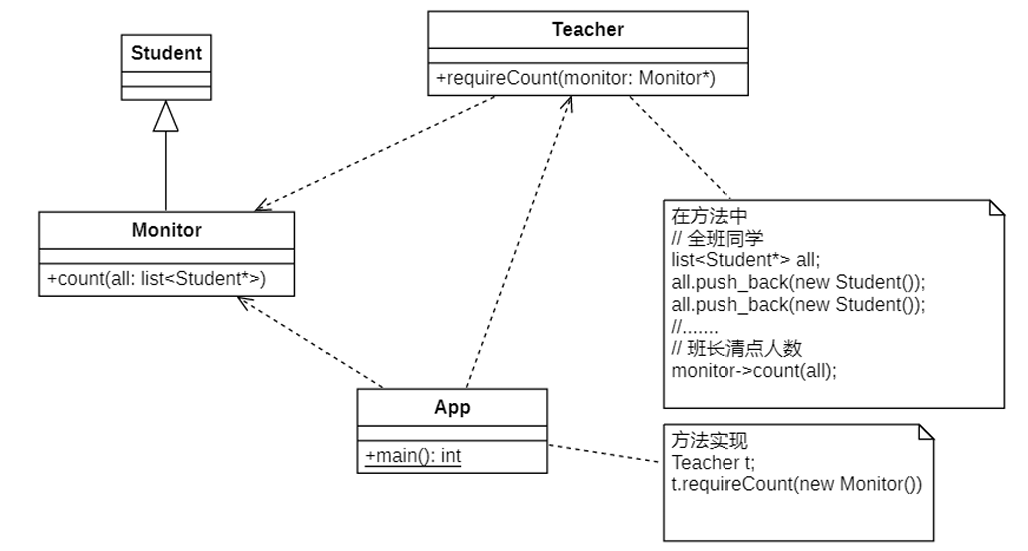
在 Teacher 中对非直接的朋友 Student 进行了通信,违背了迪米特法则。
// ❌ 违反 LOD:Teacher 直接和"陌生人" Student 通信
class Student {
public:
void study() { /* 学习 */ }
};
class Moniter { // Teacher 的成员对象(朋友)
std::vector<Student*> m_students;
public:
std::vector<Student*>& getStudents() { return m_students; }
};
class Teacher {
Moniter* m_moniter; // ✅ 是朋友
public:
void teach() {
// ⚠️ Student 是"朋友的朋友" —— 对 Teacher 来说是陌生人
for (Student* s : m_moniter->getStudents()) {
s->study(); // 🚨 越级调用
}
}
};
为什么要重构?
-
Moniter 的内部结构(用 vector 还是 list、要不要分页、有没有虚拟学生)一旦变化,Teacher 就得跟着改;
-
Teacher 被迫知道了 Moniter 的实现细节。
重构后:让 Moniter 转发
// ✅ 符合 LOD
class Moniter {
std::vector<Student*> m_students;
public:
// 把"让学生学习"这件事交给 Moniter 自己完成 —— 它才是 Student 的直接朋友
void studyAll() {
for (Student* s : m_students) {
s->study();
}
}
};
class Teacher {
Moniter* m_moniter;
public:
void teach() {
m_moniter->studyAll(); // ✅ 只和直接朋友说一句话
}
};
💬 人话版 老师要让学生学习,不需要自己一个个点名去叫 —— 跟班长说"让大家自习",班长去安排。 老师从此不需要知道班上有几个学生、用什么数据结构存的。
1.5.4.2 减少对朋友的了解
在一个类中,就是尽量减少一个类对外暴露的方法。
问题场景:
Human 需要调用许多 WashingMachine 提供的方法,
同时还有可能导致调用顺序错误,违背了迪米特法则。
// ❌ 违反 LOD:Human 需要知道洗衣机的全部操作步骤
class WashingMachine {
public:
void openLid();
void addWater();
void addClothes(const Clothes& c);
void wash();
void drain();
void spin();
void closeLid();
};
class Human {
WashingMachine* m_machine;
public:
void doLaundry(const Clothes& c) {
m_machine->openLid();
m_machine->addWater();
m_machine->addClothes(c); // ⚠️ 忘了这步?顺序搞错了?衣服白洗
m_machine->wash();
m_machine->drain();
m_machine->spin();
m_machine->closeLid();
}
};
问题:
Human 被迫知道洗衣机的全部 7 个内部步骤(知道的太多);
调用顺序错了会出问题("先放衣服再加水" vs "先加水再放衣服");
洗衣机内部流程一变(比如新增"漂洗"),所有调用方都要改。
重构后:只暴露一个"一键洗衣"
// ✅ 符合 LOD:只暴露客户端真正需要的行为
class WashingMachine {
private:
void openLid();
void addWater();
void addClothes(const Clothes& c);
void wash();
void drain();
void spin();
void closeLid();
public:
// ★ 唯一对外的方法:把复杂流程封装起来,顺序由机器自己保证
void washAll(const std::vector<Clothes>& clothes) {
openLid();
addWater();
for (const auto& c : clothes) addClothes(c);
wash();
drain();
spin();
closeLid();
}
};
class Human {
WashingMachine* m_machine;
public:
void doLaundry(const std::vector<Clothes>& clothes) {
m_machine->washAll(clothes); // ✅ 一句话搞定,与直接朋友通信
}
};
💬 人话版 你用微波炉,只需要按"开始",不需要知道高压变压器怎么工作。 洗衣机也一样 —— 人只需要会说"洗这一筐衣服",不需要背下来洗衣机的 7 步操作手册。
这也是门面模式(Facade)、外观模式的思想来源。
1.5.5 使用注意事项
-
在类的划分上,应当创建弱耦合的类,类与类之间的耦合越弱,就越有利于实现可复用的目标。
-
在类的结构设计上,每个类都应该降低成员的访问权限。
-
在类的设计上,只要有可能,一个类应当设计成不变的类。
-
在对其他类的引用上,一个对象对其他类的对象的引用应该降到最低。
-
尽量限制局部变量的有效范围,降低类的访问权限。
💬 人话版(一条实用检查清单)
| 成员访问权限 | 这个 public 真的是外面需要的吗?private 行不行? |
| 链式调用 | 有没有 a->getB()->getC()->doX()? |
| 成员引用数量 | 这个类持有了几个别的东西?能减少吗? |
| 局部变量作用域 | 这个变量真的需要活这么久吗? |
| 不可变性 | 这个类的字段能改成 const 吗? |
1.6 小结
面试/复习八问
1. 面向对象设计原则的目标是什么?
提高软件的可维护性和可复用性,实现可维护性的复用。
2. 什么是单一职责原则?
一个对象应该只包含单一的职责,并且该职责被完美地封装在一个类中。 (换个说法:一个类应该只有一个引起它变化的原因。)
3. 什么是开闭原则?
软件实体应对扩展开放,而对修改关闭。
4. 什么是里氏替换原则?
软件中所有引用基类(父类)的地方,必须能透明地使用其子类的对象。
5. 什么是依赖倒置原则?
高层模块不应该从低层模块导入任何东西,两者都应该依赖于抽象。抽象不应该依赖于细节,细节应当依赖于抽象。 即:针对接口编程,而不是针对实现编程。
6. 什么是接口隔离原则?
客户端不应该依赖哪些它不需要的接口。
7. 什么是组合复用原则?
优先使用对象的组合,而不是使用继承来达到复用的目的。
8. 什么是迪米特法则?
每一个软件单位对其他单位尽可能少的了解,而且局限于哪些与本单位密切相关的软件。
一句话记忆版
| SRP 单一职责 | 一个类只干一件事 | 类太胖,改一处牵动全身 |
| OCP 开闭 | 加功能不改老代码 | 每次需求变更都要动老代码 |
| LSP 里氏替换 | 子类必须能替换父类 | 多态用起来心里没底、运行时炸 |
| DIP 依赖倒置 | 依赖抽象,不依赖具体 | 换个实现要重编译半个项目 |
| ISP 接口隔离 | 接口要小而专 | 实现接口被迫写一堆空方法 |
| CRP 组合复用 | 优先组合,慎用继承 | 继承层次爆炸,类数量指数增长 |
| LOD 迪米特 | 只和直接朋友说话 | 越级调用,链式调用,耦合太深 |
原则之间的关系
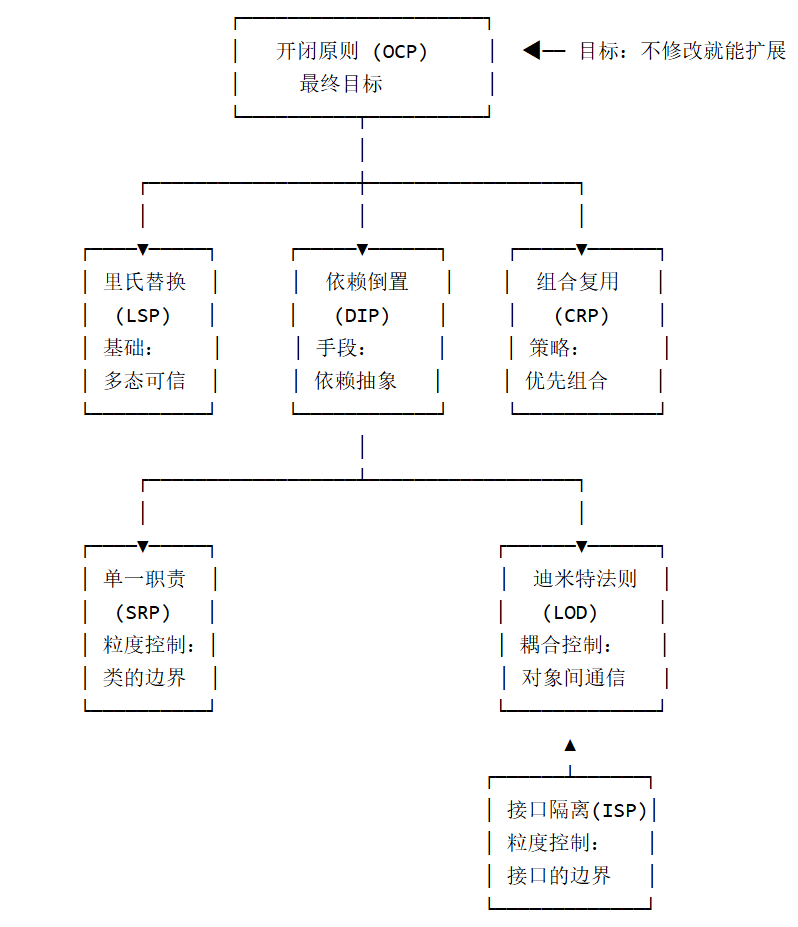
核心结论:
-
开闭原则是目标 —— 所有的原则最终都服务于"不修改就能扩展"
-
里氏替换是基础 —— 没有它,多态就是"碰运气"
-
依赖倒置是手段 —— 通过依赖抽象来达成开闭
-
SRP / ISP 是粒度控制 —— 决定"类该多大""接口该多大"
-
LOD 是耦合控制 —— 决定"对象之间怎么说话"
-
CRP 是复用策略 —— 决定"用继承还是组合来复用"
💬 最后的提醒 这些原则是"指导",不是"法律"。 它们会互相冲突(比如 SRP 拆得越细,类数量越多;LOD 越严格,转发代码越多)。 真正的功夫在于权衡:判断这个系统里"什么会变、什么不会变",然后在对的地方留出扩展点,在不对的地方保持简单。
过度设计和设计不足,都是失败。
附录:七大原则速查表(复习用)
| 1 | 单一职责原则 | Single Responsibility Principle | SRP | 一个对象应该只包含单一的职责,并且该职责被完美地封装在一个类中 | 一个类只有一个"改它的理由" |
| 2 | 开闭原则 | Open-Closed Principle | OCP | 软件实体应对扩展开放,而对修改关闭 | 加功能靠"新增",不靠"改老的" |
| 3 | 里氏替换原则 | Liskov Substitution Principle | LSP | 所有引用基类的地方必须能透明地使用其子类的对象 | 子类能顶替父类,且不出岔子 |
| 4 | 依赖倒置原则 | Dependence Inversion Principle | DIP | 高层模块不应依赖低层模块,两者都应依赖抽象;抽象不应依赖细节,细节应依赖抽象 | 别 new 具体的,让外面"送"进来 |
| 5 | 接口隔离原则 | Interface Segregation Principle | ISP | 客户端不应该依赖哪些它不需要的接口 | 接口小而专,别逼人实现空方法 |
| 6 | 组合复用原则 | Composite/Aggregate Reuse Principle | CRP / CARP | 优先使用对象的组合,而不是使用继承来达到复用的目的 | 能"装一个"就别"是一种" |
| 7 | 迪米特法则 | Law Of Demeter | LOD | 每一个软件单位对其他单位尽可能少的了解,而且局限于哪些与本单位密切相关的软件 | 只和直接朋友说话,别越级 |
结语
我相信中间还是有一些难理解的概念,多看几遍就好了,这一篇只是我们设计模式的基础,接下来我将带着大家把常见的23种设计模式一个一个走一遍。
我是YYYing,后面还有更精彩的内容,希望各位能多多关注支持一下主包。
无限进步,我们下次再见!
—⭐️封面自取⭐️—


评论前必须登录!
注册