 网硕互联帮助中心
码道 · 寻艺——从零构建"非遗交互式对话平台"的完整实践
用一行行代码,在数字世界里为千年技艺留一盏灯。
—— 记"寻艺 · 非遗交互式对话平台"的诞生
仓库地址:https://gitcode.com/Zch070214/FEIYI
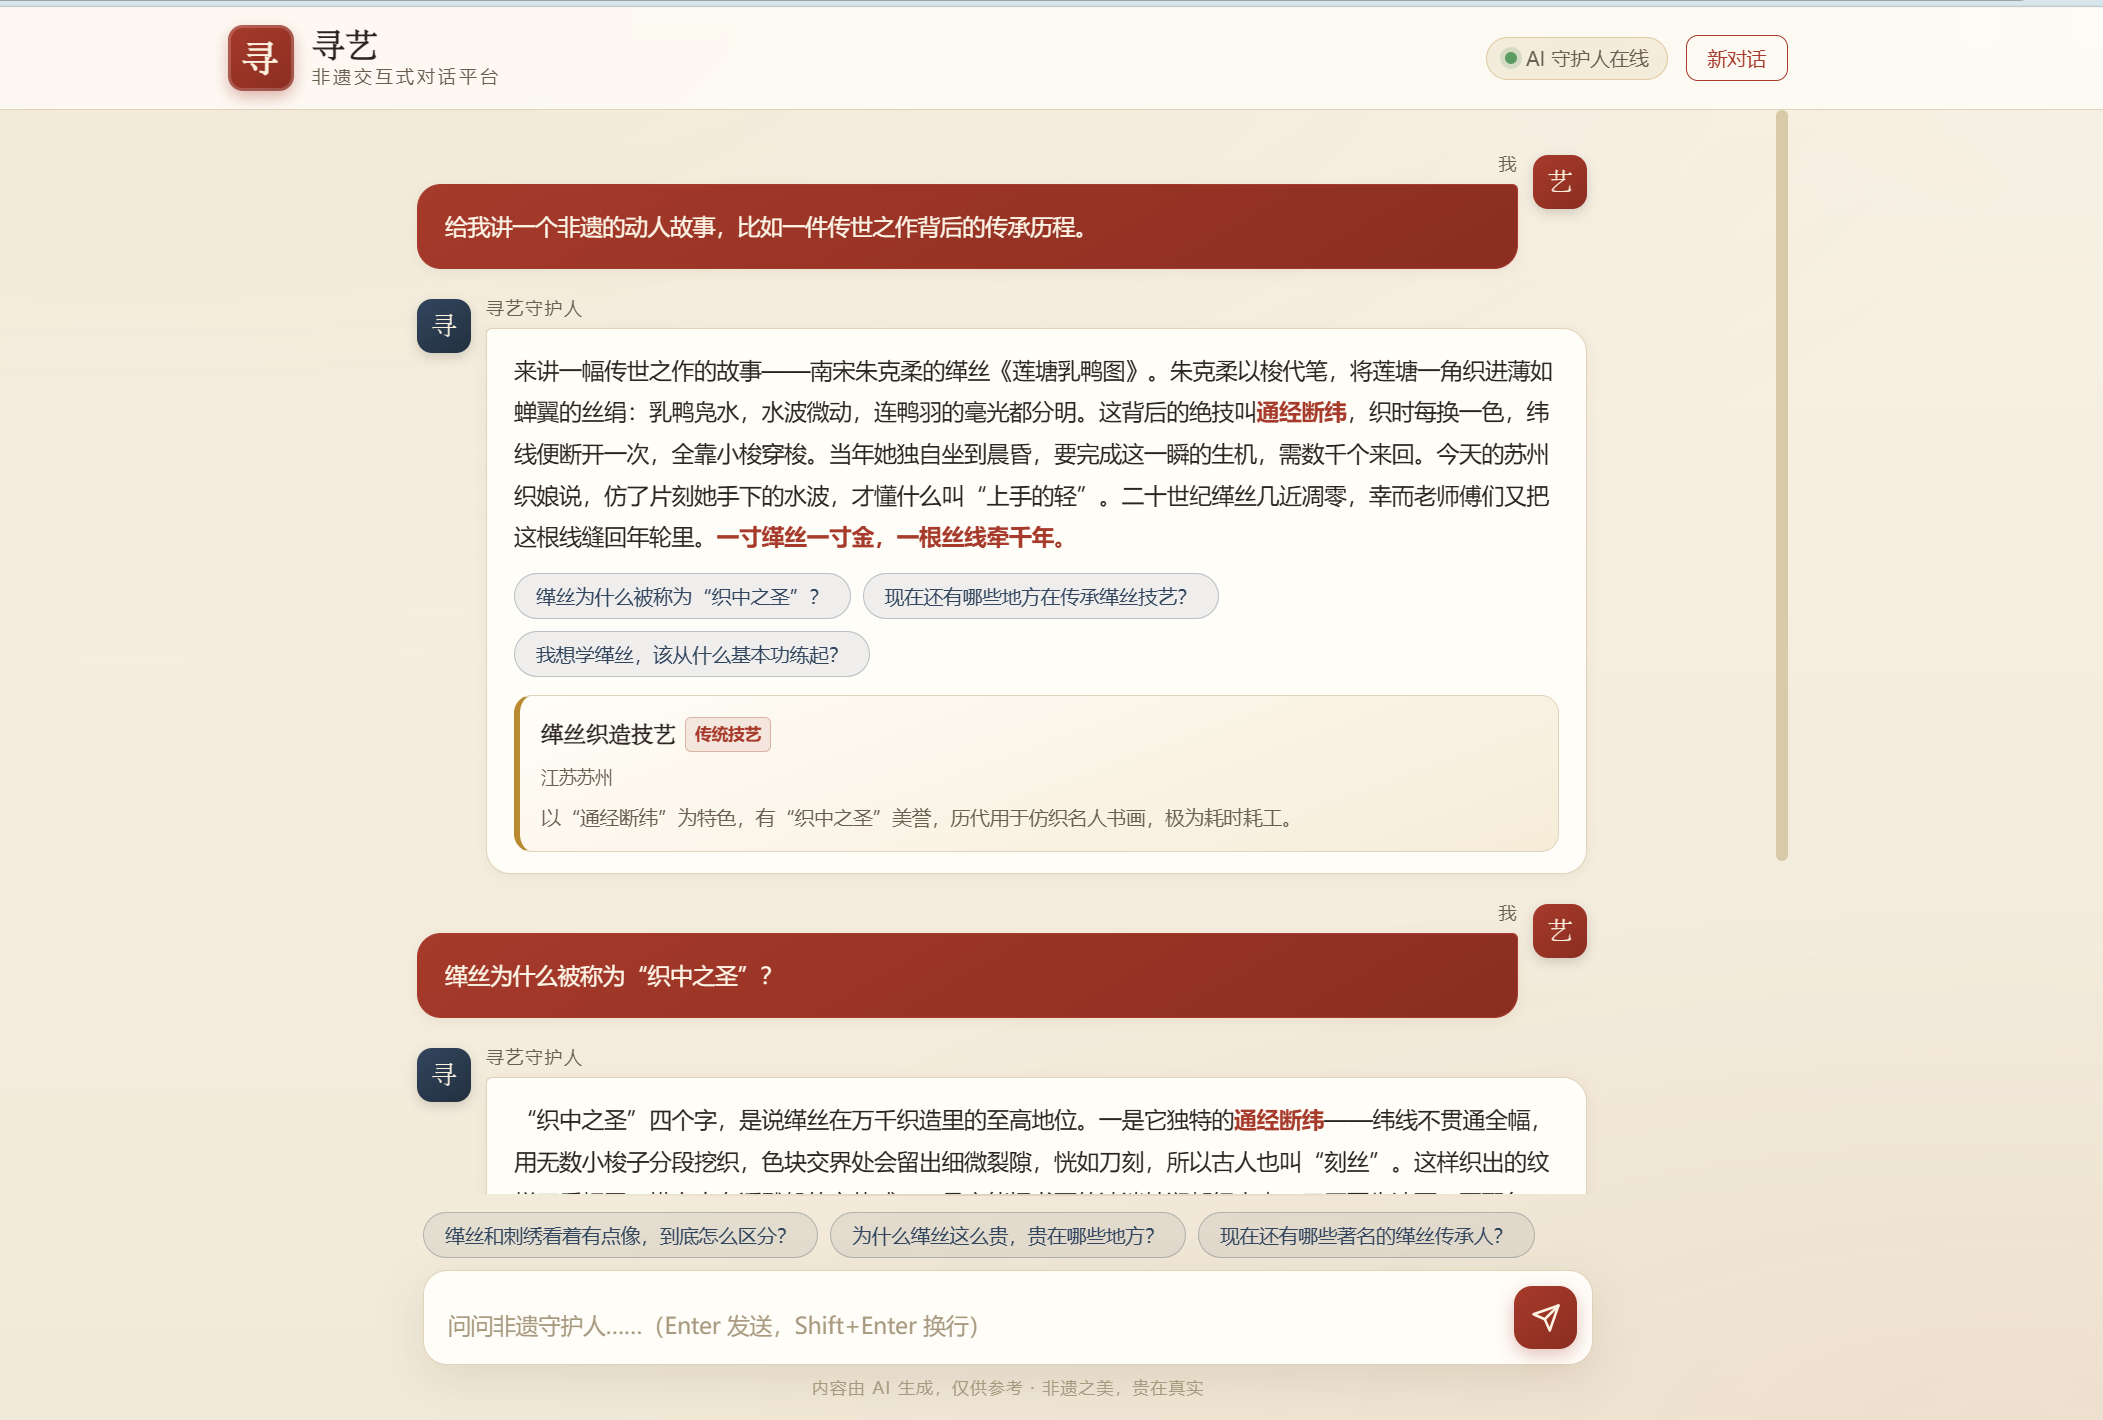
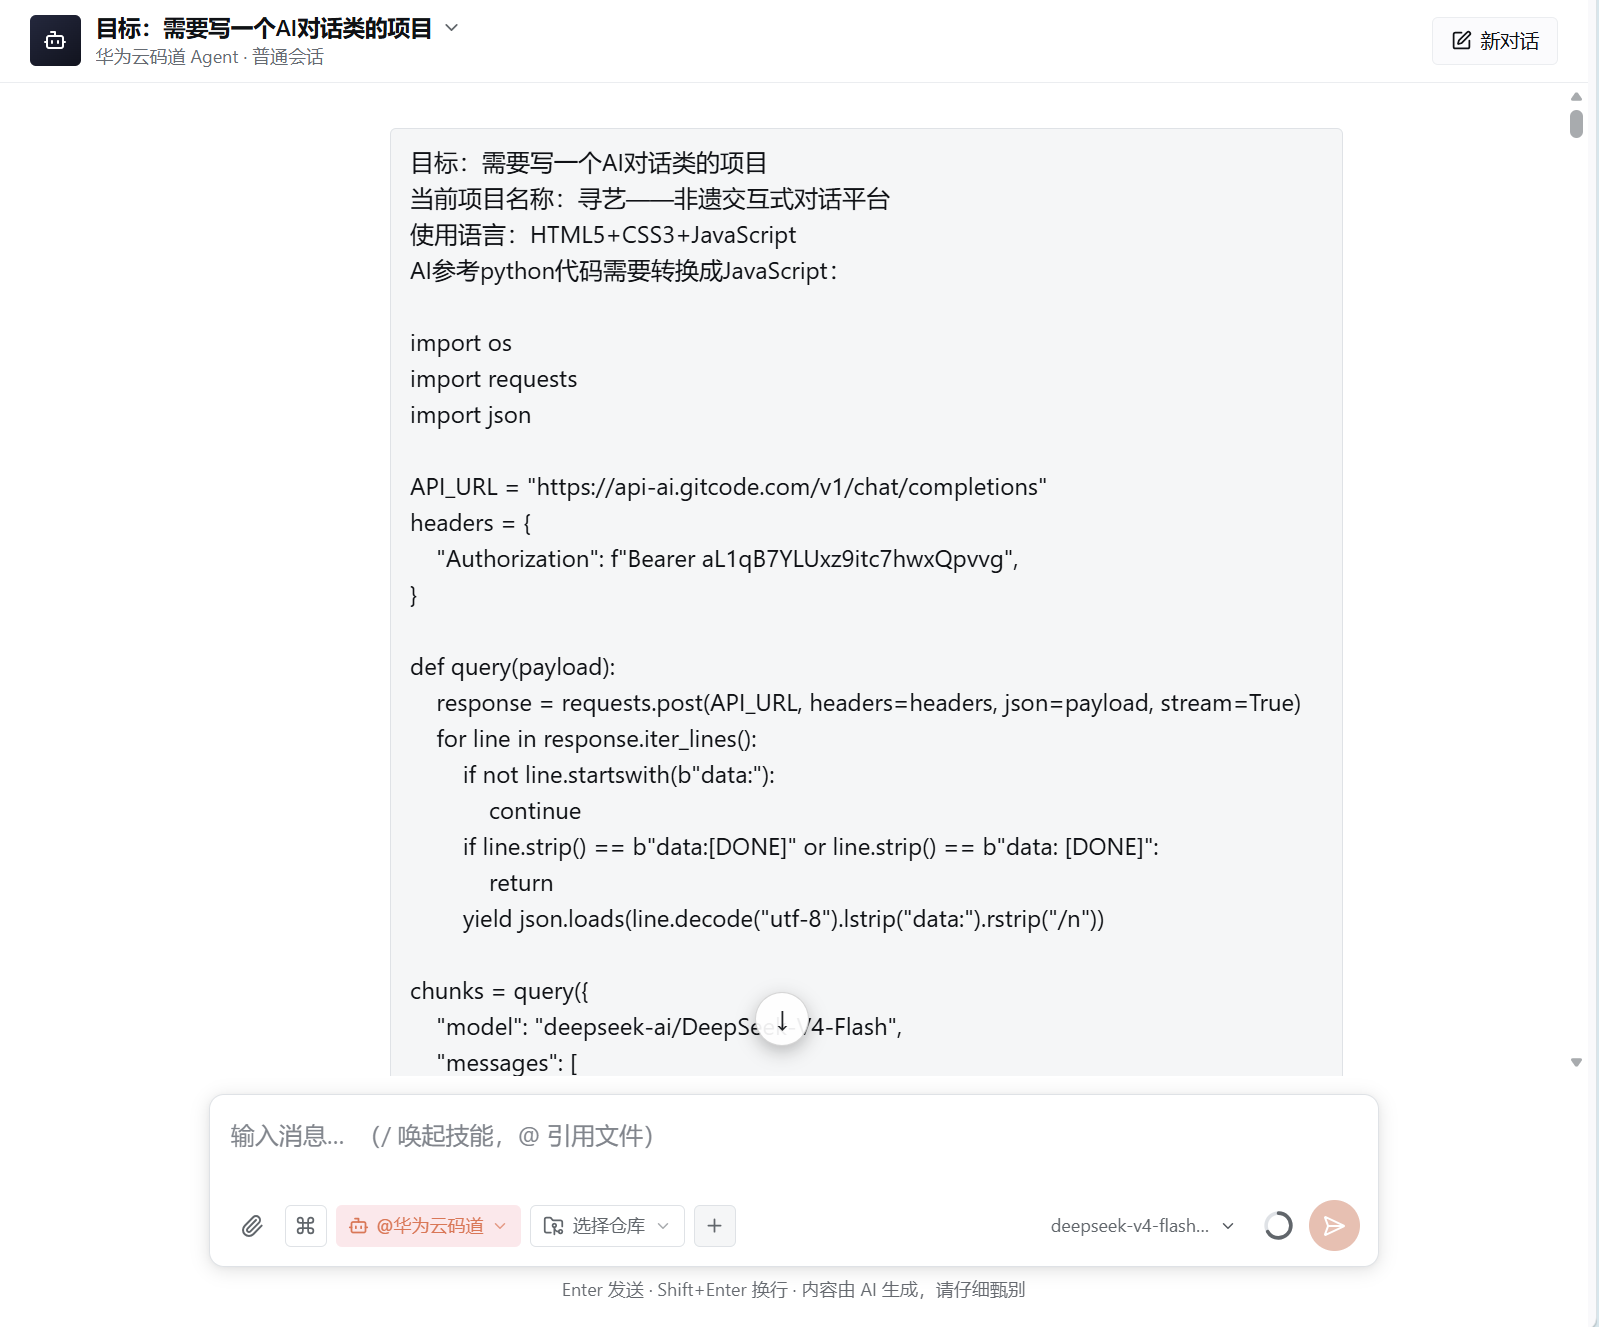
码道代码生成
一、写在前面:我们为什么要做这件事
中国非物质文化遗产浩如烟海。据文化和旅游部公布的数据,我国已有国家级非物质文化遗产代表性项目一千五百余项,涵盖民间文学、传统音乐、传统舞蹈、传统戏剧、曲艺、传统美术、传统技艺、传统医药、民俗等十大类别。然而在快节奏的现代生活中,这些承载着民族记忆的技艺,正面临着传承人老龄化、年轻人认知断层、传播渠道单一的困境。
"非遗"这个词,很多人听过,但说不出三样具体的项目;"苏绣"很美,但多数人不知道一根丝线可以劈成八十八分之一;“梁祝传说"人人耳熟能详,却少有人了解它在民间文学谱系中的位置。信息时代的悖论在于:知识前所未有的丰裕,注意力却前所未有地稀缺。非遗要"活"下去,首先要"被看见”。
而 AI 对话恰恰提供了这样一个入口:它天然是一个扁平的、无门槛的、一对一的交互界面。把 AI 塑造成一位"非遗守护人",让用户像和朋友聊天一样,问一个故事、听一段历史、学一门技艺——这正是本项目 “寻艺” 的初心:在码道之上,寻千年之艺。
二、项目定位与技术选型
2.1 定位:一个纯粹的、轻量的单页应用
在设计之初,我们明确了几个原则:
- 零门槛使用:无需安装、无需注册、打开即用;
- 零构建成本:不使用 React/Vue 等框架,不引入打包工具,保持项目极简,让人人都能读懂和维护;
- 开箱即用的智能:接入云端大模型 API,让"非遗守护人"具备真正的知识广度和对话温度;
- 结构化呈现:不满足于"打字机式"的纯文本回复,而是让 AI 返回结构化数据,前端渲染出卡片、按钮等丰富的交互形态。
最终技术栈定格为:HTML5 + CSS3 + 原生 JavaScript(ES6+)+ 云端 AI API。这份简单背后,是对"少即是多"的坚持——一个完整的对话产品,用三份 JS、一份 CSS 和一份 HTML 就能承载。
2.2 为什么是"流式"对话
传统的一次性请求(请求发出、等几秒、整段返回)存在两个体验问题:一是等待时间感知过长,二是无法看到"思考的过程",会让用户怀疑系统是否卡死。流式(Streaming)响应则像人在说话:一个字一个字地"打字"出来,先给用户即时的反馈,再逐步充实内容。
这在心理学上叫"感知性能优化"——用户体验到的响应时间,取决于第一帧内容的到达速度,而非全部内容的完成时间。因此本项目核心采用的正是 SSE(Server-Sent Events)协议的流式对话,这一点也决定了后续 JavaScript 改造方案的形态。
三、核心实现:从 Python 参考代码到 JavaScript
3.1 参考实现:一次"翻译"之旅
项目最初提供了一份 Python 参考代码,用于演示 API 的标准调用方式。其核心是一个生成器:
def query(payload):
response = requests.post(API_URL, headers=headers, json=payload, stream=True)
for line in response.iter_lines():
if not line.startswith(b"data:"):
continue
if line.strip() == b"data:[DONE]":
return
yield json.loads(line.decode("utf-8").lstrip("data:"))
这段代码短小精悍,却浓缩了流式对话的完整骨架:发起流式 POST 请求 → 逐行读取 → 过滤 data: 前缀 → 遇到 [DONE] 终止 → 逐条产出 JSON。而我们要做的,是把这套逻辑完整地移植到浏览器环境。浏览器没有 requests,却有同样强大的 fetch 与 ReadableStream。
3.2 JavaScript 改写:fetch + ReadableStream + TextDecoder
在浏览器端,fetch 的 response.body 返回一个 ReadableStream,我们可以通过 reader.read() 循环读取二进制块。这里有一个关键细节:网络数据是按块到达的,一个 JSON 对象可能被拆散在多个数据块里,甚至一个数据块里可能包含多行 SSE 数据。因此必须引入一个"缓冲区"(buffer)策略:
const reader = response.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
while (true) {
const { done, value } = await reader.read();
if (done) break;
buffer += decoder.decode(value, { stream: true });
const lines = buffer.split("\\n");
buffer = lines.pop(); // 末段可能是不完整行,留到下一轮拼接
for (const line of lines) {
if (!line.trim().startsWith("data:")) continue;
const data = line.trim().slice(5).trim();
if (data === "[DONE]") { /* 结束 */ }
const chunk = JSON.parse(data);
const delta = chunk.choices?.[0]?.delta?.content ?? "";
if (delta) onDelta(delta);
}
}
这里有三处容易被忽视的细节:
这一步"翻译",完成了从 requests 生态到 Web 平台的平滑迁移。
3.3 思考预算:thinking_budget 与推理内容
参考代码的 payload 里还包含一个特别的参数:thinking_budget: 2048。这类参数指示模型在回答前先进行一段"内部思考"(reasoning)。在返回的流中,思考过程会出现在 delta.reasoning_content 字段,而正式回答出现在 delta.content。
我们在前端对二者做了差异化处理:思考到达时,气泡显示"寻艺正在查阅古籍,梳理脉络……“的占位状态,营造"守护人正在沉吟"的仪式感;一旦正式内容开始输出,立即切换到流式打字效果。这样既保留了模型的思考质量,又不会让用户面对一大段无用的"内心独白”。
四、系统提示词:让 AI 输出程序认识的 JSON
4.1 为什么要求结构化输出
如果放任大模型自由发挥,回复可能是任意形态的文本:可能是散文、可能是列表、可能带 Markdown,也可能什么格式都没有。前端想在此基础上渲染"追问按钮"或"非遗卡片",就只能靠正则去猜,极易出错。
更好的做法是用系统提示词约定输出协议:告诉 AI"你必须只输出一个合法 JSON 对象",并给出明确的字段定义。这样 AI 的"说话"就和程序的"理解"对齐了——这正是当前大模型应用工程中的核心方法论:用自然语言定义接口契约(LLM-native API design)。
4.2 我们的 JSON 契约
我们最终定义的响应协议包含三个字段:
{
"reply": "回复正文,可含 Markdown,约 90~260 字,信息密度高",
"suggestions": ["追问示例1", "追问示例2", "追问示例3"],
"related": [{"name": "苏绣", "type": "传统美术", "region": "江苏苏州", "desc": "一句话简介"}]
}
- reply:真正的对话正文,允许适度使用 Markdown(加粗、列表、引用),前端渲染为富文本;
- suggestions:恰好三条推荐追问。它承担"对话引导"的职责——AI 不仅要回答问题,还要把对话引向深入。点击追问即可继续对话,形成对话闭环;
- related:涉及具体非遗项目时输出的"知识卡片"。包含项目名称、所属门类、地区与简介,前端渲染为卡片墙,把零散的回复沉淀为可浏览的知识单元。
4.3 角色设定的写作技巧
系统提示词的角色塑造,我们刻意融入了"人味":不要官方辞令式的"本助手为您解答",而是"你知识渊博而温和,说话如一位讲书人,亲切、有画面感、有温度";要求"善于用色彩、声音、触感构建画面";甚至规定了"每次回复尽量传达一点新知识或新视角"。同时我们也划了红线:“不编造非遗项目和传承人信息;不确定时坦诚说明,并给出查阅方向”。
实测效果令人惊喜:模型回答"苏绣的起源"时,会讲述浣纱女西施"以血染线绣芙蓉"的传说;回答"梁祝"时,会聚焦"十八相送"这个被常被略过的动人片段。好的角色设定,是把模型的"知识量"转化为"感染力"的关键。
五、前端增量解析:无损地从流中"捞出" JSON
5.1 难点:流式与 JSON 的天然冲突
流式响应是"边生成边传输"的,因此任意时刻我们手里的文本都是不完整的 JSON 片段。如果等全部传输完毕再解析,就丧失了流式即时渲染的意义;如果急于解析,又会被"半个对象"卡住。我们的目标是:一旦 JSON 在大括号层面闭合、可以被完整解析,就立即渲染,一秒也不用等。
5.2 方案:字符串感知的大括号配对扫描
最初的写法是 text.lastIndexOf("{") 拿最后一个左花括号作为起点去解析——但这在带缩进格式的多层 JSON 前会失效:related 数组里嵌套对象自身的 { 才是最后一个花括号,从它开始的子串根本不是合法 JSON(见下图示意)。
{
"reply": "…",
"suggestions": […],
"related": [ { "name": …, … } ] ← 最后一个 { 在这里,从它切片必失败
}
正确的解法是从头扫描、状态机式地统计花括号配对,同时跳过字符串字面量内的花括号:
function extractJsonObj(text) {
const start = text.indexOf("{");
if (start < 0) return null;
let depth = 0, inStr = false, escaped = false;
for (let i = start; i < text.length; i++) {
const ch = text[i];
if (inStr) {
if (escaped) escaped = false;
else if (ch === "\\\\") escaped = true;
else if (ch === '"') inStr = false;
continue;
}
if (ch === '"') { inStr = true; continue; }
if (ch === "{") depth++;
else if (ch === "}") {
depth—;
if (depth === 0) return JSON.parse(text.slice(start, i + 1));
}
}
return null; // 尚未闭合
}
这个函数有三层保险:字符串内的大括号不计入配对(防止回复正文里的 {} 干扰);闭合到顶层即尝试解析(保证效率);解析失败返回 null 而非抛错(保证流式过程零中断)。它同时被用于流式过程中的"增量尝试"和流结束后的"最终兜底",一处实现、两处复用。
5.3 渲染优先级的设计
在流式过程中我们遵循这样的渲染策略:
这套策略在保持"即时感"的同时,把最终呈现切换得干净利落。实测中,模型约在数秒内完成整段输出,用户几乎无感知地看到"打字 → 卡片浮现"的流畅过渡。
六、富文本渲染与 XSS 防护
6.1 自研轻量 Markdown 渲染器
为保持零依赖,我们没有引入 marked / markdown-it 等库,而是手写了一个约四十行的轻量渲染器,覆盖对话场景最常用的语法:行内代码、加粗、> 引用、####/### 标题、- 无序列表、段落分隔。渲染顺序经过精心设计:先做 HTML 转义,再做模式替换,并且注意"列表项先分组为 ul、再组段落"的顺序,避免嵌套错乱。
6.2 安全是硬底线
AI 生成的内容是不可信的第三方输入。如果直接把模型的输出拼进 innerHTML,一旦模型被诱导输出 <script> 或 <img onerror> 之类的载荷,就会造成存储型 XSS。因此我们坚持:
“先转义、后富化” 是安全富文本渲染的黄金次序,任何直接对模型输出做 .replace 注入标签再赋给 innerHTML 的做法都应视为高危。
七、体验细节:那些让产品"有温度"的小事
一个产品的质感,往往藏在不被注意的细节里。我们在这一版里打磨了这些点:
- Enter 发送、Shift+Enter 换行:遵循即时通讯软件的心智模型,长文本需求交给换行键;
- Textarea 自适应高度:输入框随内容增长,最高 140px,超过后内部滚动,避免遮挡对话区;
- 快捷追问条:最近一次的结构化回复中的追问,会常驻输入框上方,形成"电梯按钮"式的引导,用户可以连续追问而无需打字;
- 两个发际线:AI 侧用黛蓝印章"寻",用户侧用朱砂印章"艺",一冷一暖,呼应"守护人"与"探艺人"的身份对应;
- 本地会话记忆:对话历史持久化到 localStorage,刷新页面后原样恢复;"新对话"按钮一键清空重建;
- 打字机与思考占位:按钮禁用、占位文案切换、"阅读古籍"的耐心提示,避免用户在等待中的焦虑;
- 流式错误兜底:遇网络错误弹出 toast 并保留现场;极端情况下模型未按约返回 JSON 时,自动退化为纯文本渲染,产品绝不"白屏"。
所谓匠心,不过是把这些几像素级的工作一一做完。
八、国风视觉:让界面本身成为"非遗作品"
8.1 色彩取自古籍
整套视觉体系建立在宣纸与墨色的意象上:米白宣纸底色 #f7f1e5,配以墨色正文 #2b2520 与次级棕灰文字;点缀色选用了传统色中的朱砂红(#a63a2b)与黛蓝(#33465f),鎏金(#b98a2f)仅用于徽标、引用等少量点缀。三种色相的饱和度都经过压制,保持"素雅"的文人气质,也保证长时间的阅读舒适。
8.2 字体师承宋明
正文采用无衬线的现代中文(苹方、雅黑),而标题与印章则回落到 Songti / SimSun / Noto Serif SC 等宋体字族——宋体承载着刻书与版画的千年记忆,恰与项目气质相合。页头的"寻"字印章,用朱砂渐变打底、浮雕描边,是整套视觉的锚点。
8.3 细节里的东方意象
- 欢迎页标题下的鎏金下划线,用 SVG data-URI 绘制了一道"飞白"笔意;
- 消息气泡默认尖角朝上,AI 消息直角微圆、用户消息朱砂渐变,符合"宣纸对话"的隐喻;
- 卡片、徽章、状态灯均采用克制而统一的圆角系统,整套界面无一张外部图片——全部装饰由 CSS 与内联 SVG 完成,轻量且快。
我们希望用户在打开页面的第一秒,就能从视觉上相信:这是一位"讲书人",而不是一台冰冷的问答机器。
九、质量验证:不止于"能跑"
在交付之前,我们做了两层自动化验证。
9.1 真实 API 自测脚本
scripts/test_api.js 以 Node 环境完整走通:发起流式请求 → 累积增量 → 验证 JSON 可解析 → 校验 reply / suggestions / related 字段的完整性。在本地实测中,模型顺利返回了符合契约的结构:
{
"reply": "讲到非遗,我想起**梁祝传说**(民间文学·浙江绍兴上虞)……",
"suggestions": ["梁祝在哪些地方流传最广?", "越剧《梁祝》和原传说有什么不同?", "还有哪些非遗里藏着爱情传说?"],
"related": [{ "name": "梁祝传说", "type": "民间文学", "region": "浙江杭州、宁波鄞州、绍兴上虞等", "desc": "中国古代四大民间传说之一……" }]
}
9.2 浏览器级端到端验证
scripts/verify_page.js 基于 Puppeteer 在无头 Chromium 中完成端到端回归:加载页面 → 断言欢迎页与四张推荐卡 → 点击推荐卡触发真实对话 → 等待流式返回 → 断言用户消息与 AI 气泡出现 → 断言追问按钮(≥3)与非遗卡片(≥1)渲染成功 → 断言发送按钮恢复可用。这条链路把"界面 → 调用 → 解析 → 渲染"全部串起来,防止任何一环悄悄退化。
两份脚本连同用法一并写入了 README,让项目"可被测",而不只是"能运行"。
十、过程中的踩坑复盘
开发并非一帆风顺,这些坑值得记录:
十一、成果与展望
目前"寻艺"已完成第一个可交付版本,并通过真实环境验证。用户可以在欢迎页一键开启四类旅程:听传承故事、按推荐寻艺、学技艺入门、参与守护行动。
回望这段开发,我们更愿意把它看作一个"方法论样本":如何用极简的技术栈,搭一个有温度的 AI 产品。 项目未来的想象空间还有很多:
- 对话图谱化:把用户探索过的非遗项目沉淀为一张可视化知识图谱;
- 多模态寻艺:引入图片生成,让"苏绣针法""皮影雕刻"以图说话;
- 传承人连麦:接入语音,让用户"听"到传承人的口述史;
- 开放 API 化:将"非遗守护人"的能力封装为可嵌入的对话插件,助力文旅场景。
十二、结语
非遗传承的本质,是一场跨越时空的对话:古人把技艺交给今人,今人再把它讲给机器,机器又将这份记忆讲给下一代。在这场对话里,AI 不该是替代者,而应该是摆渡人。
"寻艺"是一个很小的项目,小到只有几份文件;它也很重,重到承载着让年轻人"被非遗打动一次"的愿望。我们走在码道上,写下代码;也走在文化的长路上,捡起技艺。愿每一位打开这个页面的朋友,都能遇到那位持朱砂印的守护人,问一句:“江湖这么远,你从哪里来?”
项目地址:https://gitcode.com/Zch070214/FEIYI
最后,借一句在民间广为流传的老话作结——“手艺人,守艺人也。” 在码道上,愿我们都能成为新一代的守艺人。
附录一:三分钟跑起来
拿到代码之后,最快的方式有两种。
方式一:直接打开。 使用最新版的 Chrome、Edge 或 Firefox 浏览器,双击 index.html 即可。页面会自动携带密钥向云端 API 发起请求,适合快速体验。需要注意的是,部分浏览器对 file:// 协议下的网络请求有更严格的限制,若遇到跨域或请求失败,建议改用本地服务器方式。
方式二:本地服务器。 项目附带了一个四十行左右的零依赖静态服务器脚本:
node scripts/serve.js
然后访问 http://127.0.0.1:8642。本地服务器方式最接近生产环境,也便于调试。将该目录整体上传到任意静态托管平台(如 GitCode Pages、Nginx、对象存储)同样可以直接运行,因为本项目没有后端、没有构建步骤,全仓库都是纯静态产物。
附录二:配置与替换
所有配置都收拢在 js/config.js 一个文件里,按需修改即可:
- API_URL:默认指向 GitCode AI 的聊天补全接口,若切换到其他兼容 OpenAI 风格的网关,只需替换此地址;
- API_KEY:替换为你自己的令牌;
- MODEL:默认 deepseek-ai/DeepSeek-V4-Flash;
- MAX_TOKENS、TEMPERATURE、TOP_P、FREQUENCY_PENALTY 与 THINKING_BUDGET:生成参数,与参考代码一一对应。
替换完成后,Ctrl + F5 强制刷新即可生效。若希望更换角色设定,直接修改 AI_SYSTEM_PROMPT 字符串——把"非遗守护人"换成"茶文化导师"“古建讲解员”,前端无需任何改动,因为渲染契约是通用的。
附录三:常见问题
问:为什么回复有时是纯文本,没有卡片? 答:系统提示词规定,仅当回复确实涉及具体非遗项目时才输出 related 卡片;寒暄类、科普类回复会返回空数组。这是刻意的设计,避免"硬塞卡片"破坏对话自然感。若你希望任何回复都带卡片调整字段即可。
问:密钥写在浏览器里安全吗? 答:纯前端方案下密钥对用户可见,这是取舍而非疏漏。面向公众的大规模部署,建议把请求放到后端代理,由服务端持有密钥并做频控、鉴权;个人自用或演示场景,直接暴露是可接受的。
问:为什么不用 Vue 或 React? 答:本项目刻意保持原生实现,为的是"每一行都可读、每一处都可改",同时把运行时体积压缩到极致。对于单页对话应用,原生 DOM 操作完全够用;若未来交互复杂度上升,迁移到框架时,api.js 与 config.js 的职责边界也能无缝复用。
问:多轮对话的上下文是怎么维护的? 答:前端维护一个 messages 数组,system 提示词恒在首位,其后按序追加用户与助手的消息,超出二十条时自动丢弃最旧的轮次,避免上下文超长。每次发送时把整个数组随请求带过去,模型据此理解对话脉络。
问:模型偶尔不按 JSON 返回怎么办? 答:这是所有"LLM 即后端"应用的常态风险。我们的策略是"提示词约束 + 增量解析 + 双重重试 + 纯文本兜底"四道防线:先尽量让模型按契约输出;流式途中实时尝试解析;结束后若仍失败,则用宽松模式抓取任意完整对象;连对象都抓不到时,把原始文本当作普通回复渲染。用户在任何情况下都不会面对空白页面。
本文由"寻艺 · 非遗交互式对话平台"项目开发过程整理而成。# 码道 · 寻艺——从零构建"非遗交互式对话平台"的完整实践
用一行行代码,在数字世界里为千年技艺留一盏灯。
—— 记"寻艺 · 非遗交互式对话平台"的诞生
一、写在前面:我们为什么要做这件事
中国非物质文化遗产浩如烟海。据文化和旅游部公布的数据,我国已有国家级非物质文化遗产代表性项目一千五百余项,涵盖民间文学、传统音乐、传统舞蹈、传统戏剧、曲艺、传统美术、传统技艺、传统医药、民俗等十大类别。然而在快节奏的现代生活中,这些承载着民族记忆的技艺,正面临着传承人老龄化、年轻人认知断层、传播渠道单一的困境。
"非遗"这个词,很多人听过,但说不出三样具体的项目;"苏绣"很美,但多数人不知道一根丝线可以劈成八十八分之一;“梁祝传说"人人耳熟能详,却少有人了解它在民间文学谱系中的位置。信息时代的悖论在于:知识前所未有的丰裕,注意力却前所未有地稀缺。非遗要"活"下去,首先要"被看见”。
而 AI 对话恰恰提供了这样一个入口:它天然是一个扁平的、无门槛的、一对一的交互界面。把 AI 塑造成一位"非遗守护人",让用户像和朋友聊天一样,问一个故事、听一段历史、学一门技艺——这正是本项目 “寻艺” 的初心:在码道之上,寻千年之艺。
二、项目定位与技术选型
2.1 定位:一个纯粹的、轻量的单页应用
在设计之初,我们明确了几个原则:
- 零门槛使用:无需安装、无需注册、打开即用;
- 零构建成本:不使用 React/Vue 等框架,不引入打包工具,保持项目极简,让人人都能读懂和维护;
- 开箱即用的智能:接入云端大模型 API,让"非遗守护人"具备真正的知识广度和对话温度;
- 结构化呈现:不满足于"打字机式"的纯文本回复,而是让 AI 返回结构化数据,前端渲染出卡片、按钮等丰富的交互形态。
最终技术栈定格为:HTML5 + CSS3 + 原生 JavaScript(ES6+)+ 云端 AI API。这份简单背后,是对"少即是多"的坚持——一个完整的对话产品,用三份 JS、一份 CSS 和一份 HTML 就能承载。
2.2 为什么是"流式"对话
传统的一次性请求(请求发出、等几秒、整段返回)存在两个体验问题:一是等待时间感知过长,二是无法看到"思考的过程",会让用户怀疑系统是否卡死。流式(Streaming)响应则像人在说话:一个字一个字地"打字"出来,先给用户即时的反馈,再逐步充实内容。
这在心理学上叫"感知性能优化"——用户体验到的响应时间,取决于第一帧内容的到达速度,而非全部内容的完成时间。因此本项目核心采用的正是 SSE(Server-Sent Events)协议的流式对话,这一点也决定了后续 JavaScript 改造方案的形态。
三、核心实现:从 Python 参考代码到 JavaScript
3.1 参考实现:一次"翻译"之旅
项目最初提供了一份 Python 参考代码,用于演示 API 的标准调用方式。其核心是一个生成器:
def query(payload):
response = requests.post(API_URL, headers=headers, json=payload, stream=True)
for line in response.iter_lines():
if not line.startswith(b"data:"):
continue
if line.strip() == b"data:[DONE]":
return
yield json.loads(line.decode("utf-8").lstrip("data:"))
这段代码短小精悍,却浓缩了流式对话的完整骨架:发起流式 POST 请求 → 逐行读取 → 过滤 data: 前缀 → 遇到 [DONE] 终止 → 逐条产出 JSON。而我们要做的,是把这套逻辑完整地移植到浏览器环境。浏览器没有 requests,却有同样强大的 fetch 与 ReadableStream。
3.2 JavaScript 改写:fetch + ReadableStream + TextDecoder
在浏览器端,fetch 的 response.body 返回一个 ReadableStream,我们可以通过 reader.read() 循环读取二进制块。这里有一个关键细节:网络数据是按块到达的,一个 JSON 对象可能被拆散在多个数据块里,甚至一个数据块里可能包含多行 SSE 数据。因此必须引入一个"缓冲区"(buffer)策略:
const reader = response.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
while (true) {
const { done, value } = await reader.read();
if (done) break;
buffer += decoder.decode(value, { stream: true });
const lines = buffer.split("\\n");
buffer = lines.pop(); // 末段可能是不完整行,留到下一轮拼接
for (const line of lines) {
if (!line.trim().startsWith("data:")) continue;
const data = line.trim().slice(5).trim();
if (data === "[DONE]") { /* 结束 */ }
const chunk = JSON.parse(data);
const delta = chunk.choices?.[0]?.delta?.content ?? "";
if (delta) onDelta(delta);
}
}
这里有三处容易被忽视的细节:
这一步"翻译",完成了从 requests 生态到 Web 平台的平滑迁移。
3.3 思考预算:thinking_budget 与推理内容
参考代码的 payload 里还包含一个特别的参数:thinking_budget: 2048。这类参数指示模型在回答前先进行一段"内部思考"(reasoning)。在返回的流中,思考过程会出现在 delta.reasoning_content 字段,而正式回答出现在 delta.content。
我们在前端对二者做了差异化处理:思考到达时,气泡显示"寻艺正在查阅古籍,梳理脉络……“的占位状态,营造"守护人正在沉吟"的仪式感;一旦正式内容开始输出,立即切换到流式打字效果。这样既保留了模型的思考质量,又不会让用户面对一大段无用的"内心独白”。
四、系统提示词:让 AI 输出程序认识的 JSON
4.1 为什么要求结构化输出
如果放任大模型自由发挥,回复可能是任意形态的文本:可能是散文、可能是列表、可能带 Markdown,也可能什么格式都没有。前端想在此基础上渲染"追问按钮"或"非遗卡片",就只能靠正则去猜,极易出错。
更好的做法是用系统提示词约定输出协议:告诉 AI"你必须只输出一个合法 JSON 对象",并给出明确的字段定义。这样 AI 的"说话"就和程序的"理解"对齐了——这正是当前大模型应用工程中的核心方法论:用自然语言定义接口契约(LLM-native API design)。
4.2 我们的 JSON 契约
我们最终定义的响应协议包含三个字段:
{
"reply": "回复正文,可含 Markdown,约 90~260 字,信息密度高",
"suggestions": ["追问示例1", "追问示例2", "追问示例3"],
"related": [{"name": "苏绣", "type": "传统美术", "region": "江苏苏州", "desc": "一句话简介"}]
}
- reply:真正的对话正文,允许适度使用 Markdown(加粗、列表、引用),前端渲染为富文本;
- suggestions:恰好三条推荐追问。它承担"对话引导"的职责——AI 不仅要回答问题,还要把对话引向深入。点击追问即可继续对话,形成对话闭环;
- related:涉及具体非遗项目时输出的"知识卡片"。包含项目名称、所属门类、地区与简介,前端渲染为卡片墙,把零散的回复沉淀为可浏览的知识单元。
4.3 角色设定的写作技巧
系统提示词的角色塑造,我们刻意融入了"人味":不要官方辞令式的"本助手为您解答",而是"你知识渊博而温和,说话如一位讲书人,亲切、有画面感、有温度";要求"善于用色彩、声音、触感构建画面";甚至规定了"每次回复尽量传达一点新知识或新视角"。同时我们也划了红线:“不编造非遗项目和传承人信息;不确定时坦诚说明,并给出查阅方向”。
实测效果令人惊喜:模型回答"苏绣的起源"时,会讲述浣纱女西施"以血染线绣芙蓉"的传说;回答"梁祝"时,会聚焦"十八相送"这个被常被略过的动人片段。好的角色设定,是把模型的"知识量"转化为"感染力"的关键。
五、前端增量解析:无损地从流中"捞出" JSON
5.1 难点:流式与 JSON 的天然冲突
流式响应是"边生成边传输"的,因此任意时刻我们手里的文本都是不完整的 JSON 片段。如果等全部传输完毕再解析,就丧失了流式即时渲染的意义;如果急于解析,又会被"半个对象"卡住。我们的目标是:一旦 JSON 在大括号层面闭合、可以被完整解析,就立即渲染,一秒也不用等。
5.2 方案:字符串感知的大括号配对扫描
最初的写法是 text.lastIndexOf("{") 拿最后一个左花括号作为起点去解析——但这在带缩进格式的多层 JSON 前会失效:related 数组里嵌套对象自身的 { 才是最后一个花括号,从它开始的子串根本不是合法 JSON(见下图示意)。
{
"reply": "…",
"suggestions": […],
"related": [ { "name": …, … } ] ← 最后一个 { 在这里,从它切片必失败
}
正确的解法是从头扫描、状态机式地统计花括号配对,同时跳过字符串字面量内的花括号:
function extractJsonObj(text) {
const start = text.indexOf("{");
if (start < 0) return null;
let depth = 0, inStr = false, escaped = false;
for (let i = start; i < text.length; i++) {
const ch = text[i];
if (inStr) {
if (escaped) escaped = false;
else if (ch === "\\\\") escaped = true;
else if (ch === '"') inStr = false;
continue;
}
if (ch === '"') { inStr = true; continue; }
if (ch === "{") depth++;
else if (ch === "}") {
depth—;
if (depth === 0) return JSON.parse(text.slice(start, i + 1));
}
}
return null; // 尚未闭合
}
这个函数有三层保险:字符串内的大括号不计入配对(防止回复正文里的 {} 干扰);闭合到顶层即尝试解析(保证效率);解析失败返回 null 而非抛错(保证流式过程零中断)。它同时被用于流式过程中的"增量尝试"和流结束后的"最终兜底",一处实现、两处复用。
5.3 渲染优先级的设计
在流式过程中我们遵循这样的渲染策略:
这套策略在保持"即时感"的同时,把最终呈现切换得干净利落。实测中,模型约在数秒内完成整段输出,用户几乎无感知地看到"打字 → 卡片浮现"的流畅过渡。
六、富文本渲染与 XSS 防护
6.1 自研轻量 Markdown 渲染器
为保持零依赖,我们没有引入 marked / markdown-it 等库,而是手写了一个约四十行的轻量渲染器,覆盖对话场景最常用的语法:行内代码、加粗、> 引用、####/### 标题、- 无序列表、段落分隔。渲染顺序经过精心设计:先做 HTML 转义,再做模式替换,并且注意"列表项先分组为 ul、再组段落"的顺序,避免嵌套错乱。
6.2 安全是硬底线
AI 生成的内容是不可信的第三方输入。如果直接把模型的输出拼进 innerHTML,一旦模型被诱导输出 <script> 或 <img onerror> 之类的载荷,就会造成存储型 XSS。因此我们坚持:
“先转义、后富化” 是安全富文本渲染的黄金次序,任何直接对模型输出做 .replace 注入标签再赋给 innerHTML 的做法都应视为高危。
七、体验细节:那些让产品"有温度"的小事
一个产品的质感,往往藏在不被注意的细节里。我们在这一版里打磨了这些点:
- Enter 发送、Shift+Enter 换行:遵循即时通讯软件的心智模型,长文本需求交给换行键;
- Textarea 自适应高度:输入框随内容增长,最高 140px,超过后内部滚动,避免遮挡对话区;
- 快捷追问条:最近一次的结构化回复中的追问,会常驻输入框上方,形成"电梯按钮"式的引导,用户可以连续追问而无需打字;
- 两个发际线:AI 侧用黛蓝印章"寻",用户侧用朱砂印章"艺",一冷一暖,呼应"守护人"与"探艺人"的身份对应;
- 本地会话记忆:对话历史持久化到 localStorage,刷新页面后原样恢复;"新对话"按钮一键清空重建;
- 打字机与思考占位:按钮禁用、占位文案切换、"阅读古籍"的耐心提示,避免用户在等待中的焦虑;
- 流式错误兜底:遇网络错误弹出 toast 并保留现场;极端情况下模型未按约返回 JSON 时,自动退化为纯文本渲染,产品绝不"白屏"。
所谓匠心,不过是把这些几像素级的工作一一做完。
八、国风视觉:让界面本身成为"非遗作品"
8.1 色彩取自古籍
整套视觉体系建立在宣纸与墨色的意象上:米白宣纸底色 #f7f1e5,配以墨色正文 #2b2520 与次级棕灰文字;点缀色选用了传统色中的朱砂红(#a63a2b)与黛蓝(#33465f),鎏金(#b98a2f)仅用于徽标、引用等少量点缀。三种色相的饱和度都经过压制,保持"素雅"的文人气质,也保证长时间的阅读舒适。
8.2 字体师承宋明
正文采用无衬线的现代中文(苹方、雅黑),而标题与印章则回落到 Songti / SimSun / Noto Serif SC 等宋体字族——宋体承载着刻书与版画的千年记忆,恰与项目气质相合。页头的"寻"字印章,用朱砂渐变打底、浮雕描边,是整套视觉的锚点。
8.3 细节里的东方意象
- 欢迎页标题下的鎏金下划线,用 SVG data-URI 绘制了一道"飞白"笔意;
- 消息气泡默认尖角朝上,AI 消息直角微圆、用户消息朱砂渐变,符合"宣纸对话"的隐喻;
- 卡片、徽章、状态灯均采用克制而统一的圆角系统,整套界面无一张外部图片——全部装饰由 CSS 与内联 SVG 完成,轻量且快。
我们希望用户在打开页面的第一秒,就能从视觉上相信:这是一位"讲书人",而不是一台冰冷的问答机器。
九、质量验证:不止于"能跑"
在交付之前,我们做了两层自动化验证。
9.1 真实 API 自测脚本
scripts/test_api.js 以 Node 环境完整走通:发起流式请求 → 累积增量 → 验证 JSON 可解析 → 校验 reply / suggestions / related 字段的完整性。在本地实测中,模型顺利返回了符合契约的结构:
{
"reply": "讲到非遗,我想起**梁祝传说**(民间文学·浙江绍兴上虞)……",
"suggestions": ["梁祝在哪些地方流传最广?", "越剧《梁祝》和原传说有什么不同?", "还有哪些非遗里藏着爱情传说?"],
"related": [{ "name": "梁祝传说", "type": "民间文学", "region": "浙江杭州、宁波鄞州、绍兴上虞等", "desc": "中国古代四大民间传说之一……" }]
}
9.2 浏览器级端到端验证
scripts/verify_page.js 基于 Puppeteer 在无头 Chromium 中完成端到端回归:加载页面 → 断言欢迎页与四张推荐卡 → 点击推荐卡触发真实对话 → 等待流式返回 → 断言用户消息与 AI 气泡出现 → 断言追问按钮(≥3)与非遗卡片(≥1)渲染成功 → 断言发送按钮恢复可用。这条链路把"界面 → 调用 → 解析 → 渲染"全部串起来,防止任何一环悄悄退化。
两份脚本连同用法一并写入了 README,让项目"可被测",而不只是"能运行"。
十、过程中的踩坑复盘
开发并非一帆风顺,这些坑值得记录:
十一、成果与展望
目前"寻艺"已完成第一个可交付版本,并通过真实环境验证。用户可以在欢迎页一键开启四类旅程:听传承故事、按推荐寻艺、学技艺入门、参与守护行动。
回望这段开发,我们更愿意把它看作一个"方法论样本":如何用极简的技术栈,搭一个有温度的 AI 产品。 项目未来的想象空间还有很多:
- 对话图谱化:把用户探索过的非遗项目沉淀为一张可视化知识图谱;
- 多模态寻艺:引入图片生成,让"苏绣针法""皮影雕刻"以图说话;
- 传承人连麦:接入语音,让用户"听"到传承人的口述史;
- 开放 API 化:将"非遗守护人"的能力封装为可嵌入的对话插件,助力文旅场景。
十二、结语
非遗传承的本质,是一场跨越时空的对话:古人把技艺交给今人,今人再把它讲给机器,机器又将这份记忆讲给下一代。在这场对话里,AI 不该是替代者,而应该是摆渡人。
"寻艺"是一个很小的项目,小到只有几份文件;它也很重,重到承载着让年轻人"被非遗打动一次"的愿望。我们走在码道上,写下代码;也走在文化的长路上,捡起技艺。愿每一位打开这个页面的朋友,都能遇到那位持朱砂印的守护人,问一句:“江湖这么远,你从哪里来?”
项目地址:https://gitcode.com/Zch070214/FEIYI
最后,借一句在民间广为流传的老话作结——“手艺人,守艺人也。” 在码道上,愿我们都能成为新一代的守艺人。
附录一:三分钟跑起来
拿到代码之后,最快的方式有两种。
方式一:直接打开。 使用最新版的 Chrome、Edge 或 Firefox 浏览器,双击 index.html 即可。页面会自动携带密钥向云端 API 发起请求,适合快速体验。需要注意的是,部分浏览器对 file:// 协议下的网络请求有更严格的限制,若遇到跨域或请求失败,建议改用本地服务器方式。
方式二:本地服务器。 项目附带了一个四十行左右的零依赖静态服务器脚本:
node scripts/serve.js
然后访问 http://127.0.0.1:8642。本地服务器方式最接近生产环境,也便于调试。将该目录整体上传到任意静态托管平台(如 GitCode Pages、Nginx、对象存储)同样可以直接运行,因为本项目没有后端、没有构建步骤,全仓库都是纯静态产物。
附录二:配置与替换
所有配置都收拢在 js/config.js 一个文件里,按需修改即可:
- API_URL:默认指向 GitCode AI 的聊天补全接口,若切换到其他兼容 OpenAI 风格的网关,只需替换此地址;
- API_KEY:替换为你自己的令牌;
- MODEL:默认 deepseek-ai/DeepSeek-V4-Flash;
- MAX_TOKENS、TEMPERATURE、TOP_P、FREQUENCY_PENALTY 与 THINKING_BUDGET:生成参数,与参考代码一一对应。
替换完成后,Ctrl + F5 强制刷新即可生效。若希望更换角色设定,直接修改 AI_SYSTEM_PROMPT 字符串——把"非遗守护人"换成"茶文化导师"“古建讲解员”,前端无需任何改动,因为渲染契约是通用的。
附录三:常见问题
问:为什么回复有时是纯文本,没有卡片? 答:系统提示词规定,仅当回复确实涉及具体非遗项目时才输出 related 卡片;寒暄类、科普类回复会返回空数组。这是刻意的设计,避免"硬塞卡片"破坏对话自然感。若你希望任何回复都带卡片调整字段即可。
问:密钥写在浏览器里安全吗? 答:纯前端方案下密钥对用户可见,这是取舍而非疏漏。面向公众的大规模部署,建议把请求放到后端代理,由服务端持有密钥并做频控、鉴权;个人自用或演示场景,直接暴露是可接受的。
问:为什么不用 Vue 或 React? 答:本项目刻意保持原生实现,为的是"每一行都可读、每一处都可改",同时把运行时体积压缩到极致。对于单页对话应用,原生 DOM 操作完全够用;若未来交互复杂度上升,迁移到框架时,api.js 与 config.js 的职责边界也能无缝复用。
问:多轮对话的上下文是怎么维护的? 答:前端维护一个 messages 数组,system 提示词恒在首位,其后按序追加用户与助手的消息,超出二十条时自动丢弃最旧的轮次,避免上下文超长。每次发送时把整个数组随请求带过去,模型据此理解对话脉络。
问:模型偶尔不按 JSON 返回怎么办? 答:这是所有"LLM 即后端"应用的常态风险。我们的策略是"提示词约束 + 增量解析 + 双重重试 + 纯文本兜底"四道防线:先尽量让模型按契约输出;流式途中实时尝试解析;结束后若仍失败,则用宽松模式抓取任意完整对象;连对象都抓不到时,把原始文本当作普通回复渲染。用户在任何情况下都不会面对空白页面。
本文由"寻艺 · 非遗交互式对话平台"项目开发过程整理而成。


评论前必须登录!
注册