 网硕互联帮助中心
一次采购20台同型号电脑,能不能只建一张“电脑20台”的资产卡?答案取决于管理粒度:若要交给不同员工、贴不同二维码、盘点时逐台核实,就不能让一张卡同时代表20件可独立流转的实物。
采购批次为20台同型号电脑,单价5,000元;其中12台已分配,8台待领用。目标是在保留采购批次关系的同时,使每台实物可被单独借用、维修、盘点和报废。
本文以 Spring Boot + MySQL 8.x 的小型管理系统为教学边界。表名、字段和数值均为示例;上线前仍应依据资产制度、财务口径、数据量和现有程序进行评审。
实现时建议把一次业务动作拆成四层:Controller只接收请求和返回结果;Service加载当前状态、执行权限与业务校验;Repository使用参数化SQL读写;数据库用主键、唯一键、非空和金额精度守住最后边界。前端校验可以减少误操作,但不能替代服务端规则。
本文的SQL用于展示约束和核对思路,不是可直接在生产库执行的完整脚本。执行DDL前应确认MySQL版本、存储引擎、表规模、磁盘余量、主从延迟和锁等待;执行查询前应补充公司、期间等范围并查看执行计划。代码示例省略了DTO、Mapper和统一异常处理,但不会省略幂等、权限、事务和审计这些决定数据是否可信的部分。
如果系统已经存在历史数据,任何“新增唯一键”“改变状态含义”或“补齐关联ID”的操作都要先做数据剖析。先统计空值、重复值和非法状态,再选择清洗、映射或人工确认;不能因为新程序要求字段非空,就用0或空字符串批量填满旧记录。
正式改造前还应保存三份基线:当前表结构的SHOW CREATE TABLE结果、目标范围的数量与金额汇总、能够代表正常和异常路径的固定样本。发布后使用同一口径复查,并记录程序版本、数据库迁移版本和执行批次。如果需要回退,先判断新版本是否已经写入旧程序无法识别的数据;代码回退并不等于业务数据自动回退。对于大表新增索引或约束,还要先在相近数据量的环境评估执行时间与锁影响,不能只根据空测试库的耗时安排生产窗口。 文中的状态名和错误码用于说明设计方法。真正落地时应集中定义状态枚举、合法迁移和错误码说明,并为关键状态变化编写自动化测试,避免不同接口各自解释同一个状态。批量接口还应限制单批数量、记录处理进度并提供明确的重复提交策略;统计和导出任务不能绕开同样的数据权限与状态规则。监控指标至少区分请求失败、业务拒绝和异步待处理,避免把合理拦截误报成系统故障。对于可重试任务,应记录下一次执行时间、重试次数和最后错误;超过上限转人工处理,不能无限循环,也不能把待处理悄悄显示成完成。所有后台修复动作同样要经过授权、幂等和审计,并保留修复前后的核对证据,方便后续回归测试和责任追溯。接口返回、数据库记录和审计事件中的业务编号应保持一致,便于跨层定位、复核和比较结果。
目录
一、先按后续动作决定粒度
未来是否独立使用、独立盘点、独立维修或独立处置,是一机一卡的判断依据。采购相同不代表管理生命周期相同。
判断管理粒度时,可以把后续动作逐项列出来,而不是按采购单上的“数量”拍脑袋。一台电脑如果需要独立领用、调拨、维修、盘点和报废,它就是独立管理对象;办公椅即使同批采购,也可能因为要按楼层盘点而需要单件编码。反过来,一箱只按数量领用且无需追踪单件生命周期的耗材,不适合强行生成几十张资产卡。
| 是否分配给不同人员或地点 | 倾向单件卡 | 可继续判断 |
| 是否需要逐件贴码盘点 | 使用一物一码 | 可按批次盘点 |
| 是否会独立维修或报废 | 必须能定位单件 | 可保存批次数量 |
| 是否有独立序列号 | 保存到单件卡 | 使用内部序号 |
因此,管理粒度应在建卡前固定为 SINGLE 或 BATCH,并记录选择依据。已经发生独立流转后再把20张卡合成一张,会丢失使用人和维修历史;已经按批领用后再随意拆卡,也无法证明新卡分别对应哪件实物。
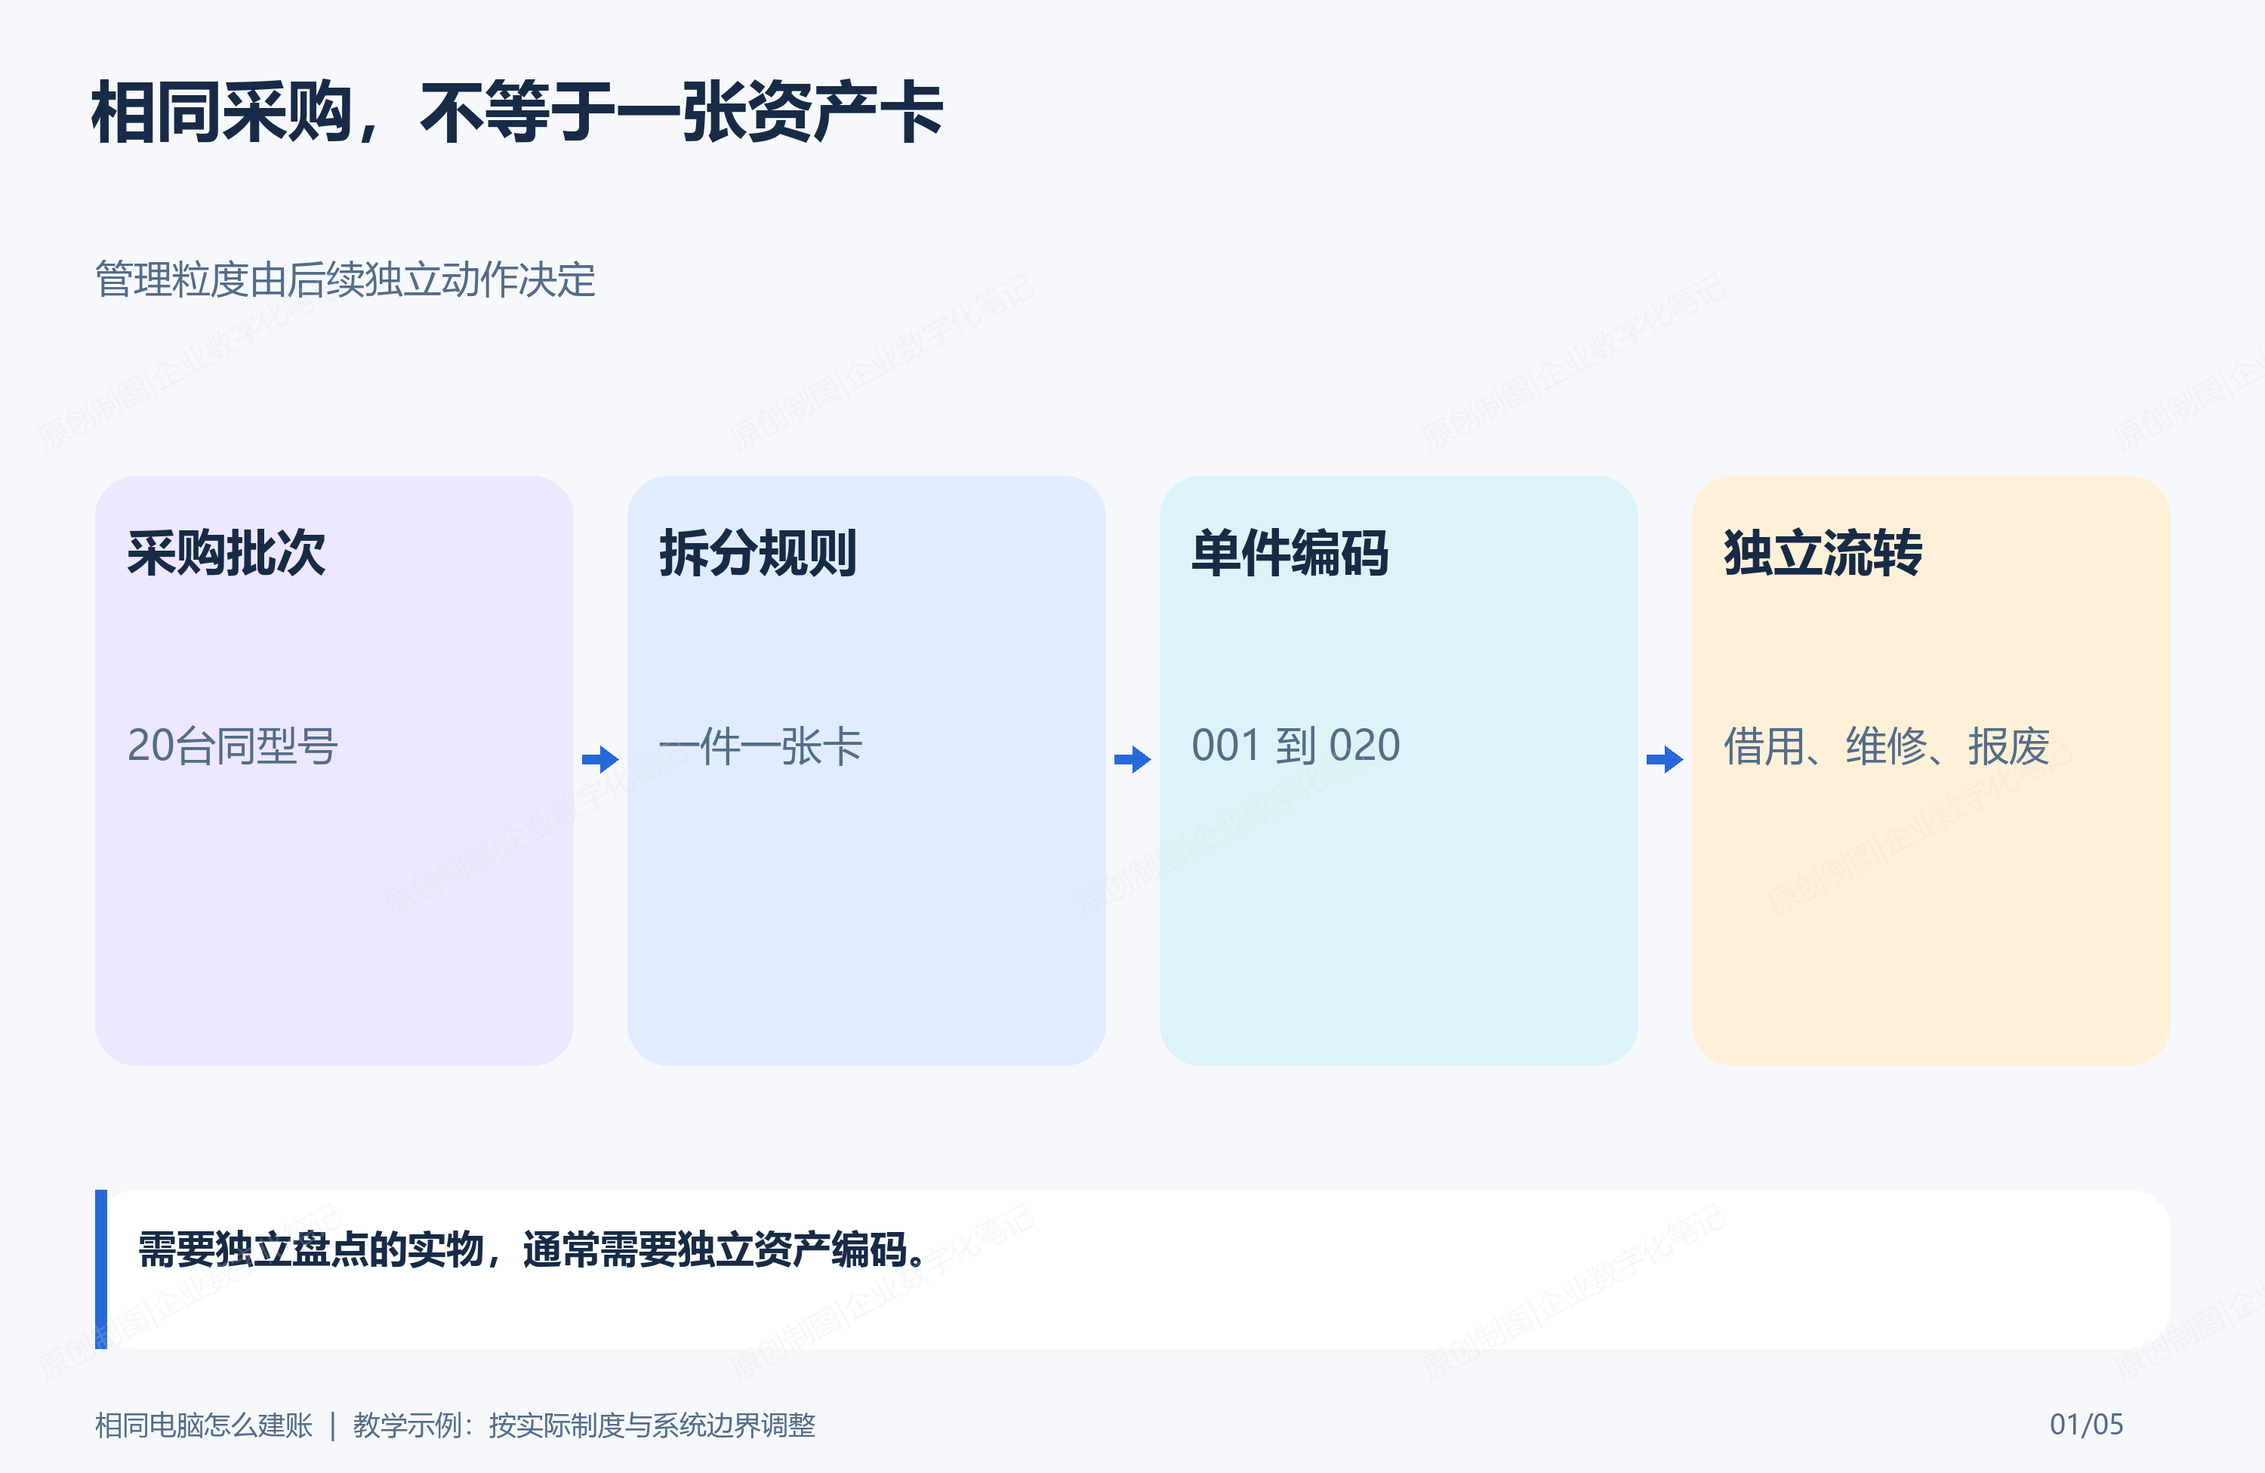
图1:相同采购,不等于一张资产卡。
二、批次记录与资产卡不是二选一
批次保存供应商、订单、型号、总数量和总金额;单件卡保存资产编码、序号、使用人、状态和单价。二者通过批次ID关联。
批次和资产卡应分别建模。批次表保存采购来源、型号、总数量和总金额;资产卡保存内部编码、批次序号、当前人员与状态。生成20张卡不是前端循环调用20次接口,而应由一个后端事务统一计算编号、分摊金额并批量写入。
@Transactional(rollbackFor = Exception.class)
public List<Long> splitBatch(SplitBatchCommand cmd) {
AssetBatch batch = batchRepository.lockById(cmd.batchId())
.orElseThrow(() -> new BizException("采购批次不存在"));
requireStatus(batch, "READY_TO_SPLIT");
if (cmd.quantity() != batch.getTotalQty()) {
throw new BizException("拆分数量必须等于批次待建卡数量");
}
List<BigDecimal> costs = allocationService.allocate(
batch.getTotalCost(), cmd.quantity(), 2);
List<AssetCard> cards = IntStream.range(0, cmd.quantity())
.mapToObj(i -> AssetCard.fromBatch(
batch, i + 1, costs.get(i),
codeService.next(batch.getCompanyId())))
.toList();
cardRepository.batchInsert(cards);
batchRepository.markSplit(batch.getId(), cards.size());
auditService.record("BATCH_SPLIT", batch.getId(), cards.size());
return cards.stream().map(AssetCard::getId).toList();
}
这里必须锁定批次并校验状态,防止两个人同时点击后生成40张卡。数据库还应为 (batch_id, item_sequence) 建唯一键,应用事务和数据库约束共同守住幂等边界。
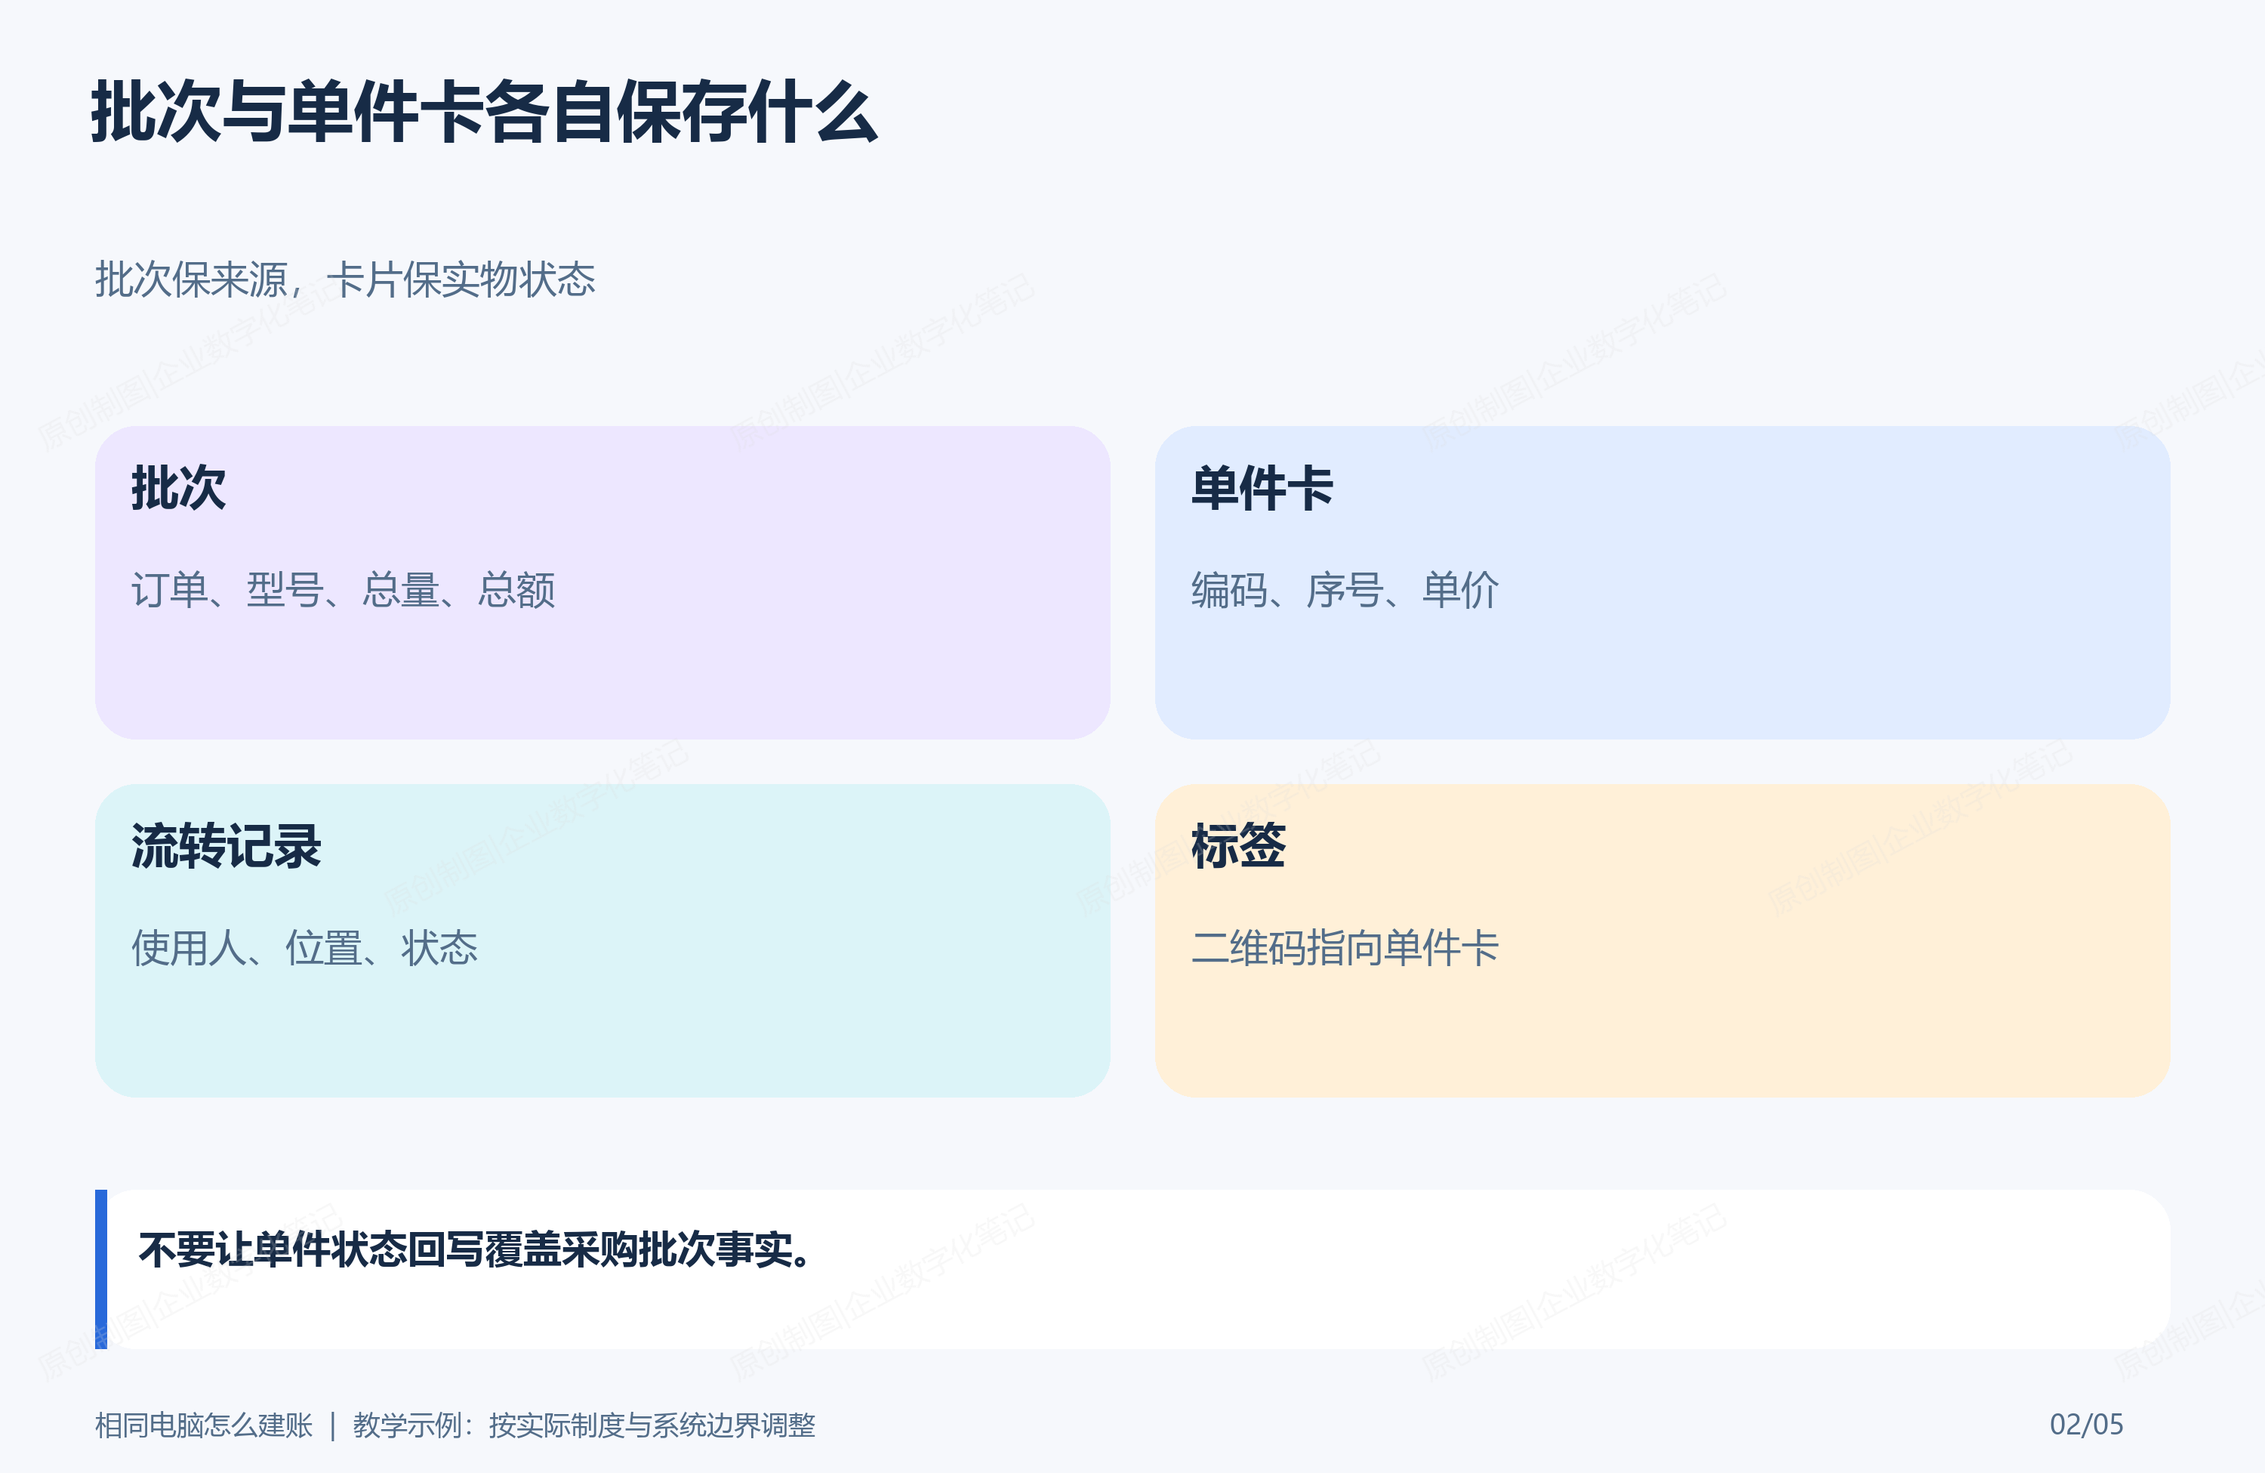
图2:批次与单件卡各自保存什么。
三、金额分摊要可复算
本例20台总额100,000元,若不含不可分摊费用,每卡5,000元。若有运费或折扣,必须写清分摊规则、精度和尾差归属。
金额分摊不能直接使用 double。例如总额100,000元平均分给20台,每台5,000元很整齐;但100,000元分给6件时会产生无法平均到分的尾差。系统应先按统一精度计算前N-1件,再把剩余尾差放到最后一件,并保存分摊规则和结果。
验收时至少验证三个恒等式:单件卡数量等于批次已拆数量;单件成本之和等于批次总成本;每张卡的来源批次和序号唯一。若后续撤销拆分,只允许尚未领用、维修、盘点或入账的卡进入冲销流程,不能直接删除已产生业务历史的资产卡。
批量生成还应返回逐件结果,包括内部编码、批次序号、金额和标签状态,而不是只返回“成功20条”。若其中一张标签打印失败,资产卡仍然存在并标为待打印,重试时只重新生成该标签。盘点抽样时选取批次中的任意一件,确认修改使用人或维修状态不会扩散到同批其余卡片。
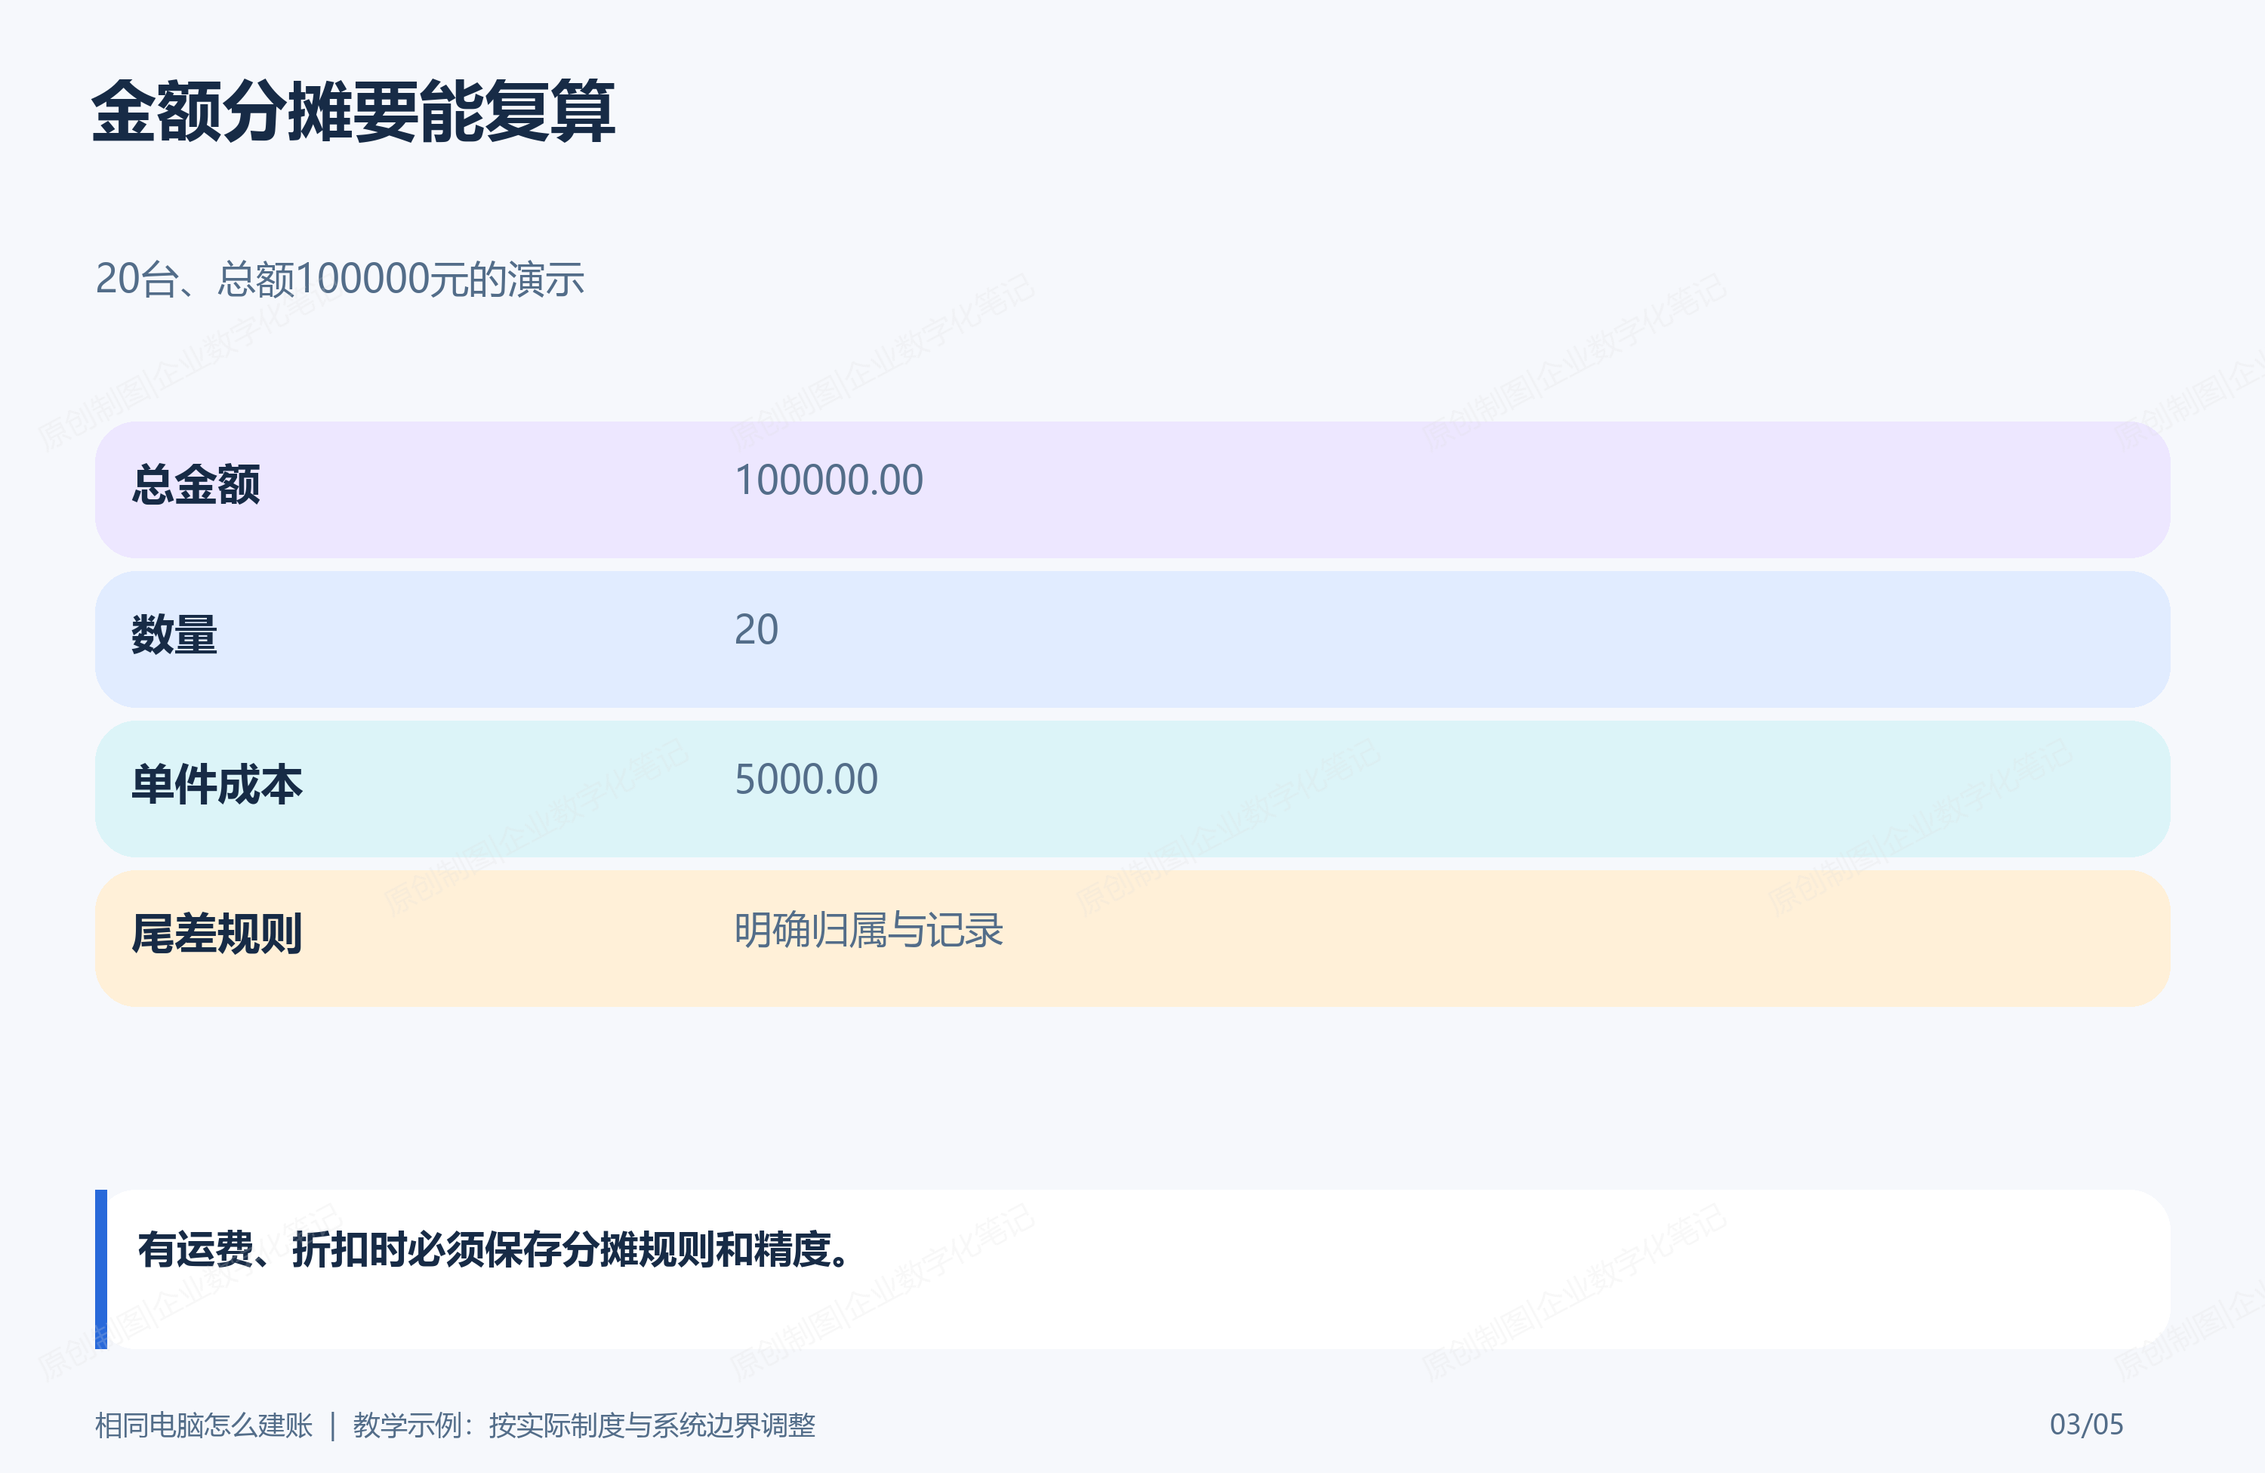
图3:金额分摊要能复算。
四、编码必须稳定,不从行号生成
建议批次号 + 序号形成资产编码,例如IT-202609-001至020。行号会随着Excel排序变化,不能作为长期标识。
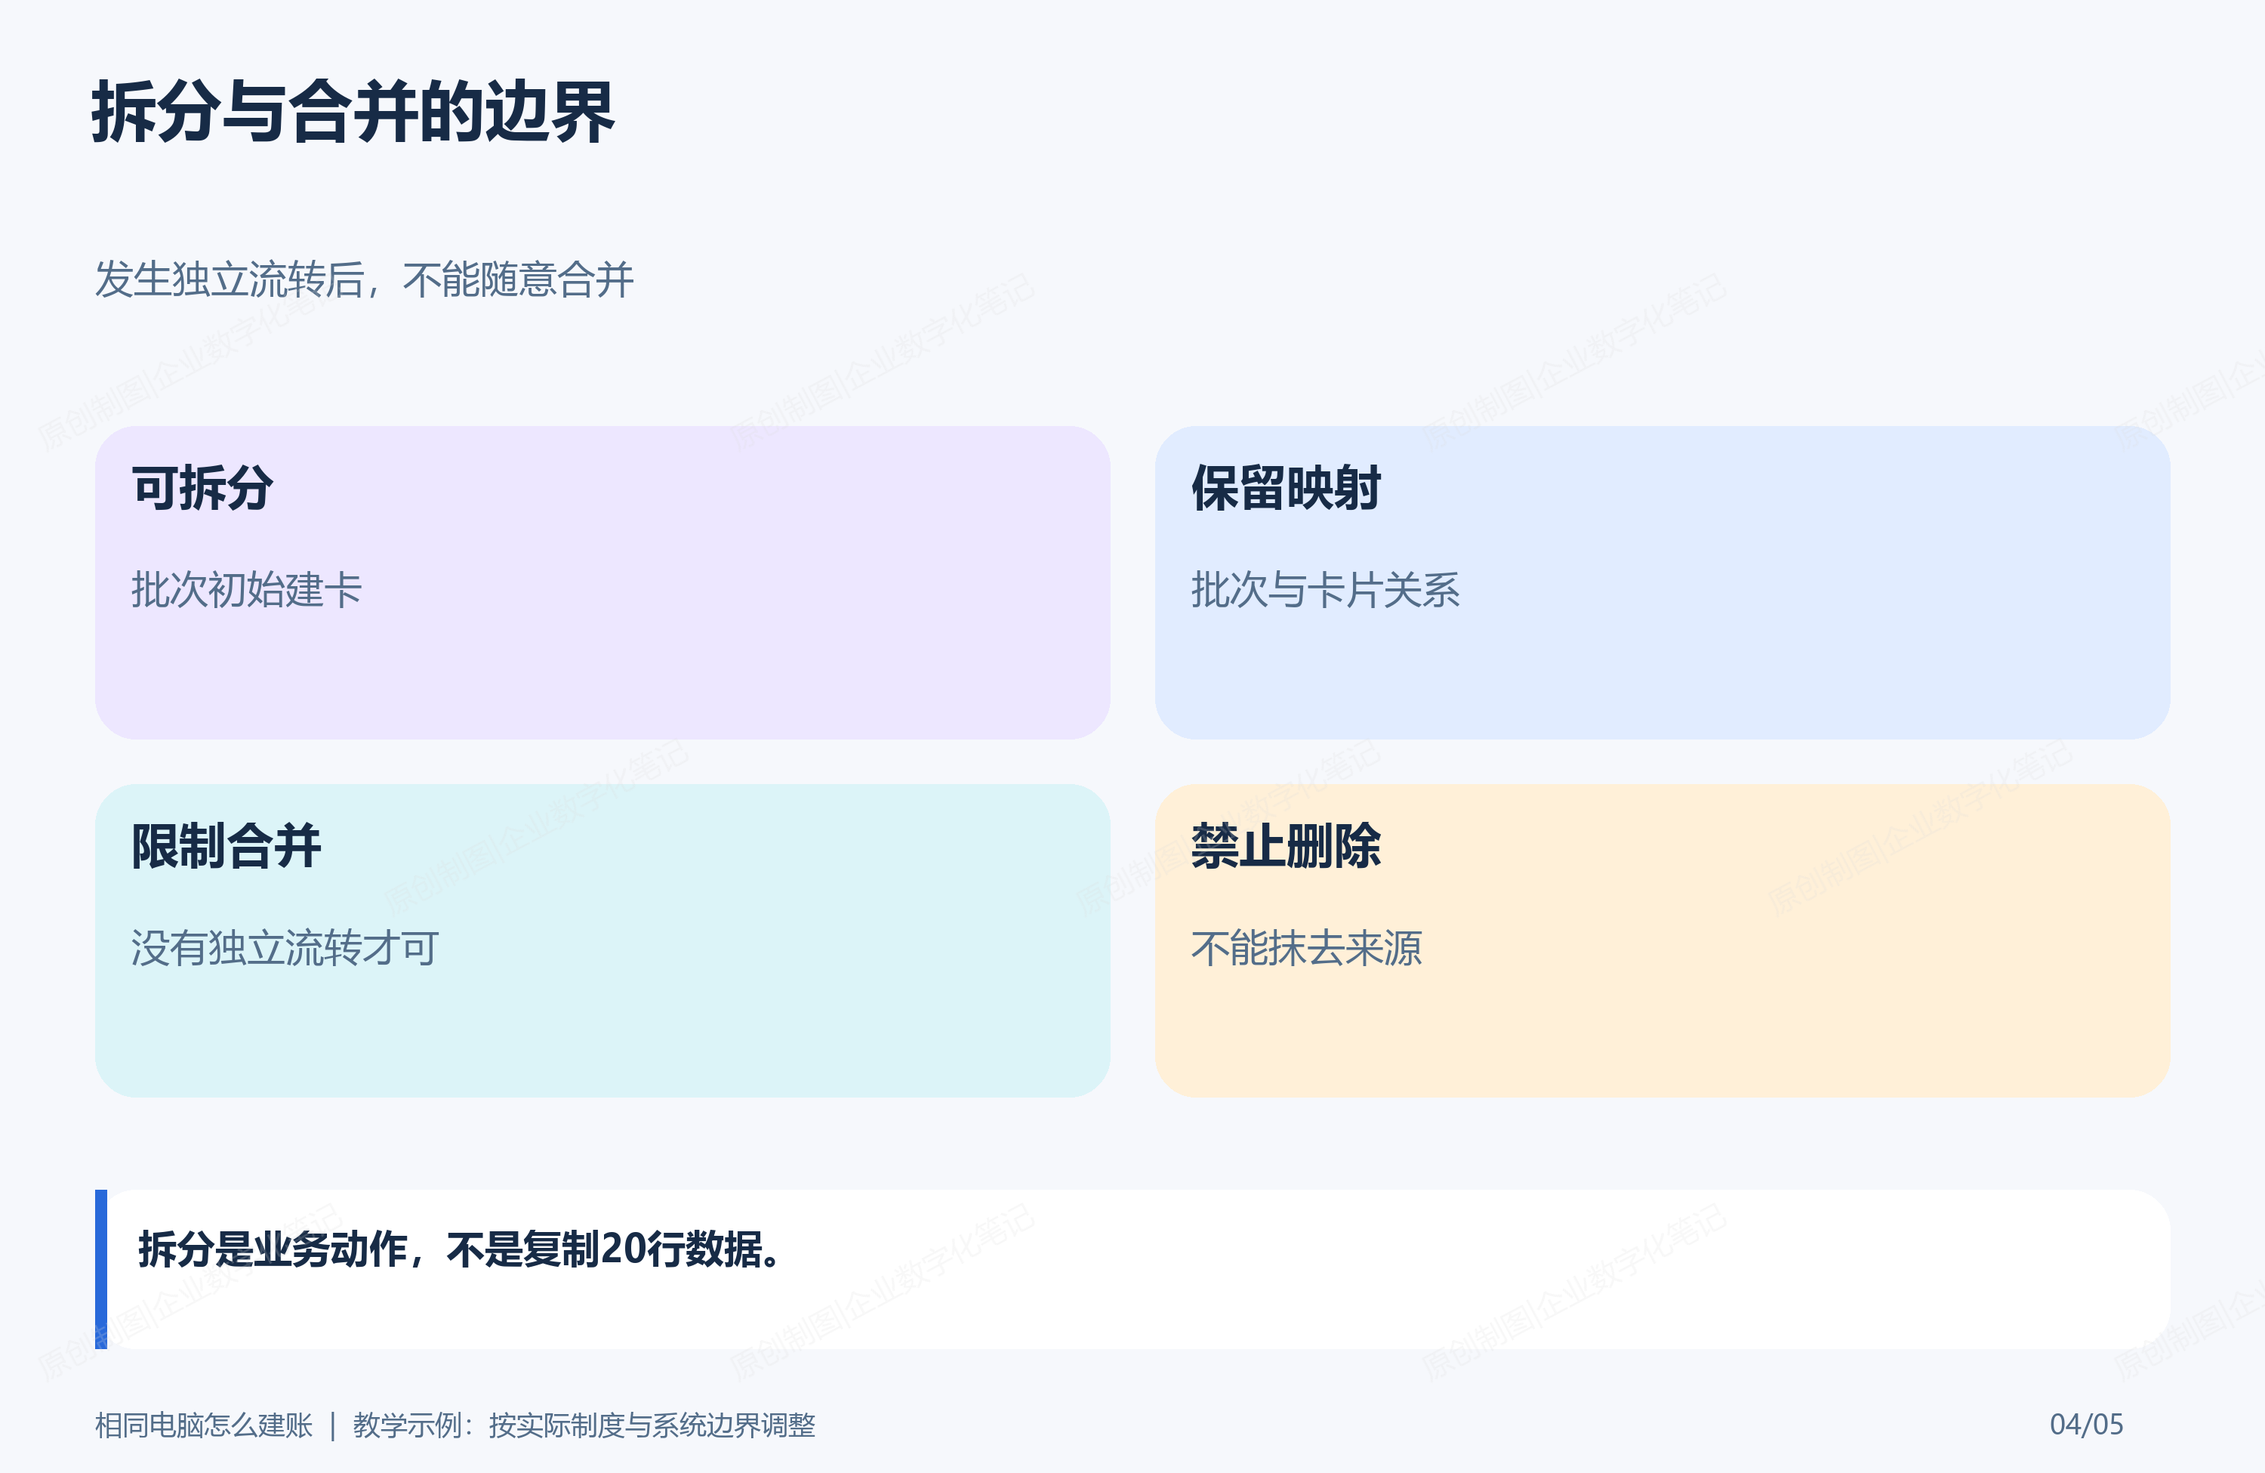
图4:拆分与合并的边界。
CREATE TABLE asset_batch_demo (
id BIGINT PRIMARY KEY AUTO_INCREMENT,
batch_code VARCHAR(32) NOT NULL UNIQUE,
total_qty INT NOT NULL, total_cost DECIMAL(18,2) NOT NULL
);
CREATE TABLE asset_card_demo (
id BIGINT PRIMARY KEY AUTO_INCREMENT,
batch_id BIGINT NOT NULL, asset_code VARCHAR(64) NOT NULL UNIQUE,
unit_cost DECIMAL(18,2) NOT NULL, asset_status VARCHAR(24) NOT NULL
);
SELECT batch_id, COUNT(*) card_qty, SUM(unit_cost) card_cost
FROM asset_card_demo GROUP BY batch_id;
五、拆分与合并都要保留来路
一张批次卡拆为20件后,禁止随手删原记录;应保存拆分批次、来源、操作者和对应关系。合并只适用于尚未发生独立流转的对象。
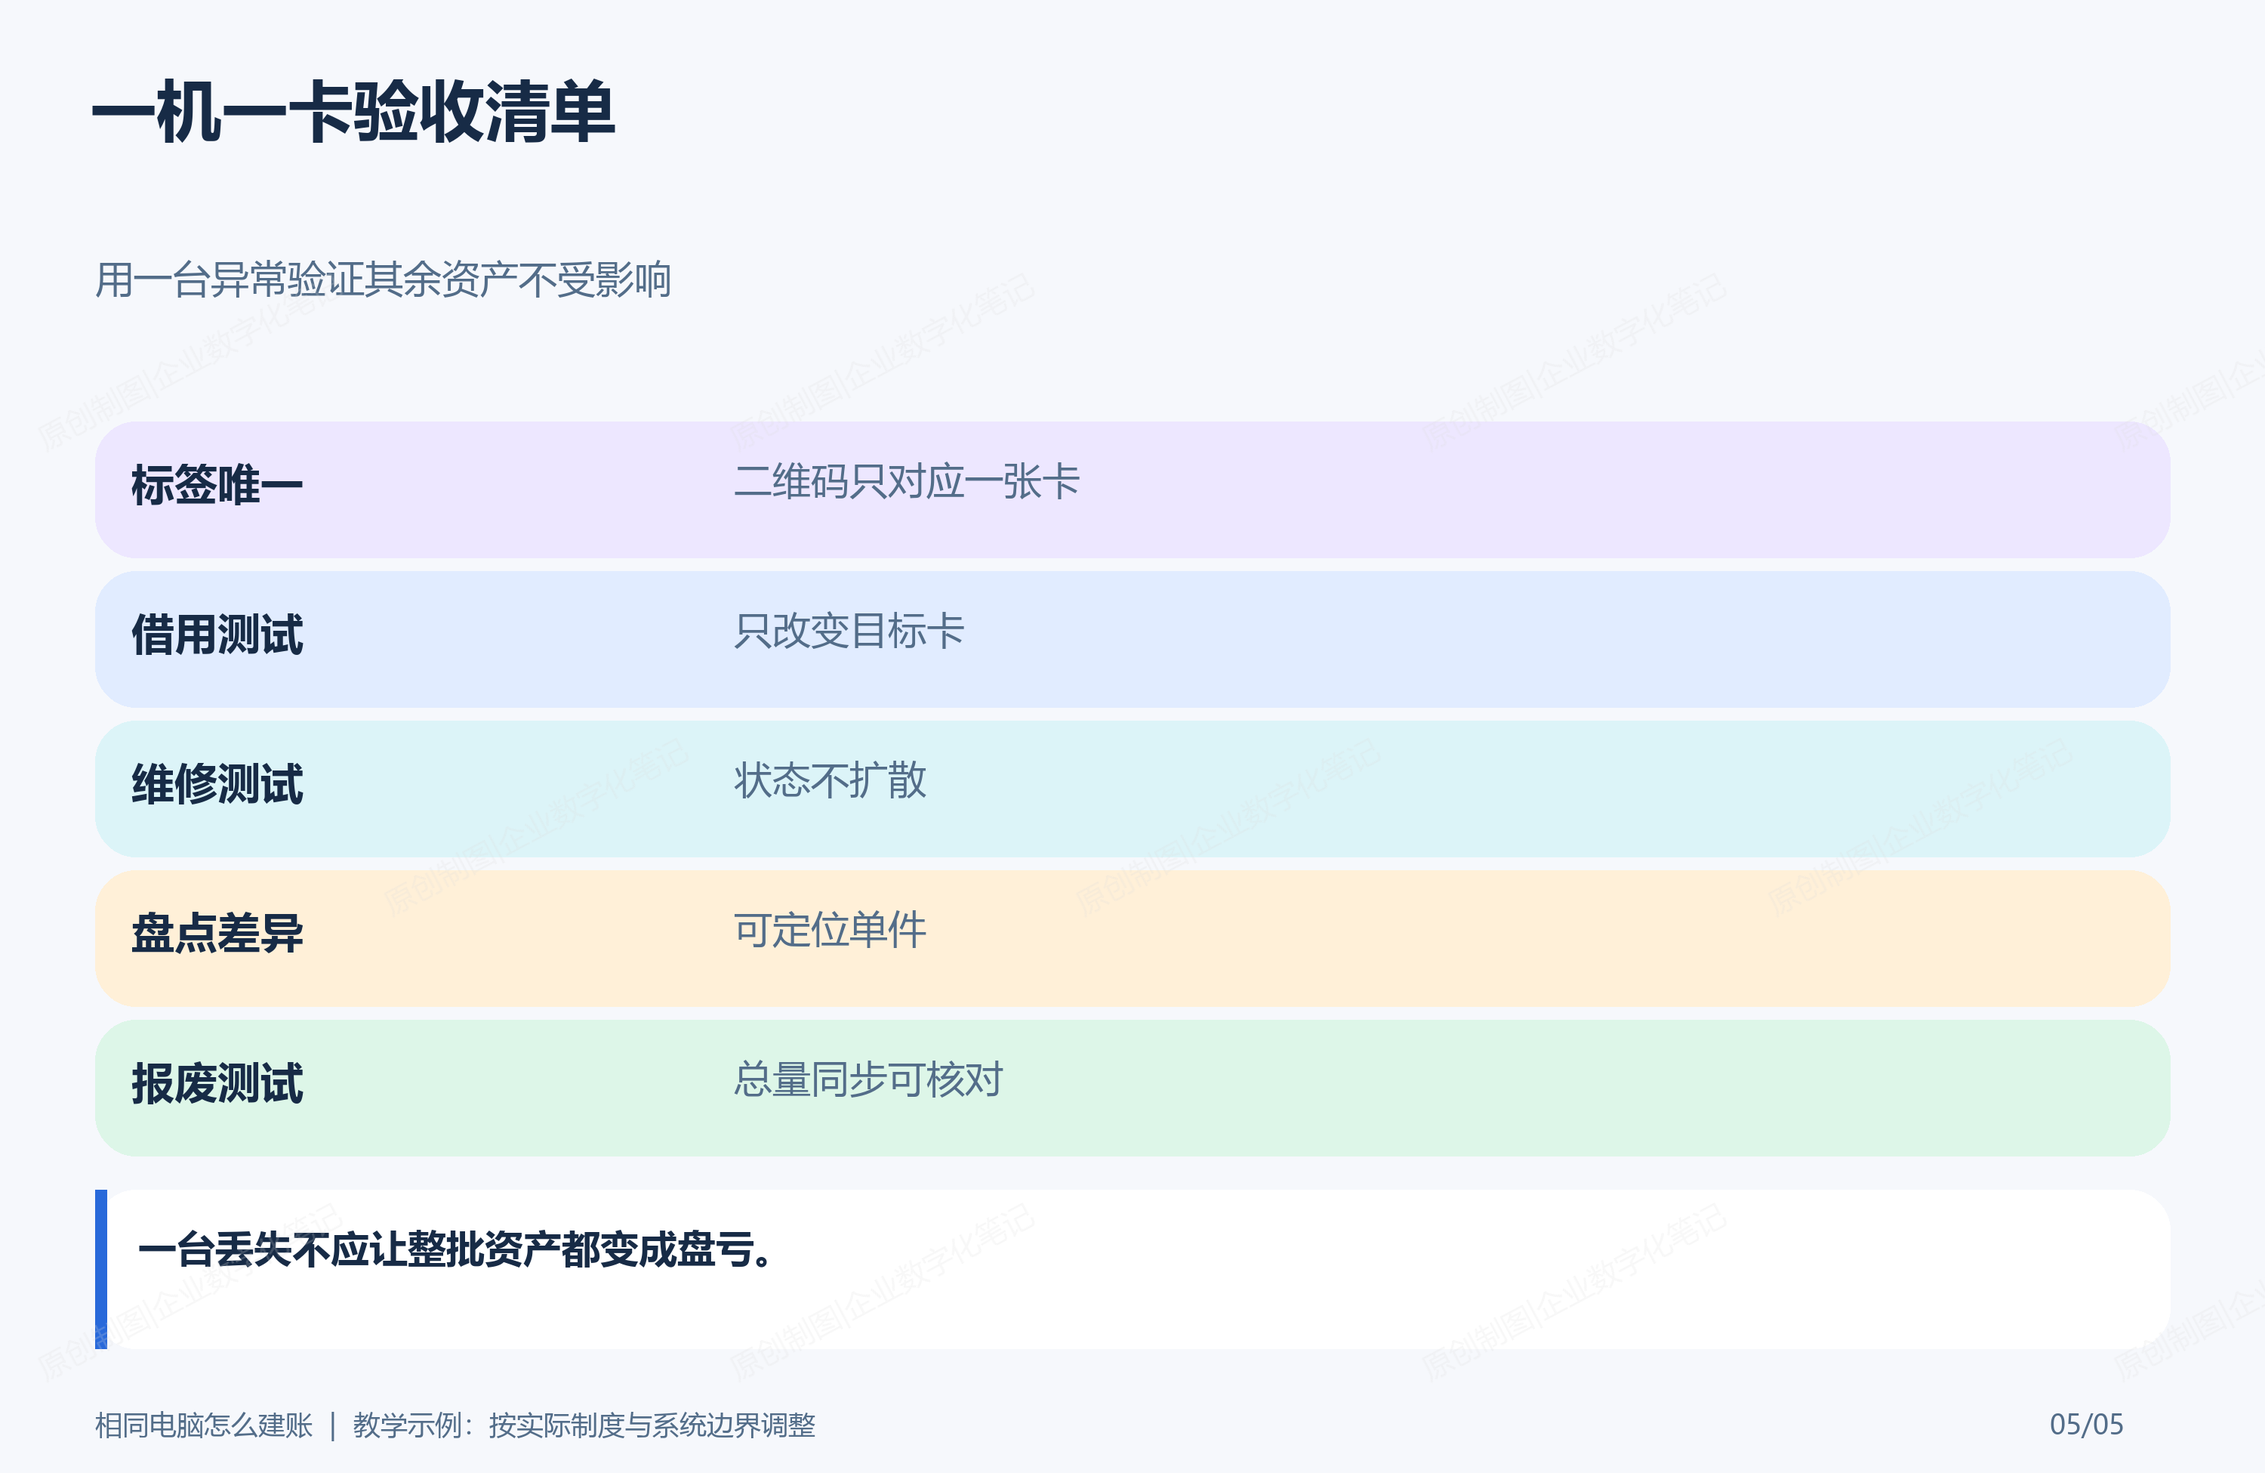
图5:一机一卡验收清单。
六、标签贴实物,状态跟卡走
二维码只指向唯一资产卡,不把“20台”印成一个可被多人扫描的编号。换使用人、维修、报废变更的是单件卡状态。
七、验收时专门模拟一台丢失
从20件中抽出一件做借用、维修、盘点差异和报废,检查其余19件不被误改。
八、服务层实现不能只相信页面参数
接口收到的公司、部门、状态和金额只能视为请求数据,不能直接当成已经校验的业务事实。服务层至少要重新加载当前记录、计算操作者范围、校验当前状态,并将业务结果写成可识别的返回对象。下面代码只展示关键边界,仓储方法、异常类型和审计方式需按项目实现。
@Transactional(rollbackFor = Exception.class)
public List<AssetCard> splitBatch(long batchId) {
AssetBatch batch = batchRepository.lockById(batchId);
if (cardRepository.existsByBatchId(batchId)) {
return cardRepository.listByBatchId(batchId);
}
MoneyAllocation allocation = allocator.divide(
batch.getTotalCost(), batch.getTotalQty(), RoundingMode.HALF_UP);
List<AssetCard> cards = IntStream.rangeClosed(1, batch.getTotalQty())
.mapToObj(seq -> cardFactory.fromBatch(batch, seq, allocation.amountAt(seq)))
.toList();
cardRepository.batchInsert(cards);
batchRepository.markSplit(batchId, cards.size());
return cards;
}
示例刻意没有让Controller拼接SQL,也没有让前端决定最终状态。这样做的价值是:批量任务、后台管理和普通页面调用同一服务时,仍遵循同一套规则。若方法会抛出受检异常,需要显式配置回滚规则;Spring默认回滚语义不应靠猜测。
九、事务、并发和外部调用的边界
拆分前锁定批次,并用批次ID唯一关系判断是否已经生成卡片。金额分摊要先在内存中完成并验证总和,再整体写入;若中途失败,批次状态和卡片都回滚。二维码图片等外部文件在事务提交后生成,可失败重试。
事务解决的是一个数据库边界内的一致性,不会自动撤销已发送的短信、已上传的对象存储文件或外部财务系统请求。遇到跨系统动作,应保存可重试任务、业务幂等键和最后错误,并让操作人员看见“业务已完成、同步待处理”这类真实状态。长事务还会扩大锁持有时间,因此批量操作要按可恢复的数据块处理。
十、失败结果要能指导下一步处理
异常不应全部压成“操作失败”。至少区分输入错误、业务冲突、权限拒绝、并发冲突和外部依赖失败;前四类通常需要用户修改或确认,最后一类才适合自动重试。本文案例建议使用以下结果:
| 数量为0或负数 | INVALID_QUANTITY | 拒绝拆分并定位来源单据 |
| 分摊出现尾差 | ALLOCATION_REMAINDER | 按固定规则归入最后一件 |
| 重复点击拆分 | BATCH_ALREADY_SPLIT | 返回既有卡片,不再生成 |
| 部分卡已有流转 | CANNOT_MERGE | 禁止合并,保留单件生命周期 |
错误回执或接口响应可以显示业务编号和友好说明,详细堆栈只进入受控日志。返回结果还应带request_id,便于把用户看到的失败与服务端日志、批次明细及审计记录关联起来。
十一、上线前用SQL核对业务结果
页面数量只能用来快速观察,最终验收还要在明确组织、期间和业务状态的前提下执行只读查询。下面查询用于发现不一致记录,生产环境应先补充分区或公司条件,并确认执行计划,避免在大表上做无范围扫描。
SELECT b.id,b.total_qty,COUNT(c.id) card_qty,
b.total_cost,SUM(c.unit_cost) card_cost
FROM asset_batch_demo b LEFT JOIN asset_card_demo c ON c.batch_id=b.id
GROUP BY b.id,b.total_qty,b.total_cost
HAVING card_qty<>b.total_qty OR card_cost<>b.total_cost;
若查询返回异常,先保留样本和执行时间,再判断是历史脏数据、迁移遗漏还是程序缺陷。不要为了让验收SQL返回零行而直接改库;修复必须经过与正常业务相同的授权、留痕和复核。
十二、可直接使用的技术验收表
正式发布前固定一组小样本,记录输入、预期、实际结果和证据位置。修复后仍用同一组样本复测,才能知道变化来自代码,而不是换了一批更容易通过的数据。
| 正常路径 | 业务结果、状态和关联记录符合预期 | 业务页面 + 数据库查询 |
| 重复操作 | 第二次执行不产生重复主记录 | 唯一键 + 行结果/业务结果 |
| 越权或非法状态 | 服务端拒绝,原数据不变化 | 低权限账号 + 更新前后对照 |
| 执行中断 | 可识别已完成与未完成范围 | 批次状态 + 明细状态 |
| 金额或数量 | 汇总与来源口径完全一致 | 固定样本 + SQL核对 |
| 追溯 | 能回到操作者、单据、时间和请求 | 审计时间轴 + request_id |
验收完成后保存程序版本、数据库版本、样本编号和结论。只写“测试通过”无法回答测试了哪些边界,也无法在下次升级后进行回归比较。
小结
一批相同的电脑怎么建账,核心不是把页面操作做出来,而是让每一步都能说明输入、边界、结果和验证证据。先用小样本走通,再按实际数据量和业务制度扩大范围。
参考资料
- MySQL 8.4:SHOW CREATE TABLE
- Spring Framework:声明式事务管理
- MySQL 8.4:定点数类型


评论前必须登录!
注册