 网硕互联帮助中心
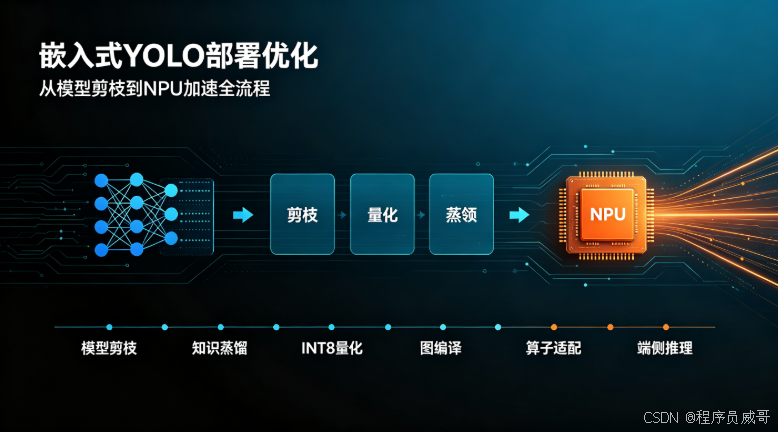
在嵌入式端部署YOLO系列模型时,多数开发者都会遇到同一个核心矛盾:算法侧的精度需求与硬件侧的算力、内存、功耗约束。很多人只停留在“转模型、跑通推理”的阶段,最终得到的推理速度慢、内存占用高、精度损失大,距离量产落地还有很大差距。
实际上,嵌入式端的YOLO优化是一个全链路工程,不是单一量化就能解决的问题。从模型侧的剪枝、蒸馏,到部署侧的量化、图编译,再到NPU端的算子适配与内存优化,每个环节都会直接影响最终的性能与精度。本文将从实战角度完整梳理整条优化链路,结合实际项目踩坑经验,给出可落地的优化方案与调优思路。
整体优化链路框架
我们将整个优化过程拆解为6个核心阶段,形成闭环迭代的优化流程,每个阶段都有明确的优化目标与验证标准:
#mermaid-svg-HV9aLfft4XClYaO2{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-HV9aLfft4XClYaO2 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-HV9aLfft4XClYaO2 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-HV9aLfft4XClYaO2 .error-icon{fill:#552222;}#mermaid-svg-HV9aLfft4XClYaO2 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-HV9aLfft4XClYaO2 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-HV9aLfft4XClYaO2 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-HV9aLfft4XClYaO2 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-HV9aLfft4XClYaO2 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-HV9aLfft4XClYaO2 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-HV9aLfft4XClYaO2 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-HV9aLfft4XClYaO2 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-HV9aLfft4XClYaO2 .marker.cross{stroke:#333333;}#mermaid-svg-HV9aLfft4XClYaO2 svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-HV9aLfft4XClYaO2 p{margin:0;}#mermaid-svg-HV9aLfft4XClYaO2 .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-HV9aLfft4XClYaO2 .cluster-label text{fill:#333;}#mermaid-svg-HV9aLfft4XClYaO2 .cluster-label span{color:#333;}#mermaid-svg-HV9aLfft4XClYaO2 .cluster-label span p{background-color:transparent;}#mermaid-svg-HV9aLfft4XClYaO2 .label text,#mermaid-svg-HV9aLfft4XClYaO2 span{fill:#333;color:#333;}#mermaid-svg-HV9aLfft4XClYaO2 .node rect,#mermaid-svg-HV9aLfft4XClYaO2 .node circle,#mermaid-svg-HV9aLfft4XClYaO2 .node ellipse,#mermaid-svg-HV9aLfft4XClYaO2 .node polygon,#mermaid-svg-HV9aLfft4XClYaO2 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-HV9aLfft4XClYaO2 .rough-node .label text,#mermaid-svg-HV9aLfft4XClYaO2 .node .label text,#mermaid-svg-HV9aLfft4XClYaO2 .image-shape .label,#mermaid-svg-HV9aLfft4XClYaO2 .icon-shape .label{text-anchor:middle;}#mermaid-svg-HV9aLfft4XClYaO2 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-HV9aLfft4XClYaO2 .rough-node .label,#mermaid-svg-HV9aLfft4XClYaO2 .node .label,#mermaid-svg-HV9aLfft4XClYaO2 .image-shape .label,#mermaid-svg-HV9aLfft4XClYaO2 .icon-shape .label{text-align:center;}#mermaid-svg-HV9aLfft4XClYaO2 .node.clickable{cursor:pointer;}#mermaid-svg-HV9aLfft4XClYaO2 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-HV9aLfft4XClYaO2 .arrowheadPath{fill:#333333;}#mermaid-svg-HV9aLfft4XClYaO2 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-HV9aLfft4XClYaO2 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-HV9aLfft4XClYaO2 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-HV9aLfft4XClYaO2 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-HV9aLfft4XClYaO2 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-HV9aLfft4XClYaO2 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-HV9aLfft4XClYaO2 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-HV9aLfft4XClYaO2 .cluster text{fill:#333;}#mermaid-svg-HV9aLfft4XClYaO2 .cluster span{color:#333;}#mermaid-svg-HV9aLfft4XClYaO2 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-HV9aLfft4XClYaO2 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-HV9aLfft4XClYaO2 rect.text{fill:none;stroke-width:0;}#mermaid-svg-HV9aLfft4XClYaO2 .icon-shape,#mermaid-svg-HV9aLfft4XClYaO2 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-HV9aLfft4XClYaO2 .icon-shape p,#mermaid-svg-HV9aLfft4XClYaO2 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-HV9aLfft4XClYaO2 .icon-shape .label rect,#mermaid-svg-HV9aLfft4XClYaO2 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-HV9aLfft4XClYaO2 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-HV9aLfft4XClYaO2 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-HV9aLfft4XClYaO2 :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
迭代调优
原始YOLO模型
基线测试与指标确认
结构化剪枝 稀疏训练
知识蒸馏 精度补偿
INT8量化校准 PTQ/QAT
NPU图编译 算子适配
端侧推理部署
性能Profiling 瓶颈定位
量产落地
一、优化前的基线建立与核心原则
在开始任何优化之前,必须先建立清晰的基线,否则所有优化都没有衡量标准。很多人上来就直接剪枝、量化,最后连精度损失了多少、性能提升了多少都说不清楚。
二、模型侧轻量化:结构化剪枝的实战落地
剪枝是嵌入式端YOLO优化的第一步,也是性价比最高的优化手段。它通过移除模型中冗余的通道与层,在尽量少损失精度的前提下,直接降低模型的计算量与参数量。
剪枝方案选型
YOLO模型中存在大量冗余的卷积通道,尤其是在骨干网络与颈部网络中,很多通道的输出激活值接近0,对最终检测结果贡献极小。
目前主流的剪枝方案分为两类:
- 非结构化剪枝:对单个权重进行剪枝,理论压缩比高,但需要特殊的推理引擎支持,嵌入式端落地难度大,不推荐。
- 结构化剪枝:以通道、层为单位进行剪枝,兼容性好,直接适配所有推理引擎与NPU平台,是嵌入式端的首选方案。
稀疏训练与剪枝流程
结构化剪枝的核心是先通过稀疏训练让模型的通道权重变得稀疏,再根据权重大小筛选并移除冗余通道。完整流程分为三步:
核心稀疏训练代码片段:
# BN层L1稀疏化正则,训练时每个step调用
def update_bn_sparsity(model, sparsity=0.001):
for m in model.modules():
if isinstance(m, nn.BatchNorm2d):
m.weight.grad.data.add_(sparsity * torch.sign(m.weight.data))
剪枝的关键细节与避坑
- 剪枝比例不要一次性过高:首次剪枝建议控制在20%-30%,根据精度情况逐步提升。对于YOLOv8n这类本身已经很轻量的模型,剪枝比例超过40%后精度会快速下降。
- 保护关键层:检测头、shortcut连接、上采样层的通道不要剪,否则会导致模型结构损坏或精度暴跌。
- 分层设置剪枝阈值:骨干网络的冗余度更高,可以适当提高剪枝比例;颈部网络和检测头的剪枝比例要更低。
- 不要直接剪枝预训练模型:必须在业务数据集上先微调,再进行稀疏训练和剪枝,否则精度损失会非常大。
三、精度补偿:知识蒸馏的嵌入式适配方案
剪枝后的模型参数量减少,表达能力会下降,尤其是小目标检测和细分类别,精度损失会更明显。知识蒸馏是目前最有效的精度补偿手段,通过大模型(教师)引导小模型(学生)学习,让小模型在参数量不变的前提下,获得更接近大模型的精度。
蒸馏策略的选择
针对YOLO检测模型,常用的蒸馏方案有两种:
- Logits蒸馏:让学生模型的输出分布拟合教师模型的输出分布,实现简单,适合检测头的蒸馏。
- 特征蒸馏:让学生模型的中间特征图拟合教师模型的中间特征图,对骨干网络和颈部网络的效果更好,是更推荐的方案。
嵌入式端的蒸馏不需要追求极致复杂的蒸馏算法,基础的特征蒸馏+Logits蒸馏组合就足够。过于复杂的蒸馏算法不仅训练成本高,在小模型上的收益也很有限。
蒸馏的实操要点
- 教师模型的选择:不要选择参数量过大的模型,比如用YOLOv8l作为教师蒸馏YOLOv8n,收益并不明显。通常选择比学生模型大一个量级的模型即可,比如YOLOv8s作为教师,YOLOv8n作为学生。
- 温度系数:Logits蒸馏的温度系数建议设置在3-5之间,温度过高会导致分布过于平滑,温度过低则起不到蒸馏效果。
- 损失权重:特征蒸馏的权重不要设置过高,一般控制在总损失的10%-20%,否则会干扰学生模型的正常学习。
- 蒸馏时机:建议在剪枝之后、量化之前进行蒸馏,先把剪枝损失的精度补回来,再进行量化,避免精度叠加损失。
四、部署侧量化:INT8量化与校准的关键细节
量化是将模型的浮点权重和激活值转换为定点整数(通常是INT8),可以直接降低内存占用、提升推理速度,同时也是NPU硬件加速的基础。嵌入式端90%以上的性能提升,都来自于INT8量化。
量化方案的选型
目前主流的量化方案分为两类:
- PTQ(训练后量化):不需要重新训练,只需要少量校准数据,通过统计激活值的分布完成量化。优点是速度快、成本低,是嵌入式端的首选方案。
- QAT(量化感知训练):在训练过程中模拟量化误差,精度更高,但需要完整的训练流程,开发成本高。只有当PTQ的精度损失无法接受时,才考虑使用QAT。
对于多数嵌入式YOLO部署场景,PTQ已经足够满足需求,只有在小目标、低光照等复杂场景下,才需要考虑QAT。
量化校准的核心要点
量化的精度损失主要来自激活值的量化误差,而校准集的质量直接决定了量化精度。
- 校准集的选择:必须使用业务场景的真实数据,不能用COCO等通用数据集。校准集的数量建议在100-500张,覆盖不同光照、角度、目标密度的场景。
- 校准方法:优先选择KL散度校准,其次是均方误差校准。对于检测模型,不要使用简单的最大值校准,会导致严重的精度损失。
- 量化粒度:优先使用per-channel量化(按通道量化),相比per-tensor(按层量化),精度损失更小,大部分NPU平台都已经支持。
- 量化节点折叠:将BN层的参数折叠到卷积层中,减少量化节点,同时提升推理速度。
量化的避坑经验
- 不要直接量化剪枝后的模型:必须先微调恢复精度,再进行量化,否则精度会叠加损失。
- 检测头单独处理:检测头的输出对量化误差更敏感,可以将检测头保持FP16,只量化骨干和颈部网络,在性能损失很小的前提下,大幅降低精度损失。
- 验证量化一致性:量化完成后,必须对比PC端和端侧的推理结果,确保误差在可接受范围内。如果出现结果偏差,优先检查预处理的归一化、通道顺序和量化参数。
五、NPU硬件加速:算子适配与图编译优化
模型剪枝、量化完成后,需要转换为NPU支持的模型格式,通过图编译和算子映射,充分利用NPU的硬件算力。这一步是嵌入式端性能提升的核心,也是最容易踩坑的环节。
NPU推理的核心流程
不同NPU平台的编译工具不同,但核心流程基本一致:
算子适配与优化
NPU的性能优势建立在算子硬件加速的基础上,如果模型中存在大量不支持的算子,会导致频繁的CPU-NPU数据交互,性能甚至不如纯CPU推理。
- 优先使用NPU支持的算子:比如将SiLU激活替换为ReLU,将Swish替换为ReLU6,避免使用复杂的自定义算子。
- 不支持算子的处理:对于NPU不支持的算子,优先用支持的算子组合实现;无法替换的,尽量放在模型的开头或结尾,减少数据拷贝次数。
- 避免动态Shape:NPU对固定输入尺寸的优化最好,尽量使用固定尺寸输入,避免动态Resize、动态Padding等操作。
图编译阶段的优化
- 开启内存复用:大部分NPU编译工具都支持内存复用选项,可以大幅降低运行时内存占用,通常可以减少30%-50%的内存。
- 开启算子融合:将卷积、BN、激活融合为一个算子,减少内存访问和计算开销。
- 调整编译优先级:可以根据业务需求,在编译时选择“性能优先”或“精度优先”模式。
六、端侧性能调优与瓶颈定位
完成模型转换和部署后,还需要通过性能分析找到瓶颈,进行针对性调优。很多时候模型本身已经优化到位,但端侧的预处理、后处理、内存拷贝会成为新的瓶颈。
性能瓶颈定位
首先使用平台自带的Profiling工具,统计每个环节的耗时:
- 模型编译阶段:RKNN Toolkit的性能分析工具、Tengine Profiler、NCNN Benchmark。
- 系统级分析:使用perf、top、free等工具,查看CPU占用、内存占用、NPU利用率。
常见的瓶颈点:
- 预处理耗时过长:图像Resize、归一化、通道转换占用大量CPU时间。
- 内存拷贝频繁:CPU和NPU之间的内存拷贝、输入输出数据的格式转换。
- NPU利用率低:算子不支持、计算图碎片化、输入尺寸不合理。
- 后处理耗时:NMS、坐标转换、结果过滤,尤其是目标数量较多时。
针对性调优方案
- 预处理加速:将预处理操作(Resize、归一化、通道转换)放到NPU上执行,或者使用硬件ISP、DMA加速;使用零拷贝内存,避免数据在CPU和NPU之间反复拷贝。
- 内存优化:使用共享内存、内存池,避免频繁的内存申请与释放;特征图内存复用,减少峰值内存占用。
- 后处理优化:将NMS放到NPU上执行,或者使用更高效的NMS算法;根据业务场景过滤掉无效检测框,减少后处理计算量。
- 流水线调度:将图像采集、预处理、推理、后处理流水线化,充分利用CPU和NPU的并行能力,提升整体吞吐量。
七、实战效果与性能对比
我们以YOLOv8n为例,在RK3588平台上进行了完整的全链路优化,输入尺寸640×640,测试数据为业务场景数据集,优化前后的性能对比如下:
| 原始FP16 | 0.682 | 45.2 | 128 | 1.0x |
| 剪枝30% | 0.675 | 32.7 | 96 | 1.38x |
| 剪枝+蒸馏 | 0.680 | 32.7 | 96 | 1.38x |
| 剪枝+蒸馏+INT8量化 | 0.672 | 16.3 | 64 | 2.77x |
| 全链路优化+NPU调优 | 0.670 | 14.8 | 58 | 3.05x |
可以看到,通过全链路优化,推理速度提升了3倍以上,内存占用降低了55%,而精度损失仅为1.2%,完全满足业务需求。
八、常见踩坑与排障指南
1. 剪枝后模型精度暴跌
- 检查是否剪到了shortcut、检测头等关键层;
- 剪枝比例是否过高,降低剪枝比例后重新测试;
- 稀疏训练的正则系数是否过大,导致模型收敛异常;
- 剪枝后是否进行了足够的微调,建议至少微调10-20个epoch。
2. 量化后小目标漏检严重
- 校准集中是否包含足够的小目标样本,补充对应场景的校准数据;
- 切换为per-channel量化,调整校准方法;
- 检测头保持FP16精度,不参与量化;
- 如果PTQ精度无法满足,尝试使用QAT量化。
3. NPU推理速度远低于预期
- 检查算子支持情况,是否有大量算子回退到CPU;
- 输入尺寸是否过大,NPU的算力利用率随输入尺寸变化明显;
- 是否开启了内存复用、算子融合等编译优化选项;
- 检查是否存在频繁的CPU-NPU数据拷贝,使用零拷贝内存优化。
4. 端侧推理结果与PC端不一致
- 检查预处理的归一化参数、通道顺序(RGB/BGR)、图像插值方式是否一致;
- 检查量化参数是否正确,是否存在溢出或截断;
- 部分NPU平台的算子实现与PC端存在微小差异,属于正常现象,只要误差在业务可接受范围内即可。
总结
嵌入式端YOLO的优化不是单点优化,而是一个从模型到部署、从软件到硬件的全链路工程。优化的核心思路是:先通过剪枝和蒸馏在模型侧做轻量化与精度补偿,再通过量化和NPU编译充分释放硬件算力,最后通过端侧调优解决预处理、后处理和内存瓶颈。
不同硬件平台、不同业务场景的最优方案差异很大,不要盲目套用极致压缩比,要根据实际的精度、性能、内存需求,找到最适合的平衡点。所有优化都必须在真实业务场景下验证,避免在通用数据集上“自嗨”。


评论前必须登录!
注册