 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
💖💖作者:计算机编程小咖 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 转转网二手手机数据可视化分析系统介绍
- 转转网二手手机数据可视化分析系统演示视频
- 转转网二手手机数据可视化分析系统演示图片
- 转转网二手手机数据可视化分析系统代码展示
- 转转网二手手机数据可视化分析系统文档展示
转转网二手手机数据可视化分析系统介绍
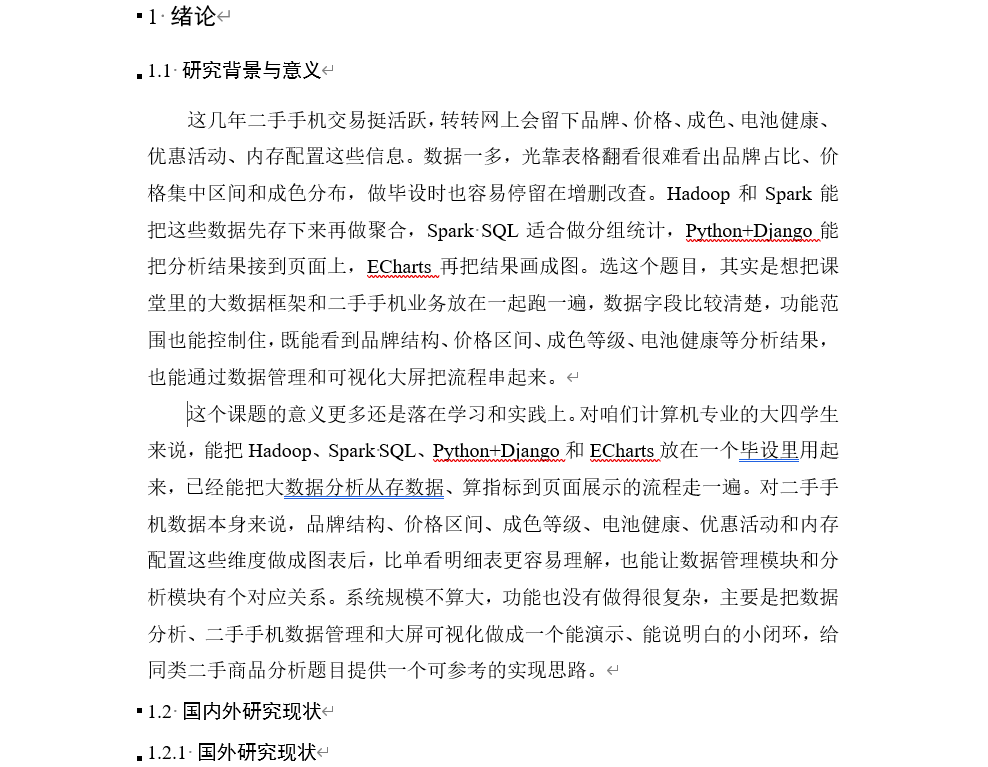
本系统名为《基于大数据的转转网二手手机数据可视化分析》,主要围绕转转网二手手机数据做存储、清洗、统计和可视化展示。系统后端采用Python+Django实现接口,大数据部分使用Hadoop与HDFS完成数据存储,借助Spark和Spark SQL对二手手机数据做分组聚合,Pandas与NumPy参与数据整理和指标计算,MySQL保存业务数据与分析结果。前端使用Vue、ElementUI、ECharts、HTML、CSS、JavaScript和jQuery完成页面交互和图表展示。功能上包括系统首页、数据分析、品牌结构分析、价格区间分析、成色等级分析、电池健康分析、优惠活动分析、内存配置分析、产品画像分析、用户管理、二手手机数据管理、大屏可视化、个人信息和修改密码。系统把品牌、价格、成色、电池健康、优惠活动、内存配置等字段整理成图表和指标,让二手手机数据看起来更直观。二手手机数据管理模块负责数据维护,分析模块输出统计结果,大屏可视化把多个分析维度集中展示,用户模块负责登录后的个人信息和密码修改。整体上,本系统是一个围绕二手手机数据做大数据分析和可视化展示的毕业设计系统。
转转网二手手机数据可视化分析系统演示视频
点击观看项目演示视频
转转网二手手机数据可视化分析系统演示图片
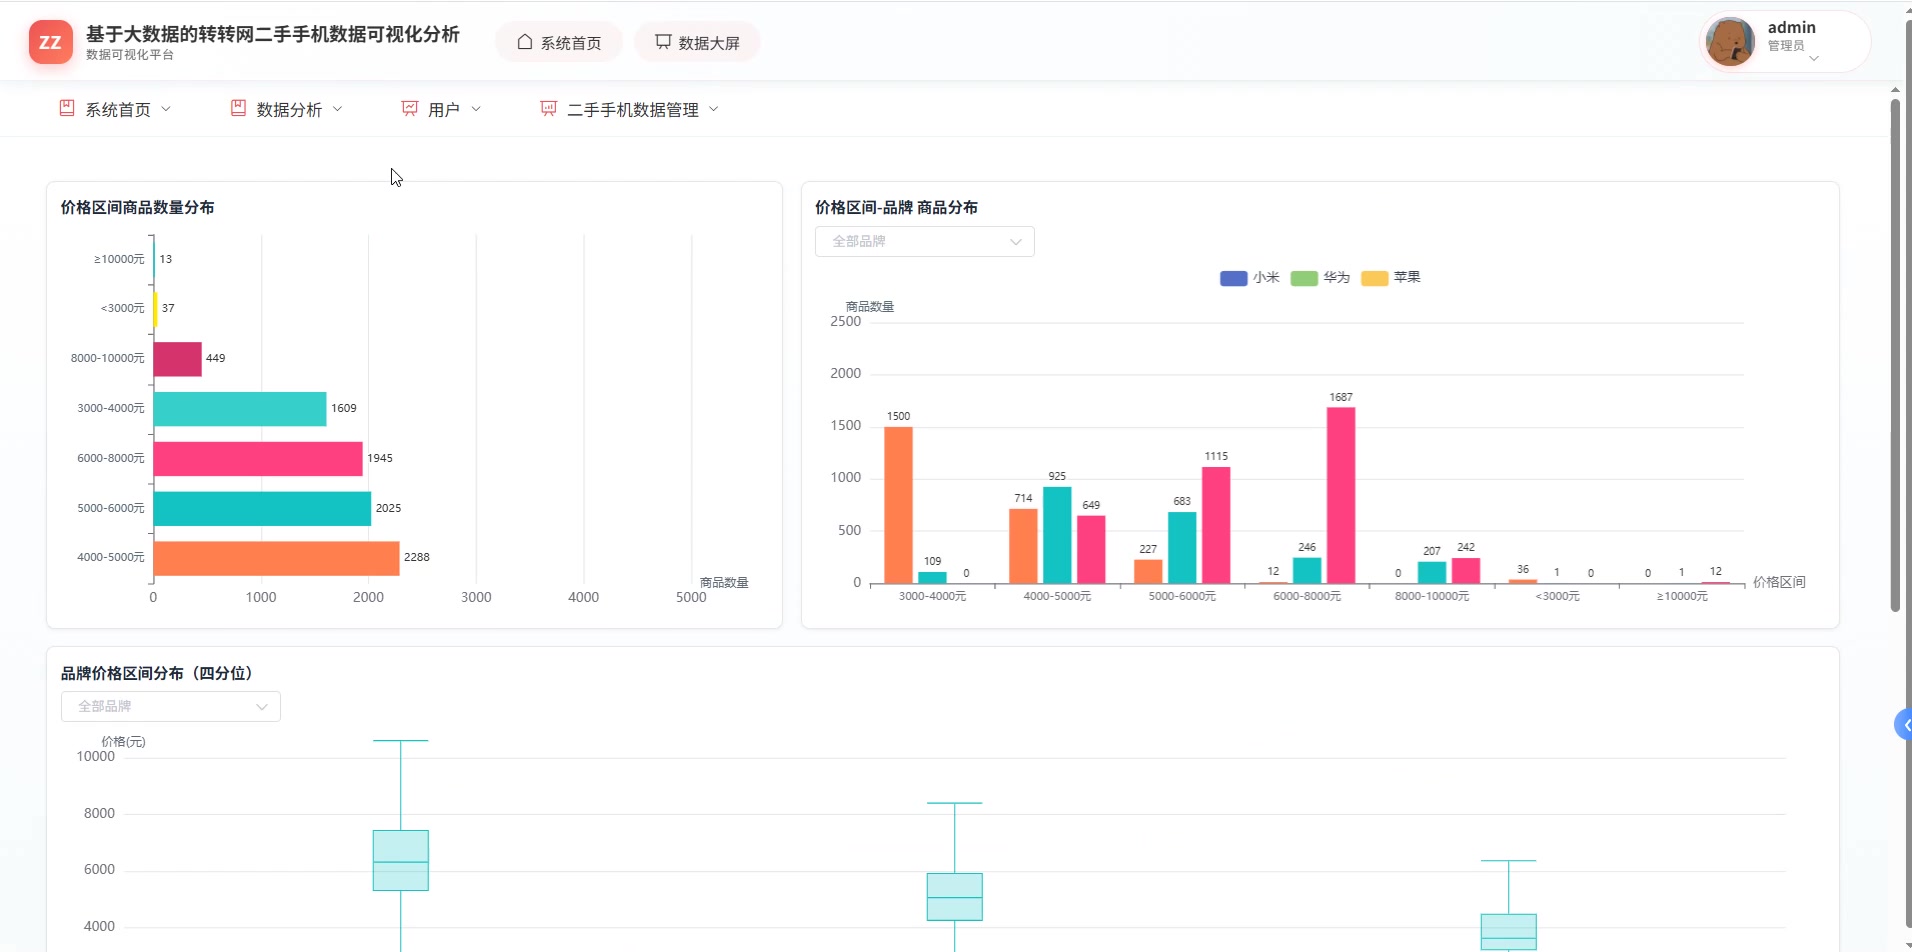
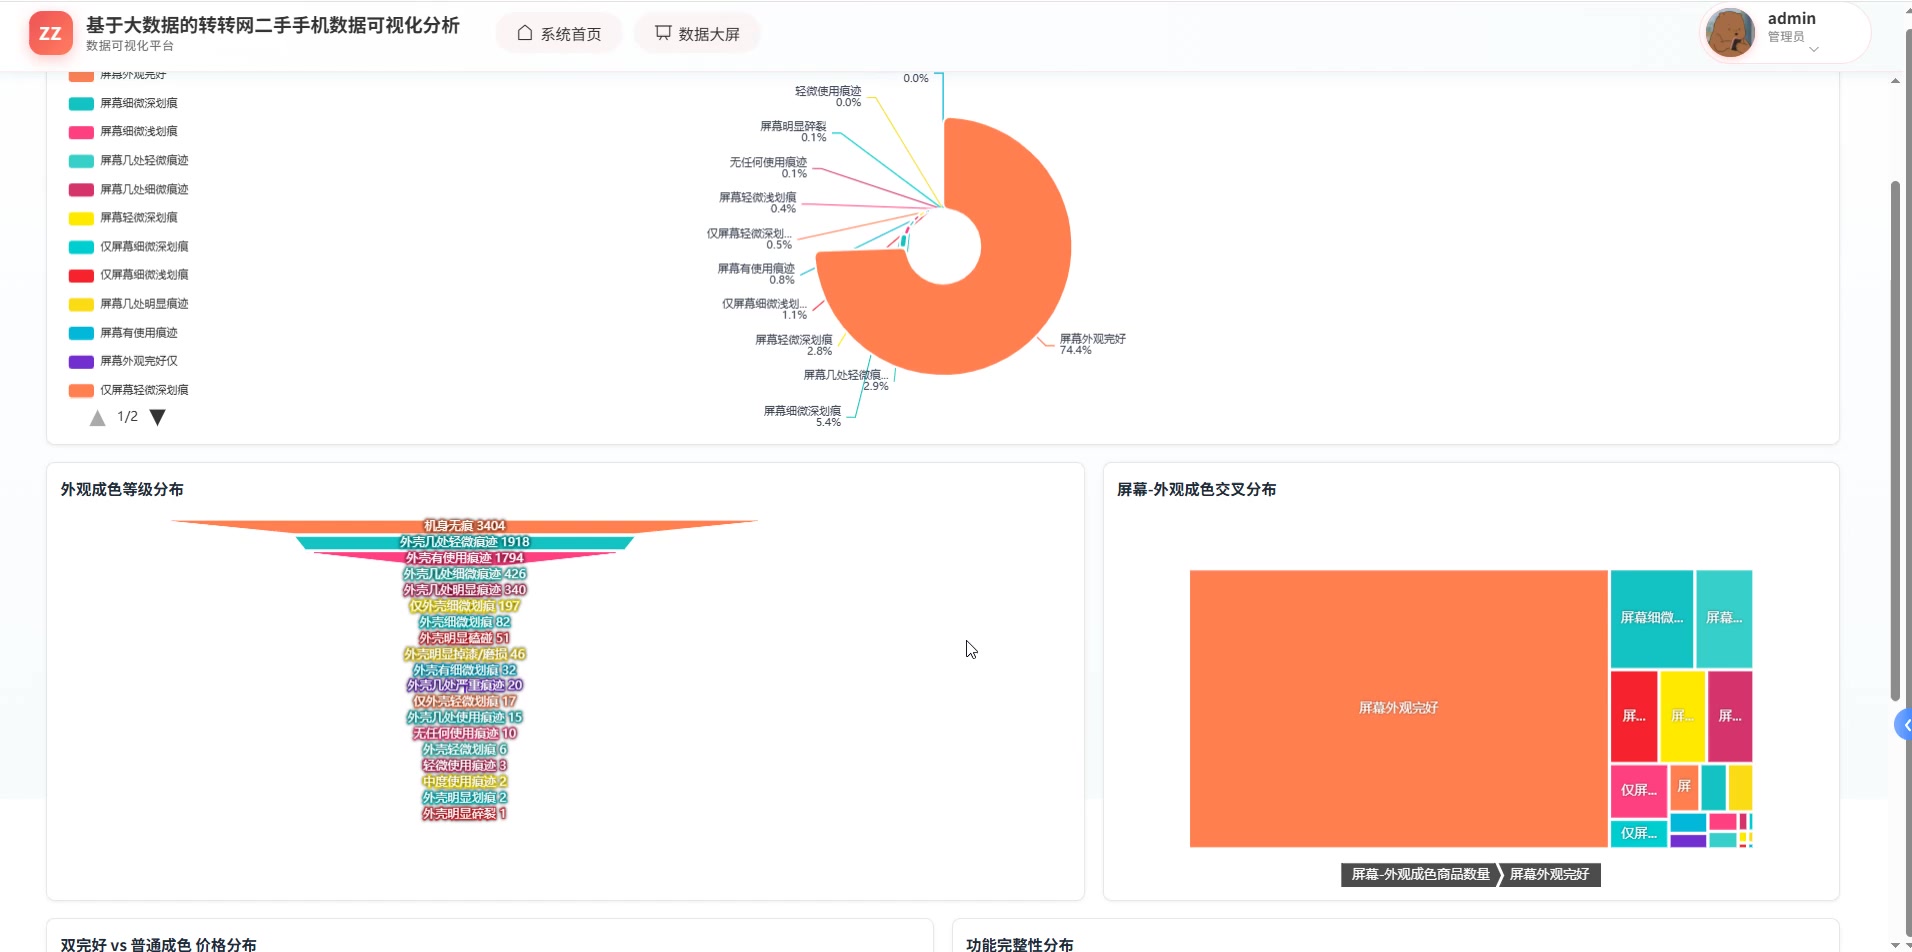
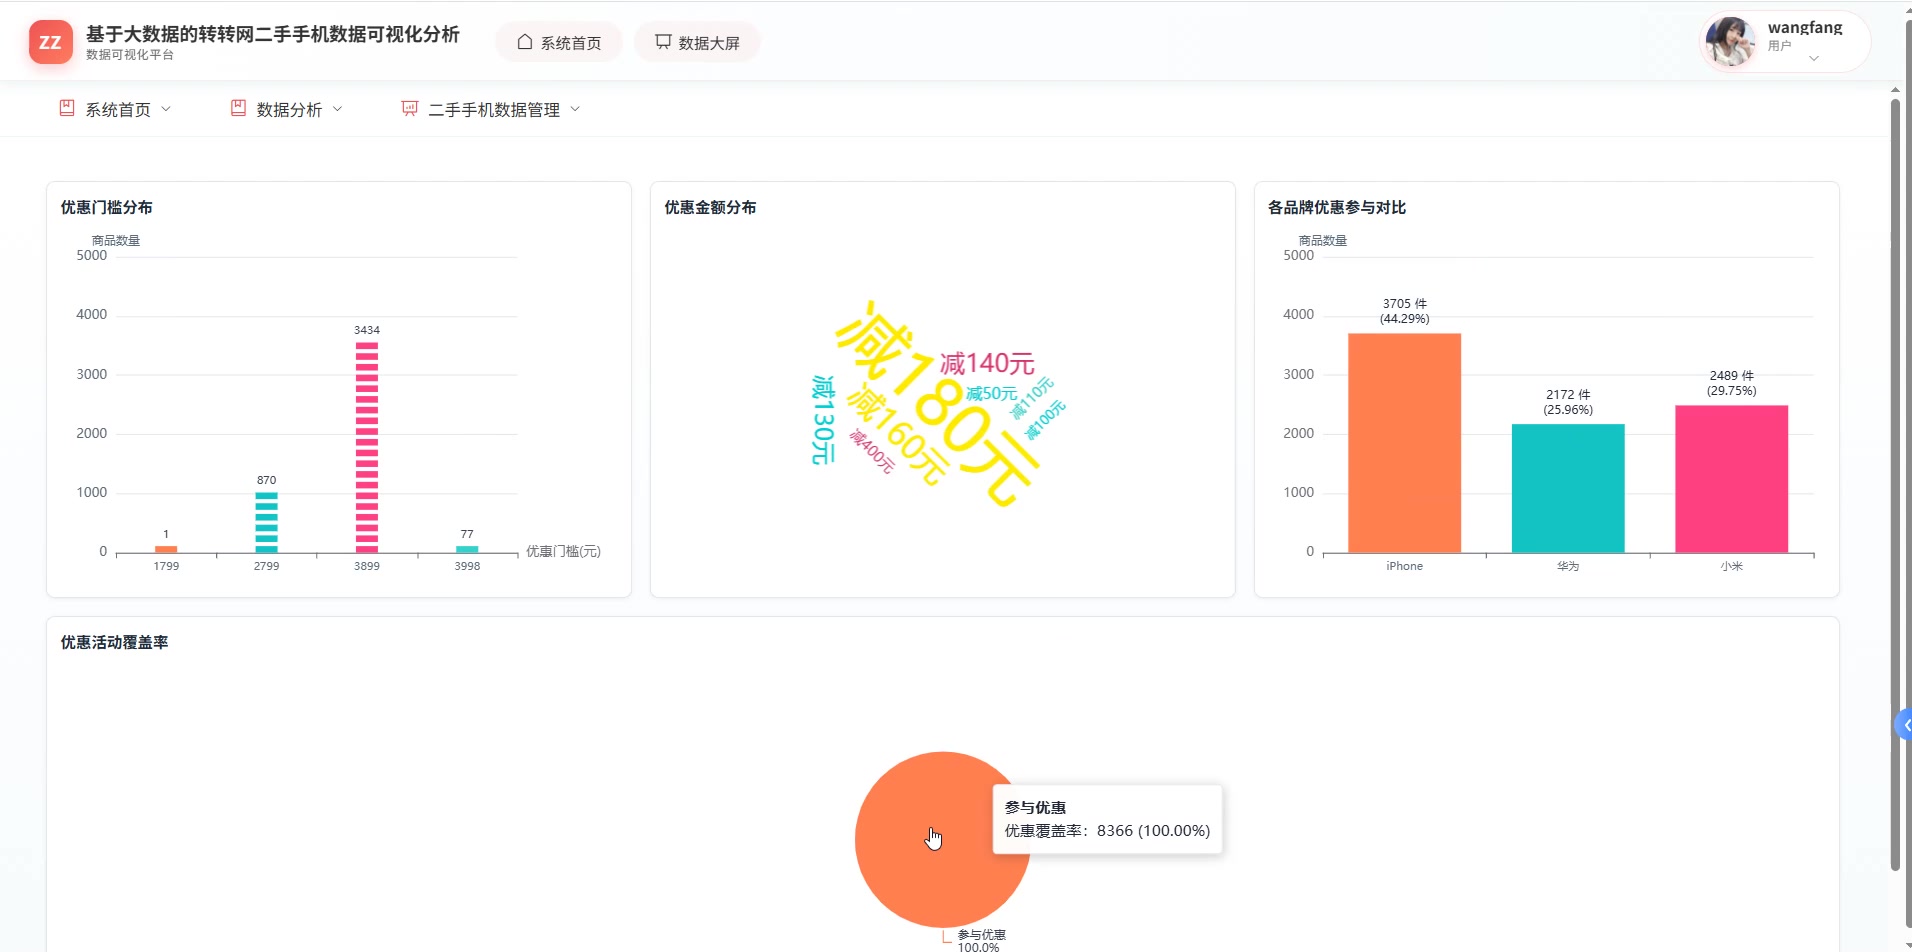
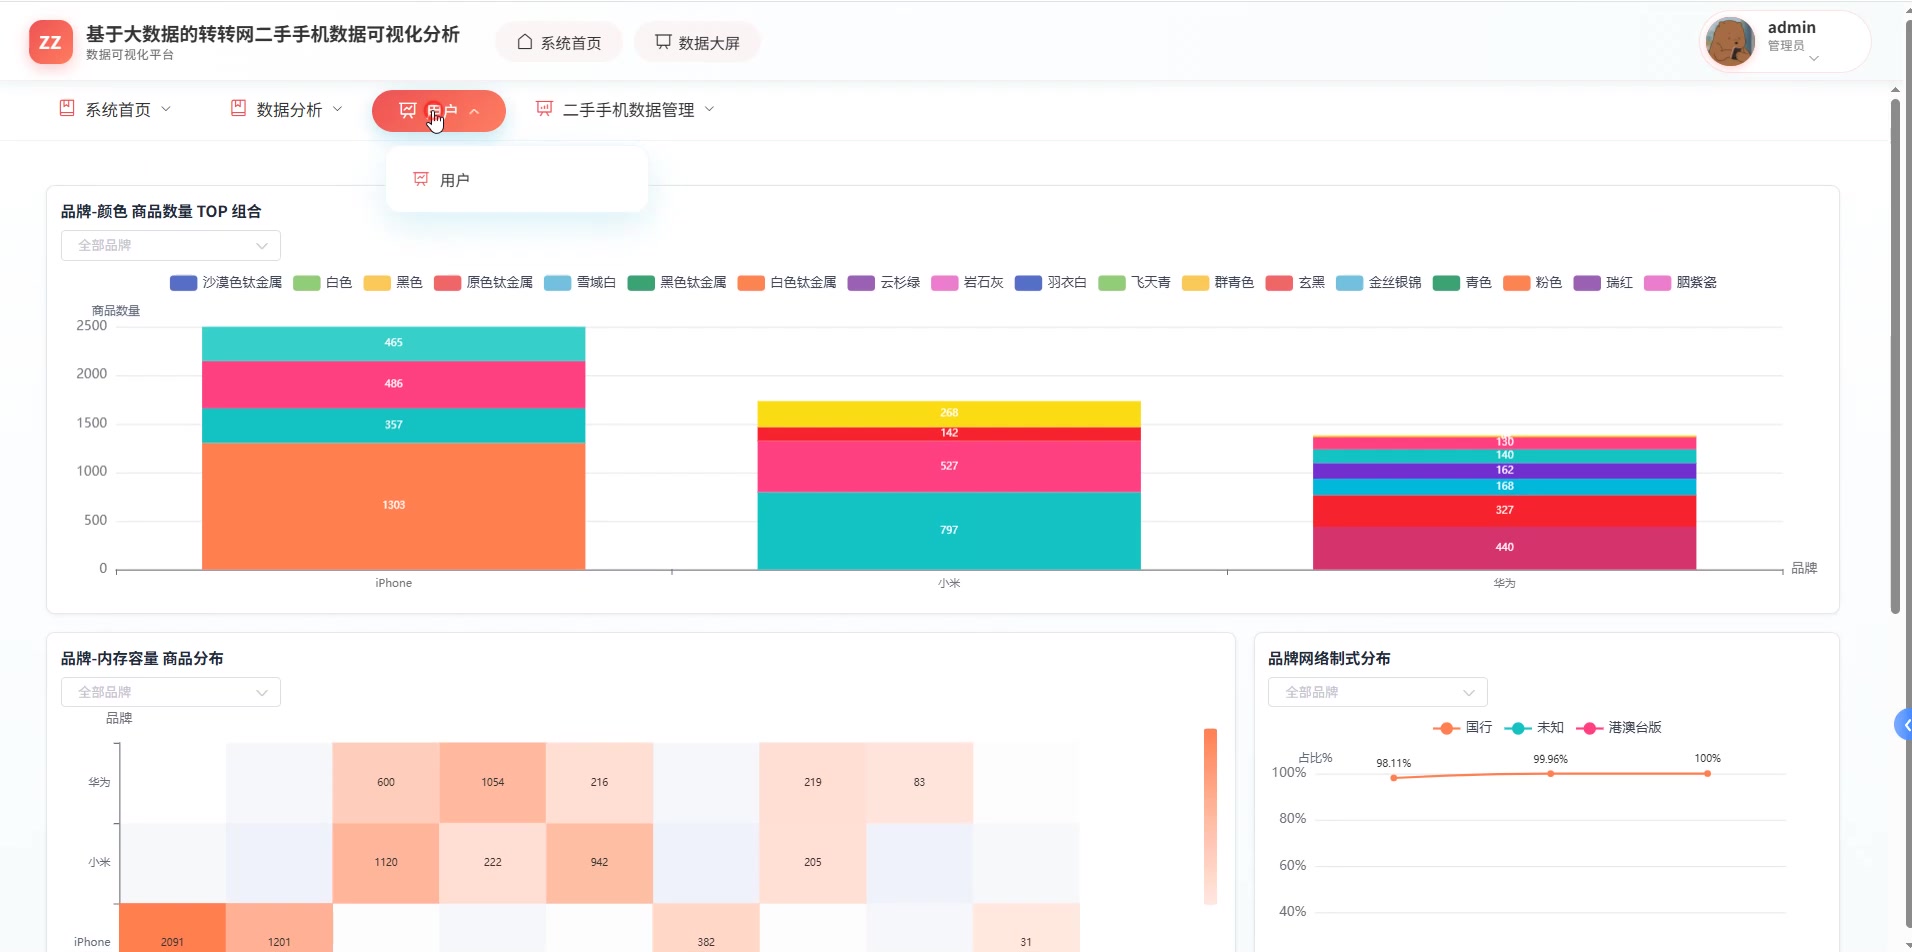
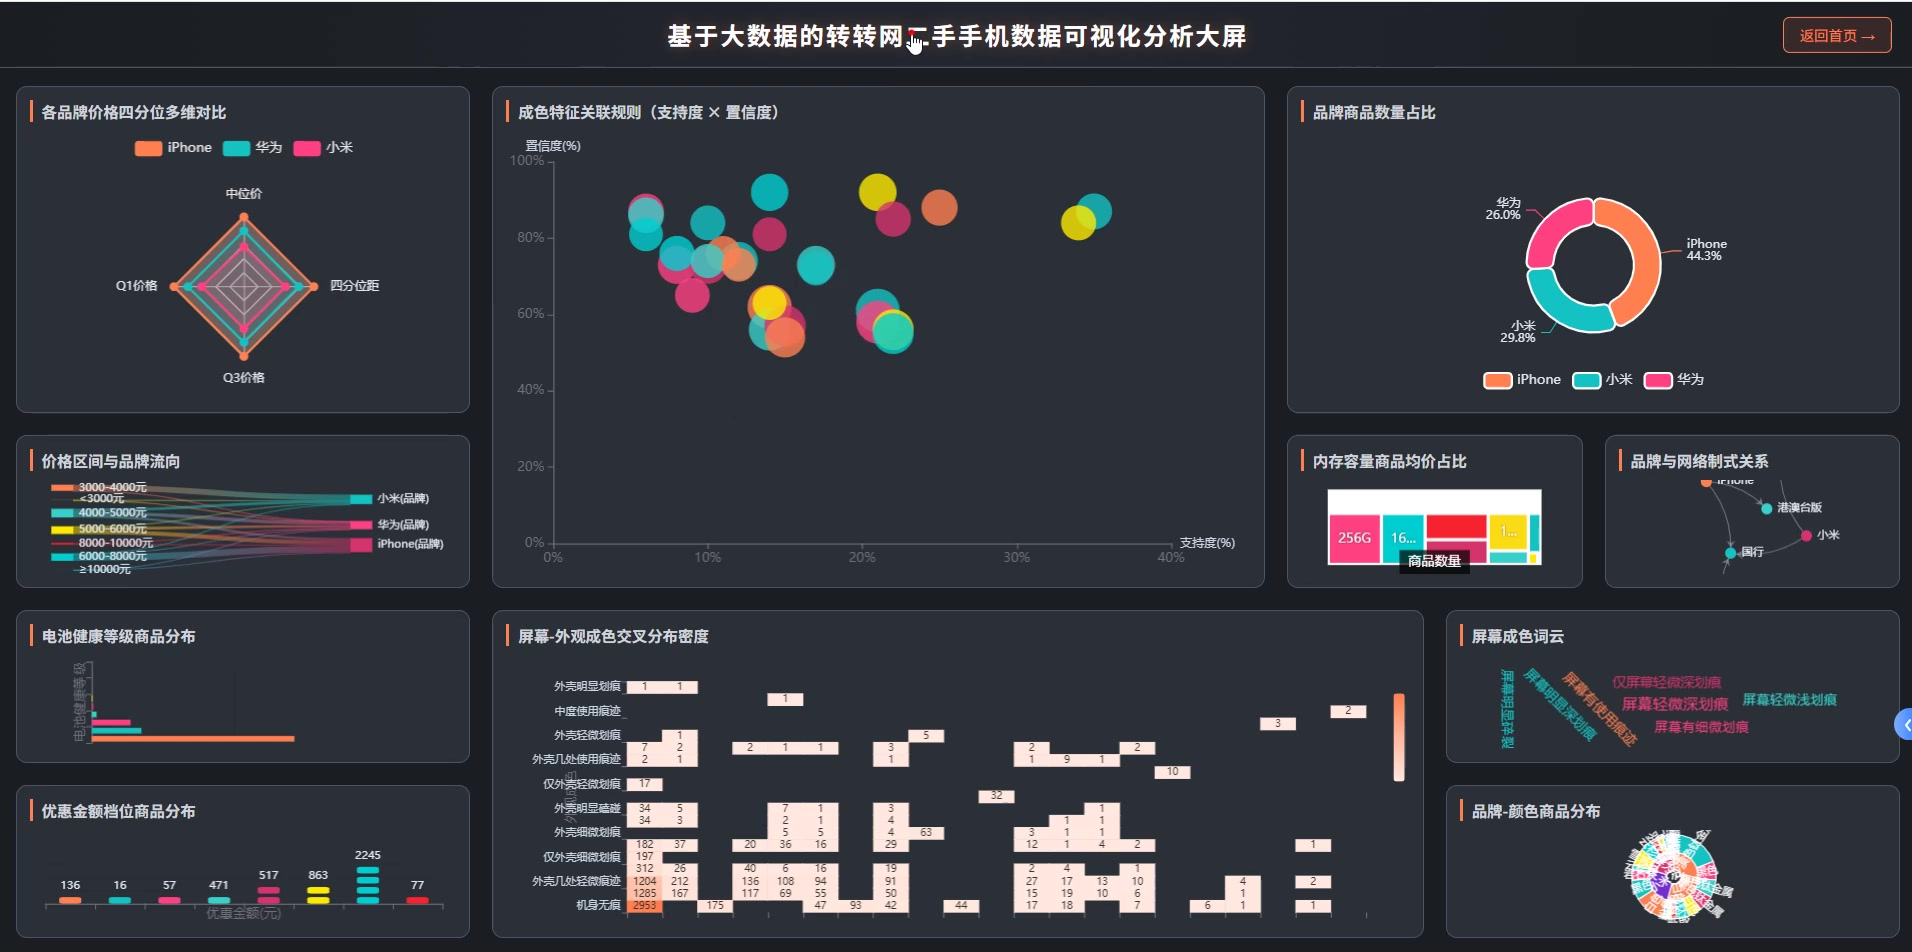
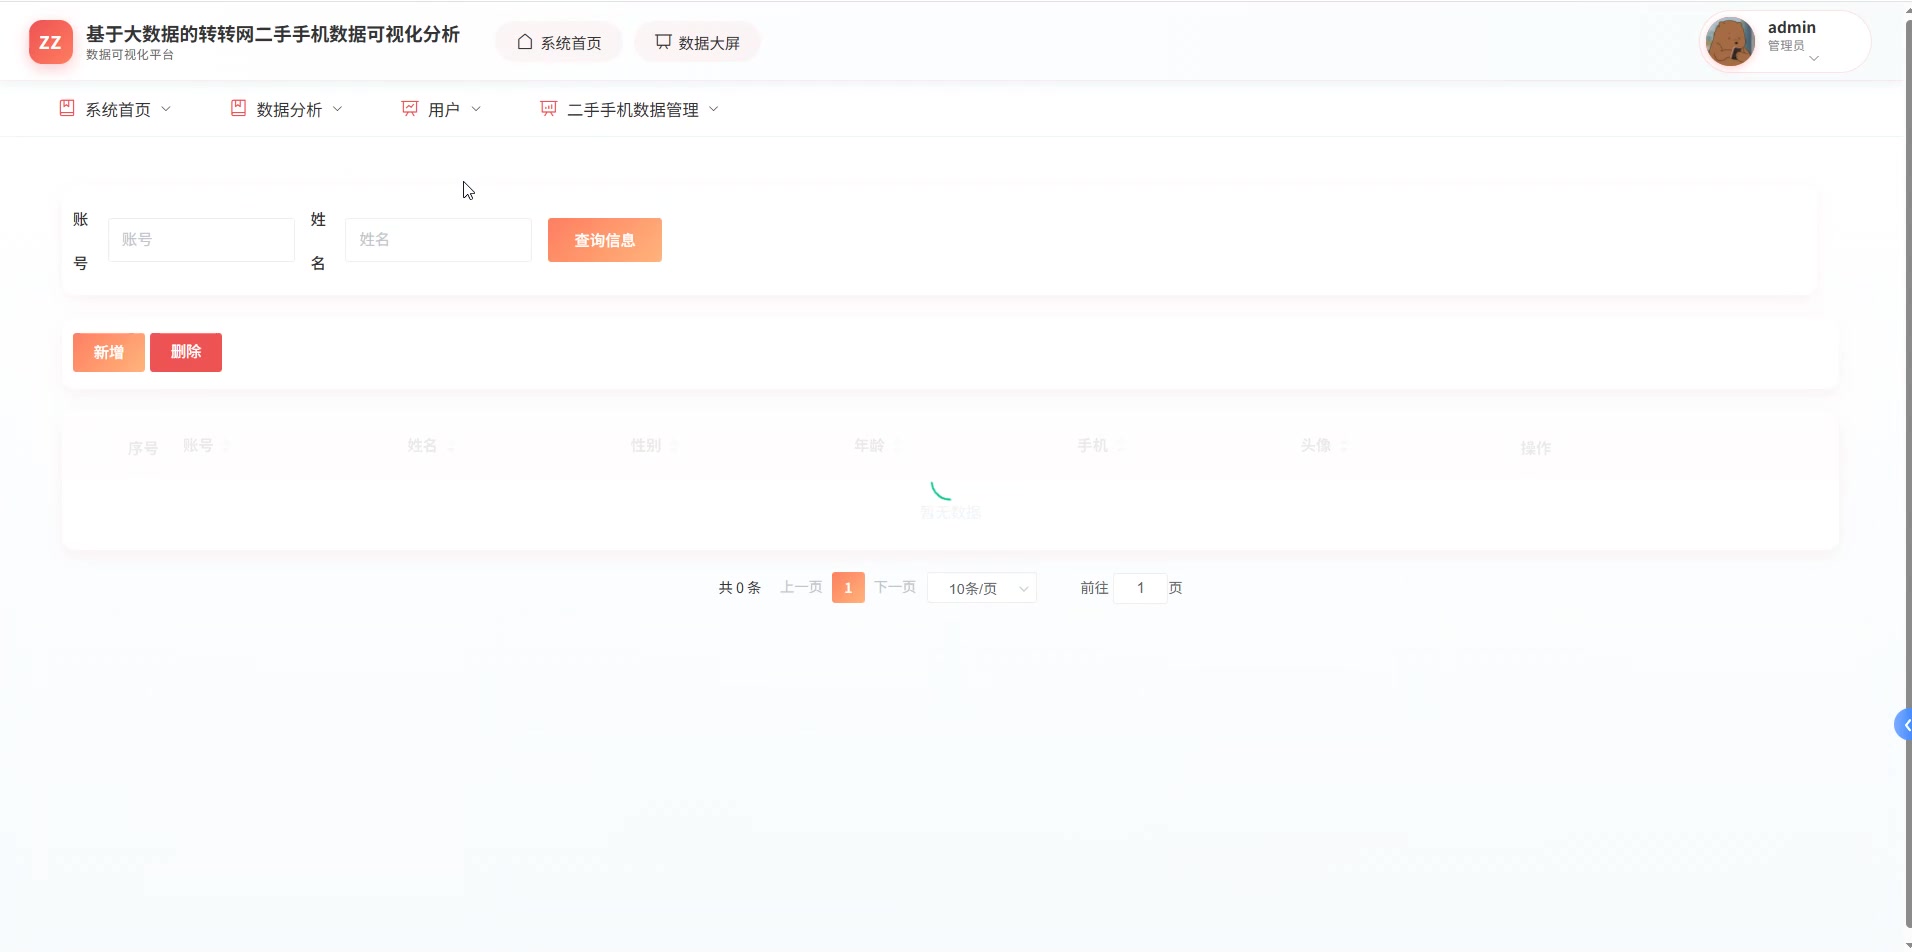
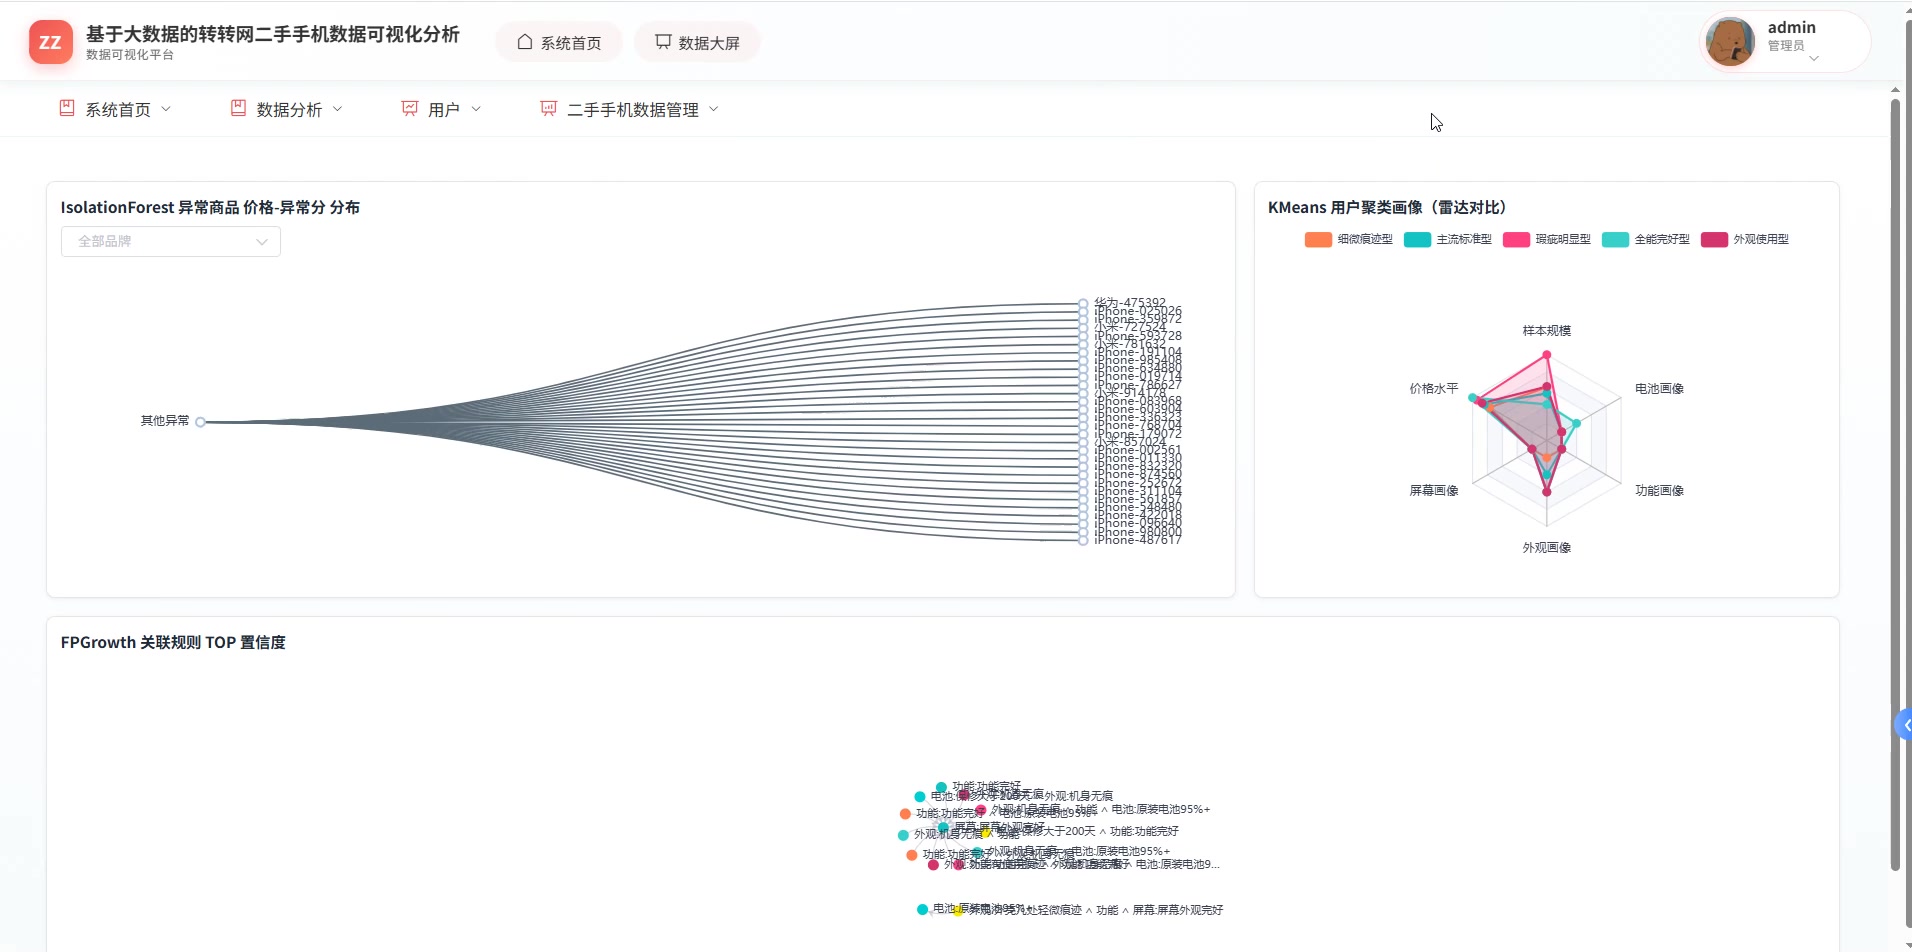
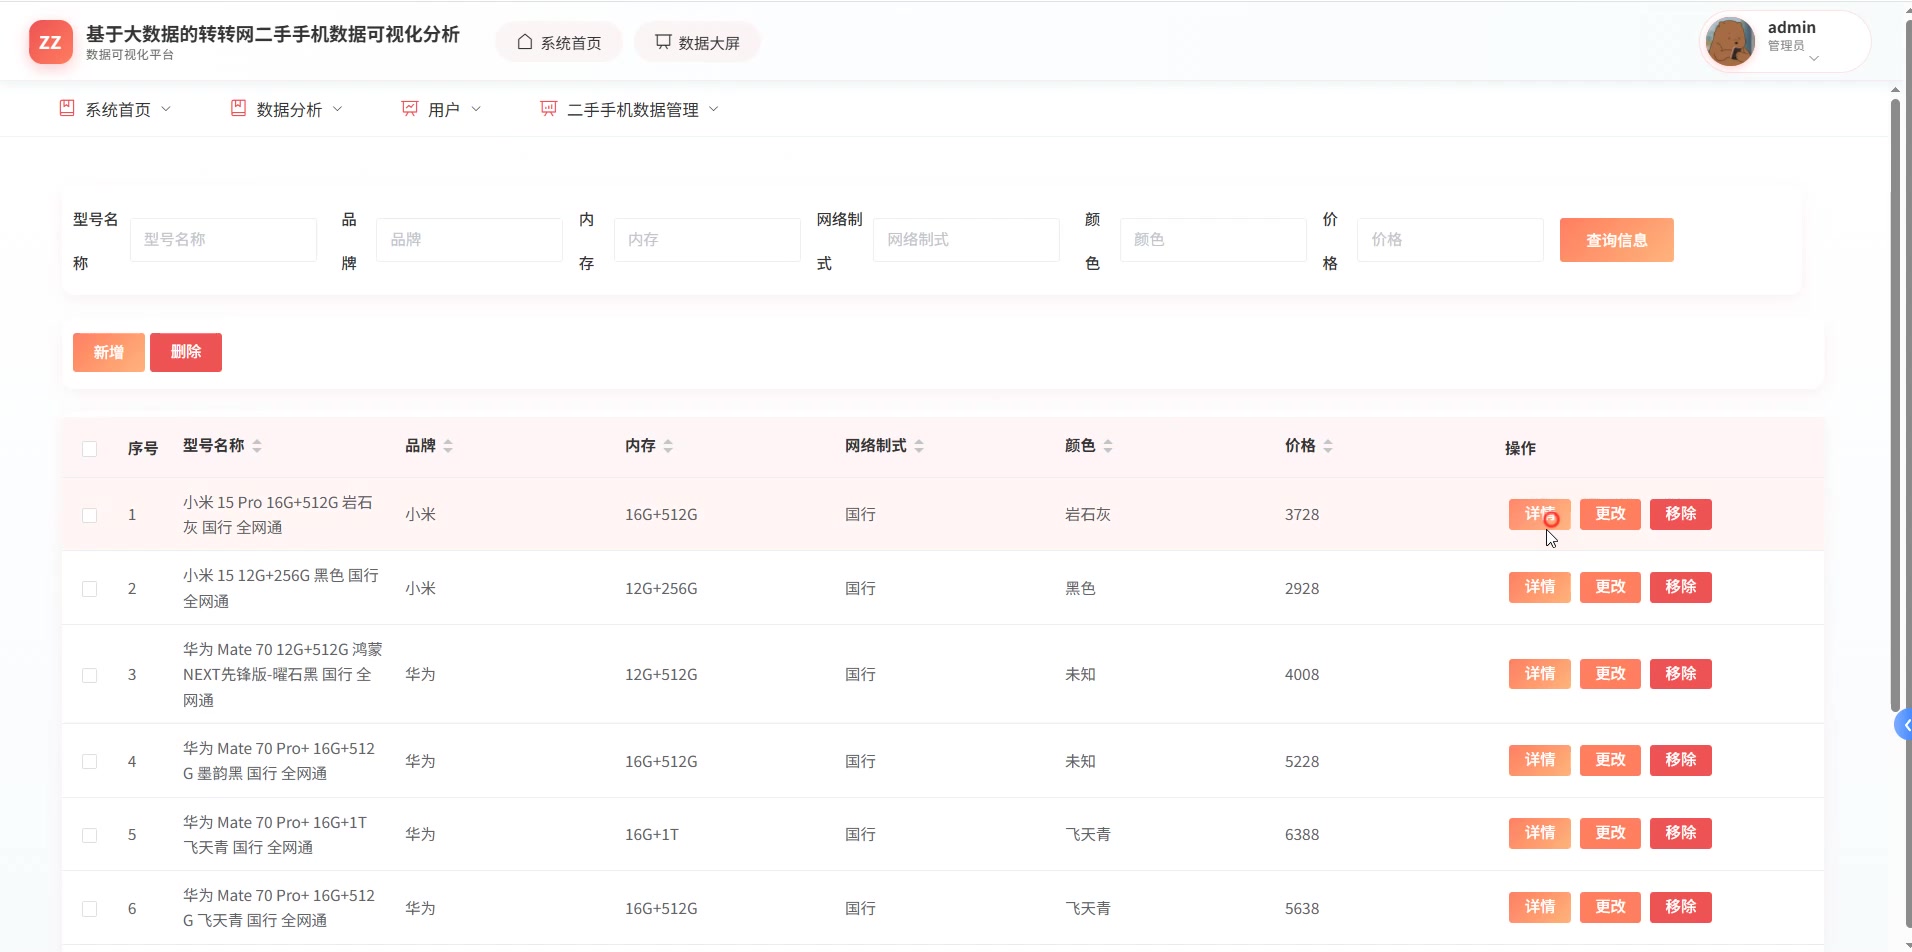
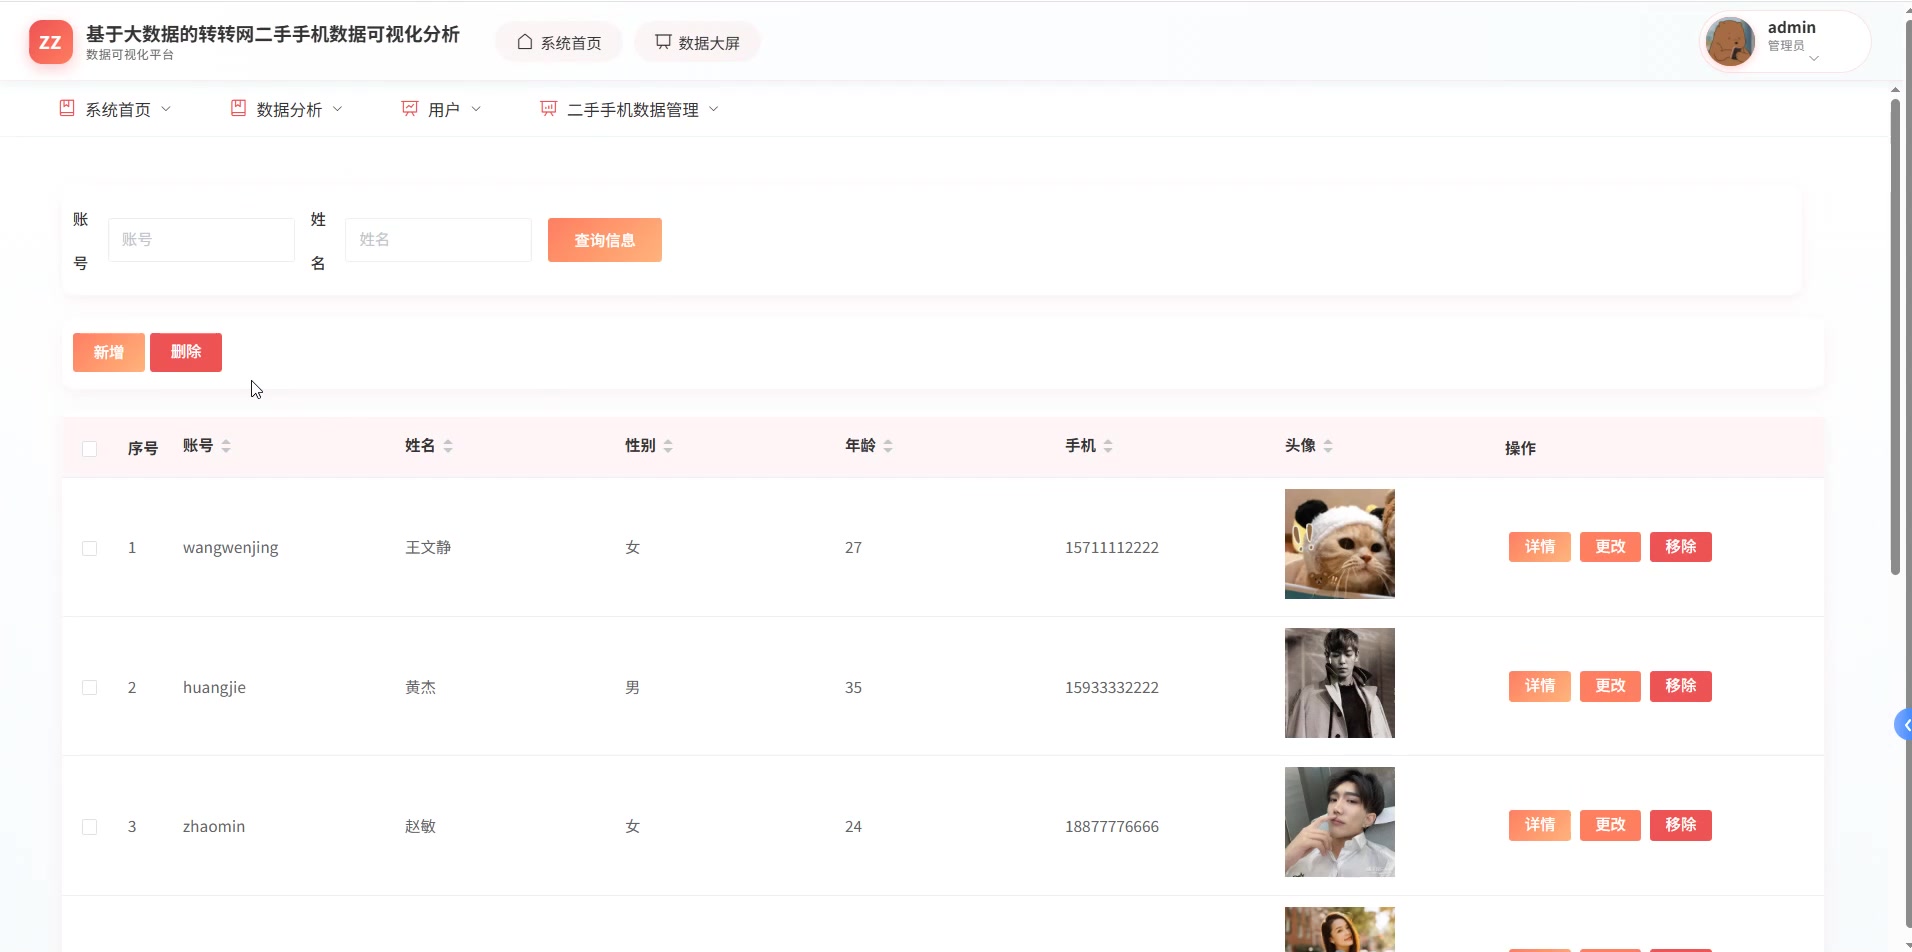
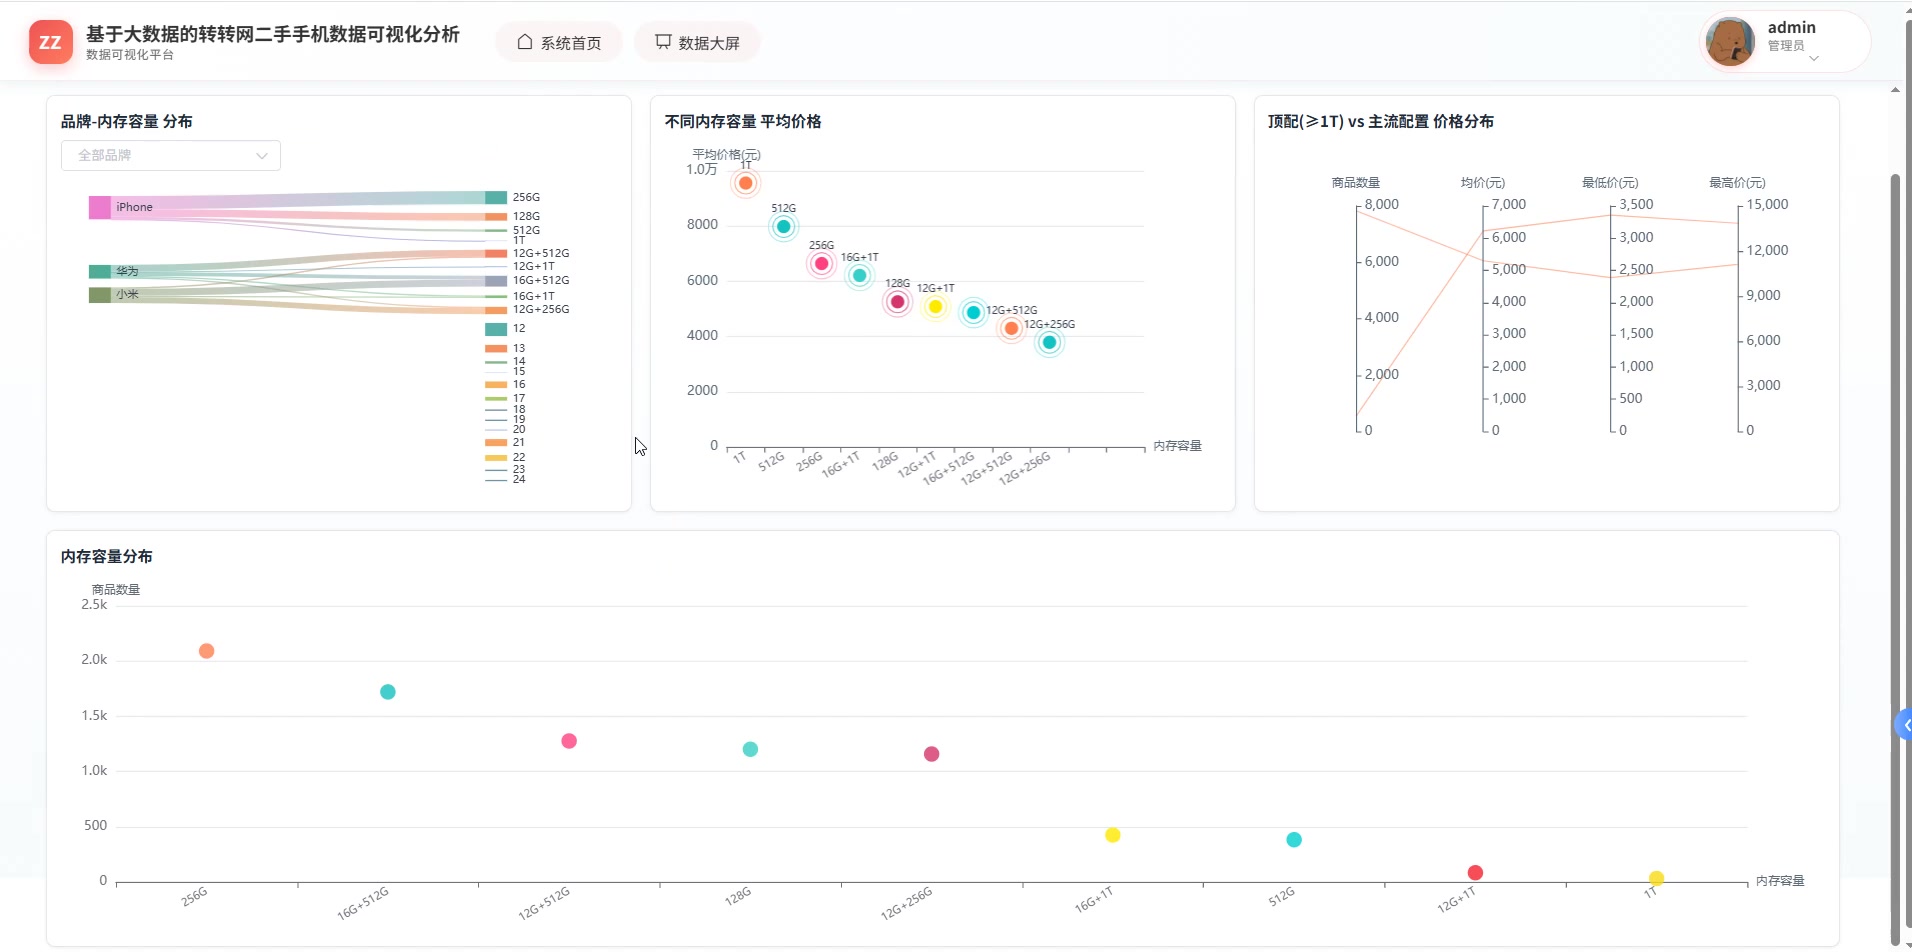
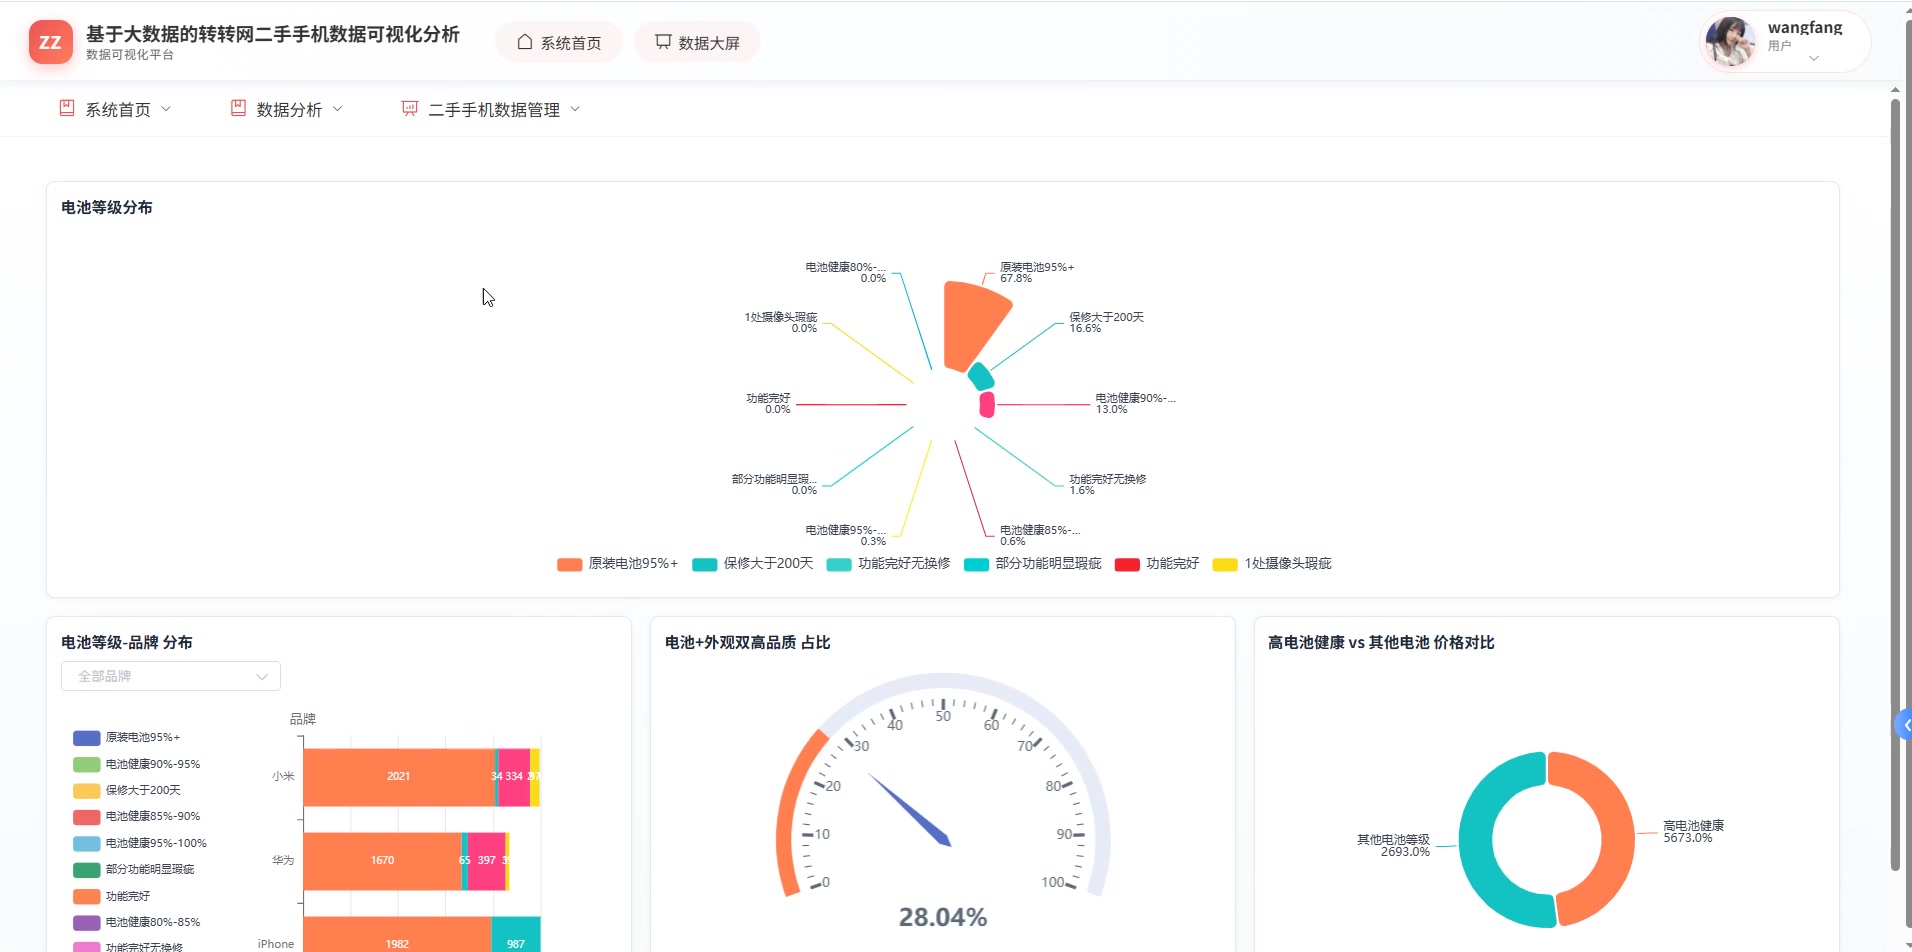
转转网二手手机数据可视化分析系统代码展示
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("SecondPhoneBigDataAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def brand_structure_analysis(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/second_phone_db").option("dbtable", "second_phone_data").option("user", "root").option("password", "123456").load()
if df.head(1) == []:
return {"code": 404, "msg": "二手手机数据为空", "data": []}
df = df.dropna(subset=["brand", "price"])
df = df.filter(df.price > 0)
df.createOrReplaceTempView("second_phone_data")
spark.sql("CACHE TABLE second_phone_data")
brand_df = spark.sql("SELECT brand, COUNT(*) AS total_count, ROUND(AVG(price), 2) AS avg_price, ROUND(MIN(price), 2) AS min_price, ROUND(MAX(price), 2) AS max_price FROM second_phone_data WHERE brand IS NOT NULL AND brand != '' GROUP BY brand ORDER BY total_count DESC")
brand_df.cache()
brand_df.count()
total = brand_df.agg({"total_count": "sum"}).collect()[0][0]
brand_rows = brand_df.collect()
result = []
for row in brand_rows:
ratio = round(row["total_count"] / total * 100, 2) if total else 0
result.append({"brand": row["brand"], "total_count": row["total_count"], "avg_price": row["avg_price"], "min_price": row["min_price"], "max_price": row["max_price"], "ratio": ratio})
top_brand = result[0] if result else {}
brand_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/second_phone_db").option("dbtable", "brand_analysis_result").option("user", "root").option("password", "123456").save()
brand_df.unpersist()
spark.sql("UNCACHE TABLE second_phone_data")
return {"code": 200, "msg": "品牌结构分析完成", "total": total, "top_brand": top_brand, "data": result}
def price_range_analysis(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/second_phone_db").option("dbtable", "second_phone_data").option("user", "root").option("password", "123456").load()
if df.head(1) == []:
return {"code": 404, "msg": "二手手机数据为空", "data": []}
df = df.dropna(subset=["price"])
df = df.filter((df.price > 0) & (df.price < 100000))
df.createOrReplaceTempView("price_phone_data")
spark.sql("CACHE TABLE price_phone_data")
range_df = spark.sql("SELECT CASE WHEN price < 1000 THEN '0-999元' WHEN price >= 1000 AND price < 2000 THEN '1000-1999元' WHEN price >= 2000 AND price < 3000 THEN '2000-2999元' WHEN price >= 3000 AND price < 5000 THEN '3000-4999元' WHEN price >= 5000 AND price < 8000 THEN '5000-7999元' ELSE '8000元以上' END AS price_range, COUNT(*) AS total_count, ROUND(AVG(price), 2) AS avg_price FROM price_phone_data GROUP BY CASE WHEN price < 1000 THEN '0-999元' WHEN price >= 1000 AND price < 2000 THEN '1000-1999元' WHEN price >= 2000 AND price < 3000 THEN '2000-2999元' WHEN price >= 3000 AND price < 5000 THEN '3000-4999元' WHEN price >= 5000 AND price < 8000 THEN '5000-7999元' ELSE '8000元以上' END ORDER BY total_count DESC")
range_df.cache()
range_df.count()
total = range_df.agg({"total_count": "sum"}).collect()[0][0]
rows = range_df.collect()
result = []
for row in rows:
ratio = round(row["total_count"] / total * 100, 2) if total else 0
result.append({"price_range": row["price_range"], "total_count": row["total_count"], "avg_price": row["avg_price"], "ratio": ratio})
main_range = result[0] if result else {}
range_df.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/second_phone_db").option("dbtable", "price_range_analysis_result").option("user", "root").option("password", "123456").save()
range_df.unpersist()
spark.sql("UNCACHE TABLE price_phone_data")
return {"code": 200, "msg": "价格区间分析完成", "total": total, "main_range": main_range, "data": result}
def big_screen_summary(request):
df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/second_phone_db").option("dbtable", "second_phone_data").option("user", "root").option("password", "123456").load()
if df.head(1) == []:
return {"code": 404, "msg": "二手手机数据为空", "data": {}}
df = df.dropna(subset=["brand", "price", "condition_level", "battery_health", "promotion", "memory_config"])
df = df.filter(df.price > 0)
df.createOrReplaceTempView("big_screen_phone_data")
spark.sql("CACHE TABLE big_screen_phone_data")
total_count = spark.sql("SELECT COUNT(*) AS total_count FROM big_screen_phone_data").collect()[0]["total_count"]
brand_top = spark.sql("SELECT brand, COUNT(*) AS total_count FROM big_screen_phone_data GROUP BY brand ORDER BY total_count DESC LIMIT 10").collect()
price_range = spark.sql("SELECT CASE WHEN price < 1000 THEN '0-999元' WHEN price >= 1000 AND price < 3000 THEN '1000-2999元' WHEN price >= 3000 AND price < 5000 THEN '3000-4999元' ELSE '5000元以上' END AS name, COUNT(*) AS value FROM big_screen_phone_data GROUP BY CASE WHEN price < 1000 THEN '0-999元' WHEN price >= 1000 AND price < 3000 THEN '1000-2999元' WHEN price >= 3000 AND price < 5000 THEN '3000-4999元' ELSE '5000元以上' END").collect()
condition_data = spark.sql("SELECT condition_level AS name, COUNT(*) AS value FROM big_screen_phone_data GROUP BY condition_level ORDER BY value DESC").collect()
battery_data = spark.sql("SELECT CASE WHEN battery_health >= 90 THEN '90%以上' WHEN battery_health >= 80 THEN '80%-89%' WHEN battery_health >= 70 THEN '70%-79%' ELSE '70%以下' END AS name, COUNT(*) AS value FROM big_screen_phone_data GROUP BY CASE WHEN battery_health >= 90 THEN '90%以上' WHEN battery_health >= 80 THEN '80%-89%' WHEN battery_health >= 70 THEN '70%-79%' ELSE '70%以下' END").collect()
promotion_data = spark.sql("SELECT promotion AS name, COUNT(*) AS value FROM big_screen_phone_data GROUP BY promotion ORDER BY value DESC").collect()
memory_data = spark.sql("SELECT memory_config AS name, COUNT(*) AS value FROM big_screen_phone_data GROUP BY memory_config ORDER BY value DESC").collect()
brand_list = [{"name": row["brand"], "value": row["total_count"]} for row in brand_top]
price_list = [{"name": row["name"], "value": row["value"]} for row in price_range]
condition_list = [{"name": row["name"], "value": row["value"]} for row in condition_data]
battery_list = [{"name": row["name"], "value": row["value"]} for row in battery_data]
promotion_list = [{"name": row["name"], "value": row["value"]} for row in promotion_data]
memory_list = [{"name": row["name"], "value": row["value"]} for row in memory_data]
result = {"total_count": total_count, "brand": brand_list, "price_range": price_list, "condition": condition_list, "battery": battery_list, "promotion": promotion_list, "memory": memory_list}
spark.sql("UNCACHE TABLE big_screen_phone_data")
return {"code": 200, "msg": "大屏可视化汇总完成", "data": result}
转转网二手手机数据可视化分析系统文档展示
💖💖作者:计算机编程小咖 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目


评论前必须登录!
注册