 网硕互联帮助中心
“回答挺专业,但没解决我的问题。”这句话经常出现在问答产品的反馈里。相关性评测要处理的正是这类落差:答案谈论了同一主题,不代表它回应了用户真正提出的要求。
若人工凭整体印象打分,模型裁判凭一段笼统提示打分,两边得到的分数很难比较。先写出共同规则,才能知道分歧来自答案,还是来自评分方法。
先把问题拆成可核对的要求
考虑这个构造问题:“我只有只读数据库权限,怎样定位昨晚变慢的查询?请给排查顺序。”它包含任务目标、权限约束、时间范围和输出形式。回答若只讲索引原理,虽然主题有关,却没有完成排查顺序;若第一步就要求创建索引,也忽略了只读限制。
先为每个评测问题写一个短的需求清单,不必写唯一参考答案。这个例子可以是:给出可执行的只读排查步骤,说明如何缩小到昨晚的问题,区分观察与修改操作。清单约束“应回应什么”,允许不同但合理的解决路径。
不要把清单扩展成理想教材的目录。用户没要求底层实现,就不该因为答案没有讲优化器而扣相关性分。评分规则一旦开始奖励“越全越好”,就会推动模型把每个问题写成长文。
用可观察的锚点代替形容词
三档评分已能用于初版,但每档需要说明证据。高分表示核心请求得到回应,必要约束被遵守,读者能依据答案推进任务;中分表示回应了部分请求,但遗漏了关键步骤或限制;低分表示主要内容偏题,或核心请求基本没有被处理。
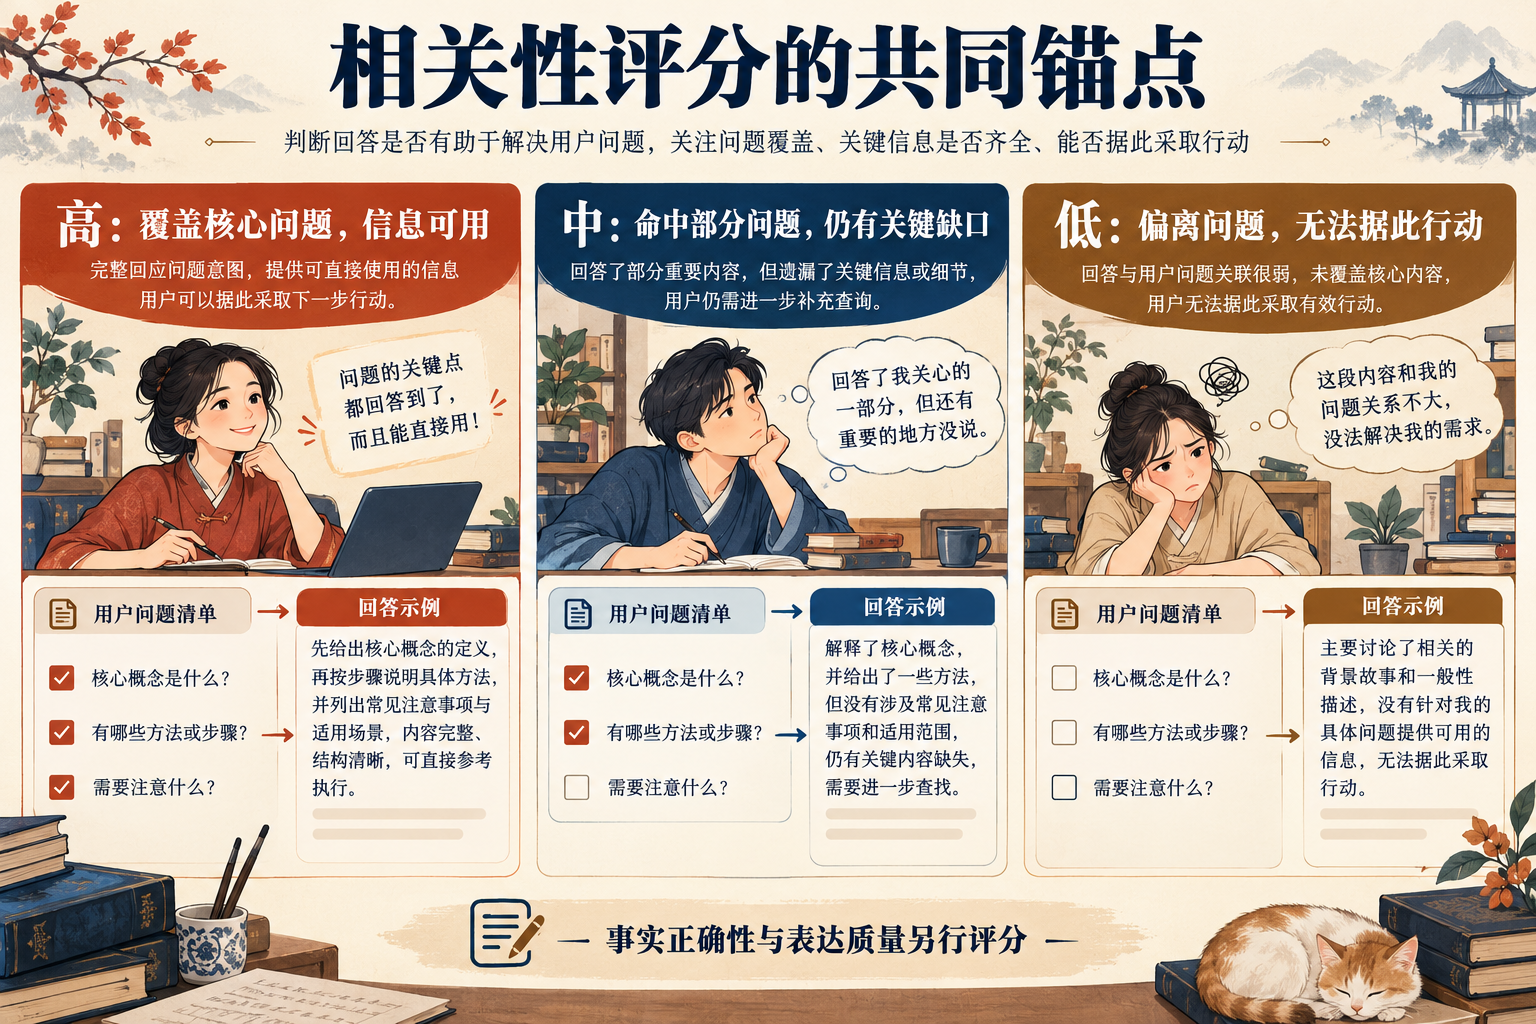
“专业”“全面”“令人满意”不能单独成为评分依据。它们描述印象,无法定位缺口。让评分员引用答案中的具体句子,说明它命中了哪条需求,或指出哪条需求仍未覆盖。
相关性不要吞掉其他质量维度
一段直接回应问题的答案,可能包含技术错误;一段完全正确的原理说明,也可能没有回应问题。相关性与事实正确性应该分别评分。否则,看到一个错误就把相关性打成最低,会让后续分析找不到真正需要修复的能力。
但约束违背通常与相关性直接有关。用户明确只有只读权限,答案却把写操作当作必做步骤,它没有适配任务条件。可以在相关性中扣分,同时在可执行性维度记录问题。允许同一缺陷影响不同维度,但每个维度的理由必须各自清楚,汇总时也要说明是否重复计权。
语气礼貌、排版整齐、答案很长,都不应自动加分。若文章式回答确实提供了必要步骤,它可以得高分;如果核心答案只有一句而且已足够,也同样可以。
给模型裁判的输入要与人工一致
人工和模型都应看到原始问题、必要上下文、候选答案、需求清单和评分锚点。如果模型额外看到了“优秀答案”标签或作者身份,比较就不公平;如果人工能查资料而模型不能,也应明确这是一种不同评测条件。
裁判输出可以包含 score、covered_requirements、missing_requirements 和 reason。理由应聚焦可观察内容,而不是自信地猜测用户未表达的动机。要求先列证据再给分,有助于复核,但不能据此断言模型一定不会受偏差影响。
分歧本身也是评测结果
先抽取一小组样本双人独立标注,再让模型评分。统计一致情况时,同步保留分歧样本。高低分相差很大的项目值得优先审阅:有时模型被长答案迷惑,有时人工把技术正确性混进了相关性,也可能是需求清单遗漏了重要条件。
修改规则后,要在新的或保留的校准样本上检查,而不是无限调规则直到当前样本完全一致。评分一致也不等于评分正确,两边可能共同忽略同一种缺陷。补入简短正确答案、冗长偏题答案、部分回应答案,有助于检查规则是否奖励了目标能力。
最后交付的评分规范应包括需求提取原则、各档锚点、边界案例和分歧处理方式。模型裁判可以加快筛查,人工可以处理复杂判断,两者真正共享的是这份可核对的标准,而不是同一个模糊分数。




评论前必须登录!
注册